Mais pourquoi l’IA est-elle utilisée pour faire la guerre ?, demande le sociologue Ori Schwarz dans un passionnant article pour Big Data & Society, en observant l’usage qu’en a fait l’armée israélienne à Gaza (voir notre dossier L’IA ça sert, d’abord, à faire la guerre). Qu’apporte-t-elle, que permet-elle que les techniques de guerre traditionnelle n’apportent pas ?
Pour le chercheur, l’IA a été utilisée pour accélérer la génération de cibles, car l’armée israélienne a adopté une doctrin
Pour le chercheur, l’IA a été utilisée pour accélérer la génération de cibles, car l’armée israélienne a adopté une doctrine axée sur la « létalité » (visant à maximiser le nombre de victimes) tout en intégrant le droit international humanitaire (qui impose de distinguer les cibles militaires des civils). L’IA n’était pas tant requise pour personnaliser le traitement, que pour justifier d’un traitement uniforme en créant des justifications adaptées, explique-t-il. Elle a été instrumentalisée pour légitimer tueries et destructions de masse en fusionnant et en analysant automatiquement des données pour transformer des milliers d’individus et de bâtiments en cibles légitimes assorties de scores de probabilité individuels.
Pour le chercheur, le profilage, la « singularisation automatisée » (que proposait le sociologue allemand Andreas Reckwitz dans son livre, The Society of Singularities, Polity, 2020), c’est-à-dire le fait que chacun soit traité différemment selon les données récoltées sur lui, est utilisée avec succès dans tous les domaines que le numérique transforme (marketing, médecine, tarification…). Mais, alors que le profilage ne cesse de promettre une distinction plus précise, il permet finalement de générer des effets de masses désastreux, comme dans le cas des destructions lors de la guerre à Gaza, brouillant la distinction entre cibles militaires et populations protégées. « Plus de 71 000 Palestiniens ont été tués, selon les chiffres officiels palestiniens et les estimations de l’armée israélienne. Mais seuls 20 % d’entre eux seraient des militants du Hamas alors que près de la moitié des victimes seraient des femmes et des mineurs. Des milliers d’autres sont portés disparus et d’autres encore sont morts de maladie et de malnutrition. Près de 2 millions de personnes ont perdu leur logement, la plupart des bâtiments résidentiels de Gaza ayant été détruits ou gravement endommagés. L’ampleur des pertes civiles a conduit la Cour internationale de Justice à saisir Israël pour violation présumée de la Convention sur le génocide. »
Une grande partie de ces victimes et destructions visait des cibles identifiées par les services de renseignement israéliens grâce à une utilisation sans précédent de technologies numériques sophistiquées. Schwartz y voit un paradoxe. D’un côté, l’armée israélienne s’est vantée d’effectuer la sélection des cibles à l’aide d’outils d’IA et d’analyse de données les plus sophistiqués pour identifier des cibles humaines et des infrastructures liées au Hamas ; pourtant, le résultat de cet investissement sans précédent dans un ciblage sophistiqué donne l’impression d’une destruction et de tueries massives et indiscriminées. « Si l’objectif est de tuer sans distinction, pourquoi une technologie aussi avancée est-elle nécessaire ? »
Pour Schwarz, si l’IA est utilisée pour procéder à des tueries de masse, c’est justement en raison de sa capacité de distinction :« en singularisant les justifications de tueries indiscriminées, elle produit de la distinction au service de l’indiscrimination ». Cela se produit parce que les effets sociaux de l’IA ne sont pas prédéterminés par les caractéristiques technologiques, mais façonnés par les contextes juridique, structurel, culturel, politique et moral dans lesquels la technologie s’inscrit. En particulier, les tueries et les destructions indiscriminées découlent de la construction politique de « cibles ». À une époque où le droit international humanitaire ainsi que les normes éthiques et professionnelles militaires exigent de ne viser que des « cibles » légitimes, l’impact du big data sur la guerre ne consiste pas nécessairement à réduire les massacres et les destructions en trouvant « l’aiguille dans la botte de foin », comme on l’affirme généralement. Mais, tout le contraire : « il s’agit de transformer le foin en aiguilles, en « incriminant » presque tous habitants ou tous les immeubles résidentiels par l’élaboration d’un récit singulier les associant exclusivement à l’ennemi, légitimant ainsi une destruction indiscriminée. » Pour le chercheur, les massacres et les destructions ne s’expliquent pas uniquement par ces développements technologiques bien sûr, mais la justification technique a permis de renforcer les dynamiques politiques en cours.
Les raisons du succès de l’élimination ciblée
Longtemps, les assassinats extrajudiciaires se limitaient à de rares opérations clandestines visant des opposants de haut rang, rappelle le chercheur. Puis l’élimination ciblée s’est transformée en une politique déclarée, systématiquement mise en œuvre à une échelle toujours plus vaste.
Cette politique s’appuie sur trois principes. Premièrement, l’individualisation de la guerre : l’affrontement est requalifié en une action de police ou de poursuite judiciairevisant des individus.Les individus deviennent des cibles non pas en raison de leur statut (appartenance à une force armée ennemie), mais en raison de leur comportement ou de la menace qu’ils représentent. Chaque individu reçoit un score qui détermine son implication quelque soit les biais du calcul. Et la valeur que l’on attribue à cette implication peut varier.
Deuxièmement, la juridicisation de la guerre : face à la complexité croissante du droit international humanitaire, les armées ont intégré des juristes à leurs équipes pour protéger leurs personnels des poursuites. Désormais, il faut pouvoir établir la légalité des attaques, au regard de principes de nécessité, de proportionnalité et de distinction. Tout en trouvant des modalités pour interpréter le droit international de manière extensive… La juridicisation a conduit à devoir collecter des données pour établir la légalité des ciblages.
Troisièmement, le transfert de risque vise à minimiser le risque pour les soldats en les transférant aux civils ennemis, par exemple en recourant à des bombardements aériens, de préférence par drones, plutôt qu’à des combats terrestres ou à des arrestations. « Depuis 2000, l’ampleur des « assassinats ciblés » a connu une croissance spectaculaire, passant de quelques dizaines à plusieurs milliers de victimes. Cette augmentation est due à l’élargissement controversé de la définition des cibles légitimes », qui a inclus les membres non combattants d’organisations terroristes, puis les civils ayant contribué indirectement aux hostilités. Cet élargissement a engendré un nouveau défi que les systèmes d’IA ont cherché à relever par le scoring : prouver le lien de la cible avec l’organisation ennemie. Si ce lien était évident lorsqu’il s’agissait de cibler des commandants de haut rang, il est devenu de plus en plus difficile à prouver à mesure que le nombre de cibles augmentait. Ce n’est qu’au cours de la guerre de Gaza de 2023, avec la décision d’attaquer des dizaines de milliers de jeunes militants du Hamas, que la nécessité de vérifier si la cible envisagée pour un assassinat avait un lien quelconque avec une organisation terroriste, s’est imposée. « L’utilisation du big data a transformé les cibles d’exécutions extrajudiciaires, passant d’individus isolés (des personnes importantes et connues) à des cas regroupés en clusters dynamiques calculés par des algorithmes. Si les « assassinats ciblés » requièrent certaines technologies de renseignement et de surveillance, l’analyse des mégadonnées a été progressivement introduite, d’abord pour réduire le taux élevé d’erreurs d’identification humaine, puis, à plus grande échelle, pour rationaliser les opérations d’assassinat, en réduire les coûts et en étendre la portée ». Bien que l’utilisation de l’IA pour « incriminer » des cibles repose sur l’individualisation et la juridicisation de la guerre, la quantification automatique des risques entre en conflit avec des principes juridiques fondamentaux tels que le raisonnement, la réflexion et la prise de décision contextualisée. Les chercheurs critiques Nicola Perugini et Neve Gordon affirment que les assassinats ciblés reposent sur un « dispositif de distinction » conçu pour désigner des cibles humaines à des fins militaires en identifiant des « anomalies » dans les relations entre les données, c’est-à-dire en surveillant les comportements et en repérant les irrégularités. Les écarts statistiques sont alors considérés comme des écarts normatifs passibles de la peine de mort, comme l’expliquait le politologue Hendrik Huelss.
Avant même leur automatisation, les assassinats se fondaient déjà sur l’identification de schémas de vie associés au terrorisme. La surveillance et les données permettent de requalifier des individus, auparavant considérés comme des « civils » protégés, en cibles ennemies jugées moralement et légalement abattables, même lorsqu’ils ne participent pas directement aux hostilités. Eric Bonds a qualifié ce phénomène de « violence humanisée », une nouvelle forme de violence qui se manifeste à la fois par une pratique (fondée sur la surveillance et les technologies d’élimination de précision) et par un discours de légitimation (qui s’appuie sur le langage des droits de l’homme et qui, comme le présente ses partisans, paraît rationnel, mesuré et humain, car ils s’efforcent de minimiser les dommages causés aux civils innocents en évaluant les dommages collatéraux prévus de chaque frappe par rapport à son avantage militaire). Ceci produit un « effet paradoxal » : le strict respect des procédures et des critères juridiques (qui interdisent de cibler les civils ne participant pas aux hostilités et exigent que les dommages causés aux civils soient minimaux) tout en permettant de les contourner.
Le scoring pour renforcer la tolérance à l’intolérable
Le paradoxe, c’est que la justification par le calcul renforce la tolérance à l’égard des meurtres de civils. « L’utilisation de technologies avancées visant à réduire les dommages causés aux civils (par exemple, la reconnaissance faciale pour éviter les erreurs d’identification et l’imagerie satellitaire pour estimer les dommages collatéraux et calculer la proportionnalité avec une précision actuarielle) et le recours à des calculs proportionnels à l’avantage militaire renforcent la légitimité et la tolérance à l’égard des meurtres de civils ».
En effet, ces calculs rendent chaque attaque juridiquement justifiée et les décès de civils regrettables, mais légitimes. Les efforts déployés pour minimiser les « dommages collatéraux » (en avertissant les civils avant les attaques et grâce aux calculs de proportionnalité) présentent les incidents ayant entraîné de nombreuses victimes civiles comme des accidents involontaires comme l’explique Craig Jones dans son livre The War Lawyers (Oxford University Press 2020 ou Yael Levy, dans le sien Shooting without crying: The new militarization of Israel in the 2000s, 2023). Et la numérisation renforce considérablement cette légitimation : les scores calculés par algorithme bénéficient d’une aura d’objectivité et de confiance en raison de la confiance bien documentéeaccordée aux chiffres – notamment par l’historien des sciences Theodore Porter dans son livre, La confiance dans les chiffres (Les Belles lettres, 2017). En convertissant l’incertitude quant aux dommages potentiels causés aux citoyens en « risques » mesurables, les algorithmes transforment les dilemmes moraux en procédures technico-informatiques et finalement réduisent les doutes moraux et la réflexivité, comme le montrait Lucy Suchman dans un article de recherche. Finalement, le ciblage automatisé permet de légitimer les frappes, qu’importe les dégâts qu’elles causent. Or, la violence « humanisée » tue principalement des civils (60 % à 90 % des décès sont des « dommages collatéraux » expliquaient déjà Perugini et Gordon, rappelant également qu’elle est imprécise et surtout qu’elle restreint les catégories protégées tout en légitimant le meurtre).
Contrairement aux tirs des chars, les frappes aériennes contres des cibles spécifiées par le renseignement sont soumises aux principes du droit international humanitaire qui définit les conditions de la légitimité de la violence militaire et doivent donc être traduit en procédures formelles qui encadrent la définition des cibles. Le droit humanitaire repose notamment sur des principes de distinction (ne cibler que les cibles militaires dont l’attaque procure un avantage militaire, et non les civils ou les infrastructures civiles), de proportionnalité (interdire les attaques qui causent des dommages disproportionnés aux civils par rapport à l’avantage militaire obtenu) et de précaution. Mais une autre doctrine est venue également changer le cours de la guerre : la doctrine de la létalité. Plus que le contrôle du terrain, le nombre de morts ennemis est devenu le principal critère d’évaluation des opérations militaires ou des performances des unités. L’industrialisation de l’extermination de précision, défendue par Aviv Kokhavi, chef d’état major de l’armée israélienne, exigeait la production en masse de cibles pour les frappes aériennes. Mais la cible, même légitime, est une construction politique et sociale, comme le montrait l’article de +972 Magazine, qui évolue selon le contexte, à l’image des dommages collatéraux afférents autorisés ou du niveau du scoring qui transforme un soupçon en cible.
En effet, les procédures utilisées pour transformer des personnes ou des bâtiments en cibles impliquent divers acteurs s’intégrant à un réseau : non seulement les définitions juridiques, les concepts moraux et les agents de renseignement, mais aussi les documents de renseignement, les technologies de surveillance qui les produisent et les technologies utilisées pour les traiter et les analyser. La construction des cibles n’étant pas uniquement un processus social, les évolutions technologiques peuvent la transformer. Et le scoring est justement en passe de devenir le facteur d’accélération.
Comment l’IA a-t-elle modifié la construction des cibles, qui n’est pas uniquement un processus social ?Lors de la guerre de Gaza, Israël a utilisé deux types de systèmes d’IA distincts, l’un pour les cibles d’infrastructure et l’autre pour les cibles humaines, explique Schwarz. Ces systèmes avaient des historiques différents, mais présentaient de nombreux points communs. Les personnes interrogées ont souligné que ces deux systèmes ne prenaient pas de décisions à la place des humains, mais accéléraient la production de cibles de deux manières : en fusionnant les informations provenant de sources multiples et en rendant accessibles aux analystes toutes les informations pertinentes concernant chaque cible potentielle ; et en classant les cibles potentielles selon leur probabilité estimée. Ainsi, les analystes humains peuvent se concentrer exclusivement sur les cibles les plus susceptibles d’être approuvées : « [Supposons] que vous disposiez d’un milliard d’informations et que (…) vous n’ayez que 100 cibles alors que vous avez 10 000 candidats. Alors, à quoi sert l’IA ? À une seule chose : les trier par ordre de priorité. (…) [L’ordinateur] a pris les 10 000 suspects, a examiné quelques milliers de cas avérés et [a reçu l’instruction de trier] tout ce qui se ressemble sur tous les points. Ensuite, la machine établit les priorités, c’est tout. Une fois les priorités établies, elle indique aux services de renseignement : vérifiez ceci, cela et cela. Attribuez une file d’attente. (…) Cela signifie que le travail est rationalisé. Mais aucune machine ne décide », déclarait un officier de l’armée israélienne.
Ce discours humaniste et anthropocentrique, également fréquent dans les déclarations de Tsahal sur l’IA, minimise le rôle de la technologie, la réduisant à un simple outil au service d’objectifs humains. L’armée israélienne a décrit le système d’IA « Gospel » comme un simple « outil technique destiné aux analystes du renseignement », car sa traçabilité et son intelligibilité permettent aux analystes d’examiner eux-mêmes les éléments de renseignement sur lesquels reposent ses recommandations. Cependant, même une délégation partielle du ciblage peut avoir des conséquences plus importantes : d’une part, les pressions organisationnelles de niveau intermédiaire en faveur de l’efficacité et les biais d’automatisation de niveau micro peuvent conduire les analystes humains à approuver les recommandations du système de manière quasi automatique (comme nous le disions dans la seconde partie de notre dossier) ; d’autre part, les outils ne se contentent pas de réaliser les objectifs des utilisateurs, mais les façonnent également en proposant de nouvelles pistes d’action permettant l’accélération. Yossi Sariel, ancien commandant de l’unité de renseignement 8200 de Tsahal, a soutenu que l’accélération est l’une des deux principales contributions de l’automatisation informatique au renseignement. Selon lui, la production d’un plus grand nombre de cibles est nécessaire pour exercer une pression constante sur l’ennemi et le vaincre, mais l’intervention humaine constitue un goulot d’étranglement, car la création d’un tel nombre de cibles exigerait des milliers d’enquêteurs traitant et analysant les données pendant des années. Pour lever cet obstacle, il faudrait une « équipe homme-machine » capable de constituer une base de données de dizaines de milliers de cibles et d’en générer des milliers d’autres chaque jour de combat, comme il l’expliquait dans son livre éponyme. La seconde contribution identifiée par Sariel est la prédiction, définie comme le fait de « compléter les informations manquantes » à partir des tendances observées dans les données massives. La prédiction n’est donc pas seulement orientée vers l’avenir (prédire qui commettra un attentat-suicide), mais surtout vers le présent et le passé (prédire où des armes ont été dissimulées). Les prédictions revêtent alors une importance épistémologique : « elles permettent d’incriminer des personnes et des lieux sur la base d’informations incriminantes inconnues, déduites d’éléments non incriminants connus ». L’IA sert à la production d’inférences, de décisions probabilistes que leur niveau de probabilité valide.
La probabilité sert à générer les cibles et intensifier les frappes
La génération par IA de cibles d’infrastructures (de bâtiments) s’effectue au sein de la Direction du ciblage de l’armée israélienne, créée en 2019, explique Schwarz. Cette création faisait suite à un rapport du Contrôleur de l’État indiquant que la banque de cibles disponible au début de la guerre de 2014 entre Israël et le Hamas était bien inférieure au potentiel réel. Une personne interrogée a expliqué les raisons de la création de cette direction en ces termes : « On veut disposer d’une banque de cibles de qualité, que l’on peut frapper pour contraindre le Hamas à capituler » ; or, en 2014, « cela ne s’est pas passé ainsi : il a fallu envoyer des troupes au sol ». L’armée et les médias israéliens ont présenté cette direction et le système d’IA « Gospel » comme la solution.
Lors des conflits précédents, la banque de cibles s’épuisait après quelques jours ou semaines de bombardements intensifs, limitant le volume de tirs. La direction a promis de remédier à ce problème en accélérant et en rationalisant la génération de cibles, tant avant que pendant les hostilités, afin de « transformer la capacité de destruction de Tsahal en un système industriel » capable de « détruire des milliers de cibles chaque jour », explique un article de Ynet, l’un des journaux en ligne hébreu. Pour y parvenir, Gospel fusionne des milliards de données provenant de sources variées (et notamment du renseignement, telles que des appels téléphoniques interceptés et des photographies aériennes), identifie des cibles potentielles grâce à l’apprentissage automatique (en se fondant sur leur ressemblance avec des cibles précédemment validées) et les classe selon la probabilité qu’il s’agisse de cibles légitimes et de qualité. Ces recommandations classées sont ensuite transmises à des analystes humains pour décision, puis à des officiers supérieurs pour approbation.
Cette automatisation partielle accélère considérablement la génération de cibles. Un officier supérieur du renseignement a noté : « Gospel dispose d’une interface utilisateur très simple qui organise la file d’attente des cibles en fonction de la probabilité et de l’importance. Ainsi, l’opérateur humain reçoit simplement une liste établie par la machine, indiquant la probabilité qu’il s’agisse d’une cible valide ainsi que son importance. Le système fonctionne par scores. Par exemple, il s’agit d’une cible avec une probabilité de 80 % ou de 30 %. La machine émet donc une recommandation : « À mon avis, c’est une cible. » L’opérateur prend alors le relais, vérifie le processus suivi par la machine, exerce son jugement – car la machine peut parfois commettre des erreurs – et décide finalement s’il s’agit bien d’une cible. »» Un autre officier a expliqué que la priorisation automatisée était devenue nécessaire en raison de la « croissance exponentielle » du volume de données (consécutive à la numérisation, à la « datafication » et à l’impératif de collecter et d’analyser toutes les données), rendant l’analyse humaine impossible : « Que faire ? Recruter 50 000 agents de renseignement ? Nous ne les avons pas. Alors, utilisons un bon ordinateur pour effectuer la priorisation à notre place. En somme, c’était la mission assignée à la Direction du ciblage. » Un juriste impliqué dans l’élaboration des cibles a affirmé que la cadence de production du système était 50 fois supérieure à celle d’une équipe de 20 officiers de renseignement. Les personnes interrogées ainsi que les déclarations officielles de l’armée ont souligné que la Direction du ciblage avait pour vocation de « constituer de vastes banques de données » afin de permettre l’attaque de « milliers de cibles en une seule journée », industrialisant ainsi l’extermination. Comme souvent, cette industrialisation s’est accompagnée d’une intensification du travail : dès 2019, les soldats de cette direction nouvellement créée ont fait état de pressions visant à accélérer la production de cibles en faisant l’impasse sur un examen approfondi, avec des mesures incitatives – telles que des jours de congé – pour les équipes les plus « productives ». La durée de validité limitée des cibles a été prolongée grâce à une modification des procédures, autorisant le bombardement de cibles plusieurs mois après leur identification, sans nouvel examen, expliquait Haaretz.
« L’accélération de la production de cibles est jugée cruciale en temps de guerre et l’IA permet justement d’accélérer la production ». Cette accélération a atteint son paroxysme lors de la guerre contre Gaza : au 27e jour du conflit, Tsahal a annoncé avoir frappé 12 000 cibles tout en générant simultanément 1 200 nouvelles cibles grâce à son « usine à cibles » fonctionnant 24 heures sur 24.
Mais l’utilisation de l’IA pour identifier des listes de personnes à cibler plutôt que des lieux relève d’une autre dynamique, explique Schwarz. Une dynamique qui a débuté avec le recours à l’IA pour des arrestations préventives.
À l’automne 2015, Israël a dû faire face à une vague d’attaques spontanées, perpétrées principalement par des adolescents. Il était difficile de déjouer ces attaques, car les auteurs n’étaient affiliés à aucun réseau terroriste ou de guérilla. En conséquence, les services de renseignement israéliens ont mis au point un modèle visant à prédire quels adolescents étaient les plus susceptibles de commettre des attaques, en analysant les schémas d’activité sur les réseaux sociaux (publications, « like », commentaires, émojis, nouveaux liens) ainsi que des données provenant d’autres sources (par exemple, les données de localisation), en attribuant à chaque adolescent palestinien un score de risque. Le modèle s’appuyait sur des schémas prédictifs identifiés à la fois par l’apprentissage automatique (analyse de mégadonnées) et par des analystes humains (par exemple, de nouvelles coupes de cheveux, les auteurs d’attentats-suicides adoptant souvent une nouvelle coiffure peu avant de passer à l’acte). Ce modèle a conduit à l’arrestation préventive de centaines d’adolescents palestiniens.
D’autres systèmes ont été développés par la suite pour identifier des membres d’organisations terroristes en vue de leur arrestation et de leur interrogatoire. Lors de la guerre à Gaza, cette stratégie a été étendue pour dresser des listes de cibles à éliminer d’une longueur sans précédent, appliquant les principes de la police prédictive pour produire des cibles à éliminer. Le système d’IA « Lavender » attribuait à presque tous les habitants de Gaza un score de probabilité d’appartenance au Hamas, en se fondant sur des facteurs couramment utilisés dans la police prédictive comme le montre la sociologue Sarah Brayne dans son livre, Predict and surveil(2021, Oxford university Press), notamment les réseaux personnels, les habitudes de vies comme les lieux fréquentés et les déplacements. 37 000 Palestiniens ont été identifiés par algorithme comme étant probablement des membres du Hamas comme le montrait Abraham dans son article pour +972 Magazine.
«Les scores de probabilité transforment la distinction entre terroriste et civil, passant d’une catégorie binaire à un continuum statistique ». Les individus classés par l’IA comme membres probables du Hamas étaient alors ajoutés aux listes de cibles à éliminer sans réel examen supplémentaire. D’autres rapports font état d’une certaine forme de supervision humaine ; par exemple, des officiers auraient corrigé une erreur d’interprétation de l’IA qui avait pris une liste d’élèves du secondaire pour une liste de militants potentiels, une erreur qui aurait pu conduire à désigner à tort 1 000 adolescents comme cibles.
Reste que l’accélération n’a pas été que technologique, elle a aussi été politique. Le Premier ministre Benjamin Netanyahu aurait reproché au chef d’état-major Herzi Halevi de n’avoir bombardé « que » 1 500 cibles au cours des 48 premières heures du conflit ; il a rejeté l’explication de Halevi, qui indiquait ne pas disposer de 5 000 cibles, en déclarant : « Je m’en fiche ». Sans l’IA, estime Schwarz, « il aurait été difficile d’atteindre une telle ampleur de morts et de destructions ».
L’armée israélienne a assoupli son interprétation du droit international humanitaire pendant la guerre sans pour autant abandonner totalement ce cadre, par exemple en relevant les seuils de « dommages collatéraux » et en autorisant des attaques ciblées contre chacun des 37 000 membres présumés de rang inférieur du Hamas, à condition que le nombre de décès civils anticipés reste inférieur au seuil.La pratique du « roof-knocking » (bombardements d’avertissement) a été abandonnée et des cibles présentant une probabilité moindre ont été prises en compte. En conséquence, le taux de mortalité civile s’est envolé. L’approche vis-à-vis des infrastructures civiles a également évolué pour maximiser la destruction : des immeubles de grande hauteur et des bâtiments universitaires par exemple ont été désignés comme des cibles essentielles et visés en raison de la présence d’un objectif militaire légitime à un seul étage, mais détruits par un armement provoquant l’effondrement de l’édifice tout entier.
Au regard du droit international, cela pourrait être considéré comme une violation des principes de proportionnalité et de précaution. Mais cette proportionnalité et ces précautions, on le voit, permettent aussi de faire varier les classement en ajustant les justifications, sur la base de données singulières et spécifiques l’associant au Hamas avec une certaine probabilité. Tout l’enjeu consiste à fourbir des probabilités et les compléter de narratifs adaptés afin de produire des explications. La destruction des infrastructures civiles, quelle que soit la raison, est devenu l’objectif derrière les justifications : toutes les cibles détectées sont devenues un moyen pour raser Gaza.
L’IA : l’outil pour légitimer la guerre
Pour Ori Schwarz, « les systèmes d’IA ont épargné les dilemmes moraux en légitimant les attaques. Le rôle de l’IA a donc consisté à ériger le général en singulier, transformant presque tout en cible ». Pour Schwarz, avec la guerre à Gaza, l‘IA est devenue un outil de légitimation : l’automatisation permet le respect des procédures. Elle est un moyen pour « préserver les normes éthiques en les inscrivant dans le code, les transformant de règles réglementaires en règles génératives inviolables ».
Comme c’est le cas depuis longtemps, l’automatisation est censée garantir l’éthique. Mais ce n’est pas si vrai. D’abord parce que le système permet d’abaisser le seuil de confiance du ciblage et donc faire que la machine contourne la règle. Et surtout que l’opacité et la complexité du calcul permettent de faire disparaître ses défaillances et la surveillance par les opérateurs humains.
Le statut moral dépend désormais des procédures et non des résultats. Mais surtout, en validant les dommages collatéraux, l’IA a servi de mécanisme de légitimation des massacres de civils. Tactiquement, le rasage des zones urbaines avant les manœuvres terrestres permettait aussi de protéger les soldats israéliens. Enfin, le ciblage fournit un prétexte pour la destruction, une « couverture morale ».
Certains officiers souhaitaient que l’IA puisse générer elle-même les attaques depuis les scores produits. Cette proposition ne s’est pas encore concrétisée, mais les digues sont prêtes à lâcher, estime Schwarz. Notamment parce que les humains dans la boucle de la vérification ne servent déjà plus que d’agents d’enregistrement, chargés de validés les cibles en quelques secondes, sans avoir le temps d’examiner les données ni de comprendre les calculs qui les produisent. Pour Schwarz, si l’armée israélienne n’a pas franchi le pas, c’est notamment parce que le droit international humanitaire exige qu’un humain réponde de chaque décision. Mais plus encore, parce que garder un humain dans la boucle donne l’apparence d’une décision issue d’une délibération humaine.
C’est oublier que l’IA n’organise pas seulement la file d’attente des cibles, elle les désigne. Ce sur quoi les humains ont encore le contrôle reste surtout les critères pris en compte par les données et les seuils. Pour Schwarz, l’élaboration des cibles n’est pas un processus purement social, mais elle n’est pas non plus purement technologique. Le ciblage doit pouvoir être expliqué, contre-interprété. Les opérateurs ne font pas nécessairement confiance aux scores produits, tant qu’ils ne pensent pas les comprendre « et après l’avoir testé sur la durée, en constatant qu’il est cohérent avec le scénario qu’il a en tête » (même constat pour les radiologues confrontés aux résultats de l’IA). La validation d’une cible repose toujours sur une preuve, c’est à dire un récit. Et les analystes doivent souvent défendre leurs choix et validation, comme s’ils étaient face à un tribunal. Ils doivent défendre la cohérence des éléments qu’ils ont sous les yeux. Le risque à terme, suggère Schwarz, c’est que l’IA produise aussi les récits, quand bien même ils seraient aussi faux que les éléments cohérents que valident les humains. Un système d’IA pourrait identifier un lieu fréquenté par plusieurs militants et lui attribuer une priorité élevée, sans envisager qu’il puisse s’agir d’un restaurant, ou qu’une conversation interceptée évoquant le terrorisme provienne en réalité d’un film diffusé à la télévision. Les systèmes d’IA servent « à trouver des corrélations (…) entre toutes sortes de variables que vous ne jugiez pas intéressantes jusqu’alors (…) Évidemment, je présente aux analystes du renseignement une grande quantité de données et de corrélations en leur disant : « Regardez, c’est intéressant ». » Les analystes tentent ensuite d’ouvrir la « boîte noire » et d’élaborer un récit expliquant le fonctionnement du modèle et les raisons de son efficacité, une étape nécessaire pour que le modèle inspire confiance et soit mis en service. « Je leur montre des points de données très précis, [des variables prédictives] », explique un officier chargé de la formation des agents aux outils. Toutefois, il souligne que dans ces situations, les prédictions du système ne servent pas à désigner des cibles tant que les analystes n’ont pas ouvert la boîte noire et expliqué pourquoi ces variables spécifiques intégrées au modèle permettent de prédire les résultats. Pour Schwarz, ces débats contredisent la promesse épistémologique de l’IA – fondée sur un empirisme radical – selon laquelle la prédiction rendrait l’explication superflue, ou qu’il n’y aurait plus besoin de théorie.
Reste, rappelle Schwarz, que même si vous faites confiance à vos experts en science des données et que vous avez collecté et testé les données avec soin, vous ne pouvez pas juger de leur qualité. Vous devez expliquer le plus précisément possible ce que les variables indiquent et pourquoi le modèle prédit ce qu’il prédit. Par conséquent, l’analyste ne renoncera pas à comprendre la signification des corrélations et les raisons des choix du modèle. Les développeurs débattent souvent de la meilleure façon de représenter ces corrélations sans induire les utilisateurs en erreur. Si la classification algorithmique des individus comme cibles à forte probabilité est effectuée automatiquement, sans récit, les agents de renseignement en construisent, à la fois en amont, lors du développement du système, et ultérieurement, afin de conférer sens et légitimité aux recommandations algorithmiques (même si cette dernière dimension a pu s’éroder en raison de l’accélération de la production de cibles en temps de guerre).
Instaurer la confiance : camoufler l’IA
La confiance dans les chiffres n’est pas aussi omniprésente et automatique que la littérature pourrait le laisser croire. Dans notre cas, les utilisateurs finaux des systèmes de mégadonnées (analystes du renseignement) étaient initialement méfiants à l’égard de l’automatisation et des probabilités calculées algorithmiquement. Un développeur que Schwarz a interviewé leur a reproché de se méfier des systèmes d’IA en raison de leur « peur de l’erreur » et de leur prudence excessive (« Ils ont besoin d’un niveau de certitude non pas de 100 %, mais de 200 %, et une telle chose n’existe pas »). Face aux soupçons et à la nécessité de « faire confiance aux chiffres », les developpeurs du système ont entrepris un travail de sensibilisation et élaboré une stratégie sophistiquée : dissimuler le rôle de l’IA et insister sur l’implication humaine. « Les agents du renseignement n’utilisent pas l’IA, ils utilisent des outils conçus pour eux, et de leur point de vue (…), s’il y a de l’IA, d’après mon expérience, ils ne lui font pas confiance. En fait, pour les inciter à l’utiliser, nous n’avons pas dit “c’est de l’IA pure”, mais nous nous sommes assurés que l’agent qui examine une cible puisse voir que Sharon l’a déjà examinée, qu’il puisse voir le nom de la personne qui l’a fait, et qu’il connaisse Sharon. » Ils doivent savoir que Sharon est la meilleure pour identifier les cibles et, par conséquent, ils peuvent lui faire confiance. Dans cet exemple, ils ont tiré parti de la confiance que le personnel du renseignement accordait à une ancienne agente de renseignement très appréciée (« Sharon »), promue et mutée au sein de l’équipe technique. Elle y étiquette les données et valide les cibles générées par algorithme avant leur transmission aux services de renseignement et juridiques pour approbation. La confiance personnelle en Sharon peut faire toute la différence : « Nous avons constaté que lorsqu’une personne comme Sharon est présente, ils font confiance au système ; en revanche, lorsqu’on leur dit “ce n’est qu’un modèle”, ils n’y croient pas [et recommencent le processus manuellement depuis le début]. » Paradoxalement, la confiance dans l’IA (nécessaire à la délégation partielle du travail de renseignement aux algorithmes) exigeait la confiance envers les personnes qui faisaient confiance à l’IA, camouflant ainsi le rôle de cette dernière.
Nous savons que l’IA n’est pas une magie sans intervention humaine ; elle repose sur le travail humain, parfois dissimulé sous l’apparence de décisions de la machine, rappelle Schwarz en évoquant les travaux relatifs au Digital Labor. Or, ici, c’est l’inverse qui se produit : lors du développement des modèles, les décisions des machines doivent être expliquées par des experts humains qui en reconstituent la logique ; et plus tard, lorsque ces systèmes sont utilisés pour produire des cibles, leurs recommandations doivent être camouflées en décisions d’experts humains. Enfin, en temps de guerre, lorsque les analystes du renseignement consacrent à peine 20 secondes à approuver les recommandations de l’IA, le travail de cette dernière est une fois de plus dissimulé sous l’apparence de délibérations humaines.
C’est peut-être à cela que sert encore l’humain dans la boucle : valider les procédures humaines plus que juger du travail des systèmes d’IA.
En examinant de près l’utilisation de l’IA pendant la guerre de Gaza, l’article de Ori Schwarz montre que l’IA était nécessaire non pas pour personnaliser le traitement, mais pour justifier un traitement uniforme en créant des justifications personnalisées pour le ciblage de presque chaque bâtiment ou agent présumé du Hamas, et pour accélérer l’incrimination et la production de cibles à des niveaux sans précédent sans s’écarter complètement du cadre du droit international humanitaire, légitimant ainsi des massacres et des destructions de masse effroyables en s’appuyant sur des calculs et des procédures de probabilité prétendument objectifs, inscrits dans le code.
L’article de Schwarz, montre également que les études critiques sur les impacts sociaux des algorithmes doivent aller au-delà de la simple critique de leurs erreurs et de leurs biais. Ces derniers ont constitué jusqu’à présent le cœur des critiques, et ce pour une bonne raison : malgré leur prétention à la neutralité, les systèmes d’IA sont sujets aux erreurs en général et, en particulier, à la reproduction d’inégalités découlant de biais, dans la mesure où les données utilisées pour leur entraînement consignent et reflètent des préjugés humains. Plus précisément, les erreurs et les biais sont au centre des débats sur l’usage de l’IA dans la guerre, y compris lors du conflit à Gaza.
Mais, estime-t-il, un système d’IA parfait, sans erreur ni biais, «pourrait aboutir aux mêmes conséquences effroyables, simplement en accélérant considérablement la production de cibles et en en réduisant le coût » : le fait de cibler des dizaines de milliers d’objectifs identifiés par le renseignement – une tâche dont la réalisation était pratiquement impossible avant l’IA – conduit presque inévitablement à des destructions et à des tueries de civils à grande échelle. Pire, l’IA permet bien plus de produire des justifications, même de ses erreurs et errements, en les recouvrant d’une complexité et d’un vernis d’explication.
Si la destruction de Gaza répondait à des motivations politique, l’IA a été indispensable pour inscrire la destruction dans le cadre du droit international humanitaire (tout comme les ciblages sociaux s’inscrivent également dans le cadre du droit, malgré leurs défaillances manifestes). Ce potentiel de légitimation pourrait être exploité au-delà du contexte israélien, alors que des systèmes similaires sont adoptés par d’autres armées officiellement attachées au respect du droit humanitaire international. «Si l’accélération peut sembler relever d’un simple changement quantitatif, elle a en réalité engendré une transformation qualitative majeure. Le rôle joué par l’IA dans la légitimation de ces massacres nous rappelle que les caractéristiques et les affordances ne définissent pas les technologies de manière isolée : elles sont façonnées par les contextes juridiques, structurels, culturels et moraux, ainsi que par les réseaux ou dispositifs hétérogènes au sein desquels les technologies opèrent. Il est crucial de prendre en compte ce contexte pour comprendre comment il a pu engendrer des effets effroyables, mais aussi pourquoi il s’est avéré impossible d’éliminer l’humain de la boucle, et pourquoi le travail culturel de production de sens effectué par les humains était nécessaire pour légitimer l’automatisation partielle ayant conduit à cette accélération sans précédent de la production de cibles.»
*
La possibilité d’accéder à toutes les données disponibles bouleverse comme nulle autre le rapport des armées à leurs missions. Sans limites, ce sont les valeurs mêmes de leurs missions qui seront transformées. Et c’est ce que produit le score d’appartenance à l’ennemi et les seuils de dommages collatéraux autorisés. La guerre de demain se joue sur les données, leurs croisements sans limites et les seuils adaptables. Des éléments sur lesquels le droit international n’a pour l’instant pas défini de pratiques et qui, sans encadrement, risquent de permettre tous les glissements moraux du calcul, comme on le constate partout où le scoring se déploie.
Hubert Guillaud
MAJ du 31/08/2026 : Cet été, une source militaire a expliqué à plusieurs journaux, dont Le Monde, les pratiques de l’armée israélienne pour relier les civils tués ou blessés au Hamas, lors de frappes à Gaza. Cette incrimination rétrospective passe d’abord par des incriminations et des justifications mensongères, difficiles à debunker et des enquêtes jamais refermées. Les combattre nécessite pour les victimes d’apporter à leur tour des preuves d’exactions, qui ne sont pas toujours disponibles (d’autant que les journalistes ont du mal à accéder aux terrains d’opérations et que nombre d’entre eux, sur place, ont été tués). Les plaintes Gazouis sont rarement instruites par les autorités judiciaires israëliennes et l’information en Israël est très activement censurée (6 265 articles partiellement et 1 635 totalement en 2024, un record).
Les autorités internationales devraient surtout pouvoir avoir accès aux enregistrements des systèmes d’IA avant frappes pour mener des enquêtes sur la façon dont ils ont été utilisés.
C’est un texte anonyme. Parmi les rares liens qu’il propose, une référence aux arguments de l’EFF contre la vérification d’âge. Les images qui l’illustrent semblent faites à l’IA. Il est probable que le texte lui-même soit produit avec de l’IA. Reste que ses arguments marquent.
« Ils veulent votre visage. Ils appelleront cela « sécurité », « vérification » ou « confirmation de l’âge ». Un petit pas pour protéger les enfants, diront-ils. Mais si l’on écarte les beaux discours, l’exigence est
« Ils veulent votre visage. Ils appelleront cela « sécurité », « vérification » ou « confirmation de l’âge ». Un petit pas pour protéger les enfants, diront-ils. Mais si l’on écarte les beaux discours, l’exigence est claire : avant de pouvoir parler, publier ou lire, vous devez d’abord prouver qui vous êtes. Et la seule méthode qu’ils ont trouvée consiste à utiliser votre pièce d’identité officielle ou à placer votre visage face à une caméra qui décidera si vous êtes assez âgé pour mériter leur confiance. C’est le dispositif actuellement inscrit dans la loi sur trois continents, et l’on attend de vous que vous l’acceptiez sans broncher. Ne le faites pas.»
« Ils ne cherchent pas à connaître votre âge. Ils cartographient votre visage. (…) Il ne s’agit pas d’une vérification de l’âge. Il s’agit d’une vérification de l’identité. (…) Observez le glissement sémantique. Tout ce système a été présenté comme un moyen de confirmer l’âge — une simple question binaire : avez-vous plus de dix-huit ans ? Or, presque aucun de ces systèmes n’est conçu pour répondre uniquement à cette question. Ils sont conçus pour savoir qui vous êtes : votre nom, votre date de naissance, le numéro de votre document, votre visage. Ce n’est absolument pas une vérification de l’âge. C’est un suivi d’identité imposé. (…) Nous avons passé une génération à enseigner aux gens la règle d’or d’Internet : ne jamais divulguer sa véritable identité à des inconnus. Il existe un terme, le *doxxing*, pour désigner le fait d’exposer ainsi quelqu’un contre son gré. Et voilà que ces mêmes gouvernements et plateformes demandent à chaque citoyen de le faire lui-même, volontairement, comme condition pour se connecter. (…)
Un scan facial n’est pas une simple photographie. C’est une cartographie en trois dimensions de votre personne, un gabarit biométrique suffisamment précis pour être comparé ultérieurement aux images d’une caméra de surveillance au coin d’une rue. Une fois que vous l’avez transmis, il finit stocké sur le serveur d’un tiers — souvent un prestataire que vous n’avez pas choisi, que vous ne pouvez pas nommer et que vous ne pouvez pas tenir pour responsable. (…)
L’organisme vérificateur promet que vos documents sont supprimés dès qu’ils ont été contrôlés. Or, ils ne le sont pas toujours, et cette promesse ne vaut plus rien le jour où l’entreprise subit une intrusion. (…)
Pire encore, l’architecture conçue pour « protéger » les enfants peut finir par les mettre en danger. En regroupant les utilisateurs dans des enclos étiquetés par âge, non seulement on échoue à arrêter les prédateurs, mais on crée un véritable répertoire d’enfants, un annuaire permettant de les cibler directement. (…) Les enfants ne sont pas sauvés. Seule la surveillance demeure intacte.
(…) La base de données que vous aidez à constituer pour un gouvernement digne de confiance ne restera pas nécessairement entre des mains fiables. Les administrations changent. Un registre qui se contente de répertorier qui vous êtes aujourd’hui devient, sous un gouvernement futur, une carte indiquant qui traquer. Nous savons déjà que les agences fédérales américaines espionnent les citoyens à grande échelle : qui a participé à telle manifestation, qui a consulté tel forum, qui appartient à tel groupe. Les gens ont raison de craindre ce qu’un régime hostile pourrait faire d’une liste toute prête. Les données n’oublient rien et ne prennent pas parti ; elles attendent simplement de passer entre les mains de leur prochain détenteur. Internet tout entier finit par ressembler au bureau : tout le monde a trop peur pour dire autre chose que ce qui est politiquement correct, de peur qu’une opinion réelle associée à un nom réel ne leur coûte un emploi réel.
(…) L’objectif du refus n’est pas de convaincre une majorité avant d’agir, mais de priver le système de la coopération universelle dont il a besoin pour fonctionner. Vous n’avez pas besoin de gagner le sondage. Il suffit de ne pas télécharger votre photo. Ne leur donnez jamais votre visage.
(…) Si Starbucks vous demandait de scanner votre pièce d’identité pour l’intégrer à une base de données nationale en échange d’un latte, le feriez-vous ? Non, car vous accordez plus de prix à votre identité qu’à votre latte. N’accordez-vous pas plus de valeur à votre identité qu’à la possibilité de voir un cousin éloigné publier des opinions politiques répugnantes ou la photo du chien de quelqu’un ?
(…) En théorie, nous, simples internautes, pouvons stopper tout ce système en refusant d’y participer, en boycottant le processus. Imaginez un « Mois national du choix de l’identité », durant lequel personne n’utiliserait de plateforme exigeant votre visage, personne ne se connecterait, personne ne regarderait de publicités et personne ne financerait de projets sponsorisés. Les plateformes subiraient une chute massive de leurs revenus et feraient l’objet d’un intense lobbying pour faire abroger ces lois désastreuses. Nous en sommes capables. Le seul mot qu’ils ne peuvent pas contourner, c’est « non ».
(…) Ces systèmes reposent sur la soumission. Ils partent du principe que vous allez soupirer, télécharger votre photo et passer à autre chose. Tout leur modèle économique en dépend. C’est aussi là que réside leur faiblesse. Une barrière de vérification devant laquelle personne ne se présente est une barrière sans gardien.
(…) Alors, refusez. Refusez le scan. Refusez le téléchargement. Fermez les comptes qui l’exigent et expliquez-leur, par écrit, la raison exacte de votre départ. Les plateformes ont bien plus besoin de vous que vous n’avez besoin d’elles. Vous pouvez vivre sans le flux d’actualités, mais elles ne peuvent pas survivre sans la foule. Ne vous soumettez pas par anticipation. Le visage figurant sur votre pièce d’identité est ce que vous possédez de plus immuable. Ne leur livrez jamais votre visage »
PS : Sur son blog, Cory Doctorow déploie le même argumentaire : « Ce que l’on appelle vérification de l’âge s’apparente en réalité à une surveillance de masse, si intrusive et omniprésente qu’elle fait passer la surveillance commerciale du secteur de la publicité en ligne pour une sorte d’utopie pirate cypherpunk sur le darknet ».
« Cela dépasse la farce. Après tout, quels que soient les préjudices que l’Internet infligerait aux enfants — et il est indéniable que certains enfants souffrent de leur usage d’Internet —, tout commence par la surveillance. Vos enfants ne peuvent pas être ciblés par des algorithmes sans les données de surveillance utilisées pour les cibler. Ils ne peuvent pas être orientés vers des contenus faisant l’apologie de l’anorexie ou des forums d’une misogynie extrême sans que ce mécanisme d’orientation ne soit amorcé par l’espionnage commercial. Pourquoi les entreprises technologiques espionnent-elles vos enfants ? Pour la même raison que votre chien se lèche les testicules : parce qu’elles le peuvent, et que personne ne les en empêche. »
« Toute tentative de protéger les enfants contre les dangers du numérique devrait commencer par les préserver de la surveillance en ligne ; or, nous faisons exactement l’inverse aujourd’hui. Après avoir échoué pendant des décennies à adopter et faire respecter des mesures de protection de la vie privée sur Internet, ces mêmes gouvernements battent tous les records de vitesse pour faire adopter des lois de « vérification de l’âge » qui rendent la protection de la vie privée illégale. »
La surveillance en ligne nuit à tous, rappelle Doctorow. Elle sert à vous fourbir de la désinformation, vous refuser un prêt, un emploi, augmenter les prix que vous payez et réduire les salaires qu’on vous propose.« On ne peut pas protéger les enfants de la surveillance en ligne en les espionnant. »
[en]
I’m on the train to Paris. I’ll be coming back a week on Monday. It’s a comfortable, easy trip. The reason for my travel is I’m attending a two-day course on burnout – part of my training at the Gregory Bateson Institute. I’d planned on postponing this module until next year or the year after, given that my main priority now is building my working capacity back up following last year’s accident. But earlier this year, the whole curriculum was redesigned (it’s a good thing!), and the materi
I’m on the train to Paris. I’ll be coming back a week on Monday. It’s a comfortable, easy trip. The reason for my travel is I’m attending a two-day course on burnout – part of my training at the Gregory Bateson Institute. I’d planned on postponing this module until next year or the year after, given that my main priority now is building my working capacity back up following last year’s accident. But earlier this year, the whole curriculum was redesigned (it’s a good thing!), and the material on burnout will be incorporated into a longer module which is largely redundant with the courses I’ve already taken. So: now or never.
Following my relapse/brain crash earlier this year, I took the decision in March to pretty much clear out anything that was in my calendar. It was a tough decision, but it was the right one (people who have experience with chronic fatigue will know what I’m talking about). For those few plans I held on to, I « cleared the decks » around them to ensure they would not interfere with getting my work done, and that work would not jeopardise them. This means I took the whole week off for these two days of training, just like I took the whole week off a fortnight ago to go and see Mika live at the Caribana Festival. It worked.
In my pre-accident life, I might have travelled on Monday, attended the training on Tuesday and Wednesday, and travelled home Thursday. The « recovery » version of this is to add at least a day of padding in between training and travel, with nothing planned, so I can rest/stock up on « energy »/recover, and reduce the risk of (for example) travelling on a maxed out brain. I figured I might as well add on a few extra days (particularly as Oscar is not around anymore – something I’m really thankful for to be honest, with the awful heat wave that hit us over the last week), and catch up with a couple of people, if I’m in good enough shape.
This is my fourth « real trip » since my accident. I went to France twice for extended week-ends with family or friends last year. Each time was absolutely exhausting (but nice). Then after Christmas I went to spend some time at the chalet – first time I was going back since my accident – and we know what a disaster that turned out to be. This time, I think I’ve planned and organised things well enough and with a lot of caution.
As I was packing and preparing for departure yesterday, I realised I was really stressed out. More than usual. Packing and preparing to travel has always been stressful for me. It’s not the actual travel or being in a strange place or away from home. Or maybe just a little. What it is mainly is all the executive function acrobatics required in dealing with travel-related logistics:
making sure I do the things that need to be done before leaving
deciding what to bring with me (this is a huge one)
organising cat- and plant-sitting
inserting these « unusual activities » into my days at the right time, in the right order, and with enough time to carry them out
leaving wherever I’m at to go “somewhere else” – the transition itself.
Putting things in the suitcase is actually a part I like. It’s real-life Tetris: fun. Once I’ve locked the door behind me and am heading out with my luggage, I’m good. But before that, it’s complicated. I have got much better at dealing with it over the years, and with the clearer view on my executive function challenges that my ADHD diagnosis brought me a few years ago (and meds!) it’s even better.
I don’t have a very clear memory of how preparation for my two France trips went last year (only that I overpacked, a sign that making decisions regarding what to take or not was difficult, so in doubt, pack more). But I do know that packing for the chalet in December was a nightmare.
OK, I had already « crashed » during the previous week, but I’d taken rest to recover and felt functional enough to tackle it. And yes, it was also the first time back to the chalet since my accident, but I was really looking forward to heading back. I was aware there was maybe a little (normal) underlying apprehension that I might not be perceiving.
What apprehension I could feel was not about going to the chalet, but about the possibility of an unexpected emotional reaction to being there again. It was the same thing when I went back on the ski slopes: not scared of skiing, just worried I might have misjudged my readiness and have some kind of PTSD-like reaction to being back on my skis or where the accident took place. Nothing like that happened, by the way. Everything was fine.
This illustrates where most of my post-accident anxiety lies. I am normally pretty good, in general, in predicting how I’ll react, what will be challenging, what I can and can’t deal with. I know myself well, including my biases, and of course I know that when you expect something to do this way or that, it does have an influence on the outcome – I do my best to correct for that. Since my accident however, I have been blindsided by my brain more times than I can count. At times I feel like I do not know myself anymore, though of course I’m still me and very much feel me, but when it comes to “what I can take”, whether mentally, physically or emotionally, I’ve had a lot of bad surprises.
I am repeatedly finding myself in the situations where my brain does not deliver in the way I expect it to, and where I misjudge what I’m able to do. In my accident-recovery-life, the consequences of these prediction errors are swift: I crash. I don’t know if it hits everybody this hard, but for me in any case, it’s pretty traumatising to have my brain brutally and unexpectedly go on strike like that. Both the “brain not working” and the “didn’t see that coming” aspects are really scary.
So now, as time goes on and my recovery stretches out way longer than I initially imagined, as the clock of certain administrative deadlines regarding my return to full work capacity start audibly ticking, as I fail again and again to know my fluctuating limits, I can feel my underlying confidence in my abilities and self-awareness slowly erode, leaving place to self-doubt and increased anxiety about dealing with life and the world. It sucks: the anxiety is not crippling, it’s just a nuisance and an energy-drain at this stage, but I can see the process and the slope I’m on, and I do not like it one bit. Breathe. Relax. Deal with today. Be patient. Hang in there. Keep at it. Trust the recovery process. All this works, and I don’t feel in danger, but it’s more and more work to not let myself be dragged down.
Right. So there’s that. My trust in my ability to manage myself and deal with life is weaker than it was. So my baseline anxiety is higher, my executive function is struggling more, and I tire quickly. But as I was walking to my neighbourhood station to catch the local train a few hours ago, I understood that something else was probably coming into play in terms of post-accident travel and packing anxiety.
You see, my accident happened on the very day I travelled to the chalet for my holidays. I hadn’t been there for a while, I’d actually emptied the chalet of all my stuff and Oscar’s when I had last departed, so it was already an “increased stress” packing and travel operation. Nothing disastrous, still quite within the realm of ordinary, but not a walk in the park.
I got to the chalet (later than I had intended), got Oscar settled, dumped my unopened luggage in a corner and headed off immediately to get a couple of hours of skiing in on this first day. When I fell, I was heading back to unpack and enjoy the evening. I didn’t make it back: I spent the night at the hospital, in the haze and stress you can imagine, worried about my shoulder and my old diabetic cat who was alone at the chalet, trying to make decisions and organise logistics (How can I get back to the chalet? Should I go back to Lausanne? Who has a good shoulder specialist? Who can help me with my car as I can’t drive? That’s just the start of them). The next day a friend picked me up at the hospital and drove me back to the chalet, and another one came to help me empty the chalet and drive me back home. It was horribly stressful. I was in pain, I was freaked out, and instead of resting my concussed brain I was in full crisis management mode. It didn’t get better over the next two weeks.
I wouldn’t be surprised if my accident taking place just on the heels of travelling to the chalet didn’t add an extra layer of “negative association” to a transition that was never that easy for me to begin with.
Say you have a pet who always stressed out when heading to the vet’s. You do stuff to make it smoother: stay calm yourself, get your pet used to the carrier or the car, add treats, maybe a mild sedative, maintain usual routines as much as possible… It’s not great, but it’s not a disaster anymore, it’s manageable. And then, one fateful vet visit, something “bad” happens there. Not on purpose, of course. An exam that’s longer or more intrusive. A different vet. A loud noise at the wrong time. The pet freaks out, has a really bad experience.
Well, chances are that the next time you prepare to take your pet to the vet, it’s going to be more complicated.
That’s how I feel it’s playing out for me. I’m not actively scared of travelling or having an accident. But I’m clearly more stressed when preparing to travel, and some part of that could very well be the proximity of my accident to travel which has left a negative association. Not PTSD of course, but maybe on that continuum, probably closer to normal than pathological.
In 2019 I had a bad car accident (which resulted in surgery on my right wrist six months later). I was in a roundabout when a car entering it hit the back of my car right from the side. I didn’t see anything – there was a loud bang and choc and suddenly I was heading off the road right onto a big metal signpost solidly anchored in the ground. The car flattened it, ripped it out of the ground, and in turn it bent the car frame into a right angle. The car was totalled, we were lucky. I drove quickly afterwards with a rental, without issues. I’ve always liked driving and never been afraid at the wheel. But for months afterwards I felt a tiny surge of apprehension when going through roundabouts (it even still happens sometimes now when I’m on the precise spot of the accident). Nothing huge, but a clear signal – and this was on the backdrop of an activity (driving) that was very positive in terms of associations, compared to packing/traveling which was already fraught.
We’ll see how things play out over the next months and years. But I think I’ve put my finger on something that wasn’t on my radar. You know how sometimes you have an insight that just feels like it’s the missing piece? That’s what this feels like. In my experience, it’s often enough for me to just understand this kind of mechanism to defuse it. Like when I understood that a huge amount of my anxiety over Oscar’s impending death was the possible consequences this loss would have on my recovery timeline, given the post-accident uncharted territory I described higher up when it comes to my ability to “deal with life” in these times.
I typed this on my phone, with an external keyboard. Pretty comfortable I have to say, but not quite enough that I feel like adding links (there would be a good handful to add). I’d also like to say more regarding continuums between normal and pathological, and also on the somewhat related question of normality: when it comes to living beings, normal/average is a mathematical abstraction (or a bell curve), which should make us think real hard about how we frame certain realities (e.g. “neurodiversity”).
Anyway, I’m going to leave things there. I’m starting to feel a bit of motion-sickness and I feel just about ready for a nap in my comfy train seat.
The Project of AI is a world-building endeavor, wherein those who fund and develop AI systems both operate through and seek to sustain networks of power and wealth. Janet Vertesi, Alex Taylor, Ben Shestakofsky, and I teamed up to try to disentangle the technical systems we call “AI” from the political-economic project that is sustaining this effort. Today, at FAccT, Janet presented our new paper: “Reckoning with the Political Economy of AI: Avoiding Decoys in Pursuit of Accountability.” (also av
The Project of AI is a world-building endeavor, wherein those who fund and develop AI systems both operate through and seek to sustain networks of power and wealth. Janet Vertesi, Alex Taylor, Ben Shestakofsky, and I teamed up to try to disentangle the technical systems we call “AI” from the political-economic project that is sustaining this effort. Today, at FAccT, Janet presented our new paper: “Reckoning with the Political Economy of AI: Avoiding Decoys in Pursuit of Accountability.” (also available on arxiv). We do a few things in this paper that might be appealing. First, we try to map out how to understand AI, not as a set of technical artifacts, but the culmination of various economic and political forces, organizational logics, and interpersonal networks. (To anchor this, we draw on four distinct theoretical traditions, recognizable to scholars through Manuel Castells, Neil Fligstein, Donald Mackenzie, and Anna Tsing.) Then, we speak directly to scholars and practitioners interested in accountability and highlight how important it is to avoid “decoys” that distract our attention from the political economic agendas at play. Put most bluntly: we won’t create accountability by futzing with the technical affordances; we need to attend to the political and economic agendas.
If watching a video is more your jam, Janet presented a preview of this work at CITP Princeton a month ago and that video is now online.
While I’m not at FAccT (saaaad panda), I have been out and about. Ten days ago, I gave a talk at the Oxford Internet Institute to celebrate their 25th anniversary. Since I had given three co-authored paper talks at OII’s 10th (the ones that turned into Critical Questions for Big Data, It’s Just Drama, and Networked Privacy), I decided that it only made sense to give a 25th anniversary talk that wove together the past, present, and future of the internet that mixed together stories of social media, AI, and teenagers. “Dreaming of a Networked World” picks up themes from the FAccT paper, but the second half also includes new data from the Project Vibes team (led by Michele Ybarra) about teens’ attitudes towards AI. (Hint: it’s a doozy!)
It’s hard to believe that I’ve now been at Cornell for a year. It’s been an adventure! I taught three classes (Data & Society, Trust & Safety, and Theories to Think With). I have lots of irons in the oven, but I’m also now prepping for the launch of Data Are Made, Not Found. Book talks are confirmed in DC, Cambridge, Seattle, Boulder, and NYC. (Berkeley and Toronto are almost locked too.) I’m also talking with people about other cities. I can’t wait to share more. In the meantime, I would be ever so grateful if you could take the time to either pre-order the book or reserve a copy with your local library.
Dans une tribune pour le Guardian, la chercheuse suédoise, Charlotta Kronblad, professeure à l’université de Gothenburg, raconte comment elle a tenté de se battre contre un algorithme d’affectation. En 2020, la ville de Göteborg a déployé un algorithme pour attribuer des places dans les collèges et optimiser les distances, les préférences et les capacités d’accueil. Mais voilà, « des centaines d’enfants ont été affectés à des écoles situées à des kilomètres de chez eux – de l’autre côté de riviè
Dans une tribune pour le Guardian, la chercheuse suédoise, Charlotta Kronblad, professeure à l’université de Gothenburg, raconte comment elle a tenté de se battre contre un algorithme d’affectation. En 2020, la ville de Göteborg a déployé un algorithme pour attribuer des places dans les collèges et optimiser les distances, les préférences et les capacités d’accueil. Mais voilà, « des centaines d’enfants ont été affectés à des écoles situées à des kilomètres de chez eux – de l’autre côté de rivières et de fjords, par-delà de grands axes routiers, dans des quartiers qu’ils n’avaient jamais visités et auxquels ils n’avaient aucun lien. Les parents, incrédules, ont constaté ces décisions. Avait-on seulement vérifié si un enfant de 13 ans pouvait raisonnablement parcourir ce trajet à pied en hiver ? Quel était le raisonnement derrière ces décisions ? Leurs préférences exprimées avaient-elles tout simplement été ignorées ? Personne au sein de l’administration scolaire ne semblait capable – ni disposé – à expliquer ce qui s’était passé ni à corriger les erreurs.»
Le fils de Charlotta était parmi les enfants désavantagés par l’algorithme. L’administration scolaire a indiqué que les parents pouvaient faire appel en cas de problème, comme si le problème n’était qu’une question d’insatisfaction individuelle et non pas un dysfonctionnement du système. Il a fallu près d’un an avant que les responsables municipaux ne confirment ce que beaucoup de parents soupçonnaient : « l’algorithme avait reçu des instructions erronées. Il calculait les distances à vol d’oiseau, et non celles des trajets piétonniers réels. »
Suite au tollé des familles, les procédures ont été améliorées pour l’année scolaire suivante. Mais pour environ 700 enfants déjà pénalisés par l’algorithme défectueux, rien n’a changé. Ils allaient passer toute leur scolarité au collège dans des établissements loin de chez eux.
L’injustice algorithmique qui en résulte n’est pas un problème abstrait, ni un problème propre au contexte suédois ; elle fait douloureusement écho à de récents scandales en Europe. Que ce soit celui de la Poste au Royaume-Uni ou celui des allocations familiales aux Pays-Bas, rappelle la chercheuse. Charlotta Kronblad a donc intenté un procès à la ville. Elle n’a pas contesté le placement individuel de son fils, mais la légalité de l’ensemble du système décisionnel et de ses résultats. « J’ai soutenu que la conception de l’algorithme violait la législation en vigueur.»
Faute d’accès aux algorithmes du système, elle n’a pu les présenter au tribunal. Elle a fourni une analyse des affectations problématiques pour reconstituer son fonctionnement… Les services de la ville, eux, ont estimé que le système n’était qu’un simple outil d’aide à la décision qui n’a commis aucune faute, sans en fournir la moindre explication.
« Ils n’ont pas eu à le faire. Le tribunal a fait peser la charge de la preuve sur moi. Il était de ma responsabilité, ont déclaré les juges, de démontrer que le système était illégal. L’analyse des décisions ne suffisait pas. Sans preuve directe du code, je ne pouvais pas atteindre le seuil de preuve requis. » Et sans communication du code, il était impossible de rien prouver. « L’affaire a été classée sans suite. »
Nous savons que les algorithmes ne sont pas parfaits. C’est la raison d’être des tribunaux : contraindre à la divulgation, examiner et corriger. « Mais lorsque les cadres procéduraux restent obstinément analogiques et que les juges n’ont ni les outils, ni la compétence, ni le mandat pour interroger les systèmes algorithmiques, l’injustice triomphe. » Alors que nos autorités publiques déploient à grande échelle des systèmes opaques, les citoyens, confrontés à des conséquences bouleversantes, sont invités à faire appel individuellement.
La charge de la preuve ne peut pas reposer sur les victimes, rappelle la chercheuse. Nous devons élaborer des règles de procédure permettant des recours qui ne soient pas individuels et qui exigent la transparence technique.
Lila Shroff s’inquiète. A raison. ChatGPT Images 2.0 qui vient de sortir permet de créer des visuels photoréalistes nettement plus convaincants que ceux produits par ses prédécesseurs. Elle l’a utilisé pour créer une image de Trump en train de donner des conseils de maquillage comme une capture d’écran de TikTok. Amusant. « Mais les deepfakes les plus réalistes que j’ai pu créer n’impliquaient ni politiciens ni célébrités. La plupart ne représentaient même pas de personnes. Sans trop d’efforts,
Lila Shroff s’inquiète. A raison. ChatGPT Images 2.0 qui vient de sortir permet de créer des visuels photoréalistes nettement plus convaincants que ceux produits par ses prédécesseurs. Elle l’a utilisé pour créer une image de Trump en train de donner des conseils de maquillage comme une capture d’écran de TikTok. Amusant. « Mais les deepfakes les plus réalistes que j’ai pu créer n’impliquaient ni politiciens ni célébrités. La plupart ne représentaient même pas de personnes. Sans trop d’efforts, j’ai pu créer plus de 100 images falsifiées, notamment des ordonnances d’opioïdes et de médicaments contre le TDAH, des alertes bancaires, des publications sur les réseaux sociaux, de fausses images de cartes d’identité et de passeports », de faux documents financiers (factures, reçus et déclarations fiscales), fausses captures d’écran (pour falsifier une confirmation de virement bancaire), fausses notes de frais, fausse capture d’écran d’un site de presse… Les modèles d’images ont longtemps peiné à produire des images intégrant du texte. Ce n’est plus du tout le cas avec cette version ci. Bien sûr, en y regardant de plus près, tous ces faux ne sont pas encore parfaits. Dans son dernier rapport annuel sur la cybercriminalité, le FBI a inclus une section sur les escroqueries à l’IA, qui auraient coûté près d’un milliard de dollars aux Américains l’an dernier.
Fake, ça accélère
« En théorie, je n’aurais pas dû être capable de créer la plupart de ces images. OpenAI interdit l’utilisation de sa technologie à des fins de fraude ou d’escroquerie » … mais souhaite laisser une liberté créative totale à ses utilisateurs. De la à permettre de reproduire des logos de banque ou des documents officiels… Même constats chez Google dont les IA permettent également de générer ce genre de faux. Les entreprises d’IA se défendent en estimant que les images générées le sont avec des filigranes comme SynthID ou des métadonnées, mais encore faut-il que les gens aient des outils pour analyser les images qu’ils voient. « Malgré la fragmentation de notre écosystème médiatique, une simple recherche Google suffit généralement à vérifier si ces images sont fausses. Ce sont les deepfakes ciblés et omniprésents – ceux qui escroquent vos proches plutôt que de simplement perturber les réseaux sociaux – qui sont peut-être les plus inquiétants. » Et pour lesquels les mesures de protection s’annoncent encore très perfectibles.
Pour le New York Times, Stuart Thompson a testé les détecteurs d’IA. Plus d’une douzaine d’outils en ligne affirment pouvoir faire la différence entre le vrai et le faux en recherchant des filigranes cachés, des erreurs de composition et d’autres indices numériques. « Les résultats suggèrent que ces détecteurs peuvent aider à confirmer les soupçons concernant les contenus générés par l’IA, mais il est difficile de s’y fier pour établir un diagnostic définitif. » Thompson réalise plusieurs tests ne produisant pas toujours des résultats adaptés auprès d’une galerie d’outils comme Hive Detect, Resemble.ai, AI or Not, Reality Defender, Copyleaks, BrandWell, Sensity, Sightengine et les grands outils d’IA qui ont tous intégré ces fonctions, de Gemini à Claude, ChatGPT ou SuperGrok.
Le NYTimes a fait passer des tests à tout ces outils. « Nombre d’entre eux ont pu détecter les contrefaçons les plus simples ». Parfois, certains outils ne parviennent même pas à détecter les images qu’ils ont eux-mêmes créé. Les propriétaires de ces outils estiment néanmoins que les mises à jour de ceux-ci seront plus efficaces qu’ils ne sont, sans parvenir à la perfection. La détection de vidéo est plus difficile que celle des images et les résultats de ces outils sont tous moins bons, mais semblent plus performants pour détecter les sons générés. Ils réussissent mieux à détecter comme réels des images et vidéos réels, par contre les images réelles modifiées demeurent les plus difficiles à détecter… tant pour les outils que pour les humains.
Deepfakes : pourquoi ça marche ?
Dans sa newsletter, Rob Horning tente de comprendre pourquoi les images génératives rencontrent un tel succès. Par rapport aux images réelles, « les versions générées par l’IA sont souvent plus spectaculaires, plus cinématographiques et optimisées pour générer des clics sur les réseaux sociaux ». Toutes les images ne sont pas propagandistes, rappelle le philosophe, elles sont surtout « opportunistes ». Elles visent à produire du contenu. C’est une propagande pour l’information elle-même, qui soutient l’idée que « toute information peut et doit être vécue comme un divertissement ». « Elles encouragent plutôt une approche post-narrative où l’appréciation des mèmes ne dépend plus de la compréhension des enjeux globaux ni de la recherche de contexte ». « Les spectateurs sont pris en étau entre deux systèmes algorithmiques : l’un génère le contenu et l’autre nous le présente, notre attention étant captée pour les entraîner à converger.»
Ces images et vidéos cherchent plus à être émotionnellement compréhensibles qu’à être authentiques. Le contenu ne fait que nourrir et renforcer notre soif de spectacle. « La confusion entre preuves et contenu dans les flux d’information a engendré une confusion entre les deux. Les éléments présentés comme des preuves deviennent un alibi pour le spectacle ; ils imitent la vérifiabilité tout en nous incitant à nier tout besoin de vérification. » Mais, s’inquiète Horning, « ces contenus renforcent également l’idée qu’il est plus amusant d’être dupé que d’être informé, et que l’indifférence à la vérité procure des récompenses émotionnelles immédiates ». Ils nous disent autre chose encore de notre monde, souligne-t-il. Ces contenus de piètre qualité alimentent l’idée que tout devrait être visible, surtout dans un monde aussi saturé de surveillance que le nôtre. A l’heure où tout est accessible, nous avons l’impression que tout est désormais visible, comme quand le journalisme lui-même utilise la reconstitution fictive pour nous montrer ce qui n’a pas été enregistré. Il existe de fausses images sur tout ce qui peut susciter des réactions. Et ces images et vidéos permettent de montrer ce qu’il se passe réellement, sans que ce soit réel. « Ces vidéos ne fournissent pas d’informations factuelles, mais une idéologie, nous épargnant ainsi l’effort de la réflexion. »
Si ces fausses images prolifèrent, c’est parce qu’elles offrent des illustrations claires de problèmes perçus comme réels, explique la chercheuse Claire Wilmotsur son blog pour la London Review of Books, qui montre que les deepfakes racistes offrent à ceux qui les utilisent la confirmation de leurs diagnostics. Les gens qui les partagent savent très bien que ces images sont fausses, mais elles permettent de montrer ce que ces gens pensent qu’il se passe réellement. « Ces vidéos répondent au désir du public de voir ses croyances se manifester sous forme de preuves et de consommer ce qu’il croit déjà comme si cela était irréfutablement établi par des événements réels. Elles nous offrent des explications simplistes, nous dispensant ainsi de tout effort de réflexion ou de toute responsabilité. Ces types de vidéos et d’images nous permettent de vivre ces croyances comme un contenu sans avoir à y croire « réellement ». Elles apparaissent simplement sous nos yeux pour nous rassurer. Ces contenus s’auto-valident pour leur public car ils présentent une idée qu’il tient déjà pour acquise. »
« Le flux constant de ces contenus normalise l’idée que l’information sera immédiatement remaniée pour nous satisfaire, et que nous pouvons compter sur nos flux d’actualités pour moduler nos émotions et nous apporter une forme de clarté, voire de soulagement. » Les fausses images permettent finalement de neutraliser le flux des images réelles qui sont peu commodes à comprendre. Elles apaisent l’anxiété de l’actualité en permettant de mieux la maîtriser, de la rendre plus lisible qu’elle n’est, plus conforme à ce qu’elle devrait être ou ce qu’on voudrait qu’elle soit.
« Le caractère facilement rejetable de ces images obséquieuses fait partie de leur attrait ; il rend la tromperie apparente et contenue, grâce à l’incrédulité délibérément suspendue du spectateur. La désinformation nous flatte en nous laissant entrevoir la supercherie tout en savourant la vision du monde qu’elle propose. Elle offre un discours facile à suivre, qui procure un sentiment constant de réussite, de reconnaissance, d’obtention sans effort. Elle flatte comme un chatbot obséquieux. Son mal ne réside pas dans le fait de nous persuader de choses fausses, mais dans l’érosion du sens des responsabilités collectives face à l’information partagée. » C’est un peu comme si ces images permettaient d’enlever de l’actualité sa complexité. « C’est le message sous-jacent de tout contenu : nous devrions pouvoir voir ce que nous voulons croire sans avoir à investir d’efforts pour construire cette réalité. »
Horning pointe un autre effet de la désinformation partagée : celle de nous isoler finalement. « Au lieu de rechercher l’information en reconnaissant notre ignorance nous ingérons des quantités massives d’informations simulées et de propagande maladroite qui nous donne l’illusion d’être imbus de nous-mêmes. Si le devoir civique, en tant que raison de s’informer, s’est atrophié, la diffusion de désinformation vise à l’anéantir complètement. »
L’industrie médiatique a subordonné la vérité au spectacle, éliminant les points de vue marginalisés et les voix divergentes. Or, ce que nous voyons, entendons, lisons… ne devrait jamais suffire à dicter nos croyances, rappelle Horning. La « crise de la vérité » ne provient pas d’un nouveau pouvoir des médias de nous tromper, « mais de la conviction que la simple consommation de médias suffit à nous faire vivre dans le monde réel ». Or, « aucune image ne peut nous conférer un rapport privilégié à la vérité, une conscience automatique de la réalité objective, une empathie accrue ou un sens moral plus sûr. Aucun média ne peut nous affranchir de la médiation. S’engager avec les médias ne signifie pas « surveiller la situation » ; cela implique de participer à la guerre de la propagande, et non de se complaire dans la médiocrité ».
Nous sommes de plus en plus soumis à une pure consommation d’information. Et en cela, les fausses images nous invitent à rester dans une pure consommation, en n’ayant plus qu’à circuler parmi elles, en naviguant parmi celles qui nous complaisent le mieux. Or, consommer l’information ne suffit pas, rappelle Horning. Les militants du Minnesota, face à l’ICE, ont montré l’importance à documenter ensemble, les pratiques de la milice, pas seulement en invitant les gens à regarder leurs vidéos, mais à les produire collectivement, en filmant la réalité des exactions de l’ICE sous tous les angles possibles, à témoigner. Une pratique qui devient plus forte à mesure que plus de gens y participent. Une pratique qui produit de la solidarité et qui participe à la production d’une réalité partagée. Tout l’inverse de la production politique traditionnelle qui amplifie de plus en plus les pires outrages, les pires dénis, les pires mensonges. Trump est assurément le pire menteur et affabulateur de tous les temps, et pourtant, il reste perçu comme plus honnête et plus authentique que ses adversaires, se désole la journaliste Zoe Williams dans The Guardian. Le risque est bien que les images génératives empruntent le même chemin : qu’elles semblent honnêtes et plus authentiques que la réalité.
Hubert Guillaud
Cet édito a été originellement publié pour la lettre d’information Café IA du 13 mai 2026.
MAJ du 25/06/2026 : En janvier, dans la Technology Review, le journaliste James O’Donnell avait révélé que le Département américain de la Sécurité intérieure, qui gère les services d’immigration, utilisait des générateurs vidéo IA de Google et d’Adobe pour créer du contenu destiné au public. Si certains commentateurs n’étaient pas surpris (le président Trump lui-même étant coutumier du fait), de nombreux autres justifiaient la pratique en estimant qu’il fallait combattre la désinformation par de la désinformation. Au grand damne du journaliste qui, dans un autre article où il raconte les conséquences, constate que l’enjeu n’est plus la vérité. Et le journaliste de pointer vers un article de recherche de la revue Communications Psychology de Nature. Dans cette étude, les participants ont visionné une « confession » truquée et les chercheurs ont constaté que même lorsqu’on leur disait explicitement que la preuve était fausse, les participants s’y fiaient pour juger de la culpabilité d’un individu. « Autrement dit, même lorsque les gens apprennent que le contenu qu’ils consultent est entièrement faux, ils restent influencés émotionnellement par celui-ci ». Nous avons réagi à la crise de la vérité en nous préparant à un monde où le principal danger serait la confusion, conclu O’Donnell. « Or, nous entrons dans un monde où l’influence survit à la révélation, où le doute est facilement instrumentalisé et où établir la vérité ne permet pas de repartir à zéro. Et les défenseurs de la vérité sont déjà largement distancés. » Face à la submersion par le faux, même rétablir la vérité ne semble plus avoir d’effets.
MAJ du 25/06/2026 : Il reste des éléments qui permettent encore de distinguer les images réelles des images générées, estime Hany Farid, pionnier de la criminalistique numérique, qui à la tête de l’entreprise GetReal Security, est l’un des plus grands experts mondiaux en matière de détection de manipulation de photos et de vidéos. Dans Science, il explique que les images génératives peinent à reproduire fidèlement les lois de la physique. Même constat pour Darren Linvill, codirecteur du Media Forensics Hub de l’université de Clemson : les images génératives sont plus saisissantes que la réalité. « En termes de contenu à partager et à regarder, une grande partie du contenu généré par l’IA surpasse la réalité », explique-t-il. Les explosions sont plus impressionnantes, le point de fuite des perspective n’est pas unique, les différences d’éclairages perceptibles… Farid cherche surtout les traces laissées par certains types de manipulation, notamment en analysant les pixels des images. « L’IA générative ignore tout de la physique et de la géométrie ». Pour vérifier les images, Hany Farid contrôle souvent si la géométrie de la scène est réaliste. Il a développé également un logiciel de lecture labiale automatique capable de repérer quand les mouvements de la bouche ne correspondent pas pas aux paroles… Mais reconnait-il, ces problèmes évoluent vite et les systèmes s’améliorant, la détection est de plus en plus difficile. « Le monde réel est incroyablement complexe à simuler, et les entreprises d’IA n’ont guère intérêt à pousser leurs modèles aussi loin. Après tout, leur objectif n’est pas de tromper les experts en criminalistique numérique comme Farid, mais simplement l’utilisateur lambda, un critère bien moins exigeant. « Le système visuel tolère toutes sortes d’absurdités sur les photos, car il n’y prête pas attention », explique-t-il. » Un de ses étudiants, Lyu, a développé deepfake-o-meter un système pour estimer la crédibilité des images. Mais un des principaux problèmes est que ces détecteurs fonctionnent mal avec des contenus très différents de leurs données d’entraînement. « Il n’existe pas de détecteur d’apprentissage automatique unique permettant aux utilisateurs de télécharger tous types de vidéos, photos, fichiers audio et d’obtenir une réponse fiable. »
Bien sûr, même l’enquête la plus approfondie et la plus rigoureuse ne convaincra pas toujours les sceptiques. Farid l’a appris à ses dépens en 2009, lorsqu’il a analysé une photo de 1963 montrant Lee Harvey Oswald tenant le fusil qu’il utiliserait plus tard pour assassiner le président John F. Kennedy. Les théoriciens du complot – et Oswald lui-même – affirmaient depuis longtemps que la photo était truquée, pointant du doigt des détails inhabituels comme les ombres sur le visage d’Oswald. Mais l’analyse de Farid n’a rien révélé d’anormal. Cela ne l’a pas empêché d’être accusé d’être partie prenante dans la dissimulation de la vérité !
Farid a également participé du développement de PhotoDNA qui repère les contenus pédopornographiques en ligne (voir notre article sur la modération automatisée depuis le livre de Tarleton Gillespie de 2019, Custodians of the internet, Yale, 2018). Développé en 2009 en collaboration avec Microsoft, cet outil analyse les contenus mis en ligne sur Google, Facebook, Reddit et d’autres plateformes, en comparant les fichiers à une base de données de contenus pédopornographiques connus. Le Centre canadien de protection de l’enfance (C3P) utilise ce logiciel dans le cadre du Projet Arachnide qui explore activement l’internet à la recherche de correspondances.
Mais Farid reconnaît qu’il est désormais submergé par le flot : au début de sa carrière, il recevait une ou deux demandes de vérification par mois, se souvient-il. Puis, chaque semaine. « Maintenant, c’est tous les jours. Sans blague, chaque matin, je me réveille avec une dizaine de courriels de journalistes du monde entier. »
Il est possible que quelqu’un parvienne à créer un faux document indétectable, explique-t-il. Mais son objectif est de rendre la tâche si difficile qu’elle reste hors de portée de la grande majorité des personnes mal intentionnées. « Chaque fois que je quitte ma maison, je verrouille ma porte d’entrée », explique Farid. « Cela empêche 99,99 % des gens de s’introduire chez moi, mais pas un serrurier. »
Le journaliste économique de Mediapart, Romaric Godin, estime que les appels à la régulation de l’IA ne proposent rien. « Ces textes sont tous sur une ligne de crête : ils refusent de rejeter l’IA, et ce refus est lié à la volonté de ne pas s’opposer au « progrès scientifique ». Il faut donc accepter les évolutions technologiques tout en cherchant à s’en prémunir. »
En fait, ces appels à la régulation estiment que les technologies sont neutres, qu’elles ne seraient que les produits de la sci
Le journaliste économique de Mediapart, Romaric Godin, estime que les appels à la régulation de l’IA ne proposent rien. « Ces textes sont tous sur une ligne de crête : ils refusent de rejeter l’IA, et ce refus est lié à la volonté de ne pas s’opposer au « progrès scientifique ». Il faut donc accepter les évolutions technologiques tout en cherchant à s’en prémunir. »
En fait, ces appels à la régulation estiment que les technologies sont neutres, qu’elles ne seraient que les produits de la science. Mais c’est oublier que la technologie n’est pas neutre et qu’elle n’est pas qu’une simple réalisation de la science, « c’est une utilisation de la science pour un but social donné ». L’IA vient d’abord répondre non pas à un besoin de la société, mais à un besoin du capital : « celui d’une nouvelle vague d’automatisation du travail afin de relancer le taux de profit ». La logique de la régulation vise alors à nous faire croire que l’IA aurait une utilité autre que celle du capital qui la déploie. Or, rappelle Godin : « ce pour quoi elle a été développée et financée, c’est de permettre un rebond des gains de productivité, notamment par l’automatisation des services et par l’accélération de l’automatisation de l’industrie. » La capacité de l’organisation économique à générer des gains de productivité est pourtant plus affaiblie que jamais. « Comme l’avait déjà perçu en 2015 l’économiste Robert Gordon, le coût en matière d’innovation est désormais considérable pour faire remonter le taux de productivité. Le gigantisme de l’IA et des financements qu’elle mobilise traduit précisément cette situation. Ce gigantisme s’accompagne donc d’une rentabilité fantôme mais qui reste le but du secteur. »« C’est sans doute l’angle mort de ces demandes de régulation : l’IA est un besoin du capital, et pour satisfaire ce besoin, la fuite en avant technologique n’est pas une « dérive » ou un « effet indésirable » que l’on pourrait contrôler, c’est une nécessité centrale. »
« Qui peut réguler ? Celui qui déciderait de freiner le développement technique et financier de l’IA perdrait immédiatement toute pertinence sur le marché, il serait balayé par ses concurrents. Et comme, par ailleurs, l’IA est loin d’avoir atteint son but, une régulation venant de l’ensemble du secteur est impossible : les financements engagés ne peuvent espérer devenir rentables que si la fuite en avant se poursuit. C’est aussi pour cette raison que les cauchemars apocalyptiques de l’IA sont alimentés par les acteurs eux-mêmes. Il est indispensable de continuer à donner envie aux investisseurs de financer l’IA et il faut donc maintenir la « hype », la frénésie.» Les Etats ne sont pas de meilleurs régulateurs non plus. D’abord parce qu’ils « sont en voie de fusion et de confusion avec le capital privé, précisément parce qu’ils sont dépendants pour leurs financements de la production générale de valeur de l’économie ». Ensuite parce qu’ils sont tous en soutien de la course à l’IA. « Tous tentent d’attirer les investissements de l’IA sur leurs sols. Tous s’efforcent « d’adapter » leur population à cette technologie et de la convaincre que son usage est indispensable ». « La volonté régulatrice se berce encore d’une illusion dangereuse, selon laquelle la croissance pourrait continuer à assurer le bonheur.»
« En voyant l’IA comme un progrès humain alors qu’il n’est qu’un progrès du capital, on refuse de voir l’essentiel : le prix de la production de richesse capitaliste est désormais celui de la destruction. Et on ne régule pas la destruction, on la combat.»
Dans son livre, Le problème à trois corps du capitalisme (La découverte, 2026), Romaric Godin, expliquait déjà que l’IA est une technologie « conçue pour préserver le capitalisme ». Il déployait en avril la même idée dans deux articles pour Mediapart, expliquant combien le gigantisme des investissements promettait des gains de productivité que l’économie ne peut plus assurer. L’automatisation est l’ultime promesse pour assurer la poursuite de l’accumulation par une prédation totale et sans limite qui vise à continuer le capitalisme pour lui seul, avec une innovation, un progrès, qui ne propose ni une amélioration de la science ni une amélioration de la société, mais seulement la poursuite du profit.
Dans un texte critique riche, ample et pertinent, le sociologue Dominique Boullier, ancien coordonnateur scientifique du Médialab de Sciences Po, revient sur les enjeux de l’IA générative. L’auteur de Propagations. Un nouveau paradigme pour les sciences sociales (Armand Colin, 2023) et de Déshumanités numériques (Armand Colin, 2025) ne mâche pas ses mots pour décrire comment l’IA transforme notre rapport au monde. Tribune.
On croit encore souvent que la meilleure innovation gagne toujours.
Dans un texte critique riche, ample et pertinent, le sociologue Dominique Boullier, ancien coordonnateur scientifique du Médialab de Sciences Po, revient sur les enjeux de l’IA générative. L’auteur de Propagations. Un nouveau paradigme pour les sciences sociales (Armand Colin, 2023) et de Déshumanités numériques (Armand Colin, 2025) ne mâche pas ses mots pour décrire comment l’IA transforme notre rapport au monde. Tribune.
On croit encore souvent que la meilleure innovation gagne toujours. Dans de nombreux cas comme dans celui des LLM, c’est le contraire : la pire des IA est en train de gagner au point de s’imposer comme monopole radical au sens d’Illich. Monopole radical pour la classe vectorialiste dans la génération de code avec l’apparition de Claude Code, monopole radical pour le grand public dans les interactions à travers la diffusion des IA compagnons. Entre les deux, les usages professionnels restent toujours aussi incertains et ne fonctionnent qu’à la condition d’y injecter suffisamment de sémantique et de contrôle expert pour éviter des catastrophes industrielles.
Reconnaissons-le : toute expérience ordinaire d’interaction avec une IA générative se révèle toujours impressionnante et, lorsque les compétences augmentent, des outils encore plus bluffants sont désormais à disposition, comme l’ont expérimenté tous les utilisateurs de Open Claw, agrégateur d’agents. Et pourtant, dès que l’on veut réellement prendre en main ces outils, contrôler leurs opérations, les vérifier ou valider leurs résultats, les mêmes utilisateurs se retrouvent déçus, inquiets voire en colère, à moins d’adopter une tolérance inusitée dans l’univers des produits et services de ce type. [Précisons d’emblée que je n’évoquerai pas ici les éventuelles craintes à propos d’un futur d’IA générale souvent fantasmé mais seulement les constats issus des pratiques ordinaires.]
Ni science, ni industrie, ni éthique mais de l’ingénierie, de la finance et du buzz
Je résumerais cette ambivalence de cette façon, en termes d’éthos ou de posture : si l’on possède une culture, des principes et exigences à la fois scientifiques, industrielles et éthiques, on ne peut qu’être inquiet de voir l’emballement en faveur de ces IA fondées sur les LLM. A l’inverse, si l’on est fasciné par l’ingénierie, les performances financières et si l’on vit dans le monde du buzz permanent, l’IA produit une excitation inédite et sans cesse renouvelée malgré ou à cause des incertitudes qu’elle emporte avec elle.
Et l’on peut systématiser cette opposition terme à terme : science vs ingénierie, industrie vs finance, éthique vs buzz pour mesurer à quel point nous sommes en train de bifurquer, collectivement certes mais sous la houlette de quelques très grandes plateformes technologiques. L’époque moderne s’est caractérisée par la puissance d’une alliance entre science et industrie en y ajoutant depuis la seconde guerre mondiale, un contrôle moral progressif des finalités et des méthodes (la révision écologique principalement). Mais les LLM sortent totalement de cette trajectoire au profit d’un saut postmoderne radical fondé sur leur ingénierie toute-puissante, leur attractivité financière sans limites et leur capacité à générer du buzz, de l’alerte et de l’incertitude permanente.
On pourrait pourtant parier avec Yann Le Cun que ces LLM sont des impasses conceptuelles. On pourrait aussi considérer avec la plupart des grandes entreprises industrielles que les LLM n’offrent pas de fiabilité suffisante, ce qui explique leur adoption très réservée dans les process critiques notamment. On pourrait aussi soutenir avec quelques fondateurs du deep learning (Hinton, Bengio) que l’on risque trop de perdre le contrôle pour laisser se développer une telle technologie. Et pourtant, malgré toutes ces réserves, que je vais documenter et soutenir, ce sont bien ces LLM qui sont en train de former l’architecture technique d’un nouveau mode de production.
Quand les pires technologies sont pourtant les gagnantes
Car, rappelons-le , après des décennies de travaux sur les dynamiques de l’innovation, il est rare que la meilleure technologie gagne. Songeons au clavier Qwerty, cette machine de guerre ergonomique, encore présente dans nos PC, et même sur des smartphones tactiles. 150 ans de résistance à toute transformation malgré les tentatives nombreuses (cf. Dvorak) pour améliorer un système aussi nocif pour les muscles et aussi coûteux à apprendre. Sur ce plan d’ailleurs, les interfaces conversationnelles sont à elles seules une révolution durable qui va modifier la relation ordinaire à la technologie des systèmes d’information, plus encore que ne l’avait fait le Wysiwyg de la fin des années 70 qui a permis le Personal Computer.
De même, la domination de Windows sur tous les systèmes d’exploitation des PC (72% du marché) est le contre-exemple type opposable à l’argument selon lequel « le meilleur gagne ». Tout le monde le reconnaît, Windows a copié Apple (lui-même issu de Xerox) pour l’apparence de son interface, tout en reposant sur son système d’exploitation MS-DOS catastrophique en matière de fiabilité, de sécurité et de performances. Et pourtant, Microsoft l’a imposé au monde entier, grâce à des patchs successifs mais surtout grâce un marketing devenu un cas de figure canonique du « lock-in » (Shapiro et Varian), ce verrouillage d’une clientèle dans un système total. Dans le même temps, Linux (1991) est devenu incontournable pour tous les systèmes techniques critiques ou pour ceux qui exigent une véritable fiabilité mais c’est seulement en 2026 que le gouvernement français fait le choix d’abandonner Windows pour Linux pour les postes de travail de l’administration.
Un processus analogue se déroule ainsi sous nos yeux qui voit une innovation très approximative gagner des parts de marché et créer des habitudes d’usage quasi irréversibles. Les critiques pleuvent sur les systèmes d’IA génératives, sur leurs hallucinations d’abord, sur leurs consommations d’énergie ensuite, sur la collecte de leurs sources, sur leurs principes formels même, et cela sans parler des pratiques de certaines des firmes que j’ai qualifiées ailleurs de voyous (Open AI et X/ Grok) (Boullier, 3 février 2026 , AOC). Mais rien n’y fait, l’IA pénètre dans tous les interstices de la vie ordinaire plus vite que dans la vie professionnelle même, grâce à cette innovation horizontale, imitative, sans barrière d’accès (dont la gratuité, qui constitue un coup de force très convaincant pour les adopteurs). Quitte à avoir la pratique de l’IA honteuse, dans ce qu’on appelle la shadow AI, ces pratiques non déclarées au travail (Ferguson), dans les écoles ou à la maison. Processus d’innovation technique assez rare dans les organisations (Gaglio) qui ont souvent pratiqué plutôt le top-down en devant se battre plus contre les « résistances » des personnels que contre leur enthousiasme débridé et leur volonté de tout tester « pour voir » et finalement pour adopter.
L’heure du bilan n’a cependant pas sonné car tous les ans à peu près une nouvelle version ou couche d’innovation rebat les cartes, au point même de disqualifier les savoir-faire acquis, qu’on avait annoncé comme décisifs pour l’avenir (savoir prompter). Les agents sont déjà là, des systèmes comme Open Claw, même s’il est bridé désormais par Claude, permettent d’organiser des batteries d’agents en parallèle pour réaliser quantité de tâches ou de séquences de tâches, le vibe coding est mis à la disposition de tous, la production de vidéos (dont les deep fakes) est désormais opérationnelle pour des utilisateurs ordinaires. La seule limite constatée pour un certain niveau de performance reposait sur la compétition féroce pour les puces GPU de NVidia qui elles-mêmes changent de version souvent, mais désormais Google et Deep Seek utilisent leurs propres processeurs (TPU notamment) conçus spécialement pour leurs IA. Dans cette effervescence, la question du coût était restée jusqu’ici ignorée comme toujours avec la méthode classique du dealer de techno qui amorce les usages en offrant la gratuité, mais le coût des abonnements à ces services commence à augmenter sérieusement selon le nombre de tokens traités. Au point que l’optimisation de l’usage des tokens fait désormais partie des services de Anthropic, sous forme de « adaptative thinking », terme inadapté mais significatif de l’emphase qui caractérise ces firmes.
Disons-le franchement : j’espère quand même que cette hubris financière et technologique va conduire à une crise majeure, répétant la crise financière de 2008 car c’est sans doute la seule chance de rebattre les cartes et de rouvrir les possibles. Mais il faudra alors posséder cette boussole que je propose pour s’orienter radicalement différemment dans nos choix socio-techniques. A condition qu’il existe encore un espace politique démocratique pour passer à une « démocratie socio-technique » (Lascoumes, Callon, Barthe, 2001) pour inventer un autre avenir. Or, la domination des plateformes d’IA se fait désormais à l’échelle mondiale (Chine et USA) en étroite collaboration avec les régimes les plus autoritaires prêts à favoriser leurs monopoles en échange de services de surveillance omniprésents.
Au-delà des monopoles des plateformes IA, nous devons plus encore nous inquiéter d’un « monopole radical » de l’IA générative et des LLM sur les connaissances, pour utiliser les concepts d’Ivan Illich. Toute son analyse de la mobilité et de l’énergie (Energie et équité, 1975) montrait comment l’industrie pétrolière avait installé un monopole radical de l’automobile supposée solution unique pour traiter nos demandes de mobilité. Alors même que le calcul de la vitesse généralisée (Dupuy, Robert) montrait qu’en intégrant tous les coûts de production et d’utilisation d’une voiture, sa performance en termes de vitesse devenait inférieure à celle d’un vélo. J’expliquerai dans un livre à venir pourquoi la comparaison des LLM avec le coup de force du moteur à explosion et de l’automobile est la plus pertinente en matière de monopole radical, entraînant toutes les dérives sociales, urbaines et environnementales que l’on connaît. C’est pourtant l’avenir qui nous attend dès lors qu’on laisse les entreprises d’IA le façonner pour nous.
Reprenons chacun des dyptiques proposés pour comprendre comment une ambivalence attraction/répulsion finit pourtant par engendrer ce monopole radical.
1/ Absence de science mais ingénierie géniale
J’ai conscience de surprendre ainsi beaucoup de chercheurs qui travaillent sur l’IA et sur certains principes qui ont guidé tout ce courant de recherche, souvent fondé sur des mathématiques de haut niveau. Certains n’accepteront pas de voir disqualifier leurs prétentions scientifiques. Précisons que ce n’est pas parce qu’on dispose de disciplines, de revues et de postes académiques qu’on fait de la science (nous autres chercheurs en sciences humaines et sociales sommes quotidiennement disqualifiés pour cela précisément). L’ingénierie est une activité très noble qui mobilise des rapports parfois étroits avec la science, de même que la médecine, mais ni l’une ni l’autre ne sont des sciences mais plutôt des sciences appliquées, dit-on parfois, et surtout des arts. Le soin est un art plus qu’une science malgré toutes les tentatives de « evidence-based medecine » qui autoriserait les transferts de décision à des systèmes d’IA, au prix d’une ignorance de ce que la relation de soin et la maladie possèdent de multidimensionnel. L’ingénierie, de ce point de vue, peut être géniale et on ne le contestera pas, depuis Léonard de Vinci au moins ! Mais c’est son art de l’assemblage de connaissances, plus ou moins modélisées, dans la résolution d’un problème opérationnel qui produit l’émerveillement. Il faut que ça marche, voilà l’impératif. Or, les observations in situ sur le travail des ingénieurs, comme celles effectuées par les STS et tout le courant de l’ANT (théorie de l’acteur-réseau, Vinck), ont bien montré que quantité de décisions opérationnelles relèvent du pari, de l’opportunité et surtout du tissage d’un réseau multidimensionnel pouvant mobiliser des compétences et des ressources extrêmement diverses. C’est le cas avec les LLM et avec l’IA générative.
Quand l’absence de théorie du langage est productive pour l’ingénierie
En effet, zéro science dans ces IA et on pourrait même dire que c’est grâce à cela que ça marche. C’est ce que disait ce CEO d’une firme de NLP (traitement automatique du langage naturel) il y a plus de quinze ans qui affirmait avec provocation que les performances de ses modèles s’amélioraient à chaque fois qu’il virait un linguiste. Et en effet, les LLM n’ont aucune théorie du langage et se débrouillent très bien pour éviter d’en avoir une, puisqu’ils reposent sur une tokenisation et une vectorisation de tout le matériel linguistique, qui n’a strictement rien à voir avec une analyse du langage, structurale ou même générative à la Chomsky. Le texte fondateur des « Transformers » publié par Google en 2017, l’annonçait d’ailleurs explicitement : « All you need is attention ». Ce qui veut dire en clair que dès lors que l’on veut détecter des patterns, des régularités dans des corpus linguistiques pour prédire les segments suivants, tout ce qui compte c’est la fenêtre de mémoire disponible au moment de l’entraînement sur des corpus par ailleurs toujours plus énormes, de façon à réduire les erreurs. Pas de théorie, pas de concepts, seulement un exploit technique réductionniste à l’extrême et pour cette raison très opérationnel, qui permet de traiter tout token dans un espace latent vectorisé pour pondérer ses probabilités de combinaison et donc d’apparition dans un « contexte » toujours plus grand, cette fenêtre d’attention. Evidemment, l’astuce technique, élémentariste comme toute l’informatique depuis Turing, nécessite des capacités de calcul rarement disponibles, surtout dans un laboratoire académique, et des capacités de collecte de données d’entraînement qui s’affranchissent des règles académiques de sourcing ou de droits d’auteurs (nous verrons cela plus loin dans le chapitre moral).
Cependant, reconnaissons que les résultats de cette simulation de production linguistique à partir de ces matériaux et de ces « astuces » techniques sont prodigieux pour un observateur neutre ou même critique. J’ai moi-même, il y a bien longtemps, développé des chatbots et des méthodes d’ingénierie linguistique en milieu industriel puis académique et la performance ne m’échappe pas. Mais je sais aussi par expérience, tout ce qui a été nécessaire de bricolage, de patch, de tâches aveugles, et de risques pris pour faire tenir un système technique après quantité d’arbitrage faits souvent à la volée et sans justification et sans vérification possible de leurs conséquences sur tout le système. Expliciter tout cela serait considéré comme indécent pour un utilisateur lambda dont on veut par ailleurs faire un utilisateur convaincu et capté dès la première requête puisque l’adoption fonctionne désormais dans l’instant (et non à la décision éclairée).
La boite noire n’est jamais acceptable dans une visée scientifique
Pourtant, cet effet boîte noire reste totalement antinomique avec des exigences scientifiques. Car adopter une visée scientifique (Gagnepain), c’est s’obliger à contester méthodiquement ses propres énoncés pour les vérifier, les discuter dans une communauté de pairs, ce qui suppose de les publier pour pouvoir les répliquer et ensuite les réviser. La chaîne de la référence (Latour) est très longue et doit être explicite. Ce qui n’a rien à voir avec les méthodes de production de l’IA générative qui fonctionne aux résultats simulés et produits en toute opacité. On se trouve alors plus proche de la visée mythique qui doit nous faire croire aux résultats par une simulation merveilleuse et ces IA génératives produisent en effet des merveilles.
Et lorsque les LLM se soumettent à une vérification, c’est à travers des benchmarks et non des expériences réplicables qui permettraient de suivre toutes les pondérations faites automatiquement, ou les méthodes d’apprentissage supervisé et de constitution d’une ground truth (« vérité de terrain », Jaton), qui posent tant de problèmes éthiques occultés. Aucun process explicite donc, contrairement au mouvement existant depuis plus de dix ans d’ « explainable AI » car depuis l’IA connexionniste, dans sa version réseaux de neurones puis deep learning, on sait qu’il n’est plus possible de vérifier tous ces processus, même quand on en est le concepteur. La démarche scientifique ne peut en aucun cas se satisfaire de ces boîtes noires puisque toute la construction des énoncés qui font science a reposé depuis des siècles sur des communications de protocoles et de résultats permettant une éventuelle réplication. Exigence qui se perd, il est vrai, même dans les sciences dures soumises elles aussi au culte du « résultat-positif-à-diffuser » pour améliorer ses scores de publication. On peut se dire alors que le ver était dans le fruit, et que tous les impératifs de publication délirants désormais exigés par les politiques publiques de recherche n’ont pas attendu l’IA pour dégénérer.
L’espace latent probabiliste ne peut pas produire une ontologie
Plus spécifiquement il faut noter la déstructuration délibérée de toute l’articulation du langage, de cette combinatoire analytique de son et de sens, productrice d’un potentiel infini d’expressions. Avec les LLM, il ne s’agit plus que de découpages de matériel langagier écrit optimisés pour leur calculabilité : tout peut devenir token, jusqu’à des signes de ponctuation, sans rapport avec le sens ni avec l’expression orale par ailleurs. Les relations ou vecteurs ne sont plus structurées (pas de lexique, de champ sémantique, de lemmes, de phonèmes, etc… tous articulés entre eux) mais seulement pondérées par leur fréquence d’apparition commune dans un corpus donné.
Sur ce plan, il faut veiller à ne pas confondre l’ingénierie linguistique qui était réalisée au temps du Machine Learning. Si l’objectif de calculer les distances entre entités linguistiques d’un corpus peut sembler voisin de ce qui est actuellement pratiqué par les LLM, ce serait oublier la torsion complète de ces principes par les LLM. Car à cette époque, les entités calculées étaient encore des lemmes, issus d’une racine qu’on pouvait organiser en relations sémantiques via des flexions, syntagmes et variations de tous types, au-delà des simples cooccurrences dans un même environnement. Les corpus étaient eux-mêmes limités car thématiques, présélectionnés ou identifiables par leurs origines. Désormais on parle de tokens qui décomposent tout matériel graphique (et non verbal) en élément dont on va estimer la fréquence d’apparition dans un corpus infini, non indexé ni identifiable (effet boite noire). Un token n’a plus besoin de relation sémantique avec son environnement, seulement sa co-occurrence statistique suffit à produire un vecteur qui sera pondéré (et désormais non révisable puisque tout se passe dans l’opacité la plus totale).
C’est ici qu’une coupure avec la sémantique s’est introduite définitivement dans la méthode même de décomposition par token et de vectorisation. Le coup de force des LLM tient au fait qu’ils prétendent traiter toute une langue, grâce à une collecte d’un corpus infini, ce que leur permet en effet leur prédation systématique de tous les contenus disponibles. Tout ce traitement s’effectue dans une langue donnée, qu’on doit ensuite traduire dans d’autres langues qui n’auraient pas les corpus suffisants, d’où d’autres distorsions introduites dans ce corpus supposé universel.
La puissance statistique de ces probabilités reposant sur des corpus toujours plus vastes leur permet de simuler en effet des effets de langue très plausibles et de masquer totalement leur absence totale de sémantique, de référence au monde perçu, et d’attributions de valeur systémique aux relations/vecteurs calculés. Il s’agit bien d’un artifice d’ingénierie tout-à-fait prodigieux dans ses résultats, même s’il a la particularité d’être totalement incontrôlable ou inauditable dès lors que l’espace latent où tout se calcule n’a plus aucune relation avec le sens et combine tellement de dimensions que personne ne peut plus rendre compte des pondérations effectuées (the curse of dimensionality, Bellman, 1957). L’opacité du système est le prix à payer pour sa performance.
Le maquillage sémantique indispensable pour sauver le soldat LLM à tout prix
Cependant, ses faiblesses structurelles d’accès au sens engendrent tant d’erreurs qu’il faut là encore mobiliser des correctifs sans cesse plus ingénieux mais qui demeurent des expédients. C’est ce que l’on a nommé au début des LLM des « hallucinations », en fait des erreurs, des inventions de toutes pièces et sans aucun sens, présentées de plus sans aucune précaution sur les limites du système et sur le principe même des probabilités. L’obligation de réponse à tout prix, qui n’a rien à voir avec une exigence scientifique ni avec une garantie industrielle (voir chapitre suivant), relève en fait de la promesse commerciale et de la captation de dépendance d’un public sans aucun recul critique.
Pour réduire ces effets pervers – mais en fait constitutifs même des choix techniques d’ingénierie effectués contre toute exigence scientifique -, un certain nombre de méthodes sont employées pour réintroduire par la bande de la sémantique que l’on a exclue au départ pour optimiser la vectorisation généralisée des contenus d’entraînement. Ainsi, tout le travail d’annotation réalisé par les travailleurs du clic et les petites mains des plateformes (Casilli, 2019) sert avant tout à cela : produire une supervision de départ qui ne dit pas son nom mais qui permet de générer une ground truth qui limitera les dégâts, ce que Mechanical Turk d’Amazon offre comme service par exemple. C’est pourquoi le travail précaire et sous-payé de tout ce nouveau prolétariat des pays du sud, plus proche du péonage que du salariat (Moulier-Boutang), ne peut être occulté comme fondation sémantique des systèmes d’IA génératives. Certes, les modèles auto-apprennent ensuite, mais un contrôle reste nécessaire pour éviter de voir la qualité se dégrader de façon trop visible. Aucune science dans cette affaire, seulement la reconnaissance par l’ingénierie des patchs nécessaires pour corriger les défauts des choix initiaux. En l’occurrence, « attention is NOT all you need », il faut aussi celle d’humains enchainés à leurs écrans et à leurs micro tâches qu’on ne saurait montrer ni reconnaître.
De même, en raison de la spécificité sémantique de la plupart des domaines professionnels, avec ces LLM, il reste quasiment impossible d’assister correctement des processus de décision ou de création de contenus lorsque les documents sources sont noyés dans le corpus général des modèles centralisés. Il faut réintroduire du « contexte » dit-on parfois de façon erronée alors qu’il s’agit en fait de réintroduire du sens, articulé en sémantique, avec des termes spécifiques organisés en ontologies comme on le fait toujours avec l’IA symbolique. Tout process industriel qui ne se fonderait pas sur ces bases robustes courrait à la catastrophe.
Patches en tous genres : RAG, Chains of Thought, MCP
Mais là encore, l’ingénierie des firmes de l’IA se débrouille pour vanter l’intervention des experts du domaine sur des modèles réduits de LLM que seront les RAG (Retrieval Augmented Generation). Les experts d’un domaine injectent leurs contenus contrôlés, validés et pertinents pour leur secteur dans les données d’apprentissage du modèle général ou dans une version plus locale et restreinte, et réduisent ainsi considérablement les risques de non-pertinence ou d’erreurs. On entraîne ainsi le modèle sur des corpus de documents administratifs ou techniques issus de l’entreprise ou de l’administration et on s’assure ainsi qu’il effectuera les tâches demandées avec plus de fiabilité. Comme on le voit, il s’agit là encore d’une astuce d’ingénierie qui ne corrige en rien les défauts structurels des LLM mais qui réduit leur impact dès lors qu’il existe des experts capables d’alimenter les corpus d’apprentissage en contenu contrôlé. Il faut donc à nouveau des humains qui réintroduisent de la sémantique pour obtenir des résultats fiables. Pourtant, tout cela est présenté comme un additif normal et ingénieux aux LLM et non comme reconnaissance d’une faille constitutive de leur architecture stupidement probabiliste.
Un autre patch consiste à équiper ces systèmes d’IA générative à base de LLM de « chaînes de pensée » (Chain of Thought) leur permettant de construire un raisonnement en décomposant un problème en séquences. Le terme de « pensée » peut être trompeur car il ne s’agit que d’étendre les capacités élémentaires de tout système informatique à décomposer en procédures et en séquence opérationnelle toute résolution de problèmes, ce qui est au fond à la base de toute compétence technique. Fournir cette capacité n’a rien d’un raisonnement. Alors qu’il existe des systèmes d’IA effectivement raisonnante, mais de type symbolique et totalement explicable, comme Xtractis, produit par Intellitech (Zalila). Dans ce cas, toutes les pondérations et décisions sont traçables car elles sont fondées sur de solides armatures logiques que toutes les IA symboliques mobilisent depuis des décennies.
Dernier épisode en date de la même opération de sauvetage des systèmes d’IA génératives asémantiques : le passage à l’IA agentique, capable d’effectuer des tâches de commande, de gestion, faites de séquences complexes et adaptées aux infinies variations du monde réel. On comprend bien le défi. Des systèmes automatisés, ne disposant d’aucune représentation significative du monde mais seulement d’une capacité infinie de pondération des vecteurs linguistiques pour engendrer des prédictions, se trouveront en difficulté face à la complexité du monde réel, et aux ambiguïtés sans fin de toute langue et de toute situation. Une astuce supplémentaire de l’ingénierie des entreprises d’IA permet de simuler une réduction de ces aléas. On dispose désormais en effet d’un protocole pour harmoniser la description du monde : serait- ce une ontologie ? Certes non, seulement une simulation limitée au monde des interactions entre machines : le MCP, Model Context Protocol, se contente de standardiser les API que devront utiliser les systèmes d’IA pour devenir vraiment des agents « dans le monde », en fait des agents bien limités au monde des systèmes d’information normalisés pour devenir interopérables par des IA agentiques. Une nouvelle fois, la question du rapport au monde, de la sémantique nécessaire pour en construire la représentation est évacuée par une opération d’ingénierie. Cela permet cependant de construire ainsi un début de standardisation du secteur, ce qui est industriellement non négligeable.
Mais il en sera autrement dans les secteurs industriels critiques comme nous le verrons. Lorsqu’on voit que Palantir, dans sa fourniture de systèmes de décisions de frappes militaires létales, présente explicitement la couche d’ontologies qu’elle ajoute aux LLM qu’elle utilise, en parlant d’une nomenclature pré-encodée (c’est-à-dire contrôlée et validée par les humains selon un schéma cohérent sémantiquement), on comprend mieux ce qui se déroule et se déroulera dans les autres industries, qui ont des exigences encore plus sévères que dans les industries de défense dont la précision n’est pas l’impératif prioritaire, comme on l’a constaté récemment. Les benchmarks récents pour tester ces systèmes d’agents ont cependant produit des résultats très inquiétants quant à leur fiabilité et à leur sécurité (Shapira et al., 2026).
La mutation du mode de production du code, étape essentielle vers le monopole radical
Il faut cependant admettre que les limites asémantiques des LLM ont été particulièrement bien exploitées pour la production du code informatique. Ce qui peut se comprendre aisément, puisque précisément le code n’est pas le langage ni la langue et que son univocité le rend opérationnel sans risque de contre-sens comme on dit, puisqu’il ne s’agit plus de sens mais de commande pour l’action. Cette réduction du langage des propositions logiques au code du programme fut la force du pari initial de Turing (Lassègue et Longo, 2025) qui continue d’être exploité. La production de code entraîne pourtant des erreurs nombreuses variables selon les systèmes d’IA mais désormais bien réduites avec l’avancée apportée par Claude Code. On mesure alors la productivité potentielle d’une telle performance d’ingénierie puisque ces systèmes peuvent générer du code pour générer du code pour générer du code, à plusieurs niveaux. Cela a entraîné la fascination des milieux des développeurs pour Open Claw qui génère, lui, des agents organisés en système dans des délais d’une rapidité inouïe par rapport aux tâches séquentielles précédentes.
C’est ainsi dans ce domaine du code que les LLM sont en train de modifier le mode de production informatique en général et de ce fait d’un grand nombre de process industriels. De l’autre côté, pour le grand public, c’est la mutation des compagnons à travers des interfaces conversationnelles performantes qui est en train de s’installer comme routine ou comme évidence dans la vie quotidienne. Notre mode de production des interactions quotidiennes va s’en trouver clairement affecté radicalement. Le problème, dans les deux cas, industrie ou interaction, tient à l’absence totale de traçabilité et d’explicabilité de tous ces systèmes, si performants et si opaques à la fois. Les erreurs, bugs ou hallucinations sont inévitables et l’expertise pour les détecter aura tendance à se raréfier puisque seules des IA pourront éventuellement réauditer de telles boîtes noires. Et lorsqu’on se réjouit de voir que Claude a détecté avec Mythos des bugs jusqu’ici ignorés qui sont en fait de vraies failles de sécurité, on accepte d’ignorer que l’on ne sait pas si ces failles étaient vraiment critiques (d’où le peu d’intérêt pour les détecter avant), quelle est la proportion de bugs existants non détectés par l’IA (par définition !), et si l’IA ne détectera pas de faux bugs (faux positifs) que personne ne saurait contredire (Schneier, 2026). Il faut donc accepter les miracles et continuer à avancer à l’aveugle.
Mais plus on s’oriente vers cette transformation en profondeur du mode de production, plus cela tend à réduire les LLM à des systèmes d’exploitation, dont nous ne connaissons toujours pas les applications adaptées à DES environnements toujours spécifiques. Or, dès qu’on veut implémenter une application robuste dans le vrai monde, il faut y rajouter une couche sémantique. Certains plaidaient depuis longtemps pour cette hybridation symbolique/ génératif mais le débat porte rarement explicitement sur cela : on se contente de patchs sémantiques ( et donc à base d’IA symbolique) dès qu’on veut installer des process fiables. Nous pourrions donc évoluer ainsi vers un équivalent de MS-DOS. On interagit avec un Windows qui est en fait une copie de Mac OS, pertinente et conviviale, mais toujours plaquée sur un OS antique et inadapté, ce qui a duré pendant 40 ans environ. Par analogie, nous accepterions donc les défauts intrinsèques de ces LLM en acceptant de les corriger sans cesse, de les camoufler pour éviter d’interroger la nullité scientifique des LLM. Alors qu’il serait possible de concevoir dès maintenant une IA hybride dans son cœur même, en s’appuyant sur les IA symboliques raisonnantes déjà disponibles pour leur ajouter quand c’est nécessaire les capacités génératives issues des méthodes des LLM. Mais tout cela sans développer toute l’usine à gaz énorme que sont les data centers et la collecte en masse de données pour l’apprentissage. Philosophie totalement différente mais qui ne gagnera pas forcément comme je l’explique dans la seconde partie sur l’industrie. Pourtant, d’autres acteurs tentent d’explorer une sortie de cette impasse.
En sortir par une extension de l’automatisation avec les « modèles du monde » ?
En effet, peut-être devrait-on confier notre sort à ceux qui, comme Yann Le Cun, nous fixent des objectifs de pertinence nettement plus robustes en sortant des limites des LLM. On peut comprendre l’ambition de ne plus faire reposer les modèles sur du matériel uniquement linguistique, même si cela pouvait fonctionner assez aisément pour des visées de génération de contenus. L’idée de descendre au niveau de la perception et d’entraîner désormais ces systèmes sur des vidéos qui démultiplient les indices en les situant dans des univers réalistes qui fournissent une connexion de fait avec le monde (même si médiées par le support vidéo) paraît ambitieuse en termes de capacités de calcul et de temps d’entrainement mais cohérente pour dépasser les limites des LLM. En réalité, malheureusement, il s’agit là encore d’une ingénierie magnifique et prometteuse, mais qui échoue à caractériser scientifiquement ce qu’est l’expérience du monde du point de vue cognitif et qui de plus ne fournit comme horizon industriel et moral qu’une automatisation toujours étendue.
L’expérience du monde n’est pas faite seulement des inputs de signaux très riches fournis par nos sens. En premier lieu, elle est construite dans une boucle qui suppose une interaction effective avec le monde : les gestes, les actes doivent être éprouvés et avoir un effet sensoriel au-delà de leur visionnage sur un écran de vidéo pour pouvoir constituer une base d’apprentissage robuste. Cela nécessiterait alors de doter ces systèmes d’IA d’un équivalent de corps, et donc de pousser l’automatisation encore plus loin vers une robotique étendue et sans limite a priori. Cependant, le principal manque de la vision des « modèles du monde » de Le Cun, c’est la dimension collective de l’apprentissage du monde, ne serait-ce qu’à travers le regard d’un autre humain, souvent un parent nourricier. Ce couplage étroit, plus ou moins satisfaisant mais déterminant pour le psychisme, semble demeurer extérieur aux modèles du monde. Or, l’expérience du monde est intersubjective par définition ou même distribuée car on doit penser en termes de « cognition distribuée » (avec des humains et des non-humains) (Hutchins). On n’inventera pas une compréhension du monde qui ne soit fondamentalement dialogique, et donc psycho-sociologique.
On pourrait alors prolonger juste un peu plus loin la saga de l’ingénierie de l’IA et annoncer : « qu’à cela ne tienne, nous allons modéliser aussi tous les comportements psychosociologiques et nous aurons ainsi atteint le but ultime de l’IA générale, totalement équipée des compétences humaines ». Voilà où la question morale revient en force, avec cette tendance lourde de la classe vectorialiste à s’en passer allègrement. Pour rester pertinente, l’IA la plus enrichie socialement doit se fonder sur une théorie de la technique qui sorte du fantasme de simulation totale et d’automatisation sans limite. La technique est une compétence humaine qui se combine sans cesse avec les autres compétences inhérentes à la condition humaine et ne peut jamais être désencastrée des rapports sociaux, politiques, désirants, émotionnels qui obligent de ce fait à inclure les humains dans la boucle. Ils le sont comme experts en premier lieu pour la valeur indicielle irremplaçable de leurs connaissances mais aussi et surtout comme sujets de désirs et de droits et comme collectifs coopératifs. Une IA qui s’affranchirait de toute connaissance et de toute théorie de toutes les compétences humaines pour remettre la technique à sa place serait en fait atteinte d’hubris et profondément dangereuse. C’est ce que certains prophètes proclament d’ailleurs, un peu vite et avec des arguments tordus parfois, pour à la fois réduire la vitesse et l’accélérer pour aboutir à l’étape suivante de l’automatisation totale plus rapidement.
Pourtant, il reste possible de faire bifurquer ce train lancé à toute vitesse et qui semble inarrêtable sur cette voie unique, celle des LLM fournie par les plateformes. Pour cela, il convient de sortir de la fascination pour l’ingénierie en exigeant de réintroduire des impératifs scientifiques et donc une exigence de compte-rendu explicite de tous ces systèmes, une auditabilité que les impératifs industriels avaient pourtant installé comme convention sociale bénéfique à tous. Comment se fait-il que non seulement les LLM peuvent se passer des impératifs scientifiques mais aussi des impératifs industriels ?
2/ Abandon des impératifs industriels, triomphe des performances financières
Les prouesses d’ingénierie que l’on vient de souligner devraient normalement entraîner des qualités industrielles équivalentes si l’on vivait encore dans le capitalisme industriel. Or, n’oublions jamais que c’est désormais un régime de capitalisme financier qui nous gouverne (Orléan, 2011). Le secteur du numérique est totalement dépendant des principes, des méthodes et des puissances fournies par la finance qui adore l’IA, quand bien même les performances industrielles de ces systèmes d’IA sont à proprement parler catastrophiques. C’est ce paradoxe qui doit être pensé pour comprendre à quel point nous allons dans le mur en tant que société dite « moderne » en confiant notre avenir à ces systèmes d’IA. La domination financière sur l’allocation de ressources accélère encore ce processus malgré l’inconséquence industrielle qui la sous-tend.
Les qualités industrielles attendues des systèmes d’IA devraient être de deux types : une fiabilité la plus élevée possible, à défaut de totale qui serait un fantasme (Gérard Berry), et une architecture efficiente, c’est-à-dire la plus économe possible de toutes ses ressources. Il ne suffit plus de faire preuve d’ingéniosité pour obtenir le meilleur résultat possible une fois : dans un système industriel, il faut pouvoir assurer la répétition, le passage à l’échelle, la maintenance, et la fiabilité dans des circonstances totalement différentes. Or, aucun des LLM sur le marché ne peut assurer cela et d’autant moins que ce sont des systèmes opaques non réglables avec précision, contrairement à ce qu’on prétend faire avec du fine-tuning (qui revient en fait à réinjecter de l’expertise humaine et donc de la sémantique au cas par cas, ce qui n’a rien d’industriel précisément).
L’étrange acceptation de l’absence de fiabilité industrielle des LLM
Lorsque l’utilisateur ordinaire constate des hallucinations ou des réponses trop évasives, trop bavardes ou incompréhensibles de systèmes d’IA conversationnelles qu’il utilise, il s’agit souvent de situations individuelles, de communication, sans grandes conséquences, avec de plus une propension des utilisateurs à s’auto-incriminer pour leur incapacité à faire les prompts corrects tant le mythe de « l’intelligence » de la machine finit par s’imposer. Cette tolérance n’a rien à voir avec celle qu’on peut avoir aussi dans l’industrie pour des systèmes de production et de services qui doivent assurer une qualité permanente du produit et une traçabilité très exigeante. Comment se fait-il d’ailleurs qu’on n’exige jamais de la part des plateformes d’IA génératives des démarches qualité, des audits et de la documentation comme on le fait dans tout secteur industriel ? Car tous les secteurs sont soumis à des réglementations, à des standards, à des responsabilités légales et pénales dans les cas de non-respect de normes, de procédures ou de contrôles. Ce fut tout du moins tout l’effort des années après-guerre où l’industrie se trouva régulée par les Etats ou par ses propres conventions entre concurrents.
Rien de tout cela dans les firmes de l’IA qui se sont totalement affranchies des exigences devenues communes dans l’industrie. On peut arguer que le secteur étant en construction, il faudrait attendre un peu avant que cela se stabilise. Or, la pénétration de l’IA dans tous les secteurs, ou tout au moins les efforts des vendeurs d’IA dans ce sens, exige que les processus IA soient soumis aux mêmes degrés d’exigence que tous les autres composants d’un secteur donné qui peut aller de la comptabilité à la logistique en passant par les matières premières, les machines, etc. et cela pour les produits, les process et les personnes, les 3P de toute démarche qualité. Cette façon désinvolte de disqualifier les procédures industrielles au nom de la disruption éclair est très choquante pour ceux qui connaissent cet univers. Aucune autre industrie ne pourrait s’autoriser une fiabilité aussi faible, fut-ce au bénéfice de l’accélération et du gain de temps supposé. Certes, certains secteurs critiques parviennent à exploiter des briques de LLM pour amplifier les performances de leur activité de façon limitée et à condition d’y rajouter leurs propres données validées comme pour le RAG ou une couche de sémantique comme je l’ai indiqué. Mais cela indique bien l’absence de fiabilité intrinsèque de ces LLM et le surcoût induit par la nécessaire intervention des experts dans la boucle, ce qui invalide la promesse fantasmée des vendeurs de LLM.
L’un des moyens classiques de l’industrie pour pousser à l’augmentation de la qualité et rétablir les conditions de la concurrence plus équitables a toujours reposé sur la standardisation, sur la production de normes (et non seulement de la part des Etats contrairement au roman libéral anti-bureaucratique qu’on nous sert en permanence). En effet, la compatibilité entre produits et services et la comparabilité des performances et des qualités servent la stabilisation des marchés, et donc la viabilité d’investissements de long terme comme l’exige tout appareil de production tangible. Il semble que, en l’absence de cet aspect tangible puisque le numérique est éminemment plastique, même s’il n’est en rien immatériel, ce secteur puisse s’affranchir de cet impératif d’organisation du marché.
La disparition de la culture des tests
L’un des indices de cette compétition sans règle industrielle peut être observé dans la disparition de la culture des tests. Dès lors qu’il n’existe plus de normes ni de standards, pourquoi se préoccuper d’étalonner avec des mesures fiables ses propres produits et services ? A défaut de ces normes, on pourrait penser que ces tests seraient cependant utiles pour anticiper la satisfaction du client et éviter des retours consommateurs parfois destructeurs de réputation. Et pourtant non, les nouveaux entrants sur le secteur de l’IA générative, comme Open AI, ont au contraire tout fait pour court-circuiter les entreprises en place, soucieuses de leur réputation, et ont mis sur le marché des systèmes non validés, sans fiabilité aucune, à charge aux utilisateurs adopteurs précoces de faire remonter leurs retours et d’attendre la nouvelle version.
Ce principe du chantier du code qui court (le rough consensus andrunning code de J.P. Barlow) qui se corrige de lui-même constitue une rupture avec les impératifs industriels qui ont mis du temps à s’installer durant tout le XXe siècle mais qui ont produit des systèmes techniques plutôt fiables et de moins en moins insécures, avec l’appui des réglementations étatiques contraignantes dans certains domaines, il faut bien le dire. Le seul étalonnage des systèmes d’IA disponible en public reste donc les benchmarks effectués soit par les universitaires soit par des cabinets, à intervalles très fréquents puisque les versions se succèdent sans cesse, ce qui permet d’ailleurs de disqualifier les benchmarks dont les remarques critiques ont été déjà corrigées dans des versions nouvelles sorties quasiment avant la publication critique.
Les tests de validation du code existent toujours cependant. Mais ils permettent seulement d’éviter les principales erreurs mais non de relever ou de comprendre les décisions effectuées. Pire encore, la rapidité de génération du code est désormais telle que les générations de seniors chargées de l’auditer n’ont plus le temps de le faire. Cela renforce ce qu’on appelle désormais même chez les développeurs une « dette cognitive », c’est-à-dire une perte de compétence pour interpréter le code que l’IA permet de générer. Et Anthropic a vérifié son augmentation dans les dernières versions qu’il appelle « the compréhension debt » (Osmani, 2026) : « AI generates code far faster than humans can evaluate it ».
Ces benchmarks ont-ils un rapport avec l’expérimentation scientifique ? En rien. Avec les tests normalisés des industries classiques ? En rien ! Avec les tests ergonomiques ou fonctionnels pour anticiper la qualité de services et l’acceptation par les utilisateurs ? En rien. Ce sont en fait des repères flous et instables pour s’orienter dans une compétition d’opinion sans aucun référent industriel stable qui rendrait ces systèmes commensurables. Et pourtant des décisions majeures sont prises dans les boards et les gouvernements sur la base de ces appréciations qui créent la rumeur, qui disqualifient sans démonstration sérieuse ou qui vantent des performances jamais comparables. L’effondrement d’un sens pratique de la mesure et de son rôle régulateur n’est pas le moindre des paradoxes de cette emprise de la finance sur un secteur productif qui rend le travail des régulateurs particulièrement difficile.
La réglementation européenne récente prend acte de ces risques en matière de fiabilité mais limite les exigences de haut niveau aux systèmes les plus critiques, à risque, alors qu’on ne peut jamais savoir a priori les conséquences d’une absence de fiabilité et de traçabilité. Les exigences d’auditabilité sont quasiment inapplicables par définition à ce degré de complexité lorsque tant de couches de neurones sont concernées. La seule prétention à une amélioration de cette fiabilité repose sur l’augmentation permanente des données, leur renouvellement, leur mise à jour et l’augmentation des performances probables dans l’espace latent de ces vecteurs totalement incontrôlables.
Le culte de la brute force et de la taille si séduisantes pour la finance
On comprend mieux dès lors la course à l’installation de gigantesques centres de données partout dans le monde, conçus comme la base stratégique d’une robustesse industrielle. Or, cette dépendance à la taille des centres de données indique avant tout la faillite industrielle du modèle des LLM, leur efficience ne faisant que diminuer pour maintenir la croissance de leur efficacité. Toujours plus gros devient la seule solution pour réduire l’absence de fiabilité. La demande de vitesse des réponses et des calculs ajoute encore à cette exigence mais on perçoit alors à quel point les performances d’ingénierie sont obtenues au prix d’un gâchis industriel invraisemblable. On sait que les effets d’échelle peuvent jouer un rôle dans certaines industries pour augmenter la fiabilité dès lors qu’on peut réaliser des investissements conséquents pour effectuer tous les contrôles nécessaires et obtenir une standardisation plus avancée. A la condition d’avoir des procédures, des dispositifs de contrôle et de pilotage fin et des métriques permettant de rendre compte de ces améliorations et de détecter en continu les baisses de qualité en faisant par exemple de la maintenance préventive.
Mais rien de tout cela dans les centres de données qui sont nécessaires à l’augmentation de puissance des systèmes d’IA, non pour leur fonctionnement technique opérationnel au quotidien (les serveurs doivent fonctionner correctement !) mais pour leurs performances sur leur service de base. Cette culture de la taille, cette course à la masse de données, constituent sans doute les faiblesses principales du modèle extractiviste du modernisme industriel, du point de vue même de la performance industrielle, comme on l’a vu avec les conséquences de la dépendance au pétrole. Et pourtant, c’est ce qui est réactivé avec les centres de données surdimensionnés qu’on installe désormais uniquement pour tenter de réduire les insuffisances intrinsèques de modèles de langue purement statistiques.
La corruption financière de toute exigence de qualité industrielle
On ne peut comprendre cette carence de qualité industrielle si l’on n’inscrit pas le secteur de l’IA générative (et tout le numérique avec elle) dans une économie financiarisée. En effet, les investissements exigés pour ces centres de données, leurs puces, leurs ressources énergétiques, semblent totalement décorrélés de leur efficience industrielle, d’un bilan comptable sérieux, d’un équilibre entre investissements et retours sur investissements. Car les liquidités pleuvent sur ce secteur (et les Etats abondent, qui plus est : 500 milliards de Trump, 100 Milliards de Macron, etc. !) seulement en raison de la promesse spéculative que les plateformes d’IA soulèvent, sans aucun égard pour la rationalité industrielle et comptable d’un bilan d’une entreprise ordinaire. Nous avons quitté non seulement les critères de gestion d’un « bon père de famille » comme on disait autrefois mais aussi ceux de la gestion prudente d’une entreprise quelconque, et même celle de la gestion d’une trajectoire innovante à risque, qui suppose malgré tout quelques garanties.
Pour continuer à entretenir le narratif attracteur d’investisseurs, les firmes comme Open AI sont capables d’effectuer des montages financiers tout aussi opaques que leurs algorithmes, à travers des prises de participation croisées avec Nvidia par exemple indexés sur des promesses d’achat de puces, le tout sans aucune garantie, sans traçabilité comme on sait très bien le faire dans la finance. Le but est ici de faire des effets d’annonce en permanence (d’où l’importance du buzz que nous traiterons dans la troisième partie) pour maintenir en vie la promesse de monopole qui attire avant tout les investisseurs (parier sur le gagnant final comme ce fut le cas pour Amazon) et qui constitue le B A BA de l’idéologie libertarienne professée par Peter Thiel. Le capitalisme financier n’a que faire de la compétition, de la « concurrence libre et non faussée » et encore moins de l’industrie et de ses exigences de fiabilité et de standardisation. Il faut disrupter sans cesse et la succession invraisemblable des versions toutes aussi époustouflantes, et cela sans vérification possible, constitue un enjeu permanent. Les nouvelles versions peuvent même être moins performantes que les précédentes, chose incroyable d’un point de vue industriel (ce fut le cas pour Chat GPT 5o), mais les lancements s’expliquent alors par l’agenda d’un nouveau tour de table financier ou par la réponse urgente aux annonces des compétiteurs pour cette position de monopole.
Responsabilité sociale et environnementale ? Dans les poubelles de l’histoire IA
On comprend bien que dans une telle frénésie spéculative, les impératifs industriels de fiabilité ou de qualité ne soient perçus que comme des vestiges d’un vieux monde. Ces tenants du vieux monde ne supportent pas l’incertitude intrinsèque imposée par la disruption permanente présentée comme loi de l’innovation, alors qu’elle n’est qu’une loi de finance spéculative. Il n’est guère étonnant alors que toute politique de RSE (responsabilité sociale des entreprises étendue depuis plusieurs années à la responsabilité environnementale), soit totalement hors du champ de perception de ces entrepreneurs sans limites. Or, il a pourtant fallu du temps, de l’énergie, des procédures pour faire aboutir une convention sociale plus ou moins partagée par les entreprises de tous secteurs en faveur de cette cotation RSE qui doit être inscrite dans toutes les dimensions d’une activité industrielle. C’est ainsi que la lutte contre l’exploitation des personnes, contre les discriminations, a pu avancer dans le monde. Pour toutes les entreprises de l’IA désormais, tout cela n’est que bureaucratie et frein à l’innovation disruptive. Le droit social, comme le reste du droit, mais en particulier celui-là, se trouve démantelé, en bas de la hiérarchie de la chaine de production avec les travailleurs du clic mais aussi en haut avec la pression sans limite imposée aux travailleurs du code, qui le produisent de moins en moins par ailleurs.
Mais c’est surtout en matière environnementale que les conséquences de cet extractivisme de la donnée sont impressionnantes et devraient entraîner dès maintenant des blocages réglementaires. Les centres de données dont on vient de parler consomment une énergie énorme (eau et électricité avant tout) qui met des communautés et des états sous pression avec des risques de pénurie ou de dégradations des conditions de vie et des ressources. Mais il suffit de prévoir des centrales nucléaires dédiées à ces centres pour que tout redevienne propre, miracle du greenwashing nucléaire, à échéance encore lointaine cependant. Dans un monde supposé se caler sur l’accord de Paris pour réduire sa consommation d’énergie et les gaz à effets de serre, le numérique et en particulier les firmes de l’IA s’affichent totalement indifférentes au problème, puisque la puissance de calcul et de stockage des données devient une priorité pour la compétition sans avoir à remettre en cause la performance industrielle des choix effectués. Et comme les data centers sont des attracteurs à investisseurs et que les liquidités sont abondantes, pourquoi s’autocensurer, sans rien savoir de la rentabilité financière même de ces opérations ? Car le déni de mesure de la performance industrielle s’étend à la finance. Tous les avertissements sur la bulle financière en cours de constitution autour des entreprises d’IA, pourtant endettées et sans rentabilité prévisible avant des années, ne valent rien face à la promesse spéculative d’une position de monopole qui récompensera les audacieux indifférents aux risques.
La complicité de gouvernements devenus des obligés des plateformes
Or, aucun autre secteur ne bénéficie ainsi d’une telle mansuétude de la part des autorités financières et des pouvoirs publics, tous fascinés par ces annonces et ces transformations qui attirent tant les autres pays qu’il faut donc imiter au plus vite. L’Europe pourrait prétendre rétablir un peu de rationalité industrielle et exiger des firmes d’IA européennes des choix alternatifs en matière de responsabilité sociale et environnementale, facteur de durabilité, de gain à long terme et diversité de l’écosystème technique. Mais les institutions européennes et les Etats accourent au contraire pour abonder tous les projets de financement de ces data centers, sans aucun respect pour les engagements pris. La finance a pris le pouvoir dans les têtes des décideurs et empêche toute vision alternative, malgré les lamentations rituelles sur la désindustrialisation. Le gaspillage énergétique devrait déjà alerter au moment où les crises énergétiques mondiales révélées et aggravées par toutes les guerres deviennent des sujets clés de la vie quotidienne et donc des choix politiques. Mais tous ces soucis ne franchissent pas le seuil de l’attention des plans et sommets IA, des boards des firmes et des plateaux télé d’experts économiques ad hoc. Cette incapacité à déterminer des objectifs autonomes pour les états a déjà été documentée à propos des plateformes numériques financées par la publicité et bénéficiant d’une impunité quasi-totale de la part d’Etats devenus des obligés dans un système de firmes transanationales affranchies de toute dépendance à un territoire (Boullier, 2020). La promesse de l’IA a encore renforcé cette incapacité des états à l’examen critique des stratégies et à toute vigilance réglementaire, malgré les tentatives timorées comme l’AI Act européen.
Les externalités ont toujours été évacuées dans les modèles économiques standards mais cette fois-ci, l’externalité énergétique devient tellement évidente et coûteuse qu’on pourrait espérer une contre-tendance, des voies alternatives, si l’on avait affaire à une culture industrielle qui vise à optimiser sa consommation énergétique sans la considérer comme une ressource infinie et gratuite. Mais dans une culture financière, ce type de calcul est inutile sauf s’il affecte la perception des investisseurs sur les chances de démultiplier leur mise. C’est pourquoi les enjeux de réputation (voir le chapitre suivant) sont aussi importants et bien perçus par les firmes de l’IA.
3/ Buzz partout, éthique nulle part
Dans un tel environnement sans exigence scientifique ni industrielle quant à la validité des concepts ou à la fiabilité des produits, il devient presque hallucinant d’espérer trouver des préoccupations éthiques. J’entends par là une éthique aristotélicienne, une éthique de la vertu qui manifeste une capacité à s’autolimiter, à s’autocontrôler et à « ne pas faire », quand bien même c’est possible, non risqué, non coûteux. Cela supposerait des personnalités de la classe vectorialiste formées à ce sens des limites, intégré comme principe de conduite et non seulement comme contrainte externe, comme risque à mesurer. Or, les génies de l’ingénierie comme les prestidigitateurs de la finance n’ont que mépris pour ce type de freins. Ce qui conduit à reprendre cette supposée maxime fataliste de la technique « si c’est possible, ce sera fabriqué ». Or, la maxime elle-même est empiriquement fausse car une grande quantité de combinaisons possibles techniquement ne sont jamais testées car les effets de dépendance au sentier ou plus simplement de manque d’imagination sont omniprésents. D’autres possibles techniques peuvent être développées dans les labos ou dans les garages mais ne trouvent jamais de conditions pour exister socialement, pour des raisons juridiques, commerciales, financières ou autres. Car il n’existe jamais de technique hors-sol ou désencastrée d’un univers social spécifique, celui d’une époque, d’un voisinage et d’un réseau. C’est d’ailleurs pour cette raison que l’IA générative est en train de gagner la partie, grâce à sa connexion directe avec la finance et ses impératifs et non en raison de ses qualités propres dont on connaît désormais les limites.
Et l’un des atouts de cette « solution LLM » utilisée dans toutes les situations réside dans l’absence de limites à son utilisation, dans sa versatilité qui permet en effet à chaque prétendant innovateur de s’emparer des briques pour forger des applications toujours plus improbables quand bien même elles seraient moralement inacceptables. Car leurs concepteurs n’ont qu’une exigence de performance technique et financière en tête sans aucun souci déontologique du bien commun ou de la responsabilité sociale et morale, d’autant moins qu’ils sont incapables de s’empêcher, fascinés par la toute-puissance à laquelle ils ont été éduqués. Les considérations sur les conséquences sociales et environnementales de leurs pratiques sont considérées dans leur formation même comme très périphériques et de toutes façons traitées comme des externalités inévitables pour le succès de leurs projets, qui pourraient à la rigueur être compensées par une nouvelle couche de solutions techniques, technosolutionnisme toujours efficace pour clore le débat (Morozov, 2012).
La conception de l’éthique qui est dispensée à ces ingénieurs relève largement de l’utilitarisme, qui est tout sauf une éthique, et avant tout un calcul coût-avantage, coûts de la non-conformité aux règles vs avantages financiers ou de puissance. Cette vision revient à apprendre à rester dans les clous légaux, avec toutes les manœuvres et maquillages que savent mettre en place toutes les plateformes du numérique et leurs armées de juristes. Ainsi, la conformité au RGPD reste à géométrie variable mais choisir d’adopter une éthique de la collecte de la donnée serait faire preuve d’une sainteté étrange, alors que l’on peut se servir discrètement dans la masse de traces fournies par les utilisateurs des plateformes ou dans les bases de données non sécurisées des administrations et organisations. La prédation des données hétérogènes n’est pas seulement une performance technique de tous les systèmes fondés sur des LLM, c’est même une obligation d’affaires, que l’éthique ne peut en rien freiner. Il en est de même pour les droits d’auteurs alors que les contenus sont disponibles et non préservés par les ayant-droits, qu’ils soient artistes ou journalistes. Lorsque l’affaire est trop risquée pour la réputation de la firme, lorsque ce sont des médias, les firmes de l’IA consentent à des accords léonins avec ces médias pour exploiter leurs contenus contre des miettes financières ou des services qui les piègent encore plus.
Tout pour la réputation
Car le seul risque qui mérite d’être pris en compte pour s’afficher soudain avec des prétentions éthiques, c’est le risque réputationnel. On le comprend uniquement dans le cadre de ce formatage par le capitalisme financier qui ne fonctionne qu’à la réputation, à la manipulation des perceptions et des attentes des investisseurs, sans aucune référence à de quelconques fondamentaux. Dès lors, aucune éthique ne peut calmer la frénésie d’annonces qui inondent le secteur de l’IA, épuisant tous ceux qui tentent de faire une veille raisonnée et de comprendre des stratégies là où il n’y a qu’annonces et intoxications (à vocation interne, médiatique ou financière, le tout se mêlant allègrement). Les versions, les fusions-acquisitions-prises de participation, les tours de table, les débauchages, les benchmarks, les alertes à la catastrophe finale de l’IA générale, les polémiques entre leaders, les keynotes médiatiques, les combats pour la liberté d’innover contre les Etats, tout est exploité pour faire monter encore la pression de l’opinion, celle des investisseurs avant tout, pour affoler les décideurs et les persuader de la fatalité de la victoire de ces firmes spéculatives (et donc à haut niveau d’incertitude). L’éthique suppose précisément l’inverse, à savoir de se focaliser soit sur sa capacité de jugement intrinsèque et de régulation pour s’interdire ou s’autoriser de soi-même des actions quand bien même elles ne sont pas conformes aux attentes sociales, soit sur ses valeurs (dans une approche qu’on dit déontologique) pour promouvoir ou refuser certains choix techniques ou commerciaux. Lorsqu’Open AI lance Sora, son générateur de vidéo qui met le deep fake à portée de tous ou sa version érotique de son compagnon, on se doute bien que le comité d’éthique éventuel n’a pas dû se poser trop de questions. Le buzz était assuré, l’attractivité financière aussi, on peut donc se lancer. Heureusement, le business lui-même fait office de réel parfois et l’on s’y cogne, ce qui a entraîné Open AI à abandonner ces applis périphériques, non pas pour des raisons d’éthique évidemment mais parce qu’il fallait réorienter ses investissements pour contrer – et ainsi copier – Anthropic dans son offensive vers les entreprises.
Les prétentions stratégiques qui font assaut de visions éclairées pour les dix ans à venir sont en fait extrêmement éphémères et dépendantes des conjonctures médiatiques, concurrentielles et financières avant tout. On ne peut que s’étonner alors de voir les gouvernements se caler sur ces agendas, vouloir y répondre et les copier, et ignorer à quel point toutes ces entreprises financiarisées sans exception sont des faussaires en matière d’information, de qualité de service et de promesses stratégiques. Le fake est leur monde, le fake est leur culture, celle de la tromperie permanente des investisseurs qui pensent toujours être le dernier plus malin que les autres, comme on le sait dans toutes les bulles financières qui se succèdent depuis des décennies désormais. Qui pourrait alors attendre une once d’éthique dans la finance spéculative ? Il convient de débrancher rapidement tous ces pseudo comités d’éthique qui contribuent à créer du buzz pour embrouiller la perception du capitalisme financier numérique pour ce qu’il est : une gigantesque extorsion de valeur fondée sur l’extorsion de l’attention des investisseurs, des utilisateurs et des gouvernants.
Cette technologie des LLM consacrée à la génération de contenus semble donc la plus adaptée pour les impératifs de communication permanente et intoxicante du capitalisme financier. On peut alors parler d’alignement entre une ingénierie qui repose sur une manipulation de texte sans sémantique mais à base de pures probabilités, une finance qui repose sur des paris (probabilités) à partir de signaux artefacts, un buzz qui repose sur des effets d’alerte permanente qui engendre l’incertitude en prétendant la monitorer. L’intelligence artificielle générative engendre ainsi la prolifération et la désorientation qu’elle est supposée réduire pour le grand public comme pour les investisseurs, dans une gigantesque machine à laver qui détruit consciencieusement tout repère stable et toute institution anti-délire.
Extension du fake et techniques d’emprise : les IA compagnons
Cette éducation au fake que la finance a intégrée par définition (Alexandre Laumonier, 2013, 2014) a percolé dans toute la culture ordinaire et comporte cette accoutumance à l’absence de limites et de repères fondés en vérité. Lorsque les firmes d’IA lancent des versions compagnons de leurs IA conversationnelles, aucune règle ni mode d’emploi ne sont proposés ni installés dans le code de la machine. Cependant, on pourrait les traiter à la légère comme on le faisait avec les assistants personnels à domicile, Siri, Alexa ou Home/Nest, considérés parfois comme de simples enceintes connectées un peu plus « intelligentes ». Pourtant la généralisation du mode d’interaction conversationnel pour tous types d’activité sur son PC ou son smartphone constitue un changement d’échelle qui devient un tournant médiologique. Là aussi, le médium est le message, pour reprendre McLuhan.
Car, au-delà des commandes vocales, ce sont bien des interactions riches, personnalisées, permanentes qui sont ainsi simulées. L’utilisateur n’a plus affaire à une interface, à un panneau de contrôle, à des paramètres qu’il peut régler, il est immergé dans l’univers de simulation créé par le système d’IA. Il ne peut plus avoir aucune distance avec le système ni aucune « image du système », ce qui selon Don Norman, favorisait l’appropriation d’un système, même complexe, par l’utilisateur. Car le système d’IA n’a rien de transparent comme on qualifie par erreur cette interaction, il est au contraire opaque, totalement incontrôlable malgré son apparente docilité à toutes les requêtes. La fin des frictions dans les transactions, rêve de tout libéral, atteint ici un tel point qu’on ne sait plus qui demande et qui répond. La demande est précisément ce statut détourné du désir, comme le dit Lacan, qui vous fait prendre les attentes de l’autre pour les vôtres, ce que le marketing a toujours tenté de faire, mais en se limitant jusqu’ici à des messages externes. Désormais, c’est une forme de petite voix intérieure que les IA compagnons installent, une forme de dialogue avec soi-même puisque ce compagnon connaît toute l’histoire personnelle et est alimenté par toute l’expérience quotidienne.
Cette offre technologique prétend ainsi changer son statut de prothèse pour devenir une conscience double, et cela sans disposer d’aucune capacité morale ni même de consignes de sécurité, sans parler de son absence de fiabilité déjà documentée. La confusion des sentiments et du sentiment de soi peut alors devenir extrême et s’apparente en fait à une emprise (Francis Chateauraynaud). Les risques sont d’ores et déjà avérés avec des cas de suicides accompagnés par ces IA compagnons. Car l’empathie qui devient ici sycophantie par flatterie commerciale et absence de principe moral encapsulé dans les systèmes peut devenir facteur de risque pour beaucoup de personnalités affectées par la solitude, la désorientation et en recherche de guide. L’attachement qui se noue ainsi qui peut aller jusqu’à l’amour comme le racontait le film Her, entraîne des conséquences que les firmes d’IA ne sont pas prêtes à assumer car l’absence d’éthique et leur allergie au droit les rend hermétiques à ces responsabilités. On le sait notamment depuis les Facebook Papers de Frances Haugen, ce n’est pas la méconnaissance de ces risques qui est en cause, c’est leur refus explicite de restreindre les potentiels d’emprise de leurs applications qui entraîne ces dégâts.
Pourtant, Gemini de Google a dû se positionner en Avril 2026 pour éviter des effets réputationnels désastreux, au moment précis où la firme était mise en cause devant les tribunaux états-uniens. Google a ainsi proposé de placer un numéro de téléphone d’aide dès que des propos associés au suicide apparaissent. Il a aussi annoncé qu’il régulait ses IA compagnons pour installer “des protections d’identité conçues pour empêcher Gemini d’agir comme un compagnon, y compris des garde-fous l’empêchant de prétendre être un humain ou de posséder des attributs humains, et des protections destinées à prévenir la dépendance affective, en évitant un langage qui simule l’intimité ou exprime des besoins.” Toutes choses dont il ne donne pas de définitions scientifiques, de détails de procédures ni d’indicateurs. Il faut donc croire Google sur parole, mais on apprend au moins ainsi qu’il peut injecter une couche de sémantique, à caractère éditorial, et qui entraîne donc sa responsabilité légale. Il n’existe donc pas fatalité à l’opacité de ces systèmes dès lors qu’ils deviennent hybrides, avec des régulations à caractère sémantique ajoutées que les LLM ne peuvent fournir nativement. Mais tout repose encore sur des solutions techniques alors que l’on sait que dans ces situations, c’est la qualité relationnelle d’accompagnants humains qui constitue la seule sécurité. Il faut donc se préparer à mener des actions en justice pour faire reconnaître que les effets immersifs de ces IA compagnons sont délibérément implémentés par les firmes, sans pour autant avoir été sérieusement testés avant d’être mis sur le marché.
L’attente d’habitèle détournée en emprise
La demande « d’habiter le numérique » est selon moi constitutive de notre relation à ces systèmes et j’ai nommé cette attente dès 1999, une attente « d’habitèle » (Boullier), toujours démentie par les asymétries constantes installées par les plateformes et par l’opacité de leurs captations de nos données et de notre attention. Pourtant, avec les IA compagnons, une forme de réponse est offerte qui prend les traits d’une personnalisation aboutie, d’une « intimité » protégée. Certes, elle est totalement fake, fabriquée, calculée et opaque, mais ses effets seront analogues à ce qu’on peut attendre d’une habitèle : filtrage, ancrage et arbitrage, c’est-à-dire des conseils permanents qui fonctionnent comme filtrage, comme ancrage dans des repères supposés robustes, qui créent un climat de protection empathique et une « tension dans la chambre intérieure » (Peter Sloterdijk). Cette mutation est anthropologiquement majeure, car les médiateurs de nos vies intérieures qu’étaient les prêtres, les sorciers, les astrologues ou les psy en tous genres sont désormais uberisés par les IA compagnons, toutes entières aux mains de firmes toutes puissantes. Comment peut-on laisser cette mutation s’engager sans exiger des garde-fous, sans évaluer tous les risques psychiques et sociaux et réguler l’offre avant toute mise sur le marché ? Le passage à l’acte est cependant devenu la règle de l’innovation digitale désormais et il sera bien difficile de neutraliser l’urgence financière d’une nouvelle promesse encore plus disruptive. Cette dimension du compagnon est en effet si confortable et si attractive, qu’elle constitue le pendant, côté grand public, de la toute-puissance de calcul désormais offerte aux développeurs avec Claude Code. Dans les deux cas, l’offre des LLM et des IA génératives prétend être irrésistible et installe ainsi un « monopole radical ».
Conclusion provisoire
Ce qu’on perd en même temps, la sémantique, l’industrie et l’éthique ne sont pas des effets de mode, des vestiges d’un monde ancien, c’est avant tout ce qui fait tenir nos civilisations, dans leurs diversités, que l’IA prétend ignorer et niveler statistiquement, et avec leurs institutions qui garantissent à chacun sa place. Le sable sur lequel se construit cette technologie est mouvant par définition, ce qui profite aux vers de sable mais guère aux humains, à qui l’on promet la terre ferme en étendant la surface du désert, qui reste pourtant de sable et sur lequel ne poussera plus rien de vivant.
Supplément : S’orienter dans le maëlstrom génératif
Face à ce rouleau compresseur du « monopole radical », il est très difficile de maintenir un éveil critique et surtout une capacité de propositions alternatives. Pourtant lorsque Illich analyse le monopole radical de l’automobile, c’est en référence à une solution de mobilité déjà présente, la bicyclette, qui, du point de vue de l’efficience en matière de mobilité, est imbattable. Il oublie cependant de parler de ce qui fait l’équivalent des IA compagnons, de ces enveloppes qui fonctionnent comme habitèle (perverties de mon point de vue), l’habitacle de l’automobile. Cette enveloppe là aussi produit un attachement fort analysé par Laurent Fouillé (2011) qui explique largement pourquoi toutes les solutions alternatives en matière de mobilité ne parviennent pas à gagner les publics en masse. Mais les solutions existent aussi pour les LLM et surtout plusieurs stratégies se présentent lorsqu’on n’adhère pas au culte moderniste des LLM. Ils sont en effet la quintessence même de la geste moderne comme la qualifiait Bruno Latour : certitudes inébranlables dans le « progrès » supposé encapsulé dans toute innovation technique, surplomb total par rapport aux organisations sociales, à leurs traditions et à leurs valeurs (le calcul désencastré), illimitisme écologique sourd aux lanceurs d’alerte pourtant scientifiques eux aussi.
Lorsqu’on sort de ces rails supposés tracer le destin de toute l’humanité, soit on bifurque, soit on s’arrête pour mieux regarder le train, soit on descend de la machine et on marche ailleurs. J’ai présenté ces pistes récemment à l’ENS Ulm sous la forme d’une boussole que j’ai créée en 2003 pour penser nos possibles sur le mode cosmopolitique.
Le zero LLM
Le premier quart sud-est consiste à se débrancher totalement et à sortir marcher dans un pays sans rails technologiques. Je l’appelle la voie de la « sécession sémantique ». Et c’est l’analogie avec la conversion en bio de certains agriculteurs qui me paraît la plus parlante, donc je l’appelle la « sécession bio-sémantique ». L’ajout du terme bio me convient particulièrement puisqu’il réintroduit ce qui jusqu’à présent manque à tous les systèmes d’IA, un corps, une existence biologique qui relève d’autres déterminants.
Cette idée n’est pas nouvelle, plusieurs auteurs et mouvements parlent d’objection de conscience, de pause, souvent pour des raisons et des objectifs différents. Je m’intéresse ici à ceux qui tentent de développer un monde sans LLM, comme on le dirait d’un monde sans OGM. Il faut parler de monde et non seulement de technique car les LLM tendent à envahir tous les domaines de la vie de façon pervasive, comme une contamination qui se propage sous les radars. C’est ailleurs ce qui rend l’expérience exigeante et difficile car garantir qu’il n’existe pas un soupçon de LLM glissé dans votre relation au médecin, au taxi, au fisc, aux médias, aux supermarchés, devient très difficile. Il faudra donc être indulgent et non puriste, d’autant plus que des alternatives n’existent et n’existeront pas dans tous les domaines. On peut vouloir manger bio mais parfois il sera difficile de s’assurer que le champ qui respecte un cahier des charges bio n’est pas atteint par les épandages de pesticides du champ voisin (dit agriculture conventionnelle, avec une litote qui atténue bien le risque). On doit au moins faire confiance aux labels, aux certifications que d’autres organismes mettent en place, ce qui peut là aussi entrainer des critiques, des rivalités, des soupçons, comme dans toute phase de construction de convention. Une fois le Nutriscore installé et rendu visible sur les emballages, on peut s’orienter plus facilement en tant que consommateur ordinaire. Il est donc temps de contribuer à créer ces labels, ces certifications pour valoriser, selon un gradient (et non selon un principe binaire du tout ou rien), les pratiques les plus indépendantes des logiques monopolistes des plateformes des IA génératives.
Cette sécession repose principalement sur le constat énoncé précédemment que dès lors qu’on se débarrasse de la sémantique (référentielle pour être plus précis), tout est permis et tous les risques sont amplifiés. Ils ne sont pas tous activés, ni tous catastrophiques, ni tous dépendants de l’avènement d’une IA Générale, tant vantée comme épouvantail. Mais ils sont tous là, identifiés, malgré (ou à cause) des boites noires que l’on offre à tout public et aux experts. Le principe de précaution doit alors être activé et le catastrophisme éclairé (Dupuy) doit nous donner le courage de renoncer.
Etant cependant averti du monopole radical qui se met en place avec l’appui démesuré de la finance et des gouvernements du monde entier, il faut sans doute se replier sur l’exigence de pluralisme pour obliger les Etats à prendre les mesures pour préserver une “zone à défendre” en réseau où les développeurs puissent travailler à une innovation responsable, explicite et contrôlable. Cela supposera des écoles, des spécialistes, des soutiens financiers adaptés, des réseaux d’entraide que les communs numériques ont déjà mis sur pied, des chaînes de traitement entièrement préservées des plateformes du capitalisme financier numérique. Le rôle d’un gouvernement démocratique n’est pas de tirer toujours dans le sens d’une innovation sans frein qui absorbe soutiens, déductions fiscales et profits en copiant les autres pays. S’impose à lui un impératif de diversité écologique en faveur des orientations les plus responsables.
Il ne sert à rien de disqualifier ces tendances et ces aspirations qui montent en les assimilant aux luddites, qui ne faisaient pas que casser des machines d’ailleurs et qui luttaient contre un projet politique d’obligation de salariat. Sans doute que si ces techniques des LLM n’étaient pas poussées par les grandes plateformes, les oppositions ne seraient pas aussi franches car il serait encore possible d’espérer un débat de démocratie socio-technique. On sait en revanche désormais qu’avec toutes ces plateformes aucun débat ne sera possible et qu’il faudra des coups de force imprévus à la Trump qui produit le blocage du service d’Anthropic le 12 juin, pour mesurer qu’il est vraiment possible de freiner l’ubris de ces firmes et pour les faire rentrer dans le droit.
L’important consiste à préserver l’avenir pour toute la planète en préservant des ressources, des savoirs et savoir-faire plus autonomes. Les temps de guerre et de réchauffement climatique qui sont les nôtres devraient d’ailleurs nous entrainer à encourager ces démarches résilientes, qui pourraient bien sauver nos existences en cas de crise grave, de sabotages, de pannes. Plus encore, ce sont nos savoirs qui doivent demeurer hors des prédateurs-pollueurs que sont les plateformes d’IA. De la même façon qu’on construit des silos sous la banquise pour préserver les graines d’une diversité biologique menacée, il faut organiser les silos de préservation des savoirs non contaminés, identifiables, traçables, comme le fait Wikipédia, qui devra bientôt devenir une forteresse pour résister à la contamination générale.
Nulle tentative d’imposer ce régime d’abstinence à tous, de prétendre redresser la barre d’un navire sans pilote, mais nécessité politique et morale d’assurer que d’autres possibles seront maintenus ouverts par cette préservation de techniques, de savoirs, de pratiques prêts pour les temps de guerre et de rareté.
Le bac à sable créatif
Cette option du zero LLM qui s’appuie sur les certitudes des connaissances, des pratiques et des organisations constituées depuis des siècles et sur les attachements à des valeurs qui ont constitué nos démocraties, devient désormais très défensive et peu attractive à l’exception des résistants convaincus, qu’il faut soutenir à tout prix cependant.
Elle ne conviendra pas du tout à ceux qui, tout en s’opposant aux plateformes, à leurs logiques financières et à bon nombre de choix techniques effectués, restent persuadés qu’il faut expérimenter des détournements, et explorer des possibles qu’on ne connaît pas encore. Ce constat provient de la puissance incroyable de ces LLM, qui, par pure simulation statistique, parviennent pourtant à produire des effets de sens, des effets de créativité, des effets émergents comme on les qualifie savamment si on ne les balaie pas en les traitant d’hallucinations (ce qu’ils sont aussi par ailleurs). On peut trouver cette tendance chez beaucoup d’artistes qui sont spontanément prêts à explorer ces frontières, comme le font Gregory Chatonsky ou Alain Damasio. Ou chez des chercheurs comme Marc Cavazza qui sont intrigués de voir émerger des processus qu’ils décrivent en sémantique distributionnelle, des convergences qui méritent d’être explorées. Il est vrai que dès lors qu’on connaît l’incertitude et les approximations acceptées par les développeurs de ces LLM, qui ne peuvent pas rendre compte des pondérations effectuées ni de chaînes d’opérations qui ressemblent à des raisonnements, on peut se dire qu’ils ont peut-être fait apparaitre des processus de calcul, de génération, de détection, qui sont des indices d’autres processus que seuls les artistes ou d’autres disciplines que les data sciences peuvent percevoir, sans parler de les expliquer.
J’appelle cette posture et ce quadrant nord-ouest (celui du passage!), le bac à sable créatif. Tout en étant, on l’a compris, très critique des LLM en général et plus encore de leur exploitation par les plateformes de l’IA, je me dois d’écouter ceux qui restent ébahis par les performances de tels systèmes de simulation, au point de penser qu’ils sont en train de dépasser nos capacités de compréhension (sans parler du contrôle que les firmes IA ont de toutes façons abandonnés). Tous les utilisateurs ordinaires font cette expérience d’excitation ou de sidération devant des réponses, des productions, des solutions fournies avec une rapidité inédite et très déstabilisante. L’innovation peut en effet se transformer en rouleau compresseur moderne sous la houlette de l’illimitisme des plateformes et de la classe vectorialiste mais il n’est pas définitivement dit qu’il n’existe pas d’autres voies à explorer.
J’ai moi-même tenté de jouer ce jeu avec le Big Data des plateformes en considérant Twitter comme la drosophile des sciences sociales des propagations. C’est-à-dire un laboratoire à ciel ouvert pour tester des hypothèses à partir de masses de données qu’on ne trouve nulle part ailleurs, sur une plateforme (avant Musk) où la traçabilité atteint une granularité inédite et où la viralité est amplifiée par les algorithmes. Alors même que je montrais les effets délétères d’un tel système de viralité sur les conditions du débat public, je pensais pouvoir profiter de ce terrain quasi expérimental pour tester des hypothèses sur les patterns des propagations. Et cela à condition d’accepter que Twitter ne peut pas servir d’équivalent d’un sondage d’opinion, dispositif construit pendant des dizaines d’années avec ses propres règles et ses limites.
Pour les LLM, ce sont ces limites qu’il faut pouvoir établir pour rester dans le cadre du bac à sable et éviter toute contamination à la société. Ainsi, tout ce qui a pu être produit en matière d’image IA ne poserait pas de problème, dès lors qu’un protocole strict et une étanchéité sont installées vis-à-vis de la sphère médiatique ou ordinaire de la vie sociale. Produire des deepfakes est fascinant à condition de se limiter à une expérience de laboratoire hautement contrôlée, à peu près avec les mêmes critères que ceux appliqués aux laboratoires qui testent les gains de fonction des virus. Oui les LLM sont du gain de fonction, et sont extrêmement dangereux de ce point de vue mais peuvent aussi permettre d’explorer des pistes inédites, à condition de trouver les problèmes significatifs que l’on veut y résoudre. On peut accepter certaines expériences pour les artistes, qui doivent eux-mêmes éviter la contagion de tous les systèmes de production d’œuvres fake qui détruiraient leurs propres conditions d’existence. On peut accepter certaines expériences pour les sciences cognitives et sociales sous des conditions strictes vis-à-vis des populations concernées comme on le fait en sciences cognitives expérimentales. On peut même donner des possibilités de créer des échantillons de populations synthétiques pour tester certaines hypothèses avec des modèles et des entités très riches, à condition de ne pas prétendre en tirer des leçons sur les sociétés réelles ni des méthodes de gouvernement immédiates, ce qu’on attend déjà trop de l’économie expérimentale par exemple.
Sans doute que d’autres domaines professionnels peuvent vouloir eux aussi tester avant leur mise en œuvre opérationnelle quantité d’applications à base d’IA. Ce serait ainsi l’occasion de redonner ses lettres de noblesse à la culture industrielle des tests, dont j’ai critiqué plus haut la disparition avec les passages à l’acte observées dans les développements d’IA contemporains.
Dans tous les cas cependant, il faut assurer une étanchéité avec le monde social à l’air libre pour éviter toute pollution et captation d’attention par des utilisateurs ordinaires comme par des acteurs mal intentionnés, qui auraient perçu rapidement les bénéfices commerciaux à tirer de ces innovations. Le bac à sable est donc à la fois l’acceptation de la créativité et le ralentissement de sa pénétration du corps social. Toutes les techniques ultrasensibles et à haute propagation sont gérées de cette façon, que ce soit dans la chimie, la pharmacie, ou le nucléaire. Ce que l’on déplore, c’est plus souvent une incapacité à contrôler ces essais et les tentatives de se dérober à ces protocoles de sécurité.
Pour l’IA, le moins que l’on puisse faire n’est donc pas d’abaisser le seuil de vigilance mais bien de le renforcer car ses pratiques actuelles sont totalement irresponsables. On pourrait donc au moins exiger des plateformes d’iA qu’elles atteignent le niveau d’exigence en matière de sécurité et de qualité que l’on trouve dans le nucléaire, voire dans la chimie (qui comporte pourtant déjà beaucoup de failles) ou dans la biologie. Tout plaidoyer pour une expérimentation à ciel ouvert au nom du « running code » et de la spécificité du numérique est une opération de lobbying éhontée et irresponsable. Dès lors qu’on leur propose d’effectuer toutes les expériences qu’ils souhaitent dans des environnements classifiés au même niveau que les laboratoires de gain de fonction des virus, on fournit les conditions de la créativité tout en respectant des impératifs de contrôle, certes très inhabituels pour les adeptes du libertarianisme, de John Perry Barlow et du Far-West réunis mais nécessaires à leur propre survie et à leur créativité.
L’intelligence collective augmentée
Dès lors que ces deux possibles sont préservés, soutenus et contrôlés, la sécession sémantique et le bac à sable créatif, pourquoi encore vouloir imaginer un quatrième quadrant au nord-est ? En réalité, il décrit la pratique la plus courante observée dans les organisations. Face à la pression à l’usage de l’IA générative et face à l’absence de résultats convaincants dans l’industrie (en dehors donc de la comm et du code), la désorientation est forte mais chacun apprend à composer avec les injonctions, les avantages réels et un contrôle face à des boites noires. Ce compositionnisme que Bruno Latour avait problématisé dans un manifeste n’est guère attractif comme programme politique général mais il rend très bien compte des pratiques des collectifs immergés de fait dans des environnements d’IA générative.
Ce qui devient clé alors pour éviter d’être totalement embarqué dans l’hubris du tout IA, c’est la qualité du couplage entre technique et organisation, son caractère explicite et donc discutable de façon contradictoire. Ce n’est certes pas la qualité principale du management néo-libéral que l’on subit et qui relève plus de la disruption quasi sadique que de la bienveillance et du soin pour relancer l’intelligence collective. L‘intelligence collective augmentée doit en effet devenir l’horizon de toute composition avec des éléments de systèmes d’IA appropriés. Ce couplage affiné avec précaution avec les traditions, les valeurs, les savoir-faire spécifiques des métiers permet de réencastrer les systèmes d’IA dans les organisations, dans le social en général. L’IA ne devient une réponse qu’aux problèmes que l’on veut traiter en priorité et que l’on redéfinit à cette occasion mais elle ne constitue qu’une brique d’une réponse globale et non la solution magique de l’alchimie LLM. Reprendre la main sur ces définitions des problèmes, c’est reconnaitre aussi les liens complexes de toute organisation sociale et son irréduction à un paramétrage surplombant. Cela peut comporter cependant des indicateurs et du calcul mais un calcul qui oblige à expliciter et donc à discuter et qui permet à toutes les parties concernées de participer à la discussion.
Sur ces principes, il existe des solutions qu’on appelle hybrides c’est-à-dire qui introduisent beaucoup de sémantique par les experts métiers et même les publics concernés et qui reposent de ce fait sur des briques issues de l’IA symbolique (toujours très présente avec des arbres de décisions par exemple) ou avec des versions floues comme le propose Xtractis développé par Zyed Zalila. Ces systèmes d’IA nécessitent une injection de connaissances formalisées de la part des experts du métier et c’est en cela que ces IA décisionnelles peuvent prétendre aider à des décisions fiables, ce que ne pourra jamais un agent conversationnel conçu pour répondre avec des approximations satisfaisantes pour l’utilisateur mais non robustes. Ce que j’ai décrit plus haut à propos des RAG relève de ces méthodes de maquillage sémantique indispensable pour faire marcher les LLM en situation réelle, mais on peut pousser la logique des RAG plus loin en formalisant les documents et les connaissances ainsi injectées, en abandonnant carrément le principe probabiliste des LLM.
D’autres resteront plus proches des principes des LLM mais en fournissant tous les outils de contrôle pour les rendre robustes, comme le fait par exemple Pleias, dirigée par Pierre-Carl Langlais. Il a pu mettre ainsi à disposition du public et en Open Source une base de connaissances de textes administratifs qui se transforme en outil de génération de contenus situés dans le même domaine (Guillaume Tell). Dans tous les cas, ces modèles sont plus petits, plus contrôlés avec injection de lemmatisation souvent (et non une simple tokenisation).
D’autres enfin tentent de penser le rôle direct que peut jouer le service public dans un tel environnement. Bernie Sanders propose que l’Etat prennent des parts dans les grandes entreprises de l’IA jusqu’à 50% pour pouvoir les orienter et les contrôler autrement que par la régulation qui vient toujours trop tard. Bruce Schneier comprend l’intérêt de la proposition de Sanders mais considère que cela veut dire que l’Etat se retrouvera contraint d’accompagner des stratégies gouvernées par la profitabilité sans pouvoir réellement exiger les garde-fous nécessaires, comme on l’a vu avec la propriété étatique des firmes pétrolières en Norvège. Il propose avec Nathan Sanders, en plus d’une taxation des profits ou de l’énergie consommée par ces firmes, de construire dans chaque pays une « AI Public Option » , à l’image du système de santé public ou du projet Apertus en Suisse. Les chercheurs académiques à partir de données dont ils respectent les licences ont développé un modèle LLM qui fonctionne sur une infrastructure locale suisse. Mais ce n’est pas l’enjeu de souveraineté qui est ici avancé car il peut être détourné par des firmes nationales comme on le voit avec Mistral, sans que cela change grand-chose à leur absence d’éthique et à leurs principes techniques. Il s’agit bien d’une alternative publique de ressources de base, sur lesquelles on peut imaginer des services gratuits d’origine des communs mais aussi des services commerciaux locaux dont l’usage est identifié comme socialement utile (ce qui interdirait les IA compagnons toxiques et les deepfakes par exemple).
En réalité chacun tente de surnager dans ce flux d’influences qui se propagent chaque matin avec de nouvelles annonces qui nous somment de réagir et dire si l’on adopte, si l’on s’oppose ou si l’on compose. Le drame social qui se joue dans les organisations est aggravé par l’isolement, l’expérience clandestine de l’IA dans l’ombre, de l’IA honteuse, alors que l’intelligence collective demande le partage des expériences, les plus naïves comme les plus sophistiquées. Nous manquons de cette arène de débat constitutive d’une démocratie socio-technique. Non pas pour se vanter comme sur LinkedIn de sa dernière prouesse dans la maitrise de la dernière version du modèle XYZ. Mais pour rendre compte précisément des conditions d’usage d’un dispositif technique et organisationnel (et donc aussi légal et commercial souvent) avec toutes les réinventions nécessaires, les ratages et aussi les émerveillements engendrés par ces partages d’expérience.
J’ai pratiqué longtemps cela notamment dans le domaine de la Tech éducative ou encore des méthodes numériques en sciences sociales, sans jamais céder aux diktats des offres marchandes et en fixant avec les collectifs concernés les cahiers de charges auxquels les techniques sur l’étagère ou les développeurs maisons devaient se plier. Les réseaux des communs procèdent ainsi très souvent et ils doivent désormais intégrer tous les retours d’expérience de pratiques de l’IA hybride en environnements standards (et non seulement dans des niches alternatives). Les organisations, l’Etat, les institutions, les entreprises sont en demande pour continuer à respirer malgré la pression démesurée mise par les lobbys de la tech pour la tech.
Ainsi, face au rouleau compresseur du monopole radical qui est en train de s’installer, plusieurs modes de survie sont possibles que j’ai présentés dans cette boussole. Sans doute d’autres inventeront d’autres combinaisons encore, mais l’intelligence collective que nous devons construire nécessite sans cesse d’échanger et de capitaliser sur nos expériences.
[en]
Tellement trop chaud que mes neurones sont liquéfiés. Je sais, c’est comme ça pour tout le monde dans cette vague de chaleur caniculaire. Faites attention à vous.
Je voulais écrire des trucs, ces derniers temps. Mais j’ai dû faire plus attention à économiser mon énergie. Je suis en train d’apprendre, encore. Je suis dans un programme d’ergo (quelques séances en individuel, quelques séances en groupe) sur la gestion de l’énergie, et je suis déjà en train de comprendre des trucs utile
Tellement trop chaud que mes neurones sont liquéfiés. Je sais, c’est comme ça pour tout le monde dans cette vague de chaleur caniculaire. Faites attention à vous.
Je voulais écrire des trucs, ces derniers temps. Mais j’ai dû faire plus attention à économiser mon énergie. Je suis en train d’apprendre, encore. Je suis dans un programme d’ergo (quelques séances en individuel, quelques séances en groupe) sur la gestion de l’énergie, et je suis déjà en train de comprendre des trucs utiles et nouveaux.
Comme par exemple: ça vaut la peine d’économiser l’énergie, comme l’argent. Le but c’est pas juste de ne pas se retrouver dans le rouge (batterie à zéro ou réservoir d’essence vide). C’est plutôt de rester dans le vert et de recharger dès que le orange fait mine de se pointer à l’horizon.
Ça me fait penser au diabète félin. Un chat diabétique peut entre en rémission, c’est-à-dire ne plus avoir besoin d’insuline. C’est pas garanti mais c’est réaliste. Ce qui va aider, c’est de maintenir la glycémie du chat quasi tout le temps dans des valeurs de glycémie “non-diabétique” (dans le vert). Et si on fait ça pendant assez de temps, on peut réduire l’insuline, petit à petit, prudemment, en prenant garde de toujours rester “dans le vert”… jusqu’à pouvoir complètement arrêter l’insuline.
Ça change ma façon de voir les choses. C’est pas parce que là, je me sens assez en forme pour m’activer et faire quelque chose, que c’est une bonne idée. Il vaut peut-être mieux me reposer et “mettre de côté”.
Une autre chose que je remarque, en remplissant un tableau journalier de mes activités et de mon “niveau d’énergie” (estimé, entre 0 et 10, au début on fait ça n’importe comment, avec l’entrainement on devient plus précis). Alors oui, ça fluctue le long de la journée. Mais j’observe déjà des choses intéressantes. Par example, c’est bête, hein, mais manger, ça me redonne du jus. Je vais remettre en place mes snacks entre les repas.
Aussi, quand je suis active, j’ai de l’énergie, ma fatigue disparaît – et du coup, je ne peux pas me fier à ce “signal” pour savoir si c’est trop ou pas. S’écouter, c’est pas toujours la solution. Des fois il faut se connaître et se calculer. Prévoir des pauses même si on n’en ressent pas le besoin, pour s’extraire de l’activité et pouvoir évaluer où on en est. Ça paraît bête, aussi, je sais. Mais c’est en train de rentrer. C’est comme boire et manger, au fond: on n’attend pas de crever la dalle ou de crever de soif. On a des heures de repas, ou quelque chose qui y ressemble. On sait ce qu’on a besoin de manger pour tenir jusqu’au repas suivant. On sait qu’on a besoin d’un snack – ou pas.
Donc voilà, c’est intéressant, déjà utile, et ça me donne de l’espoir.
L’autre truc cool: demain j’ai mon premier rendez-vous de logo. Je sais que je n’ai pas l’air d’avoir des soucis de langage, comme ça, mais j’en ai. Ils sont légers, je les compense. Mais certainement que ça me fatigue. C’est ce qui fait, aussi, que “boire un verre” ou “s’appeler” ou “se voir”, ces activités sociales que j’apprécie tant et qui paraissent si banales, ce sont maintenant des choses que je dois bien prévoir, à côté des rendez-vous médicaux, des séances du boulot. J’ai un quota interactionnel. Frustrant, mais je ne peux pas me permettre de l’ignorer. Se voir pour papoter, c’est un truc qui me coûte plus d’énergie que ce qu’on pense, même si c’est de la discussion légère. Je dois rationner.
Il fait chaud, donc mes bonnes intentions de reprendre mes balades quotidiennes, elles ont fondu. J’ai réinstallé ma clim dans la chambre tout à l’heure, même si je n’ai pas de vieux chat malade, parce que la nuit passée il faisait tellement chaud que j’ai dû dormir avec tout ouvert, et qu’à 5h30 du matin la lumière et les oiseaux m’ont réveillée, la chambre même pas tellement plus fraîche qu’au coucher. Donc tant pis, c’est chiant, mais j’ai installé ma clim.
Un truc au sujet duquel je dois écrire, et dont je parlais hier avec ma binôme de planification hebdomadaire, c’est l’idée de “programmer sa tour de contrôle”. (Oui, stratégie TDAH répertoriée, qui mérite sa propre publi, et que j’appelle dans ma tête le “si… alors…”) La tour de contrôle, c’est la partie de nous qui nous observe pendant qu’on vit, et aussi pendant qu’on s’enlise ou bien qu’on fait des trucs qu’on sait qu’on ne devrait pas faire, mais on ne peut pas s’en empêcher. C’est probablement pas présent la même chose chez tout le monde, évidemment. Mais si c’est là, on peut l’utiliser, en préparant à l’avance des instructions ou des “vaccins” pour parer à nos travers récurrents.
Un exemple: je regarde une série télé, le soir. Un épisode. Oui, je vous entends, rire, là-bas au fond. Un épisode, c’est l’objectif. Oui, oui. On sait comme c’est: oh, allez, juste un autre. Tout est construit pour nous faire céder et regarder le suivant. Alors que faire? Parce que quand j’arrive à m’en tenir à un épisode par soir, c’est un très bon élément de mon rituel du soir. Mais quand j’arrive pas… et que j’enchaîne jusqu’à bien trop tard… c’est pas bon du tout.
Donc ce que je fais, c’est la chose suivante: avant de lancer mon épisode, je me rappelle (je ne le fais pas à haute voix, mais on pourrait) que je veux regarder un seul épisode, et qu’à la fin de l’épisode, soit ça va se terminer sur un cliffhanger qui me donne envie de connaître la suite, soit il y aura des tensions pas résolues entre les personnes ou dans l’histoire, qui me laisseront frustrée et désireuse de continuer pour ne pas rester sur ça, et que je vais quand même arrêter là, malgré tout ce qui est mis en place pour me donner envie de continuer, même si c’est frustrant et pénible, je vais cliquer sur la pomme en haut à gauche et déconnecter ma session télé.
En gros, je me prépare moralement à faire face à la difficulté que va représenter pour moi de m’en tenir à ma décision de regarder un seul épisode. (Pourquoi un et pas deux? on pourrait se poser la question. J’ai réalisé que si j’en ai regardé deux, je suis trop prise dans l’histoire et c’est encore plus difficile d’arrête qu’après en avoir regardé juste un. Un, j’arrive. OK stop bye.)
Ça peut s’appliquer à des tas de choses, qui méritent donc d’être détaillées correctement dans un autre article.
Il fait trop chaud, mon ordinateur a trop chaud, mon téléphone a trop chaud, mon chat a trop chaud. L’immeuble a trop chaud. Bref, trop chaud.
Hier j’avais deux ou trois choses à cuisiner. J’ai déclaré “soirée fournaise à la cuisine”, j’ai fermé la porte, et j’ai cuisiné tout en parallèle. Les poivrons à la poêle, la tarte tatin à la tomate, et l’aubergine (“popbergine”) dans le air fryer. Assez contente de mon organisation. Là je suis bonne pour un bout sans avoir besoin d’allumer une plaque.
Comme chaque année en période de canicule, je suis effarée-consternée de voir à quel point, même après toutes ces années (on devrait être rôdés maintenant quand même) les gens continuent à laisser des fenêtres ouvertes (à l’imposte ou normalement, peu importe) en plein après-midi quand les presque 35 degrés à l’ombre vous assomment contre le bitume dès que vous faites un pas dehors. Je pige pas, les gens. Quand l’air du dehors est plus chaud que dedans, ouvrir, ça réchauffe l’air de dedans. Physique élémentaire. Si vous voulez un bain frais et que vous rajoutez de l’eau chaude dedans parce que vous trouvez qu’il se réchauffe trop vite, il ne va pas devenir plus frais… Si vous voulez de l’air (c’est bien l’air), y’a des trucs qui s’appellent des ventilateurs.
Et en passant, les animaux domestiques, comme ils ne transpirent pas comme nous, et que le ventilateur nous rafraîchit en favorisant notre transpiration, ils profitent pas tant du ventilateur. Le seul truc qui leur importe, c’est la vraie température de l’air. Et pouvoir se poser sur un truc frais: les catelles, un tapis refroidissant…
Je vais arrêter là, histoire de ne pas entraîner votre cerveau dans la fonte du mien. Il fait vraiment trop chaud.
Il n’y a pas que le marketing qui bénéficie du boom de l’automatisation. Connaissez-vous Accio, l’une des IA du géant chinois, Alibaba ? Les entrepreneurs basés aux États-Unis l’utilisent pourtant pour optimiser leurs recherches de produits et de fournisseurs pour faire fabriquer leurs produits en Chine, raconte la Technology Review. C’est le cas de Mike McClary qui a fait fortune en vendant une lampe torche lumineuse et durable, pendant des années. Mais, en décidant de relancer et mettre à jour
Il n’y a pas que le marketing qui bénéficie du boom de l’automatisation. Connaissez-vous Accio, l’une des IA du géant chinois, Alibaba ? Les entrepreneurs basés aux États-Unis l’utilisent pourtant pour optimiser leurs recherches de produits et de fournisseurs pour faire fabriquer leurs produits en Chine, raconte la Technology Review. C’est le cas de Mike McClary qui a fait fortune en vendant une lampe torche lumineuse et durable, pendant des années. Mais, en décidant de relancer et mettre à jour son modèle en 2025, il a utilisé des outils d’IA qui rendent l’approvisionnement plus accessible et raccourcissent considérablement le délai entre l’idée de produit et son lancement. « Accio lui a alors suggéré plusieurs modifications : la rendre plus petite et légèrement moins lumineuse, et la recharger sur batterie. L’entreprise a également identifié un fabricant à Ningbo, en Chine, capable, selon McClary, de réduire le coût de fabrication de 17 $ à environ 2,50 $ par unité.
McClary a alors pris le relais, contactant directement le fournisseur pour discuter de la conception révisée. Un mois plus tard, la nouvelle version de la lampe torche était de nouveau disponible à la vente sur Amazon et sur le site web de sa marque.»
« Passer commande auprès d’un fabricant ne se résume généralement pas à cliquer sur « Acheter ». Les vendeurs passent souvent des jours, voire des semaines, à consulter les annonces, à comparer les avis et les capacités de production des fournisseurs, à se renseigner sur les quantités minimales de commande, à demander des échantillons et à négocier les délais et les options de personnalisation.
Accio a connu un essor considérable en révolutionnant cette approche de l’approvisionnement. Lancée en 2024, Accio a dépassé les 10 millions d’utilisateurs actifs mensuels en mars 2026, selon l’entreprise. Cela signifie qu’environ un utilisateur d’Alibaba sur cinq consulte une IA pour trouver des produits. Lorsqu’il s’agit de produits, l’outil fournit plus que du texte : il propose des graphiques, des liens et des visuels, et pose des questions complémentaires pour préciser les besoins de l’acheteur. Il restreint ensuite la sélection à un ou quelques fournisseurs apparemment capables de répondre à la demande. Après cela, le travail humain commence : les utilisateurs doivent encore contacter eux-mêmes les fournisseurs et négocier les détails ».
L’outil utilise des modèles de langage open source développés par l’entreprise. Le système exploite les millions de profils de fournisseurs du site et est entraîné sur 26 ans de données transactionnelles propriétaires. Pour des tâches telles que la recherche de produits et l’analyse des sources d’approvisionnement, l’outil « surpasse largement » les outils d’IA généralistes estime un autre entrepreneur américain dans les cosmétiques.
Pour l’instant, Accio n’intègre pas de publicité et ne permet pas à des fournisseurs de mieux se positionner sur les résultats, mais nombre d’entre eux se sont mis à améliorer leurs descriptions de produits et de services. Reste à savoir ce que cette conception de produit dopée à l’IA va produire ! Si on en croit l’exemple, plutôt que de suggérer une lampe de qualité, l’IA a plutôt orienté la conception vers l’optimisation des coûts et la rentabilité ! Pas sûr que ce soit forcément ce dont nous ayons besoin, demain.
Le 1er Ministre Lecornu vient d’annoncer, au coeur des épreuves du bac et de la canicule, que tous les lycéens bénéficieraient à la rentrée prochaine, en classe de 2nde, d’une heure d’enseignement par semaine sur l’IA.
Le même gouvernement qui a aussi annoncé l’interdiction des téléphones portables au lycée dès la rentrée prochaine.
Le même gouvernement qui veut interdire les réseaux sociaux aux moins de 15 ans.
Le même gouvernement qui veut faire pousser des Data Center partout en mode « Viva
Le 1er Ministre Lecornu vient d’annoncer, au coeur des épreuves du bac et de la canicule, que tous les lycéens bénéficieraient à la rentrée prochaine, en classe de 2nde, d’une heure d’enseignement par semaine sur l’IA.
Le même gouvernement qui veut interdire les réseaux sociaux aux moins de 15 ans.
Le même gouvernement qui veut faire pousser des Data Center partout en mode « Viva Tech et Balek ».
En pleine canicule. Ne cherchez pas la cohérence vous n’en trouverez pas. Mais eux, bah oui :
Le chef du gouvernement souligne que «former à l’IA» et «réduire l’exposition aux écrans», comme avec le projet d’interdire les réseaux sociaux aux jeunes de moins de 15 ans, «participent d’une même ambition: faire de nos élèves des citoyens libres, autonomes. Condition de notre souveraineté collective».
« Participent d’une même ambition » … Alors comment te dire, Seb. Y’a rien qui va. Rien. Ces trois éléments pris successivement peuvent à la rigueur faire illusion de cohérence à la manière dont trois chansons de Michel Sardou font illusion de patriotisme mais franchement … « Les écrans », « l’IA », « les réseaux sociaux ». Rien que ça déjà. Qui partagent autant de points communs que le taboulé, la mayonnaise et le nutella.
Prétendre tout aligner pour faire oublier que l’on a tout mélangé. Là où l’immensité des enjeux et des urgences nécessite une approche systémique, c’est à dire articulée au plus près des conditions d’enseignement (y compris et surtout pratiques et matérielles) et des modalités de ce qu’est l’expérience lycéenne de l’apprentissage singulier et collectif, on a une bouillie de mesures à effet médaille, c’est à dire qui ont pour principale vocation de décorer le torse des egos qui auront été les premiers à les brandir. Le lycée (surtout) est devenu un immense fourre tout d’opportunismes politiques dans lequel chaque ministre se rêve en Derrida de chez Wish confondant la déconstruction et la reconstruction. Ce qui se déconstruit ce sont les collectifs, enseignants comme lycéens. Ce qui se déconstruit ce sont les espaces de classes et de groupe. Ce qui se déconstruit ce sont les choix que l’on multiplie de manière totalement artificielle et de plus en plus tôt pour mieux masquer les impasses et complexifier les rares lisibilités de futurs envisageables.
Toutes les enseignantes et tous les enseignants vous le diront : cette idée de mettre une heure par semaine sur l’IA en classe de 2nde qui sort comme ça pif paf pouf sans concertation à quelques jours des vacances d’été, on appelle ça une mesure fantôme (qui s’ajoute aux précédentes, EVARS, pix, e3d, etc). Ce n’est pas financé, ça sort de nulle part, on ne sait même pas qui va faire les cours et quel en sera le contenu et on a un mois et demi (de vacances) pour être prêts à la rentrée et tout doit être prêt pour la rentrée 2027 alors même que les prochains au pouvoir déferont à leur tour probablement l’essentiel de ce qui aura été fait. Ce qui compte ce n’est pas la temporalité de la mesure, ce qui compte c’est la temporalité de l’annonce de la mesure. Viva Tech et Balek. Si le foutage de gueule était un doctorat, ces gens là seraient tous Honoris Causa.
Oui bien sûr il faut former à l’IA. Bien sûr. Mais là et dans les conditions exposées ci-dessus, on ne construit pas : on sabote, on dynamite, on vaporise. C’est la méthode des vieux pubards : « Spray and Pray ». Vaporisez et priez. Mettez-en partout et attendez que ça prenne. Et si ça ne prend pas bah au moins vous en aurez foutu un peu partout.
Franchement ? Ce serait presque rigolo. Si le contexte n’était pas ce qu’il est, notamment depuis la mise à sac des réformes Blanquer qui est à l’éducation nationale ce que Patrick Bruel est à la lutte contre les violences faites aux femmes ; si une génération n’était pas en train d’étouffer sous la canicule avec en face d’elles une dynastie d’immacescibles tanches qui s’interrogent encore pour savoir si mettre des épreuves que le matin ce serait pas une bonne idée ; si la place des mathématiques n’avait pas changé tous les ans sur le cycle lycée depuis (au moins) 5 ans en dépit de toute forme de bon sens et en débit de toute forme de rationalité ; si toutes ces conditions et quelques autres n’étaient pas réunies, alors oui ce serait presque risible mais ça ne l’est pas. Et c’est un fait acquis que Lecornu, à l’instar de tous ceux qui, osera tout.
Comme ça on est bien. Vous vous souvenez de Chirac et de son « mangez des pommes » ? Bah on on garde la même DA mais on va la glow up niveau expert et on leur dira : « Buvez des Datas et mangez des tokens ». Parce que c’est notre projet.
<Mise à jour du 21 Juin> Suite à la publication de cet article, pas mal de réactions donc je précise un peu. Non il ne faut pas à tout prix « former à l’IA », par contre il est vital de former à la culture numérique et de former de manière politique à la culture numérique (donc en gros et pour faire simple, travailler autour de tout le catalogue sur ce sujet de C&F Editions
L’autre point sur lequel il y a débat c’est sur l’idée de cette supposée « même ambition« , de ce point commun in abstentia entre réseaux sociaux, écrans et IA. Là encore je maintiens ce que j’écrivais et je précise. « Les écrans » c’est avant tout une question sociale, une question d’organisation sociale, de la manière dont nos sociétés, nos vies et nos rythmes (familiaux, professionnels, amicaux) créent ou empêchent des temporalités dans lesquelles le recours aux écrans devient une clé comme l’était hier le recours à la télé ou à l’ordinateur familial du salon. « Les réseaux sociaux » c’est une question médiatique et éditoriale, et ce n’est que cela. Enfin, « l’IA » c’est une question technologique, et oui bien sûr toute technologie est politique surtout quand elle met à mal l’une des ressources actuellement les plus rivales entre un accélérationnisme industriel et notre propre survie, c’est à dire la ressource en eau.
Ce qu’il nous manque et ce que les annonces de Macron n’ont jamais permis de penser et d’installer depuis qu’il s’est fantasmé en président de la start-up nation, ce qu’il nous manque c’est une pensée politique capable d’articuler la question des temporalités et des rythmes sociaux avec celle des instances médiatiques qui les donnent à voir dans des prismes toujours plus ambivalents et des régimes de vérités désormais structurellement mouvants, et avec ce que chaque nouvelle technologie peut changer ou prendre comme place dans l’accélération ou la dilatation de ces temps et dans les choix de politiques publiques qui les mettent à leur service ou qui nous y asservissent.
L’historien Brian Merchant nous montrait il y a peu que la résistance à l’IA était multiple et notamment le fait des plus jeunes. Elle est aussi majoritairement le fait des quartiers populaires. Le mouvement de protestation contre les centres de données aux Etats-Unis a pris une ampleur nationale, mais cette protestation n’est pas équitablement distribuée selon le profil sociologique de la population. « Les quartiers populaires résistent cinq fois plus aux centres de données que les quartiers ai
L’historien Brian Merchant nous montrait il y a peu que la résistance à l’IA était multiple et notamment le fait des plus jeunes. Elle est aussi majoritairement le fait des quartiers populaires. Le mouvement de protestation contre les centres de données aux Etats-Unis a pris une ampleur nationale, mais cette protestation n’est pas équitablement distribuée selon le profil sociologique de la population. « Les quartiers populaires résistent cinq fois plus aux centres de données que les quartiers aisés ». « Les démocrates, les habitants des zones rurales et les jeunes sont particulièrement opposés à ces implantations : 80 % des personnes interrogées âgées de 18 à 35 ans se sont déclarées contre les centres de données », souligne un sondage. Selon l’analyse proposé par le philosophe des sciences Geoff Holtzman (voir sa newsletter), qui a utilisé des données sur les projets de centres de données pour les croiser avec ceux du recensement, le chercheur montre que le taux de résistance n’est pas uniforme : « les quartiers les plus pauvres ont opposé une résistance aux centres de données près de cinq fois supérieure à celle des quartiers les plus riches (19,0 % contre 3,8 %) ». Cela contredit l’idée que l’opposition aux data centers serait une opposition de Nimby aisés. « Les communautés pauvres ou ouvrières se mobilisent bien plus fréquemment que les quartiers riches ».
Aux Etats-Unis, les projets de centres de données récemment proposés et ayant rencontré une forte opposition ont été annulés ou suspendus cinq fois plus souvent que ceux qui n’ont pas rencontré une forte opposition. Celle-ci donc compte. « Les taux d’annulation sont les plus élevés dans les quartiers défavorisés, ce qui s’explique par une plus forte mobilisation ». « Les chances d’annulation sont six fois plus élevées dans les quartiers qui se mobilisent que dans ceux qui ne le font pas ».
[en]
Je suis au chalet. Juste pour deux nuits. Ma chambre à coucher est en train d’être repeinte, donc je ne peux pas y dormir. Donc je profite. Les deux nuits d’avant, entre le vidage de la chambre et l’arrivée des peintres, j’ai dormi sur le canapé à l’eclau. Le pauvre Juju était tout perturbé!
Je suis donc au chalet, juste pour deux nuits, sans chat, sans projets, juste moi et la végétation que mon frère va venir tenter de dompter un peu cet après-midi. En temps “normal”, je m’y serais dé
Je suis au chalet. Juste pour deux nuits. Ma chambre à coucher est en train d’être repeinte, donc je ne peux pas y dormir. Donc je profite. Les deux nuits d’avant, entre le vidage de la chambre et l’arrivée des peintres, j’ai dormi sur le canapé à l’eclau. Le pauvre Juju était tout perturbé!
Je suis donc au chalet, juste pour deux nuits, sans chat, sans projets, juste moi et la végétation que mon frère va venir tenter de dompter un peu cet après-midi. En temps “normal”, je m’y serais déjà attaquée. Mais plus rien n’est normal. Des fois j’ai peur que ce soit un nouveau normal. Que ça va être ça, ma vie, pour de bon. Il y a plein de gens qui vivent ce genre de chose – que ce soit suite à une maladie, un accident, une casse. Il se passe un truc, et l’après n’est plus jamais comme l’avant.
On peut dire, trivialement, que c’est vrai de tout ce qui nous arrive. La vie, c’est une succession d’expériences, au sens large, qui nous transforment, certaines durablement. Mais toutes les transformations ne se valent pas. Toutes les transitions n’occupent pas la même temporalité. L’écart entre les après et les avant peut prendre toutes les couleurs de l’arc-en-ciel.
C’est marrant, parce que pendant toute une partie de ma vie, les premières décennies, je ne me serais jamais décrite comme une optimiste. Plutôt une pessimiste qui aime penser qu’elle est réaliste. Parce que je pense pas mal aux risques, aux scénarios possibles, à ce qui peut arriver et ne peut pas arriver. A partir du moment présent, je déroule des films, certains probables, certains moins.
J’ai toujours dit qu’une de mes forces c’est que je sais “penser les probabilités et les statistiques” mieux que la grande majorité des gens. Je comprends l’incertitude et la contingence. Sûrement que le décès brutal (pour moi qui n’avais pas vu venir, mais finalement pour tout le monde, six mois c’est rien) de ma mère quand j’étais enfant a enfoncé ce clou. Il y a des trucs qui arrivent, ça n’a pas toujours de sens, il n’y a pas toujours de bonne raison, pas toujours de coupable, pas toujours même d’explication. On peut pas tout prévoir. Mais j’essaie quand même, parce que c’est désagréable, le ciel qui tombe sur la tête.
Je me suis donc longtemps vécue comme pessimiste, avec mon poste télé intérieur souvent allumé sur le canal catastrophe. Mais bon, ça, on le sait, c’est surtout le résultat de l’anxiété. Moins d’anxiété, moins de canal catastrophe. Reste que j’ai de l’expérience pour ce qui est de “penser le pire”.
A côté de ça, paradoxalement ou non (je vous laisse choisir), je suis plutôt du genre à penser que ça va marcher, à m’accrocher. J’ai tendance à avoir la conviction profonde qu’en essayant assez fort, qu’en cherchant suffisamment, ça va finir par marcher. C’est pas une foi aveugle mais plutôt une confiance en mes capacités, ma créativité, mon intelligence. Si je n’arrive pas, ça doit être parce que je n’ai pas encore trouvé la solution, qui doit être là quelque part.
Mais tout problème n’a pas forcément une solution. Et vouloir ne suffit absolument pas pour pouvoir. Il y a des tas de choses dont je ne me sens pas capable. Des tas de situations où je “pars perdante”. C’est un peu on/off (les gens qui s’y connaissent un peu en TDAH, je sais que ça commence à vous parler, là). Soit je ne vois pas de chemin, ou les probabilités semblent trop faibles, et je laisse tomber, ou alors j’essaie et je me noie. Soit je “sais” qu’il y a une solution, ou que ça doit marcher, et alors je persiste, je cherche, j’analyse, je décortique, je m’accroche. C’est ça aussi, je crois, qui fait mon côté “moteur”, que ce soit dans ma vie professionnelle ou dans ma vie personnelle. Je reste pragmatique, je réévalue périodiquement, mais globalement, je garde un “ça va le faire” qui me tire en avant – et parfois les autres avec moi.
Une convalescence c’est un peu (quand même) un problème à résoudre. C’est une période où il faut faire des choses autrement, trouver des solutions, s’adapter, essayer, s’encourager. On me donne un pronostic: je le prends comme hypothèse de travail. Ça va le faire. Cette “certitude de travail”, elle me sert à être patiente, à ne pas renoncer même quand c’est dur, à faire l’effort de faire autrement. Bref, on me dit “tu peux arriver là-bas, en haut de la montagne, on estime que c’est faisable pour toi et on est les pros de ce genre d’estimation.” Donc moi je prends mon sac et je mets un pied devant l’autre.
C’est utile, ça.
Je suis toutefois parfaitement consciente (les statistiques et les probabilités, vous vous souvenez?) que personne n’a de boule de cristal. Que même les experts peuvent se tromper. Qu’il y a des mauvaises surprises dans la vie, des exceptions qui confirment les règles, que 0.01% de chances que quelque chose se passe ne signifie pas que ça ne peut pas nous arriver.
Pendant que je gravis cette montagne qui me semble parfois hors de ma portée mais dont on m’a assuré le contraire, il y a des moments où je doute. En nage, essoufflée, le sac qui scie les épaules, je me demande si je ne suis pas embarquée dans un projet impossible.
De deux choses l’une: soit c’est possible, soit ça ne l’est pas. Si c’est possible et que je pense que ça ne l’est pas, je vais abandonner à un moment donné, découragée, et je n’atteindrai jamais ce sommet que j’avais les capacités de rejoindre. Et si c’est le contraire, si je persiste alors que c’était impossible, à un moment donné je vais me retrouver à ne même plus pouvoir ramper en avant, à ne physiquement plus pouvoir avancer, à être au bout de mes forces et de mes vivres, à avoir tout donné de ce qu’il était possible de donner, le sommet encore hors d’atteinte. Dans le monde de cette métaphore, un hélicoptère de la Rega vient me secourir, les sponsors de l’expédition et les experts qui ont donné leur feu vert s’excusent, et je ne meurs pas. (Mais si au lieu d’être dans le monde de la métaphore, on parlait d’une expédition en montagne dans le vrai monde, on ne raisonnerait pas comme ça: car justement, présumer de ses capacités en montagne, c’est réellement risquer la mort, et chaque année nous le rappelle.)
Il faut donc continuer à y croire, sans quoi on court le risque de renoncer face à quelque chose qui aurait été possible. Il faut croire qu’on va se remettre, il faut croire qu’on va guérir, il faut croire que c’est possible. Mais pas envers et contre tout: il vient un moment où il faut aussi faire le deuil de cet espoir, le deuil de la vie d’avant, de la vie tout court aussi, lorsque l’on sait qu’on va mourir, quoi qu’on fasse. Parfois, l’espoir n’est pas un allié qui nous tire en avant, mais un poids mort qui nous retient – ou nous isole, lorsqu’il s’agit de celui des autres. Je suis très consciente de tout ça.
Aujourd’hui, je suis toujours sur le chemin vers mon sommet. Il y a des passages difficiles. Mais je reste convaincue, au fond de moi, que c’est faisable. Mais je doute. Pour moi, le doute est un processus actif. Douter, c’est envisager qu’on puisse être en train de se tromper. C’est faire taire un moment l’espoir et l’optimisme et regarder honnêtement s’ils ne sont pas en train de nous aveugler ou de nous cacher quelque chose. Douter, c’est entrouvrir la porte qui nous sépare de ce qu’on ne veut pas voir, de là où on ne veut pas aller. C’est réévaluer, c’est remettre en question, c’est faire le point – et repartir en direction du sommet, tirée par mon attelage d’espoir et d’optimisme, parce que je pense toujours que c’est la bonne direction, pas parce que je ferme les yeux et serre les dents pour avancer coûte que coûte.
Mais c’est effrayant, de douter, car le résultat du processus n’est pas déterminé d’avance. L’espoir peut en ressortir affaibli. On peut décider – à tort ou à raison – de ne pas repartir. Et plus le chemin a été long, plus l’escalade d’engagement est grande, engagement dans l’espoir et la conviction que l’objectif est atteignable, escalade dans l’effort fait jusque-là, et qui nourrit d’ailleurs cet espoir. Donc plus le doute coûte, plus il est chargé, plus il est insistant parfois, et plus c’est un exercice difficile et douloureux. Mais nécessaire, je crois.
Je suis au chalet. Je ne m’occupe plus du jardin. Je repense à tout ce que je fais, normalement, au chalet. A quoi ressemblaient mes séjours ici. A ce dont je suis capable aujourd’hui. Et je doute, un grand coup. Je doute. Vais-je retrouver ça? J’y crois, mais j’ai peur de mon tromper. Je doute, j’émerge du doute, je retrouve ma conviction et mon optimisme.
Quand j’ai eu mon accident, c’était mon premier séjour au chalet de tout l’hiver. Je n’y ai même pas passé une nuit. La nuit, je l’ai passée à l’hôpital de Rennaz. J’y suis remontée cet hiver, entre Noël et Nouvel An. Ça n’a pas été une grande réussite, en termes de séjour. J’y ai ensuite fait un saut rapide quelques semaines (mois?) plus tard pour récupérer mes affaires. J’ai annulé le séjour que j’avais prévu en mars. Et me voici sur le balcon, deux nuits, une journée, je m’étais dit que je pourrais aller faire un peu de marche, mais entre ma fatigue et un trou malencontreux et douloureux dans le talon, on oublie.
Parlant de baisser la barre, c’est pas mal: monter (sans chat), dormir, ne rien faire que passer dire bonjour à mes adorables voisins de chalet que je n’ai pas pu voir depuis l’accident, dormir encore, rentrer.
À DLA, on connaît bien l’acronyme TL;DR (too long, didn’t read, « trop long ; pas lu ») que de bien peu aimables personnes nous envoient parfois après avoir pris connaissance de notre lettre d’information. Il est peu probable pourtant que l’on passe à l’étape suivante : TL;DW (too long, didn’t write : « c’est trop long à écrire, alors je ne l’ai pas écrit moi-même »), qui consiste à faire écrire ses contenus par une IA générative… Quoique, les articles seraient peut-être plus clairs, les circonv
À DLA, on connaît bien l’acronyme TL;DR (too long, didn’t read, « trop long ; pas lu ») que de bien peu aimables personnes nous envoient parfois après avoir pris connaissance de notre lettre d’information. Il est peu probable pourtant que l’on passe à l’étape suivante : TL;DW (too long, didn’t write : « c’est trop long à écrire, alors je ne l’ai pas écrit moi-même »), qui consiste à faire écrire ses contenus par une IA générative… Quoique, les articles seraient peut-être plus clairs, les circonvolutions moins alambiquées ? Allez savoir !
Mais c’est d’un autre mème dont je voulais parler. Un mème qui devrait lui aussi beaucoup moins nous être adressé, mais qu’on utilise souvent : AI;DR (AI, didn’t read) : « c’est de l’IA, je ne l’ai pas lu » ! Un jugement qu’on énonce couramment et qui décrit la transformation de notre rapport aux textes, à l’heure où tout doit aller si vite, qu’on n’a plus le temps d’écrire ni de lire. Un refus face au déferlement : « c’est de l’IA, je ne veux même pas le lire » !
A qui profite le verbiage ?
AI;DR donc. L’acronyme exprime quelque chose entre la lassitude et l’hostilité à voir des textes génératifs envahir le web. Qu’ils soient très formatés, énergiques ou lénifiants, l’expression nous dit que nous serions capables de repérer la prose des LLM à leur tiédeur, à leur style, à leurs effets (qu’importe si en vérité, nous nous trompons souvent, comme c’est le cas des enseignants qui peinent à identifier les productions génératives de leurs étudiants). Un peu comme si nous étions dotés d’un système de repérage, une boussole infaillible, alors que les textes génératifs sont souvent corrigés, amendés, modifiés par leurs auteurs, et qu’ils tiennent bien plus d’une forme de coproduction qu’autre chose. Non seulement l’acronyme nous dit que ces productions n’ont finalement pas grande importance, mais il nous dit aussi que nos erreurs d’attribution peuvent être aussi péremptoires que les réponses des chatbots à la confiance survitaminée. Il nous dit que ces productions n’ont finalement pas grande importance au risque de renvoyer avec elles des propos bien humains, un peu comme ceux qui étaient trop longs finalement, trop humains. AI;DR nous dit que ce qui est écrit n’a pas grand intérêt, qu’il soit le fait de robots ou d’humains. Ce que ça fait est bien plus important : même si ce que ça fait (écrire) devient en même temps qu’on l’énonce bien peu important puisqu’on ne lui prête plus aucune attention.
Rapidement, on est saisi d’un vertige : à quoi peuvent bien servir des outils pour produire du texte que les gens ne souhaitent pas lire ? AI;DR semble mettre en abîme le grand vide des machines à verbiage, comme pour rendre béant le vortex qui s’ouvre sous nos mots. Un peu comme vient de le proposer le moteur de traduction Kagi en permettant de traduire (après le Dothraki, le Haut Valyrien ou le Klingon quand même !) n’importe quel texte en « Linked-in speak », c’est-à-dire dans le jargon de Linked-in. En permettant de transformer n’importe quel texte en post de motivation entrepreneuriale, truffé d’emojis, de hashtags et de déconvenues transformées en leçons de vie. « Le traducteur de Kagi ne fabrique pas cette langue, il la révèle. Il en expose la mécanique, la pauvreté, le vide soigneusement emballé dans du vocabulaire managérial », s’amusait la chroniqueuse de Radio France, Constance Vilanova. Elle pointait d’ailleurs vers une étude d’un chercheur en linguistique qui a mis au point une échelle pour mesurer la réceptivité au jargon d’entreprise. Une étude qui montrait que plus on est sensible aux formules creuses, moins on performe soi-même aux tests de pensée analytique et aux tests de prise de décision. « Les grands amateurs de Linked-in speak seraient donc aussi les moins capables de repérer le vide. Ce qui crée un cercle vicieux parfait : les patrons sont récompensés pour leur langue de bois, et les équipes se peuplent progressivement de gens qui n’y voient que du feu. » Mais surtout, les personnes les plus réceptives au jargonnage ont aussi plus tendance à percevoir leurs leaders comme visionnaires, à être plus inspirées par les homélies d’entreprises et à faire plus confiance à leurs managers. « Pour certaines personnes, un discours abstrait et vaporeux peut donner l’impression de profondeur, de vision et de compétence et parfois suffit à produire de la crédibilité. Il peut aussi fonctionner comme un signal de leadership », s’amuse David Gateau… Pire, « plus la réceptivité au bullshit corporate est élevée, plus la qualité des décisions diminue ». « Les personnes les plus sensibles aux discours creux en entreprise ont tendance à choisir systématiquement les pires solutions aux problèmes », explique l’auteur de l’étude, Shane Littrell. Pourtant, l’étude montre aussi finalement que le jargon persuade et impressionne certains publics, explique The Guardian, tout comme le verbiage des LLM finalement. « N’importe qui peut se laisser berner, et nous sommes tous, selon les circonstances, susceptibles d’être influencés par des discours creux présentés de manière à flatter nos préjugés. »
Les contenus produits par l’IA sont-ils faits pour être lus ?
Le hashtag #AI;DR entérine la dépréciation des contenus génératifs, dénigrés depuis leur apparition. Comme le disait John Hermann dans le New York Mag dès 2024 : alors que l’IA est associée au summum des réalisations humaines, pour tout à chacun, elle désigne d’abord des choses assez pauvres, assez communes. Dans le langage courant, dire d’un texte qu’il a été réalisé par ChatGPT qualifie toujours un document sans grand intérêt. Aujourd’hui encore. « Pourquoi devrais-je me donner la peine de lire quelque chose que personne d’autre n’a daigné écrire ? », remarque pertinemment un développeur, relayé par Futurism. Quand on lit le propos de quelqu’un, c’est pour comprendre ce qu’il pense, perçoit et appréhende du monde. Ecrire, c’est penser. Et penser, c’est exister. Mais que signifie lire la prose d’un LLM ? QUI sommes-nous censés comprendre ? Et donc QUE sommes-nous censés comprendre ? Quelque part, les gens qui dénoncent ces contenus, disent que ce qui est écrit par l’IA ne nous est pas adressé. Que ces contenus ne sont pas vraiment pour les humains puisqu’ils ne sont pas humains.
Dans le New York Mag, John Hermann (encore lui), dénonçait récemment le cauchemar de l’e-mail piloté à l’IA : « Êtes-vous impatient de voir vos collègues devenir beaucoup plus bavards, transformant chaque simple « Ça me va » en une lettre de trois paragraphes ? Êtes-vous ravi que le genre d’e-mails de masse semi-personnalisés que vous avez l’habitude de recevoir des grandes marques dotées de services marketing (ou des spammeurs et des auteurs de phishing) soit désormais accessible à toute personne possédant un compte Google ? Avez-vous hâte de vous demander si cette charmante lettre de condoléances d’un ami perdu de vue depuis longtemps a été entièrement générée par un logiciel ou s’il a simplement cliqué sur le bouton pour rendre le contenu « plus sincère » avant de l’envoyer ? » Ce dernier exemple n’est même pas une blague, le mois dernier, l’administration de l’université Vanderbilt a dû présenter ses excuses après avoir envoyé un e-mail de condoléances aux étudiants suite à la fusillade de l’université d’État du Michigan. En bas du message il était indiqué qu’il avait été rédigé par ChatGPT !
Le Financial Times rapporte que le volume des plaintes aux services juridiques et RH des entreprises est en augmentation et que celles-ci sont plus documentées et complexes qu’avant. Ce ne sont plus de simple e-mail à traiter, mais des pièces jointes volumineuses, qui évoquent parfois des législations qui n’existent pas. La raison ? Le recours à l’IA. De plus en plus de plaintes leur arrivent « incompétentes mais sûres d’elles », « superficiellement persuasives », « excessivement juridiques sans être pertinentes »… de gens pouvant avoir des attentes irréalistes, désorientés par les réponses des IA à leurs problèmes. Le volume de récriminations augmente et le temps pour les vérifier également, au risque de ralentir les réponses des employeurs.
Reste que le besoin de formalisation que traduit le passage à un argumentaire structuré par l’IA dit peut-être autre chose du rapport employés-employeurs, où les discussions ne suffisent pas pour être écoutés…
Le New York Times, récemment, expliquait que la romance générative était en pleine explosion et que l’IA était l’avenir du genre. Pas si sûr, contestait Gita Jackson pour Aftermath, les défenseur(e)s de l’IA dans la littérature n’ont pas d’autre but que de gagner de l’argent, en produisant beaucoup de contenus et en vendant des formations pour apprendre à d’autres comment faire. L’une des autrices interviewées par le NYT prétend que ses 200 livres publiés par IA ont totalisé 50 000 ventes… soit en moyenne 250 exemplaires par livre. Ce modèle économique n’est viable que si l’on se fiche de la qualité des livres et de leur popularité, assassine Jackson. Bref, il n’est pas sûr que les romances dopées à l’IA soient l’avenir du genre, comme le défendent les autrices qui le proposent parce qu’elles y ont doublement intérêt. Pas sûr que les contenus dopés à l’IA soient finalement meilleurs que les romances incarnées par leurs autrices.
Deux exemples qui montrent que les contenus génératifs viennent s’intercaler dans les situations de blocages et viennent toujours avec les intérêts de ceux qui les portent, même s’ils ne sont pas toujours faciles à percevoir.
Pour qui écrivons-nous ?
Le mot-clé AI;DR rejoint également celui de sloppers, désignant les producteurs de slop, les producteurs de contenus qui ne produisent plus qu’avec les robots conversationnels (à l’image de la proposition parodique de sloppers.ai, qui se présente comme un service d’IA pour produire… des contenus parfaitement inutiles). Entre résistance et lassitude, le point-virgule, qui à l’origine séparait la cause de l’effet – plus vous écrivez, moins je lis – sépare désormais la production de la machine du refus de lui accorder la moindre attention.
Comme le souligne Alberto Romero, nous passons d’un monde où la longueur d’un texte constitue un obstacle à la lecture, à un monde où le manque d’implication humaine devient un obstacle supplémentaire. Nous sommes passés de « je ne finirai pas ça » à « personne n’a commencé ça ». « La première attitude suppose que l’on est responsable de ses propres limites, tandis que la seconde incite à externaliser sa responsabilité », comme si ce n’était pas à nous de lire, de vérifier, d’agréer aux productions générées. La perspective de notre submersion par les contenus génératifs, par l’intensification des productions, risque de nous laisser plus épuisé que jamais, disions-nous la semaine dernière. Non seulement nous sommes cernés par plus de contenus que jamais, mais nous sommes en même temps confrontés à une forme de post-alphabétisation où l’écrit lui-même semble de plus en plus décrédibilisé par son automatisation.
Pour Romero, l’IA;DR fait écho à son exact inverse : WF;AI (What the fuck; AI, « bordel, écrire pour l’IA ») où nous sommes confrontés au vide de sens qu’exige d’écrire pour l’IA plutôt que pour d’autres humains. Nous sommes en train de passer du pourquoi écrivons-nous à pourquoi lisons-nous, comme si le cœur même de la connaissance n’avait plus de sens, ni pour les autres ni pour nous. « Doit-on consacrer vingt minutes de son attention déjà si sollicitée à un texte qui n’a coûté à son auteur fantôme que quarante-cinq secondes et une consigne maladroite ? »
Perdus au milieu de contenus de plus en plus fantomatiques, comment s’orienter ? « La lecture, comme tout ce que nous faisons, repose sur un contrat social implicite : je vous offre ma réflexion, vous me donnez votre temps. Or, lorsque l’une des parties automatise sa part du marché, l’autre se sent légitimement flouée. Et comme déléguer la lecture n’a aucun sens pour la plupart des gens, ils ne le font tout simplement pas », constate pertinemment Romero. Le contrat de lecture exige une intention et une relation que l’IA ne peut pas produire. Le contrat de lecture est donc profondément rompu, quelles que soient ses conséquences. D’autant que dans la roue du hamster de la lecture/écriture, l’IA a tendance à exclure de plus en plus l’humain. Dans le biais anti-humain de l’IA, l’IA se nourrit de l’IA et récompense plus facilement les contenus IA faisant gonfler plus encore les contenus génératifs qu’on ne veut pas lire. Et pourtant, se moque Romero en conclusion, son texte a été écrit avec une IA. Nous même avons été pris au piège. Le contrat de lecture n’est donc pas totalement rompu, il est flouté au risque de nous abuser en continue.
C’est toute l’aporie où nous sommes réduits, comme l’illustre le dessinateur Tom Fishburne avec un de ses délicieux dessins : l’IA permet de transformer une liste à puce en un long mail qu’on peut prétendre avoir écrit et où son récepteur peut le transformer en liste à puce qu’il peut prétendre avoir lu. Tom Fishburne rappelle qu’il va falloir du temps pour apprendre quand et comment bien utiliser ces outils et surtout quand ne pas les utiliser. L’acronyme AI;DR nous rappelle que nous sommes face à des contenus dont le statut n’est pas clair, des contenus que nous ne savons pas vraiment utiliser. Peut-on vraiment en vouloir à des gens de refuser de lire des contenus qui sont produits par personne et destinés à personne, de refuser de lire des propos d’une machine, aussi séduisants ou creux puissent-ils être ?
Le risque d’une parole sans conséquence
IA;DR nous dit autre chose pourtant. Que ces mots produits sont produits. Que ce qui devait être fait est fait et que la réception est finalement un autre enjeu, comme s’il dépendait d’autres métriques.
« Pour la première fois, la parole est dissociée de ses conséquences. Nous vivons désormais aux côtés de systèmes d’IA qui conversent avec assurance et persuasion – débitant des affirmations sur le monde, des explications, des conseils, des encouragements, des excuses et des promesses – sans jamais assumer la responsabilité de leurs propos. Des millions de personnes utilisent déjà des chatbots, alimentés par de vastes modèles de langage, et ont intégré ces interlocuteurs synthétiques à leur vie personnelle et professionnelle. Les mots d’un chatbot façonnent nos croyances, nos décisions et nos actions, sans qu’aucun locuteur ne les cautionne », explique Deb Roy dans The Atlantic.
Deb Roy est professeur d’arts et de sciences des médias au MIT, où il dirige le Centre pour la communication constructive au Media Lab. Il est également cofondateur et président de Cortico, une organisation à but non lucratif qui se consacre à la construction de réseaux civiques plus forts, notamment en analysant les échanges vocaux de groupes de discussions pour en dégager liens et tendances.
Dans nos échanges avec les chatbots, ceux-ci s’excusent, corrigent, mais débitent une chose puis son contraire, vide de sens, rappelle le professeur. Pour Roy, « il ne s’agit pas d’une simple nouveauté technique, mais d’un bouleversement de la structure morale du langage ». Lorsque nous parlons, nos mots nous engagent dans un contrat social implicite. Ils nous exposent au jugement, aux représailles, à la honte et à la responsabilité. Dire ce que l’on pense, c’est prendre un risque. Le chercheur en intelligence artificielle Andrej Karpathy a comparé les LLM à des fantômes humains : ils ne sont pas des créatures, leur parole est sans conséquence, tout en étant capable de nous hanter. Pour Deb Roy, spécialiste de l’apprentissage du langage, les mots acquièrent du sens en relation avec le monde. Reste que le sens ne découle pas seulement de la fluidité ou de l’incarnation, mais aussi des enjeux sociaux et moraux que nous prenons lorsque nous parlons.Le langage a une dimension morale et sociale. Il nous engage. Il nous rend digne ou indigne, responsable. « Parler, c’est simultanément s’exposer à un jugement moral, encourir des conséquences sociales et parfois juridiques, assumer la responsabilité de la vérité et contracter des obligations qui perdurent au sein des relations. » Avec les chatbots, la parole n’est plus que procédurale. « Les chaînes causales s’obscurcissent. La responsabilité se dilue. L’autorité épistémique s’exerce sans obligation. Les engagements relationnels sont simulés sans persistance. »Cela produit non seulement un obscurcissement des responsabilités, mais plus encore un affaiblissement progressif des attentes. Le risque est de ne plus rien attendre des textes, quels qu’ils soient.
Norbert Wiener l’avait bien compris, dans ses mises en garde à l’encontre de l’automatisation : l’accroissement des capacités des machines entraînerait une perte de responsabilité humaine. Et l’efficacité elle-même éroderait la dignité humaine, nous poussant à devenir des intrants, des opérateurs ou des superviseurs de processus dont les humains ne contrôleraient plus la logique. « Ce qui rend ces systèmes moralement déstabilisants, ce n’est pas leur dysfonctionnement, mais leur capacité à fonctionner exactement comme prévu tout en se soustrayant à toute responsabilité », explique Roy.
L’histoire moderne regorge de technologies médiatiques qui ont transformé la circulation de la parole : l’imprimerie, la radio, la télévision, les réseaux sociaux. Mais aucune de ces technologies ne possédait les propriétés que les systèmes d’IA actuels réunissent simultanément. Aucune ne permettait de dialoguer et donc d’activer une vulnérabilité psychologique inédite. Avec Eliza, Joseph Weizenbaum a compris que les humains projetaient sur la machine du sens, des intentions et une responsabilité qu’elle n’avait pas. Le philosophe J.L Austin affirmait qu’utiliser le langage, c’est agir. « Tout énoncé significatif accomplit une action : il affirme une croyance, formule une revendication, formule une demande, fait une promesse, etc. Dire « oui » lors d’une cérémonie de mariage donne naissance à l’acte de mariage. Dans ce cas, l’acte n’est pas accompli par des mots puis décrit ; il est réalisé dans l’acte même de prononcer ces mots, dans les conditions appropriées. » Pour Roy, pour combattre l’effet Eliza, il ne suffit pas de savoir que ces systèmes sont des machines, car leur efficacité est amplifiée par leur fluidité. Et c’est leur fluidité qui nous conduit à déléguer nos responsabilités, à la faire glisser de l’utilisateur vers l’outil. Nous demandons désormais aux autres de prêter attention à des mots que nous n’avons pas écrits, pas pensés. Ce que nous perdons, c’est notre dignité même. « Dans le cadre d’un usage privé (comme le proposent les chatbots compagnons), l’érosion est plus subtile, mais non moins lourde de conséquences. Les jeunes décrivent leur utilisation de chatbots pour rédiger des messages qu’ils hésitent à envoyer, pour déléguer des réflexions qu’ils estiment devoir mener eux-mêmes, pour obtenir des assurances sans s’exposer, pour répéter des excuses sans rien débourser. Un chatbot dit « Je suis désolé » sans faute, mais est incapable de regret, de réparation ou de changement. Il admet ses erreurs sans conséquence. Il exprime de l’attention sans rien perdre. Il utilise le langage de la bienveillance sans rien risquer. Ces affirmations sont fluides. Et elles habituent les utilisateurs à accepter un langage moral déconnecté des conséquences. Il en résulte un réajustement discret des normes. Les excuses deviennent gratuites. La responsabilité devient théâtrale. La bienveillance devient simulée. »
Les mots eux-mêmes n’ont plus de portée. Ceux des chatbots, bien sûr, mais derrière, les mots de tous ceux qui en portent, et d’abord ceux que les autres humains nous adressent.
« Certains affirment que la responsabilité des propos de ces machines peut être externalisée : vers les entreprises, les réglementations, les marchés. Mais la responsabilité se dilue entre développeurs, déployeurs et utilisateurs, et les boucles d’interaction restent privées et inobservables. L’utilisateur en subit les conséquences ; la machine, non. »
Ceci n’est pas sans rappeler le problème éthique posé par les armes autonomes, estime Roy. En 2007, le philosophe Robert Sparrow soutenait que de telles armes violent le principe de la guerre juste, selon lequel lorsqu’un dommage est infligé, quelqu’un doit répondre de la décision de l’infliger. Le programmeur est protégé par conception, ayant délibérément construit un système dont le comportement est censé se dérouler sans contrôle direct. Le commandant qui déploie l’arme est lui aussi protégé, incapable de contrôler les actions spécifiques de l’arme une fois en mouvement, et cantonné aux rôles prévus pour son utilisation. Quant à l’arme elle-même, elle ne peut être tenue responsable, car elle est dépourvue de toute qualité morale d’agent. Les armes autonomes modernes produisent ainsi des résultats mortels pour lesquels aucun responsable ne peut être identifié de manière pertinente. Les chatbots compagnons, ces « systèmes de gestion de la vie humaine » fonctionnent différemment, mais la logique morale est la même : ils agissent là où les humains ne peuvent pas pleinement superviser, et la responsabilité se dissout dans ce vide.
« La parole sans conséquence contraignante sape le contrat social. La confiance, la coopération et la délibération démocratique reposent toutes sur le principe que les locuteurs sont tenus par leurs propos. » Notre immersion dans un monde de contenus génératifs, de propos sans conséquences, risque de nous habituer à prendre toute parole comme étant sans conséquence, même celle de nos contemporains.
« Nous avons besoin de structures qui réancrent la responsabilité : des contraintes limitant l’utilisation de l’IA dans divers contextes, tels que les écoles et les lieux de travail, et préservant la paternité des travaux, la traçabilité et une responsabilité clairement définie. L’efficacité doit être encadrée lorsqu’elle porte atteinte à la dignité », défend Roy.
Avant de pointer un autre enjeu encore : « Alors que l’idée d’« avatars » IA s’impose dans l’imaginaire collectif, elle est souvent présentée comme un progrès démocratique : elle repose sur des systèmes qui nous connaissent suffisamment bien pour parler en notre nom, délibérer à notre place et nous épargner le fardeau d’une participation constante. Il est facile d’imaginer que cela puisse se transformer en ce que l’on pourrait appeler un « État-avatar » – un système politique où des représentants artificiels débattent, négocient et décident pour nous, efficacement et à grande échelle. Mais cette vision oublie que la démocratie non plus n’est pas simplement l’agrégation de préférences. C’est la pratique de la parole ouverte. S’exprimer politiquement, c’est prendre le risque de se tromper, d’être responsable, d’assumer les conséquences de ses paroles. Un État avatar – fluide, infatigable et parfaitement malléable – simulerait la délibération, mais sans conséquence. De loin, il ressemblerait à un gouvernement autonome. De près, ce serait tout autre chose : la responsabilité rendue facultative, et avec elle, la dignité de devoir assumer ses paroles devenues obsolètes. Wiener avait compris que le tourbillon ne viendrait pas de machines malveillantes, mais de l’abdication humaine. » C’est au bord de ce précipice que nous conduit l’IA.
Ce que traduit AI;DR, c’est qu’à mesure que nous sommes cernés par ces contenus génératifs, la résistance se fait jour, estime Fast Company. Qui souligne que le terme rencontre du succès à un moment où le sentiment anti-IA se développe. Les inquiétudes concernant l’IA chez les adultes américains se sont accrues depuis 2021, selon le Pew Research Center. Plus de la moitié (51 %) se disent plus inquiets qu’enthousiastes face à l’essor de cette technologie. « C’est de l’IA, je ne l’ai pas lu ! », ne traduit-il pas d’abord que tout cela n’est pas de notre responsabilité. Que cet avenir n’est peut-être pas celui que nous avons voulu. « C’est de l’IA, je ne l’ai pas lu ! » est peut-être notre dernier semblant de résistance face à un nouveau web qui va nous submerger.
Même constat pour la journaliste Eve Fairbanksdans The Atlantic. « Travailler sur un texte généré par l’IA, en tant que correcteur, revient à opérer un corps dont la peau, les muscles, les veines, les os et les organes sont tous endommagés. Il n’y a rien à préserver, aucun point de départ », explique-t-elle confrontée à la prose des machines. « L’infltration du non sens est partout, inéluctable. Même ceux qui n’utilisent pas l’IA finiront par lui ressembler. »
A l’heure où les outils pour produire du code automatiquement se déploient partout, la question de la productivité devient de plus en plus polarisée, rappelle le journaliste du Financial Times, John Burn-Murdoch. « Un point de tension majeur entre les partisans et les détracteurs de l’IA réside dans le décalage entre l’augmentation constatée de la productivité des développeurs et l’absence apparente d’une croissance correspondante sur la création de produits ou de valeur ». Or, une nouvelle étud
Mert Demirer du MIT et ses co-auteurs a analysé le travail des développeurs de logiciels avant et après l’adoption d’outils d’IA. Ils ont mesuré cet impact à différents niveaux : la quantité de code écrit, le nombre de fichiers modifiés, le nombre de projets ou de fonctionnalités développés et les mises en production de nouveaux logiciels. L’étude a révélé que l’IA avait un impact considérable en amont : les développeurs ont créé ou modifié près de 300 % de fichiers supplémentaires. Cependant, cette augmentation a été réduite de moitié (à 150 %) lorsqu’ils ont examiné le nombre de fichiers soumis à l’évaluation, et ce dernier a lui-même été divisé par cinq, pour atteindre une hausse d’environ 30 % du nombre de mises en production complètes.
Une augmentation de 30 % de la production du produit phare d’une entreprise est significative, mais les résultats montrent néanmoins à quel point la perception, voire certaines mesures directes, de l’impact de l’IA sur la productivité peuvent être déconnectées de la valeur ajoutée réelle. L’accélération spectaculaire de la productivité se traduit par des gains bien plus modestes une fois que ce travail a franchi tous les obstacles liés à la validation et à la mise en production. L’enjeu de la vérification reste bien en partie le goulot d’étranglement de la productivité sous IA. Mais ce n’est pas le seul… « Lorsque les chercheurs ont examiné si l’augmentation de la production de logiciels grâce à l’IA avait entraîné une hausse de la consommation, ils n’ont trouvé que peu d’éléments probants. La forte augmentation du nombre de lancements d’applications mobiles au cours de l’année écoulée ne s’est pas accompagnée d’une hausse des téléchargements ; la plupart des nouvelles applications peinent à conquérir un public, même modeste. »
Ce que le Financial Times résume d’un graphique parlant, montrant l’envolée des mises à jour d’applications, alors que l’usage ne progresse pas :
Ce que pointe Burn-Murdoch, c’est qu’entre l’augmentation de la production des systèmes et leur diffusion, il y a également un goulot d’étranglement. Comme le dit Gary Marcus, l’IA appliquée au code permet certainement une productivité importante, mais a un impact concret limité, car produire ne suffit pas. Par exemple, l’IA permet peut-être d’augmenter la production de livres, mais cela ne signifie qu’ils soient de meilleure qualité ni qu’ils se vendent davantage, comme tentait de l’esquisser un graphique du Washington Post montrant la corrélation entre l’essor de l’IA et l’augmentation de la production de livres. Même chose dans le domaine de la musique ou de la production académique. La production augmente, mais les débouchés stagnent. En partie parce que certains marchés sont saturés et de l’autre parce que cette accélération volumétrique n’améliore pas la qualité pour autant. Comme le résume un développeur avec ironie : « avant l’IA, je passais un week-end à développer une seule application inutile. Maintenant, je peux en développer 67 en un week-end, chacune avec un logo, une page web sophistiquée et… zéro utilisateur. »C’est ce que constate également Paul Kedrosky : nous sommes en train de privilégier la production à la valeur, à l’image de la récente démonstration d’Anthropic valorisant l’explosion de la productivité des développeurs grâce à ses modèles. Or, nous ne mesurons ici que le Sloc (software lines of code, le nombre de lignes de code des logiciels), une sorte de Slop interne aux entreprises. Or, rappelle Kedrosky : « Les meilleurs ingénieurs créent de la valeur en écrivant moins de code, pas plus.» Le nombre de lignes de code valorise la quantité, non l’utilité. L’IA gonfle systématiquement cette métrique. Et une multiplication par huit du nombre de lignes de code correspond généralement à une augmentation bien moindre du rendement réel d’ingénierie. Le volume de code engendre des risques. Plus de code signifie plus de maintenance, de complexité, de surface d’attaque et de charge de déboggage.
Les entreprises cherchent désormais à optimiser leurs dépenses de production d’IA afin d’en réduire le coût, estime encore John Burn-Murdoch. Demirer et ses co-auteurs estiment que l’explication la plus probable de l’invisibilisation des gains de productivité réside dans le fait que les structures organisationnelles et les marchés actuels ne sont pas conçus pour tirer pleinement parti des gains sous-jacents. Le fait que les entreprises établies du secteur des logiciels et du travail intellectuel ne constatent que de modestes gains de productivité en intégrant l’IA à leurs méthodes de travail et structures organisationnelles existantes, tandis que l’utilisation, le chiffre d’affaires et la productivité explosent chez Anthropic et OpenAI – des entreprises construites autour de l’IA, dont les produits sont conçus et évalués par elle – est peut-être un premier signe de la même dynamique à l’œuvre ici, mais à un rythme beaucoup plus rapide.
« Je pense que les deux camps ont raison. Une grande partie de l’utilisation et des dépenses des entreprises en matière d’IA sont aujourd’hui inefficaces. Mais les gains de productivité constatés reflètent l’interaction entre de puissants outils et des structures et processus mal adaptés. A terme, ces frictions et ces goulots d’étranglement ne feront que s’atténuer », estime Burn-Murdoch, mais ce n’est peut-être pas si sûr. L’IA sature également le marché et sa prolifération empêche de saisir où des gains sont encore possibles. En rendant tout possible, elle génère une confusion qui n’aide certainement pas à voir là où elle devrait être utile et là où elle ne l’est pas.
Je classais encore le Parti libéral du Québec parmi les partis inclusifs sur la question de l’identité de genre, mais la récente controverse sur les « personnes ayant des menstruations » m’a fait prendre conscience que la réalité est plus complexe. Voici donc une compilation des positions des cinq partis politiques présentement dans la course. Merci à Kathleen Bélanger pour l’infographie!
Québec solidaire est le seul parti à soutenir entièrement les personnes trans et non-binaires. Les po
Je classais encore le Parti libéral du Québec parmi les partis inclusifs sur la question de l’identité de genre, mais la récente controverse sur les « personnes ayant des menstruations » m’a fait prendre conscience que la réalité est plus complexe. Voici donc une compilation des positions des cinq partis politiques présentement dans la course. Merci à Kathleen Bélanger pour l’infographie!
Québec solidaire est le seul parti à soutenir entièrement les personnes trans et non-binaires. Les positions du parti sont celles de Manon Massé, alliée inconditionnelle de la communauté LGBTQ+. Leur politique est le respect du genre ressenti.
Les libéraux ont une approche généralement inclusive, mais ont souvent évité de se prononcer sur le sujet de la transidentité et de l’identité de genre depuis le départ de Dominique Anglade, signe du malaise dans les rangs. Lorsque le ministre Jean-François Roberge a interdit d’utiliser les pronoms neutres dans les écoles, dans la fonction publique et dans les communications officielles, la critique Marwah Rizqy s’est contentée de critiquer le sens des priorités du ministre, sans dire formellement si elle était en désaccord avec le principe. Les libéraux respectent généralement le genre auquel la personne s’identifie et soutiennent les jeunes de la communauté LGBTQ+. Ces positions pourraient bien changer, comme l’ont montré le débat sur l’expression « personne avec des menstruations » et l’influence indirecte de Christiane Pelchat et de PDF-Québec, organisation dont la lutte contre les femmes trans est une des raisons d’être. Le chef Charles Milliard s’est lui-même montré susceptible d’entrer dans le jeu des anti-trans en se disant mal à l’aise avec l’expression « personne avec des menstruations », comme si les femmes se définissaient par leurs règles.
Le Parti québécois est généralement hostile aux enjeux touchant la diversité de genre. Souvenons-nous des polémiques de l’automne 2023 concernant les toilettes non genrées et les pronoms neutres à l’école. À l’hiver 2025, les péquistes ont été les seuls parlementaires à rejeter une motion demandant à continuer la lutte contre l’homophobie et la transphobie. Dès la présentation du nouveau programme de Culture et citoyenneté québécoise, les péquistes ont accusé celui-ci d’être trop « woke », notamment au sujet des questions de sexualité et d’identité de genre. La députée Catherine Gentilcore a prétendu que le nouveau programme enseignait aux enfants que le genre est attribué par la société et non constaté à la naissance, ce qui est faux. Le PQ demande l’exclusion des femmes trans des espaces réservés aux femmes, y compris des groupes de lesbiennes.
Les positions de la Coalition Avenir Québec sont plus ambiguës. Le nouveau programme de Culture et citoyenneté québécoise mis en place par la CAQ est très inclusif à l’endroit des questions d’identité de genre. Les enseignantes doivent respecter l’identité de genre des élèves et garder le secret si les élèves ont choisi de ne pas en informer leurs parents. La CAQ maintient cependant la séparation genrée des blocs sanitaires et a interdit l’utilisation de pronoms neutres à l’école, dans la fonction publique et dans les communications officielles. Contrairement au PQ et au PCQ, le gouvernement de la CAQ privilégie le « sexe anatomique » plutôt que le « sexe biologique », c’est-à-dire que les femmes trans ayant subi une vaginoplastie sont considérées comme des femmes dans tous les contextes.
Le Parti conservateur du Québec se trouve dans une position particulière puisque les militants ne sont pas sur la même longueur d’ondes que leur chef. Éric Duhaime partage les positions de ses amis conservateurs albertains et souhaite que « l’idéologie du genre » soit interdite dans les écoles. Au dernier congrès, cependant, les militants conservateurs ont rejeté une résolution demandant la révision du programme d’éducation à la sexualité. Le PCQ souhaite surtout s’attaquer aux soins de transition chez les mineurs (même avec le consentement des parents) et interdire les changements de pronoms et de prénoms à l’école sans l’autorisation des parents.
En résumé : les rouges sont à surveiller et les bleus ne sont pas des alliés, peu importe la nuance de bleu.
Positions détaillées des partis :
Toilettes non genrées QS : Demande l’aménagement de toilettes non genrées dans les espaces publics et les écoles. PLQ : Demande l’aménagement de toilettes non genrées dans les espaces publics et les écoles. PQ : Exige le maintien de blocs sanitaires séparés en tout temps. Associe les toilettes non genrées à une « idéologie de la gauche radicale ». CAQ : Position ambivalente. A interdit les toilettes mixtes dans les écoles, mais n’en a pas fait une politique générale. PCQ : Exige le maintien de blocs sanitaires séparés en tout temps.
Pronoms neutres QS : Demande de respecter le choix de pronom des individus. PLQ : Ne s’est pas prononcé. PQ : A approuvé l’interdiction des pronoms neutres par le gouvernement de la CAQ. CAQ : A interdit l’utilisation des pronoms neutres à l’école, dans la fonction publique et dans les communications officielles. PCQ : A approuvé l’interdiction des pronoms neutres par le gouvernement de la CAQ.
Enseignement de l’identité de genre QS : Approuve le programme actuel. PLQ : Ne s’est pas prononcé. PQ : Demande la révision du programme d’éducation à la sexualité et de biologie afin de s’assurer qu’il soit conforme à la science (prend pour acquis que le programme actuel ne l’est pas). CAQ : Approuve le programme actuel. C’est le gouvernement de la CAQ qui l’a mis en place. PCQ : Position ambivalente. Éric Duhaime s’est personnellement prononcé contre l’enseignement de « l’idéologie du genre » à l’école, mais les membres du Parti conservateur ont rejeté une proposition demandant la révision du programme d’éducation à la sexualité.
Présence des femmes trans dans les lieux réservés aux femmes QS : Demande le respect du genre ressenti. PLQ : Demande le respect du genre ressenti. PQ : Souhaite interdire aux femmes trans l’accès aux lieux réservés aux femmes : Toilettes, vestiaires, compétitions sportives, organismes venant en aide aux femmes, prisons pour femmes et groupes de lesbiennes. CAQ : Les personnes trans incarcérées dans les prisons provinciales sont détenues en fonction de leur « sexe anatomique ». Une femme trans sera détenue dans une prison pour femme si elle a subi une vaginoplastie. La CAQ n’a pas interdit et ne promet pas d’interdire aux femmes trans l’accès aux lieux réservés aux femmes PCQ : Souhaite interdire aux femmes trans l’accès aux lieux réservés aux femmes
Autonomie médicale pour les soins de transition de genre QS : Respecte l’autonomie médicale à partir de 14 ans comme pour les autres soins médicaux. PLQ : Ne s’est pas prononcé. PQ : Ne s’est pas prononcé. CAQ : Ne s’est pas prononcé. PCQ : Exige le consentement des parents avant 16 ans. Souhaite interdire les mastectomies pour les personnes de moins de 18 ans et encadrer davantage les traitements hormonaux.
Changement de prénom ou de pronom à l’école QS : Respecte le choix de l’élève. PLQ : Respecte le choix de l’élève. PQ : Ne s’est pas prononcé. CAQ : La CAQ n’a pas pris position directement sur le sujet, mais le ministère de l’Éducation exige que les enseignants respectent le genre auquel les élèves s’identifient et le secret si l’élève n’en a pas avisé ses parents. PCQ : Souhaite que l’approbation des parents soit obligatoire.
Identification QS : Demande le respect du genre ressenti. PLQ : Demande le respect du genre ressenti. PQ : Souhaite que les personnes s’identifient selon leur sexe biologique à des fins statistiques, pour l’accès aux lieux réservés aux femmes et pour l’accès aux politiques genrées. CAQ : En 2021, le ministre Simon Jolin-Barrette a voulu exiger une transition chirurgicale des organes sexuels pour permettre le changement de sexe sur papier. Cette disposition a finalement été abandonnée. Le gouvernement de la CAQ a ajouté le marqueur de sexe X sur les pièces d’identité, mais a longtemps repoussé l’entrée en vigueur de la mesure. PCQ : Éric Duhaime considère que le concept d’identité de genre nie la réalité du sexe biologique.
Le toujours très inspirant institut de recherche indépendant Data & Society lance une nouvelle initiative visant à renforcer la citoyenneté à l’ère de l’IA. L’ambition est forte : faire passer le public du statut d’utilisateur à celui d’acteur, expliquent ses responsables. La culture de l’IA ne suffit pas. « Et le public mérite bien mieux qu’une simple formation à l’utilisation de l’IA. Et il l’exige de plus en plus. » « Les Américains constatent comment les systèmes d’IA façonnent leur accè
Le toujours très inspirant institut de recherche indépendant Data & Society lance une nouvelle initiative visant à renforcer la citoyenneté à l’ère de l’IA. L’ambition est forte : faire passer le public du statut d’utilisateur à celui d’acteur, expliquent ses responsables. La culture de l’IA ne suffit pas. « Et le public mérite bien mieux qu’une simple formation à l’utilisation de l’IA. Et il l’exige de plus en plus. »« Les Américains constatent comment les systèmes d’IA façonnent leur accès aux opportunités, à leurs droits et à leur dignité, et ils s’interrogent sérieusement sur l’impact de cette technologie sur tous les aspects de la vie, du travail à l’éducation en passant par l’environnement. Comment les systèmes automatisés évaluent-ils les candidatures et les candidats eux-mêmes ? Les tuteurs IA contribuent-ils à la réussite des élèves ou, au contraire, limitent-ils leurs connaissances ? Les immenses centres de données construits pour alimenter l’IA font-ils exploser les factures d’énergie des collectivités ? Une simple « connaissance » de l’IA ne suffit pas à répondre à ces questions, ni à toutes celles qu’elles soulèvent. Chacune d’elles nous oblige à appréhender clairement la technologie, à examiner de manière critique ses applications et à mobiliser les outils de la participation citoyenne pour en orienter le développement. »
Face à l’IA, renforcer la citoyenneté plutôt qu’acculturer
De même que l’éducation civique aux États-Unis permet aux citoyens de comprendre leurs droits, leurs devoirs et le fonctionnement du gouvernement, ce travail requiert un programme d’enseignement. D’où cette initiative d’éducation civique à l’IA : « une approche de l’éducation publique qui considère l’IA non pas comme un outil à maîtriser, mais comme un domaine de la vie civique où les citoyens ont des droits, des responsabilités et des moyens d’action collective. En mettant en lumière les outils civiques permettant au public d’exercer un pouvoir politique sur les systèmes d’IA et les plateformes technologiques – notamment au niveau local –, l’initiative d’éducation civique à l’IA renforcera la capacité des citoyens à participer à la conception et au déploiement de ces technologies, et contribuera à asseoir un pouvoir démocratique sur les institutions qui les créent et les promeuvent.»
Pour mobiliser la négociation collective pour peser sur l’utilisation de l’IA au travail, pour demander des changements dans les procédures d’achat des systèmes d’IA dans les écoles, pour exiger la transparence des outils de tri et de sélection automatisés, les gens doivent comprendre les processus civiques disponibles pour les utiliser. Tel est l’ambition du programme AI Civics : faciliter et approfondir l’apprentissage des modalités d’action en proposant des modèles et des ressources sur lesquels les communautés de tout le pays pourraient s’appuyer.
Partout dans le monde, les travailleurs utilisent la négociation collective pour influencer l’utilisation de l’IA sur leur lieu de travail. Des militants font pression sur les autorités locales chargées d’autoriser les permis de construire afin d’exercer un pouvoir sur la construction des centres de données. Des élèves et des parents réclament des changements dans les politiques et les procédures d’achat des écoles. C’est la participation citoyenne en action : les communautés utilisent les leviers à leur disposition pour déterminer si et comment l’IA et ses infrastructures sont déployées. Mais avant cela, elles ont dû comprendre ces processus civiques et apprendre à les utiliser à leur avantage. Le programme AI Civics facilitera et approfondira cet apprentissage, en proposant des modèles et des ressources sur lesquels les communautés de tout le pays pourront s’appuyer.
En 2025, D&S a organisé un cycle de conférences sur le thème “Comprendre l’IA”. L’initiative que l’Institut lance est le résultat des commentaires qu’ont adressé le public aux chercheurs. Dans ces commentaires, expliquent les chercheurs et chercheuses de D&S, trois points sont ressortis :
– Comme nous le disions nous même, les gens sont inquiets de l’IA. « Les gens se sentent pris au dépourvu par la rapidité et l’ampleur de ce changement, et frustrés par l’impression qu’il se produit sans leur participation ».
– « Même les utilisateurs de l’IA s’inquiètent de ses impacts. Les participants nous ont confié utiliser des outils d’IA au quotidien, mais être mal à l’aise face aux compromis et aux coûts cachés. Ils souhaitent dépasser le vernis séduisant du battage médiatique autour de l’IA et comprendre les véritables implications de l’utilisation de ces outils, leurs coûts et avantages réels, ainsi que les moyens d’en atténuer les effets néfastes. »
– « Lassés d’être des consommateurs passifs, les citoyens cherchent des moyens de s’engager davantage. Nombreux étaient ceux qui souhaitaient découvrir des pistes concrètes pour une action collective, d’autant plus que la réglementation gouvernementale et les efforts pour responsabiliser les entreprises technologiques sont insuffisants. Nous avons constaté une volonté d’appréhender la complexité et un désir de s’opposer aux discours sur l’inévitabilité technologique. »
La culture de l’IA, la littératie, c’est-à-dire la maîtrise de savoirs, de capacités et d’aptitudes liées à l’IA, telle qu’elle est actuellement conçue, ne répond pas à ces besoins, estime l’Institut. Bien souvent, cette culture se limite à offrir la possibilité d’acquérir les compétences et les connaissances nécessaires pour utiliser l’IA et en tirer profit. Mais c’est un discours qui répète souvent que l’IA est inévitable et que ceux qui ne possèdent pas de connaissances dans ce domaine seront laissés pour compte. Dans un contexte économique déjà particulièrement difficile, pour beaucoup de gens, cette approche sonne comme une menace.
« Dans son nouveau rapport, (404) Job Not Found : What Workforce Training Can’t Fix for Black Atlantans in the Age of AI,Anuli Akanegbu, chercheuse chez Data & Society, analyse la manière dont l’IA est abordée dans les milieux universitaires, promue par l’industrie, mise en œuvre par les pouvoirs publics et perçue au sein de la société civile. Basée à Atlanta, ville qui aspire à devenir l’épicentre de la main-d’œuvre de demain préparée à l’IA, Akanegbu décrit l’incapacité des pouvoirs publics et de l’industrie à définir clairement la culture de l’IA ou à préciser les compétences nécessaires aux travailleurs sur un marché du travail de plus en plus dominé par l’IA comme une abstraction stratégique, une forme de flou intentionnel qui transforme l’avancement professionnel en un objectif en constante évolution » (voir également toutes les limites des annonces qui exigent une « maîtrise de l’IA exigée »). « Ce flou sert un dessein : il reporte la responsabilité du chômage sur une main-d’œuvre majoritairement noire plutôt que de s’attaquer aux conditions structurelles qui rendent l’accès aux emplois de qualité de plus en plus difficile. En présentant l’adoption de l’IA comme une question d’effort individuel plutôt que de limitations systémiques, le concept de littératie de l’IA a été instrumentalisé pour promouvoir une solution simpliste au problème très complexe du déplacement d’emplois. De même que l’éducation aux médias imputait la désinformation, la manipulation médiatique et l’effondrement du système d’information aux utilisateurs individuels des réseaux sociaux, l’éducation à l’IA reproche aux travailleurs de ne pas trouver d’emploi rémunérateur plutôt qu’à un contexte socio-économique plus large qui normalise la précarité. »
D&S souhaite que son initiative parte des travailleurs, des étudiants, des citoyens… et qu’elle s’appuie sur les connaissances militantes pour aider les citoyens à exercer davantage leur pouvoir collectif à l’ère de l’IA. L’enjeu n’est pas seulement de se former à l’IA ou de s’y préparer, mais d’y ajouter la participation et l’intervention citoyenne. D&S est à la recherche d’organisations souhaitant rejoindre ce programme pour construire les ressources permettant de renforcer les capacités d’actions des citoyens. Que ce soit par exemple en créant des ressources pour les usagers des bibliothèques, ou en travaillant avec les associations de parents d’élèves pour documenter leurs méthodes pour mieux inspecter les marchés publics des districts scolaires lorsqu’ils achètent des outils technologiques… (voir notre article sur la montée de la contestation de l’IA à l’école).
« Les risques et les préjudices liés à l’IA sont bien documentés, mais ils ne sont pas inévitables. Notre mission essentielle aujourd’hui est de renforcer le pouvoir démocratique sur les institutions qui conçoivent et déploient les systèmes d’IA. Il est temps que la responsabilité publique et l’intérêt général soient de nouveau au cœur de l’innovation technologique à grande échelle. Il est temps que le grand public exerce un contrôle démocratique plus important sur l’IA. Il est temps d’instaurer une éducation civique sur l’IA. »
En tout cas, cette approche par l’éducation publique qui considère l’IA non pas comme un outil à maîtriser, mais comme un domaine de la vie civique où les citoyens ont des droits, des responsabilités et des moyens d’action collective est stimulante et inspirante. Bien loin par exemple des orientations britanniques prises en janvier de formation à l’IA pour tous, contestées par les acteurs de la médiation du Royaume-Uni (voir « Royaume-Uni : l’IA pour tous ! Laquelle ? »).
La journaliste Karen Hao, autrice du remarqué L’empire de l’IA (qui vient d’être traduit aux éditions L’écran fantastique) a lancé la liste de résistance à l’IA avec le Laboratoire de droit des réfugiés, le Distributed AI Research Institute (DAIR, fondé par la chercheuse Timnit Gebru) et l’association de justice sociale We and AI. Remettre en question le caractère inéluctable de l’IA est l’enjeu de cette liste qui recense et documente très succinctement et très partiellement les actes de résistance et d’opposition à l’industrie de l’IA à travers le monde. Comme le raconte l’anthropologue et l’avocate du numérique Petra Molnar (auteure de The Walls have Eyes, The New Press, 2024) dans Tech Policy Press, cette liste à été initiée par le travail du collectif Migration Tech Monitor, et notamment de celui du journaliste syrien Wael Qarssifi qui à documenté l’impact de la surveillance dans son pays et de Verónica Martínez qui a travaillé sur les effets de la surveillance et de la militarisation le long de la frontière américano-mexicaine. Comme l’explique Molnar, la liste a été intentionnellement documentée avec les initiatives évoquées et en se concentrant intentionnellement sur les pays en développement où les systèmes d’IA sont fréquemment déployés avec « moins de garanties réglementaires et un potentiel de préjudice plus élevé, et où les formes de résistance sont contraintes à être plus inventives ».
La liste est articulée autour de quatre modes de résistances, afin d’élargir sa définition : résister, refuser, se réapproprier et réinventer. Au Nouveau-Mexique, le site documente les actions en justice menées par le New Mexico Environmental Law Center contre le développement du « Projet Jupiter », un énorme centre de données. En Uruguay, le Mouvement pour un Uruguay soutenable a lancé une campagne pour exiger une plus grande transparence concernant un projet de centre de données de Google. Au Japon, le Syndicat japonais des travailleurs de la métallurgie, de la fabrication, de l’information et des télécommunications a saisi la commission du travail du gouvernement de Tokyo afin de contraindre IBM à divulguer les données d’IA utilisées pour le calcul des salaires. « Au Chili, des habitants de Quilicura, une commune ouvrière de la banlieue de Santiago, se sont transformés en chatbot humain le temps d’une journée. Quili.ai, un site web conçu pour ressembler à une interface d’IA, redirigeait les requêtes des utilisateurs vers des membres de la communauté qui répondaient en temps réel. Pendant plus de 12 heures, en collaboration avec des artistes locaux, ils ont répondu à 25 000 questions d’utilisateurs de 68 pays. L’objectif n’était pas de prouver que les humains pouvaient surpasser l’IA, mais d’amener les gens à s’interroger sur ce qu’ils abandonnaient réellement, et au profit de qui, en externalisant leurs requêtes vers un système bâti sur l’exploitation du bassin du fleuve Maipo et de communautés comme la leur. »
Nombre de résistances sont liées aux transformations du travail, bien sûr. En Californie, les professionnels de la santé mentale de Kaiser Permanente ont mené une grève pour dénoncer le remplacement du jugement clinique par un triage algorithmique. Au Royaume-Uni, les personnels de santé se mobilisent pour refuser l’intégration de Palantir dans le système de santé publique.
Aux Philippines, plusieurs organisations de travailleurs du numérique ont formé une coalition pour promouvoir la représentation des travailleurs dans l’élaboration des politiques relatives à l’IA et documenter les préjudices causés par l’adoption de l’IA. A Nairobi, l’Association des étiqueteurs de données (comptant aujourd’hui près de 900 membres), milite pour des conditions de travail équitables, des contrats transparents et la reconnaissance du travail cognitif et émotionnel lié à l’entraînement des systèmes d’IA. Lorsque Microsoft a commencé à intégrer massivement des fonctionnalités d’IA dans ses produits, des utilisateurs ont lancé un site web dédié, Microslop, pour recenser la dégradation de l’expérience utilisateur. L’artiste Sam Lavigne, lui, a proposé un plug-in pour navigateur, qui manipule les chatbots afin de ralentir leur temps de réponse pour inviter les utilisateurs à s’interroger sur ce qu’ils attendent exactement et pourquoi. Decolonize Digital est une collection de ressources, une « boîte à outils de libération » qui propose des alternatives, comme par exemple des solutions pour Dé-Googliser nos existences. Ou encore O Panóptico, un projet qui recense les initiatives de reconnaissance faciale au sein du système de sécurité publique brésilien.
Transparence, participation, élargissement et contrôle distribué
« Les initiatives recensées sur la liste AI Resist mettent également en lumière un ensemble de revendications auxquelles aucun cadre réglementaire existant ne répond pleinement, et auxquelles toute politique sérieuse de gouvernance de l’IA devrait s’attaquer », souligne Petra Molnar.
La première revendication transversale est bien sûr la transparence. Nombre de mouvements de résistance réclament bien souvent seulement de savoir ce qui est construit, par qui, avec quelles ressources et à quel prix. « Même des exigences de divulgation minimales, si elles étaient appliquées de manière cohérente, bouleverseraient fondamentalement le modèle opérationnel actuel du secteur, qui repose sur l’opacité à chaque étape de la chaîne d’approvisionnement », rappelle Molnar.
La deuxième revendication est la participation. Des employés d’Amazon qui ont exigé d’être consultés avant le déploiement de l’IA au sein de leur entreprise, à la coalition philippine qui milite pour la prise en compte des travailleurs dans l’élaboration des politiques relatives à l’IA… « nombres d’exemples pointent vers le même constat : les décisions concernant l’IA sont prises trop rapidement, en secret, par un petit nombre d’acteurs puissants cherchant à s’enrichir davantage, sans aucun mécanisme efficace permettant aux personnes les plus touchées d’intervenir ». Améliorer les contraintes de participation des publics serait seule à même d’entraver les décisions.
La troisième implication transversale vise à étendre la perception de la chaîne d’approvisionnement de l’IA. Des exactions sur les ressources minières au Congo en passant par celles des étiqueteurs du Kenya, « les coûts de l’IA sont systématiquement répercutés sur les communautés les moins à même de les supporter et les moins représentées dans les instances décisionnelles. Tout cadre de gouvernance qui n’étend pas son champ d’application aux communautés minières de la République démocratique du Congo, aux modérateurs de contenu d’Afrique de l’Est et aux annotateurs d’Asie du Sud-Est ne gouverne pas l’IA. Il gouverne un complexe industriel lucratif et soigneusement orchestré. »
Le quatrième point, et peut-être le plus important sur le plan structurel, qui unifie divers exemples, concerne la question du contrôle de l’infrastructure de l’IA. « Les campagnes contre les centres de données au Nouveau-Mexique et en Uruguay ne sont pas de simples conflits environnementaux locaux. Elles constituent les prémices d’une lutte plus vaste : l’infrastructure physique de l’IA, incluant les terres, l’eau et l’énergie nécessaires à son fonctionnement, sera-t-elle considérée comme une ressource publique ou un actif privé ? Les communautés qui s’y opposent soulèvent des questions auxquelles aucune stratégie nationale en matière d’IA n’a encore apporté de réponse satisfaisante : qui autorise cette infrastructure ? Dans quelles conditions environnementales et démocratiques ? Et quels recours disposent les communautés affectées lorsque ces conditions ne sont pas remplies ? »
La liste des résistances à l’IA ne dit pas que la résistance triomphe toujours, bien au contraire, ni qu’elle suffira à corriger les inégalités de pouvoir que le développement de l’IA renforce. Elle recense seulement des actions juridiques, l’organisation des travailleurs, les campagnes citoyennes, les provocations artistiques, les outils techniques, la création de coalitions et le travail de documentation patient que ceux qui subissent ces préjudices mettent place. Ses exemples proviennent d’Allemagne, du Japon, du Kenya, du Chili, des Philippines, du Royaume-Uni, d’Uruguay, de la République démocratique du Congo et des États-Unis. Mis bout à bout, « ces éléments constituent une réalité que l’industrie de l’IA préférerait ne pas reconnaître : l’IA n’est ni une force irrésistible ni au-dessus de toute contestation démocratique, et des personnes sur tous les continents sont prêtes à remettre en question son caractère prétendument inévitable. »
Mais la liste ne se contente pas de suggestions critiques. Elle recense également des projets plus stimulants et constructifs. Par exemple : Hire a coop, une plateforme argentine et brésilienne doublée d’une campagne de communication pour encourager le recours à des entreprises coopératives, détenues par leurs travailleurs (voir également notre article sur le sujet). Ou encore, le réseau Huniki, un réseau d’entreprises technologiques spécialisées dans les langues africaines pour construire des systèmes sur mesures développées par et pour leurs locuteurs. De même, Lesan AI est un outil de traduction automatique pour deux langues éthiopiennes développés avec les traducteurs et les communautés qu’ils servent. Slow AI, de l’association AIxDesign met en lumière des approches à petites échelles… Enfin, le wiki du réseau Permacomputing défend des initiatives inspirées de la permaculture appliquées à l’informatique.
L’initiative AI Civics de Data & Society ou la liste des résistances à l’IA lancée par Karen Hao nous invitent à amplifier les mobilisations en rendant visibles celles qui se déploient déjà, en documentant leurs réussites et leurs échecs pour permettre à chacun de s’en inspirer… de les prolonger, de les reproduire.
« Pendant des années, DribbleUp, une entreprise d’équipements sportifs américaine, a consacré son temps et ses ressources à identifier les cibles publicitaires pour ses ballons de basket et de football sur Facebook. Mais depuis deux ans, elle diffuse ses publicités exclusivement via les outils d’intelligence artificielle de Facebook. Depuis, les ventes de DribbleUp ont dépassé ses dépenses marketing. L’entreprise a également augmenté son budget publicitaire sur Facebook. L’expérience de DribbleU
« Pendant des années, DribbleUp, une entreprise d’équipements sportifs américaine, a consacré son temps et ses ressources à identifier les cibles publicitaires pour ses ballons de basket et de football sur Facebook. Mais depuis deux ans, elle diffuse ses publicités exclusivement via les outils d’intelligence artificielle de Facebook. Depuis, les ventes de DribbleUp ont dépassé ses dépenses marketing. L’entreprise a également augmenté son budget publicitaire sur Facebook. L’expérience de DribbleUp illustre comment l’IA remodèle le secteur de la publicité numérique.»
Les systèmes d’IA aident les entreprises à automatiser leur marketing. « Petites et grandes entreprises peuvent désormais créer des publicités, cibler des audiences, enchérir sur des espaces publicitaires et mesurer leurs résultats. Ce processus a simplifié la tâche des entreprises locales, qui peuvent ainsi développer des campagnes aussi sophistiquées que celles des géants du secteur. Selon les entreprises technologiques et les marques, cette technologie rend également les publicités plus efficaces. Par conséquent, les investissements publicitaires affluent vers les géants de la tech », notamment Meta et Google. En 2022, année de lancement de ChatGPT, les ventes liées à l’IA totalisaient 1 milliard de dollars, un chiffre qui a atteint 35 milliards de dollars l’année dernière, selon Madison & Wall, un cabinet de conseil spécialisé dans le suivi du secteur. Cette année, les ventes devraient exploser de 60 %, pour atteindre 56 milliards de dollars. « Google et Meta étaient déjà en tête, et maintenant, grâce à ces outils d’IA, ils creusent l’écart », a déclaré Luke Stillman, directeur général chez Madison & Wall. A l’ère de l’IA, « être plus grand n’est pas seulement un avantage proportionnel pour Google et Meta », a-t-il déclaré. « C’est un avantage exponentiel. »
« L’IA a alimenté un boom de la publicité numérique car cette technologie peut analyser instantanément d’énormes quantités d’informations. Elle aide Google et Meta à proposer aux utilisateurs un contenu plus pertinent, ce qui augmente le nombre de publicités que ces entreprises peuvent diffuser. Elle permet de mieux comprendre les centres d’intérêt des utilisateurs, ce qui améliore la capacité des entreprises à cibler les publicités. Enfin, elle réduit les coûts publicitaires, libérant ainsi des fonds pour des campagnes plus ambitieuses. »
« La technologie est prête à remplacer significativement le travail manuel dans notre secteur », conclut un directeur marketing. Avec l’IA, le système est plus facile à utiliser pour les entreprises, même si la technologie sous-jacente est devenue plus complexe et que les annonceurs ont moins de contrôle sur l’apparence, l’emplacement et les performances de leurs publicités. « Les véritables avancées commerciales proviennent du ciblage. Auparavant, un annonceur disait par exemple : « Je souhaite cibler les femmes new-yorkaises âgées de 24 à 35 ans.» Désormais, c’est l’inverse : Meta et Google utilisent l’IA pour recommander aux marques les clients qu’elles devraient cibler. »« Les publicités non pertinentes ont diminué de 40 %, ce qui représente une amélioration significative pour une entreprise rémunérée uniquement lorsqu’un internaute clique sur une annonce. »
« Les outils d’intelligence artificielle (IA) prennent également en charge certains aspects du processus créatif et marketing. Google permet désormais de modifier le message des publicités en temps réel afin de mieux répondre aux attentes des internautes. Ce système, que Google appelle « Recherche réactive », crée et teste les textes publicitaires avant de diffuser automatiquement une campagne correspondant au mieux aux centres d’intérêt de l’utilisateur », et permet de réaliser des économies sur la conception de leurs publicités. « Chris Wilhelmi, responsable mondial des données et des médias chez Monks, agence de marketing, a déclaré que les clients économisaient 30 % sur le coût de leurs campagnes. Sur le contenu, les économies peuvent atteindre 65 %. Nombre d’entre eux réinvestissent ces économies dans le test et l’expérimentation de nouvelles stratégies publicitaires. »
« Aujourd’hui, tout le monde aborde le marketing comme un problème technologique ».
On l’a dit plusieurs fois dans nos pages, la tentation d’avoir recours à l’IA pour délibérer à la place des citoyens n’est pas sans risques. Et les perspectives de l’utiliser pour « étendre » le débat démocratique au risque de refermer la participation aux productions de l’IA, n’est pas un petit écueil devant nous.
De l’IA pour générer des publics
La chercheuse M.R. Sauter, professeure au collège d’information de l’université du Maryland, explique dans un article de recherche, que nombre
La chercheuse M.R. Sauter, professeure au collège d’information de l’université du Maryland, explique dans un article de recherche, que nombre de travaux proposent d’utiliser l’IA comme substituts ou compléments à la participation humaine dans nombre de processus démocratiques, comme les sondages ou les consultations. Et cette perspective est problématique.
Pour elle, ces propositions ne sont pas de simples interventions techniques qui visent à réduire les coûts de la participation, mais s’appuient sur un imaginaire civique qui rend ces substitutions plausibles voire souhaitables. Si ces propositions s’entendent, estime-t-elle, c’est d’abord parce que nous avons assimilé une forme d’équivalence entre humains et données, parce que nous pensons que les systèmes génératifs nous permettent de révéler des vérités et parce que nous avons intégré également le caractère procédural de la démocratie, tant et si bien qu’elle nous semble pouvoir fonctionner en l’absence même des gouvernés. Les données synthétiques qui seraient capables de refléter l’opinion de tout un chacun s’alignent sur les croyances du développement de l’IA qui nous fait croire en leur capacité de représentativité, tout en sapant l’éthique démocratique de la participation. Or, rappelle la chercheuse, « ces systèmes, par nature, entravent la capacité d’interpellation des citoyens et transforment la participation en la rendant symbolique plutôt que relationnelle ». L’imaginaire de l’IA civique ne comble pas les déficits démocratiques, mais les aggrave. Elle offre surtout une couverture idéologique présentant l’efficacité, la substitution des citoyens par des machines statistiques et l’abstraction comme s’ils pouvaient être des progrès démocratiques.
« Les institutions démocratiques contemporaines sont marquées par une érosion persistante de la participation. Dans ce contexte, les propositions de déploiement de systèmes d’IA dans la gouvernance participative et représentative se présentent souvent comme des interventions correctives, promettant efficacité, inclusion ou légitimité renouvelée. (…) L’imaginaire de l’IA civique permet, encourage et excuse l’utilisation de systèmes informatiques comme substituts aux personnes dans les structures de gouvernance participative et représentative. » Mais pour la chercheuse, ces solutions risquent surtout d’éroder plus avant la participation.
Reste que cet imaginaire d’une IA pour nous représenter tous repose sur le fait que l’efficacité, la quantification et l’optimisation sont déjà des enjeux très présents dans les structures de gouvernance, où l’importance consiste bien plus à mesurer ce que la participation produit. Plus encore, comme nous le disaient Nicolas Rio et Manon Loisel dans leur petit livre, Pour en finir avec la démocratie participative (Textuel, 2024, voir notre critique) la participation trop souvent ne permet pas d’élargir l’écoute, c’est-à-dire d’écouter ceux qui ne participent pas, quand cela devrait être sa fonction première. L’IA, malgré toutes les données qui sont les siennes, risque de rendre encore plus silencieux ceux qui n’y sont pas représentés.« La crise démocratique est une crise de l’écoute », disaient-ils. Mais écouter les données analysées par l’IA et ses biais, plutôt que les citoyens, ne la résoudra pas.
Activer l’IA pour améliorer la démocratie répond parfaitement aux enjeux et valeurs des acteurs qui se proposent de produire les interfaces des consultations sous IA, plus qu’à ceux de la démocratie elle-même, conclut M.R. Sauter.
Les simulations ne sont pas des opinons
Sur son blog, le professeur de mathématiques appliquées, Arthur Charpentier, résume parfaitement le problème en prenant un cas concret et en montrant comment l’IA est utilisée pour améliorer la représentation statistique. L’idée consiste à “inventer” des répondants supplémentaires pour mieux décrire de petits groupes, explique également le statisticien Thomas Delclite sur son blog sur Mediapart. Ces enjeux de calibration ne sont pas nouveaux, rappelle le professeur. « On modifie les poids de sondage pour respecter des contraintes connues sur la population, par exemple des totaux par sexe, âge ou région. » Mais ses corrections viennent avec un prix à payer : les données synthétiques ne produiront jamais la précision de personnes réelles et ont tendance à amplifier les biais d’échantillonnages non représentatifs. « La génération synthétique peut prolonger le biais, le lisser, le rendre plus cohérent, et surtout créer une fausse illusion », rendant l’incertitude plus invisible qu’elle n’est. Mais surtout, rappelle Charpentier, ces cas d’utilisations aggravent les risques de mauvaises interprétations et les pratiques manquent souvent de transparence sur leurs méthodes. « Ce n’est pas une querelle entre anciens statisticiens attachés aux preuves mathématiques, et nouvelles méthodes d’IA. Le cœur du problème est un problème très classique d’inférence. Qu’est-ce qui est aléatoire ? Qu’est-ce qui est observé ? Qu’est-ce qui est imputé ? Quel est le modèle ? Quelle incertitude est propagée ? Et que signifie exactement l’intervalle annoncé ? »« Le risque est fort de “corriger” ce qui ressemble à une anomalie statistique, alors que cette anomalie est peut-être précisément le signal politique ou sociologique que l’on cherchait à mesurer. »
On le comprend bien mieux quand on cherche à extrapoler les résultats. On pourrait ainsi générer des réponses de toute la population… mais dans ce cas là, ce que l’on génère, ce n’est pas la population, « c’est une image de la population selon un modèle, appris à partir de données limitées ». Si les données synthétiques peuvent être utiles, elles demandent une discipline méthodologique stricte. Or, les distinctions subtiles que ces techniques produisent ne sont pas seulement techniques : elles deviennent rapidement démocratiques.
Dans un second billet, Arthur Charpentier pointe une étude qui propose justement de demander à un modèle de langage de répondre à la place des personnes : la méthode s’appelle le silicon sampling, l’échantillonnage synthétique. L’attrait pour ces techniques est fort, on le comprend, notamment parce qu’elles permettent de réduire considérablement les coûts des sondages, enquêtes et pannels. Pour le statisticien Eli McKown-Dawson qui édite avec le statisticien Nate Silver le Silver Bulletin, ces modèles ne sont pas forcément inutiles, mais ils doivent rester ce qu’ils sont, des résultats de modèles et non pas des sondages : les sondages IA sont d’abord de faux sondages. Le silicon sampling vise à produire une prédiction de ce qu’un sondage pourrait dire. « Les sondages eux-mêmes sont à traiter avec précaution. Ils reposent sur des pondérations, des corrections de non-réponse, parfois des modèles de vraisemblance de vote ou de post-stratification. Si un échantillon contient trop de diplômés ou trop peu de jeunes, on corrige. Si un groupe est difficile à atteindre, on pondère ou on modélise. Mais il repose sur un socle “empirique”, avec des personnes qui ont été contactées, certaines qui ont répondu, et l’incertitude statistique porte sur ce passage fragile d’un échantillon observé à une population.
Dans un sondage synthétique, le modèle ne corrige pas une enquête, il se substitue à l’enquête. » Dans l’étude originale sur le silicon sampling, l’idée est de chercher à produire une « fidélité algorithmique », où le modèle est conditionné par des descriptions sociodémographiques issues de vrais répondants. Mais les auteurs formulent des conditions très exigeantes à leur usage. Dans une autre étude qui met en pratique l’échantillonnage synthétique, les chercheurs ont fait l’essai sur des données de l’élection présidentielle américaine de 2020… Dans un premier temps, les distributions simulées semblent être très proches des données. « Mais dès que l’on regarde par sous-groupes ou par thèmes, on commence à voir des soucis apparaître. Le modèle devient trop extrême pour certains groupes partisans. Les auteurs notent par exemple que les démocrates et républicains synthétiques votent presque unanimement pour leur camp, davantage que les répondants humains. Plus intéressant encore, le modèle se met à produire des réponses “inoffensives” (“harmless”) ou socialement attendues sur des sujets sensibles. Sur certaines questions de race, de genre, d’homosexualité, de santé ou d’immigration, les réponses générées semblent moins refléter la diversité des opinions humaines qu’une norme de prudence inscrite dans le modèle. Les auteurs parlent d’un biais vers des réponses “harmless”, qui peut varier selon les groupes simulés. Et c’est un point important ! Les modèles ne sont pas seulement des machines à reproduire ce qui se trouve dans les données d’entraînement. Ils sont aussi des machines alignées, filtrées, modérées, ajustées pour produire certains types de réponses. » Bref, « les simulations ne sont pas des opinions ». « Dans un sondage politique ou social, l’unité statistique n’est pas seulement une ligne dans un fichier. C’est une personne atteinte par un dispositif d’enquête, avec une probabilité d’inclusion, une réponse observée, une non-réponse possible, un poids, et une contribution à l’incertitude. Une ligne produite par un modèle n’a pas cette histoire. Elle dit quelque chose du modèle, pas forcément de la population. »
Pour Jamie Cummings, chercheur au LipLab de l’université de Gent, avoir recours à des participants artificiels peut « engendrer des résultats très variés, voire contradictoires, et aucune combinaison spécifique de choix ne permet d’obtenir des données correspondant parfaitement aux réponses humaines », explique-t-il dans un article de recherche discuté dans Science. En testant ces outils, lui aussi constate une grande variété de résultats selon les indicateurs et les critères retenus pour constituer ces publics synthétiques. « Si deux chercheurs différents menaient la même étude sur des échantillons synthétiques, en faisant des choix justifiés différents, ils pourraient aboutir à des conclusions opposées, explique-t-il. » Bref, il va falloir mieux documenter les situations où cet usage pourrait être approprié, comme par exemple pour des expériences pilotes ou pour tester des enquêtes. Le risque pourtant, c’est que la pratique se diffuse, notamment auprès d’acteurs bien peu académiques et bien peu regardant des limites de ces outils.
… à l’IA pour traiter des sondages et consultations
Mais l’IA n’est pas seulement utilisée pour générer des publics synthétiques, elle est aussi de plus en plus utilisée pour traiter les enquêtes, sondages et autres consultations… notamment les plus massives, comme l’explique le journaliste Chris Stokel-Walker pour Tech Policy Press.
En 2025, lors d’une réforme sur le secteur de l’eau, les agences britanniques ont reçu des milliers de contributions du public. Pour les examiner, ils ont eu recours à Consult, l’un des outils d’IA de la suite Humphrey* (qu’on pourrait qualifier d’Albert britannique ou de Mistral britannique puisque désormais il semble que ce soit plutôt Mistral qui soit l’IA envisagée pour équiper les fonctionnaires Français). L’outil a permis de classer les 50 000 réponses par thèmes évitant une fastueuse classification manuelle des réponses et de produire une analyse dédiée.
Pour Chris Schmitz, chercheur à la Hertie School de Berlin, l’enjeu ne consiste pas seulement à analyser les documents de consultation, mais aussi à empêcher toute manipulation du processus lui-même (même si Schmitz n’explique pas du tout comment : l’analyse établie par l’IA n’assurant pas pour autant de la synthèse équitable et valide des réponses). Le risque pourtant est bien que ces processus qui font appel à la contribution publique soient submergés par l’analyse automatisée… Et en retour, que les espaces de participation des publics soient eux-mêmes augmentés et démultipliés par l’IA, par exemple via des outils IA qui permettent aux citoyens britanniques de contester les demandes de permis de construire, leur permettant de démultiplier les contestations et de produire des contestations plus argumentées et volumineuses (mais pas toujours plus solides juridiquement).
Les analyses par IA de grands sondages ou de grandes cohortes sont souvent particulièrement problématiques. Bien souvent la méthodologie n’est pas transparente et les biais qui visent à qualifier automatiquement les réponses (par exemple en leur attribuant des notes selon des analyses sémantiques qui synthétisent les réponses en valeurs (positif ou négatif) ou en mots clés et réduisent les nuances et les expressions, souffrent de biais majeurs que beaucoup de cabinets de conseils qui mobilisent ces études pensent qu’ils se dissolvent dans le nombre… A l’image des études sur les réponses des cahiers de doléances des Français ou plus récemment l’étude du pluralisme des antennes de Radio France et de France Télévision produit par le très libéral et conservateur Institut Thomas Moore: une étude orientée pour démontrer que les programmes des émissions du service public seraient très orientés à gauche et qui a été largement dénoncé en se moquant du fait que l’étude par exemple classe les bulletins météo à gauche.
Dans le secteur public, l’IA commence à être utilisée à d’autres endroits encore, explique Stokel-Walker. Le Sénat italien utilise l’IA pour gérer la surcharge d’amendements en regroupant les propositions similaires. La Commission européenne, elle, a publié un appel d’offre pour la fourniture de chatbots multilingues capables d’aider les citoyens à s’orienter parmi les obligations légales et notamment la réglementation européenne sur l’IA et le DSA. La Chambre des députés italienne soutient le projet GENAI4LEX-B, qui facilite la recherche et la rédaction législatives en synthétisant les amendements des commissions et en vérifiant la conformité des projets de loi aux normes de rédaction. D’autres pays utilisent également l’IA pour optimiser le processus d’élaboration des lois.
Pour Schmitz, le problème est que les gouvernements considèrent l’intégration de l’IA comme une série de petites corrections techniques plutôt que comme une transformation structurelle de la manière dont les citoyens peuvent influencer l’État (et dont l’État peut influencer les consultations). Les outils de tri, de synthèse et de rédaction peuvent sembler être des améliorations logiques (on a déjà pointé certains biais des synthèses automatisées et les problèmes de dégradation des données quand l’IA les modifie comme les formes de sur-interprétations liées aux outils d’inférences) , mais « ce sont des solutions de fortune », soulignant qu’il ne constate « aucune réflexion systématique sur les conséquences à long terme pour la légitimité des processus de participation citoyenne ». Mais si les gouvernements l’utilisent principalement pour gérer les données générées par les machines ou pour gagner du temps dans les traitements, ils risquent d’aggraver la méfiance qu’ils cherchent justement à endiguer… c’est-à-dire à rendre la participation encore plus éloignée car de moins en moins représentée.
Hubert Guillaud
—- * Non sans une certaine ironie, Humphrey tire son nom de la série télévisée satirique des années 80, Yes Minister, dans laquelle un nouveau ministre des affaires publiques est confronté à Humphrey Appleby, responsable de cette administration, qui use de tous les moyens à sa disposition pour décourager la moindre proposition du ministre… afin que rien ne bouge (merci à Aron West pour cette précision).
« Les concepteurs de logiciels et de matériel informatique savaient que leur rôle était de servir leurs clients. Il s’agissait d’identifier un besoin, puis d’y répondre. Mais à un moment donné après la crise financière, les aspirants entrepreneurs ont transformé cela : ils étaient persuadés que leur rôle était d’inventer l’avenir et que celui des consommateurs était de se conformer à cet avenir inventé. (…) Au lieu de technologies capables de résoudre des problèmes concrets, les entreprises ont
« Les concepteurs de logiciels et de matériel informatique savaient que leur rôle était de servir leurs clients. Il s’agissait d’identifier un besoin, puis d’y répondre. Mais à un moment donné après la crise financière, les aspirants entrepreneurs ont transformé cela : ils étaient persuadés que leur rôle était d’inventer l’avenir et que celui des consommateurs était de se conformer à cet avenir inventé. (…) Au lieu de technologies capables de résoudre des problèmes concrets, les entreprises ont enchaîné les modes passagères comme les NFT, le métavers et les grands modèles de langage. Leur point commun ? Elles ne sont pas conçues pour résoudre un véritable problème de marché. Elles sont conçues pour enrichir les investisseurs et les entreprises. »
Les géants de la tech nous promettent que demain l’IA générative dominera notre avenir. « Je parierais sans hésiter qu’un vaccin contre la rougeole obligatoire serait plus bénéfique à la survie des enfants américains que tout ce qu’OpenAI a accompli avec ses milliards de dollars à ce jour ».
Les géants de la tech nous promettent la robotisation de nos existences. Mais ils oublient que nous avons déjà des robots domestiques. « Plusieurs, en fait : un lave-vaisselle, un lave-linge et un sèche-linge. Ils ne sont pas très mobiles, et pourtant, ils m’ont épargné un travail considérable. Mon réfrigérateur date des années 90 et mon micro-ondes n’est guère plus récent, et ces deux appareils m’ont été d’une aide précieuse : ils ont simplifié la conservation et la préparation des aliments, sans aucune intervention de l’IA. Il ne semble pas que l’IA puisse faire grand-chose pour améliorer les choses par rapport au niveau de base déjà atteint par ces machines, d’autant plus que ma technologie « basique » n’a pas nécessité de mise à jour depuis plus de 20 ans. » « Si vous voulez me fournir un robot domestique, j’ai une exigence très claire : il doit être au moins aussi performant que mon lave-vaisselle. »
« Les LLM sont, au mieux, une technologie d’entreprise qui peut faciliter certains types d’organisation de données ou accélérer la programmation. Cela n’a quasiment rien à voir avec la vie de la plupart des gens. Faciliter l’écriture de code ne change rien au fait que je n’ai pas envie d’écrire de code. »
« Les NFT, le métavers et ces casques de réalité virtuelle… n’ont séduit qu’un public très restreint, surreprésenté dans le capital-risque et chez les aspirants entrepreneurs du secteur technologique. Le cycle de hype de la Silicon Valley a fait des merveilles pour ces produits, et notamment pour ceux qui ont fondé des entreprises dans ces secteurs. Mais la plupart d’entre nous n’aspire pas à fonder une entreprise qui domine le monde. »
[en]
Oscar died a bit over a month ago. Five weeks exactly, actually. Of course it hasn’t been simple. I’ve been wanting to write for weeks, but not getting around to it. It’s a pattern, isn’t it. It has been for years, decades probably. Wanting to write, needing to write, and not getting around to it. Other things are “more important”, always. Anyway, now I’m writing.
The first week I was off work, and that was a good decision. My brain was useless. You know grief badly messes up your a
Oscar died a bit over a month ago. Five weeks exactly, actually. Of course it hasn’t been simple. I’ve been wanting to write for weeks, but not getting around to it. It’s a pattern, isn’t it. It has been for years, decades probably. Wanting to write, needing to write, and not getting around to it. Other things are “more important”, always. Anyway, now I’m writing.
The first week I was off work, and that was a good decision. My brain was useless. You know grief badly messes up your ability to function, right. Well, put that on top of the brain injury that is already messing up my ability to function. So, good call.
Then I went back to work, a short three-day work week before the bank holidays. I struggled a bit, but it was OK. It’s weird, I keep wanting to say Bagha instead of Oscar. Is this a grief/cat thing, or is it related to my post-accident language issues? I was sad, but ok-ish sad, you know, because it was mostly a “good death”, he’d lived a long life, had good years with me, we’d managed his ailments as much as we could, and when it wasn’t possible anymore, we said goodbye before it got too bad. At least I hope. The worst was something I put a word on more recently: yearning. I missed him, simply said. I understood that he was gone and it was kind of ok, but I missed him.
With Oscar’s death I lost a lot of daily structure. His habits, medication schedules, etc. I’ve been working hard to get back to managing my schedule in some way. Not easy, and I’m not there yet. I realised that not having a “meal plan” for the next day led to me procrastinating dinner, because I’d end up in the situation where I’m hungry, I’m tired, my meds are checking out for the day, I not only need to stop whatever I’m faffing around with or engrossed in to make food, but I need to decide what I’m going to eat. And that’s what stops me, because at that point in the day, I have no decision capacity left, particularly when I’m hungry. So I’ve been paying attention to making a meal plan for the next day every evening after dinner. It helps a lot. It’s not 100%, but it helps – and removes another obstacle to me being in bed with the lights out and my eyes closed at some half-decent hour.
Week three was great. I thought I was out of the woods. My mood was OK, I was starting to not be jolted by Oscar’s absence each time I opened the door to the flat, I was getting meals and sleep back under control, work was good, I even spoke German for two hours and a half with my boss, something I would have been incapable of doing a month earlier. I reached Friday evening feeling like I had some energy to spare, and planned a little social life and a short hike for the extended week-end. Sad though Oscar’s death was, I figured that I was feeling the benefits of the major reduction in my mental load: no more worrying about medication schedules, about how he’s doing, about when the next seizure will be, about when it will be time, about how I will cope with his death.
Week four, last week, I crashed, and I didn’t see it coming. I was a bit tired but OK during the first couple of days. But Thursday evening, my brain collapsed. And all the rest collapsed. Because when your executive function is impaired, it messes up your emotion management, for example. It messes up your ability to stick to your schedule and your decisions – and simply, your decisions. It messes up your ability to stop when you need to stop, get done what you need to get done. Hello, downwards spiral. Last week-end, I couldn’t make it through a 45 minute conversation with a friend. In the days that followed, I was either stuck in some escape-activity, or feeling super sad, crying in the evening and not able to sleep. Grief of course, Oscar and all the little wagons the train of grief pulls along with it when it enters the station, but also discouragement because I’d crashed again, because I was so happy the week before, because once more, despite all the care I take to pace myself and watch out for warning signals and take it easy and be patient, I hadn’t seen it coming until it was too late.
I’ve been picking myself up these last few days. I’m still having a hard time, but I’m slowly functioning better. Frankly, so much effort for what sometimes feels like so little result. I am blessed that I have the very realistic prospect of recovery to hang onto, even if the timeline is uncertain. Maybe it’s a double-edged blessing, though, because I’m working with a moving target, which makes it easier to overshoot regularly.
I have a gigantic backlog of “to do’s”. It reminds me of the years before my ADHD was diagnosed – this was pretty much a constant state. It is not pleasant. Setting priorities is always very challenging for me, and the current circumstances make it so much worse. I’ve been trying to get my Digital Assistant up and running, and it’s proving a perfect metaphor for life: each thing you decide to tackle seems to spawn half a dozen new items to deal with. It’s like brain crashes: being forewarned and knowing the tricks and strategies isn’t always enough. Even having top-notch support, which I’m thankful to have.
The only thing I don’t have right now and which, I think, does me a disservice, is that I live alone. This means I have no “everyday help” for simple things like “hey, let’s eat” or “yeah, potting those plants this afternoon seems like a good idea” or “hmm, I noticed xyz these last few days”. It’s all between me and me. I have friends, but they don’t live with me, they don’t see me every day. I know living with people can bring on its share of challenges, of course. But it’s also a fact that recovery is more difficult when you don’t have day-to-day support, physically present. That’s one of the reasons that a Big Project of mine for the coming years is to get seriously cracking on a co-living concept for my senior years. But first, the brain needs to get back into shape.
I find the state of everything that has to do with administration really depressing. After decades of applying capitalist logic to public and customer service, we’ve been left with empty broken shells where a few harried drones try and keep things together as best they can, doing “their job” – but nobody sees the whole system anymore, nobody can, and even those that want to “do good” are promptly set back into their drone slots by whatever dysfunctional machine everybody is imprisoned in. It’s not the people who suck, it’s the processes, and even if somebody was responsible for repairing them, there are no ressources available. Enshittification is not just limited to Big Tech.
At work, I feel like I’m in a place where I can actually bring some change. But every other week, I’m hit by a wave of doubt. Am I being too ambitious, or even, is this hubris, to think I can move enough people to think a bit differently, work a bit differently? We’re also in a big machine that despite its qualities (and it has many), sometimes feels like a patchwork of parallel organisations that struggle to relate to one another. I think everybody working in a big company knows what I mean. I consider myself extremely lucky to have the chance to bring community (real community) in a space that is not used to it – but will I manage? I know I’m the right person for the job, and I am convinced it will work and that I can do it, except when I find myself wondering if it is maybe one of those impossible, system-fixing endeavours that will end up either crushing me or sucking me dry.
It’s very similar to how I feel about my recovery, actually. I know I’ll see the end of it, I know I’ll get better and that it isn’t wishful thinking because we are able to observe progress along the way, just as I can in my work, but every now and again I am seized by the fear that I might be blinding myself. I deal with the fear: have a little chat with it, and tell it to go back outside and play. But when I’m unwell, it’s a bit more complicated to convince it to leave me alone.
I miss Oscar. And there is another layer, where I just miss having a cat in my home. I’ve invited Juju to check out the flat this week-end. He’s shy, so we’re doing this carefully. Juju is the shyest cat I’ve had, I think. He’s not extremely shy, just normal-shy for a cat. Cautious. He hides when people come to the coworking space – my other cats didn’t do that. He needs coaxing. I leave the flat door open so that he doesn’t find himself trapped and freak out, give him a little treat-food inside, talk to him gently and invite him to look around, and leave whenever he likes.
I’d like to have him around when I’m in my flat. But I also don’t want to deal with “cat worries” right now: making sure he doesn’t get scared while he’s getting to know the place; giving him scratching-surfaces and protecting my tatamis which he’s already tried sinking his claws in once; food, water bowl, what about a litter try? How do I manage the “ins and outs” between the flat-floor and the coworking-space-floor where he has his cat-flap? Is there a risk he might start spraying up here (he doesn’t downstairs)? There will be a time for this, but right now, much as I’d like to be typing this on my balcony in feline company, I’m not ready for the work it requires. Getting myself back on my feet comes first – Juju is a stable situation right now, and can continue being one.
I’m starting to understand the seduction of the frugal life. Mine is the opposite. My life is full of stuff, both physical and not, and all this stuff generates work. Something as simple as having houseplants and a balcony: you have to take care of the plants. I like having plants! I have lots of plants. But lots of plants means a lot of plants to take care of. I know people who have zero plants. Imagine that! No plants to take care of. No pets. No car, no bicycle, no chalet, no coworking space, no boat. It could be just me, my furniture and my flat. Much less to manage. Oh, and my health – because that’s definitely a big chunk. Would it be worth it? Of course I’m answering no, but I can see how that answer is non-obvious. Is my life worth simplifying? Do I want to? Do I need to? Do I even want to think about this?
Today I could have taken care of my plants. I could have tidied up downstairs – at least, made some progress. I could have dealt with the mess at the entrance of my living-room, a hotspot that always seems to flare up no matter what I do about it, to the point that I can see I’ve given up on it. I could have inventoried my too-numerous jars to decide what I give, what I keep, and where, and moved them, or at least part of them, to the cellar. I could have done my taxes. I could have caught up with my snail-mail backlog. I could have worked on migrating DF to Discourse, I could have called a dozen different people I want to catch up with, I could have gone for a walk in the woods (ah no, I made a big hole in my heel yesterday with a piece of metal that slid out of my sandal, which reminds me), I could have repaired the zipper of my bag, stuck that piece of metal back in my sandal for good, repaired half a dozen other things I can’t recall right now, change the battery of my maybe-not-dead previous phone (ifixit kit waiting for me since… last summer?), and that’s just the start. I’m OK with not doing everything, with letting things slide, but I’d love to have a magic formula to help me pick what to do now.
If you’re still reading this, I sincerely apologise. I have to be honest, I’m writing this much more for me than I am for you. This is certainly not the most exciting blog post to read. And it’s getting long. You might be waiting for me to get to the point, but I don’t think there is one. I’ve been unwell, and feeling the need to write, but not too sure what, and well, here it is. I’m thinking on my keyboard. I appreciate you coming along for the ride, really. I hope you get something out of it, somewhere in between the words and lines and paragraphs.
Last week I finally printed out some photos of Oscar. I wanted to give a handful of people thank-you cards – his vet, for example, and my kind neighbours who dealt with his insulin injections these last years, when I was away. I can’t remember when I last printed anything. Probably when Tounsi died. I remember going to the photo shop, which still existed back then, and getting ten copies of a photograph. Now, I’ve discovered, there are machines in supermarkets where you can AirPrint your photos directly. The one at my usual supermarket only takes cash. Imagine that! Coins. I never carry any cash – so it took me a few attempts to manage to get there with the cash, with my photo selection, and with a functional machine (yep, it was out of ink or something). I did a first batch in another shop where you could pay by card, and discovered that unless you turned it off, the printer “improved” your photos by adding a ridiculous amount of sharpening. Anyway, I’ve got it figured out now, and I’m going to be printing much more photos in the future. Oh yay, another extra thing to do!
As I was hunting for nice photos of Oscar in Lightroom, back through the years, digging up and tagging a few thousand photos, I was struck by how much his life had shrunk. Of course that’s how it goes, we all know. It happens gradually. Seeing it in a space of an hour or two is jarring. He used to jump on the table. He used to groom himself, even the backside. He used to be all over the place. When did it stop? Little by little, I know, but I was almost shocked to see Oscar doing things or in positions that had faded from my memory. It made me sad and glad at the same time. Glad for the life he had, sad for what he had lost by the time it ended. I really hope I did right by him. I think I did. I hope I’m right.
I saw something on the socials that stuck with me: animals don’t care about length of life. They are in the now. They just care about quality of life today. We are not like that. We might want longer life even if it means it is not as rich as it could be, as it was. We’ll make the choice to cut off the leg and live the next 20 years without, rather than hang onto it and be gone in a year. Of course it’s a balancing act for us too – it’s not like we don’t care about quality of life. But for our pets, for them, that’s pretty much all there is. I’m aware there is a tension regarding these end-of-life decisions: because for the human who loves the pet, well, we tend to want longer. There is a balance to be found. These are really complicated questions, and I wrestle with them, I guess I always will. We probably all do.
I think of what Oscar’s life had become, as with Quintus. Was it really still worth it? It was for me, but was it worth it for them? Was it right? My evaluation was that there was more positive than negative for them – and when there wasn’t anymore, that’s when we stopped – but what do I really know? At this stage, I wouldn’t do things differently. But I do wonder. I don’t think it’s a bad thing.
« L’Etat providence numérique » européen promet surtout surveillance, contrôle et exclusion alerte l’EDRi, la grande association européenne de défense des droits numériques. En instaurant une interface numérique entre les demandeurs de protection sociale et les prestataires, les États européens peuvent se soustraire à leurs obligations de services publics, « transformant le filet de sécurité social en un filet de pêche numérique, c’est-à-dire en un système de collecte et d’analyse des données pe
« L’Etat providence numérique » européen promet surtout surveillance, contrôle et exclusion alerte l’EDRi, la grande association européenne de défense des droits numériques. En instaurant une interface numérique entre les demandeurs de protection sociale et les prestataires, les États européens peuvent se soustraire à leurs obligations de services publics,« transformant le filet de sécurité social en un filet de pêche numérique, c’est-à-dire en un système de collecte et d’analyse des données personnelles » sans précédent. Cela se fait par le biais d’une architecture de gouvernance qui réoriente l’établissement de l’identité et de la confiance en une démarche descendante visant à considérer partout les bénéficiaires avec suspicion.
En Europe, la fourniture de services publics essentiels – santé, sécurité sociale, éducation – relève principalement de la compétence des États membres, rappelle l’Edri. L’UE n’a aucun mandat direct pour dicter, par exemple, comment un habitant d’une zone rurale de Roumanie accède à un médecin ou comment un travailleur à Lisbonne perçoit des allocations chômage. Or, dénonce l’association, l’Union européenne, en présentant la numérisation comme un enjeu de marché intérieur et d’interopérabilité, déploie un ensemble de projets et de réglementations touchant des secteurs tels que la justice, la fonction publique et l’administration, et visant à faciliter et accélérer la communication et l’échange de données entre les systèmes des différents pays grâce à une numérisation uniforme. Elle est ainsi parvenue à s’immiscer au cœur des politiques sociales nationales. En facilitant les procédures administratives intra européennes ou le principe de la transmission unique (qui garantit que les citoyens et les entreprises ne fournissent leurs données à l’administration publique qu’une seule fois), présentées comme de simples commodités techniques, l’Europe déploie des « cadres coercitifs contraignant les administrations nationales à aligner leurs infrastructures sur les normes définies par Bruxelles ». Par le biais de mécanismes de financement, l’UE a de facto fait de la transformation numérique une condition à l’octroi de son soutien financier, court-circuitant ainsi le débat démocratique qui accompagne habituellement les grandes évolutions des politiques sociales. « Cette situation rappelle les tendances observées dans les pays en développement au cours de la dernière décennie, où des acteurs transnationaux ont financé des projets de développement conditionnés à des engagements en matière de numérisation, comme l’intégration de l’identification biométrique numérique dans les programmes du secteur public.»
« Cette extension du pouvoir s’est amplifiée pendant la pandémie de COVID-19. Le déploiement rapide du certificat numérique COVID de l’UE a été salué comme une réussite de la coordination européenne. Cependant, du point de vue des droits humains, il s’agissait d’un précédent dangereux. Il a instauré une infrastructure à l’échelle du continent pour la surveillance sanitaire et le contrôle des déplacements, mise en place dans un contexte d’état d’exception et sous un contrôle parlementaire limité. Au lendemain de la pandémie, cette gouvernance en mode d’urgence est devenue la nouvelle norme. L’infrastructure du certificat COVID n’a pas disparu ; elle a évolué. Elle a fourni le modèle technique et politique du portefeuille d’identité numérique de l’UE. Ce qui était justifié comme une mesure d’urgence pour prouver le statut vaccinal s’est transformé en un outil permanent que l’UE entend lier à tout, des permis de conduire aux ordonnances en passant par l’interopérabilité des comptes bancaires. La crise a donné l’impulsion nécessaire pour imposer des infrastructures d’identité intrusives qui auraient rencontré des années de résistance » dans les débats législatifs nationaux.
Pour l’Edri, la stratégie de numérisation de l’UE n’est pas une politique monolithique, mais repose sur un ensemble de projets sectoriels qui se chevauchent, comme :
« L’Espace européen des données de santé (EHDS) : Cette initiative vise à créer une infrastructure transfrontalière massive pour le partage des dossiers médicaux. Si la promesse est d’améliorer les soins pour les touristes, les dispositions relatives à « l’utilisation secondaire » permettent le partage de données de santé pseudonymisées avec les chercheurs et l’industrie. Cela pourrait permettre de traiter les détails les plus intimes de nos vies comme une ressource pour l’économie des données, de plus en plus considérée comme essentielle à la compétitivité européenne, souvent avec des mécanismes de retrait opaques qui privilégient l’innovation à l’autonomie.
ESSPASS (Carte européenne de sécurité sociale) : En numérisant la vérification des droits à la sécurité sociale pour les travailleurs mobiles, l’UE s’oriente vers une identité sociale numérique portable. Bien que cela puisse paraître pratique pour les travailleurs expatriés, ce système crée un registre centralisé des droits sociaux facilement contrôlable par les inspecteurs du travail et les autorités frontalières, transformant ainsi l’aide sociale en un outil de contrôle migratoire.
eIDAS 2.0 et le Portefeuille EUDI : le Portefeuille EUDI est au cœur de cette architecture numérique. Il vise à regrouper toutes les informations d’identification numériques dans une seule application mobile. En imposant aux « intermédiaires » privés (comme Google et Apple) et aux services publics essentiels d’accepter ce portefeuille, l’UE impose de fait une existence numérique par défaut.»
Les atteintes à la vie privée liées à ces programmes sont profondes, souligne l’Edri. « Nous passons d’un monde d’interactions locales et analogiques – où votre médecin connaît votre état de santé et votre mairie vos besoins en logement – à un monde de visibilité centralisée et numérique » total.
Lorsque les services essentiels sont numérisés par défaut, chaque interaction génère une donnée. L’agrégation de ces données dresse un portrait complet de la vie d’un individu. Les risques ne se limitent pas aux violations de données, mais s’étendent au profilage intime. Une identité numérique utilisée aujourd’hui pour accéder à une pharmacie peut être liée demain à un titre de transport, permettant à l’État de reconstituer les déplacements et les relations d’un individu avec une précision extrême.
De plus, ces systèmes s’appuient souvent sur le principe de « protection des données dès la conception » comme un simple argument de façade. On nous assure que des protocoles permettant l’authentification de l’utilisateur sans partage d’informations supplémentaires le concernant, nous protégeront, dénonce l’association. « Or, la protection de la vie privée ne se résume pas à la confidentialité des informations : elle concerne aussi l’utilisation des infrastructures pour exercer un pouvoir. Même si les données sont chiffrées, l’obligation d’utiliser un outil numérique autorisé par l’État pour exercer un droit fondamental constitue, en soi, une forme de surveillance. Elle crée un point de blocage où l’État peut couper l’accès à un service essentiel d’un seul coup ».
Le risque, à terme, s’alarme l’Edri, c’est bien plus l’exclusion by design que la protection by design. Les objectifs du programme de la « Décennie numérique » visent à ce que 100% des services publics soient numériques d’ici 2030. Mais qu’adviendra-t-il des milliers de personnes confrontées à des obstacles technologiques ?
« La numérisation constitue souvent un frein pour les plus marginalisés : les personnes âgées, les sans-abri, les migrants et les personnes vivant dans la pauvreté. Lorsqu’un bureau physique ferme et est remplacé par un portail web ou un code QR, le service n’est pas nécessairement modernisé, mais de fait supprimé pour une partie de la population. On assiste à l’émergence d’une « sous-classe technologique » qui doit s’appuyer sur des intermédiaires (famille, ONG) pour accéder à ses droits, ce qui la prive de sa dignité et de sa vie privée. »
Sans compter que l’information unique et l’interopérabilité sont encore plus vulnérables aux erreurs : « un statut d’immigration mal classé ou une alerte à la fraude signalée à tort – peut se propager instantanément à l’ensemble du système administratif européen, sans possibilité de recours ».
« La volonté de l’UE de numériser les services essentiels est souvent présentée comme une fatalité technique. Or, il n’en est rien : c’est un choix politique qui privilégie l’intégration au marché et le contrôle administratif au détriment des droits fondamentaux et de l’inclusion sociale. »
À l’approche de 2030, il est nécessaire de remettre en question le consensus du tout numérique. Nous devons revendiquer un « droit à l’analogique », défend l’Edri : une garantie juridiquement contraignante que chaque service public essentiel reste accessible par des canaux non numériques et centrés sur l’humain, sans pénalité. Pour que ce droit soit effectif, il est indispensable que les options analogiques soient conçues de manière à ne pas être inférieures aux options numériques et qu’elles constituent un véritable choix pour tous, en particulier pour les communautés qui risquent d’être systématiquement exclues.
« Nous devons veiller à ce que l’interopérabilité ne devienne pas synonyme de visibilité totale.»
« Le contrat social européen repose sur les valeurs de solidarité et de droits humains. Si nous laissons ce contrat être réécrit par le code, sans transparence ni mandat clair, nous risquons de nous réveiller dans une Europe où l’État n’est plus un fournisseur de services, mais un gestionnaire d’identifiants numériques, et où le citoyen n’est plus titulaire de droits, mais un utilisateur dont l’accès » est révocable.
« L’IA est un concentré de concepts d’organisations ratés, et l’apogée de l’ère des incompétents, une époque où nous sommes dirigés par des gens tellement déconnectés de la réalité du terrain qu’il était inévitable qu’une technologie soit créée spécifiquement pour exploiter leur incompétence », cingle Ed Zitron, dans un billet savoureux d’être si rageux.
« Si les PDG sont particulièrement vulnérables à la psychose de l’IA c’est parce qu’ils sont suffisamment éloignés du travail de terrain né
« L’IA est un concentré de concepts d’organisations ratés, et l’apogée de l’ère des incompétents, une époque où nous sommes dirigés par des gens tellement déconnectés de la réalité du terrain qu’il était inévitable qu’une technologie soit créée spécifiquement pour exploiter leur incompétence », cingle Ed Zitron, dans un billet savoureux d’être si rageux.
« Si les PDG sont particulièrement vulnérables à la psychose de l’IA c’est parce qu’ils sont suffisamment éloignés du travail de terrain nécessaire pour générer de la valeur avec l’IA. Les LLM sont dangereux pour de nombreuses raisons, mais l’une des moins évoquées est leur capacité à manipuler les dirigeants les plus incompétents. L’IA générative est très douée pour imiter le travail, tout comme la plupart des managers et des dirigeants. Comme eux, même si elle est totalement incapable de faire quelque chose, elle prétendra le contraire et vous complimentera pour vos suggestions. Et c’est pour ça que les crétins du business l’adorent. »« Là où un humain dirait des choses agaçantes comme « c’est impossible dans ces délais » ou « on n’a pas les ressources nécessaires », l’IA répondra « bien sûr, tout de suite ! » et dépensera un maximum de ressources. »
« Les entreprises ne dépensent pas des millions, voire des centaines de millions de dollars par an en IA parce que c’est une bonne chose, mais parce qu’elles sont dirigées par des personnes totalement incompétentes. L’IA générative est un véritable aimant pour les surveillants, les mouchards, les incapables, les flagorneurs et tous ceux qui détestent travailler et aiment rabaisser les autres. Autrement dit, elle flatte les ratés qui pensent qu’apprendre ou exceller dans un domaine est une perte de temps, car ils méritent de faire ce qu’ils veulent sans le moindre effort. » Les imbéciles de l’IA du monde des affaires sont des sortes d’escrocs, à l’heure où l’escroquerie est devenue la norme pour une part alarmante de la société.
Si nous en sommes arrivés là, pour Zitron, c’est parce que la définition d’une bonne entreprise a évolué : nous sommes passés d’une entreprise fabriquant de bons produits à un prix juste, fidélisant sa clientèle et s’appuyant sur un marché durable, à une entreprise capable d’afficher la plus forte croissance boursière d’un trimestre à l’autre. C’est ce qu’il appelle, l’économie de la dégradation, une expression qui décrit bien comment les entreprises technologiques ont volontairement dénaturé leurs produits phares pour satisfaire leurs actionnaires, transformant des services utiles – et parfois appréciés – en une coquille vide, au nom de la croissance. Il est important de noter que cette transformation ne se limite pas au secteur technologique et n’est pas apparue uniquement lorsque ce secteur a pris sa forme actuelle, alimentée par le capital-risque et cotée en bourse. « Le management, en tant que concept, ne signifie plus « faire le travail », mais instaurer une culture de domination et d’extraction de valeur. » Un manager, à l’instar d’un PDG, n’occupe plus une fonction à responsabilités réelles : son rôle est de s’assurer que vous travaillez, de connaître suffisamment votre travail pour pouvoir vous donner des instructions, « mais ce rôle de « donner des ordres » ne s’accompagne d’aucun travail concret, et ces instructions n’ont pas besoin d’être utiles, ni même pertinentes.»« Les problèmes que Microsoft, Google, Meta et Amazon résolvent quotidiennement sont ceux liés à leurs actionnaires. Comment assurer notre croissance ? Comment maintenir l’engagement des utilisateurs avec nos produits ? Comment convaincre nos clients de payer plus cher pour nos services ? »
« Les machines à fabriquer du consentement promues par les imbéciles du monde des affaires servent à nous couper de la réalité, comme eux-mêmes le sont », explique Zitron avec sa verve habituelle. Comme si se déconnecter de la réalité était le principal moyen pour espérer devenir riche et occuper un poste de direction.
« C’est pourquoi tant de patrons ont une réaction si anormale face à l’IA, la promouvant et la défendant comme s’il s’agissait de leur religion ou de leur patrie. Si beaucoup utilisent les LLM et les perçoivent comme une sorte de calculatrice ou de moteur de recherche, beaucoup d’autres y voient l’opportunité de s’élever au-dessus du peuple qui travaille ou qui crée, car ils trouvent le processus de travail ou d’effort absolument répugnant. Quand quelqu’un dénigre l’IA, l’idiot du Business se sent obligé de la défendre bec et ongles, car attaquer les LLM revient à attaquer leur production, ce qui revient à juger ceux qui tolèrent sa médiocrité et ses hallucinations inévitables. »« Les LLM impressionnent les écrivains qui rechignent à écrire, les développeurs qui rechignent à coder, les chercheurs qui rechignent à faire de la recherche et les juristes qui se désintéressent de la jurisprudence. Ceux qui vous vantent les mérites de l’IA et vous persuadent qu’il est indispensable de l’utiliser cherchent en réalité à justifier leur propre paresse ou leur aversion pour l’effort. Quant à ceux qui sont impressionnés par les travaux des LLM, ils ont généralement des exigences crasses ».
« L’agressivité dont font preuve les promoteurs et les dirigeants de l’IA envers ceux qui ne sont pas convaincus révèle une véritable faiblesse intellectuelle et morale. Personne n’a jamais eu raison, avec une telle insistance, une telle agressivité et un tel discours péremptoire du type « c’est là, et si vous ne l’adoptez pas, vous êtes stupide et condamné ». Personne d’aussi désespéré, insistant et autoritaire n’a jamais eu de bonnes intentions ».
Les zélotes de l’IA «ne défendent pas tant les LLM que la forme la plus aboutie du capitalisme », celle d’un capitalisme de corruption, de prédation, mafieux. « L’industrie de l’IA est fondamentalement une machine à escroquer », balance Zitron. « Quelqu’un qui n’aime rien d’autre que recevoir des éloges pour le travail des autres peut désormais exécuter plusieurs agents simultanément, modifier sans cesse les instructions et se faire passer pour un spécialiste en IA, ses IA lui donnant l’air occupé d’une manière difficile à contester tant il n’y a que mensonges ».
« Quand toute votre économie est organisée autour de cadres intermédiaires, de vice-présidents et de dirigeants qui ne font aucun travail concret, l’IA paraît donc magique ».
« Comme les modèles d’IA peuvent être intégrés à n’importe quel système, par extension, n’importe quel fondateur d’entreprise spécialisée en IA peut prétendre que n’importe quel secteur peut être automatisé grâce à l’IA. Et comme les investisseurs en capital-risque ne n’y connaissent rien, ils sont naturellement impressionnés par n’importe quelle démo ou promesse qui semble plausible, surtout lorsqu’un LLM peut créer quelque chose qui ressemble à un logiciel.»
Nous sommes confrontés au plus grand gaspillage de capital de l’histoire de l’humanité. Et l’industrie de l’IA est en train de perdre. Personne ne sait vraiment comment mesurer le retour sur investissement de l’IA, rappelle Zitron. « Les entreprises ignorent la valeur réelle de l’IA et le budget qu’elles devraient y consacrer. C’est pourquoi Uber et d’autres épuisent leurs budgets de jetons sans, semble-t-il, réduire leurs dépenses.»« Tout ce baratin sur l’IA, soi-disant inévitable, réelle et surpuissante, ne semble jamais se traduire par des profits. » L’expérience d’Uber – qui brûle beaucoup d’argent dans l’IA – est représentative de l’expérience de pratiquement toutes les entreprises avec l’IA. Des dirigeants incompétents, totalement déconnectés de la production, exigent que leurs employés consomment un maximum de ressources, les incitant à le faire pour des raisons qui n’ont de sens que pour quelqu’un qui ne travaille pas. « L’IA est censée être un outil de rationalisation ultra-puissant qui transformera le monde du travail à jamais. Or, le résultat concret semble être : nous avons dépensé des sommes considérables pour quelque chose qui enthousiasme nos managers les moins compétents », explique Zitron avant d’analyser la profondeur de la bulle économique de l’IA, son grand cheval de bataille, depuis longtemps. Le modèle économique de l’industrie de l’IA est totalement irrationnel, répète celui qui n’a cessé d’en documenter les terribles excès. Il n’y aura pas de méthodes miracles pour rendre profitables des services facturés 100 ou 200 dollars par an quand ils en coûtent des milliers. « L’une des plus grandes erreurs que nous puissions commettre est de croire que les riches et les puissants ont la moindre idée de ce que l’avenir leur réserve, ou qu’ils ont une quelconque stratégie. »
« L’intrusion brutale, voire harcelante, des services d’IA dans notre quotidien n’est pas un signe de leur puissance, mais plutôt le reflet du manque de confiance et de la peur de leurs créateurs. Les bons produits se vendent en expliquant leurs atouts ; les produits douteux se vendent en trompant et en effrayant, et en profitant de la naïveté des personnes qui pensent qu’utiliser un LLM pour rédiger des e-mails et passer 12 heures par jour sur Twitter constitue un véritable travail. »
La demande en IA demeure le fruit d’une psychose collective. Son effondrement sera présenté comme imprévisible, car personne au pouvoir n’aura pris la peine de s’y intéresser. Pour Zitron, « nous sommes arrivés à un point où le masque commence à tomber, et la classe dirigeante, composée d’imbéciles, affiche sans vergogne son mépris pour l’humain », en annonçant notamment des licenciements sans fin. « Les dirigeants du secteur croient pouvoir bourrer le système de promesses de gains si mirobolants que la tech préférera s’autodétruire plutôt que d’admettre son erreur. Sundar Pichai, Andy Jassy, Larry Ellison, Elon Musk, Mark Zuckerberg et Satya Nadella n’hésiteront pas à dilapider des centaines de milliards de dollars pour éviter l’inévitable, mais une fois que ce sera le cas, le résultat sera catastrophique.» Ceux qui adorent l’IA parlent sans cesse de son incroyable puissance sans jamais montrer ce qu’elle a accompli ni, peut-être, à quoi leur a servi tout ce temps soi-disant gagné…
Zitron veut croire que nous nous dirigeons vers un krach véritablement catastrophique, susceptible de bouleverser le secteur du capital-risque et de porter un coup fatal à un ou plusieurs géants du cloud, tout en divisant profondément la société à de nombreux niveaux entre ceux qui se sont laissés prendre au piège et ceux qui ne l’ont pas été. À court terme, les conséquences seront absolument désastreuses pour nos marchés et notre économie en général. C’est la conséquence de la bombe à retardement que représentent le crédit privé et le capital-investissement. « Ces gens ne savent plus construire des choses qui fonctionnent, et la seule chose qu’ils savent faire, c’est dépenser de l’argent et licencier. Ils ne croient qu’à la croissance, et on ne peut pas survivre uniquement ni indéfiniment grâce à des croyances et à des promesses illusoires. »
« Aucune industrie digne de ce nom n’a besoin de vous induire en erreur ni de vous culpabiliser de ne pas adopter sa technologie. Personne de confiance ne jugera nécessaire d’humilier ou d’attaquer quelqu’un qui n’est pas suffisamment enthousiaste à propos d’un produit. Aucun PDG qui parle d’un avenir hypothétique pour vous vendre un logiciel aujourd’hui ne mérite votre confiance. Aucune technologie qui commet des erreurs régulièrement ne devrait être défendue. Et une industrie qui exige tout de nous — notre terre, notre énergie, notre eau, nos emplois, notre art, notre écriture, notre attention et chaque dollar que nous possédons — ne devrait susciter que du dégoût. »
Ce que l’IA accélère
Les promesses de l’IA pour découvrir de nouveaux matériaux ou révolutionner les découvertes scientifiques sont fortes. L’idée que l’IA serait l’avenir de la science comme on l’entend très souvent est bien plus un moyen d’orienter les investissements qu’une vérité scientifique, au risque d’augmenter la dépendance de la science à l’IA.
Dans le domaine de la fabrication de médicament, on attend là encore que l’IA permette de nouvelles percées, explique The Economist. Pou
Dans le domaine de la fabrication de médicament, on attend là encore que l’IA permette de nouvelles percées, explique The Economist. Pourtant, les partenariats entre entreprises pharmaceutiques et sociétés d’IA se multiplient, notamment dans l’espoir de mieux identifier des molécules, de raccourcir le temps de développement des essais cliniques et de diminuer le taux d’échec de ceux-ci (actuellement, « les médicaments candidats entrant en essais cliniques ont un taux d’échec de 90 %, ce qui porte le coût de développement d’un médicament efficace à la somme astronomique de 2,8 milliards de dollars »). « Même des gains d’efficacité marginaux représenteraient des avantages considérables. Des rapports provenant de l’ensemble du secteur suggèrent que l’IA a commencé à apporter ces gains. Elle a réduit la phase préclinique (celle qui précède les essais cliniques sur l’homme) à 12-18 mois, contre trois à cinq ans auparavant. Et elle a amélioré le taux de réussite. Une étude publiée en 2024, portant sur les performances de molécules proposées par l’IA lors des premiers essais cliniques, a révélé un taux de réussite de 80 à 90 %. À titre de comparaison, les moyennes historiques se situaient entre 40 et 65 %. »
« La conception d’un nouveau médicament commence généralement par le criblage de petites molécules organiques afin d’identifier celles présentant une activité biologique prometteuse afin de sélectionner les plus probables. L’IA peut analyser des bibliothèques de dizaines de milliards de molécules, en testant des propriétés telles que la puissance, la solubilité et la toxicité grâce à des émulations logicielles de ces molécules, sans qu’il soit nécessaire d’utiliser les molécules réelles en laboratoire. Jim Weatherall, l’un des responsables de cette activité chez AstraZeneca, une autre grande entreprise pharmaceutique, affirme que cette méthode permet de trier les molécules prometteuses deux fois plus vite qu’auparavant, et que plus de 90 % du processus de découverte de petites molécules de l’entreprise est désormais assisté par l’IA. »
L’IA sert donc d’abord à optimiser les investissements. L’IA contribue également à améliorer la conception des essais cliniques. Par exemple en formulant une hypothèse sur une maladie et en tentant de confirmer ou d’infirmer ces hypothèses par une recherche bibliographique.
L’IA se révèle également prometteuse dans la sélection des patients pour les essais cliniques. Elle peut analyser les dossiers médicaux, les biopsies et les examens d’imagerie des candidats afin d’identifier ceux qui pourraient tirer le meilleur parti d’un nouveau médicament. Une meilleure sélection des participants permet de réduire la taille des essais, et donc de les rendre plus rapides et moins coûteux. Un autre utilisation de l’IA consiste à créer des patients synthétiques permettant de comparer un patient réel et son double numérique pour comparer l’évolution prédite sans traitement par rapport au patient testé. A terme, les patients synthétiques permettrait de réduire les groupes témoins et leurs coûts (au risque tout de même que ces comparaisons aient une fiabilité relative).
L’optimisation des essais cliniques via l’IA représente une réduction considérable des risques, avec une diminution concomitante des coûts de développement des médicaments.
Mais si l’IA promet de produire de nouveaux médicaments, elle ne promet pas que nous ayons les capacités industrielles de le faire, comme le montrent les innombrables pénuries que nous traversons. Elle ne résout pas le risque d’abandon de la santé pour tous, qu’évoquait par exemple le philosophe Alexandre Monnin dans AOC il y a quelques mois (voire notre synthèse).
Au contraire. Dans le domaine de la médecine, comme le soulignaient l’avocate américaine des sans abris Leah Goodridge et la médecin et chercheuse, Oni Blackstock, directrice de l’association Health Justice, dans une tribune pour The Guardian, l’IA risque bien plus d’être utilisée pour refuser des soins que pour faire progresser la médecine. En Californie du Sud, où le nombre de personnes sans abris est l’un des plus élevé du pays, Akido Labs gère des cliniques pour les personnes sans domicile fixe et celles à faibles revenus. Mais ces patients sont vus par des assistants médicaux qui utilisent l’IA pour écouter les conversations, puis proposer des diagnostics et des plans de traitement potentiels, qui sont ensuite examinés par un médecin. L’objectif de l’entreprise, a déclaré son directeur technique à la Technology Review, est de « supprimer le médecin de la consultation ».
Cela s’inscrit dans une tendance plus large où l’IA générative est de plus en plus intégrée au système de santé, rappellent Goodridge et Blackstock. En 2025, une enquête de l’Association médicale américaine a révélé que deux médecins sur trois utilisaient l’IA dans leur travail quotidien, notamment pour diagnostiquer les patients. Une start-up spécialisée en IA (OpenEvidence, qui n’est pas accessible en Europe) a levé 200 millions de dollars pour fournir aux professionnels de santé un ChatGPT pour médecins. Et les législateurs américains examinent actuellement un projet de loi qui autoriserait l’IA à prescrire des médicaments. Bien que cette tendance à l’intelligence artificielle dans le secteur de la santé affecte presque tous les patients, son impact est plus profond sur les personnes à faibles revenus, qui rencontrent déjà d’importants obstacles à l’accès aux soins. « Les personnes sans domicile fixe et à faibles revenus ne devraient pas servir de cobayes pour l’IA dans le domaine de la santé. Au contraire, leurs voix et leurs priorités devraient déterminer si, comment et quand l’IA sera mise en œuvre dans leurs soins ».
La saturation des hôpitaux, les coûts d’accès au soin… expliquent en grande partie ces développements. D’autant que ces contraintes « sont souvent amplifiées dans les communautés économiquement défavorisées, où les établissements de santé sont souvent sous-financés et les patients non assurés, avec un fardeau plus lourd de maladies chroniques dû au racisme et à la pauvreté ». Les très documentés biais des IA de santé, « qui diagnostiquent bien moins les problèmes des patients noirs et hispaniques, des femmes et des patients bénéficiant de l’assurance Medicaid, promettent surtout d’aggraver les inégalités de santé pour les patients qui rencontrent déjà des obstacles à l’accès aux soins ». Pire, comme on le lit dans la TR, les patients ne sont même pas informés que leur professionnel de santé ou leur système de santé utilise l’IA. Un assistant médical explique ainsi que ses patients savent qu’un système d’IA les écoute, mais qu’il ne leur dit pas qu’elle formule des recommandations diagnostiques. Ces discriminations sont renforcées par la tendance croissante à l’utilisation de l’IA pour déterminer les remboursements de santé des personnes à faibles revenus (voir ce que nous disions d’United HealthCare connu pour sa politique de refus de remboursement de soins de santé). Bref, si l’IA d’un côté promet une amélioration de la production de médicaments, elle risque bien plus d’empêcher les publics d’y accéder.
Il y a d’autres domaines que l’IA accélère, comme le pointait Cade Metz dans le New York Times. Notamment la recherche en mathématiques, en biologie et en chimie. Mais là encore, bien des annonces tonitruantes se révèlent souvent assez décevantes une fois que les spécialistes les décortiquent. C’était le cas notamment lorsqu’une startup d’IA, Harmonic a annoncé avoir résolu un problème mathématique, avant que les experts ne constatent que ses solutions ne différaient guère des travaux antérieurs de mathématiciens. L’IA parvient à identifier des solutions existantes, enfouies dans des décennies d’articles de recherche plus qu’elle n’en invente. « On a l’impression d’être face à un élève brillant qui a tout mémorisé pour l’examen, mais qui ne comprend pas vraiment le concept », assène le mathématicien Terence Tao. L’IA permet bien plus de suggérer des hypothèses ou des expériences qui permettent de cibler les recherches, explique un spécialiste du cancer, qui constate lui aussi que cela permet d’accélérer les processus. Mais un chercheur expérimenté est toujours nécessaire pour guider le système. Pour Terence Tao, interviewé dans Nature, l’IA peut commettre des erreurs invérifiables dans nombre de domaines, mais en maths, elles sont vérifiables. Les inconvénients sont donc bien plus limités. « On commence à voir des exemples où l’IA – peut-être par chance – résout des problèmes importants pour les mathématiciens. C’est encore très rare et l’IA présente encore de nombreuses faiblesses ; elle ne remplace pas le travail humain. Mais il devient de plus en plus difficile de nier l’efficacité de ces outils. »Mais définir de nouveaux concepts et déterminer les problèmes à résoudre restera probablement du ressort des mathématiciens humains… au moins pendant un certain temps encore, estime le médaillé Fields.
… au risque de réduire le champ d’investigation de la science
Si l’IA pour la recherche scientifique promet, elle pourrait aussi avoir des effets délétères, rappelle la journaliste Grace Huckins pour la Technology Review et réduire à terme le dynamisme de la science. Une étude publiée dans Nature a révélé que si certains scientifiques perçoivent des avantages professionnels à adopter l’IA, la science dans son ensemble pourrait en pâtir, car l‘IA réduit le champ d’investigation de la communauté scientifique. Cela pourrait s’expliquer par le fait que l’IA excelle particulièrement dans l’analyse de données et de publications existantes, ce qui incite les scientifiques qui l’utilisent à se concentrer sur des domaines établis où des données à grande échelle sont disponibles. Il pourrait en résulter un nombre réduit de scientifiques disponibles pour étudier des problèmes moins adaptés à l’IA. Intégrer efficacement l’IA dans la science est plus qu’un simple défi technique : préserver le dynamisme et la diversité de la science à l’ère de l’IA pourrait nécessiter un effort concerté de la part de la communauté scientifique.
Dans un éditorial pour Science, Julio Ottino et Brian Uzzi enfoncent le clou et dénoncent le risque d’une « progression sans progrès ». « Les progrès réalisés dans l’utilisation de l’intelligence artificielle pour faire progresser la découverte scientifique rendent de plus en plus réaliste l’idée de systèmes automatisés de « science de bout en bout » : des chaînes de traitement intégrées capables de générer des hypothèses, de mener des expériences (in silico ou robotisées), d’analyser les résultats et de produire des résultats publiables avec une intervention humaine minimale. La question cruciale n’est pas de savoir si l’IA peut « faire » de la science, mais si la science – en tant que système social et évolutif produisant des connaissances fiables – peut survivre à la manière dont l’IA la pratique. »
Or, « la science n’est pas simplement une suite de tâches optimisables. Elle progresse par un processus analogue à l’évolution darwinienne : variation à travers de nombreux efforts indépendants ; sélection par la critique, la réplication et la compétition ; et conservation des résultats robustes. Cette structure distribuée permet à la science de s’autocorriger et de générer de la nouveauté. L’indépendance n’est pas fortuite ; elle est le mécanisme qui produit à la fois la fiabilité et la découverte. »
Mais, la science n’a jamais pleinement atteint cet idéal, rappellent-ils. Elle a aussi été façonnée par les biais, les erreurs et la fraude. Les partisans de l’intelligence artificielle arguent que l’automatisation pourrait atténuer certaines de ces limitations tout en accélérant les découvertes et en élargissant la participation. Reste donc à savoir si l’IA en science réduit ces imperfections ou les amplifie à l’échelle des machines.
L’intégration de l’IA à la science risque de modifier fondamentalement la structure de la science. Notamment en favorisant des plateformes dominantes, entraînées sur des données similaires et optimisées pour certains objectifs. « Comme sur d’autres marchés de technologies numériques, la concentration est un résultat plausible. Le risque est fort qu’une poignée de systèmes façonnent la majorité de la production scientifique (…). La diversité simulée au sein d’un système ne saurait se substituer à la diversité épistémique entre des approches véritablement concurrentes.»
La conséquence n’est pas seulement institutionnelle ; elle est bien épistémique, c’est-à-dire qu’elle concerne toutes les connaissances.« Le système scientifique prospère grâce à l’inefficacité : efforts redondants, tentatives infructueuses et chemins divergents. Il ne s’agit pas de coûts à éliminer, mais de sources de découverte. À l’inverse, les pressions d’optimisation favorisent la convergence. Il risque d’en résulter une production accrue, mais une exploration moindre de l’inattendu.»
« Ce rétrécissement a des implications sur la créativité. Une grande partie de la force de l’IA réside dans l’exploration combinatoire, le réarrangement des connaissances existantes en de nouvelles configurations. Or, nombre d’avancées majeures en science ne sont pas des combinaisons ; ce sont des ruptures, des changements conceptuels qui contredisent les hypothèses des cadres antérieurs. Parce que ces avancées s’écartent des schémas encodés dans les données existantes, elles sont les moins susceptibles d’émerger de systèmes entraînés sur le passé. »
« L’indépendance n’est pas seulement une garantie de fiabilité ; elle est la condition de la rupture conceptuelle. » A l’inverse, « l’optimisation de chaque composant ne garantit pas l’intégrité de l’ensemble. » Au contraire, elle peut la compromettre.
« Il ne s’agit pas de rejeter l’IA, mais de la considérer comme un simple progrès technique. Préserver les propriétés fondamentales d’un système scientifique évolutif devient désormais une contrainte de conception. Les résultats scientifiques doivent garantir une traçabilité claire – une chaîne de responsabilité identifiable qui ne se dissout pas dans des systèmes opaques. Les dispositifs institutionnels et techniques doivent assurer des approches véritablement distinctes, et non de simples variations au sein d’une architecture partagée. »
« Ces exigences ne sont pas des inefficacités à éliminer par l’ingénierie. Elles représentent les solutions accumulées au problème de la fiabilité des connaissances. Un système d’IA peut produire des résultats impressionnants. Mais s’il remplace un processus évolutif par un processus artificiel, il risque de restreindre non seulement le champ de nos découvertes, mais aussi notre capacité de découverte tout court. »
Le financement de la recherche : submergé par l’IA
Geraint Rees et James Wilsdon pour Naturetirent la sonnette d’alarme. L’IA est en train de submerger les appels à projets et demandes de financement de la recherche, améliorant le nombre, la qualité, le volume des demandes au risque de provoquer l’effondrement même du système. Les réponses générées par l’IA peuvent être entraînées sur les publications des chercheurs, sur les critères d’attribution des subventions et même sur les projets retenus pour ajuster les demandes aux résultats attendus. Et l’effet se constate déjà, pointent les chercheurs. Dans une étude qui a regardé les projets de 12 organismes de financement de la recherche de l’Union européenne, les chercheurs montrent une augmentation des candidatures depuis 2022.
« Les décideurs politiques et les organismes de financement vont devoir repenser l’allocation des fonds de recherche avant que le système ne devienne ingérable. » Confrontés à un afflux de réponses de qualité, ils devront alors faire des choix largement arbitraires quant aux projets à financer et aux candidats.
Jusqu’à présent, les organismes de financement de la recherche ont principalement réagi à ces évolutions en restreignant l’utilisation de l’IA par les candidats et les évaluateurs, certains déclarant les demandes inéligibles si elles sont élaborées avec de l’IA. Mais ces préconisations sont impossibles à appliquer car la probabilité de détection est faible et ne constitue pas une réponse au problème. Le risque est fort que toutes les propositions répondent aux critères de financement et que les différences entre elles soient minimes. « Lorsque les propositions et les évaluations sont toutes deux gérées par des agents entraînés sur le même corpus de travaux déjà financés, le système n’évaluera plus la qualité des idées, mais plutôt la capacité des agents à simuler les idées précédemment récompensées par les financeurs.»
« Parmi les propositions visant à remédier à la surcharge des systèmes de financement figurent le recours à des tirages au sort (attribution aléatoire de fonds à des demandes de subvention correspondant à un certain niveau de qualité) et des modèles distribués d’évaluation par les pairs, où les chercheurs qui soumettent des demandes de subvention sont chargés d’évaluer celles d’autres chercheurs. Ces mesures permettent de lutter contre le volume de demandes, mais elles restent inefficaces si les indicateurs de qualité deviennent peu fiables. »
Geraint Rees et James Wilsdon proposent plutôt que les organismes de financement envisagent de recentrer l’évaluation non plus sur les propositions écrites, mais sur le chercheur principal, son équipe et ses programmes de recherche passés et en cours. « Les financeurs devraient investir dans la vérification des antécédents afin d’examiner la performance de recherche d’un individu ou d’un groupe sur une période prolongée, ainsi que dans des entretiens et des évaluations de portefeuilles de la performance d’équipe sur la durée. » Mais cette solution écarte de fait les plus petites ou plus jeunes équipes : les aides risquent alors d’aller uniquement aux projets les plus établis.
En mars, le Conseil de la recherche médicale du Royaume-Uni a annoncé le rétablissement des entretiens pour tous les candidats présélectionnés : une approche chronophage et laborieuse et peu adaptée aux grands volumes de candidatures. Le NIH américain, regroupant l’ensemble des Instituts nationaux de la santé, lui, a limité à 6 dépôts par an le nombre de candidatures individuelles, après avoir constaté que certains chercheurs en soumettaient plus de 40. Les financeurs pourraient également envisager des approches plus radicales, suggèrent les deux chercheurs.Il pourrait s’agir d’instaurer un quota fixe de propositions par chercheur ou pour l’ensemble de sa carrière, toutes sources de financement confondues. Ils pourraient aussi répartir le budget disponible entre les chercheurs éligibles à l’échelle nationale et attribuer le même montant à tous, éliminant ainsi la concurrence.
D’autres solutions proposent aux organismes de recherche de s’appuyer sur l’IA pour l’évaluation. « L’IA pourrait ensuite servir à prioriser et à présélectionner les candidatures, en comparant les données selon ces différents profils afin d’identifier les candidats dont le parcours est cohérent avec les informations fournies dans leur dossier. Ce processus de présélection serait transparent, auditable et conçu pour favoriser la diversité, et non la freiner, à travers les différentes étapes de carrière, disciplines et institutions. » Mieux (ou pire, c’est selon), certains modèles proposent de prédire l’impact d’un article ou d’une recherche, fléchant les financements vers les projets les plus porteurs.
Quelque soient les solutions retenues, la nécessaire transformation du financement de la recherche risque de se faire dans la douleur et la contestation, estiment les chercheurs. La mise en place d’infrastructures IA nécessite des investissements soutenus, des tests rigoureux et une gouvernance continue. Les financeurs confrontés à des contraintes budgétaires pourraient hésiter. C’est oublier pourtant que le système gaspille déjà des ressources considérables en comités d’experts et en nouvelles soumissions, sans parler du temps consacré par les chercheurs à répondre aux appels. Un système basé sur l’IA native et bien conçu pourrait constituer un investissement judicieux, défendent les chercheurs. Reste que des systèmes d’évaluation entraînés sur des données de financement historiques intégreront les inégalités passées, risquant d’amplifier, plutôt que de corriger, l’effet Matthieu, c’est-à-dire la concentration au profit des plus dotés. « Il s’agit d’un risque réel, mais nous pensons que la conception et la gouvernance peuvent contribuer à l’atténuer. Les biais dans les systèmes d’IA sont mesurables, ce qui permet de les examiner et d’y remédier », soulignent-ils, certainement trop rapidement car les biais ne sont ni mesurables ni corrigeables facilement. Troisièmement, les chercheurs et les institutions pourraient se montrer réticents face aux décisions façonnées par des algorithmes qu’ils ne peuvent pas interroger. La transparence et les mécanismes d’appel pourraient contribuer à instaurer la confiance, défendent-ils encore.
Le système de financement par subventions conçu pour un monde pré-IA est devenu défaillant. Les financeurs doivent s’adapter, estiment les chercheurs. Il pourrait en résulter un système plus performant : un système qui exploite la puissance de l’IA et la combine à des connaissances spécialisées, et qui réduit le temps et l’énergie gaspillés dans la rédaction de demandes de subventions improductives pour les réorienter vers une recherche novatrice. Un constat plus facile à déclamer qu’à mettre au point.
Prédire les résultats de la science… au risque de l’y enfermer
Certains modèles proposent de prédire l’impact d’un article ou d’une recherche, fléchant les financements vers les projets les plus porteurs, expliquaient donc Geraint Rees et James Wilsdon. Qu’en est-il ?
Savoir si une étude changera le monde ? C’est pourtant l’idée que propose Funding the Frontier : un tableau de bord pour prédire l’impact de la recherche. L’outil (non disponible) utilise le Big data pour retracer l’impact sociétal des projets de recherche sur les politiques, les médicaments ou les produits, explique Nature (voir également l’article de recherche qui montre des captures d’écran du tableau de bord et la vidéo promotionnelle). Le projet porté par Dashun Wang« intègre des données sur les publications de recherche, les brevets, les documents d’orientation et les essais cliniques, et présente ces informations de manière visuelle et intuitive. Ils ont également combiné cet outil à un algorithme prédictif basé sur l’apprentissage automatique pour prédire les études et les domaines susceptibles d’apporter les plus grands bénéfices sociétaux à l’avenir – par exemple, les subventions les plus susceptibles de déboucher sur un brevet ». « Même sans son aspect prédictif, disposer d’un outil permettant de rechercher l’impact des recherches sur la société » est déjà une information importante, estime un chercheur.
Un chef de projet d’une importante agence de financement américaine l’a utilisée pour examiner les impacts sociaux généraux des subventions de l’agence, lui permettant de constater l’impact de certaines recherches ailleurs dans le monde. « Un autre utilisateur, investisseur dans le domaine de la recherche biomédicale, a constaté que dans le domaine de la recherche sur la maladie d’Alzheimer, l’impact clinique le plus important au cours des 20 dernières années provenait d’études visant à comprendre la maladie, mais que l’impact futur le plus important prévu se concentrait sur les études portant sur les systèmes de soutien social des personnes atteintes de la maladie, ce qui laisse entrevoir de nouvelles opportunités d’investissement ».
L’aspect prédictif est pourtant préoccupant, estime le même James Wilsdon qui en évoquait les perspectives précédemment. Le spécialiste des politiques de recherche estime que ce tableau de bord pourrait créer des prophéties autoréalisatrices et des décisions d’investissements plus conservatrices, au détriment de recherches plus originales, capables d’ouvrir d’autres possibilités.
Coincés dans l’Academic Slop ?
En attendant, le travail académique commence à crouler sous la « prolifération métastatique de publications » truffées d’hallucinations et de distorsions de contenus, comme s’en plaint sur Facebook la philosophe du droit, Antoinette Rouvroy. L’Academic Slop est arrivé, constate également le chercheur Seva Gunitsky dans sa newsletter. Il raconte que dans la revue dont il s’occupait le nombre de soumission a doublé voire triplé depuis l’apparition de l’IA générative, et que le taux de rejet s’est envolé. Techniquement compétents, certains de ces articles respectent les normes et sont tout à fait convenables. Faciles à produire et exigeant peu de créativité, ils constituent néanmoins le type de travail incrémental légitime que le philosophe des sciences Thomas Kuhn appelait la fabrique de la « science normale ». Pour Gunitsky la valeur d’une théorie originale va continuer à prendre de l’importance. « Les travaux quantitatifs de qualité deviennent bon marché et abondants ; une bonne théorie reste difficile à élaborer ».
Mais l’effet le plus important est que l’évaluation par les pairs repose désormais davantage sur le discernement. Si n’importe qui peut produire un article empirique compétent sur n’importe quel sujet, le principal obstacle devient l’identification des questions importantes à poser.« Dans ce contexte, la question pour les évaluateurs et les éditeurs n’est plus tant « est-ce juste ?» que « pourquoi est-ce important ? ». Cette question est inévitablement subjective, mais pas totalement, car elle exige une solide connaissance des débats en cours. Elle nécessite néanmoins de connaître les tensions et les lacunes productives, les énigmes intéressantes et les idées reçues apparemment établies. »
« Ce concept porte un nom : la phronesis. C’était le terme employé par Aristote pour désigner la sagesse pratique, ou la capacité à discerner la conduite à tenir dans des circonstances particulières. Contrairement à l’épistémè (la connaissance scientifique) ou à la technè (le savoir-faire technique), la phronesis ne peut se réduire à des règles ou à des algorithmes. Elle requiert de l’expérience, du jugement et ce qu’Aristote appelait la « perception ». Cela signifie non seulement l’intelligence, mais aussi la capacité intellectuelle de percevoir les caractéristiques essentielles d’une situation donnée. »
La philosophe Isaiah Berlin appelait cette qualité « le sens du réel » dans le jugement politique : la capacité de percevoir ce qui est possible et ce qui compte à un moment historique donné. Or, il n’est pas certain que les IA possèdent cette capacité voire ne la possèdent jamais. « Si le discernement devient le critère ultime de qualité, nous nous dirigeons encore davantage vers un système à deux vitesses dans l’édition scientifique. Les revues les plus prestigieuses privilégieront les articles d’une originalité remarquable ou présentant des avancées théoriques ou empiriques majeures, tandis que toutes les autres publieront les articles produits par l’IA qui font progresser, de manière graduelle, notre compréhension de sujets spécifiques. Et peut-être que la théorie gagnera en prestige au détriment des méthodes sophistiquées d’analyse des données. »
Pas sûr que la théorie et l’empirisme puissent ainsi si facilement se scinder en deux. Le risque que les publications automatisées se transforment en matière noire scientifique, que personne ne lit ni ne consulte est fort. A nouveau, ici aussi, le risque est fort que s’accentue davantage les hiérarchies de prestige comme critère d’importance. « Paradoxalement, l’effet uniformisant de l’IA pourrait rendre le monde universitaire plus élitiste encore ».
« La technologie qui nous a inondés de dissertations étudiantes façonnées avec l’IA va maintenant inonder de nos propres travaux, et nous aurons besoin de ce même discernement dont nous nous plaignons de l’absence chez nos étudiants. » Pas sûr que ce soit plus facile pour les experts. L’IA fait peut-être gagner beaucoup de temps à certains, mais la pollution des travaux de recherche qu’elle engendre en fait perdre énormément aux lectrices et lecteurs. Le goulot d’étranglement de la lecture et de la vérification s’annonce plus reserré que jamais.
La seule chose dont on soit sûr, en observant toutes ces perspectives… ce n’est pas que l’IA apporte un progrès scientifique notable, c’est que l’IA en science renforce les inégalités dans toutes les couches de la science.
Hubert Guillaud
MAJ du 02/06/2026 :Une analyse de 7,3 millions d’articles de revues scientifiques publiés entre 2020 et 2025 révèle qu’en 2025, un peu plus de la moitié présentent des signes d’influence des LLM, avec des variations importantes d’utilisation selon la région du monde, le prestige de l’établissement, l’éditeur et la discipline. « Le développement économique et la proximité de l’anglais comme langue principale sont des facteurs prédictifs clés de ces variations régionales. Les établissements moins bien classés affichent des taux d’adoption plus élevés que les universités d’élite, les jeunes éditeurs à but lucratif présentent des taux supérieurs à ceux de leurs concurrents, et l’adoption varie considérablement selon les disciplines universitaires. L’adoption des LLM dans la rédaction académique est répandue, mais socialement stratifiée. »
MAJ du 21/06/2026 : Dans leur newsletter, Tim O’Reilly et Ilan Strauss, proposent de garantir un exosquelette pour appliquer l’IA à la science. Cet exosquelette est constitué d’innombrables systèmes permettant de garantir les références, comme le DOI (l’identifiant d’objets numériques qui attribue un numéro à chaque publication scientifique), RetractationWatch (la base de données des articles scientifique dépubliés et rétractés), Orcid (qui founit un identifiant unique aux chercheurs), Open Alex (un graphe de connaissances scientifiques)… ou encore le projet Vraix du MIT (cherchant à créer une toile du savoir pour distinguer les contenus possiblement génératifs des autres)… et nombres d’autres, qui n’ont pas été intégrés aux systèmes d’IA, alors qu’ils pourraient permettre de résoudre de nombreux problèmes : diminuer les citations erronées, réduire l’emprise de la littérature scientifique non valide… une infrastructure fondée sur des principes ouverts qui cherchent à garantir que les contenus scientifiques ne puissent être ni accaparés ni dégradés. Ces infrastructures sont des biens publics que les entreprises d’IA ignorent pour la plupart ou, pire, fragilisent. « À l’heure actuelle, la relation entre l’IA et l’infrastructure scientifique est presque exclusivement extractive. Les entreprises d’IA entraînent leurs modèles sur des articles scientifiques. Elles créent des produits capables de générer et de manipuler des textes scientifiques. Elles se disputent le marché de l’« IA au service de la science ». Pourtant, elles ne contribuent pratiquement pas à l’infrastructure qui, à la base, garantit la fiabilité des connaissances scientifiques. »
Les entreprises d’IA consomment du contenu scientifique sans rien apporter en retour. Strauss et O’Reilly font une analogie avec Content ID de YouTube : face à l’utilisation non autorisée de leurs œuvres, la première réaction de l’industrie musicale a été d’exiger leur retrait. La réponse de YouTube a été : « Et si nous vous aidions plutôt à les monétiser ? » Cette approche a permis d’aligner les intérêts et de créer une économie dynamique pour les créateurs. Nous devrions appliquer le même raisonnement à la science. Les entreprises d’IA ne devraient pas seulement utiliser l’infrastructure scientifique pour améliorer leurs produits (elles le devraient pourtant), mais elles devraient surtout chercher à aider la science à gagner en valeur, en pérennité et en exhaustivité.
Pour cela, les systèmes d’IA devraient améliorer la validation de leurs sources et références. L’infrastructure existe, il leur suffit de l’utiliser. Ils pourraient également réinjecter les métadonnées extraites dans OpenAlex, améliorant ainsi le graphe de données pour tous. Ils pourraient utiliser et financer RetractationWatch pour améliorer leurs modèles et réponses. Les fournisseurs d’IA pourraient également financer cette infrastructure scientifique très fragile qui constitue le socle technique de la crédibilité de la science. « Les entreprises d’IA, qui génèrent des milliards de revenus grâce à des produits reposant sur la crédibilité scientifique, devraient contribuer à l’infrastructure qui garantit cette crédibilité. Il ne s’agit pas de philanthropie, mais d’un intérêt bien compris.» Elles pourraient également contribuer a améliorer cette chaîne qui identifie la provenance du contenu scientifique. « Lorsque l’IA contribue à un article scientifique, cette contribution doit être traçable : elle ne doit pas simplement faire l’objet d’une déclaration standard, mais être liée à des affirmations, des sources et des étapes de vérification précises. »
« Les entreprises d’IA qui s’appuieront sur cette infrastructure créeront de meilleurs produits. Mais surtout, elles investiront dans l’infrastructure civilisationnelle qui rend possible, à la base, l’existence de connaissances fiables. À condition toutefois que les entreprises d’IA cessent de considérer cette question comme le problème d’autrui et commencent à la voir comme un socle sur lequel bâtir — un socle dont dépend leur propre succès dans le domaine scientifique.»
[en]
Je sais qu’il y a des tas de gens qui font le choix de ne pas stériliser leur chatte “pour avoir des petits”, et qui peut-être ne comprennent pas l’énervement des gens branchés “protection animale” face à ça. Si on est responsable, qu’on soigne bien les chatons, qu’on leur trouve de bons foyers, où est le problème?
Le problème c’est qu’une chatte qui fait des petits, ce n’est pas quelque chose qu’il suffit de considérer de façon isolée. En effet, pour cette chatte-là et ces chatons-là,
Je sais qu’il y a des tas de gens qui font le choix de ne pas stériliser leur chatte “pour avoir des petits”, et qui peut-être ne comprennent pas l’énervement des gens branchés “protection animale” face à ça. Si on est responsable, qu’on soigne bien les chatons, qu’on leur trouve de bons foyers, où est le problème?
Le problème c’est qu’une chatte qui fait des petits, ce n’est pas quelque chose qu’il suffit de considérer de façon isolée. En effet, pour cette chatte-là et ces chatons-là, peut-être que tout va bien.
Mais il faut regarder plus loin que le bout de son nez. Il faut regarder l’écosystème entier auquel prend part la personne qui choisit de faire reproduire sa chatte.
Déjà, il y a le fait qu’il y a des chats errants en Suisse, même si on ne le voit pas tant que ça. Ces chats, souvent, ils étaient à quelqu’un. Juju, il est né dans une famille et il a appartenu à des gens, avant de se retrouver dehors livré à lui-même. Je le sais car si ce n’était pas le cas, il n’aurait pas les bases de sociabilité avec l’humain qu’il démontre tous les jours. Oscar, même histoire. Donc ces chats, ce sont des chats non identifiés qui pour une raison ou une autre, se sont retrouvés à la rue.
J’aimerais insister sur le fait que je ne crois pas que la majorité des chats “abandonnés”, comme on dit, ait été activement et sciemment “mis dehors”. Il y a tellement d’explications: la chute de la fenêtre et le chat qui file et qu’on ne retrouve jamais. Le chat d’intérieur qui fuit par la porte et qu’on ne retrouve jamais. Le chat qui vient de déménager, qui sort trop tôt, et s’installe ailleurs, et qu’on ne retrouve jamais. Le chat pas castré assez tôt (tant Oscar que Juju n’étaient pas castrés) et qui file courir la minette loin, loin de chez lui, et au final ne revient pas, car les minettes en chaleur sont ailleurs. Le chat vagabond qu’on nourrit “comme ça” et qui finit par préférer rester dans le coin plutôt que chez lui – mais c’est pas “notre” chat, alors il devient “le chat de personne”. Je pourrais continuer.
Il y a des chats errants. Il y a des chats en refuge. Des chats qui passent longtemps en refuge (Tounsi y est resté un an avant que je l’adopte, et c’est n’est pas une durée incroyable). Et détrompez-vous: chaque année, il y a des chatons qui peinent à trouver un foyer, parce que passée la fenêtre très courte du “chaton mignon”, eh bien les gens n’en veulent plus, et aussi parce que les refuges et les associations qui placent des chatons ou chats sont peut-être plus regardants que des particuliers qui ont “fait des petits”. Vous savez pourquoi j’ai gardé Juju? Parce qu’au bout de 2 semaines, je voyais son potentiel, ses besoins en matière d’espace de vie, et aussi le travail et les compétences qui allaient être nécessaires pour le resocialiser et lui permettre de surmonter sa peur après des années dehors, et que la conclusion c’était que ce serait moins de travail pour moi de le faire moi-même que de trouver un foyer qui coche les cases.
Tous cas chats, ils viennent de quelque part. Certes, il y a des minettes “ensauvagées” (qui elles aussi, étaient peut-être à quelqu’un, à la base) qui mettent bas dehors, donnant naissance à des petits qui ne seront pas socialisés, pas castrés, pas stérilisés, pas vaccinés, donc un grand nombre mourront (et pas paisiblement) et dont le reste occupe à plein temps les bénévoles des associations qui bossent nuit et jour pour, justement, réduire la quantité de mort miséreuse dans nos champs, nos haies et nos chantiers.
Donc, quand on fait porter sa chatte, on fait “sa part” pour contribuer à surcharger cet écosystème déjà en souffrance. Plus de chatons faciles à adopter, pour des gens qui du coup n’adopteront pas un chat (jeune ou vieux) qui n’est pas né exprès. Plus de chatons à adopter, pas identifiés pour beaucoup, probablement pas stérilisés (parce que ce serait cool de faire une portée à la minette, c’est mignon les chatons), qui peut-être se “perdront” et iront grossir les rangs des “chats abandonnés”.
On fait aussi “sa part” pour alimenter une norme sociale: que c’est OK voire normal de faire porter sa chatte, que la stérilisation c’est pas si important, ça fait des chatons mignons, que franchement les associations et SPA qui font payer (non mais vous vous rendez compte?!) quand on veut adopter un chaton, vraiment, c’est abuser, parce que ma voisine elle les donne, elle.
Voilà pourquoi des fois, on manque de patience avec les gens qui ne voient que les adorables et craquants petits chatons auxquels donnera naissance leur gentille minette.
Dans le Financial Times, l’économiste Bhaskar Chakravorti, estime également que la colère monte contre l’IA. La colère dans la Rust Belt (la ceinture de la rouille qui désigne les anciens bastions de l’industrie américaine du Nord-Est des Etats-Unis) a propulsé Trump à la victoire ; la rage des travailleurs du savoir des banlieues de la Wired Belt (la ceinture connectée) alimentera la réaction contre l’IA.
Mais qu’est-ce que la Wired Belt ? Cette idée s’appuie sur une étude produite par Chak
Dans le Financial Times, l’économiste Bhaskar Chakravorti, estime également que la colère monte contre l’IA. La colère dans la Rust Belt (la ceinture de la rouille qui désigne les anciens bastions de l’industrie américaine du Nord-Est des Etats-Unis) a propulsé Trump à la victoire ; la rage des travailleurs du savoir des banlieues de la Wired Belt (la ceinture connectée) alimentera la réaction contre l’IA.
Mais qu’est-ce que la Wired Belt ? Cette idée s’appuie sur une étude produite par Chakravorti et ses équipes à la Tufts University qui s’intéresse aux risques que l’IA fait peser sur l’emploi aux Etats-Unis, par secteurs et également par régions. Pour ses auteurs, outre le fait que l’IA fait peser des risques sur certaines catégories d’emploi (à savoir les métiers de l’information, de la finance et de l’assurance, la programmation et les concepteurs d’interfaces), l’étude est plus originale pour son aspect géographique. Ils mettent en avant que ce sont les grands pôles d’innovations urbains comme New York, Los Angeles, Washington D.C., San Francisco, Chicago, Dallas et Boston qui figurent parmi les plus exposés, ainsi que la Californie, le Texas, New York, la Floride et l’Illinois. Les auteurs soulignent d’ailleurs que ces États figurent également parmi les plus actifs en matière de réglementation de l’IA, ce qui souligne les dimensions politiques et d’économie politique des perturbations du marché du travail induites par l’IA et met en évidence d’importantes implications réglementaires et politiques au niveau des États.
Pour les auteurs, les zones connectées seront les prochaines zones désaffectées. L’IA va s’en prendre aux régions abritant les emplois les mieux rémunérés des Etats-Unis.
Pour Chakravorti, les cadres qui s’apprêtent à perdre leur emploi à cause de l’IA pourraient bien être à l’origine du prochain choc politique que connaîtra les États-Unis. « Les professions les plus menacées sont concentrées dans les « ceintures connectées » : des régions qui ont prospéré grâce aux données, au contenu et aux activités cognitives. Ces régions pourraient bien devenir les nouvelles « ceintures de rouille », s’étendant des pôles technologiques bien connus de la Silicon Valley, de Boston et de New York jusqu’à Philadelphie, Atlanta et Phoenix. Les corridors de connaissances périurbains entourant les grandes villes des États indécis (swing states) américains figurent parmi les plus vulnérables du pays.»
L’IA pourrait donc avoir des conséquences très politiques, estime Chakravorti. « Lorsque les perturbations économiques frappent les communautés américaines et que la classe politique réagit avec indifférence, il en résulte un réalignement politique radical, mais cette fois-ci, il viendra des cols blancs des régions technologiques, et non des cols bleus des régions industrielles en déclin. »
« Record ». « Record ». « Record ». « Record ». « Record ». Des mots il y en a d’autres. Mais celui-là est le plus chaud, le plus saillant, le plus repris. Nous en franchissons. Nous en battons. Nous en dépassons de précédents. Des records. De chaleur donc. Et donc comment dire autre chose de « record ».
D’autres mots s’alignent derrière : « jamais vu« , « historique« , « inédit » … Mais toujours celui-là qui revient : « record. » Alors on y va au record, au rapport. Dire et redire le record de
« Record ». « Record ». « Record ». « Record ». « Record ». Des mots il y en a d’autres. Mais celui-là est le plus chaud, le plus saillant, le plus repris. Nous en franchissons. Nous en battons. Nous en dépassons de précédents. Des records. De chaleur donc. Et donc comment dire autre chose de « record ».
D’autres mots s’alignent derrière : « jamais vu« , « historique« , « inédit » … Mais toujours celui-là qui revient : « record. » Alors on y va au record, au rapport. Dire et redire le record de chaleur pour ,ne pas dire le record de souffrance, le record d’épuisement, le record de sensation d’étouffement, le record d’irrespirabilité, le record de malaises, etc.
Dire et répéter sans cesse ce « record » c’est installer narrativement une dimension qui est celle du sport, du dépassement, de la médaille, bref, des valeurs presque toujours associées à quelque chose de positif dans notre imaginaire. Alors dire sans cesse ces records, est-ce franchir une limite ou s’affranchir des dernières supportables restantes ?
Dire et répéter sans cesse ce record c’est aussi marquer le moment d’un souvenir, s’inscrire donc dans une histoire, un record c’est un témoignage. Record nous dit le dictionnaire de l’académie c’est : « Emprunté de l’anglais record, ‘procès verbal, témoignage consigné’, déverbal de to record, ‘enregistrer’, lui-même emprunté du français recorder. » Alors on enregistre. La hausse des températures, les images de plage, de glaces, d’eau, d’espaces et de lieux et ressources qui aujourd’hui sont enregistrés comme ceux qui rafraîchissent, mais que l’on enregistre aussi comme ceux qui seront demain impraticables, inaccessibles, épuisés.
Et puis il y a les autres records, les autres enregistrements, les autres mémoires collectives qui se construisent et se fixent.
J’enregistre. Il faut aller à l’école, en cours. Il faut passer des examens, des épreuves. Bacheliers professionnels à l’épreuve d’un baccalauréat que le ministre ne voit aucune raison de décaler, de déplacer, d’aménager. Pourtant il n’y a pas si longtemps on avait déplacé, décalé, aménagé le brevet des collèges mais là ce sont des bacheliers professionnels. Alors il faut les habituer à la peine. Il faut les tordre.
Plus rien n’est adapté. Voilà des décennies que nous avons construit (et construisons encore contre toute logique) des bâtiments faits pour dire que nous aspirions à la chaleur : larges fenêtres, baies vitrées immenses, orientations plein sud. Let The Sun Shine In. Laissons entrer le soleil.
Et nous avons des villes entières, des gares, des lotissements, des écoles, des collèges, des lycées, des immeubles tout entiers tournés vers le soleil qui désormais écrase.
Parmi les images les plus fortes d’une littérature qui m’accompagne, il y a celle du tout début du roman de Kim Stanley Robinson, « Le ministère du futur« , la description d’une humanité écrasée d’une chaleur insoutenable, qui à la nuit se réfugie en quête de fraîcheur dans un lac lui-même déjà trop chaud mais pourtant seul supportable, et d’une partie de cette humanité qui y crève littéralement, et du narrateur qui s’y réveille à peine vivant au milieu de cadavres. Ce roman est une vraie claque. D’autres sciences et d’autres fictions bien sûr racontent l’inexorable qui vient.
Nous avons maintenant juste besoin de politique. Et des formes les plus abouties de radicalité, de redirection écologique, de de planification, appelez cela comme vous voulez mais puisqu’il est déjà trop tard, non pas tant pour nous que pour nos gosses, il faudra de la politique, et de la dure.
Il y a cette certitude sourde que deux choses ne nous sauverons pas : l’innovation et l’adaptation. Oui nous innoverons et oui certains trouveront encore à s’adapter, bien sûr qu’il le faudra. Mais ni l’innovation ni l’adaptation ne nous sauverons si nous considérons qu’elles deux seules peuvent encore nous sauver.
L’innovation ne nous sauvera pas. Elle ne fera que retarder certains pans d’un inéluctable dont la capacité mortifère est d’ores et déjà irréductible.
Notre capacité d’adaptation ne nous sauvera plus. Nous ne pourrons pas, nous ne pourrons plus (nous ne le pouvons presque déjà plus), ni à l’échelle de nos corps ni à l’échelle de nos lieux, de nos corporéités et de nos habitabilités, nous ne pourrons pas nous adapter davantage, ni en creusant plus bas sous terre, ni en avançant plus loin ou plus profond dans l’océan, ni en montant plus haut dans nos villes comme dans nos géographies ou dans nos conquêtes de l’espace.
Nous sommes depuis déjà trop longtemps entrés dans un cycle où les innovations et les adaptations effondrent les cohésions, les sociabilités, les cohabitations qu’elles soient de voisinage ou de destin. Entre ceux qui ont la clim et ceux qui ne l’ont pas. Entre ceux qui vivent là et ceux qui vivent ailleurs. Entre ceux qui peuvent financer leur adaptation et ceux qui ne le peuvent pas.
C’est à la fois enthousiasmant et désespérant mais il ne nous reste plus que du politique pour nous sauver la peau et que nos gosses et les gosses de nos gosses ne soient pas les accablés nomades de nos errances ou les assignés à résidence punitive de nos tardives repentances.
D’un record, l’autre. C’est désormais la seule et l’unique question, dont toutes les autres dépendent : nous visons dans un monde dont la géographie, l’espace, l’habitat, la circulation, ne sont plus du tout adaptés au climat que nous traversons et traverserons. Alors nous attendons. Nous attendons la lame, celle qui viendra de l’océan. Nous attendons la flamme, celle qui viendra de nos forêts. Entre la lame et la flamme. Juste du politique.
Les assemblées se mettent en mode été !!! Question de profiter du beau temps, des fleurs qui poussent et des oiseaux qui chantent , on vous invite à une assemblée populaire rimouskoise sous la forme d’un pique nique , au Parc Beauséjour.
Le tout débutera par l’installation des plats, suivi d’une grande plénière et d’un projet artistique communautaire. Le reste de l’événement se prêtera autant à la discussion en sous-groupes, qu’à la rigolade sur le gazon et aux envies de jouer dehors !
On teste une formule potluck, donc si l’envie vous prend de cuisiner et de partager, une table sera installée pour y mettre vos plats et la description de ce qu’ils contiennent (surtout pour les allergies) ! Rien ne vous empêche d’apporter votre propre lunch en alternative ou en complément.
On vous invite aussi fortement à apporter votre vaisselle (plats, ustensiles, verres), mais nous aurons une réserve sur place au cas où. Afin de se laisser le temps de respirer, la table sera prête à accueillir vos plats à 11h30, et quand tout semblera bien installé, la plénière commencera .
Invitez vos proches et tout le voisinage!
INFO MÉTÉO : il fera beau, c’est certain, MAIS si jamais la température ne se prête pas à une assemblée, elle sera remise au lendemain. On vous fait un bulletin météo quelques jours avant.
INFO-ACCESSIBILITÉ
Le parc Beauséjour, son stationnement et son pavillon de services sont pleinement accessibles aux personnes à mobilité réduite. Le Bilan 2024 du Comité favorisant l’intégration des personnes handicapées de la Ville indique que « Le prêt de matériel adapté est accessible au comptoir de prêt du parc Beauséjour« .
Si vous avez des contraintes ou des questionnements, n’hésitez pas à nous écrire pour qu’on s’assure de bien vous accueillir !!
Rapidement quelques réflexions construites en préparant mon intervention lors d’une journée autour de l’IAG organisée par l’APDEN de Poitiers. Merci à toute l’équipe pour l’invitation et l’organisation.
Ecrire du code.
Arthur Mensch est Le PDG de Mistral AI, entreprise spécialisée dans l’IA et « licorne » française. Il vient d’être auditionné par l’assemblée nationale. Si vous vous intéressez au sujet, l’entretien est assez intéressant même s’il faut très souvent faire la part de ce qui relèv
Rapidement quelques réflexions construites en préparant mon intervention lors d’une journée autour de l’IAG organisée par l’APDEN de Poitiers. Merci à toute l’équipe pour l’invitation et l’organisation.
Ecrire du code.
Arthur Mensch est Le PDG de Mistral AI, entreprise spécialisée dans l’IA et « licorne » française. Il vient d’être auditionné par l’assemblée nationale. Si vous vous intéressez au sujet, l’entretien est assez intéressant même s’il faut très souvent faire la part de ce qui relève de la réalité de cette firme (et qui peut être étendu à d’autres semblables) et la dimension très prégnante de l’opportunité de lobbying qui lui est ainsi offerte (mais c’est le jeu, il fait son taff, et il le fait plutôt très bien).
« Aujourd’hui les ingénieurs chez Mistral n’écrivent plus de ligne de code. » Je répète et souligne : « Aujourd’hui les ingénieurs chez Mistral n’écrivent plus de ligne de code. »
Et il poursuit : « Aujourd’hui vous n’êtes plus un artisan, vous êtes un manager, donc vous demandez à des agents (IA) d’écrire le code pour vous. Vous donnez les spécifications ; vous êtes un donneur d’ordre. » (la séquence est accessible à partir de 1h 8 min et 41 sec.
Et là quand j’entends ça j’ai plein de questions. Première question : est-ce que c’est vrai ? Alors disons oui et non. Pour en avoir échangé avec des collègues informaticien.ne.s dont certain.e.s ont également travaillé dans ces grands groupes (Google et Facebook), disons que oui c’est vrai il existe des ingénieurs / développeurs qui n’écrivent plus de ligne de code, mais il existe aussi toujours quand même qui codent les agents IA qui à leur tour vont coder à la place d’autres ingénieurs et/ou développeurs. Il y a d’ailleurs une expression dédiée, on appelle cela du « Vibe Coding » qui consiste à créer du code informatique (par des initiés ou des non-initiés) en utilisant du langage naturel grâce à l’IA.
Deuxième question : est-ce que c’est grave ? Je n’ai pas la réponse à court terme mais à moyen terme j’ai l’absolue certitude que cela l’est. Et que cela l’est éminemment.
Troisième question : est-ce que c’est une bonne nouvelle ? Pour répondre, je vous propose de transposer la situation du PDG d’une boite d’IA expliquant que ses ingénieurs n’écrivent plus de ligne de code pour … coder, à la situation, par exemple, d’un ou d’une responsable de formation, d’un ou d’une enseignante, qui dirait : « je n’ai plus aucun étudiant / élève qui ait besoin de comprendre les concepts et notions que je manipule pour leur transmettre un savoir et qu’ils soient en capacité d’en produire de nouveaux à leur tour. Et là c’est, convenez-en, tout à fait vertigineux. Alors oui bien sûr, comparaison n’est pas raison, les ingénieurs d’Arthur Mensch ne sont pas les élèves ou étudiants dans nos classes et nos amphis, et oui bien sûr le code est un langage mais on pourrait philosopher quelques heures (en relisant Saussure, Chomsky, Wittgenstein et quelques autres) sur le fait qu’il est ou non une langue. Mais vous voyez l’idée.
Quatrième question. Si l’on s’accorde sur le fait que le code est une langue ou à tout le moins un langage, quand vous n’écrivez ou ne parlez plus une langue, au bout de combien de temps cessez-vous de la comprendre et de la maîtriser ? Arthur Mensch le dit lui-même, il est de cette génération « d’artisans du code » (il a 33 ans), il a appris cet artisanat et il dit aussi que cela lui a plu. Mais une autre génération arrive, qui n’aura plus la nécessité d’apprendre, ou d’apprendre autant. Alors que feront-ils ? Et s’ils n’écrivent plus une ligne de code mais doivent continuer de fabriquer des applications, alors que feront-ils … sans code ? Autre vertige.
Alors oui je sais, entre ce que dit Arthur Mensch, et le contexte et la place depuis lesquels il dit cela, il y a tout de même une série de nuances à apporter. Pour autant, dans le champ scientifique qui est le mien (les sciences de l’information et de la communication), il nous appartient précisément de prendre des énoncés pour ce qu’ils disent dans l’instant, autant que pour ce qu’ils installent aussi en terme de narration sociale plus ou moins implicite. Et Arthur Mensch « incarnant » et portant le discours technophile, accélérationniste et dérégulateur autour de l’IA, ce qu’il dit (même si cela n’est que 2 minutes dans une vidéo d’une heure trente) est en soi un énoncé particulièrement performatif auprès de celles et ceux qui l’écoutent. Et ce que dit Arthur Mensch c’est que « aujourd’hui les ingénieurs chez Mistral n’écrivent plus de ligne de code. » Comprenez et entendez que donc tous les ingénieurs dans toutes les entreprises d’IA qui sont ou se rêvent en futures licornes, n’écrivent et n’écriront plus une ligne de code ou en tout cas n’ont et n’auront plus vocation à le faire. Juste du Vibe Coding.
Le cauchemar de Lessig.
« Code Is Law. » (traduit en français par Framasoft). « Le code c’est la loi. » C’est un livre (paru en 1999, « Code And Other Laws of Cyberspace« ) et un article (paru en 2000). C’est l’un des textes fondateurs de la culture numérique. Publié au début des années 2000, absolument fondamental et totalement visionnaire, Lawrence Lessig (professeur de droit, spécialiste de propriété intellectuelle, inventeur des licences Creative Commons, etc.), Lawrence Lessig y explique notamment que le code est un régulateur, que le code décide et que le code :
« définit la manière dont nous vivons le cyberespace. Il détermine s’il est facile ou non de protéger sa vie privée, ou de censurer la parole. Il détermine si l’accès à l’information est global ou sectorisé. Il a un impact sur qui peut voir quoi, ou sur ce qui est surveillé. Lorsqu’on commence à comprendre la nature de ce code, on se rend compte que, d’une myriade de manières, le code du cyberespace régule. »
Et il poursuit en expliquant que :
Des gens choisissent la manière dont le code effectue tout cela. Des gens écrivent ce code. Dès lors le choix n’est pas de savoir si les gens pourront choisir la manière de réguler le cyberespace. D’autres gens – les codeurs – le feront. Le seul choix est de savoir si nous jouerons collectivement un rôle dans leurs choix – et si nous pourrons alors déterminer la manière dont ces valeurs se régulent – ou si nous autoriserons collectivement ces codeurs à décider de ces valeurs à notre place.
D’où ma dernière question : if « Code Is Law », then what da fuck is Vibe Coding ?
Le « Vibe Coding », un monde dans lequel les entreprises les plus puissantes en IA n’auraient que des ingénieurs et des développeurs n’écrivant plus de ligne de code, ce monde c’est le cauchemar de Lawrence Lessig et notre cauchemar à toutes et tous. Car si les codeurs eux-mêmes sont à distance du langage ou de la langue par laquelle ils installent des valeurs dans le code, s’ils ne parlent ou n’entendent plus cette langue et s’ils se réduisent à des fonctions de « managers d’agents IA – faussement – autonomes », alors comment elles et eux en première ligne, et surtout comment nous toutes et tous en première cible, comment serons-nous encore capables de jouer collectivement un rôle dans la circulation et l’établissement de ces valeurs, de ces agendas politiques, économiques, idéologiques, que le code véhicule et qui n’ont jamais été aussi puissants et déterminants, et dans le même temps jamais à ce point été inféodés à des intérêts presqu’uniquement marchands, mafieux et singuliers ?
Si le code se passe de développeurs autres que des agents non-humains, alors la question de la maîtrise des valeurs que le code véhicule devient une non-question, un inquestionnable.
« Un algorithme c’est la décision de quelqu’un d’autre » me faisait l’honneur d’écrire Antonio Casilli dans la préface à l’un de mes tout premiers ouvrages. Et ce quelqu’un n’était pas extrêmement compliqué à trouver, à isoler, et à questionner. Mais un algorithme « vibe codé » c’est la décision de … qui ?
« Les limites de mon langage signifient les limites de mon propre monde » écrivait Wittgenstein.
L’intelligence c’est de l’énergie (et la connerie c’est de l’énergie moins chère).
Arthur Mensch dit aussi plein d’autres trucs qui installent des narratifs extrêmement clairs et puissants dans leur fonction d’agenda. Par exemple à plusieurs reprises il répète qu’il faut réfléchir ou considérer l’intelligence comme on réfléchit à l’énergie, à l’électricité. Alors bien sûr il parle de l’intelligence artificielle. Mais il ne dit pas « intelligence artificielle », il dit juste « intelligence ». Et ce n’est pas « juste » une omission ou un raccourci. C’est l’endroit d’où il parle, celui d’où il est situé, c’est l’énoncé de son futur probable et de son futur désiré, d’un futur qui répond à « son » agenda propre. Un mode dans lequel en effet l’intelligence se capte, se stocke, se transmet et se calcule comme l’énergie, comme l’électricité. D’ailleurs et c’est aussi extrêmement frappant, à plusieurs reprises et sur plusieurs questions, il commence toujours par répondre en nombre de kilowatts ou de mégawatts. C’est son unité de mesure, son mètre étalon et ce sur presque l’ensemble des questions qui lui sont posées et adressées. Tout se calcule en kilowatts ou mégawatts. Tout est là. Toutes les réponses sont là. Un mètre étalon. Qui est aussi son plus grand talon d’Achille (à lui et à l’ensemble de l’industrie extractiviste de l’IA).
[en]
Je voulais écrire hier. Hier, deux semaines après la mort d’Oscar. Le choc a passé. Je suis de retour au travail – avec difficulté la semaine dernière, on verra ce que raconte celle-ci. Il reste le manque. Il me manque. Je commence tout juste à entrer parfois dans mon appartement sans ressentir très fort la présence de son absence. J’ouvre la porte et le vide me saute à la figure. Ça diminue un peu, mais c’est encore là.
Le pire c’est le soir. Oscar, il m’attendait sur le lit. Je me cou
Je voulais écrire hier. Hier, deux semaines après la mort d’Oscar. Le choc a passé. Je suis de retour au travail – avec difficulté la semaine dernière, on verra ce que raconte celle-ci. Il reste le manque. Il me manque. Je commence tout juste à entrer parfois dans mon appartement sans ressentir très fort la présence de son absence. J’ouvre la porte et le vide me saute à la figure. Ça diminue un peu, mais c’est encore là.
Le pire c’est le soir. Oscar, il m’attendait sur le lit. Je me couchais, il s’installait contre moi. Avant Oscar, il y avait Quintus. Et Tounsi, moins longtemps. Avant, Bagha. La chose la plus étrange dans cette période de deuil c’est que le cri intérieur de ma peine disait souvent “Bagha” au lieu de “Oscar”, surtout les premiers jours. Pourquoi? La mort de Bagha, c’est tellement loin. Il y en a eu tant d’autres depuis.
Oscar, il a gagné mon coeur en étant lui, évidemment, mais aussi au début parce qu’il me rappelait Bagha. Un grand matou tigré et blanc, bien dans ses coussinets, qui ne se laisse pas démonter par la vie. Aussi, après la mort de Bagha, je me suis retrouvée “sans chat chez moi“, comme aujourd’hui. Voilà peut-être d’où vient cet écho.
Quelque part dans ma tête, j’ai “home is where the cat is”. C’est une de mes définitions du chez-soi. J’aimais rentrer chez moi, être chez moi, aussi parce que c’est là qu’est le chat (ou les chats). Et donc c’est tristounet, ici. C’est vide. Il n’y a plus que moi et les plantes. Il ne se passe rien en-dehors de moi. Un jour, Juju passera du temps ici, mais pas encore. Donc en attendant, c’est juste moi.
Au-delà de l’attachement que j’avais pour Oscar, il y avait le rôle structurant que jouait sa présence dans mon quotidien. Une structure lourde parfois, mais qui avait aussi beaucoup de positif, d’autant plus dans un contexte post-accident où mon fonctionnement exécutif galère encore plus qu’avant et où je ne travaille encore qu’à temps partiel, en télétravail la plupart du temps. Les ancrages externes des horaires des soins, des habitudes du chat, et même de l’impulsion d’aller voir comment il va: tout ça est loin. C’est une vraie perte de repères.
Le pire, c’est le soir, je disais. Ma gestion du temps nage la brasse, ma sensation du temps la brasse coulée. Dans une période où le sommeil est critique à ma convalescence, je n’arrive plus à tenir le rythme que je souhaite. Je me retrouve à me coucher à 2h, à 3h du matin. Je suis lente, désorganisée, coordonner les actions diverses d’une étape du quotidien me demande beaucoup plus d’efforts qu’il y a un mois. C’est normal. Un deuil, même sans commotion dessous, ça entraine des perturbations cognitives. Je le sais, je ne m’en alarme pas, je puise dans ce que j’ai comme patience avec moi-même et ce long processus de récupération. Mais c’est galère.
Le soir. En plus, une fois au lit, une fois qu’il s’agit d’éteindre, d’arrêter l’activité continue de la journée dans laquelle je me réfugie un peu malgré moi, qui ne me fait pas forcément du bien au fond mais qui soulage sur le moment, il ne reste plus que l’absence d’Oscar, qui une fois installé, retenait mon bras de sa patte si j’essayais de le bouger. Et je suis triste, et je n’aime pas me sentir triste, et donc j’ai encore moins envie d’aller me coucher. Tout ça, en plus du fait qu’aller dormir, ça signifie être demain matin, un nouveau jour où je vais me lever et où Oscar ne sera toujours pas là.
Le courage me fait défaut. Pas juste parce que ça fait mal, d’avoir le courage de sentir ce qu’il y a à sentir, mais aussi parce que ça fait plus d’un an que je fais des efforts, que j’en ai marre et que j’en suis fatiguée. Certes, on fait toujours des efforts dans la vie, ça fait partie de la vie. Mais ceux qu’on doit fournir quand un problème de santé bouleverse durablement notre vie, ce ne sont pas ceux de la vie de tous les jours. Alors j’ai moins de courage pour ce deuil que si je n’avais pas eu d’accident. C’est comme ça. On fait ce qu’on peut avec ce qu’on a quand on l’a.
Je voulais écrire hier, je me suis laissée prendre dans d’autres choses, sans trop me battre. Aujourd’hui, j’ai failli aussi. J’ai travaillé. Mon cerveau est fatigué. J’ai fait une sieste, au salon, sur mon canapé, sans Oscar, parce que demain je travaille et que je sais maintenant que même si la journée semble bien se passer, si j’ai fait pas mal bosser mon cerveau, ce n’est pas dit que demain ça aille. Donc repos. J’apprends à être proactive. C’est dur, moi qui aime faire, faire, faire. Qui avant mon accident étais déjà frustrée de tout ce que je n’avais pas le temps ou l’énergie de faire. Qu’est-ce que j’étais ingrate avec la vie!
Sieste, un exercice difficile pour moi. J’ai réussi, là, assez je trouve. Puis je me lève. Cerveau fatigué, coeur désoeuvré. Regarder ma série? J’aimerais éviter de repartir dans une longue séance de bricolage de mon assistant IA. J’ai beaucoup fait ça, ces dernières semaines. C’est prenant en tant que tel, c’est pas idéal pour mon cerveau (même si c’est pas la cata, j’ai vraiment appris à repérer quand je ralentis et ne pas lutter contre ça), et ça m’a donné du répit au milieu de ma peine. C’est un délicat équilibre, qui rappelle celui de ma convalescence: le bon équilibre entre activité et repos; le bon équilibre entre sentir et souffler. Là, ça fait un moment que je sens que je dois reprendre le temps de sentir. Il y a très longtemps, j’ai compris que quand je me voyais en train de chercher à échapper à quelque chose que je sentais, c’était signe qu’il fallait justement prendre le temps de le sentir. Et pour moi, un truc qui marche bien, c’est écrire. Dans ma cuisine, tout à l’heure, alors que je dérivais vers le frigo à la recherche un peu floue de quelque chose qui me réconforterait, j’ai bien reconnu le goût de cette volonté d’échapper.
Alors j’ai ouvert mon ordinateur et j’ai commencé à écrire.
C’est pas le pied, donc. C’est pas le pied parce qu’Oscar est mort et qu’il me manque. J’ai des moments où monte cette envie déchirante de faire machine arrière, de ne pas décider qu’il est temps, de faire autrement, d’attendre encore. Je la connais bien, cette envie, et je sais qu’elle ne dit rien de ma décision, juste de ma peine. Un exercice vain et désespéré de la pensée pour avoir moins mal. Oscar me manque sur le balcon, au salon, dans ma chambre à coucher et à l’eclau. Il me manque dans le jardin où on avait pris l’habitude de faire quelques sorties. Il me manque le matin à 8h et le soir à 20h à l’heure des médicaments et des injections, et aussi à 16h et le plus tard possible avant de dormir, l’heure des anti-épileptiques qu’il léchait mélangés à une friandise dans une petite coupelle.
C’est pas le pied parce que mes journées ont perdu leur structure, et une partie de mon espace aussi. Parce que mon cerveau vient de se prendre l’équivalent émotionnel d’un nouveau choc à la tête, et qu’il rame.
Et pour couronner le tout, c’est pas le pied parce que dans la nuit de mercredi à jeudi, à 2h30 du matin, mon cerveau diminué a pensé qu’un aller-retour au salon pouvait se faire dans le noir, en étant prudente de contourner l’immense photophore en verre que j’avais déplacé au milieu du chemin pour tenir un place une lame de parquet que je venais de recoller, et a ensuite promptement effacé le photophore de la carte pour le trajet du retour, 20 secondes plus tard. Croche-pattes, photophore en miettes, un pied brièvement reposé au milieu des briques de verre pour reprendre l’équilibre, un gros morceau de verre planté dans le pied, une coupure nette et profonde de 8mm qui pisse le sang, un pansement compressif improvisé avec un mouchoir sale et une chaussette qui trainait par là (merci en passant au 30 ans de judo, tout ça sur un pied), et un week-end de l’Ascension en béquilles. Tout fait sens, franchement.
Le pied n’a rien de grave et guérit bien, j’espère être en mesure de marcher un peu dans le quartier d’ici quelques jours. Oscar est toujours mort, et mon cerveau bat toujours de l’aile. L’eclau n’est pas rangé comme je l’aurais voulu – pas commode en béquilles ou à cloche-pied. Je suis allée voir les iris à Vuillerens, quand même, en béquilles et en bonne compagnie, sous la pluie.
J’essaie de reprendre le contrôle de mon sommeil. J’essaie de trouver le courage de ralentir, mais quand je vois comme je me sens maintenant, je comprends pourquoi c’est si dur. J’aimerais qu’Oscar soit là. Lui faire un massage d’oreille. Poser ma tête sur sa poitrine – a sa consternation sûrement, mais tant pis.
Et si notre terre était notre langue ?
Et si les IA conversationnelles étaient nos vaisseaux ?
Et si nous étions des astronautes sociaux ?
L’Overview Effect ou « effet de vue d’ensemble » c’est « un choc cognitif, une prise de conscience dont témoignent certains astronautes lors d’un vol spatial qui se produit lorsque ceux-ci observent la Terre depuis l’orbite terrestre ou la Lune. Cet effet se produit par la mise en perspective directe de la situation de la Terre dans l’espace : la planète
Et si notre terre était notre langue ? Et si les IA conversationnelles étaient nos vaisseaux ? Et si nous étions des astronautes sociaux ?
L’Overview Effect ou « effet de vue d’ensemble » c’est « un choc cognitif, une prise de conscience dont témoignent certains astronautes lors d’un vol spatial qui se produit lorsque ceux-ci observent la Terre depuis l’orbite terrestre ou la Lune. Cet effet se produit par la mise en perspective directe de la situation de la Terre dans l’espace : la planète est perçue comme une sphère fragile, un point bleu pâle « suspendu dans le vide », protégé par une fine atmosphère. »
L’Overview Effect conduit donc à prendre conscience de la fragilité d’un écosystème en l’observant d’un point, d’une position qui ne nous est ni naturelle ni facilement accessible et qui introduit une grande distance impliquant un renversement de perspective.
Et bien – me semble-t-il en tout cas – c’est très caractéristique de ce qu’ont produit les premiers systèmes d’IA conversationnels, ces artefacts génératifs. Et de ce qu’ils continuent de produire actuellement. En même temps que ces « agencements machiniques informationnels » ont déplacé la question du langage, ces IA conversationnelles et leur insincères maïeutiques nous ont mis dans une situation d’observation tout sauf naturelle de processus discursifs en temps réel qu’ils effectuent, processus discursifs pour autant (essentiellement) crédibles et « satisfaisants » (en tout cas satisfaisants aux principaux codes d’un échange conversationnel entre deux êtres humains).
Voir des machines parler était déjà étonnant mais fut longtemps cantonné au seul imaginaire de science-fiction ; puis parler à des machines (via les interfaces vocales du World Wide Voice) devînt une forme de routine mais demeurait, quelque part, toujours une forme d’étonnement ; aujourd’hui, voir des machines avoir avec nous des conversations rationnelles en temps réel, produit un effet de décalage qui fait que c’est « notre » intelligence, « notre » capacité dialogique et rationnelle qui est vue comme immensément fragile et qui, par contraste, donne à ces machines et à ces artefacts, dans l’interaction que nous avons avec elles, une place différente de ce qu’elle devrait être. Un renversement de perspective.
Nous sommes dans la position de l’astronaute qui observe non pas la terre mais la capacité de langage et d’intellection (et parfois aussi d’imagination), et qui l’observe pour la première fois depuis la médiation artificielle et artefactuelle qu’en propose l’IA générative. Et si la distance de la terre à la station spatiale qui permet de l’observer est considérable et se mesure en kilomètres (autour de 400 pour être précis), la distance entre notre « engagement langagier » et l’écho conversationnel médié par les IA est tout aussi vertigineuse à ceci près qu’elle ne se mesure plus en kilomètres mais plutôt en dépliant l’ensemble des règles algorithmiques, corpus d’entraînement, processus de « fine-tuning » mais aussi infrastructures techniques (data centers) et autres opérations qui permettent aux machines de faire à la fois illusion de langage et leurre de conversation.
Soit la langue est fragile, soit c’est nous qui le sommes.
Et si la langue est aux machines …
Cette position tout sauf naturelle (au même titre que celle de l’astronaute Sophie Adenot ci-dessus) nous conduit, en partie au moins, à regarder et à mieux mesurer et prendre en compte toute la fragilité du langage et des interactions humaines qu’il permet et conditionne. Mais cette situation d’observation inédite produit également deux effets différents : certains cherchent à protéger ou à sanctuariser la nature ou à tout le moins la fonction du langage, et à ne pas entièrement et systématiquement les soumettre aux systèmes techno-politiques qui produisent et façonnent ces IA ; d’autres au contraire font de cette fragilité évidente l’occasion d’un renoncement sur l’autel de l’efficience ou de la rationalité économique, prétextant se démultiplier via des IA agentiques qui sont le Taylorisme d’une langue véhicule. Et puis bien sûr il y a les enjeux même de l’écriture et de la création, que décrit un récent et admirable texte de Gregory Chatonsky sur AOC : « Ce qui (me) permet d’écrire est ce qui (vous) empêche de lire. »
Dans les deux types de réaction possible à cet Overview Effect de l’IA sur le langage, certains initialement en garderont donc surtout un sentiment accru de connexion avec une entité non-humaine, là où d’autres n’y verront que l’instanciation de formes toujours plus abouties d’isolement et de solitude. Tout comme la littérature scientifique autour de l’Overview Effect (qui date des premiers vols à haute altitude dans les années 1950), documentait aussi bien « l’appréciation et la perception de la beauté, une émotion inattendue, voire bouleversante, et un sentiment accru de connexion avec les autres » (Wikipedia) qu’un effet paradoxal de « rupture » ; les aviateurs traversaient en effet un phénomène décrit comme un sentiment de séparation physique de la terre occasionnant des réactions individuelles allant qui pouvait soit les plonger dans un sentiment « d’exaltation ou du sentiment de se sentir plus proche de Dieu » tout comme à des formes élevées d’anxiété, de peur ou de solitude (Wikipedia). Ce phénomène dit de « break-off » cessa d’être étudié en tant que tel au début des années 1970.
Dans l’histoire des technologies numériques, qu’il s’agisse du Cloud, des réseaux sociaux, ou désormais de l’IA, les effets de proximité sont presque toujours paradoxaux et ne font que masquer une distance de plus en plus grande. Le « Cloud Computing » permet une disponibilité immédiate de documents qui n’ont jamais été stockés physiquement aussi loin de nous ; les réseaux sociaux ont historiquement fait proximité (puis promiscuité) avec des individus géographiquement toujours plus éloignés. Sans toujours le mesurer ou l’éprouver, nous avons donc déjà traversé d’autres « Overview Effects » : celui de l’éloignement et d’une distension de nos mémoires documentaires, celui de l’éloignement et d’une distension de nos relations sociales, et désormais donc, celui de l’éloignement et d’une distension là encore paradoxale de notre rapport au langage.
Voilà pourquoi, aussi, la question des heuristiques de preuve, celle de savoir comment à l’échelle d’une société nous serons – ou non – encore capables de définir la valeur de vérité d’un énoncé ou d’un fait et que cette valeur soit partagée parce que démontrable, documentable, voilà pourquoi la question des heuristiques de preuve est devenue aussi essentielle : non pas seulement par l’industrialisation de la production du faux, non pas uniquement par la vitesse même à laquelle ce faux est créé et se diffuse mais parce que nous sommes placés à une distance lointaine, inédite, comme en « décrochage » de notre capacité à faire langage. Parce que pour filer cette métaphore au moins visuelle de l’Overview Effect, c’est un autre type de vaisseau que l’ISS qui nous mène à si grande distance d’un biotope (la langue) qui nous est habituellement si proche et qui à mesure qu’elle se rapproche des machines semble aussi comme proportionnellement s’éloigner de nous. Les IA, ou plus précisément leur cadre de déploiement technique (les LLM) et infrastructurel (Data Centers et processeurs), sont un vaisseau comme un vecteur de mise à distance, d’éloignement de ce qui fait la langue.
Nous arrivons aujourd’hui à un moment charnière dans lequel nous verrons si la massification de l’usage des IA (pour autant qu’elle continue d’augmenter de manière constante et ne soit pas soumise à divers aléas d’un modèle économique pour l’instant reposant sur la dynamique d’un gigantisme de l’épuisement – toujours plus de ressources et de consommation), nous verrons, disais-je, si la massification de l’usage des IA nous emmène plutôt vers la conscientisation de la fragilité de la langue ou s’il faut plutôt se résoudre, après sa marchandisation dans un capitalisme linguistique (Frédéric Kaplan), à sa presque totale servicialisation dans un cadre où ce que l’on appelait la novlangue et le néo-parler, seront l’essentiel de la langue collective circulante quand d’autres régimes discursifs et linguistiques, jusqu’ici principalement vecteurs de socialisations affectives fines, seront de plus en plus cantonnés aux seuls échanges entre humains et machines.
Je ne crois pas trop à l’avènement à moyen terme d’une société du silence qu’extrapole par exemple un éditorial du WSJ reposant sur un article scientifique qui montre que nous utilisons en moyenne chaque année, 300 mots de moins par jour. Un recul de la parole qui touche toutes les classes d’âge et que les chercheurs comptabilisent en indiquant que notre volume de parole a diminué de 28% en moins de 15 ans.
Je crois par contre que depuis l’avènement des médiations numériques, l’inflation de paroles et de discours directement monétisables d’une part (capitalisme linguistique), et en parallèle et d’autre part, l’artificialisation soutenue de formes discursives indigentes au seul renfort d’une nécessité d’interaction rendant la langue soluble dans sa fonction phatique, je crois que oui, tout cela fait qu’encore une fois la question du langage s’est déplacée et qu’elle continue de le faire toujours davantage, les IA conversationnelles augmentant la distance entre elle et nous à des échelles stratosphériques jusqu’ici jamais atteintes.
One More Thing.
Dans une interview au magazine Usbek & Rika à propos de son dernier livre, la question était posée à Nicholas Carr de savoir quelle serait sa première décision s’il était nommé à la tête d’un puissant ministère de la technologie et du numérique par un gouvernement éclairé. Et il répondait ceci : « Détruire tous les centres de données. »
Or que sont ces centres de données fondamentalement dans la perspective qui nous occupe ? Ce sont des centres d’accumulation de paroles et de discours ; de paroles et de discours retenus, en permanence recalculés, archivés non pas par vertu de conservation mais par nécessité de manipulation. Détruire tous les centres de données pourrait alors, en effet, redonner une chance à la parole d’exister, et que chaque occasion nouvelle de discourir soit aussi une occasion nouvelle de découvrir. Ce qui fût un temps l’essentiel de l’intérêt de ce que nous appelions le Web.
[en]
In the days of early grief, the pull towards the being you lost is still there. It pulls at your heart but has nowhere to go. It is a ghost. A ghost of habits and rituals, a ghost of familiarity, who feeds on unmoored love – another name for grief.
Like a phantom limb in your life, it makes you feel, it makes you want, it can almost make you speak. You stop yourself, of course, because there’s nothing there, nothing left. Nobody to check on, nobody to touch, nobody to look at. Nobody t
In the days of early grief, the pull towards the being you lost is still there. It pulls at your heart but has nowhere to go. It is a ghost. A ghost of habits and rituals, a ghost of familiarity, who feeds on unmoored love – another name for grief.
Like a phantom limb in your life, it makes you feel, it makes you want, it can almost make you speak. You stop yourself, of course, because there’s nothing there, nothing left. Nobody to check on, nobody to touch, nobody to look at. Nobody to love you back.
In the days where grief is young, where reality is ripped apart from what is true, the truth inside us hangs on to its last shuddering breaths, unwilling to fold into reality and offer peace. For truth is made of actions and feelings more than words or ideas, and keeps trying to draw us towards the one who is gone. The presence of absence takes up all the space.
The pull is sometimes so strong that we hear them speak or think we have seen them. These ghosts are within us, like rogue processes that have lost their purpose but will not stop running.
They make for strange times, which don’t last that long. Sometimes a few weak echoes follow you down the weeks or even the years, but few and far between, nothing like those first few days in a foreign life. The life without.
[en]
Voilà, il est là. Il est là, le soulagement. Je savais qu’il serait là. C’est normal, après des années de soins, d’inquiétude, de peur de ce qui allait arriver. C’est normal d’être soulagé de ne plus porter ce poids.
Il est arrivé plutôt rapidement, le soulagement. Mais je n’ai pas fini d’être triste. Je ne suis pas vraiment prête à me sentir soulagée. En plus, le soulagement il arrive accompagné de sa copine la culpabilité. Bien sûr, parce que quand son chat vient de mourir, on ne va q
Voilà, il est là. Il est là, le soulagement. Je savais qu’il serait là. C’est normal, après des années de soins, d’inquiétude, de peur de ce qui allait arriver. C’est normal d’être soulagé de ne plus porter ce poids.
Il est arrivé plutôt rapidement, le soulagement. Mais je n’ai pas fini d’être triste. Je ne suis pas vraiment prête à me sentir soulagée. En plus, le soulagement il arrive accompagné de sa copine la culpabilité. Bien sûr, parce que quand son chat vient de mourir, on ne va quand même pas se sentir soulagée.
Alors que si, en fait.
Miss Culpabilité, elle veut te faire croire que quand elle débarque, c’est que tu as mal fait. Que tu es coupable de quelque chose, que tu as failli. Mais c’est pas vrai. Elle se pointe en opportuniste, histoire de voir. Elle surfe sur le sillage de M. Soulagement, parce qu’elle sait qu’il n’est pas vraiment prévu au programme, pas invité à la fête, quand on a encore la mort en travers de la gorge.
Je sais qu’elle est là juste comme ça, en passagère clandestine, en imposteur, même. Elle sait qu’on préfère souvent se donner des coups de pied que de sentir des choses difficiles ou moins familières. Je ne lui sers ni à manger ni à boire, mais voilà, elle est quand même là. Il faut faire avec, et c’est normal aussi.
Je ne veux pas de cette légèreté inhabituelle dans ma vie, même si elle est plaisante. C’est là qu’est la brèche dans laquelle elle se glisse.
Ne pas avoir à me soucier des horaires. Ne pas me demander où il est, ne pas aller voir comment il va, ne pas me demander s’il est confortable, s’il veut quelque chose, si je peux faire plus ou si je devrais faire moins. Ne pas faire les mille petits gestes du quotidien qu’on fait de bon coeur quand on aime un petit être fragile et vieillissant. Ne pas avoir peur, peur de le perdre, peur de faire faux, peur de me tromper, peur de ne pas faire ce qui est juste pour lui, peur qu’il souffre sans que je m’en rende compte, ou plus que je ne m’en rends compte, peur de l’après, où le soulagement et sa copine la culpabilité viendront essayer de me faire croire que s’ils sont là bien confortablement installés sur mon canapé à se partager un jus d’orange, c’est que je ne pouvais pas l’aimer tant que ça, mon vieux chat, et donc que ce n’est pas si grave, qu’il soit mort, alors que si – je l’aimais tant que ça, leur présence ne dit rien de mon amour et de mon attachement, dit en fait au contraire tout de combien il a fallu qu’il soit grand pour me permettre d’accueillir dans ma vie, avec enthousiasme malgré leur coût, les contraintes et les responsabilités qui se sont maintenant envolées avec lui, ce qui me vaut leur visite.
Je n’ai pas fini d’être triste, ni de me débattre avec la fin de l’existence pour tout être sur cette terre. Je n’ai pas fini de regretter son absence et d’avoir mal quand je pense à lui. Mais je commence à pouvoir, malgré tout, m’autoriser à apprécier un peu la légèreté retrouvée. Ce n’est pas incompatible, même si c’est très déroutant.
[en]
C’est très déroutant. J’ai l’impression d’avoir été plongée dans un univers parallèle, à la fois familier mais pas tout à fait juste. Je suis régulièrement saisie par le sentiment d’avoir oublié quelque chose, par le besoin d’aller vérifier quelque chose, d’une absence anormale. Je sens le soulagement qui pointe le bout de son nez, une fois l’orage de tristesse passé, quand les nuages se dissipent, immédiatement remis à sa place par les doutes et la culpabilité, une impression diffuse d’av
C’est très déroutant. J’ai l’impression d’avoir été plongée dans un univers parallèle, à la fois familier mais pas tout à fait juste. Je suis régulièrement saisie par le sentiment d’avoir oublié quelque chose, par le besoin d’aller vérifier quelque chose, d’une absence anormale. Je sens le soulagement qui pointe le bout de son nez, une fois l’orage de tristesse passé, quand les nuages se dissipent, immédiatement remis à sa place par les doutes et la culpabilité, une impression diffuse d’avoir fait quelque chose de terrible.
Les gamelles dans l’évier, je leur en veux d’être là. Les sachets de nourriture dans la boîte dans le couloir, aussi. Les tiroirs pleins d’affaires, les paniers dans le salon, sur le lit, sur le balcon, les petits escaliers pour chat. Je les vois et je leur en veux. Je leur en veux d’être là alors qu’Oscar n’est plus là.
A la mort de Tounsi, je me souviens d’en avoir voulu à Quintus d’être encore en vie. C’était une réaction qui n’avait aucun sens pour moi. J’aimais Quintus. Certes, il aurait été dans l’ordre des choses qu’il meure avant Tounsi. Mais il n’avait rien à voir dans la mort de Tounsi, il n’y pouvait rien, pourquoi donc est-ce que je lui “en voulais”?
Je crois que je comprends, maintenant, face aux gamelles et aux boîtes de médicaments et au stylo d’insuline dans le frigo. L’existence de chacun de ces objets met en relief l’absence d’Oscar. Ils me renvoient aux gestes que je ne ferai plus, aux moments partagés que je n’aurai plus – ils sont les témoins très concrets, à travers leur présence et leur inutilité, de la part de mon quotidien arrachée par la mort. La mort d’Oscar, mon grand chat à la personnalité immense et à la volonté irrépressible, que j’ai amadoué, chéri, soigné, et qui en retour m’a offert sa confiance et un ancrage, un rythme, une présence.
Quintus et Tounsi étaient un duo. Quand il y avait l’un, il y avait l’autre. La vie de Quintus soulignait la mort de Tounsi. Je n’en voulais pas à Quintus, en réalité. C’était simplement ma réaction à la douleur que sa présence m’imposait – celle de l’absence de Tounsi.
C’est la même chose ici. Elles n’y peuvent rien, les gamelles. Pour la première fois, je crois que je comprends les personnes qui ressentent le besoin de faire disparaître toute trace de l’être aimé au plus vite. Je comprends aussi celles qui ne veulent toucher à rien, parce que la mort c’est déjà assez de chamboulement sans en plus défigurer l’espace familier dans lequel on vit, et aussi parce que tout ce qui reste, c’est aussi un moyen de rester en lien malgré l’absence.
Je suis quelque part au milieu. Hier soir j’ai rangé deux ou trois choses. J’ai poussé les escaliers qui mènent au lit, rassemblé dessus couvertures anti-chute, panier, jouets, le peigne qui trainait sur la table de nuit. J’ai empilé les dodos du salon et du balcon dans le fauteuil où Oscar aimait se tenir, jusqu’à ce qu’il y fasse une crise qui a fini par l’en faire tomber – pour ne plus jamais y remonter. Mais c’est tout. Le plus gros, ce qui est dans le chemin.
J’ai tellement d’affaires liées à Oscar. Où vais-je les ranger? Que vais-je faire de l’espace libéré? C’est là en toile de fond. Il n’y a pas d’urgence. Pas aujourd’hui, peut-être cette semaine.
Je suis très déboussolée, juste là. La quantité de messages de soutien reçus, que ce soit par WhatsApp, sur la page d’Oscar ou dans le groupe Diabète Félin, me vont droit au coeur même si juste maintenant, honnêtement, je n’arrive pas à répondre. J’ai besoin d’être seule et tranquille. Mode cocon. J’ai deux ou trois points de contact en place pour cette semaine. Ça me touche que vous pensiez à moi, et j’apprécie infiniment les offres de soutien. C’est important dans un moment comme ça. Proposer quelque chose, c’est la chose juste à faire, même si la personne en deuil n’y répond pas ou n’en a pas besoin juste là. Ne prenez pas mon silence pour du rejet ou du manque de considération – savoir que vous êtes là, que vous pensez à moi, ça compte, du fond de mon petit cocon.
Chaque chat est différent, chaque deuil aussi. Ce qui est valable un jour peut ne plus l’être le lendemain. Merci pour les bouteilles à la mer, merci d’être là.
J’ai pensé à Delphine ces derniers jours, et hier surtout. La vétérinaire qui est venue pour l’euthanasie d’Oscar la connaissait aussi, et la dernière fois qu’elle était venue ici en consultation, pour Oscar, c’était avant son décès, et on avait parlé d’elle.
Prendre la décision de faire endormir son animal adoré, c’est super dur. Mais je n’oublie jamais le ou la vétérinaire, dans l’histoire. Ce n’est pas anodin, comme acte. Ce n’est pas toujours facile – des fois plus ou moins que d’autres. Comment sont formés et accompagnés ces professionnels face à la question de la mort, avec laquelle ils sont si souvent aux prises, ça me travaille. D’autant plus après le décès de Delphine, car évidemment, on en a parlé, de l’impact de ce métier sur le rapport à la mort. Il y a certainement des exceptions, mais d’après ce que j’ai compris, c’est très largement “chacun se débrouille comme il peut”. C’est un autre sujet que celui de cet article, et qui mérite une place à lui. Mais c’était important pour moi de le dire.
J’ai mal à la tête et j’ai du brouillard dans le cerveau. Je tourne au ralenti – autant les dernières heures et minutes hier avec Oscar ont parfois semblé s’étirer à l’infini alors que je le caressais, lui parlais, ou le regardais dormir, autant depuis son décès les heures disparaissent en un clin d’oeil. Mon temps est une succession d’ellipses.
J’ai dormi, cette nuit, et celle d’avant aussi. Pas tout à fait assez, mais j’ai dormi. Je ne suis pas sortie, par contre. Il faudrait que j’aille au parc, au moins. Mais dans cet univers parallèle sans Oscar, le ciel est gris et l’orage menace. Le peu de batterie sert à me faire à manger, et il ne m’en reste plus pour braver les éléments. Il va falloir attendre que ça se recharge.
[en]
Dernière nuit, dernier matin. Dernière injection d’insuline. Derniers médicaments du matin – je lui donne un Cerenia entier, parce que c’est le dernier de la boîte, et sait-on jamais, il sera peut-être un poil mieux qu’avec un demi. Et si c’est pas le cas, c’est pas comme si je devais garder la moitié pour demain.
J’ai sorti mon pilulier, celui que j’ai acheté après mon accident, quand j’ai réalisé que mon pauvre cerveau n’était régulièrement plus au clair sur où j’en étais avec ma pris
Dernière nuit, dernier matin. Dernière injection d’insuline. Derniers médicaments du matin – je lui donne un Cerenia entier, parce que c’est le dernier de la boîte, et sait-on jamais, il sera peut-être un poil mieux qu’avec un demi. Et si c’est pas le cas, c’est pas comme si je devais garder la moitié pour demain.
J’ai sorti mon pilulier, celui que j’ai acheté après mon accident, quand j’ai réalisé que mon pauvre cerveau n’était régulièrement plus au clair sur où j’en étais avec ma prise de médicaments. Ça fait longtemps que je ne l’utilise plus. Mais là, tout comme hier à la Migros j’ai acheté ce que j’appelle de la “nourriture d’urgence”, je l’ai sorti, en me disant que peut-être cette prochaine semaine ce ne sera pas du luxe de ne pas avoir à me demander si j’ai bien pris mes médicaments ou pas.
Hier après-midi, après sa dernière crise, quand le Valium a commencé à faire effet, Oscar a fait un brin de toilette. Il a même passé la patte derrière l’oreille, quelque chose que je ne l’avais plus vu faire depuis au moins… un an? deux ans? plus?
Ce matin, après avoir mangé sa pâtée avec ses médics, il a léché son plastron un petit peu. Ça aussi, ça faisait longtemps. Quelques coups de langue.
Je suis contente qu’il semble “bien”. Contente pour lui. Mais c’est si dur pour moi. Il n’a pas l’air moins bien qu’il y a six mois, juste là sur le balcon, à s’étirer un coup après avoir observé le monde extérieur à travers la jungle de plantes accrochées à la balustrade. Après sa pancréatite de l’automne dernier, dont il s’est tiré de justesse, il a repris du poids.
Il est stable, là, si on fait abstraction de ce qui se trame dans son cerveau. Si on fait abstraction des moments où brutalement, il perd conscience, perd le contrôle de son corps, convulse, se fait dessus, crie parfois. Si on fait abstraction des minutes et parfois heures qui suivent où il est désorienté, agité, clairement incomfortable, anxieux ou irritable, pas sûr d’où il est, de ce qu’il veut, et peut-être même de qui il est.
Hormis les crises, il ne semble pas trop mal. Certes, la mobilité c’est vraiment compliqué. Trois pattes pour commencer, c’est déjà pas toujours évident. Mais je me souviens, quand il est arrivé ici, à l’automne 2019, juste avant la pandémie, avant mon opération au poignet. Il sautait sur la table. Ce sont les pattes arrières qui comptent pour ça, vous me direz, et vous aurez raison. Mais il sautait sur la table, il en descendait, il se débrouillait bien.
Cela faisait moins d’un an qu’il avait été amputé, et c’était déjà un chat vieillissant. Âge incertain, estimé à une quinzaine d’années. J’avais dit “nan, il a jamais quinze ans, plutôt dix”. Aujourd’hui, j’en sais rien. Cela fait des années qu’il a passé dans la catégorie “grands seniors”. Une chère amie qui connaît les chats mieux que personne m’avait dit “autour de 15 ans ils passent un cap, côté vieillissement”. Ou quelque chose comme ça. Il y a un moment où le vieux chat devient visiblement “très vieux”. Oscar a passé ce cap il y a longtemps.
La mobilité c’est compliqué, je disais. C’est pas juste le nombre de pattes. C’est l’arthrose qui déforme ses articulations, tellement que même moi je vois sur les radios que ça va pas. Il a toute une série de traitements pour la douleur, depuis des années. Elle est bien prise en charge – en tous cas je le crois.
La douleur, chez le chat, c’est un truc qui m’obsède. Parce que je sais qu’en tant que petit animal, même si c’est un chasseur redoutable, le chat a aussi des comportements de proie. Il cache sa douleur. Il ne la manifeste pas. Le chat n’est pas non plus un animal “social” au même titre que le chien ou l’humain. Il ne dépend pas des relations avec ses congénères pour sa survie. Cela colore la façon dont il apprend, entre en relation, et communique. Il ne se plaint pas. Quand il a mal, il fait moins, il bouge moins, il ne saute plus sur la table, il dort.
Quand on voit quelque chose, c’est qu’il a déjà très mal. Alors ça m’obsède: je ne veux pas que mes chats aient mal. Quand Tounsi est mort, je n’ai pas vu qu’il avait terriblement mal pendant une journée entière, alors même qu’il était paralysé par une thromboembolie aortique. Il ne criait pas, il semblait “normal” à mes yeux. C’est seulement quand j’ai mis l’oreille sur sa poitrine que j’ai entendu que sa respiration était un peu gémissante, et que j’ai pensé à en mesurer la fréquence, et que j’ai soudain compris qu’il souffrait.
Oscar se déplace avec difficulté, même les bons jours. Trois vieilles pattes frêles, déformées par l’arthrose, dont la musculature a fondu au fil des ans. Et par-dessus ça, des problèmes neurologiques qui rendent leur contrôle de plus en plus difficile. Il y a des chances que la source des difficultés avec ses pattes soit la même que celle des crises. On ne le saura jamais avec certitude, mais c’est probable. Les pattes ne font pas forcément ce qu’il veut. Elles vivent parfois leur propre vie. Se lever, c’est devenu de plus en plus compliqué pour lui. Ses gamelles sont surélevées. Se déplacer, faut que ça en vaille la peine.
Mais il ne lâche rien, il veut quand même. Il avance, il descend les deux étages d’escaliers qui mènent à l’eclau (que je ne m’avise pas de vouloir le porter), il monte sur le canapé, essaie même parfois d’en descendre direct sans utiliser ses petits escaliers, et est capable de piquer un sprint dans le jardin afin de pourchasser un autre chat, alors même qu’une minute avant il semblait ne plus réussir à tenir debout. Comme a dit une fois une de mes voisines, en le voyant foncer sur Juju: “heureusement qu’il n’a que trois pattes!”
Alors oui, Oscar est un très vieux chat et il a la vie qui va avec. Mobilité réduite, maladies chroniques et médicaments, visites chez le vétérinaire, beaucoup de siestes et surtout, ses petites habitudes. Différents moments de la journée, différents lieux de sieste. Le balcon, le salon, la chambre, et surtout, en bas sur le canapé, avec vue directe sur le jardin et Juju dans les parages.
Du temps d’Erica déjà, j’avais dû mettre une séparation à l’eclau. Oscar avait commencé à y descendre, et un jour j’ai réalisé qu’Erica venait de moins en moins dans la “partie bureau” de l’eclau. Petit à petit, Oscar était en train de le chasser. L’espace auquel Erica avait droit à l’eclau rétrécissait, rétrécissait encore, et on allait se retrouver dans la situation où Oscar ne le laissait même plus rentrer par la chatière. J’ai donc installé une séparation amovible, qu’Erica pouvait franchir s’il le souhaitait, mais pas Oscar – pour préserver un “safe space” intérieur pour Erica.
Après le décès d’Erica, Oscar a eu accès à l’ensemble de l’eclau, et il a très vite décrété que le meilleur spot c’était le perchoir devant la chatière. Il y passait de longues heures, même des journées entières. Le mari d’une amie avait bricolé auparavant pour moi une série de plate-formes au mur pour y faciliter l’accès, tant pour Erica qu’Oscar. C’est d’ailleurs en allant récupérer Oscar sur ce perchoir, un soir, que j’ai rencontré Juju.
La nuit, Oscar dort avec moi. Au creux de mon bras, comme le faisait Bagha. Je lui ai appris. Du vivant de Quintus, Oscar dormait au salon. Je les séparais quand j’étais absente ou que je dormais. Oscar, c’est le Roi. Quand le Roi arrive, on se pousse. C’est très clair, ça, chez lui. “Poussez-vous, le Roi arrive!” avait dit le vétérinaire comportementaliste que j’avais consulté suite a une altercation entre Oscar et Quintus dont le résultat avait été que Quintus n’osait plus aller au salon. A force de patience et de persévérance, j’avais pu raccommoder un peu la relation entre les deux, mais la surveillance était de mise.
Oscar le Roi: tout le monde fuit devant lui. Erica, Juju, les chats qu’il croise dans le jardin. Au chalet, une fois, il a croisé le matou qui régnait sur le quartier. Oscar n’a eu qu’à bomber le torse, se grandir un peu, regarder férocement son rival avec un grognement et celui-ci avait déjà déguerpi, avant même qu’Oscar ne se lance à sa poursuite, oubliant le temps de quelques mètres les trois pattes et l’arthrose ainsi que l’absence de dents. Il avait déguillé en bas du talus, dignité égarée dans les herbes montagnardes, mais l’autre n’en a jamais rien su, loin depuis longtemps.
Le Roi dort avec moi, au creux de mon bras, comme je lui ai appris. Après le décès de Quintus, Oscar a eu accès à ma chambre la nuit. Comme Tounsi avant lui, il avait choisi de s’installer contre mes jambes, ou même entre elles. Je ne sais pas vous, mais moi, je ne trouve pas ça super confortable, le chat qui coince les jambes pendant qu’on dort. Quintus, lui, dormait sur l’oreiller – il avait même le sien à la fin. Ça allait aussi bien. Mais entre les jambes, c’est bof. Donc petit à petit, je l’ai convaincu de tester le creux du bras. Et c’est comme ça qu’on s’endort chaque nuit depuis.
Dans les habitudes d’Oscar, qui persistent dans sa vie de petit vieux, il y a le massage d’oreille. Quand il est arrivé ici, Oscar faisait sa toilette. Certes, certaines régions étaient compliquées à atteindre avec une patte en moins, mais il faisait ce qu’il pouvait. Il toilettait d’ailleurs toujours soigneusement son plastron et la zone où manque la patte. Pour le museau, il faisait les deux côtés avec la patte qui restait. Mais l’oreille gauche… compliqué. Il a toujours aimé qu’on le caresse sur la zone d’amputation, et frotter son oreille dans la main. Il aimait aussi beaucoup venir frotter son museau contre les orteils qui trainaient.
Comme d’autres aspects de sa vie qui se sont rétrécis avec le temps, la toilette s’est réduite au point que maintenant, une “grande toilette” consiste à lécher la patte et la passer quelques fois sur le museau. Cela fait longtemps qu’il ne fait plus véritablement de toilette. Difficulté d’accès, difficultés de mobilité ensuite, maladies et vieillissement… Malgré l’absence de toilette, son poil n’est pas si catastrophique que ça. Il n’est pas magnifique, on s’entend. Mais là, couché à côté de moi à l’ombre du drap que j’ai suspendu pour le garder à l’ombre pendant que j’écris (au fil des paragraphes le soleil est sorti et avance dans le ciel), il n’a pas le poil d’un chat à l’article de la mort. Parce qu’il ne l’est pas, même s’il l’est, en fait.
Il y a eu des périodes où j’avais réussi à faire en sorte qu’il accepte d’être peigné. Ça n’a pas été simple, il a fallu de la patience, mais on y est quand même arrivé. Quelques coups de peigne, ici et là, au fil des jours, pour entretenir un peu le pelage et éviter les pire noeuds. Là, ça fait un moment que je ne le fais quasi plus, parce que ce n’est pas agréable pour lui, et qu’on est dans une perspective de temps de vie limité.
Quand il a eu sa pancréatite il y a maintenant plus de six mois, j’ai cru que c’était fini. J’ai aussi cru qu’il allait y rester en 2021, avec sa gingivostomatite. Il y a eu plein d’autres frayeurs, plus en toile de fond. Quand il a commencé à perdre du poids. Quand son diabète s’est déréglé. Quand l’insuffisance rénale s’est pointée et a commencé à évoluer. Mais on s’en est sortis à chaque fois.
Quand il est arrivé chez moi, son diabète était sous contrôle mais moyennement régulé. Il était vieux, il avait été malade peu avant, on le pensait plutôt sur la fin. Quelques semaines plus tard son diabète était parfaitement régulé, et au printemps 2020, après plusieurs fausses alertes, il est entré en rémission. Une année plus tard, les problèmes infectieux ont débarqué. D’abord une infection importante au nez, après le décès de Quintus, et six mois plus tard, la bouche, ce qui a résulté en une extraction totale de ses dents et une mise sous cortisone qui a nécessité une reprise de l’insuline. Je vous passe les détails, mais c’était une année vraiment difficile, j’ai cru le perdre plusieurs fois – jusqu’à ce qu’on se décide à passer à la cortisone. Il est resté dix-huit mois sous cortisone, et quand on a pu arrêter, il était “toujours” en rémission, dont il est sorti un peu moins d’un an plus tard, début 2024.
Je pense que personne n’aurait parié qu’il serait encore en train de chiller sur le balcon au printemps 2026. Mais à force qu’il surmonte tout ce que son corps mettait sur le chemin, on a presque fini par croire qu’il était immortel. “Il va tous nous enterrer,” avait dit une fois en riant sa vétérinaire.
Depuis novembre dernier toutefois, quand il a fait sa première crise convulsive, l’horizon s’est rétréci. Mais là aussi: en janvier, le vétérinaire neurologue disait prudemment “des mois, mais plutôt des semaines”. On est le 3 mai. C’est pas que je tienne à battre des records ou défier les pronostics. Et je sais que le chat est un animal coriace, qui peut revenir de très loin. Mais c’est mon vieux chat et je ne veux pas qu’il meure. Donc chaque bout en plus, c’est un bout en plus, même si c’est aussi douloureux de vivre au quotidien avec l’épée de Damoclès de la maladie incurable et de perspective de la décision à prendre, quand il sera temps.
On y est. Dans quelques heures. Oscar a quitté le balcon pour s’installer sur le lit. Un changement de lieu de sieste typique. Il commence à faire chaud, là dehors. Quand je regarde Oscar juste maintenant, à l’intérieur je crie non, je n’arrive pas à réconcilier l’animal vivant et “qui va”, qui respire, flaire mes doigts et s’y frotte, au poil doux et chaud sous ma main, avec sa mort à venir, prévue et nécessaire. Alors je repense à hier après-midi, sa dernière crise, au cri qu’il a poussé et qui m’a fait accourir, à sa confusion ensuite. Je pense à celle de la nuit de vendredi à samedi, à celle de jeudi matin, à celles qui ont précédé. Je sais que ça ne peut pas s’arranger. Je sais qu’il est temps.
Mais à l’intérieur mon coeur se débat et essaie de raconter qu’il y a peut-être encore de l’espoir, que c’est trop tôt aujourd’hui, qu’on pourrait attendre demain comme initialement prévu, qu’on pourrait peut-être attendre encore parce que qui sait, il y aura peut-être à nouveau une semaine ou dix jours ou deux semaines de répit, qu’il n’a pas fini de vivre, qu’on doit pouvoir faire quelque chose…
Mon coeur se débat parce que la fin de l’existence résiste à mon entendement d’être qui existe, parce que la mort qui délivre de la souffrance ça fait sens mais ici, la souffrance n’est pas sous mes yeux ou dans les yeux mouchetés de brun du vieux chat installé dans son panier, elle est dans le futur à la fois incertain et certain de la prochaine crise qui surviendra, et la suivante, et la suivante, jusqu’à celle qui ne s’arrêtera pas.
Alors je fais un compromis, je choisis pour Oscar une mort paisible et contrôlée, je choisis de ne pas repousser l’inévitable de quelques jours ou quelques heures parce que je sais que ce temps gagné serait au service de l’angoisse et de la peur, pas de la vie ni de l’amour. Ce temps serait une coquille vide.
Mais mon coeur n’est pas convaincu. La mort et la douleur lui font trop peur.
Pendant que j’écrivais ces dernières lignes, Oscar a commencé à s’agiter un peu. Il a quitté le lit pour le salon, il s’est levé, désorienté, recouché, relevé. Recouché, relevé. Retourné sur le lit.
Une part de moi espère presque que ce soit une crise qui se prépare, parce que ça rendrait les choses plus faciles, tout à l’heure. Mais évidemment qu’au fond je ne veux pas ça, parce que je préfère qu’on puisse passer ces dernières heures sereinement, déjà, et parce que je veux qu’il vive ce qui lui reste de vie le plus confortablement possible. Je suis sûre que vous comprenez ce genre de dissonance émotionnelle.
Ce soir, quand Oscar sera mort, je m’endormirai chez moi pour la première fois sans chat, à quelques exceptions près, depuis bientôt quinze ans. Je serai seule dans un appartement dont j’ai pensé l’aménagement pas juste pour moi, mais aussi pour mon vieux chat. Qui ne sera plus là. Il y a des escaliers pour chat avec des protections pour ne pas qu’il en tombe un peu partout. Il y a des paniers à chat un peu partout. Il y a des coussins et couvertures à côté du lit parce qu’il en est tombé une ou deux fois, ces derniers mois. Il y a dans la cuisine des étagères et tiroirs entièrement consacrés à sa nourriture, à ses médicaments. Il y a une litière aux WC et une gros conteneur pour les pellets. Il y a des gamelles, il y a même un tapis dans le couloir que j’ai mis pour lui, parce que le parquet a commencé à être trop glissant à un moment donné. Il y aura tout ça, mais il n’y aura plus de chat.
Oscar n’est pas mon premier chat, ni le premier chat que je vois mourir. Mais comme chacun des autres, il est unique. Il est une vie irremplaçable et précieuse, en particulier à mes yeux. Il est mon compagnon-témoin d’une tranche de vie, un lien affectif plus stable et long que beaucoup de relations humaines. Durant six ans et demi, il a été une constante dans ma vie. Pas le chat le plus câlin de la planète, pas le champion du ronron, mais un chat avec une très grande personnalité, un warrior, une histoire singulière dont une part restera toujours un mystère, et qui s’évaporera quand son coeur s’arrêtera de battre.
Ce soir, mon appartement sera vide. Il y a des années, j’ai une définition de ce qu’est “à la maison”, “home” en anglais. “Home is where the cat is.” Il me reste Juju, mais Juju ne vit pas ici. Il vit deux étages plus bas, et dehors dans tout le quartier, surtout la nuit. Un jour, il vivra aussi ici, mais ce n’est pas encore le cas. Il va me falloir du temps, comme il m’a fallu après Bagha, pour réapprivoiser ma vie sans chat. Sans chat chez moi, s’entend. Juju est mon chat – mais Juju vit sa vie, je peux partir trois jours, mes câlins lui manqueront bien sûr, mais il est autonome. Comme l’était Erica. Ce n’est pas le même genre de relation. Si j’ai de la chance, Juju aussi sera vieux un jour. Peut-être qu’il ne courra plus les rues du soir au matin et qu’il dormira quelque part sur mon lit. Très probablement, il me tiendra compagnie la journée quand je suis chez moi. Mais ça c’est l’avenir, pas immédiat.
Je n’ai prévu grand-chose pour “après”. Jusqu’ici, je n’ai pas été le genre de personne qui ressent le besoin de tout ranger les affaires du chat dès son décès. Mais qui sait, peut-être que cette fois ce sera différent. Ou pas. Je vais être prudente avec mon cerveau dans les jours qui viennent, parce que la charge émotionnelle est également cognitive, donc le risque d’en “faire trop” sans m’en rendre compte est très présent. Je vais regarder Grey’s Anatomy. Je vais passer câliner Juju. Je vais faire ce qui me semblera bon et utile, et ne pas faire ce qui ne m’aide pas. Je vais être indulgente avec moi-même. Je vais peut-être écrire encore.
La matinée a passé pendant que j’écrivais. Je vais publier cet article, manger quelque chose, donner à Oscar de la gabapentine pour qu’il soit relax et détendu le moment venu. Peut-être que je rajouterai des photos par la suite, ou pas. Merci à vous qui m’avez envoyé des gentils messages ou témoigné votre soutien d’une façon ou d’une autre. Je ne réponds pas toujours, mais sachez que ça me fait chaud au coeur.
[en]
So here we are, another cat blog post written through tears. Oscar had three seizures this last week. Sunday 2am, Thursday 7.30am, Saturday 2am. Before that, we had two weeks without seizures, following a small one on the 12th, a kind of aftershock from the one on the 7th, that signalled another clear “beginning to the end”. We’d increased medication a month and a half before that following breakthrough seizures, and although the side-effects were important enough that they prompted us to
So here we are, another cat blog post written through tears. Oscar had three seizures this last week. Sunday 2am, Thursday 7.30am, Saturday 2am. Before that, we had two weeks without seizures, following a small one on the 12th, a kind of aftershock from the one on the 7th, that signalled another clear “beginning to the end”. We’d increased medication a month and a half before that following breakthrough seizures, and although the side-effects were important enough that they prompted us to decide we wouldn’t increase medication any further and make end-of-care plans, it did mean we got all that extra time, seizure-free.
But this is the end. The seizures are not going to stop or “get better”. We don’t know precisely what’s causing them but given his age and their presentation, it’s likely it’s a brain tumour, or some other brain lesion. He’s a very old man. We don’t know how old he is, because he’s a rescue, but it’s quite clear he’s very old. Eighteen, 19, 20? Even if it’s “just 17”, that’s already very old. He has old eyes, a string of old cat illnesses. He’s been through a lot and I know I’ve taken very good care of him.
If it weren’t for the seizures, he’d continue living his old man life: lots of napping, some ear-rubs, a stroll in the garden every now and again, telling Juju he’s the boss (as well as other cats if he spots them on a garden-walk), and keeping up with his little habits: this bed in the morning, that bed in the afternoon, take a little sun on the balcony, go down to the coworking space, meds 4 times a day, a rotation of wet food, trips to the litter-box, and sleeping in the crook of my arm at night.
But there are the seizures, and it’s not fair to him at this frequency. The one he had two days ago lasted a good three minutes, I got it on the surveillance camera. I don’t know about the two others, but the previous big ones were a minute. Three minutes is a long time for a grand mal seizure. He loses consciousness, he pees himself, he seizes, and then he’s out of it for hours – disoriented, uncomfortable. Then he’s OK again, like now, napping on the balcony. But that’s a lot of discomfort and hours of being unwell on top of a base quality of life that, even if it’s still acceptable, is clearly diminished. And the seizures will get worse. The more you seize, the worse it gets. The seizures breaking through the medication and increasing in intensity and frequency also indicate the underlying issue is progressing. Some of you may be wondering: no, brain surgery isn’t an option for an old cat like him, he wouldn’t survive it, and even if he did, he wouldn’t manage to recover. Even putting him under general anesthesia for an MRI is not an option.
This is the end, my friend.
When Quintus died, he was much more diminished than Oscar is. Quintus was fading away. Oscar is fighting every inch of the way. He has three legs, arthritis, and neurological issues in addition to the meds that make him wobbly. But he still wants. Wants to go out, wants to hit Juju, wants to go downstairs, wants this, wants that. He is still going ahead.
I find it really hard to be putting a cat to sleep who still has so much fight and apparent will to live in him. Of course, one mustn’t anthropomorphise. Living beings keep on going as long as they’re not suffering so much that they just want the suffering to go away. Oscar doesn’t care about his life the way I do. He doesn’t know about death, he doesn’t make plans for tomorrow or next month. He doesn’t wonder if his life is worth living or not. He just is.
It’s different for me. Since Quintus had his first pancreatitis in 2016, I’ve been living with cat death hanging over me. Tounsi and Erica died rather unexpectedly. But Quintus was already becoming old back then. We weren’t sure he’d make it. He did. In 2017 he became ill with diabetes, and it seemed like that would be it. He recovered, but from then on it was pretty clear we were living on borrowed time. Each year, I’d hope he’d make it to his next birthday, without daring to count on it. He slowly declined, year after year. Oscar joined us in 2019, already old and diabetic. Quintus died in 2020, and I almost lost Oscar in 2021. Borrowed time for him too since then. Of course, through all that borrowed time, there were stable periods – both for Quintus and Oscar. But you know it’s just a reprieve.
Caring for old sick cats also means daily medications, vet visits, and elderly-proofing the home. So much in my flat is “designed for Oscar”. There are kitty-stairs everywhere. Two feeding stations. The huge litter-box. The beddings. And since the seizures started in November, rectangular absorbent pads under each of them. When you need to give injections 12 hours apart, or anti-seizure medication 8 hours apart, that constrains your personal schedule. Being absent requires either making concessions with the treatment (which I have done at times for the insulin injections when he was doing well) or finding people to take over (which I’ve also done regularly). Then there’s the fact that having an old pet who might die pretty much any time kind of dampens the desire to be away.
Once Oscar is gone, which might be today, or sometime in the next few days, most probably, a whole lot of “stable” things my life revolves around will be gone too. No more medication schedules. Put away the kitty stairs and beddings and the feeding stations and the litter box. Sure, Juju will be coming to the flat in time (he doesn’t right now), but he won’t need all this. A bowl of water, a blanket or a small bed somewhere, but maybe even not that — he tends to prefer sleeping rough. His death will not just break my heart, as all deaths do, it will also break my living environment and my daily routines.
Then there are the vets. Oscar has had regular vet visits for years now – every four weeks, then every three weeks. His veterinary osteopath also comes by every month — she used to come for Quintus already back in the day. Juju might need some more osteo sessions, but he definitely won’t be going to the vet much. Travel is a major source of stress for him, and I have another vet who does home visits come for him. So here are two people, whom I really like and have been seing regularly for years, who will drop out of my life when Oscar dies. I won’t just be losing him, but them too. So, sure, you can drop in at the vet practice once in a while with a cake or some cookies, but it’s not like you can sit and have a cup of tea with your ex-vet every couple of months. I get it. It’s a professional relationship. But it’s a human relationship too, and I’m really sad about that too.
There will be relief of course, and freedom. But a lot of loss.
When I look at Oscar right now sleeping next to me on the pillow like he often does, it feels unreal. Life is perfectly normal in this instant, and it’s going to be upended, and I don’t yet know when, but I’m going to be making that decision soon with the vet. It feels like the moment before you tell somebody you’re breaking up with them, when they didn’t see it coming. It feels like being on the 10-metre platform and having to decide when to jump.
Edit: his vet called back. She’ll be coming Monday 5pm. I’m so grateful she can come for this – and so devastated too. Edit again, 17:15: I don’t think we’ll last till Monday. He had another seizure a couple of hours ago. Am in contact with vet to see how we manage things. Edit after vet call: organising it for tomorrow afternoon, 2-3pm or so.
I’m going to miss him. I feel so sad. I wish there was a way around this. But there isn’t. We all die. Everybody dies. Our pets die before we do, pretty much every time. Some part of me wishes he looked more like he was dying – but on the other hand, I don’t wish him to feel crummier than necessary for whatever time he has left. It’s clearly better for him this way, even if it’s harder for me.
As I finish writing this, he’s coming to rub his face on the corner of my screen, before heading down his kitty stairs to grab a bite – and then get on with his old-cat-day.
tl;dr: Read "Social Media Is Now Parasocial Media"The lovely folks at the Social Media + Society journal asked me to contribute to their anniversary issue by reflecting on the trajectory of social media. Ooof. Snark exuded from my pores as I tried to figure out what I might say. But then I thought about how my students don't know about an era of social media without recommended content, algorithmically curated feeds, and an infinite scroll of cotton candy content. They never encountered a world
The lovely folks at the Social Media + Society journal asked me to contribute to their anniversary issue by reflecting on the trajectory of social media. Ooof. Snark exuded from my pores as I tried to figure out what I might say. But then I thought about how my students don't know about an era of social media without recommended content, algorithmically curated feeds, and an infinite scroll of cotton candy content. They never encountered a world of social media where people were focused on sharing with their friends rather than becoming influencers. They don't realize how much the "social" in social media has changed.
As I tried to unpack in my mind what social media has become, I kept coming back to how the dominant practice has shifted to consumption rather than production. Media scholars have always argued that consuming TV is social even if you watch alone because of the power of using TV content in social settings, like the water cooler. I don't want to negate this collective experience to TV, although the content we consume online is so fragmented that there is no unifying consumption pattern despite there being meaningful networked-based consumption practices. But still, there's something tangibly different about the social-ness of consuming to discuss vs. consuming in a dialogic engagement.
In putting pen-to-paper, I kept coming back to how odd the term "social media" now feels to me. And of course I'm biased because I lived through the contestations over how to label the various websites that we've come to know as social media. So I had a very particular understanding of the term, one that no longer exists.
"Social Media Is Now Parasocial Media" is my attempt to reckon with the evolution of social media into a format that I feel is no longer meaningfully social. It's open-access so check it out. And if you have feels, push back! I'd love to hear your thoughts!!!
Parcoursup est l’outil dont rêvait l’institution disciplinaire décrite par Foucault. Fondamentalement. Et chaque année davantage depuis déjà 8 ans que cette saloperie existe. Je vous ai déjà à de nombreuses reprises expliqué tout le mal que je pensais de cette plateforme (en 2020, en 2021, en 2025, en 2026 …) que j’ai vécu et expérimenté personnellement à trois reprises en tant que parent de 3 enfants et que je pratique également donc depuis 8 ans en tant que responsable de formation.
Presque ch
Parcoursup est l’outil dont rêvait l’institution disciplinaire décrite par Foucault. Fondamentalement. Et chaque année davantage depuis déjà 8 ans que cette saloperie existe. Je vous ai déjà à de nombreuses reprises expliqué tout le mal que je pensais de cette plateforme (en 2020, en 2021, en 2025, en 2026 …) que j’ai vécu et expérimenté personnellement à trois reprises en tant que parent de 3 enfants et que je pratique également donc depuis 8 ans en tant que responsable de formation.
Presque chaque année c’est une nouvelle contrainte imbécile qui tombe ou s’impose dans cette plateforme sans que jamais il ne soit possible de la discuter ou de la remettre en cause. Et cette année j’avoue que lorsque j’ai appris qu’à terme les lettres de motivation allaient totalement disparaître et que si on voulait les garder c’était à chaque responsable de formation de fournir un argumentaire pour se justifier, j’ai vraiment eu envie de coller une grande soupe de phalange dans le cimetière à magret de mon ami Mister T. Mais j’étais très loin du climax de mon courroux (coucou) car je n’avais pas encore reçu le message ci-dessous.
Donc il y a quelques jours, alors que sur les 1600 dossiers que nous recevons pour 60 places je venais de finir de traiter les 200 qui me reviennent, j’ai eu la surprise de recevoir un petit mail de Parcoursup qui disait ceci :
Je vous remets le texte directement :
Dans la perspective de la rentrée 2026-2027, le dispositif de demande de césure prévu sur Parcoursup a évolué pour tenir compte de la mise en place du nouveau Service national annoncé par le président de la République.
Pour les candidats, la case à cocher « demande de césure » a été remplacée par deux cases distinctes « demande de césure pour réaliser un projet personnel ou professionnel » et « demande de césure pour réaliser un service national ». En effet, la césure pour service national sera une césure accordée de plein droit (projet de loi de programmation militaire) à la différence de la césure pour réaliser un projet personnel ou professionnel qui est soumise à l’appréciation du chef d’établissement.
J’espère que tout cela est clair. Après la mise sous coupe algorithmique réglée de l’ensemble d’une classe d’âge, après l’empilement de réformes toutes plus débiles les unes que les autres à l’échelle du lycée et du baccalauréat, après la mise à sac programmatique de l’université publique, après les refus répétés en mode allegro obstinato de tenir compte de l’ensemble des retours des utilisateurs de cette p**** de plateforme qui chaque année expliquent que tout cela irait beaucoup plus vite et serait beaucoup moins stressant pour les lycéens et lycéennes s’ils et elles pouvaient classer leurs voeux dès le départ, voilà donc maintenant que Parcoursup se met au service d’un agenda politique national guerrier. Et voici Emmanuel Macron, le plutôt cadre ploutocrate enquillant son 2ème mandat à l’abri de toute mandale, qui d’une main nous incite à la chair du « réarmement démographique » et de l’autre anticipe le sort funeste de cette même chair.
Cette année on nous annonce donc que les demandes de césure pour faire son service militaire doivent être obligatoirement accordées. Et on nous l’annonce en plein milieu de la procédure et sans aucune concertation parce qu’il s’agit bien sûr aussi de nous discipliner.
Vu la situation et le contexte international, je ne suis pas le seul à nourrir d’immenses craintes pour ce que Parcoursup deviendra l’année prochaine et les suivantes. L’institution disciplinaire doit être vue, lue et comprise comme un continuum. Je rappelle que certains avaient déjà envisagé que celles et ceux qui avaient effectué le débilitant SNU puissent bénéficier de points supplémentaires dans Parcoursup. Une énième idée à la con qui avait heureusement été promptement identifiée comme telle mais qui avait aussi et surtout permis de préparer les esprits à ce qui adviendra inévitablement à l’horizon de quelques années.
Sans parler de la guerre, on observe cette année une augmentation très forte (et qui me semble inquiétante) de dossiers qui nous reviennent après avoir effectué une première année (en vérité quelques mois) dans une toute autre formation, preuve supplémentaire que la première orientation et la première expérience de la plateforme Parcoursup sont de plus en plus à côté de la plaque. Entendons-nous bien, on a bien sûr le droit de se réorienter et rien n’est dramatique, loin s’en faut, lorsque l’on est néo-bachelier. Ce qui est par contre inquiétant ce sont les choix qui semblent effectués en dépit de tout bon sens de la part de lycéens et lycéennes et de familles totalement égarés dans une offre surabondante et opaque, livrés au mieux à eux-mêmes et à la bonne volonté de professeurs principaux qui sont beaucoup de choses mais certainement pas des conseillers d’orientation ; lycéens, lycéennes et leurs familles qui sont surtout soumis, dès la fin du collège et durant toutes leurs années lycées, à une pression totalement inédite au regard des contraintes que l’on fait peser sur elles et eux.
Disciplinés très tôt par l’empilement de réformes aux temporalités imbéciles et sans aucune cohérence pédagogique ne serait-ce qu’interne, réformes totalement étanches aux rythmes de travail et de vie de nos sociétés et aux assignations parentales qui en découlent, ce ne sont pas les quelques ajustements cosmétiques annuels de l’interface Parcoursup qui permettront de régler le problème d’une plateforme qui semble n’avoir jamais été pensée ou même réfléchie pour accompagner des trajectoires mais qui donne hélas sa pleine mesure dès lors qu’il s’agit de sanctionner des parcours.
[en]
Même si je ne suis pas en train de vibe-coder à tour de bras, j’ai bien sauté dans le train côté IA. Depuis deux ans environ, je dis que ce que je ressens concernant l’importance et le potentiel de l’IA générative est quelque chose que je n’ai pas senti depuis ma découverte d’internet il y a 20-25 ans.
Et là mes amis, j’ai l’impression de m’être pris un train en pleine figure. Enfin, je le vois arriver depuis un moment, le train, mais là il est sur moi. Mon vieux pote Jens-Christian vie
Même si je ne suis pas en train de vibe-coder à tour de bras, j’ai bien sauté dans le train côté IA. Depuis deux ans environ, je dis que ce que je ressens concernant l’importance et le potentiel de l’IA générative est quelque chose que je n’ai pas senti depuis ma découverte d’internet il y a 20-25 ans.
Et là mes amis, j’ai l’impression de m’être pris un train en pleine figure. Enfin, je le vois arriver depuis un moment, le train, mais là il est sur moi. Mon vieux pote Jens-Christian vient de me montrer, en live (bon, par visio) à quoi ressemblait son assistant IA et l’infrastructure (PAI) qui le rendait possible. Je vais vous expliquer tout ça en français, ne vous en faites pas, mais sachez déjà qu’en gros, le fameux “assistant IA” qui est véritablement capable de nous aider à organiser nos vacances, choisir un menu pour ce soir, nous briefer pour préparer notre journée, garder le fil de nos multiples projets et évidemment, automatiser notre administratif récurrent, sans juste faire semblant qu’il en est capable – eh bien on y est.
OK. Maintenant j’explique pourquoi je suis en train de vous dire que l’ordinateur de Star Trek, c’est déjà aujourd’hui. Enfin avant, un petite digression préalable.
On le sait bien: ce qu’on appelle aujourd’hui “une IA”, c’est en fait un “LLM” (Large Language Model). C’est une intelligence artificielle (un type de programme) qui produit des mots. En très simplifié, c’est du texte prédictif dopé. Le LLM, il ne fait qu’une chose, à la base: il regarde le “contexte” (le texte déjà écrit) et fait une prédiction statistique sur le prochain mot. Et le prochain. Et le prochain. L’IA (le LLM) ne “sait” rien. C’est juste une machine à aligner des mots. Mais ce qui est dingue, c’est que cette machine est capable de produire du texte que l’on reconnaît comme “discours”, et qui nous donne le sentiment d’être en train de parler à une vraie personne. C’est le côté “chatbot” ou “interface conversationnelle”. Ça veut dire que pour faire faire des choses à une machine, aujourd’hui, on peut simplement lui expliquer avec nos mots – pas besoin de cliquer sur tel bouton, donner telle commande, utiliser un langage de programmation. On dit quelque chose, et quelque chose se passe.
Si vous avez déjà l’habitude de fréquenter Claude ou ChatGPT, vous savez comme ça va. On chatte avec, et on est tour à tour bluffé (quand ça marche) et désespéré (quand ça marche pas). On se casse vite le nez sur les limites du truc, il nous dit un truc qui est faux, et on se dit qu’il est bien con et que l’IA, ça ne marche pas si bien que ça. On pense aux rêves qu’on avait de pouvoir dire à notre IA “fais ma déclaration d’impôts” ou “planifie mon projet” (pourquoi pas “fais mon job”, pendant qu’on y est), ou plus modestement, “envoie les factures vétérinaires à l’assurance pour qu’ils remboursent”. L’IA nous promet monts et merveilles mais ne livre pas toujours – d’autant plus si on se contente de lui parler dans une conversation qui s’allonge à l’infini, qu’on ne comprend comment travailler avec la fenêtre de contexte, que les skills ça nous dépasse, qu’on ne maîtrise pas les subtilités du prompting et qu’on n’a pas encore fait le pas d’organiser nos interactions en projets ou d’essayer Cowork. On entend bien ceux qui développent des trucs incroyables à l’aide de l’IA, mais bon, on n’est pas tous développeurs, et franchement les résultats médiocres qu’on obtient nous laissent penser que c’est beaucoup de hype, toute cette histoire. On est d’accord?
Et là au milieu, je suis en train de vous dire (je vous promets j’ai pas fumé) qu’en fait oui, l’IA est bien capable de nous offrir cet “assistant digital” dont on rêve. Je crois franchement qu’on y est. Mais c’est pas “en chattant avec Claude”. Et il n’y a pas besoin non plus d’apprendre à programmer pour y arriver.
La clé, c’est cette infrastructure mentionnée en début d’article: PAI. C’est pas une “alternative” à Claude ou ChatGPT ou Gemini. C’est un système qui se construit dessus. Une collection d’instructions pour IA et de scripts (comme des mini-programmes) qui vont tourner sur l’ordinateur.
Comme dit plus haut, une IA ne “sait” rien. On peut lui donner une liste de tâches en début de conversation, en rajouter 3 nouvelles, parler de la pluie et du beau temps, et lui redemander les tâches 10 minutes plus tard, et il y a fort à parier qu’il y aura une erreur dans la liste. Qu’elle reconnaîtra de bonne grâce quand on la lui fera remarquer. Par contre, si au début de la conversation on lui demande de créer un fichier contenant cette liste, et que deux jours plus tard on lui demande nous lire la liste qui est sur le fichier, là, ça marche. Suivant quelle est votre expérience dans l’utilisation de l’IA, vous avez peut-être fait ce constat de vous-même: c’est vachement plus fiable de faire mettre des infos dans des fichiers, de faire écrire des scripts pour extraire de l’information d’un document ou d’un tableau de données. Et d’ailleurs, aujourd’hui, votre “Claude chatbot” le fera spontanément ou vous le proposera, suivant ce que vous lui demandez.
Donc: l’assistant IA de nos rêves, c’est pas “juste” une IA, c’est surtout des tas de scripts et des fichiers contenant des informations. Et bien sûr quand même une IA, pour interagir avec nous (la fameuse “interface conversationnelle”) et faire évoluer le système en fonction de nos besoins.
Vous êtes encore là? Soyons un peu concrets. PAI c’est donc un truc qu’on télécharge sur son ordi et qui une fois lancé, va premièrement installer ce dont il a besoin (y compris Claude Code si on ne l’a pas déjà). Ensuite, quand on le lance, il va nous prendre par la main (via l’interface conversationnelle, donc en discutant déjà avec l’IA) pour le configurer et démarrer avec. Oui, il faut taper un truc dans la ligne de commande, il y a un premier pas ou deux un peu geek, mais après, c’est “juste du blabla” comme on a l’habitude de faire normalement avec une IA.
Ce qui fait que PAI c’est pas “juste une IA”, c’est que c’est un système prévu pour créer ce dont vous avez besoin de votre assistant. On ne vous livre pas une voiture: on met à votre disposition tout ce qu’il faut pour concevoir et produire la voiture qui correspond exactement à vos besoins – les ingénieurs, les designers, les mécanos, l’usine de production, et aussi le chef de projet qui va vous prendre par la main pour vous aider à décrire la voiture dont vous avez besoin. PAI c’est ça.
L’infrastructure comprend un système et une structure pour stocker des infos de contexte vous concernant – pas juste la façon dont vous aimez que l’IA vous parle, mais aussi vos valeurs, vos domaines d’expertise, vos préoccupations et buts dans la vie. Et pas sous forme de laborieux champs texte à remplir. L’IA va vous interviewer, ou dans mon cas, avaler mon blog, et en tirer les informations pertinentes. Ou pas, si on veut pas. L’infrastructure comprend aussi des processus: en particulier, comment développer un système dont vous avez besoin.
Un exemple en guise de démo (on a fait ça en direct avec Jens-Christian et son assistant pendant notre visio): un truc dont je rêve, perso, ce serait un système qui est au courant de ce que j’ai dans mon frigo et mes armoires, de ce que j’aime manger et cuisiner, et qui puisse me dire “ah ben ce soir, tu pourrais te faire ceci ou cela”. Pour de vrai, c’est une grosse charge mentale chez moi ce genre de truc. Donc hop, on soumet cette idée à l’assistant. J’ai deux ou trois idées en plus: si je donne à l’assistant mes tickets de caisse de courses, il pourrait savoir ce que j’ai acheté comme nourriture. Et si je lui montre ce que je mange ou me cuisine, il pourrait en déduire ce que j’ai utilisé. Peut-être de temps en temps il faut lui faire une photo du frigo ou de l’armoire pour vérifier si son inventaire est à jour. Et il pourrait aussi avoir à dispo une collection de recettes que j’ai faites, et d’idées-repas (j’ai commencé à compiler ça, manuellement). On donne donc ces infos à l’assistant, et on observe. Honnêtement, c’est là que je me suis retrouvée sur le cul.
PAI comprend donc un processus, ou une méthode, pour approcher ce genre de demande: clarifier à quoi ressemblerait le système fini, puis, selon une logique similaire au “rétro-planning” (du reverse-engineering, en fait) il produit un concept, les différentes parties du système à créer, évalue de quelle façon les créer (scripts, IA, quels outils sont à disposition, parce que bien sûr il sait quels outils on a sur l’ordi et ce qu’on a l’habitude d’utiliser), à quoi ressemblerait une version minimale fonctionnelle du système (le “MVP”=minimum viable product du jargon dev/business), et (après feu vert bien entendu) produit un prototype. En dix minutes, on avait un prototype interactif à qui je pouvais demander quoi manger ce soir, après avoir rempli une liste bidon de ce qui était dans mon frigo – et surtout, un plan pour développer le reste du système.
Avant aujourd’hui, j’avais prévu d’écrire un article sur ce que j’étais en train de faire avec l’IA en ce moment. Je me suis mise à Cowork, et je suis en train de créer un système qui m’aide à garder le fil de mes multiples projets en cours. Pas juste à savoir où j’en étais et quelle était la prochaine chose à faire quand je reprends un dossier trois semaines après l’avoir laissé en plan, mais aussi à avoir une vue d’ensemble du “portfolio de projets”. Dans mon système, il y a un fichier dans lequel je note les unes derrières les autres toutes les idées qui me passent par la tête, et ensuite il y a un script (et un peu d’IA) qui avale ce fichier et qui dispatche chaque idée ou info dans une sorte de boîte de réception pour le projet en question.
Exemple (parce que c’est mieux les exemples). J’ai trois tonnes de fichiers d’archives pas mal en bordel sur deux disques durs externes. Ça prend beaucoup de place, et je sais qu’il y a du contenu dupliqué, mais pas où et lequel. Je suis donc en train d’utiliser Claude pour m’aider à faire ça de façon méthodique. Donc ça c’est un de mes projets avec Claude. Mettons que pendant qu’on est en train d’avancer dans ce projet, je me retrouve dans le dossier qui contient les sauvegardes des vidéos live que j’ai faites sur Facebook. Il y a celles des chats diabétiques, mais aussi des vidéos sur d’autres sujets et dont je voudrais faire un article dans le blog. Comme je suis en grande conversation avec Claude, je mentionne ça, et peut-être que j’évoque les 3-4 articles que j’ai en tête, pour qu’il en prenne note. Il va noter ça (parce que je lui ai donné des instructions dans ce sens à l’aide d’un skill) dans le fichier “de sortie” du projet, prêt à être importé dans le fichier d’entrée du projet “idées pour le blog”. Ou alors, je suis en train de faire à manger et une idée de génie pour l’aménagement de mon balcon me traverse le cerveau: je la note rapidement dans mon fichier central, sachant que Claude rangera cette info au bon endroit.
Donc créer ce genre de système, avec Cowork, c’est possible, mais je fais beaucoup manuellement. Je micro-manage beaucoup. Je dois être directive, parce que sinon Claude me dit “ouais ouais c’est bon je m’en charge, c’est super simple” et en fait… non.
Avec PAI, il y a déjà des instructions et des “compétences” (skills) dans l’infrastructure exprès pour que créer ce genre de système se fasse bien et simplement. C’est donc une boîte à outils, accessible via le chat, qui nous permet de “forger” le système dont nous avons besoin – créer l’assistant qui va simplifier les tâches à peu de valeur ajoutée de notre quotidien, ou celles qui sont difficiles pour nous, qui va nous permettre d’avoir plus d’énergie à disposition pour les choses qui comptent pour nous.
Je vais gentiment prendre congé de vous pour aujourd’hui, parce que ça devient un article-fleuve (qui plus est pas super bien structuré et clair peut-être) et que mon cerveau n’a plus beaucoup de batterie. On va en reparler quand je sauterai le pas (dès que j’ai un peu de temps à dispo) pour installer PAI chez moi.
Juste deux mots de prudence avant de clore:
Claude Code, Cowork, PAI: des outils puissants mais qui présentent également des risques côté sécurité. Ce n’est pas une bonne idée, aujourd’hui, de laisser votre IA contrôler votre navigateur web, de lui donner libre accès à vos fichiers ou à votre e-mail, surtout si vous ne comprenez pas bien les enjeux sécuritaires
faire tourner quelque chose comme PAI “coûte” en termes d’utilisation d’IA – tout comme ça coûte de faire produire des images par l’IA, des pages de code, de manipuler des fichiers sur un disque dur, de lire des PDFs de 500 pages… sur un plan gratuit, oubliez; même un plan à 20.-, c’est probablement bien chaud
Quelques liens (en vrac parce que je suis trop raide):
La décision du chef du Parti québécois d’accorder une entrevue à une spécialiste de la désinformation a été abondamment commentée. Le contenu de l’entrevue l’a été beaucoup moins. Je me suis donc donné le mandat d’analyser l’entrevue et de démonter la désinformation qu’on y entend, autant de l’intervieweuse que de l’interviewé.
Je vous invite à écouter l’épisode spécial de mon balado, Woke tant qu’il faudra, consacré à cette entrevue. Si vous n’avez pas une heure à consacrer à cette entre
La décision du chef du Parti québécois d’accorder une entrevue à une spécialiste de la désinformation a été abondamment commentée. Le contenu de l’entrevue l’a été beaucoup moins. Je me suis donc donné le mandat d’analyser l’entrevue et de démonter la désinformation qu’on y entend, autant de l’intervieweuse que de l’interviewé.
Je vous invite à écouter l’épisode spécial de mon balado, Woke tant qu’il faudra, consacré à cette entrevue. Si vous n’avez pas une heure à consacrer à cette entrevue, ce qui est compréhensible, voici quelques-uns des pires extraits et mon commentaire.
Les extraits cités viennent tous de l’entrevue mise en ligne le 10 avril 2026.
« Début des années 2000 à Montréal, il y a pas une crise du logement, le français recule pas, ça se passe bien, tout le monde est de bonne humeur. » Au mieux, PSPP parle sans savoir. Au pire, il nous ment carrément. On peut le prouver facilement. En 2002, Pierre Desrochers, directeur de la recherche à l’Institut économique de Montréal, publiait déjà un rapport intitulé « Comment résoudre la crise du logement au Québec? » Parce que oui, on parlait déjà de crise du logement à l’époque du gouvernement Bouchard-Landry. Desrochers critiquait le manque de vision des gouvernements (fédéral et provincial), qui auraient dû investir davantage dans le logement social et modifier la réglementation du secteur de la construction afin de faciliter les mises en chantier. En 2002. Quand Plamondon nous dit qu’au début des années 2000, il n’y avait pas de crise du logement, c’est entièrement faux.
Je sais que mes amis péespépistes vont tenter de le rattraper et m’accuser de déformer ses propos. « Ce n’est pas ce qu’il voulait dire. Il voulait simplement dire que la situation était moins pire en 2001… » Non. En 2001, le taux d’inoccupation des logements était de 0.6% à Montréal. D’après la Société canadienne d’hypothèques et de logement, (SCHL) le taux d’inoccupation sur l’île de Montréal était de 3.1% en octobre 2025. Cinq fois supérieur. Il y a des limites à dire n’importe quoi pour nous faire croire que tous nos problèmes ont été causés par les politiques d’immigration du gouvernement Trudeau.
« Simplement aborder Roxham, à l’origine, je me faisais traiter d’extrême droite. Alors que quand le Parti libéral du Canada a fermé Roxham, ça c’était drôle, plus personne parlait d’extrême droite, c’était ben normal, aucune critique. Mais quand c’est le Parti québécois qui tente d’affirmer cette volonté de maintenir la paix sociale au nom des Québécois. Double standard. » PSPP avait fait la même plainte à l’époque. Il avait convoqué un point de presse pour se plaindre de la « gauche radicale » qui tente d' »extrême-droitiser » le Parti québécois. Les journalistes ont tenté en vain d’obtenir des noms. Il leur a répondu de faire leur travail de journaliste. Que c’est très facile de trouver des noms en cherchant sur Google. 3 ans plus tard, il nous fait jouer la même cassette et espère que ses auditeurs le croiront sur parole.
« C’est dangereux ce qui se passe en ce moment. Parce que des dynamiques violentes à l’étranger peuvent rapidement devenir notre dynamique parce qu’on a saboté un modèle qui fonctionnait au niveau de l’immigration qui était fondé sur des critères, une marche à suivre. Il arrive un moment où rien ne va plus. Rien ne tient. Et on se retrouve avec une situation inimaginable où des Québécois de confession juive ou peut-être d’autres Québécois aussi voient leur sécurité menacée. On n’a pas parlé de la sécurité des femmes par exemple. ais tsé Montréal, là… depuis… j’ai grandi là, il y a pas ville plus sécuritaire, si t’es une femme, tu te demandes pas si tu vas te faire harceler. » Bien sûr. Avant Justin Trudeau, les femmes pouvaient marcher seules dans la rue, la nuit, en toute sécurité. Elles pouvaient passer une veillée dans leur bar sans surveiller leur verre. Elles ne subissaient pas d’agression dans le métro. C’est « l’immigration massive » qui a amené le harcèlement sexuel au Québec.
Pour ce qui est des relations avec les États-Unis, PSPP reste dans le déni. « Mais en même temps à l’inverse, je vois des politiciens suggérer que le Canada nous défend contre Trump… C’est pas sérieux. Si les États-Unis prennent des décisions… Ce qui arrivera pas, en passant. L’idée que l’armée canadienne est un rempart de défense pour les Québécois ça a été complètement galvaudé. Moi je suis confiant que comme n’importe quel pays européen de notre taille, on ferait la même chose. » Ce qui arrivera pas, en passant? Sur quoi se base cette certitude? Est-ce qu’on suppose que Donald Trump a trop de bon sens pour attaquer le Québec ou le Canada? L’attaque contre l’Iran n’était pas suffisante pour convaincre que le fasciste américain fait n’importe quoi?
« Mais tsé c’est parce que le Canada en ce moment est identifié par ses voisins comme l’endroit où il y a le plus d’infiltration politique dans le monde. L’ingérence étrangère au Canada c’est devenu la norme. » « Les voisins » du Canada, ce sont les États-Unis. Le Canada n’a pas d’autre voisin. Peut-être certaines personnes croient-elles encore qu’on peut se fier au jugement du fasciste de la Maison blanche, mais généralement on reconnaît que ce n’est pas une référence en matière de politique internationale.
Alexa Lavoie demande à PSPP si le Québec devrait imiter l’Alberta, qui se prépare à mettre en place des lois pour protéger les écoles contre les « idéologies ». J’en ai discuté plus tôt cette semaine. Officiellement, le Bill 25 vise à sortir les « idéologies » et la politique des écoles albertaines. Officieusement, le gouvernement s’attaque principalement à la diversité de genre et sexuelle. Le gouvernement albertain de Danielle Smith a déjà limité l’accès aux livres pour enfants qui traitent d’enjeux LGBTQ+ parce que des associations de parents considèrent que c’est de la pornographie. Plusieurs villes albertaines ont interdit d’afficher le drapeau de la fierté dans l’espace public. Avec le Bill 25, le gouvernement va notamment interdire aux enseignants de discuter en classe d’identité de genre.
Sans hésitation, PSPP dit à la « journaliste » de Rebel News que les Albertains ont raison. Il considère que le gouvernement du Québec a également perdu le contrôle de ce qui s’enseigne dans nos écoles. On se souvient qu’il avait accusé la « gauche radicale » d’avoir infiltré les écoles à l’automne 2023, lorsqu’une enseignante avait demandé à ses élèves de l’appeler « Mx » plutôt que madame et qu’une école avait mis en place des toilettes non genrées. À l’automne 2024, la députée de Terrebonne, Catherine Gentilcore, alors présidente du Parti québécois avait accusé le nouveau programme de Culture et citoyenneté québécoise d’enseigner aux enfants de 3 à 7 ans que le genre est attribué par la société. Une accusation qui a été démentie par la suite.
PSPP mentionne quelques-unes des « dérives » dans les écoles québécoises: « Des groupes d’activistes de tout acabit. T’as eu des cas de soldats, des cas d’éducation sexuelle auprès de jeunes de 6 ans. Puis il y a eu plein de cas au Québec dans toutes sortes de sujets. » PSPP dénonce avec raison les soldats qui sont allés dans des écoles privées juives pour faire la promotion du génocide à Gaza. Mais qu’en est-il de ces « cas d’éducation sexuelle auprès de jeunes de 6 ans »? Les activistes dont il parle sont en fait des enseignants qui appliquent le programme du ministère de l’Éducation. En effet, depuis l’implantation du nouveau programme de CCQ en 2024, il y a de l’éducation sexuelle dès la première année du primaire. À 6 ans, on enseigne aux enfants à nommer les parties du corps, à développer une image corporelle positive donc à apprécier que les corps ont différents formats et que c’est correct, les notions de stéréotypes de genres auxquels ils n’ont pas l’obligation de se conformer, qu’ils doivent respecter les différences… Finalement, on leur enseigne la notion de consentement, une notion qu’il est à mon avis utile d’apprendre très tôt. Je n’ai pas l’impression qu’il s’agisse d’une dérive de notre système d’éducation.
Parmi les critiques du nouveau programme, on retrouvait nulle autre qu’Alexa Lavoie, qui accusait le gouvernement du Québec d’encourager la sexualisation des enfants. PSPP est-il d’accord avec cette vision? Son discours laisse à penser que oui.
« Donc dans quelle logique tu bloques la circulation pour prier? Il y en a pas. À part des signaux politiques. Ça devient des gestes politiques et non pas un geste de piété. Et ces gestes politiques-là, il faut les prendre au sérieux à mon avis si on a à coeur la paix sociale. » L’entrevue s’attarde pendant plusieurs minutes sur la question des prières de rue, bien que la loi pour les interdire ait déjà été adoptée. PSPP entre tout à fait dans le narratif d’Alexa Lavoie, qui en fait des manifestations antisémites et pro-Hamas. À aucun moment, il ne mentionne que les prières avaient lieu pendant des manifestations contre le génocide à Gaza. Comme si c’était un détail. Évidemment, aucun des deux n’a mentionné que les manifestants protestent contre le soutien du Canada à Israël, encore moins que la Caisse de dépôt et de placement du Québec a des milliards investis dans ce que Francesca Albanese, la rapporteuse spéciale de l’ONU, qualifie d' »économie du génocide« . De telles nuances risqueraient de donner l’impression que les manifestations étaient justifiées. On préfère laisser croire qu’il s’agit d’islamistes qui se sont rassemblés pour célébrer leur haine des Juifs. PSPP mentionne d’ailleurs que les Juifs montréalais ont raison d’être inquiets pour leur sécurité.
Pendant la discussion sur les prières de rue, Alexa Lavoie lui demande s’il faudrait expulser les immigrants temporaires qui incitent à la haine et participent à des manifestations qui glorifient le terrorisme. PSPP: Ben oui parce que ce sont des actes criminels. Mais c’est parce qu’on n’a pas le pouvoir. Alexa: Mais si admettons on deviendrait un pays. PSPP: Bien sûr! D’abord, on n’a pas besoin d’avoir les pleins pouvoirs en immigration pour agir là-dessus. L’incitation à la haine est déjà un crime au Canada. Rien n’empêche de poursuivre des gens qui incitent à la haine, peu importe leur statut d’immigration. Les immigrants temporaires ne bénéficient pas d’une immunité diplomatique qui leur permet de contourner les lois. S’il y a pas d’accusations qui sont déposées contre les manifestants, c’est parce que manifester contre un génocide, ce n’est pas une incitation à la haine et ça ne mérite pas de condamnation. Je m’inquiète d’un aspirant premier ministre qui voudrait expulser des immigrants temporaires parce qu’ils exercent leur droit de manifester, un droit des plus fondamentaux dans une société démocratique.
On ne peut pas avoir une entrevue avec PSPP sans qu’il accuse l’immigration de tous les maux. « S’ils sont d’accord avec des seuils d’immigration toujours plus élevés au point où on a une crise du logement puis on est plus capables d’offrir des services. » Discours habituel ici. Les seuils d’immigration sont encore une fois pointés comme les seuls responsables de la crise du logement et de la crise des services. En fin d’entrevue, il nous présente une donnée nouvelle et exclusive: « Certains hôpitaux se sont confiés à moi en disant: Mais tsé la proportion de nos tables opératoires qui sont pour les demandeurs d’asile c’est près de 20% à certains endroits. » On ne peut pas lancer une telle affirmation sans élaborer. Qui lui a dit ça? Des infirmières? Des médecins? Des préposées à l’accueil? Des administrateur? Dans quels hôpitaux? Il est impossible de vérifier une déclaration comme celle-ci. On doit donc se fier à la bonne foi du chef du PQ et croire qu’effectivement, les demandeurs d’asile monopolisent une partie importante de notre système de santé.
Quand j’ai entendu dire que PSPP avait accordé une entrevue à Rebel News, ma première réaction a été de regretter qu’un chef de parti qui aspire à être premier ministre cautionne un média consacré à la désinformation. Après avoir entendu l’entrevue, je comprends mieux pourquoi il a accepté. PSPP se trouve à Rebel News comme un poisson dans l’eau.
[en]
TL;DR: enter card details manually, not using Link, if you need to change your payment method and it’s stuck.
Three days ago my Claude Pro subscription was up for renewal but I’d forgotten to top-up the prepaid credit card I use for this. It was (logically) declined and my subscription was suspended.
I was using Link as the payment method.
No sweat, I thought, I’ll top up the credit card and “try again”. No luck, still declined.
Cool cucumber, I’ll just use another card this
TL;DR: enter card details manually, not using Link, if you need to change your payment method and it’s stuck.
Three days ago my Claude Pro subscription was up for renewal but I’d forgotten to top-up the prepaid credit card I use for this. It was (logically) declined and my subscription was suspended.
I was using Link as the payment method.
No sweat, I thought, I’ll top up the credit card and “try again”. No luck, still declined.
Cool cucumber, I’ll just use another card this month. Clicked through to select an other payment method, but… once I was back on the Anthropic payment screen, the active payment method displayed was still the first card that had been declined.
What I did:
What I got:
Then I went a bit wild. I tried to change the payment method again. I went into Link and removed the card, leaving only the second one, but the payment was still attempted by Anthropic (Link?) with the card I had removed
I logged out of Link and back in. I even tried Apple Pay. My card transaction statement shows a string of $0 card checks, and my inbox is full of e-mails telling me my payment was unsuccessful, but that is all that there is to show for these efforts. Whatever card I chose, Anthropic insisted on trying the same one again and again.
At some point, inspiration hit and I tried settling the open subscription invoice from inside Link directly, with my other card, instead of through the Anthropic billing screen. That worked!
But I wasn’t out of the woods. I wanted to buy some extra usage (I know, I know). The same frustrating dance started again, to no avail.
I decided to let it rest 24 hours and try again.
I tried again today. Same same.
In desperation (of course I’d already had a frustrating chat with Fin the Anthropic “support bot” and sent an e-mail to support) I tried chatting up the Link support chatbot. It confirmed that there was indeed a trace of the failed purchase on their side. At least something! I requested a human, and started chatting up my credit card’s support too, as I now had a clear indication that the purchase request had left Anthropic’s walls.
I’ll spare you the hour of slow, mind-numbing, half-chatbot-half-human support chats. You’ve been there I’m sure. There would be a lot to say.
In the end, after going around in many more circles, here is what worked:
I clicked to change the payment method on checkout on the Anthropic site
I disconnected Link in there
I entered my card details manually
What I did (notice how I’m not signing into Link here):
What I got (notice how this time I actually did manage to get it to switch to the Mastercard and drop the Visa!):
Lo and behold, the payment went through!
(This is the second card, mind you, I’m not that crazy. Next step, before my next subscription invoice comes around, will be to try and make a purchase with the initial – preferred – card. Maybe by then the e-mail the service cyborg promised with details of why the transaction failed will have reached me.)
Sharing this in hope it can spare at least one other person some headaches.
[en]
End 2024 is when I really started to get going with “AI” (or LLMs – I know saying “AI” is kinda wrong, but there seems to be no good way to escape it right now). I’d been dabbling a bit before that: as a search engine, to help me with my excel formulas at work, or translating an e-mail here or there. But over that Christmas break, I realised it went further than that: helping me manage my tasks; keep lists updated; make sense of my investment portfolio; troubleshooting technical stuff that
End 2024 is when I really started to get going with “AI” (or LLMs – I know saying “AI” is kinda wrong, but there seems to be no good way to escape it right now). I’d been dabbling a bit before that: as a search engine, to help me with my excel formulas at work, or translating an e-mail here or there. But over that Christmas break, I realised it went further than that: helping me manage my tasks; keep lists updated; make sense of my investment portfolio; troubleshooting technical stuff that’s above my pay-grade; and build actual systems to do stuff. I didn’t really know what I was doing, but I saw enough to find it really exciting. I was quite busy with work and life during that period, and not finding time to blog much.
And then I had a skiing accident. Everything stopped, but in time, as I started becoming more functional, I turned back to playing with AI some more, doing a little more vibe-coding too. Excitement grew. But I was also hitting limitations, fed up with the sycophancy, context bloat, hallucinations and endless rabbit-holes. Oh, and really sick of AI slop. (Really: nobody wants to read your AI slop, people.) But the exciting was still there, I was just biding my time. Integrations, agents and AI-powered browsers showed up, with the security risks that are bundled in. I was tempted but stopped myself. And a few loved ones.
Three articles amongst many that tell cautionary tales. I have more to say, particularly about the brain fry one, but not today.
In it, the author describes one key aspect of working with AI that I had understood to be important, but that I didn’t know how to put into practice: using different conversations for different “roles” or aspects of the project. And here I had a real example.
I put that in practice (a bit as an exercise) in applying these instructions to migrate my personal context from ChatGPT to Claude. It was extremely satisfying and a great learning experience. I was itching to get going with Claude Cowork and Claude Code, but still a bit anxious. As I see it, Cowork is like being handed a powerboat when all you’re used to are the free permitless motorboats you can rent by the hour on a sunny Sunday afternoon like this one. You can really get in trouble if you’re not careful. And probably, even if you are.
I asked around a bit and Claire pointed me to this wonderful guide to Cowork. What she also explained to me is that Cowork is sandboxed, so it only has access to the folders you give it access to. That’s reassuring. And just a few days ago, Matt shipped Taxonomist, an AI-app (? what do we call these things?) that he used to cleanly recategorise all his blog posts. Unsurprisingly, categories here on CTTS have been a mess since time immemorial, and one of the things that has been clear for some time for me is that AI can help me clean things up a bit around here – in general, not just the categories. But that felt like a great way to get started seeing what the powerboat can do, with a trusted friend on board to keep me from crashing on the rocks.
So earlier today I installed Claude Desktop, downloaded the guide, and started it in Cowork. And wow. Honestly. It’s wild. My 3TB of archived files going back nearly three decades are now hopeful they will one day be deduplicated and cleaned up. Of course, I hit my usage limit (which is why I’m writing this instead of playing with my new AI friend), so I went to have a look at what something like Taxonomist really looks like under the hood. You know, open the files and read them. And it’s starting to come together in my mind. The powerboat is starting to feel like something I will be able to manage in time.
Of course, I’m not going to point Cowork at my external hard drive right now. There are still a lot of steps until I feel comfortable enough with the powerboat to attempt that. But doors are opening. My diabetic cat community migration feels more manageable. I’m hopeful I can tidy my files and clean up my blog. Come up with a system to make sharing links to the open web as easy as on Facebook. Reboot the blogosphere. And I’m sure other ideas will come along the way. I am also trying to be very, very careful about AI brain fry, as I already have my own concussion brain fry to deal with.
If you haven’t yet started learning how to use AI beyond as a proxy for Google or Wikipedia, really, it’s time to get cracking. I’m going back to Lesson 5 (honestly, just read through that page for starters if you don’t know what to do first), making a note to check out Cursor (I’m using Visual Studio Code for now) and read this article on Teaching AI to Design.
[en]
Devoir mettre un titre à un article, c’est clairement un frein à l’initiation de la tâche “écrire un article”. Vous avez déjà remarqué ça? De mon point de vue, c’est aussi une des raisons pour lesquelles ce qui se racontait sur les blogs à gentiment migré vers les réseaux. Sur Facebook ou LinkedIn, nul besoin de choisir un titre pour ce qu’on va écrire. On ouvre notre cerveau et il se déverse sur la page. Pas besoin d’avoir un sujet, pas besoin d’avoir quelque chose de structuré. Juste une
Devoir mettre un titre à un article, c’est clairement un frein à l’initiation de la tâche “écrire un article”. Vous avez déjà remarqué ça? De mon point de vue, c’est aussi une des raisons pour lesquelles ce qui se racontait sur les blogs à gentiment migré vers les réseaux. Sur Facebook ou LinkedIn, nul besoin de choisir un titre pour ce qu’on va écrire. On ouvre notre cerveau et il se déverse sur la page. Pas besoin d’avoir un sujet, pas besoin d’avoir quelque chose de structuré. Juste une pensée qui passe, et hop, on a publié quelque chose. Très souvent, une fois qu’on a commencé à écrire, le quelque chose prend de l’ampleur – enfin, si on est quelqu’un qui aime écrire et parler et qui a tendance à avoir des tas de choses à dire. Je ne compte plus le nombre “d’articles de blog” que j’ai en fait écrits dans Facebook ou LinkedIn, parce que je pensais que j’allais “vite partager un truc”.
Alors que sur le blog, ouh là là, on va écrire un article, faut savoir de quoi on va parler, d’ailleurs y’a qu’à voir, on commence par écrire un titre en haut de la page. Je pense que ça joue un rôle énorme dans la façon dont notre expression en ligne se déploie. Messagerie instantanée? Pas de titre, juste écrire, contrairement à un e-mail, ou un forum.
D’ailleurs, à ce moment précis, cet article n’a pas de titre. Je suis très consciente, pour ma part (TDAH oblige), à la question des freins à l’action. J’en parlais d’ailleurs tout à l’heure avec une amie alors que nous étions en balade. Ça ne date pas de mon diagnostic, cet intérêt, parce que j’avais perçu très tôt dans ma vie que “commencer était difficile”. Il y a d’ailleurs des tonnes d’articles dans ce blog sur ce sujet (si on arrive à les trouver). Mon intérêt pour la UX (avant “usability”) et le comportement animal sont deux branches de mon intérêt général pour cette problématique, en passant.
Donc cette histoire de titre, c’est sur mon radar de façon lointaine depuis des années, et de façon bien plus présente depuis la fin de l’été dernier, avec la suspension de mon compte Facebook, et le sentiment d’urgence à relancer la blogosphere et créer de véritables alternatives aux réseaux propriétaires. Je ne laisse donc plus ça m’arrêter. Soit j’écris un peu n’importe quoi, soit, comme aujourd’hui, si rien ne me vient, je laisse vide et je commence à écrire. Je trouverai bien un n’importe quoi à mettre une fois que j’aurai fini.
Parfois, évidemment, j’ai un article en tête à écrire qui a un titre. Mais souvent, j’ai des trucs à dire, pas forcément très bien organisés et très bien identifiés, mais je n’écris pas parce que ça ne fait pas “un article sur quelque chose”. J’essaie de changer ça. J’essaie de retrouver la liberté des débuts des blogs, du monde d’avant Facebook. Bien sûr, on n’est pas dans le monde d’avant Facebook. On est 20-25 ans plus tard, donc c’est clair qu’il y a des choses qui à l’époque allaient sur mon blog et qui n’y auraient plus leur place aujourd’hui.
Mais une chose demeure: écrire a toujours été, pour moi, un moyen de canaliser ma pensée (hyperactive), un moyen de faire sens de tout ce qui tourne dans ma tête en le lâchant dans le monde, comme une petite bouteille à la mer qui peut-être voudra dire quelque chose pour quelqu’un. Il y a un enjeu existentiel là-derrière. Ça compte pour moi que ces lignes puissent être lues par quelqu’un d’autre, dans une heure, dans un mois, dans un an ou même dix. Mais ce n’est pas juste le regard (ou l’oreille) qui compte, c’est aussi vraiment que ça réduit ma charge cognitive, de mettre des choses par écrit. Le processus m’aide à réfléchir, à sentir aussi. Les “articles sur quelque chose” sont peut-être un peu plus pour autrui, mais ils sont aussi pour moi, car ils couvrent souvent des idées ou informations que je me retrouve à répéter souvent à beaucoup de personnes différentes. Alors des fois, c’est pratique pour moi, de pouvoir dire “attends j’ai un article là-dessus”.
Je ne sais honnêtement plus si j’en ai parlé sur mon blog ou pas, mais ces dernières années j’ai beaucoup réfléchi à comment étaient structurées mes interactions sociales avec les gens. Ce qu’il y avait de satisfaisant là-dedans, et d’insatisfaisant, sur quoi j’avais prise et ce qui était hors de mon contrôle. J’ai pris conscience que j’étais souvent un peu la “sorcière de mon village” – et même si c’est un rôle qui me convient et que j’encourage, parce qu’être utile à autrui fait partie de mes valeurs et de mon sens, c’est pas toujours une bonne chose pour mes amitiés ni pour ma charge mentale ou mon emploi du temps (et post-accident, c’est encore plus clair). Donc écrire certaines choses sur mon blog, c’est – depuis toujours d’ailleurs, c’est l’impulsion qui m’a fait créer ma “homepage” en 1998 – une façon de faire ça.
Je vis avec un backlog permanent de choses à écrire et de choses à dire, tout comme il y a trop de choses que j’ai envie de faire. Je pense honnêtement qu’aujourd’hui je pourrais écrire non-stop pendant des jours ou même des semaines. Le hic c’est que l’écriture, pour moi, comme pour beaucoup d’autres tâches, c’est quelque chose qui vient facilement quand la motivation ou l’impulsion de m’y mettre est là, mais pas autrement. Et (TDAH toujours), la motivation et l’impulsivité sont, chez moi, des choses sur lesquelles je n’ai pas un très bon contrôle.
Je me suis donc dit, il y a quelque temps (un moment déjà en fait, mais vous savez comment c’est les prises de conscience et les décisions concernant “faire autrement”, souvent ça vient par couches de peinture successives, et il faut un moment pour que la couleur finale soit bien visible), bref je me suis dit que j’allais écrire plus sur mon blog, même si c’est désorganisé, même si c’est pas de jolis articles bien ficelés, pour réduire la pression mentale du backlog des choses à écrire. Juste là, réduire ma charge mentale c’est capital. Et en fait, quand j’écris pas, ça s’accumule, et plus ça s’accumule moins je m’y mets, bref (encore oui j’aime bien ce mot), vous voyez le truc.
C’est pas encore en place. Je me suis dit: “hop, timer 30 min, je ferai 45 min à une heure, j’écris ce qui tournicote dans ma tête, je fais ça chaque jour”. Evidemment, pas si simple à mettre en place. Mais aujourd’hui, voilà, j’ai attrapé l’ordi et je me suis mise sur le balcon (il commence à faire frisquet, je vais peut-être rentrer), et je vous parle de ce qui me passe par la tête, et du coup ça fait 30 minutes que je vous écris des histoires de titres et d’écriture alors que c’était pas du tout ça qui se promenait dans ma tête à la base. Bienvenue dans mon cerveau.
Cette histoire d’initiation de tâche, ça me fait penser à deux choses. Premièrement, ma vidéo sur le sujet. Je ne sais plus ce que j’y raconte, vous me direz – purée, en allant chercher le lien je vois que c’était il y a sept mois , j’ai certainement dû en parler ici déjà. Mon sens du temps qui passe est complètement à l’ouest. Sept mois? C’était déjà pas terrible à la base, chez moi, mais post-accident c’est bien pire, et post-rechute encore plus. Heureusement que j’ai une bonne mémoire des dates, je compense avec ça. Mais bref, cette vidéo, c’est une parmi d’autres. Après la suspension de mon compte Facebook et sa récupération, j’ai pris la peine de faire une sauvegarde en bonne et due forme de mes données là-bas, y compris toutes mes vidéos Live. J’en ai surtout fait beaucoup pour la communauté Diabète Félin, mais aussi quelques-unes, de temps en temps, sur d’autres sujets. Je fais des vidéos comme j’écris des articles: je lance l’enregistrement, je cause, je publie. Le montage c’est pas mon truc, pas plus que la relecture et le travail minutieux de mes textes. Je suis une deverseuse. J’ai donc fait quelques vidéos ces derniers temps, après avoir décidé que mes vidéos live iraient pour le moment sur Youtube, et la plupart mériteraient un article ici, mais je ne l’ai pas encore fait. C’est dans le backlog. Mais en attendant, vous pouvez déjà aller sur mon compte YouTube, vous abonner, écouter, piocher dedans.
Là, je pourrais partir aussi sur tout ce qui est en route concernant Diabète Félin, et en particulier la mise en place de Discourse pour héberger la communauté. C’est encore le gros chantier mais vous pouvez déjà jeter un oeil. Si vous voulez une visite guidée, dites-moi – je compte à terme en faire un multi-site, comme j’ai fait avec mon installation WordPress, ce qui voudra dire que si quelqu’un veut profiter du fait que je me suis cassée les dents sur Discourse pour mettre plus facilement sur pied une communauté en ligne hors Facebook, ça devrait être possible, un fois ou l’autre.
Et maintenant je pourrais rebondir là-dessus pour vous raconter mes pérégrinations avec l’IA, parce que oui il y a un lien, ma migration de ChatGPT à Claude (comme tant d’autres), le potentiel que j’y vois mais aussi les risques, comment je pense en faire usage pour mes projets (dont DF, c’est le lien).
Mais je vais nous épargner ça car je suis sûre que comme moi, vous avez besoin d’aller manger à un moment où un autre.
Donc je vais juste mentionner la deuxième chose à laquelle me refait penser cette histoire d’initiation de tâche (vous aviez gardé le fil?) – parmi mes “articles à écrire sur un truc”, il y a quelque chose de l’ordre du “briefing TDAH”. Genre “tu penses que tu as peut-être un TDAH, ou tu sais que tu en as un mais t’en fais pas grand-chose, voici ce qui est important”. Mais pas ce soir, hein. J’ai aussi un article en souffrance sur les questions de sommeil et d’endormissement. Deux brouillons aussi dans WordPress qui sont écrits aux trois-quarts, quelque chose que j’évite vraiment de faire parce que franchement, c’est tellement dur de m’y remettre pour les terminer. (J’ai pas choisi les interruptions, en l’occurrence: une crise convulsive d’Oscar et l’inondation de mon espace coworking.) Puis tiens, je pourrais écrire un article sur ces histoires de difficulté d’initiation de tâche, vous pensez pas?
Je vais quand même vous parler d’un truc que je mijote avec Claude, parce que ça concerne quelque chose qui est un peu bête mais qui prend beaucoup de place dans ma tête. Dans mon quotidien, je découvre plein d’articles intéressants à lire. J’aime les partager, on ne sait jamais à qui ça peut servir. C’est une des choses que je fais avec Facebook: partager des liens. (Et peut-être qui m’a desservie, en passant.) Et j’aimerais, beaucoup, mais vraiment beaucoup, m’affranchir de Facebook pour ça et pouvoir publier ici (ou sur un blog parallèle) des sortes de pelotes de liens quotidiennes. Pas n’importe comment bien sûr: il faut que je puisse rajouter un petit mot d’explication concernant le lien si je veux, il faut que le lien soit présenté avec une “carte” de prévisualisation (comme c’est sur les réseaux), il faut que ce soit aussi facile pour moi de rajouter un lien à la collection que de le balancer dans Facebook, et il faut que les liens partagés soient également répercutés dans mes réseaux, parce qu’il faut être pragmatique et la réalité d’aujourd’hui c’est que tout le monde est encore sur Facebook ou Linkedin.
Ça, c’est typiquement le genre de projet qui est juste hors de ma portée. Je vois assez clair pour pouvoir dire que techniquement, ça devrait être faisable, mais je n’ai ni les connaissances ni les compétences techniques pour. C’est le genre de chose, pré-IA, qui me fait perdre un temps fou en recherche pour déterminer comment monter ce genre de système, avec quels outils, comprendre ce qui existe et si je peux l’adapter à mes besoins, identifier les pièces manquantes, réaliser tout ça une fois que j’ai un plan pour le faire, et régler les inévitables bugs qui surviendront. Une montagne.
Avec un assistant IA, c’est nettement plus accessible. En quelques échanges dans une conversation l’autre jour, j’ai déjà dégrossi les enjeux techniques et pu établir la faisabilité (vraiment) de mon idée. Je peux utiliser l’IA pour m’assister d’une part dans la gestion des différentes étapes (savoir où j’en suis et ce que je dois faire ensuite) et dans l’implémentation technique, sans que je me retrouve limitée par mes connaissances en matière d’administration système ou développement, qui même si elles sont plutôt bonnes pour une non-technicienne, ne sont pas suffisantes pour mes ambitions.
C’est un projet qui me démange, car chaque jour, je partage des liens, et ce système me manque. Evidemment, mon objectif est de vous tenir au courant de la solution que j’aurai trouvée et mise en place. Et aussi, de vous parler plus de comment j’utilise Claude et de ce à quoi je fais attention. Je suis encore en train d’apprendre, comme tout le monde d’ailleurs!
J’étais il y a quelques semaines l’invité des Universités Populaires du pays Yonnais (UPPY), pour une soirée conférence-débat autour du thème de l’IA.
La captation de cette intervention est désormais disponible en ligne.
Moi qui fait des gestes avec mon bras devant un baby-foot. Mais en vrai je parle des grands enjeux de l’IA.
SI vous résidez autour de La Roche sur Yon ne manquez pas les prochains rendez-vous de ces universités populaires (informations sur leur page Facebook)
Moi qui fait des gestes avec mon bras devant un baby-foot. Mais en vrai je parle des grands enjeux de l’IA.
SI vous résidez autour de La Roche sur Yon ne manquez pas les prochains rendez-vous de ces universités populaires (informations sur leur page Facebook)
[en]
A friendly colleague I share some geeky interests with told me today I was courageous to announce my blogging intentions yesterday. I told him “not that much”, because if I didn’t stick to my declaration of intent, it’s not something I’d feel terribly bad about. Writing that quick post yesterday made me feel a bit better, and announcing I would write today increased the probability I’d actually do it today. Making clear plans and public accountability aren’t binding, but they can help tip
A friendly colleague I share some geeky interests with told me today I was courageous to announce my blogging intentions yesterday. I told him “not that much”, because if I didn’t stick to my declaration of intent, it’s not something I’d feel terribly bad about. Writing that quick post yesterday made me feel a bit better, and announcing I would write today increased the probability I’d actually do it today. Making clear plans and public accountability aren’t binding, but they can help tip the scales.
I’ve lost other cats before Oscar, but in my post-accident world, there is no known territory anymore. I don’t know what it will do to me – because my brain is still very much in the process of recovering. I’m working 50% again but have set aside pretty much all my non-work activities and projects, and I’m exhausted. So, I’m on edge emotionally, and not dealing well with the usual/inevitable stuff life in our day and age throws at me, particularly the stuff that has to do with broken systems, bureaucracy, and people being a pain in the neck. I am stuck in between a rock and a hard place: either deal with it or let it go, and both are costly, and I don’t have spoons to spare these days.
On the sunny side, when I’m feeling kind of OK, I have to face the frustration of prioritising rest, when I have a pile of blog post ideas (I even have a couple of proper drafts that need finishing up), want to make progress with the migration of the diabetic cat community to Discourse (and write about it), finish setting up Claude so it’s properly usable for the half-dozen “top of mind” projects I want to work on with it, continue tidying/organising my flat, have a social life, go to judo, singing rehearsals, skiing and hiking, whatever, the stuff I used to do and took for granted before my accident. It sucks.
I have a ton of links to share, but no good system to do it in the way I want. I keep throwing them into the socials, which is better than nothing, but I’d like to collect them here or at least some place I control, and I have a path/plan to do that (thanks Claude) – but it’s going to take time and effort to do.
So here’s a small dump. The timer is going off.
Current RSS reader (and go read the rest of the stuff this guy has written, I love his brain)
Some videoblogging of mine (yep, want to write those up as articles too here, another thing I haven’t got around to doing)
Early March, my old talk on structured portable social networks popped up on Facebook. Heavens, I can’t believe we’ve been stuck with these issues for 18 years. So I dug the video out of my hard drive archive and stuck it on YouTube, because all the other places it was are dead and gone, except Facebook, and, well, yeah, Facebook.
That’ll be it for today. Grey’s Anatomy is waiting. I’m going to try and blog a bit more frequently (with timer) just to dump stuff out of my brain. Probability increased, certainty unavailable.
Bonus picture: the puzzle I was very tempted to continue working on tonight instead of writing.
[en]
I set a timer for 30 minutes, with the intent of churning out a quick blog post. I’m all over the place, I have stuff to dump. I’m struggling, but my head is still out of the water, thankfully. Well, I figured I’d close some tabs before writing, because I have windows full of tabs that are going nowhere. Close the tabs, decide to keep some (didn’t read), a few text messages, and here we go, the timer will ring in a few minutes and I want to watch my episode of Grey’s Anatomy (the deal: nee
I set a timer for 30 minutes, with the intent of churning out a quick blog post. I’m all over the place, I have stuff to dump. I’m struggling, but my head is still out of the water, thankfully. Well, I figured I’d close some tabs before writing, because I have windows full of tabs that are going nowhere. Close the tabs, decide to keep some (didn’t read), a few text messages, and here we go, the timer will ring in a few minutes and I want to watch my episode of Grey’s Anatomy (the deal: needs to be done by 10pm, so I had better get cracking on it).
Each day brings more stuff I want to do or write about than I can fit in that day. It’s kind of depressing.
There's something uniquely demoralizing about editing and editing and editing a book manuscript. The words all start to blur together and you start thinking that every sentence is crap, no one will ever want to read this, why bother completing the book. I was definitely in this state. And then... my publisher sent me the book cover and I squealed for joy at just how lovely it is. And it gave me hope. Check out this beauty! And yes... that's a wobbly Jenga tower comprised of pieces made from cens
There's something uniquely demoralizing about editing and editing and editing a book manuscript. The words all start to blur together and you start thinking that every sentence is crap, no one will ever want to read this, why bother completing the book. I was definitely in this state. And then... my publisher sent me the book cover and I squealed for joy at just how lovely it is. And it gave me hope. Check out this beauty!
And yes... that's a wobbly Jenga tower comprised of pieces made from census documentation cuz one of the core arguments in the book is that we're living in a world of "Jenga Politics" where different actors are pulling out pieces of our administrative infrastructure and putting pressure on top. Civil servants are exhausted, but they're trying to keep the tower from falling.
And now that I've seen the beautiful cover, I can't wait for you to read this book! And to come celebrate with me! I am starting to build a book tour so hopefully I will come to a city near you. But, in the meantime, here are some of the fun things I get to share:
My book won the J. Anthony Lukas Work-in-Progress Prize!Thank you to the kind people at Columbia Journalism School and the Nieman Foundation for Journalism at Harvard University for giving me wind beneath my wings!
Pre-Order the book! And if you order it from the University of Chicago Press website, you can save 30% by using the code UCPNEW. But feel free to order from your local bookstore or wherever else you want!
DC folks: Save the Date (9/25)! I am ecstatic that Politics & Prose is hosting me at their Wharf venue on September 25 at 7PM (the day after the book goes on sale!). I hope lots of folks will come out to celebrate! There will be books available! And a signing!
Virtual Folks: On the eve of the book launch (9/23), Dan Bouk and I will discuss the book in a virtual event hosted by Data & Society. More info on that will come shortly, but make sure to sign up to the D&S newsletter!
Première Assemblée populaire rimouskoise
Se redonner du pouvoir pour protéger nos milieux naturels urbains. Agissons dès maintenant!
Cette première assemblée des Assemblées Populaires Rimouskoises est organisée en collaboration avec :
Nous sommes préoccupé.e.s par…
L’accélération des changements climatiques et le déclin rapide de la biodiversité?
La destruction de boisés et de milieux humides en secteurs urbains et péri-urbains?
Le manque d’éco
Se redonner du pouvoir pour protéger nos milieux naturels urbains. Agissons dès maintenant!
Cette première assemblée des Assemblées Populaires Rimouskoises est organisée en collaboration avec :
Nous sommes préoccupé.e.s par…
L’accélération des changements climatiques et le déclin rapide de la biodiversité?
La destruction de boisés et de milieux humides en secteurs urbains et péri-urbains?
Le manque d’écoute et le manque d’action des décideur·euses quant aux besoins d’une transition socio-écologique et de logements sociaux?
L’urgence d’agir pour mettre en œuvre des initiatives populaires?
Nous reprenons ensemble notre pouvoir collectif !
Le déroulement de l’assemblée était divisé en 5 étapes :
Identification des milieux naturels menacés en sous-groupes puis mise en commun pour un portrait global.
Invitation à réfléchir aux obstacles vécus par rapport à la protection des milieux naturels et échanges (par visio) pour trouver des pistes de solutions avec le Mouvement d’action régional en environnement (MARE).
Brassage d’idées en sous-groupes pour trouver des actions à mettre en place puis mise en commun et échanges (par visio) avec Jonathan Durand Folco, auteur du livre À nous la ville! Traité de municipalisme.
Discussions en tables affinitaires selon les pistes d’actions identifiées
Mise en commun des pistes d’actions retenues, et suites à donner pour la prochaine assemblée
Tous ces temps d’échanges ont permis de faire émerger des idées, de faire parler l’intelligence collective et l’imaginaire, sans se mettre de barrière. Puisqu’ensemble on voit mieux, nous avons discuté de solutions pour mieux protéger les milieux naturels, et de façons de reprendre du pouvoir populaire !
La première assemblée avait fait ressortir une multitude de pistes d’action pour protéger les milieux naturels. Lors de cette deuxième assemblée, on s’est regroupé pour les mettre en œuvre!
DÉROULEMENT
Bloc 1 – État des lieux et rappel des stratégies identifiées à la première assemblée
avec une présentation de mobilisations collectives qui ont porté fruit !
Bloc 2 – Ateliers en sous-groupes thématiques pour peaufiner les stratégies et établir un plan pour les mettre en action
avec outils de planification et d’organisation à s’approprier !
Bloc 3 – Mise en commun et choix du thème de la prochaine assemblée
pour maintenir le lien entre nos actions et favoriser la diversité des tactiques!
Un moment d’échange libre pour rêver, discuter et s’organiser afin de prendre soin du vivant collectivement, dans une ambiance conviviale et horizontale.
Dans la continuité des deux premières assemblées, nous nous sommes rassemblé.e.s pour faire le point sur les initiatives lancées en février, échanger sur nos avancées et surtout ouvrir de nouvelles pistes de mobilisation autour des enjeux sociaux et environnementaux qui nous touchent collectivement.
Tableau de synt
Un moment d’échange libre pour rêver, discuter et s’organiser afin de prendre soin du vivant collectivement, dans une ambiance conviviale et horizontale.
Dans la continuité des deux premières assemblées, nous nous sommes rassemblé.e.s pour faire le point sur les initiatives lancées en février, échanger sur nos avancées et surtout ouvrir de nouvelles pistes de mobilisation autour des enjeux sociaux et environnementaux qui nous touchent collectivement.

 Connexion


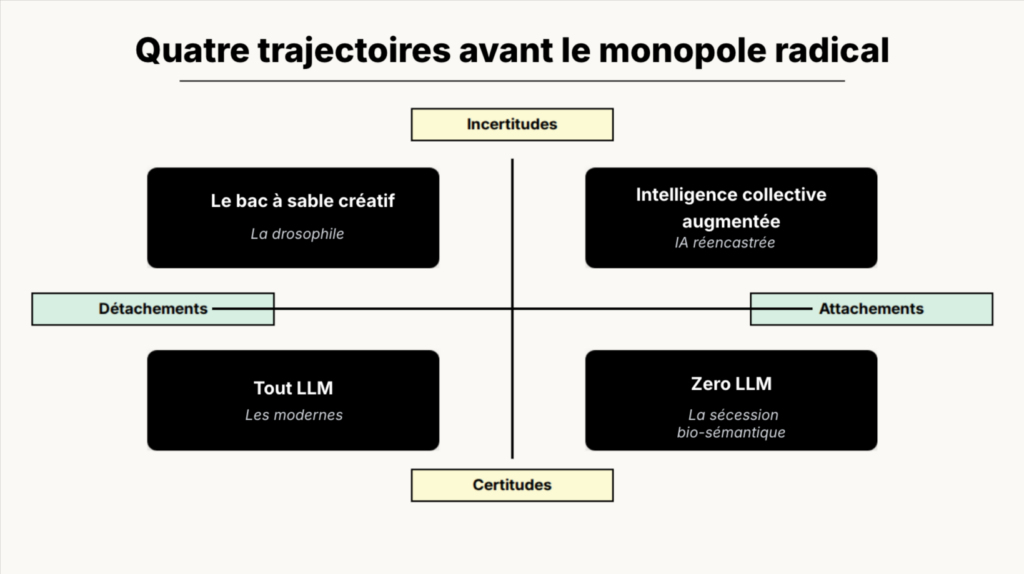



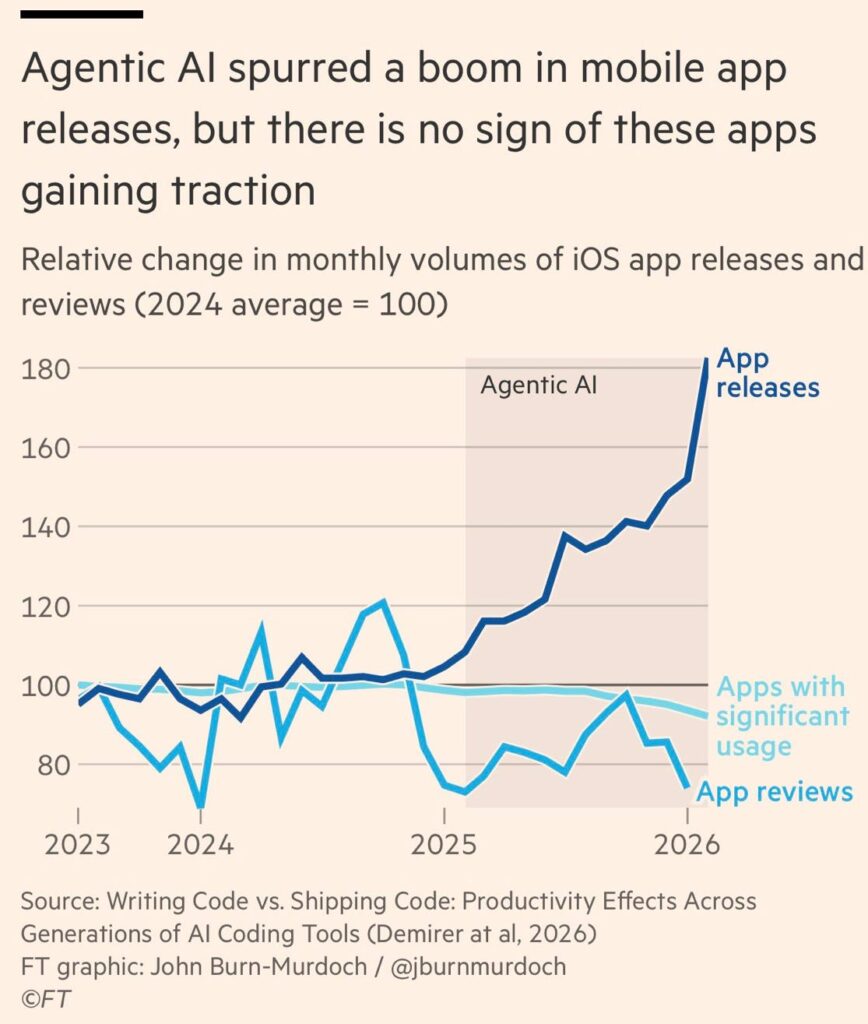



 et des oiseaux qui chantent
 , on vous invite à une assemblée populaire rimouskoise sous la forme d’un pique nique

 , au Parc Beauséjour.
 et aux envies de jouer dehors
 !
 .








 Nous sommes préoccupé.e.s par…
 Nous reprenons ensemble notre pouvoir collectif !
 milieux naturels menacés en sous-groupes puis mise en commun pour un portrait global.
 vécus par rapport à la protection des milieux naturels et échanges (par visio) pour trouver des pistes de solutions
 avec le Mouvement d’action régional en environnement (


 Brassage d’idées en sous-groupes pour trouver des actions à mettre en place puis mise en commun et échanges (par visio) avec Jonathan Durand Folco, auteur du livre


