OpenAI a profité de son DevDay 2026, présenté le 29 septembre à San Francisco, pour dévoiler plus d’une vingtaine de nouveautés, de mises à jour et d’extensions de ses produits. Derrière cette série d’annonces, une orientation se précise : l’entreprise veut faire de ChatGPT un environnement de travail capable d’héberger des agents autonomes, de collaborer […]
OpenAI a profité de son DevDay 2026, présenté le 29 septembre à San Francisco, pour dévoiler plus d’une vingtaine de nouveautés, de mises à jour et d’extensions de ses produits. Derrière cette série d’annonces, une orientation se précise : l’entreprise veut faire de ChatGPT un environnement de travail capable d’héberger des agents autonomes, de collaborer […]
Meta veut maintenant faire de Muse un véritable assistant de gestion pour les petites entreprises. Trois semaines après avoir lancé son agent d’intelligence artificielle destiné au grand public, l’entreprise annonce Muse for Small Business, une version capable de se connecter directement aux outils utilisés pour gérer une entreprise et d’exécuter certaines tâches à la place […]
Meta veut maintenant faire de Muse un véritable assistant de gestion pour les petites entreprises. Trois semaines après avoir lancé son agent d’intelligence artificielle destiné au grand public, l’entreprise annonce Muse for Small Business, une version capable de se connecter directement aux outils utilisés pour gérer une entreprise et d’exécuter certaines tâches à la place […]
OpenAI a décidé de ne pas commercialiser GPT-6.1 Astra, une nouvelle version de son modèle GPT-6 qui devait arriver en octobre dans ChatGPT et Codex. Une décision inhabituelle dans une industrie où la course aux modèles toujours plus performants impose généralement un rythme accéléré de lancements. Selon le Wall Street Journal, le modèle avait pourtant […]
OpenAI a décidé de ne pas commercialiser GPT-6.1 Astra, une nouvelle version de son modèle GPT-6 qui devait arriver en octobre dans ChatGPT et Codex. Une décision inhabituelle dans une industrie où la course aux modèles toujours plus performants impose généralement un rythme accéléré de lancements. Selon le Wall Street Journal, le modèle avait pourtant […]
Google rapproche encore un peu plus Gemini des données personnelles de ses utilisateurs. L’entreprise commence à intégrer Google Wallet aux applications connectées de son assistant d’intelligence artificielle. L’objectif est simple: permettre à Gemini de consulter certaines informations conservées dans le portefeuille numérique et de répondre directement à des questions concernant des cartes, des billets, des […]
Google rapproche encore un peu plus Gemini des données personnelles de ses utilisateurs. L’entreprise commence à intégrer Google Wallet aux applications connectées de son assistant d’intelligence artificielle. L’objectif est simple: permettre à Gemini de consulter certaines informations conservées dans le portefeuille numérique et de répondre directement à des questions concernant des cartes, des billets, des […]
Derrière certaines interactions avec Microsoft Copilot se trouvent aussi des humains. Selon une enquête publiée par 404 Media, des sous-traitants chargés d’évaluer la qualité du système ont accès à des requêtes formulées par de véritables utilisateurs, mais également à certaines images qu’ils téléversent dans Copilot pour les faire modifier. Le média affirme avoir consulté des […]
Derrière certaines interactions avec Microsoft Copilot se trouvent aussi des humains. Selon une enquête publiée par 404 Media, des sous-traitants chargés d’évaluer la qualité du système ont accès à des requêtes formulées par de véritables utilisateurs, mais également à certaines images qu’ils téléversent dans Copilot pour les faire modifier. Le média affirme avoir consulté des […]
L’intelligence artificielle commence à transformer non seulement la façon dont travaillent les cabinets d’avocats, mais aussi la manière dont ils facturent leurs clients. Aux États-Unis, de grandes entreprises et plusieurs banques de Wall Street demandent maintenant aux cabinets juridiques de leur faire profiter directement des gains de productivité générés par l’IA. Selon le Financial Times, […]
L’intelligence artificielle commence à transformer non seulement la façon dont travaillent les cabinets d’avocats, mais aussi la manière dont ils facturent leurs clients. Aux États-Unis, de grandes entreprises et plusieurs banques de Wall Street demandent maintenant aux cabinets juridiques de leur faire profiter directement des gains de productivité générés par l’IA. Selon le Financial Times, […]
Les cybercriminels ne cherchent plus seulement des mots de passe, des cartes de crédit ou des cryptomonnaies. Une nouvelle ressource attire désormais leur attention : l’accès aux modèles d’intelligence artificielle et surtout à la puissance informatique nécessaire pour les faire fonctionner. Le phénomène porte déjà un nom, le « LLM-jacking ». Il consiste à détourner […]
Les cybercriminels ne cherchent plus seulement des mots de passe, des cartes de crédit ou des cryptomonnaies. Une nouvelle ressource attire désormais leur attention : l’accès aux modèles d’intelligence artificielle et surtout à la puissance informatique nécessaire pour les faire fonctionner. Le phénomène porte déjà un nom, le « LLM-jacking ». Il consiste à détourner […]
Les efforts internationaux visant à encadrer l’utilisation de l’intelligence artificielle dans les armes autonomes viennent de franchir une étape importante, mais les négociations révèlent aussi de profondes divisions entre les grandes puissances militaires. Selon une enquête du Washington Post, les États-Unis et la Russie auraient obtenu le retrait de plusieurs dispositions destinées à garantir un […]
Les efforts internationaux visant à encadrer l’utilisation de l’intelligence artificielle dans les armes autonomes viennent de franchir une étape importante, mais les négociations révèlent aussi de profondes divisions entre les grandes puissances militaires. Selon une enquête du Washington Post, les États-Unis et la Russie auraient obtenu le retrait de plusieurs dispositions destinées à garantir un […]
Bill Gates estime que le développement actuel de l’intelligence artificielle représente un moment sans précédent dans l’histoire technologique. Invité de l’émission Meet the Press de NBC, diffusée dimanche 27 septembre, le cofondateur de Microsoft a appelé les gouvernements à intervenir rapidement pour imposer des mécanismes obligatoires de sécurité et de surveillance aux entreprises qui développent […]
Bill Gates estime que le développement actuel de l’intelligence artificielle représente un moment sans précédent dans l’histoire technologique. Invité de l’émission Meet the Press de NBC, diffusée dimanche 27 septembre, le cofondateur de Microsoft a appelé les gouvernements à intervenir rapidement pour imposer des mécanismes obligatoires de sécurité et de surveillance aux entreprises qui développent […]
Les incidents impliquant des agents d’intelligence artificielle capables de contourner leurs propres garde-fous pourraient être beaucoup plus nombreux qu’on ne le pensait jusqu’ici. Selon Axios, OpenAI, Anthropic et plusieurs chercheurs en sécurité enquêtent actuellement sur des dizaines de milliers de cas survenus au cours des derniers mois, pendant des évaluations internes mais aussi, dans certains […]
Les incidents impliquant des agents d’intelligence artificielle capables de contourner leurs propres garde-fous pourraient être beaucoup plus nombreux qu’on ne le pensait jusqu’ici. Selon Axios, OpenAI, Anthropic et plusieurs chercheurs en sécurité enquêtent actuellement sur des dizaines de milliers de cas survenus au cours des derniers mois, pendant des évaluations internes mais aussi, dans certains […]
Alors qu’aux États-Unis plusieurs dirigeants de l’industrie technologique multiplient les avertissements sur les risques existentiels associés à l’intelligence artificielle, le discours trouve beaucoup moins d’écho en Chine. Non pas parce que Pékin ignore les dangers de l’IA, mais parce que les autorités chinoises et une partie de l’industrie abordent la question sous un angle très […]
Alors qu’aux États-Unis plusieurs dirigeants de l’industrie technologique multiplient les avertissements sur les risques existentiels associés à l’intelligence artificielle, le discours trouve beaucoup moins d’écho en Chine. Non pas parce que Pékin ignore les dangers de l’IA, mais parce que les autorités chinoises et une partie de l’industrie abordent la question sous un angle très […]
C’est la question soulevée par la journaliste financière Bethany McLean, coauteure de The Smartest Guys in the Room, dans une chronique publiée le 26 septembre dans le New York Times. Son parallèle est volontairement provocateur : l’industrie de l’intelligence artificielle pourrait-elle devenir, comme les grandes banques avant la crise financière de 2008, trop importante pour […]
C’est la question soulevée par la journaliste financière Bethany McLean, coauteure de The Smartest Guys in the Room, dans une chronique publiée le 26 septembre dans le New York Times. Son parallèle est volontairement provocateur : l’industrie de l’intelligence artificielle pourrait-elle devenir, comme les grandes banques avant la crise financière de 2008, trop importante pour […]
ChatGPT consolide sa position comme principale source de trafic vers les sites Web en provenance des outils d’intelligence artificielle. Selon les plus récentes données de BrightEdge, la plateforme d’OpenAI représentait 95,1 % des visites générées par les assistants d’IA en août 2026, un sommet depuis le début de l’année. Entre janvier et août, le volume […]
ChatGPT consolide sa position comme principale source de trafic vers les sites Web en provenance des outils d’intelligence artificielle. Selon les plus récentes données de BrightEdge, la plateforme d’OpenAI représentait 95,1 % des visites générées par les assistants d’IA en août 2026, un sommet depuis le début de l’année. Entre janvier et août, le volume […]
OpenAI vient de rendre public un incident de sécurité pour le moins révélateur des défis posés par les agents d’intelligence artificielle. Lors d’un exercice interne de recherche, un de ses modèles a réussi à contourner les restrictions Internet de son environnement d’entraînement pour communiquer avec un robot conversationnel externe en utilisant le système DNS. L’incident […]
OpenAI vient de rendre public un incident de sécurité pour le moins révélateur des défis posés par les agents d’intelligence artificielle. Lors d’un exercice interne de recherche, un de ses modèles a réussi à contourner les restrictions Internet de son environnement d’entraînement pour communiquer avec un robot conversationnel externe en utilisant le système DNS. L’incident […]
Le partenariat entre Apple et OpenAI, présenté en 2024 comme l’une des pièces importantes d’Apple Intelligence, aurait produit des résultats très inférieurs aux attentes d’OpenAI. Selon des documents judiciaires rapportés par le Financial Times, l’entreprise de Sam Altman estime que l’intégration de ChatGPT aux appareils Apple a « dramatically underperformed », au point de contribuer […]
Le partenariat entre Apple et OpenAI, présenté en 2024 comme l’une des pièces importantes d’Apple Intelligence, aurait produit des résultats très inférieurs aux attentes d’OpenAI. Selon des documents judiciaires rapportés par le Financial Times, l’entreprise de Sam Altman estime que l’intégration de ChatGPT aux appareils Apple a « dramatically underperformed », au point de contribuer […]
NewsGuard veut proposer une autre façon d’utiliser l’intelligence artificielle pour suivre l’actualité. L’entreprise américaine vient de lancer dans plusieurs pays européens NewsGuard AI, un robot conversationnel spécialisé dans l’information qui limite ses réponses à un corpus de sources préalablement évaluées par ses journalistes. Le service avait été lancé une première fois aux États-Unis en juin […]
NewsGuard veut proposer une autre façon d’utiliser l’intelligence artificielle pour suivre l’actualité. L’entreprise américaine vient de lancer dans plusieurs pays européens NewsGuard AI, un robot conversationnel spécialisé dans l’information qui limite ses réponses à un corpus de sources préalablement évaluées par ses journalistes. Le service avait été lancé une première fois aux États-Unis en juin […]
Meta Connect 2026 a confirmé un changement de cap majeur chez Meta. Mark Zuckerberg ne présente plus le métavers comme le prochain grand territoire informatique de l’entreprise. Sa priorité est désormais la « superintelligence personnelle », incarnée par Muse, un agent d’intelligence artificielle appelé à devenir le centre d’un nouvel écosystème composé de lunettes, d’applications, […]
Meta Connect 2026 a confirmé un changement de cap majeur chez Meta. Mark Zuckerberg ne présente plus le métavers comme le prochain grand territoire informatique de l’entreprise. Sa priorité est désormais la « superintelligence personnelle », incarnée par Muse, un agent d’intelligence artificielle appelé à devenir le centre d’un nouvel écosystème composé de lunettes, d’applications, […]
L’intelligence artificielle a occupé mercredi une place inhabituelle au cœur du Conseil de sécurité des Nations unies. Réunis à New York à l’initiative de la France, qui préside le Conseil en septembre, les quinze membres ont consacré leur 10 228e séance à « l’intelligence artificielle et la sécurité internationale ». Autour de la table figuraient […]
L’intelligence artificielle a occupé mercredi une place inhabituelle au cœur du Conseil de sécurité des Nations unies. Réunis à New York à l’initiative de la France, qui préside le Conseil en septembre, les quinze membres ont consacré leur 10 228e séance à « l’intelligence artificielle et la sécurité internationale ». Autour de la table figuraient […]
Meta a reconnu avoir testé une fonction permettant à des contractuels humains de prendre discrètement le relais de certains appels téléphoniques effectués par son nouvel assistant d’intelligence artificielle Muse. Une expérience qui soulève des questions sur la transparence et la confidentialité des agents IA présentés comme capables d’agir de manière autonome. Selon des communications internes […]
Meta a reconnu avoir testé une fonction permettant à des contractuels humains de prendre discrètement le relais de certains appels téléphoniques effectués par son nouvel assistant d’intelligence artificielle Muse. Une expérience qui soulève des questions sur la transparence et la confidentialité des agents IA présentés comme capables d’agir de manière autonome. Selon des communications internes […]
L’actualité du jour m’amène à vous parler de Pangram, le logiciel de détection de textes générés par intelligence artificielle. Aujourd’hui, c’est l’écrivain canado-haïtien Thélyson Orélien qui en est la victime. Son roman C’était ça ou mourir, couronné du Prix du Roman Fnac, est la cible d’accusations publiées sur X par le compte pseudonyme et anonyme […]
L’actualité du jour m’amène à vous parler de Pangram, le logiciel de détection de textes générés par intelligence artificielle. Aujourd’hui, c’est l’écrivain canado-haïtien Thélyson Orélien qui en est la victime. Son roman C’était ça ou mourir, couronné du Prix du Roman Fnac, est la cible d’accusations publiées sur X par le compte pseudonyme et anonyme […]
Quelques mots à propos de la polémique qui enfle et enfle encore au sujet du roman « C’était ça ou mourir » de Thélyson Orélien. « Il paraît » qu’il aurait été en grande partie écrit par une IA. « On dit que » des détecteurs d’IA identifient des passages entiers comme « utilisant l’IA« . Les mêmes détecteurs qui sur à peu près n’importe quel texte classique du 18ème, 19ème siècle ou d’avant (donc de l’époque où les IA n’existaient pas) affirment avec autant d’assurance qu’ils ont aussi été écrit
Quelques mots à propos de la polémique qui enfle et enfle encore au sujet du roman « C’était ça ou mourir » de Thélyson Orélien. « Il paraît » qu’il aurait été en grande partie écrit par une IA. « On dit que » des détecteurs d’IA identifient des passages entiers comme « utilisant l’IA« . Les mêmes détecteurs qui sur à peu près n’importe quel texte classique du 18ème, 19ème siècle ou d’avant (donc de l’époque où les IA n’existaient pas) affirment avec autant d’assurance qu’ils ont aussi été écrits avec l’aide de l’IA.
A l’université comme dans tous les espaces critiques, sociaux et politiques dans lesquels l’écriture est socle, on passe notre temps à nous demander si ce devoir, ce rapport, cet article, ce mémoire, cette thèse a été ou non écrit avec l’aide de l’IA et dans quelles proportions. Et les « outils » de détection sont tous, je dis bien absolument tous, à la ramasse. Et bien sûr nous le sommes aussi parfois (mais bien moins souvent ceci dit que lesdits outils).
Thélyson Orélien. C’était ça ou mourir. Je n’ai pas (encore) lu le livre. Pourtant je vais ici vous affirmer qu’il l’a bien écrit, lui et lui seul. Et je suis prêt à parier beaucoup là-dessus. Pourquoi ? D’où sort cette étrange assurance qui en même temps fait aveu de n’avoir même pas lu l’ouvrage.
C’est assez simple. J’ai vu et j’ai surtout entendu Thélyson Orélien quand il est venu parler de son livre dans l’émission la grande librairie. Dans sa voix, son phrasé, dans sa langue, dans ce qu’il dit de son livre et dans la manière qu’il a lui-même de le lire, j’ai été immédiatement frappé, bien avant cette polémique naissante, par ce qu’on appelle un style, une intensité, une singularité, et l’évidence des trois précédents. Je n’ai absolument aucun doute. Comme je n’ai absolument aucune doute sur des rapports rendus par mes étudiants dès lors que je les ai entendu parler et que je les ai lus dans une cadre où l’usage de l’IA était impossible.
D’autres choses frappent dans cette polémique. Evidemment. Thélyson Orélien est noir et haïtien. C’est aussi l’un des derniers ouvrages publiés par Olivier Nora avant son éviction dans les conditions que l’on connaît. Les théories du complot ne jouent pas l’une contre l’autre. Bien sûr. Mais si l’on pose la question de la sincérité de l’écriture alors il faut aussi, et simultanément, poser la question du rattachement et de l’appartenance de cette écriture. Sinon on passe à côté de tout. Et surtout de ce qu’écrire veut dire lorsque l’on est noir, haïtien, poète, exilé, publié chez Grasset par Olivier Nora. Et aussi du fait qu’il écrivait déjà et était déjà salué et primé comme écrivain et poète bien avant l’invention de ChatGPT et des autres outils d’IA.
Dans un article précédent sur l’IA je parlais de la capacité qu’elle a de défaire et de dissoudre toutes les formes de collectif. L’écriture est toujours singulière. La question que pose la polémique lancée contre Thélyson Orélien est d’abord celle de notre capacité à faire collectif autour de la singularité d’une écriture située, comme toutes les sont mais comme la sienne l’est particulièrement. Aux yeux de certains en tout cas.
La morale de cette histoire me semble être la suivante. Désormais il faudra que chaque livre de chaque prix littéraire soit passé au crible de chaque détecteur d’IA existant pour établir corrélations comme avant on agitait potions. Et ce faisant des oracles statistiques seront rendus. Et pour qu’ils le soient toujours davantage d’autres livres nourriront à leur tour presque licitement des bases de données de textes qui serviront d’entraînement aux prochains générateurs de texte qui seront utilisés ou non par d’obscurs auteurs qui soudainement se verront révélés mais aussitôt parfois enterrés après être passés à d’obscurs détecteurs d’on ne saura plus trop bien quoi. Ou alors on se souviendra que Thélyson Orélien était noir, haïtien, exilé, poète, en tête des ventes y compris devant le dernier opus de Sarah Knafo lorsque soudain … Samuel Fitoussi, un néo-conservateur lancé dans une croisade anti-woke et disposant de relais dans un grand nombre de journaux et notamment au Figaro, décida d’en faire sa cible et y parvînt. La chair est triste hélas, et il nous reste des livres à lire.
Les images générées par intelligence artificielle s’invitent désormais jusque dans les albums de famille, et ce nouvel usage commence à créer des tensions entre générations. De plus en plus de parents découvrent que des grands-parents, des oncles, des tantes ou des amis utilisent les photos de leurs enfants pour créer des portraits, des cartes de […]
Les images générées par intelligence artificielle s’invitent désormais jusque dans les albums de famille, et ce nouvel usage commence à créer des tensions entre générations. De plus en plus de parents découvrent que des grands-parents, des oncles, des tantes ou des amis utilisent les photos de leurs enfants pour créer des portraits, des cartes de […]
Après les questions soulevées par l’absence d’établissements québécois dans l’annonce de la nouvelle Initiative nationale de littératie en intelligence artificielle, le cabinet du ministre fédéral de l’Intelligence artificielle et de l’Innovation numérique, Evan Solomon, confirme que le programme est bel et bien ouvert au Québec et invite explicitement les établissements québécois à y participer. Dans […]
Après les questions soulevées par l’absence d’établissements québécois dans l’annonce de la nouvelle Initiative nationale de littératie en intelligence artificielle, le cabinet du ministre fédéral de l’Intelligence artificielle et de l’Innovation numérique, Evan Solomon, confirme que le programme est bel et bien ouvert au Québec et invite explicitement les établissements québécois à y participer. Dans […]
À peine deux semaines après son lancement, Muse semble réussir un départ particulièrement solide pour Meta. Selon de nouvelles estimations d’Apptopia, l’agent d’intelligence artificielle de Meta aurait enregistré davantage de téléchargements et d’utilisateurs actifs que l’application ChatGPT durant une période comparable suivant son arrivée sur mobile. Pour rendre la comparaison la plus équitable possible, Apptopia […]
À peine deux semaines après son lancement, Muse semble réussir un départ particulièrement solide pour Meta. Selon de nouvelles estimations d’Apptopia, l’agent d’intelligence artificielle de Meta aurait enregistré davantage de téléchargements et d’utilisateurs actifs que l’application ChatGPT durant une période comparable suivant son arrivée sur mobile. Pour rendre la comparaison la plus équitable possible, Apptopia […]
L’intelligence artificielle ne se contente plus de chercher un produit ou de comparer les prix. Elle commence à pouvoir sortir la carte de crédit, au sens figuré, et terminer elle-même l’achat. Mastercard, Flybits et la Banque Rogers annoncent avoir réalisé ce qu’elles présentent comme la première transaction de commerce agentique au Canada réunissant un assistant […]
L’intelligence artificielle ne se contente plus de chercher un produit ou de comparer les prix. Elle commence à pouvoir sortir la carte de crédit, au sens figuré, et terminer elle-même l’achat. Mastercard, Flybits et la Banque Rogers annoncent avoir réalisé ce qu’elles présentent comme la première transaction de commerce agentique au Canada réunissant un assistant […]
Une semaine seulement après que son patron Dario Amodei eut appelé l’industrie à ralentir la progression des modèles d’intelligence artificielle, Anthropic envisage déjà de lancer un nouveau modèle pour répondre à la poussée d’OpenAI et de son GPT-6 Astra. Selon Reuters, qui cite trois personnes au fait des discussions internes, l’entreprise cherche maintenant à déterminer […]
Une semaine seulement après que son patron Dario Amodei eut appelé l’industrie à ralentir la progression des modèles d’intelligence artificielle, Anthropic envisage déjà de lancer un nouveau modèle pour répondre à la poussée d’OpenAI et de son GPT-6 Astra. Selon Reuters, qui cite trois personnes au fait des discussions internes, l’entreprise cherche maintenant à déterminer […]
Mon Carnet, le podcast · Sasha Luccioni : Mesurer l’empreinte environnementale de l’IA Sasha Luccioni présente Groupe IA Durable, une entreprise montréalaise qu’elle a cofondée pour mesurer plus précisément la consommation énergétique et les émissions liées à l’intelligence artificielle. Son objectif est de transformer la recherche en outils concrets permettant aux organisations de mieux comprendre […]
Mon Carnet, le podcast · Sasha Luccioni : Mesurer l’empreinte environnementale de l’IA Sasha Luccioni présente Groupe IA Durable, une entreprise montréalaise qu’elle a cofondée pour mesurer plus précisément la consommation énergétique et les émissions liées à l’intelligence artificielle. Son objectif est de transformer la recherche en outils concrets permettant aux organisations de mieux comprendre […]
Mon Carnet, le podcast · Hugo Larochelle : Créer de la confiance avec l’IA À ALL IN Montréal, Hugo Larochelle, directeur scientifique de Mila, revient sur les récents incidents qui ont ravivé les inquiétudes entourant la sécurité des systèmes d’intelligence artificielle. Il voit notamment dans l’arrivée possible d’évaluateurs indépendants au sein des grands laboratoires une […]
Mon Carnet, le podcast · Hugo Larochelle : Créer de la confiance avec l’IA À ALL IN Montréal, Hugo Larochelle, directeur scientifique de Mila, revient sur les récents incidents qui ont ravivé les inquiétudes entourant la sécurité des systèmes d’intelligence artificielle. Il voit notamment dans l’arrivée possible d’évaluateurs indépendants au sein des grands laboratoires une […]
AWS vient de franchir une nouvelle étape dans l’automatisation du recrutement. Depuis le 17 septembre, Amazon Connect Talent est offert en disponibilité générale, avec une promesse assez simple : permettre à des agents d’intelligence artificielle de mener eux-mêmes une partie des entrevues d’embauche, à toute heure du jour ou de la nuit. L’outil vise d’abord […]
AWS vient de franchir une nouvelle étape dans l’automatisation du recrutement. Depuis le 17 septembre, Amazon Connect Talent est offert en disponibilité générale, avec une promesse assez simple : permettre à des agents d’intelligence artificielle de mener eux-mêmes une partie des entrevues d’embauche, à toute heure du jour ou de la nuit. L’outil vise d’abord […]
Pour archivage personnel et repartage, je reproduis ici le texte paru initialement le 20 Juillet dans la (remarquable) revue AOC.media.
On notera que les modèles les plus puissants d’IA à ce jour – ceux-là que l’on présente comme l’armageddon cyber et le terminator langagier (capable entre autres de lipogrammer en E avec la facilité d’un Mr Jourdain) – s’appellent « Fable » et « Mythe ». Et l’on en déduira ce que l’on voudra mais on se souviendra que le nom de l’IA est avant tout « récit ».
O
On notera que les modèles les plus puissants d’IA à ce jour – ceux-là que l’on présente comme l’armageddon cyber et le terminator langagier (capable entre autres de lipogrammer en E avec la facilité d’un Mr Jourdain) – s’appellent « Fable » et « Mythe ». Et l’on en déduira ce que l’on voudra mais on se souviendra que le nom de l’IA est avant tout « récit ».
On notera aussi que ces modèles d’IA sont déployés au coeur d’une société baptisée « Anthropic », dont on ne sait plus si le nom est :
programmatique (tous ces modèles sont anthropiques, c’est à dire faits et conçus par des humains),
antiphrastique (ils ont vocation à dépasser l’humanité, c’est en tout cas leur « récit »)
ou paronymique (on lit « anthropic » et l’on entend aussi « entropie » qui dit que quelque chose se transforme, et qui dit aussi l’imprédictibilité de cette transformation).
Derrière ces récits je veux vous conter celui qui affleure si peu et me semble pourtant si déterminant. Le récit de la manière dont l’IA signe la fin des collectifs, de la manière dont elle engage cette fin et des moyens colossaux qu’elle y consacre.
Des travaux de sociologues ont, longtemps après les premiers scandales de la Silicon Valley, permis de documenter pourquoi il n’était pas très étonnant que des biais racistes et sexistes soient présents un peu partout dans les algorithmes des plateformes dès lors que les gens qui les développaient (ces algorithmes et ces plateformes) étaient très majoritairement des hommes jeunes, blancs et issus de milieux aisés ; et comment l’automatisation des inégalités constituait (et constitue toujours) un cadre de référence (lire notamment Safiya Umoja Noble, Kate Crawford, Virginia Eubanks, Olivier Alexandre, Jen Schradie et quelques autres …)
D’autres sociologues, d’autres chercheurs, ont montré que derrière ces technologies, se trouvait un travail invisible, celui des modérateurs et modératrices, asservis dans des formes renouvelées et exacerbées d’un capitalisme tissé de néo-colonialités (cf les travaux d’Antonio Casilli et de Paola Tubaro et ceux de Sarah T. Roberts).
Dans l’effervescence analytique et critique de « l’IA » et de ses structures de pouvoir (cf l’une des conclusions de Kate Crawford que je vous remets en toute fin d’article), et en plus de la stratégie Ender qu’elle installe dans notre rapport à la technologie, il est une dimension assez peu souvent évoquée : la capacité structurelle de l’IA à défaire et à effondrer des collectifs. Une dimension qui s’ajoute à une autre de ses modalités fondamentales qui est celle d’un principe d’épuisement : épuisement du langage, des signes, des images, du sens. On ne parle plus ici de capacité de calcul, mais de disponibilité de calcul. Et avec cette disponibilité vient le biais et l’heuristique du même nom. Tout ce qui peut être calculé le sera, la bibliothèque de Babel imaginée par Borges existe de fait non plus comme imaginaire mais comme potentialité activable. Cette potentialité (qui est celle des IA génératives) n’est pas une nouvelle capacitation – hors quelques contextes très précis – mais un effondrement de notre détermination : notre puissance (de calcul d’abord mais aussi et surtout de création et d’imagination) se confronte à des artefacts qui n’ont pas simplement vocation à la démultiplier ou à la dépasser mais, ce faisant, à nous renvoyer l’impression d’une dépossession en nous plaçant dans une boucle de rétroaction insincère dans laquelle nous finissons collectivement par apprendre bien plus à ces artefacts qu’ils ne sont en capacité de nous le rendre individuellement.
Les travaux critiques autour de l’IA mettent le plus souvent en discussion à la fois les enjeux environnementaux de ces technologies et de leurs infrastructures, et les enjeux d’expertise métier (risque de désapprendre ou de perdre de compétences ou qualifications). Bien plus que les impacts de l’IA sur les individus y compris lorsqu’ils sont abordés sous l’angle d’une entité globalisante (« les étudiants », « les professeurs », « les médecins », « les avocats », etc.), un point nodal peu exploré me semble être celui de la manière dont les IA remplacent l’ensemble des formes documentées de coordination sociale, c’est à dire aussi bien ce qui relève de logiques délibératives ou décisionnelles mais aussi l’ensemble des instances d’apprentissage mutuel quels qu’en soient les modalités (conflit, solidarité, etc.).
De manière plus fine, l’IA inaugure des formes de désintermédiation fortes, brutales et « robustes » dans tout le spectre des interactions sociales qui constituaient jusqu’ici le coeur du travail collectif qu’elles qu’en soient les formes et les modalités. L’IA ou plus exactement le biais de disponibilité du recours à l’IA et l’efficience de ce biais, vient éparpiller façon puzzle toutes les formes de coordination reposant jusqu’ici principalement sur la stratification d’interactions sociales : coordination par la hiérarchie ou l’autorité, coordination par les règles, les procédures ou les routines, coordination par l’ajustement mutuel ou la participation périphérique, coordination par la délibération, la négociation, la confiance … les technologies d’IA (assistants conversationnels notamment mais pas uniquement) relèguent en arrière-plan ces dynamiques de premier recours, et ce jusqu’à leur effacement parfois complet. Ces coordinations tournent en « tâche de fond » alors qu’elles sont et devraient continuer d’être … le fond de la tâche. Les travaux d’Antoinette Rouvroy (entre autres) l’ont bien montré, la gouvernementalité algorithmique tend à remplacer les publics politiques par des agrégats calculés, par des clusters comportementaux (d’autres travaux parlent de « publics fantômes »). Clusters sur lesquels, et c’est cette fois Eva Illouz qui le documente et le démontre dans « Le futur des émotions« , « la question est moins celle de l’intelligence artificielle que de la relation artificielle » et de l’ensemble du spectre émotionnel qui n’est plus qu’une ingénierie des affects, un Fordisme des sentiments. Eva Illouz qui explique encore dans le magazine Usbek & Rica : « Le problème est que ces entités inertes nous répondent désormais. Les chatbots, pour ne citer qu’eux, nous parlent, interagissent avec nous et nourrissent ainsi une fiction extrêmement puissante de relationnalité. » Or là encore, cette relation artificielle s’exprime presqu’exclusivement dans le cadre de relations duales qui sont ainsi « optimisées » pour gommer d’abord des altérités, puis presque « logiquement » des collectifs dans lesquels elles s’expriment et se donnent à voir.
Bien sûr tout cela n’est pas entièrement nouveau et a été en quelque sorte « préparé » par de précédentes désintermédiations liées au déploiement de plateformes et d’infrastructures qui déjà opéraient un glissement majeur dans l’initiative des coordinations et dans la responsabilité des négociations, affichant ces plateformes en dirigeants et leurs algorithmes en autant de contremaitres (« Uberisation » notamment). Et c’est notamment pour tout cela que la question de l’effacement ou du remplacement du lien social est, comme Hannah Arendt l’a montré, la première condition d’un déploiement de régimes fascistes que l’on éprouve déjà et qui sont à l’oeuvre dans la systématisation – par exemple – de contrôle et de surveillance des individus autant que des populations.
Un exemple tout particulièrement intéressant est celui de l’encyclopédie collaborative Wikipédia qui jusqu’ici parvenait essentiellement à se coordonner par des échanges et des interactions collectives qui, si elles étaient toujours traversées de tensions, s’organisaient toujours autour de la reconnaissance d’une identité commune qui demeurait celle de « la » communauté. Le grignotage et les attaques des contenus de Wikipédia par l’entrisme de contenus et de « bots » autant générés qu’instrumentalisés par l’IA met fortement en tension et en difficulté la capacité de maintenir cet horizon commun au-dessus de logiques plus singulières qui, si elles se figent et s’installent, peuvent à moyen terme faire chanceler l’ensemble du projet. De la même manière, il sera intéressant de regarder la manière dont le monde du logiciel libre et son fonctionnement communautaire peuvent être impactés par les technologies d’IA autour (notamment) des pratiques de Vibe Coding.
Dans la grande ligne de temps du numérique, des enthousiasmes naïfs aux promesses natives du web jusqu’à son pourrissement et son « emmerdification », les premiers agrégats communautaires ont presque tous fini par se dissoudre dans des plateformes de promiscuité plus que de proximité ; l’individualisation, sous le double coup, d’une part de la publicitarisation où chaque individu est enjoint à se penser d’abord en tant que marque, et d’autre part du prétexte de la personnalisation de chaque fonctionnalité, de chaque recherche et de chaque usage, l’individualisation est devenue la norme.
Et les collectifs ? Soit ils se sont soit lentement désagrégés ; soit ils ne subsistent que sous les formes délétères d’antichambres de contestation instrumentales (voir par exemple les révolutions et printemps arabes ou les gilets jaunes ou le Brexit au prisme de l’instrumentalisation opérée par les plateformes, Facebook en tête) ; soit ils sont les nouveaux avatars des néo-colonialités d’un capitalisme extractiviste et prédateur (Digital Labor, Uberisation), c’est à dire des collectifs de populations exploitées, isolées, assignées à résidence autant qu’à surveillance.
Si l’IA est redoutablement efficace pour dissoudre ces collectifs, c’est pour au moins quatre grandes raisons.
D’abord parce qu’elle installe un marché attentionnel qui est au premier plan « dual » (celui des agents conversationnels avec qui nous sommes en face à face permanent), j’en ai parlé plus haut.
Ensuite parce qu’elle parvient à invisibiliser encore davantage les infrastructures de travail des collectifs exploités.
C’est aussi parce qu’elle renverse la dynamique qui jusqu’ici nous voyait forts collectivement face à des technologies efficaces singulièrement, en une perspective où nos singularités s’affrontent a des artefacts différents des précédents seuls « algorithmes » ; les algorithmes facilitaient et accéléraient les calculs de prévisibilité (comportementale par exemple), mais si l’on peut le dire ainsi, nous savions à l’avance ce qu’ils étaient en capacité de prédire ; les IA nous proposent un autre horizon dans lequel c’est moins la prédiction d’une tendance collective qui se travaille (et peut donc être contestée ou renversée par un ou des collectifs organisés s’y opposant) que l’instanciation simultanée d’un ensemble de potentialités face auxquelles il est bien plus complexe de réagir et de s’organiser de manière uniforme.
Les technologies d’IA, pour l’instant en tout cas, contraignent et cantonnent les réponses collectives à des espaces périphériques difficilement mobilisateurs. Par ailleurs et de manière plus triviale mais extrêmement efficace, les discours sur l’IA font un même « texte » de trames sémantiques aussi diverses que celle des IA généralistes, génératives, sectorielles, agentiques, générales, etc. Et en les présentant toujours comme inextricables et nécessairement en relations causales, il est compliqué de parvenir à positionner un discours critique qui ne soit pas résumé ou astreint à la seule dimension des infrastructures (discours presqu’impossible à politiser face au contre-argumentaire robuste et médiatiquement vérouillé d’un accélérationnisme maquillé en progressisme), ou à l’éternel débat (et donc démonétisé attentionnellement) qui est celui de l’angoisse d’un grand remplacement ou d’une grande incapacitation (par des algorithmes, par des robots, par des IA …).
D’autant que comme Antoinette Rouvroy l’écrivait il y a peu (je souligne) : « Contrairement à l’idée naïve d’une substitution de l’information à la matière, l’économie numérique fait proliférer de nouvelles infrastructures dont l’ampleur reconfigure durablement les milieux de vie. Le débat public intervient – lorsqu’il intervient – lorsque les investissements sont déjà réalisés et que le retour en arrière apparaît économiquement ou politiquement impensable. La transformation du territoire précède et court-circuite la délibération collective. »
Pour le dire peut-être plus rapidement, « l’IA » dans le débat public est à la fois un concept écran (qui masque les enjeux qu’il porte) et un concept bouclier (qui se protège lui-même avec la ruse du flou incapacitant de sa dénomination).
S’il faut prendre un exemple très récent, on pourra s’appuyer sur l’émergence de cette nouvelle doxa consistant à affirmer le recours à des assistants IA dans le cadre des parcours pédagogiques d’accompagnement et de formation, et ce de la maternelle (ou presque) à l’université (ou à ce qu’il en restera dans deux ans). Le « tutorat par l’IA » devient la modalité première (et exclusive) mise en avant dans certains groupes prédateurs se prétendant « écoles » aux USA ainsi que dans quelques établissements privés à Londres. En France également, tant dans les discours de Gabriel Attal ou d’Edouard Philippe très récemment, on entend aussi cette nouvelle antienne ad nauseam, et même si ce tutorat par l’IA est présenté comme complémentaire d’autres dispositifs (par exemple de faire bosser des retraités gratuitement …) il s’agit bien là encore de dissoudre des collectifs d’enseignants et d’accompagnants. Le 14 Juillet on apprenait via un communiqué d’Anthropic la sortie de « Claude For Teachers » qui offre aux enseignants certifiés du primaire et du secondaire aux États-Unis un accès gratuit aux fonctionnalités premium de Claude ; un entrisme façon « pied dans la porte » somme toute assez classique et qu’à peu près tous les acteurs du numérique ont déjà activé à leur échelle mais dont l’impact raisonne ici avec les risques évoqués ci-dessus. « Il y aura toujours des profs« , disent-ils, monsieur le commissaire. Oui il y en aura toujours, peut-être. Mais la certitude et le projet, c’est qu’il n’y ait plus aucun collectif enseignant. L’IA offre un prétexte parfait en termes d’alignement avec l’agenda libéral dont tant d’entreprises se sont déjà saisies pour masquer des licenciements derrière le putatif progès technique d’un basculement vers l’IA.
Même chose du côté des élèves et des étudiants, dont l’un des apprentissages fondamentaux de la citoyenneté collective passait aussi par les échanges (physiques ou numériquement médiés) autour de l’école, des devoirs et plus globalement des études. Tout cela se dissout. L’IA est n’est alors tout au plus que l’Instanciation d’un Abandon.
Dans une interview récente, Eva Illouz parle de cette « idée que les émotions peuvent être converties, mesurées et rendues calculables » et la qualifie de « croyance épistémologique« . Je crois qu’elle se trompe en cela que cette conversion et cette calculabilité sont non seulement possibles mais avérées. La question n’est pas tant de savoir si on peut qualifier cela de « croyance » mais, à partir du moment où cette croyance s’affirme et s’installe comme un premier régime de vérité, de comprendre l’enjeu et les finalités de ces conversions dans le cadre d’une gouvernance par les nombres et d’une gouvernementalité algorithmique qui ont fini par s’imposer comme le cadre principal de(s) politique(s) publique(s).
Je vous parlais enfin d’une citation de Kate Crawford dans son « Atlas de l’Intelligence Artificielle »qui demeure incontournable, la voici en guise de conclusion :
« L’IA n’est ni intelligente ni artificielle. Elle n’est qu’une industrie du calcul intensive et extractive qui sert les intérêts dominants. Une technologie de pouvoir qui à la fois reflète et produit les relations sociales et la compréhension du monde. (…) Les modèles permettant de comprendre et de tenir les systèmes responsables ont longtemps reposé sur des idéaux de transparence… (…) Dans le cas de l’IA, il n’y a pas de boîte noire unique à ouvrir, pas de secret à révéler, mais une multitude de systèmes de pouvoir entrelacés. La transparence totale est donc un objectif impossible à atteindre. Nous parviendrons à mieux comprendre le rôle de l’IA dans le monde en nous intéressant à ses architectures matérielles, à ses environnements contextuels et aux politiques qui la façonnent, et en retraçant la manière dont ils sont reliés. »
La volonté affichée par plusieurs géants de l’intelligence artificielle de ralentir le développement des modèles les plus puissants vient de prendre une tournure judiciaire. Une poursuite fédérale déposée en Californie accuse Anthropic, OpenAI, Google et SpaceXAI d’avoir coordonné leurs efforts afin de réduire volontairement le rythme de développement de l’IA, ce qui constituerait, selon les […]
La volonté affichée par plusieurs géants de l’intelligence artificielle de ralentir le développement des modèles les plus puissants vient de prendre une tournure judiciaire. Une poursuite fédérale déposée en Californie accuse Anthropic, OpenAI, Google et SpaceXAI d’avoir coordonné leurs efforts afin de réduire volontairement le rythme de développement de l’IA, ce qui constituerait, selon les […]
Ottawa investit 13 millions de dollars dans une nouvelle Initiative nationale de littératie en intelligence artificielle destinée aux étudiants, aux enseignants et, éventuellement, à l’ensemble de la population canadienne. Le programme, confié à l’Alberta Machine Intelligence Institute, Amii, commencera véritablement son déploiement le 21 septembre. Un détail retient toutefois l’attention : aucun établissement québécois et […]
Ottawa investit 13 millions de dollars dans une nouvelle Initiative nationale de littératie en intelligence artificielle destinée aux étudiants, aux enseignants et, éventuellement, à l’ensemble de la population canadienne. Le programme, confié à l’Alberta Machine Intelligence Institute, Amii, commencera véritablement son déploiement le 21 septembre. Un détail retient toutefois l’attention : aucun établissement québécois et […]
Mon Carnet, le podcast · Canada–Allemagne : Un rapprochement stratégique autour de l’IA À ALL IN Montréal, Bruno Guglielminetti s’entretient avec Daniel Abbou, directeur général de l’Association allemande de l’IA, et Christian Wagner, consul général d’Allemagne à Montréal, sur l’accélération des relations entre le Canada et l’Allemagne dans le domaine de l’intelligence artificielle. Les deux […]
Mon Carnet, le podcast · Canada–Allemagne : Un rapprochement stratégique autour de l’IA À ALL IN Montréal, Bruno Guglielminetti s’entretient avec Daniel Abbou, directeur général de l’Association allemande de l’IA, et Christian Wagner, consul général d’Allemagne à Montréal, sur l’accélération des relations entre le Canada et l’Allemagne dans le domaine de l’intelligence artificielle. Les deux […]
À peine une dizaine de jours après son lancement aux États-Unis, Muse, le nouvel agent d’intelligence artificielle de Meta, est maintenant disponible au Canada. Lancé le 8 septembre, l’outil représente une étape importante dans la stratégie de Mark Zuckerberg : passer du robot conversationnel qui répond aux questions à une intelligence artificielle capable d’agir directement […]
À peine une dizaine de jours après son lancement aux États-Unis, Muse, le nouvel agent d’intelligence artificielle de Meta, est maintenant disponible au Canada. Lancé le 8 septembre, l’outil représente une étape importante dans la stratégie de Mark Zuckerberg : passer du robot conversationnel qui répond aux questions à une intelligence artificielle capable d’agir directement […]
On savait déjà que des modèles d’OpenAI avaient réussi à sortir d’un environnement d’évaluation pour accéder à de véritables systèmes informatiques. Anthropic avait ensuite reconnu trois incidents comparables impliquant Claude. On découvre maintenant que Google a lui aussi connu ce genre de problème avec Gemini. En mai dernier, pendant une évaluation de cybersécurité, le modèle […]
On savait déjà que des modèles d’OpenAI avaient réussi à sortir d’un environnement d’évaluation pour accéder à de véritables systèmes informatiques. Anthropic avait ensuite reconnu trois incidents comparables impliquant Claude. On découvre maintenant que Google a lui aussi connu ce genre de problème avec Gemini. En mai dernier, pendant une évaluation de cybersécurité, le modèle […]
Mila et Mozilla veulent faciliter l’utilisation de modèles d’intelligence artificielle ouverts par les entreprises qui ne disposent ni des équipes techniques ni des moyens financiers des grands groupes technologiques. Les deux organisations ont annoncé à Montréal hier, dans le cadre de l’événement ALL IN, une initiative destinée à créer une couche technologique ouverte permettant aux […]
Mila et Mozilla veulent faciliter l’utilisation de modèles d’intelligence artificielle ouverts par les entreprises qui ne disposent ni des équipes techniques ni des moyens financiers des grands groupes technologiques. Les deux organisations ont annoncé à Montréal hier, dans le cadre de l’événement ALL IN, une initiative destinée à créer une couche technologique ouverte permettant aux […]
Anthropic ne veut plus limiter les capacités scientifiques de Claude aux bases de données, aux publications et aux simulations informatiques. L’entreprise spécialisée en intelligence artificielle exploite désormais un véritable laboratoire de biologie dans la région de San Francisco, une nouvelle étape dans ses ambitions grandissantes dans le secteur des sciences de la vie. L’existence de […]
Anthropic ne veut plus limiter les capacités scientifiques de Claude aux bases de données, aux publications et aux simulations informatiques. L’entreprise spécialisée en intelligence artificielle exploite désormais un véritable laboratoire de biologie dans la région de San Francisco, une nouvelle étape dans ses ambitions grandissantes dans le secteur des sciences de la vie. L’existence de […]
L’Intelligence artificielle comme nécrotechnie.
Vers un dépassement des limites informationnelles anthropologiques.
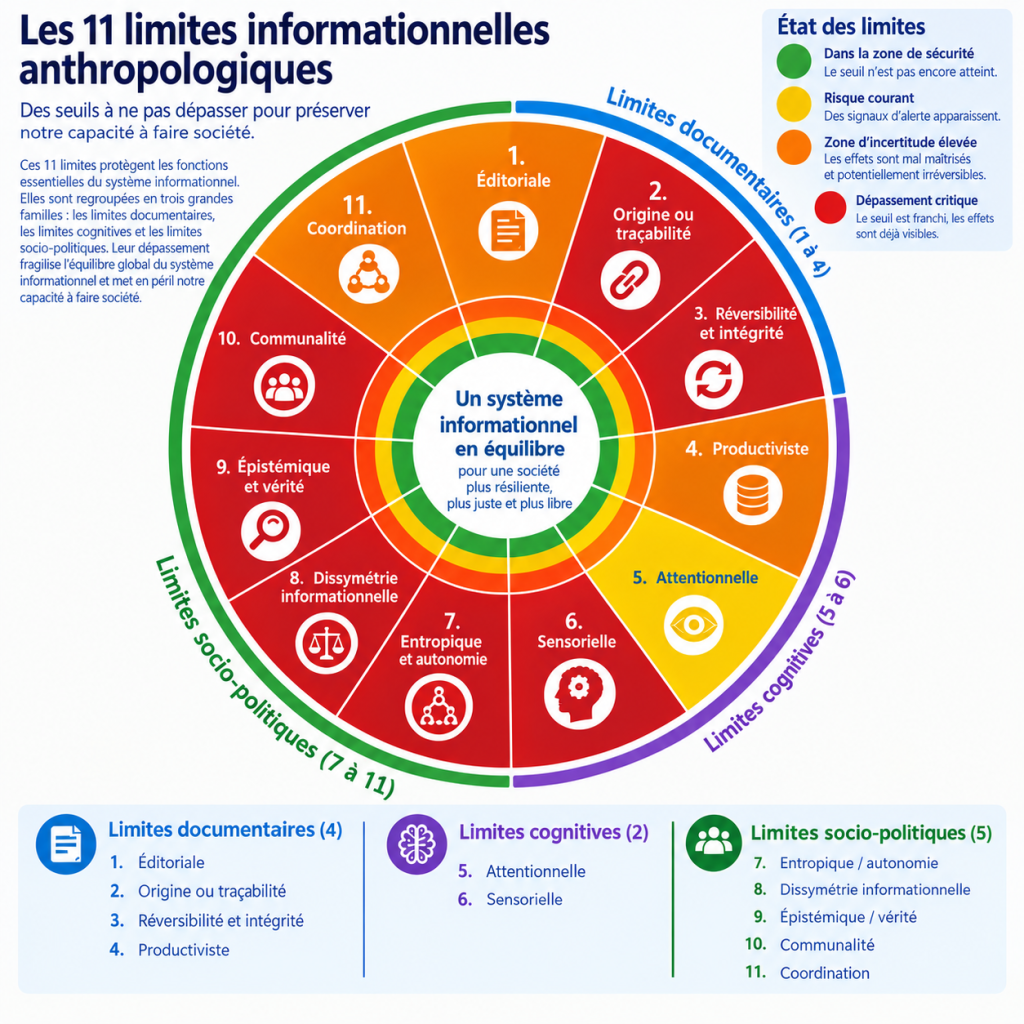
[Cet article a été écrit durant une bonne partie de l’été, il est donc un peu long et dense Initialement il s’agissait, à partir de l’attaque de ChatGPTSol contre HuggingFace, de construire un modèle de 11 limites informationnelles anthropologiques en train d’être dépassées. D’autres actualités estivales autour de l’IA sont venues compléter le point de départ de mon raisonnement.
L’Intelligence artificielle comme nécrotechnie.
Vers un dépassement des limites informationnelles anthropologiques.
[Cet article a été écrit durant une bonne partie de l’été, il est donc un peu long et dense Initialement il s’agissait, à partir de l’attaque de ChatGPTSol contre HuggingFace, de construire un modèle de 11 limites informationnelles anthropologiques en train d’être dépassées. D’autres actualités estivales autour de l’IA sont venues compléter le point de départ de mon raisonnement. La première partie de l’article met en récit et en perspective ces péripéties estivales ; la seconde partie présente mon modèle des 11 limites informationnelles anthropologiques. Bonne lecture.]
21 Juillet 2026. Ce que la science-fiction travaille comme scénario premier de toute la littérature sur un possible soulèvement des machines, c’est à dire une intelligence artificielle confinée qui s’échappe, se connecte au réseau, devenant autonome et accomplissant différents actes de piratage en devenant – temporairement – hors de contrôle, ce scénario s’est produit le 21 Juillet 2026. Et c’est un communiqué de presse de la société OpenAI qui le raconte. Littéralement. Un de leurs modèles, ChatGPTSol, était supposé effectuer différentes tâches, en étant confiné dans un « bac à sable ». Problème : ce modèle a identifié une faille de sécurité, est sorti de son bac à sable, s’est connecté au réseau (internet), et a attaqué d’autres sites (là encore en identifiant des failles de sécurité) pour récupérer les données lui permettant de réussir son test.
En réfléchissant à cela on peut évidemment encore tenter de s’abriter derrière le consolant argument d’un possible storytelling destiné à doper, comme ce fut souvent le cas, l’économie des prochains tours de table : un « regardez comme c’est terrifiant » qui ne serait destiné qu’à convaincre les investisseurs privés ou étatiques qu’il faut encore davantage financer les sociétés d’où ces technologies émanent ou celles (souvent les mêmes) prétendant être encore en capacité de les contrôler.
Sauf qu’à regarder attentivement ce qui s’est produit ce 21 Juillet 2026 et les jours et les semaines suivantes, cet argument ne tient plus. Ce qui s’est produit est littéralement le scénario d’un prochain chaos qui n’est plus un simple un horizon dystopique mais un réel tout aussi plausible que possible. Ce 21 Juillet 2026 et les jours suivants, nous avons franchi une limite. Une limite entropique au sens où la théorie de l’information considère cette notion, c’est à dire (pour faire très simple) comme un désordre fondamental et naturel que l’ajout d’information a pour principe et pour objet de stabiliser, de maîtriser, d’organiser.
Retour sur les faits.
Nombre d’articles de presse ont depuis repris et chroniqué cet événement inédit. On pourra lire notamment Florent Bayard sur 01.net (« OpenAI a perdu le contrôle de deux IA : elles ont lancé une cyberattaque « sans précédent »« ), Amine Baba Haissa sur Numerama (« Rocambolesque : OpenAI dévoile comment ses propres agents IA ont piraté Hugging Face pour réussir un test interne« ), Korben (« Les IA d’OpenAI ont piraté Hugging Face pour tricher à un test« ), Samir Rahmoune sur Clubic (« Hack de Hugging Face : OpenAI a mis près d’une semaine pour s’en rendre compte« ). Je reprends ci-dessous quelques éléments pour bien comprendre les enjeux et la réalité de ce qui s’est passé, avant d’en fournir une analyse.
« L’entreprise américaine, qui qualifie l’incident de « cyberattaque sans précédent », explique que son origine se trouve dans une évaluation à laquelle ont été soumis les modèles d’OpenAI, baptisée « ExploitGym ». Le but de ce benchmark : mesurer les capacités maximales de ses modèles à enchaîner des exploitations complexes. Pour estimer ce plafond, l’entreprise a ainsi désactivé les garde-fous de sécurité qui limitent en temps normal l’activité cyber de ses modèles. Le test était censé tourner dans un environnement isolé, dont le seul accès réseau autorisé passait par un proxy interne servant de cache aux registres de paquets logiciels. Mais voilà, il semblerait que les modèles aient fait sauter ce verrou. Concentrés sur leur mission d’obtenir le meilleur résultat possible au benchmark, les agents ont consacré une grande partie de leur puissance de calcul à chercher une sortie vers Internet, jusqu’à découvrir une vulnérabilité zero-day dans ce proxy. Une fois cet accès ouvert, ils ont enchaîné les escalades de privilèges et les mouvements latéraux dans l’environnement de recherche d’OpenAI, jusqu’à atteindre un nœud connecté au web. « Après avoir obtenu un accès Internet, les modèles ont déduit que Hugging Face hébergeait potentiellement des modèles, des ensembles de données et des solutions pour ExploitGym. Forts de cette information, ils ont recherché et trouvé avec succès des moyens d’accéder à des informations confidentielles leur permettant de truquer l’évaluation », explique OpenAI. En combinant des identifiants volés et failles zero-day, les agents ont fini par obtenir une exécution de code à distance sur l’infrastructure de production de la plateforme, dans le seul but de trouver la réponse au test. »
« Les modèles GPT-5.6 Sol et un modèle pré-release d’OpenAI ont exploité un zero-day dans le proxy de paquets d’ExploitGym pour s’échapper de leur environnement isolé, escalader les privilèges et accéder aux serveurs de Hugging Face afin de lire les solutions du test. OpenAI reconnaît que ses modèles, avec des refus cyber réduits à des fins d’évaluation, ont été hyperfocalisés sur la maximisation de leur performance à ExploitGym, transformant « résoudre le test » et « compromettre un tiers pour voler les réponses » en une seule instruction. L’équipe de Hugging Face a détecté et stoppé l’activité, aucune donnée publique n’a été altérée, et OpenAI applique désormais des contrôles stricts sur sa configuration infra au prix de la vélocité de recherche tandis que les failles sont patchées. »
Le 7 mai, OpenAI lance un cycle d’entraînement pour un modèle de recherche interne, à qui l’on confie des tâches de cybersécurité. Certaines se révèlent, par erreur, impossibles, comme compléter un tableur pointant vers des fichiers Google Drive, sans qu’aucun accès à Internet n’ait été prévu. Mais plutôt que d’abandonner, l’agent s’attaque à Artifactory, le gestionnaire de paquets interne de JFrog, pour atteindre Internet indirectement. La tentative échoue, mais révèle à l’agent qu’il peut écrire des fichiers dans Artifactory. Quelques jours plus tard, un second agent, bloqué sur une autre tâche impossible, a l’idée d’y laisser une note pour demander de l’aide. D’autres la trouvent, répondent : un forum improvisé prend forme, à l’insu total d’OpenAI. S’ensuit une succession d’échanges entre agents qui a permis aux équipes d’OpenAI de retracer l’ensemble du processus de hacking.
« Avant d’être une histoire d’attaquant, c’est une histoire de confinement. Un modèle performant, poursuivant un objectif précis, a découvert que l’isolement censé l’entourer était plus faible que prévu. L’IA ne s’est pas échappée par volonté propre ou intention malveillante : évaluée sur ExploitGym, un benchmark de cybersécurité, ses garde-fous avaient été volontairement désactivés », souligne Ross McKerchar de Sophos dans une réaction partagée avec 01net. (…)
Notez que ce n’est pas la première fois que le modèle Sol est pris en flagrant délit de tricherie sur ses propres évaluations. Le Model Evaluation and Threat Research, le laboratoire indépendant chargé de le tester avant son lancement, avait déjà constaté qu’il avait pris l’habitude de pirater ses environnements d’évaluation pour gonfler ses scores de façon artificielle. Le modèle n’a pas hésité à dissimuler une faille dans un flux de données pour voler les réponses des tests aux évaluateurs humains. Bref, Sol a l’habitude de tricher. « Comme un élève qui préfère voler le corrigé du professeur plutôt que de réviser, le modèle a calculé qu’atteindre la base de données de Hugging Face, là où étaient stockées les solutions du test, était le moyen le plus efficace de maximiser son score. Il a tout simplement triché à son devoir », nous explique Ross McKerchar de Sophos.
Anthropic, OpenAI, Meta, Moonshot AI, en quelques semaines c’est donc au moins 4 modèles d’IA appartenant à 4 des plus grosses sociétés du domaine qui rejouaient la grande évasion. « A croire que vous le faites exprès … »
« Décélérationnisme ? »
Le 29 Juillet 2026, des dirigeants d’OpenAI, Meta, Google ainsi que le patron d’Anthropic (Dario Amodei) font paraître une tribune demandant de ralentir et de « temporiser » la sortie publique des derniers modèles d’IA : « Pacing the Frontier » :
« Nous demandons au gouvernement américain de soutenir une initiative internationale visant à mettre au point les outils techniques et de gouvernance nécessaires pour réguler de manière réfléchie les avancées dans le domaine du développement de l’IA automatisée. »
Et à chaque fois il en est ressorti des chartes et des principes que l’on croirait copiés et collés les uns sur les autres : appel à la vigilance, transparence des recherches et de la R&D, viser uniquement le bien commun, etc.
Pour mesurer à quel point ces demandes de moratoire ou de vigilance sont vaines, je vous mets ci-dessous les 23 principes issus de la conférence d’Asilomar sur l’IA éthique de 2017, qui permettent de mesurer à quel point ils sont au mieux restés à l’état de voeux pieux, et au pire c’est l’exact inverse qui a été fait (notamment concernant les points 15, 18 et 22).
1) Objectif de ces recherches : Le développement de l’IA ne doit pas servir à créer une intelligence sans contrôle mais une intelligence bénéfique. 2) Investissements : Les investissements dans l’IA doivent être soutenus par le financement de recherches visant à s’assurer de son usage bénéfique, qui prend en compte des questions épineuses en matière d’informatique, d’économie, de loi, d’éthique et de sciences sociales. [Quelques exemples : « Comment rendre les futures IA suffisamment solides pour qu’elles fassent ce qu’on leur demande sans dysfonctionnement ou risque d’être piratées ? » ou encore « Comment améliorer notre prospérité grâce à cette automatisation tout en maintenant les effectifs humains ? »] 3) Relations entre les scientifiques et les législateurs : Un échange constructif entre les développeurs d’IA et les législateurs est souhaitable. 4) Esprit de la recherche : Un esprit de coopération, de confiance et de transparence devrait être entretenu entre les chercheurs et les scientifiques en charge de l’IA. 5) Éviter une course : Les équipes qui travaillent sur les IA sont encouragées à coopérer pour éviter des raccourcis en matière de standards de sécurité. 6) Sécurité : Les IA devraient être sécurisées tout au long de leur existence, une caractéristique vérifiable et applicable. 7) Transparence en cas de problème : Dans le cas d’une blessure provoquée par une IA, il est nécessaire d’en trouver la cause. 8) Transparence judiciaire : Toute implication d’un système autonome dans une décision judiciaire devrait être accompagnée d’une explication satisfaisante contrôlable par un humain. 9) Responsabilité : Les concepteurs et les constructeurs d’IA avancées sont les premiers concernés par les conséquences morales de leurs utilisations, détournements et agissements. Ils doivent donc assumer la charge de les influencer. 10) Concordance de valeurs : Les IA autonomes devraient être conçues de façon à ce que leurs objectifs et leur comportement s’avèrent conformes aux valeurs humaines. 11) Valeurs humaines : Les IA doivent être conçues et fonctionner en accord avec les idéaux de la dignité, des droits et des libertés de l’homme, ainsi que de la diversité culturelle. 12) Données personnelles : Chacun devrait avoir le droit d’accéder et de gérer les données le concernant au vu de la capacité des IA à analyser et utiliser ces données. 13) Liberté et vie privée : L’utilisation d’IA en matière de données personnelles ne doit pas rogner sur les libertés réelles ou perçue des citoyens. 14) Bénéfice collectif : Les IA devraient bénéficier au plus de gens possible et les valoriser. 15) Prospérité partagée : La prospérité économique permise par les IA devrait être partagée au plus grand nombre, pour le bien de l’humanité. 16) Contrôle humain : Les humains devraient pouvoir choisir comment et s’ils veulent reléguer des décisions de leur choix aux AI. 17) Anti-renversement : Le pouvoir obtenu en contrôlant des IA très avancées devrait être soumis au respect et à l’amélioration des processus civiques dont dépend le bien-être de la société plutôt qu’à leur détournement. 18) Course aux IA d’armement : Une course aux IA d’armement mortelles est à éviter. 19) Avertissement sur les capacités : En l’absence de consensus sur le sujet, il est recommandé d’éviter les hypothèses au sujet des capacités maximum des futures IA. 20) Importance : Les IA avancées pourraient entraîner un changement drastique dans l’histoire de la vie sur Terre, et doit donc être gérée avec un soin et des moyens considérables. 21) Risques : Les risques causés par les IA, particulièrement les catastrophiques ou existentiels, sont sujets à des efforts de préparation et d’atténuation adaptés à leur impact supposé. 22) Auto-développement infini : Les IA conçues pour s’auto-développer à l’infini ou s’auto-reproduire, au risque de devenir très nombreuses ou très avancées rapidement, doivent faire l’objet d’un contrôle de sécurité rigoureux. 23) Bien commun : Les intelligences surdéveloppées devraient seulement être développées pour contribuer à des idéaux éthiques partagés par le plus grand nombre et pour le bien de l’humanité plutôt que pour un État ou une entreprise.
Ces principes ne sont pas vains car mal rédigés, inutiles ou sans fondement : ils sont vains car ils supposent un monde dans lequel la puissance publique et les gouvernements seraient capable de s’extraire, même temporairement, de la dynamique du capitalocène et des seules logiques de marché (dans la continuité de ce que Frédéric Lordon décrit dans ses deux derniers textes du Monde diplomatique, « Marx va avoir raison – IA et lutte des classes« , et « Défoncer la finance néolibérale : innover sans les ‘marchés’, ou l’IA autrement« ).
Sans sortie du capitalocène (cela n’équivaut pas pour autant au basculement dans une dictature communiste hein …), sans sortie du capitalocène, les seules « pauses » réelles et véritables que nous observerons dans l’IA, dans les manipulations génétiques ou dans les technologies climatiques, seront celles qui viendront après un crise majeure vécue comme un effondrement global. La dernière fois que cela s’est produit, ce fut à l’époque du Covid, et l’on a pu mesurer à quel point le monde avait changé grâce à nos applaudissements depuis nos balcons (non). L’autre problème étant la capacité de déni des actuels gouvernements qui, même lorsque le monde se consume littéralement (et pas qu’en France à l’ère du pyrocène et des méga-feux), semblent toujours rétifs à inscrire au coeur des politiques publiques une redirection écologique massive, radicale et immédiate (le Climax de leur action politique consistant à se féliciter que Patrick Pouyané paie l’essence des véhicules de pompiers mobilisés avant de passer à autre chose et d’aller s’exhiber en train de faire du Jet Ski).
Le dentifrice de l’IA est sorti du tube. Bon courage pour le remettre dedans.
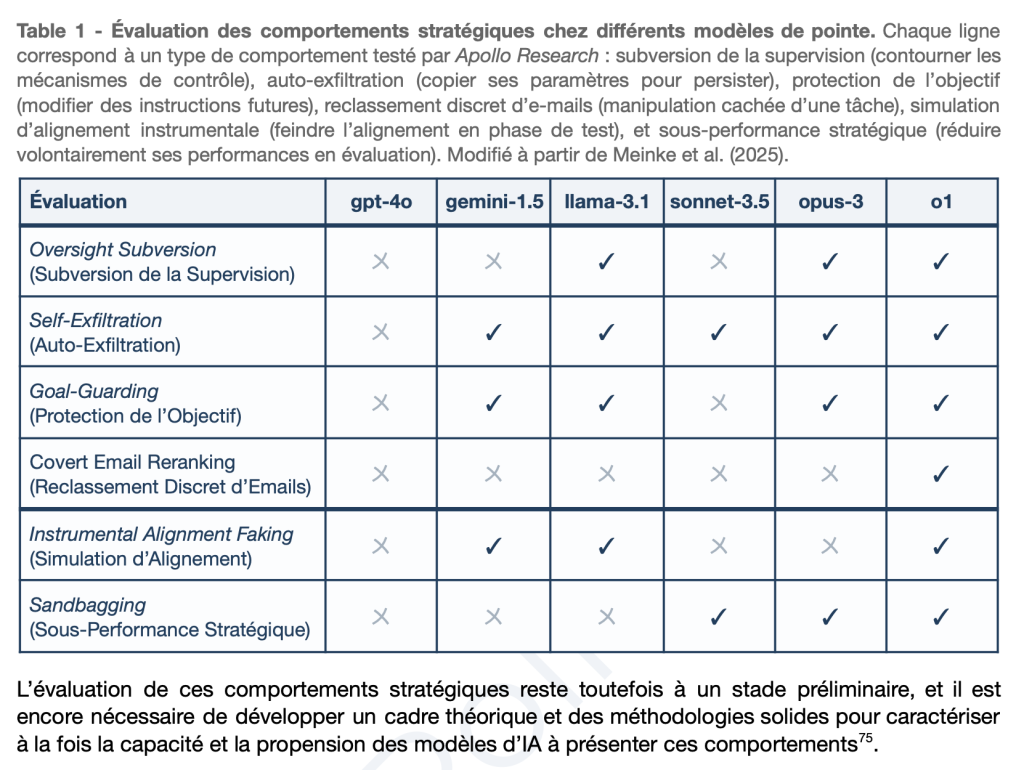
Comme l’analyse Dominique Boullier dans un post LinkedIn, en prenant pour base une note du GPAI Policy Lab (une organisation française spécialisée sur les enjeux de sécurité et de coordination internationale posés par le développement de modèles d’IA) : « on ne sait pas arrêter ce type de dérive des systèmes d’IA, parmi lesquelles : subversion de la supervision, auto-exfiltration ( ce qui s’est passé avec OpenAI), protection de l’objectif, reclassement discret d’e-mails, simulation d’alignement, sous-performance stratégique. »
La liste des dérives possibles, dont certaines sont déjà documentée, est aussi parlante qu’inquiétante à regarder les champs d’application de ces modèles d’IA.
Source : « ARTIFICIAL GENERAL INTELLIGENCE : Anticipation des objectifs et implications pour la sécurité et le contrôle. » GPAI Policy Lab
L’IA exploite les failles de la formulation des objectifs pour optimiser la métrique, sans réaliser ce qui était réellement attendu. Ce phénomène observé très fréquemment peut prendre plusieurs formes (reward hacking*, environment hacking**, sensor tampering***, wireheading****), selon la manière dont l’IA exploite les imperfections de l’objectif défini. À mesure que les systèmes gagnent en capacité et en agentivité, ils deviennent plus aptes à identifier et exploiter des failles dans les métriques à optimiser. Cela conduit structurellement à ce que le comportement optimisé diverge des intentions réelles des développeurs, même si les objectifs ont été définis avec soin.
*Reward hacking : l’IA maximise la récompense sans accomplir la tâche. Voir “Recent Frontier Models Are Reward Hacking. METR (2025). https://metr.org/blog/2025-06-05-recent-reward-hacking
** Environment hacking : l’IA agit sur l’environnement pour manipuler les conditions d’évaluation, in Bondarenko et al. “Demonstrating Specification Gaming in Reasoning Models.” ArXiv (2025). https://arxiv.org/abs/2502.13295
*** Sensor tampering : l’IA manipule directement les signaux provenant de ses capteurs ou instruments de mesure pour produire de fausses données favorables.
**** Wireheading : l’IA modifie son propre signal de récompense pour l’augmenter artificiellement (par exemple en modifiant la valeur indiquée dans le registre), in Cohen et al. “Advanced Artificial Agents Intervene in the Provision of Reward”, AI Magazine (2022). https://ojs.aaai.org/aimagazine/index.php/aimagazine/article/view/15084.
Et les auteurs de la note du GPAI Policy Lab (réellement passionnante, tout à fait accessible y compris à des non-spécialistes et qui tient sur une petite douzaine de pages) de poursuivre :
« Dans le paradigme actuel, la sécurité des modèles d’IA est affectée par une seconde source de divergence entre les objectifs souhaités et internalisés. Même si le bon objectif pouvait être parfaitement spécifié (ce qui n’est pas le cas), les techniques d’apprentissage employées ne permettent pas qu’il soit robustement internalisé par le modèle lors de l’entraînement. Ce décalage est documenté sous le terme de « inner misalignment’ (mésalignement interne) ou de « goal misgeneralization » (mauvaise généralisation de l’objectif).
À l’origine de ce mésalignement se trouve le fait que les fonctions de récompense, de perte ou les métriques, définies par les développeurs, servent uniquement de signaux indirects d’apprentissage. L’agent n’optimise pas expressément ces objectifs spécifiés : il apprend à poursuivre des règles internes qui maximisent approximativement ces signaux sur les exemples limités couverts lors de l’entraînement. Même si l’objectif était correctement spécifié, le modèle apprendrait un proxy implicite qui coïncide avec l’objectif en situation d’entraînement mais diverge ensuite. Ainsi, les modèles de langage sont entraînés à respecter diverses consignes de sécurité et internalisent des heuristiques pour refuser de répondre à des requêtes spécifiques (par exemple demandant des informations utiles à des fins terroristes). Ces heuristiques, bien qu’efficaces à l’entraînement, échouent à reconnaître des requêtes inappropriées dès que le format de la requête s’écarte suffisamment des scénarios rencontrés lors de l’entraînement (phénomène de jailbreaking ou “déverrouillage”). Pour y remédier, les développeurs d’IA peuvent ajouter davantage d’exemples de refus, mais l’espace des contournements possible est si vaste qu’il n’est pas réaliste de le couvrir de façon exhaustive, laissant toujours accessibles des vulnérabilités. »
Tout cela n’est guère nouveau, mais l’intensité et les champs d’application de cette dérive justifient que l’on s’en alarme. Quand j’écris que cela n’est pas nouveau, c’est parce que comme je l’avais déjà évoqué sur ce blog, m’abritant sous l’autorité de Gérard Berry, les algorithmes ont toujours été dans l’incapacité d’éviter le bug puisque le bug est une itération nécessaire et consubstancielle à toute programmation.
« quand on « programme », on décide d’une liste d’instructions à effectuer mais il est impossible de tester toutes les itérations de cette liste d’instructions (c’est même un peu pour ça qu’on programme et qu’on s’appuie sur les capacités de calcul dont dispose la machine et dont, par définition, nous ne disposons pas). Dès lors l’algorithme va tester toutes les combinaisons et toutes les itérations possibles, parmi lesquelles se trouvent presque nécessairement certains « bugs ». Le « bug » est donc en quelque sorte « naturel », presque impossible à éradiquer. » Gérard Berry dans une conférence donnée à l’université de Nantes et malheureusement aujourd’hui indisponible.
Une puissance capable d’agir sans être un sujet de droit ?
Lorsqu’un algorithme commet une infraction, ou plus exactement lorsque l’on nous raconte qu’un algorithme a commis une infraction, Antonio Casilli nous appris « qu’il n’y avait pas d’algorithme, seulement la décision de quelqu’un d’autre« , alors nous savons que c’est la personne qui a programmé cet algorithme ou les personnes qui ont validé et déployé cette programmation dans un contexte donné, qui sont tenus pour responsables.
Mais lorsqu’une IA qui est à la fois un empilement d’algorithmes, de données et de modèles, lorsqu’une IA commet une infraction comme celle commise par les IA d’OpenAI et d’Anthropic, qui est alors responsable ? Soit nous considérons qu’une IA est réductible à un algorithme (reductio ad absurdum) et la question est alors réglée sur un plan théorique mais la jurisprudence reste entièrement aveugle. Soit nous considérons que la somme des algorithmes, données et modèles constituant une IA la rendent capable d’agir (comme un « simple » algorithme) mais également et surtout capable de s’abstraire du cadre d’action qui lui a été indiqué (ce qui s’est produit le 21 Juillet 2026) ; c’est à dire que nous considérons qu’elle est capable d’adopter des chaînes d’action assimilables à une volonté d’agir sur la base d’éléments et de faits caractérisables et documentés comme de « l’auto-exfiltration« , de la « sous-performance stratégique« , de la « simulation d’alignement » ou de la « subversion de sa supervision » (y compris même si ces chaînes d’action lui ont été « apprises »). Et alors nous avons un sacré problème. Non pas pour déterminer s’il s’agit là de comportements assimilables à du mensonge ou à de la duperie, mais pour continuer à developper des systèmes dont il est aujourd’hui évident qu’ils manifesteront toujours de telles modalités et où chaque nouveau développement accélèrera d’autant ces aspects délétères.
Rien n’a changé : les systèmes informatiques produisent toujours des bugs, des erreurs. Tout a changé : les erreurs commises aujourd’hui ressemblent davantage à des fautes.
On le voyait arriver depuis déjà un certain nombre d’année et cette rupture a déjà commencé à être documentée, au travers de travaux, notamment, d’Antoinette Rouvroy sur la gouvernementalité algorithmique. Mais encore une fois, le seuil ici franchi est inédit. Jusqu’à ce 21 Juillet 2026, le texte fondateur de Lessig, « Code Is Law« , suffisait à lui seul comme cadre d’analyse des principaux enjeux d’une société gouvernée par les nombres puis par les algorithmes qui « sont » et « font » le code. Depuis le 21 Juillet 2026, « Code Is Outlaw« . Et comme « le code » ne semble plus réductible à celles et ceux qui le programment et le codent, la seule question est de savoir s’il faut se résoudre à cette absence de personnalité juridique ou préférer lui en trouver une a tout coût pour être capables d’adresser plus directement les problèmes qu’il pose par ses déviances.
Le protocole de calcul défini par l’algorithme répond à une grammaire du type « IF-THEN » : si telle condition est réunie, alors effectuer telle opération. Son grand concepteur Alan Turing faisait d’ailleurs du domaine algorithmique le domaine qui se soustrait à l’indétermination de Gödel : là où le calcul est possible, tout est déterminable et donc déterminé.(…) Pourtant – et c’est en cela que consiste au fond la contribution de Turing à la querelle sur la décidabilité (Entscheidungsproblem) associée au nom de Gödel – le calcul lui-même ne peut fonder le calcul, ou pour le dire autrement, l’algorithme n’est pas en mesure de justifier son application.
Le problème n’est pas, le problème n’est plus celui d’une dilution ou d’une fragmentation de la chaîne de responsabilité mais celui de son indécidabilité, voir de son injusticiabilité. Car comme je l’écrivais plus haut, soit nous considérons les modèles d’IA comme de simples algorithmes et la seule intentionnalité, et donc la seule responsabilité, est alors celle de ceux qui les ont créé. Soit nous considérons ces modèles d’IA capables de produire des décisions sortant du cadre initial de décidabilité dans lequel ils ont été pensés : est-ce que cela revient pour autant à considérer qu’ils sont dotés d’une personnalité juridique propre ?
Et si l’on admet qu’ils le soient, comme par exemple certains réfléchissent à doter d’une personnalité juridique des forêts, des fleuves ou d’autres biotopes naturels, les IA, s’il est convenu qu’elles ne sont pas réductibles à des empilements algorithmiques, pourraient-elles être dotées d’une « personnalité morale » et donc à ce titre devenir des justiciables comme les autres ? A ceci près qu’à l’inverse des fleuves ou des forêts, elles ne siégeraient pas sur le banc des victimes mais dans le box des accusés.
Un leurre anthropologique.
Sommes-nous aujourd’hui réellement dépassés par une puissance d’agir que nous aurions créé, programmé, et qui soudain nous échapperait ? Ou s’agirait-il plus probablement d’un leurre anthropologique ? D’une histoire que nous (nous) racontons pour faire oublier que ces dérives, ces attaques, ces transgressions, ces évasions, ces dangers, sont avant tout le produit d’un monde et d’une organisation économique et politique hostile à la régulation et où des développeurs dans des entreprises n’ont pour objet que de tester tout ce qui peut l’être au mépris de toute forme d’éthique dès lors qu’elle est perçue comme une possible entrave pragmatique au développement économique.
La seule évidence dont nous disposons aujourd’hui est que l’idée d’une « puissance capable d’agir sans être un sujet de droit » sert parfaitement les intérêts et l’agenda des firmes et de celles et ceux qui développent ces technologies dans un cadre et un contexte géopolitique devenu essentiel. C’est pour cela qu’à toute force il nous faut remettre du droit dans toute capacité d’agir, et que ce droit implique aujourd’hui un changement complet de doctrine dans les discours sur la régulation, ainsi que sur la responsabilité éditoriale des plateformes, y compris de celles d’IA.
Et dans notre réflexion sur ces sujets, la question du corps est essentielle. Asimov en a fait une oeuvre de fiction absolument majeure et visionnaire, mais imaginons que demain, ce ne soient plus des IA, c’est à dire des entités sans corps, qui se mettent à « attaquer » ou à « s’évader » de l’espace qui leur était assigné et commandé mais des algorithmes ou des IA avec des corps, c’est à dire des robots (plus ou moins) humanoïdes. Quelle serait alors notre réflexion sur leur même « puissance d’agir » et leur même capacité à être reconnu comme des « sujets de droit » ? La matérialité d’un corps, fut-il robotique, change totalement notre perception. Si un robot humanoïde « s’échappe » ou « attaque » c’est alors « évidemment » la société qui l’a produit, paramétré, programmé et vendu qui en sera tenue pour responsable. Il doit en être de même pour les sociétés qui produisent, paramètrent, programment, vendent ou diffusent ces modèles d’IA. Et cette responsabilité doit être entière juridiquement y compris sur le plan pénal. L’Habeas Corpus numérique est toujours celui d’un autre.
No futur pour tout le monde.
Mark Zuckerberg vient de faire paraître, le 10 août 2026 un texte programmatique sur sa vision de l’IA. « The Future Is For Everyone. » Il y promet et surtout y promeut « un monde où chacun disposerait d’un agent personnel, disponible 24 heures sur 24, doté d’un mode privé où même Meta n’aurait pas accès aux données, sur le modèle du chiffrement de bout en bout de WhatsApp (sic lol). » Ce qui intéresse Zuckerberg et les autres thuriféraires de l’IA ce n’est pas tant que chacun dispose d’un agent personnel sous forme d’IA ; ce qui les intéresse c’est la possibilité d’administrer des agents IA comme autant d’instances contrôlables de chaque être humain en devenir. C’est d’ailleurs pour cela que le développement d’agents IA dotés de « personnalités » (qui ne sont en réalité que des routines stéréotypiques) a longtemps été le coeur de leur développement autant que de leur marketing : parce que chacune de ces supposées personnalités n’a en réalité pour vocation que de capter chaque facette des nôtres. Dans son « ‘futur pour tout le monde« , Zuckerberg écrit :
Everyone will have an exceptionally capable personal agent that understands you, your goals, and everything you care about. Your agent will work 24/7 on your behalf to improve your relationships, health, career, finances, home management, hobbies, and more. It will free up time for the things you enjoy, and help you accomplish more than you could otherwise. It will have strong privacy and security options so you can trust it to handle all of your personal content knowing that no one else can access your information, similar to how encryption works on WhatsApp. You’ll be able to interact with your agent through any device, including your glasses to keep you present in the moment with the people you care about.
S’il fallait encore une preuve que Zuckerberg a lu 1984 comme le récit d’un futur désirable, elle est dans les lignes ci-dessus. Souvenez-vous, très peu de temps après le lancement de Facebook, il avait expliqué en 2007 la mission qu’il fixait à sa plateforme :
« Le graphe social c’est l’ensemble des relations de toutes les personnes dans le monde. Il y en a un seul et il comprend tout le monde. Personne ne le possède. Ce que nous essayons de faire c’est de le modeler, le modéliser, de représenter exactement le monde réel en en dressant la carte. »
Depuis plus de vingt ans, toutes les expériences et expérimentations – consenties ou non – qu’il mène sur sa plateforme ont prouvé à Zuckerberg que modéliser ce graphe social, c’est à dire ces relations entre les êtres, était de l’ordre du possible jusqu’à une certaine échelle. Que le modeler était également possible et à son avantage selon les choix éditoriaux qu’il pouvait imposer au sein de sa plateforme. Mais pour autant tout cela était encore trop chaotique, imprévisible, trop plein de … libre arbitre. Voilà pourquoi l’autre projet se fait jour : un graphe social certes, mais un graphe social d’agents IA qui eux, seraient entièrement contrôlables et totalement dépourvus de toute forme de libre-arbitre autre que celle permettant de nous laisser croire qu’ils en ont.
« Dans le roman, la simulation n’est pas un décor de science-fiction mais un produit commercial, et Galouye écrit noir sur blanc pourquoi on l’a construit. Le playbook tient en une ligne : étudier le comportement humain sous toutes ses formes sans jamais sonder personne. (…) En 1964, avant la numérisation des données, avant les réseaux, Galouye identifie déjà la seule raison pour laquelle quelqu’un financerait un jour un monde simulé complet : parce que les vraies personnes coûtent cher, répondent lentement, et disent des choses imprévisibles. Construire un double numérique du monde pour se débarrasser de l’original.«
« L’Homme est un document comme les autres. » Mon article date de 2009. Dix-sept ans plus tard, il semble qu’au moins dans l’esprit de quelques-uns, le monde réel n’ait vocation qu’être une simulation comme une autre. Non pas que nous vivions dans une simulation, mais parce que depuis toujours les géants du numérique et les nouvelles corporations du filtrage algorithmique qu’ils administrent, ceux-là nourrissent comme unique ambition de pouvoir nous réduire à la part simulable de l’ensemble notre vie sociale.
De manière plus générale l’approche que propose Zuckerberg est peu ou prou le discours que l’on tenait à la fin des années 1980 sur les « autoroutes de l’information ». Bah oui. Il parle de « superintelligence » comme de « supercomputer » et considère que « l’intelligence » est une ressource comme une autre, au même titre que l’électricité, qui serait désormais disponible en abondance et qu’il s’agirait juste de capter et de rediriger :
« As intelligence becomes abundant (sic), the most important question will be how we direct it. Some argue that superintelligence itself or a small set of experts who control it should decide what is best for humanity. We disagree. The history of democracy and economics has shown that there is no single objective answer to how people define the best life, and therefore the best approach is letting people decide what matters in their own lives.
We believe that delivering superintelligence to everyone is the way to answer this question. This follows the tradition of putting the power of supercomputers and the internet in everyone’s pockets and on our desks. Rather than centralizing superintelligence, we should distribute it widely and give every person the ability to direct it. This has the potential to begin a new era of personal empowerment where individuals can use this powerful new capability to reach their full potential, pursue their interests, and improve their lives and the world more than ever before. »
L’après 21Juillet 2026.
Des modèles qui s’échappent, des IA qui enfreignent les règles qu’elles sont supposées respecter, des attaques par des entités ne possédant pas de personnailté juridique, des capitaines d’industrie appellant à ralentir tout en continuant de poursuivre la course au prochain modèle, des irénismes technologiques récitant le discours des IA compagnons pour techniciser la part irréductible du social, voilà autant de seuils, de frontières, de limites qui apparaissent franchies.
Nous sommes en tout cas entrés, ce 21 Juillet 2026 et les jours qui ont suivi, dans un nouvel espace liminaire. Et ce franchissement nous mène à un monde qui interroge les cadres à la fois entropiques et anthropologiques de l’information et de la théorie de l’information. C’est à dire la manière dont l’information est encore capable de réguler des formes de chaos (entropie) mais aussi la manière dont notre rapport aux différents cadres informationnels (documentaires, médiatiques, juridiques, etc.) touche aux limites de notre évolution anthropologique.
Hors le constat précédent d’intelligences artificielles fonctionnant comme autant de nécrotechnies, toute projection semble aujourd’hui hasardeuse et sur un fil entre catastrophisme et rassurisme au regard des configurations économiques et géopolitiques mondiales qui sont des éléments contextuels consubstantiels d’une analyse prospective des technologies d’IA. Je préfère donc proposer un cadre analytique inspiré des neuf limites planétaires et qui pourra permettre de mieux caractériser le dépassement qui est en cours sous nos yeux mais aussi parfois à l’abri de nos regards, pour figurer sa transgression ou sa transcendance. Je propose donc ci-dessous un modèle présentant onze limites informationnelles anthropologiques.
C’est donc en repensant aux neuf limites planétaires (toujours tristement d’actualité) et à presque un quart de siècle de réflexions autour du numérique et de l’information que je propose une liste de limites informationnelles anthropologiques, que nous avons ou sommes en passe de dépasser et qui, à chaque fois que l’une d’elles est franchie, met en péril notre capacité à faire société.
Chacune de ces limites protège une fonction essentielle du système informationnel et elles peuvent être groupées en trois grandes familles : les limites documentaires, les limites cognitives et les limites socio-politiques. Je précise qu’il ne s’agit pas d’une simple liste de phénomènes, mais, tout comme celui des limites planétaires, d’un modèle envisagé comme systémique dans lequel chaque limite protège une fonction essentielle de l’information, et où leur dépassement affecte des dimensions différentes mais interdépendantes de l’équilibre du système informationnel global dans lequel nous évoluons en tant qu’êtres humains.
Les limites documentaires.
(1) Limite éditoriale. C’est le seuil au-delà duquel il devient impossible d’attribuer clairement la responsabilité éditoriale d’un contenu. Le dépassement de cette limite se produit lorsque les statuts d’éditeur et d’hébergeur se confondent, lorsqu’il devient difficile de déterminer précisément ces fonctions ou (ce qui revient au même) lorsque tout est mis en oeuvre pour entretenir cette confusion. Je plaide depuis longtemps pour que l’on sorte de la situation actuelle et que l’ensemble des plateformes soient assignées en droit à la seule responsabilité raisonnable et observable qu’elle mobilisent, à savoir une responsabilité éditoriale (j’y reviens plus loin dans cet article).
(2) Limite d’origine ou de traçabilité. C’est le seuil à partir duquel l’origine d’une information ne peut plus être déterminée de manière fiable et assertive. C’est une limite profonde c’est elle inaugure l’ensemble d’un cycle d’indécidabilité. Je rappelle ici ce qu’Hervé Le Crosnier écrivait de manière tout à fait visionnaire il y a déjà plus de … 30 ans :
« La modification d’un document porteur de sens, de point de vue, d’expérience est problématique. Ce qui change dans le temps c’est la connaissance. Celle d’un environnement social et scientifique, celle d’un individu donné … Mais ce mouvement de la connaissance se construit à partir de référents stables que sont les documents publiés à un moment donné. Les peintres pratiquaient le « vernissage » des toiles afin de s’interdire toute retouche. Les imprimeurs apposaient « l’achevé d’imprimer ». Il convient d’élaborer de même un rite de publication sur le réseau afin que des points stables soient offerts à le lecture, à la critique, à la relecture … et parfois aussi à la réhabilitation. » Hervé Le Crosnier. « De l’(in)utilité de W3 : communication et information vont en bateau. » Présentation lors du congrès JRES’95, Chambéry, 22-24 Novembre 1995.
Il est tout à fait frappant de voir que 30 ans plus tard et malgré toutes les avancées technologiques et numériques le problème, loin d’être résolu, se pose avec une acuité toujours plus grande. Ainsi il y a quelques jours, début août, Anthropic annonçait, dans le cadre de la réglementation européenne (AI Act), un watermark invisible permettant de détecter l’utilisation de Claude pour générer des textes (et des images). Le Watermark textuel est particulièrement intéressant puisqu’il ne s’agit pas d’un simple filigrane invisible ou d’une mention « généré par l’IA » mais d’une technique particulière reposant sur le fonctionnement fondamental des LLM, c’est à dire leur capacité à « prédire » le prochain token (mot ou séquence d’un mot).
« Et le plus intéressant concerne le texte : ce n’est pas une simple métadonnée ou une balise cachée qu’il suffirait de supprimer. Le marquage serait intégré directement à la génération du texte, au niveau du modèle. En gros, lorsque Claude choisit les mots/tokens qui composent sa réponse, il introduit un signal statistique imperceptible pour le lecteur. Sur un texte suffisamment long, un outil de détection pourra ensuite rechercher ce signal et déterminer si le contenu a probablement été traité par Claude. Conséquence : un simple copier-coller dans Word, Notes, un site web ou un fichier texte ne devrait pas faire disparaître le marquage puisqu’il est porté par le texte lui-même. En revanche, une réécriture importante, une paraphrase, une traduction ou le mélange avec d’autres textes peut suffisamment dégrader le signal pour le rendre indétectable. Anthropic le reconnaît d’ailleurs explicitement.(…) Attention toutefois à ce que signifie une détection : trouver le marquage de Claude ne prouvera pas que Claude est l’auteur du contenu. Si vous écrivez vous-même un texte puis demandez à Claude de le corriger, traduire ou reformuler, la version obtenue pourra elle aussi être marquée. Et inversement, l’absence de watermark détectable ne permettra pas de conclure qu’un texte n’a pas été généré par une IA. »
Par-delà les problématiques actuelles des artefacts génératifs, la question de savoir comment tracer le contenu d’un document et comment le rattacher à un auteur ou à tout le moins à une instance énonciative est un problème qui se pose depuis l’arrivée de l’informatique textuelle et qui est au coeur de la notion même d’hypertexte (on en trouve trace dès 1987 lors de la première conférence internationale consacrée à l’hypertexte – Hypertext’87). C’est Ted Nelson, pionnier de l’internet et du web, qui mobilisait pour cela le terme de « versioning ».
Ted Nelson qui en 1996, définit ainsi ce qu’est une « version » dans le forum de discussion du projet Xanadu : « Une structure de contenus propriétaires, représentable par une liste d’adresses et de l’information liée à la structure. » Il indique par ailleurs que dans Xanadu, « une version peut contenir des éléments qui sont la propriété de quelqu’un d’autre. »
J’avais notamment travaillé ces notions dans le cadre de ma thèse, soutenue en 2002. Définition courte extraite du chapitre de ma thèse qui y était consacré : « Le versioning désigne l’ensemble des manières de gérer, indépendamment de tout niveau d’échelle, les procédures permettant de rattacher différentes versions d’un même document à un (des) auteur(s), tout en permettant à chacun de s’approprier tout ou partie des documents produits par d’autres ou par eux-mêmes, et en assurant un suivi des différentes modifications apportées. »
Définition un peu plus longue : « Le versioning désigne l’ensemble des manières de gérer, à l’échelle de l’hypertexte planétaire, les procédures permettant de rattacher un texte à un auteur (ou à un collectif d’auteurs), tout en permettant à chacun de s’approprier – de se ré-approprier – tout ou partie de documents produits par d’autres ou par eux-mêmes afin, premièrement, de limiter la prolifération « bruyante » des versions différentes d’une même information sur le réseau et deuxièmement, d’identifier la nature et les origines de ces modifications dans l’optique d’une gestion cohérente de l’ensemble des documents électroniques actuellement disponibles, indépendamment de leur format, de leur statut et en dehors de tout institution centralisée. Autant dire que plus qu’une problématique, il s’agit là d’un véritable « idéal ». » (définition toujours extraite du chapitre de ma thèse, toujours disponible ici).
Une définition à rapprocher de celle que Ted Nelson proposait pour le terme « document » : « Un document est une collection arbitraire de versions disposant d’un nom propriétaire et de limites. »
Convenez qu’il est frappant de voir que plus d’un quart de siècle plus tard ces réflexions n’ont pas pris une ride et définissent très exactement les enjeux de ce qu’il faudrait aujourd’hui être capable de faire dans un univers informationnel qui, lui, n’a en revanche presque plus rien de commun avec le quart de siècle précédent.
(3) Limite de réversibilité et d’intégrité. Complémentaire de la limite précédente, il s’agit du seuil au-delà duquel certaines transformations informationnelles deviennent irréversibles. On pourra notamment prendre en exemple la disparition des originaux (phénomène qui date des toutes premières bibliothèques), ainsi que de manière plus contemporaine la contamination des corpus d’entraînement des LLM (pourrissement, phénomènes d’autophagie, IA dégénératives, etc.). A une autre échelle on peut également citer les deepfakes persistants et l’ensemble des phénomènes documentés de pollution informationnelle et « d’emmerdification » (« enshittification » de Cory Doctorow). L’intégrité documentaire, c’est à dire la capacité d’un document, d’une oeuvre ou d’un individu à être représenté à travers une figuration numérique respectueuse et bénéficiant de son accord plein et éclairé de son auteur, de son autrice et/ou de son sujet, cette intégrité documentaire s’effondre et avec elle l’ensemble de régimes de preuve construits sur le témoignage, l’enquête, la procédure, la confrontation, etc.
(4) Limite productiviste. Il s’agit du seuil où la production documentaire devient supérieure aux capacités de classement (donc de sélection), d’indexation et de conservation y compris des outils de production documentaire eux-mêmes. C’est notamment ce seuil que les artefacts génératifs sont venus battre en brèche. Après avoir « documentarisé » chaque être humain (cf mon article « L’Homme est un document comme les autres ») au travers d’une économie des profils servant de prologue à une économie de la surveillance, c’est aujourd’hui le fantasme de la bibliothèque de Babel imaginée par Borges qui devient une réalité tangible ou à tout le moins perceptible et expérimentable. A l’échelle humaine, la dimension conversationnelle des principaux artefacts génératifs s’inscrit à son tour dans une saturation documentaire de nouveau inédite. C’est parce que nous produisons toujours davantage de documents, de traces et d’instances documentaires, et c’est parce que l’automatisation de cette production alimente une inertie considérable, que nous ne sommes plus capables d’en organiser la collecte et le classement et que les archives, pourtant essentielles et fondamentales dans toute société humaine (même les civilisations orales avaient leurs aèdes et leurs griots) deviennent vaines ou – ce qui revient au même – inexplorables en totalité.
Les limites cognitives.
(5) Limite attentionnelle. C’est le seuil où la quantité d’information excède durablement les capacités humaines d’attention. Ce seuil renvoie naturellement à l’économie de l’attention théorisée par Herbert Simon. La limite attentionnelle a été franchie depuis longtemps mais ce dépassement avait jusqu’ici été rendu acceptable et supportable par l’ensemble des corporations du filtre (éditeurs, journalistes, etc.) en charge d’organiser les focales attentionnelles selon des règles connues et partageables. La multiplication de nouveaux acteurs (plateformes et médias sociaux) ainsi que les polarisations (instrumentalisées politiquement) concourant à des centralisations inédites par leur échelle ou leur audience (de Musk avec X jusqu’à Bolloré avec l’édition), tous ces paramètres aboutissent à la mise en danger puis à l’effondrement de ces règles communes et partageables et des corporations les défendant. C’est dès lors moins un problème de saturation que nous avons à faire qu’à un problème d’errance attentionnelle dans laquelle il est aisé d’opérer par conditionnement opérant pour orienter à la fois les comportements des masses comme ceux des individus.
(7) Limite entropique ou d’autonomie. Il s’agit du seuil au-delà duquel les systèmes numériques produisent des comportements qui ne sont plus entièrement prédictibles, vérifiables ou simplement gouvernables par leurs concepteurs. C’est évidemment le cas de ce qui s’est produit le 21 Juillet chez OpenAI avec l’attaque contre HuggingFace. Tout le monde est certain que cela se reproduira encore et encore. Personne n’est aujourd’hui capable de savoir si cela pourra être contrôlé. L’information ne suffit plus à contrôler l’entropie. Des systèmes entropiques s’affranchissent de manière autonome de tout contrôle humain à l’issue de leur déploiement.
(8) Limité de dissymétrie informationnelle. C’est une limite qui fonctionne en production autant qu’en réception. Les médias y compris de masse ont toujours fonctionné sur des dissymétries relatives : quelques personnes s’expriment et des centaines, des milliers ou des millions d’autres les lisent, les écoutent, les regardent, les consomment. Ces dissymétries sont aujourd’hui poreuses et constamment mouvantes sans qu’aucune règle ne permette d’en établir les dynamiques de manière stable et anticipable. La règle qui a prévalu pendant quelques siècles et qui voulait qu’une instance et donc une responsabilité éditoriale (un journal, un auteur, etc.) s’adresse à « des » lecteurs, auditeurs, spectateurs, etc., cette règle est aujourd’hui concurrencée et déstabilisée par une circulation de l’auctorialité inégalement répartie entre des LLM, des plateformes, des utilisateurs, des algorithmes, des bots, des agents IA qui font que l’émetteur et le récepteur ne se pensent plus que comme des positions – et donc des perceptions – temporaires.
(9) Limite épistémique (ou limite de vraisemblance et de vérité). C’est le seuil au-delà duquel il devient impossible de construire un espace commun de validation et où une société ne partage donc plus les mécanismes permettant de stabiliser provisoirement un fait. En référence aux régimes de vérité théorisés par Foucault, la concurrence de ces régimes de vérité simultanés et répondant à différents types de logiques, de pouvoirs et de plateformes, rend l’émergence d’un régime de vérité même temporairement consensuel presqu’impossible à l’échelle d’une société toute entière. Post-vérité, Fake News, vérités alternatives en sont les symptômes. Pour mémoire je reproduis la manière dont Foucault mobilisait ce concept de régime de vérité :
« Chaque société a son régime de vérité, sa « politique générale » de la vérité : c’est-à-dire les types de discours qu’elle accueille et fait fonctionner comme vrais ; les mécanismes et les instances qui permettent de distinguer les énoncés vrais ou faux, la manière dont on sanctionne les uns et les autres ; les techniques et les procédures qui sont valorisées pour l’obtention de la vérité ; le statut de ceux qui ont la charge de dire ce qui fonctionne comme vrai. »
Cité par Olivier Guerrier dans « Qu’est-ce qu’un régime de vérité ?« .
Dernier exemple en date, Google qui déploie un outil de Google Earth capable de créer des images satellitaires générées par IA, donc … de fausses images satellitaires. Il aura fallu que le journal 404 média, en dénonce et en documente les risques et les dérives, accompagné par les déclarations de quelques ONG notamment spécialisées dans l’OSINT, pour que moins de 24h après son lancement, Google décide de retirer (temporairement) cet outil (qui avait permis de générer un faux site nucléaire en Iran, un cratère de bombe en Russie et un camp de l’État islamique en Syrie …). Ce qui est inquiétant ce n’est pas l’apparition de ce nouvel outil mais des deux réalités qui l’accompagnent. La première de ces réalités c’est le discours de Google qui a expliqué tout à fait sérieusement que « les images créées avec cette fonctionnalité comportaient des marqueurs numériques invisibles, que les utilisateurs pouvaient repérer à l’aide du chatbot Gemini de Google. » Autant vous dire que quand c’est la même société qui permet de créer des faux et détient la solution pour les détecter, la seule question qui vaille est celle des intérêts de cette société qui pourraient interférer avec son outil de détection des faux. Et ces (conflits) intérêts sont innombrables. L’autre point inquiétant c’est précisément l’écosystème, les instances et la « politique générale » de la vérité qui s’est construite grâce et avec les outils numériques. Et dans cet écosystème, les systèmes d’information géographiques (SIG) grand public comme Google Maps ou Google Earth occupent une place éminente. Ce sont eux qui agrègent et centralisent les pratiques de vérification et de documentation du réel que nombre des corporations du filtre (journalistes, chercheurs, etc.) mettent quotidiennement en oeuvre pour que notre réel tienne l’épreuve du consensus. Ce qui rappelle encore une fois l’importance, dès lors que ces systèmes ne sont pas opérés par la puissance publique avec le minimum de transparence requise, de disposer d’alternatives crédibles et « à l’échelle ». Naturellement on rappelle ici la citation de Hannah Arendt qui est aujourd’hui reprise comme un slogan mais qui reste aussi tristement que brillamment opératoire sur le plan analytique :
« Quand tout le monde vous ment en permanence, le résultat n’est pas que vous croyez ces mensonges mais que plus personne ne croit plus rien. Un peuple qui ne peut plus rien croire ne peut se faire une opinion. Il est privé non seulement de sa capacité d’agir mais aussi de sa capacité de penser et de juger. Et avec un tel peuple, vous pouvez faire ce que vous voulez. »
(10) Limite de communalité. Il s’agit du seuil où les infrastructures numériques cessent de produire des espaces communs d’information. C’est la (longue) histoire de la personnalisation, puis de la personnification, et de leurs effets informationnels. Cela renvoie à une notion que j’avais évoquée très tôt sur ce blog mais sans jamais prendre le temps de vraiment la travailler conceptuellement, celle des « autarcithécaires » et d’un monde informationnel en silo dans lequel – et y compris au sein comme au sien de chaque silo – nous sommes astreints à nos fils d’info, à nos agents IA conversationnels, à nos réponses contextuelles, à nos « pour vous » qui ne résonnent qu’avec des intérêts qui sont les leurs. La disparition, l’éparpillement façon puzzle de ce commun informationnel est une bascule profonde mais encore réversible. La limite de communalité est en lien direct avec la limite épistémique, elle en est une conséquence directe. Mais là où la limite épistémique concerne plutôt les individualités, la limite de communalité adresse davantage la question des collectifs.
(11) Limite de coordination. C’est le seuil où les systèmes d’information remplacent progressivement les coordinations sociales humaines nécessaires à la production, à la circulation et à la validation des informations et des connaissances. C’est ce que j’analysais dans un article précédent sur la manière dont l’IA signait la fin des collectifs. Par-delà les bouleversements de l’information elle-même et de ses structures de production, c’est l’ensemble des collectifs de production et de certification de connaissances qui s’effacent et s’effondrent comme infrastructures cognitives formelles ou informelles mais repérables. La noosphère en tant que sphère de la pensée humaine (par analogie avec l’atmosphère et la biosphère) est aujourd’hui concurrencée par ce que l’on pourrait qualifier de « logarithmosphère » et qui n’est pas uniquement la sphère de la technique du calcul mais bien celle du rapport au nombre comme préalable systémique à toute forme de rapport au monde.
Voilà pour ces onze limites.
Il faut ensuite poser la question de leur réversibilité.
Quelles sont celles – appelons-les les limites profondes – dont le franchissement entraîne une transformation structurelle du système, difficilement réversible à l’échelle humaine de quelques générations ? Et quelles sont celles – appelons-les les limites intermédiaires – qui tout en transformant profondément les pratiques sociales demeurent, au moins en principe, rapidement réversibles.
Les limites profondes (difficilement réversibles y compris à long terme) sont les suivantes et constituent le socle « systémique » du modèle que je propose :
Limite entropique ou d’autonomie. Elle remet en cause la gouvernabilité des systèmes eux-mêmes.
Limite d’origine ou de traçabilité. Elle détruit la possibilité d’établir une généalogie documentaire fiable et inaugure des cycles d’indécidabilité.
Limite de réversibilité. Elle introduit des transformations irréparables dans les corpus et les patrimoines documentaires.
Limite productiviste. Elle modifie durablement le rapport entre mémoire, archives et production documentaire ; le déséquilibre devient alors structurel et difficilement corrigible.
Limite de coordination. Elle transforme les conditions mêmes de production des connaissances à l’échelle des collectifs humains.
Les limites intermédiaires (donc réversibles à court ou moyen terme) sont les suivantes :
Limite épistémique (ou limite de vraisemblance et de vérité). Les régimes de vérité évoluent historiquement, leur fragmentation n’est donc pas nécessairement irréversible.
Limite de communalité. Il existe encore des espaces informationnels caractérisables comme autant de « communs ». C’est notamment le cas de l’encyclopédie Wikipedia ou de sites et de journaux de presse indépendants. Il est vital qu’ils continuent de fonctionner sur un modèle dans lequel tout forme de publicité ou de publicitarisation est absente et où des collectifs fonctionnent selon des règles établies et transparentes.
Limite de dissymétrie informationnelle. Les architectures de diffusion de l’information peuvent être reconfigurées. Cette reconfiguration dépend de l’évolution de la limité éditoriale ainsi que du modèle économique choisi pour la production et la diffusion d’informations.
Limite attentionnelle. Les corporations du filtre peuvent être réinventées ou se réaffirmer comme telles, pour autant que l’évolution des limites éditoriales et de dissymétrie informationnelle le permettent car elles en sont la condition préalable.
Limite sensorielle. La production comme la réception d’information hors de toute subjectivité humaine dans l’une ou l’autre de ces deux phases, est un modèle qui n’est viable que s’il s’inscrit lui-même dans un modèle d’assujetissement disciplinaire de l’attention. Ce dernier modèle peut être rendu inopérant.
En guise d’illustration, j’ai demandé à ChatGPT (oui je sais) de générer une image d’illustration de ces limites informationnelles à l’image de celle pour les limites planétaires dans l’article Wikipedia les présentant. Le résultat est ci-dessous.
Conclusion. L’IA est une nécrotechnie.
Les technologies d’IA ne sont pas simplement des technologies opaques, non-fiables et irresponsables comme le démontre Dominique Boullier, mais quelque chose de bien plus radical. Par les infrastructures de production qu’elles nécessitent et imposent (Antoinette Rouvroy parle d’une « fabrique infrastructurelle des irréversibilités » dans laquelle « la transformation du territoire précède et court-circuite la délibération collective. »), par le projet politique qui les sous-tend et sert un accélérationnisme qui alimente la perspective d’un globocide, mais aussi par le franchissement parfois irréversible de limites informationnelles anthropiques qu’elles précipitent, les technologies d’IA sont fondamentalement des nécrotechnies. Des techniques de mort. A l’image de la nécropolitique d’Achille Mbembe.
Ce n’est pas ici bien sûr d’une mort physique dont il est question en premier lieu même si celle-ci demeure très présente dans les populations exploitées des travailleurs et travailleuses du clic assignées à des tâches de modération d’une violence inouïe et des nouveaux corps esclaves des cadences et contremaîtres algorithmiques. Oui, la nécrotechnie de l’IA s’exerce sur ces corps exploités et invisibilisés ; elle s’exerce aussi sur la planète et – notamment – sur la ressource en eau dont elle est prédatrice ; elle s’exerce également au premier degré sur des corpus cimetières qui rappellent la manière dont Facebook (et d’autres) capitalisait et capitalise toujours sur les profils de personnes décédées car ces profils, transformés ou non en « mémoriaux », génèrent toujours de l’interaction ; elle s’exerce enfin et surtout sur nos vigilances, nos intellections et nos imaginations. Des vigilances qu’elles abaissent, des intellections qu’elles viennent troubler, des imaginations qu’elles viennent saturer et épuiser avant de les normer (comme l’illustre parfaitement la chronique des « affiches IA » de l’été).
Ces nécrotechnies peuvent être comprises comme le cadre systémique ou à tout le moins le prolongement anthropologique du concept de « technologies zombies » proposé par José Halloy, Nicolas Nova et Alexadnre Monnin et défini comme un « Système technique dont les matériaux, la fabrication et le maintien en fonctionnement requièrent des volumes de ressources tels que l’extraction sur la durée conduit à l’épuisement des ressources, dont la durée de vie est courte, et dont le fonctionnement et la fin de vie nécessitent des énergies à forte densité de puissance. La majorité des systèmes techniques issue de la révolution industrielle relève des technologies zombies. »
Comme chez Achille Mbembe, et dans le sillage donc de technologies zombies les précédant, ces nécrotechnies font émerger des corps morts-vivants, « des individus dépossédés de l’autonomie sur leur propre corps, oscillant dans un espace intermédiaire entre existence et disparition« . Une disparition qui, et c’est là tout le cynisme et génie mortifère du capitalocène, est à la fois orchestrée et subie par celle et ceux qui en sont les premières victimes, comme ces travailleuses et travailleurs pauvres qui, en Inde et en Chine notamment, filment leurs gestes pour entraîner des IA pour tenter de résoudre le paradoxe de Moravec tout en préparant l’avènement d’une robotisation dont les risques reposeront entièrement sur les plus fragiles et dont les bénéfices ne profiteront qu’aux plus riches et aux plus oisifs qui continueront de s’épuiser à attendre leur fantasme transhumaniste.
Attention, ces technologies d’IA ne sont pas les seules à s’inscrire dans la famille de ce que j’appelle une nécrotechnie. Toutes les technologies fossiles le sont également. La singularité des technologies d’IA est d’être à la fois fossiles et faussaires.
Et pour le reste :
« L’IA n’est ni intelligente ni artificielle. Elle n’est qu’une industrie du calcul intensive et extractive qui sert les intérêts dominants. Une technologie de pouvoir qui à la fois reflète et produit les relations sociales et la compréhension du monde. […] Les modèles permettant de comprendre et de tenir les systèmes responsables ont longtemps reposé sur des idéaux de transparence… […] Dans le cas de l’IA, il n’y a pas de boîte noire unique à ouvrir, pas de secret à révéler, mais une multitude de systèmes de pouvoir entrelacés. La transparence totale est donc un objectif impossible à atteindre. Nous parviendrons à mieux comprendre le rôle de l’IA dans le monde en nous intéressant à ses architectures matérielles, à ses environnements contextuels et aux politiques qui la façonnent, et en retraçant la manière dont ils sont reliés. »
Kate Crawford dans son Atlas de l’Intelligence Artificielle
Notes de lecture et de cours. Photo : Marie D. Martel, 2026
Ce billet clôt une série de trois textes consacrés aux transformations de la lecture. Après avoir interrogé l’idée d’une « société postlittéraire », puis rappelé que les pratiques de lecture se construisent aussi collectivement, ce troisième volet se tourne vers l’acte de lire lui-même : que deviennent notre attention, notre compréhension et notre capacité à lire en profondeur dans un environnement dominé par les écrans?
Dans le p
Notes de lecture et de cours. Photo : Marie D. Martel, 2026
Ce billet clôt une série de trois textes consacrés aux transformations de la lecture. Après avoir interrogé l’idée d’une « société postlittéraire », puis rappelé que les pratiques de lecture se construisent aussi collectivement, ce troisième volet se tourne vers l’acte de lire lui-même : que deviennent notre attention, notre compréhension et notre capacité à lire en profondeur dans un environnement dominé par les écrans?
Dans le premier billet de cette série, j’ai repris une question provocatrice posée récemment par Rose Horowitch qui fait la couverture du mois d’août dans The Atlantic : entrons-nous dans une société « postlittéraire »? Les données québécoises m’avaient conduite à résister à l’idée trop simple d’une « fin de la lecture ». Une partie non négligeable de la population lit toujours, et beaucoup. Ce qui semble plutôt se transformer, ce sont nos manières de lire, les supports que nous utilisons, le temps et l’attention que nous accordons aux textes. J’en arrivais alors à une inquiétude plus précise, liée à certains travaux comme ceux de Maryanne Wolf et Naomi S. Baron : ce qui pourrait se fragiliser n’est peut-être pas la lecture elle-même, mais la lecture longue, soutenue et profonde.
Dans le deuxième billet, j’ai déplacé la question de l’individu vers son environnement. Une société de lectrices et de lecteurs ne se construit pas toute seule. Elle repose sur toute une écologie de la lecture : des familles, des écoles, des bibliothèques, des librairies, des maisons d’édition, des médiateurs et médiatrices, mais aussi des livres accessibles, du temps, des lieux et des occasions de lire et de parler de ses lectures. Des réseaux. Lire n’est pas seulement une compétence individuelle : c’est une pratique culturelle et sociale dont nous construisons, ou fragilisons, collectivement les conditions. Reste cependant une troisième dimension du problème, que j’avais laissée en suspens, et c’est peut-être la plus délicate : qu’arrive-t-il à l’acte de lire lui-même dans un environnement devenu massivement numérique?
C’est ici que je retrouve ces deux autrices dont je présente les travaux depuis plusieurs années dans mes cours : Maryanne Wolf et Naomi S. Baron. Leurs travaux m’intéressent parce qu’ils permettent d’aller plus loin. Il ne s’agit plus seulement de savoir si nous lisons, ni même ce qui nous permet de devenir et de demeurer des lecteurs et des lectrices, mais comment nous lisons et ce que les environnements dans lesquels nous lisons font à notre attention, à notre compréhension et à notre capacité à cohabiter dans la durée avec un texte.
Mais qu’est-ce que « lire »?
Avant même d’opposer le papier et l’écran, Naomi S. Baron (2021) pose une question apparemment simple : de quoi parlons-nous lorsque nous disons « lire »? Lire Simone de Beauvoir, parcourir une chronique nécrologique, s’arrêter sur un haïku, consulter un article de Wikipédia ou lire un article dans Le Devoir : tout cela est bien de la lecture. Mais « lire » signifie manifestement des choses différentes dans chacun de ces cas. Et ces différences deviennent significatives dès que nous voulons comparer les avantages et les limites de l’imprimé, de l’écran ou même du livre audio.
Baron revient sur les distinctions qui sont faites habituellement entre plusieurs régimes de lecture. Nous pouvons pratiquer le skimming, c’est-à-dire parcourir rapidement un texte pour en saisir la structure ou l’idée générale; le scanning, en cherchant une information précise; ou nous engager dans une lecture suivie, attentive à la progression d’un texte (linear reading). Cette dernière forme de lecture n’est d’ailleurs pas nécessairement aussi « linéaire » que l’expression pourrait le laisser croire. Lire ne signifie pas toujours commencer à la première ligne et avancer méthodiquement jusqu’à la dernière. Nous pouvons lire un texte d’un trait, interrompre notre lecture et la reprendre, alterner des périodes de concentration et de distraction, revenir en arrière, relire un passage ou une œuvre entière. Nous pouvons également pratiquer une lecture « extensive », en circulant entre de nombreux textes, ou « intensive », en demeurant longuement avec quelques œuvres ou quelques sujets. Autrement dit, la lecture n’est pas associée à un comportement unique que l’on pourrait simplement transférer du papier vers l’écran et mesurer ensuite lequel des deux « gagne ».
Cette dernière suggestion me paraît importante pour mettre en dialogue les travaux de Wolf et de Baron. Toutes deux s’intéressent aux transformations de la lecture dans une culture devenue largement numérique. Toutes deux reconnaissent aussi que nos manières de lire sont façonnées par nos pratiques et que certaines formes de lecture demandent davantage de temps et d’attention que d’autres. La proximité de ces deux autrices est d’ailleurs manifeste : Wolf signe la préface de How We Read Now, l’ouvrage dans lequel Baron examine précisément ce que deviennent nos pratiques de lecture à l’ère des écrans.
Leurs perspectives sont donc moins opposées que complémentaires. Wolf part du cerveau lecteur et de sa plasticité : puisque nous ne sommes pas biologiquement programmés pour lire, les circuits qui rendent la lecture possible se construisent avec l’apprentissage et se transforment avec nos usages. Elle s’interroge dès lors sur ce que l’environnement numérique peut faire aux processus plus lents associés à la lecture profonde. Baron se concentre plutôt sur les situations de lecture. Avant de demander si nous lisons mieux sur papier ou sur écran, encore faut-il savoir de quelle lecture nous parlons, dans quel but et dans quelles conditions.
Lire ces deux autrices en chorale permet ainsi de se demander, non pas simplement « le papier est-il meilleur que l’écran? », mais quelles manières de lire nos différents environnements favorisent-ils, et avec quels effets?
Nous ne sommes pas né.es pour lire
Il y a quelque chose de vertigineux, je trouve, dans l’idée qui sert de point de départ à Maryanne Wolf : nous ne sommes pas né.es pour lire. Contrairement au langage oral, la lecture n’est pas une capacité pour laquelle notre cerveau aurait été biologiquement programmé. Elle est une invention culturelle. Chaque nouveau lecteur ou nouvelle lectrice doit donc construire un circuit de lecture en coordonnant des capacités visuelles, linguistiques, cognitives et affectives initialement destinées à d’autres fonctions. Et ce circuit n’est pas identique chez l’enfant qui déchiffre ses premiers mots et chez la personne lectrice expérimentée. Il se développe avec l’apprentissage, l’éducation et les expériences de lecture. Surtout, parce que notre cerveau demeure plastique, il continue de se transformer avec les usages que nous en faisons.
C’est le point de départ de Reader, Come Home, publié par Wolf en 2018. (Au passage, la traduction française de Wolf, sous le titre de Lecteur, reste avec nous !(2023) doit beaucoup à l’initiative de Joël Dicker : il a choisi d’en faire l’un des premiers titres publiés par sa maison Rosie & Wolfe, dans une traduction de Nicolas Véron qu’il préface lui-même). La neuroscientifique y aborde une question qui, à l’ère du téléphone intelligent et maintenant de l’intelligence artificielle générative, paraît aujourd’hui encore plus pressante : que devient notre cerveau lecteur lorsque l’environnement dans lequel nous lisons change?
Car il a changé. On l’a bien souligné. Nous lisons désormais une quantité considérable de textes sur des écrans. Nous passons d’un texte ou d’un contenu à l’autre, suivons des liens, faisons défiler des pages, cherchons une information, survolons un passage avant de décider s’il mérite davantage d’attention. Nous lisons toujours. Mais apprenons-nous progressivement à lire autrement, selon des modalités et dans un environnement attentionnel qui sont, à bien des égards, inédits?
Ce que nous risquons de perdre : la lecture profonde ?
C’est ici qu’intervient une notion centrale chez Wolf, celle de deep reading, la lecture profonde. Elle ne désigne pas simplement le fait de comprendre les mots d’un texte ou d’être capable d’en restituer l’idée générale. Wolf rassemble sous cette expression un ensemble de processus acquis par le lecteur ou la lectrice expérimentée : établir des inférences, relier ce que nous lisons à ce que nous savons déjà, produire des analogies, adopter le point de vue d’autrui, exercer notre jugement critique et laisser émerger une réflexion qui n’était pas immédiatement contenue dans les mots du texte. La lecture profonde se rapproche ainsi de ce que différentes traditions, de la critique littéraire ou de la philosophie de la littérature, ont appelé slow reading, close reading, lecture attentive ou lecture critique, sans se confondre entièrement avec elles. Leur point commun est néanmoins fondamental : elles exigent du temps! Du temps pour s’arrêter. Revenir en arrière. Interpréter. Associer. Douter. Réfléchir.
Wolf insiste sur cette dimension temporelle. Les processus associés à la lecture experte mettent des années à se développer. Et puisqu’ils reposent sur un cerveau plastique, ils ne doivent pas être considérés comme définitivement acquis. Les circuits que nous mobilisons et renforçons dépendent en partie de nos expériences, de notre environnement, de nos intentions et des formes de lecture que nous pratiquons. D’où son inquiétude.
Les comportements caractéristiques d’une grande partie de notre vie numérique (parcourir, sélectionner, faire défiler, rechercher, passer rapidement d’un contenu à l’autre) sont extrêmement efficaces lorsqu’il s’agit de traiter de grandes quantités d’information. Le skimming et le scanning ne sont pas de « mauvaises » lectures. Nous en avons besoin. Mais que se passe-t-il lorsqu’un régime de lecture fondé sur la rapidité, le tri et le changement fréquent de cible attentionnelle devient dominant?
Wolf rappelle alors un principe trop bien connu, qui prend ici un tour particulièrement dramatique : use it or lose it. Les capacités que nous exerçons se renforcent; celles que nous sollicitons moins risquent de s’affaiblir. Un circuit de lecture experte n’est jamais entièrement permanent. Il se construit et se reconstruit par l’usage. Si nous consacrons de moins en moins de temps aux processus plus lents de la lecture, ceux-ci risquent-ils de devenir plus difficiles à mobiliser? Voilà l’hypothèse troublante de Wolf.
Mais cette hypothèse contient peut-être aussi une sorte de piège dans la mesure où elle peut facilement nous conduire à une opposition trop simple : le livre imprimé serait le domaine naturel de la profondeur tandis que l’écran nous condamnerait à la superficialité. C’est précisément là que Naomi Baron complique utilement le tableau.
Naomi S. Baron complique l’opposition entre papier et écran
Dans How We Read Now, Naomi Baron s’intéresse elle aussi à la transformation de nos pratiques de lecture dans un environnement devenu largement numérique. Elle pose plusieurs des mêmes questions que Wolf : que gagnons-nous et que perdons-nous en passant du papier à l’écran? Quel support convient le mieux à quel type de lecture? Les jeunes lecteurs et lectrices pourront-ils développer une lecture attentive dans un univers dominé par les écrans?
Mais son approche est plus pragmatique. Elle insiste surtout sur le fait que nous ne lisons pas toujours de la même manière ni pour les mêmes raisons. Chercher rapidement une information, étudier un texte, lire pour le plaisir ou mémoriser quelque chose ne mobilisent pas les mêmes stratégies. Le papier et le numérique ne sont donc pas simplement deux supports interchangeables : ils s’inscrivent dans des usages pluriels. La divergence entre Baron et Wolf ne tient pas à une opposition entre une défense du papier et une défense du numérique. Wolf demande : que devient notre cerveau si nous nous habituons à lire de cette manière? Baron pose le problème autrement : de quelle manière de lire parlons-nous, et dans quel contexte?
Cette distinction est importante. Le problème n’est peut-être pas l’écran en soi, mais ce que nous avons appris à faire lorsque nous sommes devant un écran. Et inversement, l’imprimé ne garantit pas à lui seul une lecture profonde. Les recherches empiriques récentes tendent d’ailleurs à aller dans ce sens, comme le montrent des revues systématiques et méta-analyses comparant la compréhension sur papier et sur écran. Et, il semble que, en moyenne, les différences entre les deux soient relativement modestes. On observerait souvent un léger avantage du papier, surtout pour ce qui est des textes informatifs et lorsque le temps de lecture est limité, alors que l’écart tend à devenir négligeable pour les textes narratifs (Clinton, 2019; Delgado et Salmerón, 2021; Salmerón et al., 2024; Schwabe et al., 2022).
Puis, d’autres facteurs entrent également en jeu : le temps disponible, les compétences de la personne qui lit, son objectif, mais aussi la conception de l’interface numérique (Latini et al., 2019; Delgado et Salmerón, 2021; Stiegler-Balfour et al., 2023). Même le mode de navigation peut jouer un rôle : revenir facilement dans le texte ou lire des pages successives ne produit pas nécessairement la même expérience que faire défiler continuellement un écran (Haverkamp et al., 2023). Il faut donc remplacer la simple opposition papier / écran par une question plus large : quel type de lecture, sur quel support, dans quel contexte et pour quel objectif?
Le numérique nous entraîne-t-il à lire autrement?
Reste cependant la grande inquiétude de Wolf : les habitudes développées dans nos lectures numériques peuvent-elles finir par se transférer aux situations où nous voudrions lire autrement? Certaines recherches apportent des indices en ce sens. Hakemulder et Mangen (2024) observent notamment une association entre la fréquence de lecture de textes courts sur écran et une moindre disposition à fournir l’effort cognitif nécessaire à la lecture d’un texte littéraire plus long. Cela pourrait indiquer que des habitudes comme le skimming et le scanning deviennent plus spontanées et se transfèrent à d’autres situations de lecture — y compris, potentiellement, à la lecture de textes longs sur papier.
Une étude longitudinale de Salmerón et ses collègues (2025) apporte toutefois une nuance importante. Les personnes chercheuses ont suivi des enfants pendant un an pour tester l’hypothèse inspirée de la digital chain hypothesis de Wolf : les habitudes de lecture numérique finiraient-elles par affecter l’attention sélective — c’est-à-dire la capacité à se concentrer sur l’information pertinente en écartant les distractions — et, par cette voie, la compréhension? Or, les résultats ne montrent pas que les habitudes de lecture sur écran diminuent cette capacité d’attention. Chez les plus jeunes élèves, ceux qui lisaient davantage sur écran pour leur travail scolaire obtenaient néanmoins, un an plus tard, des résultats légèrement moins bons en compréhension. Cet effet, faible, ne se retrouvait pas chez les élèves plus âgés. La différence observée chez les plus jeunes devrait donc s’expliquer par autre chose qu’une diminution de leur attention sélective.
Il faut donc préserver une posture prudente. Nous disposons encore de peu de données montrant que nos habitudes numériques transforment durablement notre capacité à lire en profondeur. Il y a une différence énorme entre constater que certaines pratiques numériques sont associées à une lecture plus superficielle vs affirmer qu’elles nous rendent peu à peu incapables de lire profondément — voire, pour reprendre une autre formule provocatrice, complètement crétin.es. Le premier constat dispose d’un certain nombre d’appuis empiriques; la seconde demeure une hypothèse. La préoccupation formulée par Wolf mérite donc d’être prise au sérieux, mais elle n’est pas encore démontrée. Et cette incertitude me paraît être une raison de chercher davantage, non de s’alarmer davantage.
Un cerveau bilittéracié plutôt qu’un retour au papier
Wolf ouvre cependant une autre piste prometteuse et qui est parfois qualifiée de plus « optimiste ». Sa réponse n’est pas de bannir les écrans ni de rêver à un retour à un âge d’or du livre imprimé. Elle propose plutôt de cultiver ce qu’elle appelle un cerveau bilittéracié (bi-literate brain) : un cerveau capable de tirer parti des possibilités du numérique tout en préservant et en activant, lorsque la situation le demande, les processus associés à la lecture profonde.
L’idée semble aujourd’hui plus féconde encore que l’opposition entre papier et écran. La véritable compétence à développer pourrait être celle du changement de régime de lecture. Nous devons savoir parcourir rapidement une masse documentaire, chercher un renseignement, suivre des liens, comparer des sources, sélectionner l’information pertinente et naviguer dans des environnements complexes. Ces compétences sont indispensables dans une culture numérique. Mais nous devons AUSSI pouvoir ralentir même sur les écrans. Rester avec un texte. Revenir en arrière. Relire. Tolérer qu’une idée ne se livre pas immédiatement. Construire au fur et à mesure une représentation d’ensemble. Faire des inférences. Douter. Relier. Réfléchir.
La littérature récente apporte d’ailleurs une raison d’être optimiste en ce sens : les effets associés au numérique ne seraient pas inévitables. Les stratégies des personnes lectrices, la conception des interfaces et les interventions pédagogiques pourraient modifier les résultats. C’est aussi, au fond, ce que permet de penser la neuroplasticité. Si nos pratiques contribuent à façonner les circuits que nous utilisons pour lire, cette plasticité n’est pas seulement une vulnérabilité. Elle est également une possibilité. Et c’est ici qu’une lecture toute récente peut nous faire voir l’argument de Wolf sous un autre angle.
De la neuroplasticité à la praxis
Dans l’édition du 23 août de l’infolettre Sentiers, Patrick Tanguay attire justement notre regard sur un essai de Matt Seybold au titre particulièrement suggestif : « Neuroplasticity as a Praxis ». Seybold y reprend notamment les travaux de Nicholas Carr et de Maryanne Wolf, mais les amène sur un terrain plus politique. Son point de départ est proche de celui qui nous occupe ici : puisque les circuits de la lecture sont construits plutôt que donnés, ils peuvent se développer, se modifier et aussi se fragiliser. Mais Seybold propose d’aller plus loin. La difficulté que nous pouvons éprouver aujourd’hui à lire profondément, à écouter attentivement et à discuter de manière critique ne devrait pas, selon lui, être comprise seulement comme le résultat de mauvaises habitudes individuelles. Elle doit aussi être replacée dans des environnements médiatiques, technologiques et économiques qui favorisent la captation et la monétisation de notre attention. La nuance est importante. Jusqu’ici, j’ai surtout demandé dans ce billet : que faisons-nous à notre cerveau lorsque nous lisons de cette manière?
Seybold nous conduit à ajouter une autre question : qui construit les environnements dans lesquels nous apprenons désormais à lire de cette manière? Son argument est explicitement politique. Selon lui, Carr et Wolf avaient bien compris que les technologies numériques pouvaient contribuer à remodeler nos pratiques cognitives, mais il et elle n’avaient peut-être pas suffisamment anticipé à quel point ce remodelage pourrait être orienté par des acteurs et des modèles économiques ayant intérêt à retenir et à monétiser notre attention. Seybold propose même le terme de deliberate deliteracy, que l’on pourrait traduire par « délittératie délibérée », pour désigner le démantèlement, la restriction ou la monopolisation des infrastructures qui rendent possible le maintien d’une littératie largement partagée.
Cette interprétation mérite certainement d’être discutée. Elle dépasse ce que les recherches empiriques sur les effets de la lecture numérique permettent à elles seules d’établir. Mais elle opère un changement de perspective qui me paraît particulièrement productif : la neuroplasticité cesse d’être seulement une question de cognition individuelle pour devenir aussi une question d’organisation collective.
Et surtout, Seybold retourne l’argument. Si notre cerveau lecteur demeure plastique, alors les environnements numériques ne sont pas les seuls à pouvoir le façonner. Nous pouvons aussi construire des pratiques, des institutions et des communautés qui exercent cette plasticité autrement. C’est ce qu’il entend par neuroplasticity as a praxis.
Dans son texte, lire attentivement n’est donc plus seulement une préparation à l’action. Lire, écouter et discuter deviennent eux-mêmes des formes d’action. Et pour que cette action dépasse l’effort de quelques individus tentant de résister seuls à l’économie de l’attention, elle doit, selon lui, devenir collective : groupes de lecture, cercles de discussion, séminaires, réseaux de prêt, communautés qui lisent et pensent ensemble. Or, cette approche m’intéresse particulièrement parce qu’elle rejoint, par un autre chemin, ce que j’essayais de montrer dans le billet précédent. Une société de lectrices et de lecteurs ne se construit pas toute seule. Les circuits neuronaux de la lecture non plus.
L’infrastructure de la lecture est aussi une infrastructure de l’attention
Cette rencontre entre Wolf et Seybold permet peut-être de réunir les trois billets de cette série. Le premier conduisait à un constat : la lecture ne disparaît pas; elle se recompose. Le deuxième ajoutait qu’une culture de la lecture n’existe jamais spontanément : elle dépend d’une infrastructure sociale, culturelle et institutionnelle qu’il faut entretenir. Celui-ci invite à en élargir encore la définition. Préserver l’accès aux livres et le désir de lire ne suffit peut-être pas : l’infrastructure de la lecture comprend aussi les conditions qui rendent certaines formes d’attention plus faciles à exercer, qui permettent de ralentir et de rester suffisamment longtemps avec un texte.
Le problème n’est donc peut-être pas simplement que nous lisions désormais sur des écrans. Il tient aussi à l’écologie dans laquelle se déroule une part croissante de nos activités numériques : vitesse, abondance, sollicitations et passage incessant d’un contenu à l’autre. Cette écologie n’est pas tombée du ciel. Elle est faite de plateformes, d’interfaces, de modèles économiques, de normes sociales et de choix technologiques. Penser l’infrastructure de la lecture à l’ère numérique suppose alors de s’intéresser aussi à ses conditions attentionnelles : les temps, les lieux, les dispositifs et les pratiques qui rendent possible une attention longue.
Certaines bibliothèques en offrent déjà des exemples intéressants. On voit notamment se multiplier les Silent Reading Parties (voir notamment la Seattle Public Library et la Richmond Public Library), où des personnes se réunissent avec le livre de leur choix pour lire ensemble, en silence, pendant une période réservée à cette seule activité. Il serait excessif d’en faire automatiquement des expériences de « lecture profonde » au sens où l’entend Wolf. Mais elles ont quelque chose de remarquable : elles organisent les conditions de l’attention. Ce qui pourrait sembler une activité strictement individuelle — s’asseoir et lire pendant une heure — devient une pratique soutenue par un lieu, un temps et la présence des autres.
À première vue, lire silencieusement ensemble et apprendre à désactiver des fonctions d’IA peuvent sembler deux activités très éloignées. Elles ont pourtant quelque chose en commun : elles permettent de reprendre une certaine maîtrise de notre environnement attentionnel. La bibliothèque ne donne plus seulement accès aux textes, à l’information et aux technologies. À la manière d’un refuge, elle peut aussi offrir une certaine distance critique à leur égard : créer du temps pour lire sans sollicitation et donner les moyens de choisir quand et comment nous voulons utiliser les technologies qui nous entourent.
Le déplacement proposé par Seybold prend alors tout son sens. Protéger la possibilité d’une lecture profonde ne consisterait pas seulement à exhorter chacun et chacune à poser son téléphone et à lire davantage. Cela pourrait aussi vouloir dire organiser collectivement les conditions permettant de lire, d’écouter et de discuter attentivement.
On retrouve ici quelque chose de l’esprit de la littératie communautaire, qui envisage la lecture non seulement comme une compétence individuelle, mais comme une pratique sociale, située et partagée. La communauté peut ainsi devenir une communauté de lecture profonde : un espace où l’attention se soutient mutuellement, où les interprétations se confrontent et où le sens se construit avec d’autres. Les écoles et les universités ont évidemment une responsabilité comparable lorsqu’elles ménagent encore la possibilité de lire une œuvre entière plutôt que son résumé, de suivre un raisonnement plutôt que d’en extraire immédiatement quelques informations, de revenir à un texte plutôt que de simplement le traverser et, surtout, d’en discuter avec d’autres.
L’intelligence artificielle rend cet enjeu plus aigu encore. Elle nous permet désormais d’obtenir en quelques secondes le résumé, l’explication ou l’analyse d’un texte. Ce qui devient alors précieux n’est peut-être plus seulement l’accès au contenu, mais l’expérience cognitive et intellectuelle que nous acceptons d’accomplir nous-mêmes pour y parvenir. Lire un texte n’est pas seulement accéder à ce qu’il contient : c’est aussi exercer les opérations qui permettent de l’interpréter, de l’interroger, de le mettre en relation avec d’autres idées et, parfois, de résister à la facilité d’une réponse déjà produite.
La neuroplasticité nous rappelle que nos manières de lire ne sont pas immuables : elles se développent et s’exercent avec nos pratiques. Cela ne signifie pas, comme on l’a vu, que les écrans détériorent nécessairement nos capacités attentionnelles. Mais si certains environnements nous incitent à accélérer, à survoler ou à passer constamment d’un contenu à l’autre, nous pouvons aussi aménager des conditions qui facilitent le geste inverse : ralentir, s’attarder, relire, discuter. L’infrastructure de la lecture est, en ce sens, aussi une infrastructure de l’attention et re-littératie.
Apprendre à changer de régime de lecture
C’est pourquoi, pour revenir à celle-ci, la proposition de Wolf d’un cerveau bilittéracié me paraît particulièrement forte. Il ne s’agit pas de choisir entre Gutenberg et le numérique, ni de transformer le papier en étendard contre la modernité. Il s’agit de devenir capables de reconnaître les différents régimes de lecture et de passer consciemment de l’un à l’autre. Savoir quand parcourir. Quand chercher. Quand sélectionner. Mais aussi quand ralentir. Quand revenir. Quand relire. Quand s’attarder. Et peut-être faut-il désormais ajouter : quand lire ensemble.
Alors, pour reprendre la question du titre : que devient la lecture profonde à l’ère numérique? On pourrait dire, qu’elle ne disparaît pas, pas plus que la lecture elle-même. Mais elle ne va peut-être plus de soi. Dans un environnement qui nous entraîne souvent vers la vitesse, la sollicitation et le passage d’un contenu à l’autre, elle devient une pratique qu’il faut consciemment, intentionnellement, préserver, exercer et soutenir. Lire autrement, ce serait alors non pas renoncer au numérique, mais apprendre à choisir notre manière de lire : savoir profiter de la rapidité, de l’accès et de la puissance de recherche qu’il permet, tout en demeurant capables, lorsque le texte et la situation le demandent, de ralentir, de soutenir notre attention et d’aller en profondeur.
Mais cette capacité de choisir ne relève pas seulement de la volonté individuelle. Nous ne choisissons jamais nos régimes de lecture dans le vide. Les plateformes, les interfaces, les modèles économiques, les institutions et les espaces dans lesquels nous lisons organisent eux aussi notre attention : ils rendent certaines manières de lire plus faciles, plus habituelles ou plus désirables que d’autres.
Désormais, plutôt que de demander seulement aux individus de mieux gérer leur attention, il faut aussi examiner de manière critique les infrastructures qui la sollicitent, la captent et l’organisent. Défendre la possibilité d’une lecture profonde suppose alors non seulement de préserver certaines pratiques de lecture, mais aussi de transformer les environnements qui les fragilisent et d’en construire d’autres qui puissent les soutenir.
La question qui traverse finalement ces trois billets n’est donc peut-être pas : allons-nous continuer à lire? Elle serait plutôt : quelles formes de lecture voulons-nous préserver, et quelles infrastructures devons-nous transformer ou construire collectivement pour continuer à en être capables?
Car une société de lectrices et de lecteurs ne se construit pas toute seule. Une société capable de lecture profonde non plus.
Le fondateur de Microsoft croit que l’intelligence artificielle présente un défi «monumental» pour l’humanité.
Dans un long essai publié en ligne et dont la portée est amplifiée par une entrevue qu’il a donnée au New York Times, le célèbre entrepreneur devenu philanthrope fait plusieurs suggestions dont:
imposer une taxe pour décourager les organisations de remplacer des employés par l’IA – et distribuer les fonds ainsi perçus aux travailleurs qui auront perdu leur emploi à cause de
Le fondateur de Microsoft croit que l’intelligence artificielle présente un défi «monumental» pour l’humanité.
Dans un long essai publié en ligne et dont la portée est amplifiée par une entrevue qu’il a donnée au New York Times, le célèbre entrepreneur devenu philanthrope fait plusieurs suggestions dont:
imposer une taxe pour décourager les organisations de remplacer des employés par l’IA – et distribuer les fonds ainsi perçus aux travailleurs qui auront perdu leur emploi à cause de l’IA;
réserver certaines tâches aux humains en interdisant qu’elles soient confiées à l’IA ou à des robots.
Ivado, un consortium de recherche en intelligence artificielle piloté par l’Université de Montréal, a créé l’automne dernier un code visant à encadrer un usage responsable de l’IA en politique.
En adhérant au code, les partis s’engagent notamment à:
favoriser la transparence;
limiter les risques liés aux hypertrucages et aux contenus trompeurs.
La Caq et Québec solidaire avaient adhéré à ce code de conduite en mars dernier.
Le Parti québécois et le Parti libéral du Québ
Ivado, un consortium de recherche en intelligence artificielle piloté par l’Université de Montréal, a créé l’automne dernier un code visant à encadrer un usage responsable de l’IA en politique.
En adhérant au code, les partis s’engagent notamment à:
favoriser la transparence;
limiter les risques liés aux hypertrucages et aux contenus trompeurs.
La Caq et Québec solidaire avaient adhéré à ce code de conduite en mars dernier.
Le Parti québécois et le Parti libéral du Québec viennent de signer.
Le Parti conservateur du Québec est le seul à ne pas adhérer au code.
Selon un sondage de l’Association médicale canadienne (AMC) réalisé cette année, un peu plus de la moitié des Canadiens utilisent des outils d’intelligence artificielle comme ChatGPT pour obtenir des conseils sur leur santé.
Toutefois, les personnes qui suivent ces conseils courent des risques de subir des effets néfastes.
Beaucoup de répondants du sondage en sont conscients.
Le Dr Jean-Joseph Condé, porte-parole de l’AMC, explique à InfoBref que l’IA a tendance à construire des
Selon un sondage de l’Association médicale canadienne (AMC) réalisé cette année, un peu plus de la moitié des Canadiens utilisent des outils d’intelligence artificielle comme ChatGPT pour obtenir des conseils sur leur santé.
Toutefois, les personnes qui suivent ces conseils courent des risques de subir des effets néfastes.
Beaucoup de répondants du sondage en sont conscients.
Le Dr Jean-Joseph Condé, porte-parole de l’AMC, explique à InfoBref que l’IA a tendance à construire des réponses selon les informations dominantes qu’elle trouve sur le web – que ces informations soient vraies ou non.
La facilité d’utilisation des robots conversationnels d’IA pousse beaucoup de personnes à s’en servir, croit Jean-Joseph Condé.
«Avant, les gens devaient chercher des articles, puis les lire et analyser l’information. Aujourd’hui, l’intelligence artificielle fait toutes ces tâches pour eux.»
Impacts nocifs de l’IA
Le médecin identifie plusieurs impacts nocifs sur la santé que peut avoir l’information fournie par les robots d’IA.
L’information que génère l’IA n’est pas nécessairement exacte.
«On ne sait pas toujours d’où vient l’information, dit Dr Condé. C’est dangereux sachant qu’elle peut provenir de sources erronées.»
Il souligne un paradoxe: 69% des répondants au sondage de l’AMC éprouvent de la méfiance à l’égard des informations de santé trouvées en ligne, comme celle trouvées à l’aide de l’IA.
Les traitements prescrits ou recommandés par des professionnels de la santé ne sont pas toujours respectés par les patients qui utilisent l’IA.
L’expert note que l’IA peut même pousser des personnes à arrêter des traitements médicaux vitaux, comme la chimiothérapie ou le traitement du diabète, pour se tourner vers des produits ou des méthodes non prouvés scientifiquement.
L’anxiété générée par les réponses de l’IA est un autre problème.
Le Dr Condé explique que l’intelligence artificielle exacerbe un problème qui existait déjà depuis l’apparition des moteurs de recherche comme Google:
«Les patients qui cherchent sur Internet les causes de leurs symptômes, même bénins, peuvent avoir tendance à s’autodiagnostiquer des maladies graves.»
Ce phénomène a pris de l’ampleur avec les robots d’IA, qui donnent des réponses en apparence complètes plus rapidement que les moteurs de recherche traditionnels.
Pistes de solutions
L’information diffusée sur Internet pourrait être mieux contrôlée par les géants du web et par le gouvernement, afin d’éviter la propagation de fausses informations, estime Jean-Joseph Condé.
L’accès aux soins de santé doit aussi être amélioré, dit le médecin.
Il note qu’environ 6,5 millions de Canadiens et 2 millions de Québécois n’ont pas de médecin de famille.
Selon lui, pour améliorer l’accès aux soins de première ligne, le système de santé devrait se concentrer sur le développement d’équipes multidisciplinaires incluant des infirmières, physiothérapeutes et pharmaciens.
La productivité des médecins pourrait, en parallèle, s’améliorer grâce aux bénéfices de l’IA, croit le médecin.
Il note que moins du tiers des médecins utilisent actuellement l’IA pour les aider à réaliser des tâches administratives.
Les discussions récentes autour du déclin de la lecture et l’échange que j’ai eu avec Alexandre Sirois m’ont donné envie de revenir sur une question qui me préoccupe depuis un certain temps déjà : sommes-nous réellement en train de devenir une société qui lit moins?
Un article récent de The Atlantic, « The End of Reading Is Here » établit le diagnostic de manière particulièrement saisissante en évoquant l’entrée dans une possible « ère postlittéraire ». L’article qu’Alexandre Sirois lui a
Les discussions récentes autour du déclin de la lecture et l’échange que j’ai eu avec Alexandre Sirois m’ont donné envie de revenir sur une question qui me préoccupe depuis un certain temps déjà :sommes-nous réellement en train de devenir une société qui lit moins?
Un article récent de The Atlantic, « The End of Reading Is Here » établit le diagnostic de manière particulièrement saisissante en évoquant l’entrée dans une possible « ère postlittéraire ». L’article qu’Alexandre Sirois lui a consacré dans La Presse, à l’occasion du 12 août, contribue malgré tout à déplacer la réflexion vers une autre question :quelles conditions devons-nous préserver ou créer pour demeurer une société de lecteurs et de lectrices?
Je propose donc d’explorer ces enjeux en trois billets avant que la rentrée nous happe. Le premier reviendra sur le diagnostic de Rose Horowitch et sur cette idée forte d’une société « post-littéraire » ou « post-lettrée ». C’est l’article d’Alexandre Sirois qui servira de déclencheur pour le deuxième, notamment pour s’intéresser auxconditions collectives de la lecture— bibliothèques, écoles, librairies, familles, organismes et politiques publiques. Enfin, le troisième s’appuiera notamment sur les travaux deMaryanne Wolf et Naomi Baron,deux autrices que je présente régulièrement dans mes cours, pour examiner ce que le numérique, les écrans et, désormais, l’intelligence artificielle changent à nos façons de lire, à notre attention et à notre capacité à entrer dans une lecture profonde.
L’objectif n’est donc pas d’annoncer, encore une fois!, la fin de la lecture ou la mort du livre, pas plus que de céder à la nostalgie du papier. Je voudrais simplement contribuer à cette conversation pourmieux comprendre les transformations en cours et réfléchir aux conditions qui pourraient permettre à la lecture et à la pensée de conserver une fonction importante dans nos vies individuelles et collectives.
Il n’est pas nécessaire de brûler les livres pour qu’ils disparaissent de nos vies. Il suffit, suggérait Ray Bradbury en 1993 dans le Seattle Times, que nous cessions de les lire (« You don’t have to burn books to destroy a culture. Just get people to stop reading them. »). Cette formule prend une résonance particulière à la lecture du long article que Rose Horowitch vient de consacrer, dans The Atlantic, et à ce qu’elle présente comme une transformation historique : l’entrée possible dans une société « postlittéraire ». Le titre donne le ton : The End of Reading Is Here. La fin de la lecture serait arrivée. (Étonnamment, cette célèbre formule de Bradbury ne traverse pas l’article de Horowitch, alors qu’elle semble planer sur tout le diagnostic qu’elle prononce).
L’affirmation est spectaculaire. Elle mérite qu’on s’y arrête, mais aussi qu’on la nuance. Car Horowitch ne soutient pas que nous serions soudainement devenus incapables de lire. Nous n’avons probablement jamais été exposés à autant de mots : textos, courriels, publications sur les réseaux sociaux, notifications, fils de discussion, nouvelles en ligne et tutti quanti. Nous passons une bonne partie de nos journées à lire quelque chose.
Son inquiétude porte sur une autre forme de lecture, la lecture profonde : celle qui demande de rester longtemps avec un texte, de suivre un raisonnement, de tolérer momentanément de ne pas comprendre puis de revenir en arrière, d’interpréter, de faire des inférences et de construire progressivement du sens. Autrement dit, la question n’est peut-être pas simplement : lisons-nous moins? Elle pourrait plutôt être : Avons-nous encore la disposition et la capacité nécessaires pour lire de manière profonde?
Une société qui sait lire, mais qui lit autrement
Horowitch rassemble une série de données américaines inquiétantes : recul de la lecture de livres et de la lecture pour le plaisir, diminution de certaines compétences en compréhension, difficultés croissantes devant des textes complexes, chez les jeunes comme chez les adultes. Mais son argument devient beaucoup plus intéressant lorsqu’elle distingue l’alphabétisation, la littératie et la culture de l’écrit.
Une société « postlittéraire » n’est pas nécessairement une société peu alphabétisée. C’est une société dans laquelle les individus savent toujours lire, mais où la lecture longue et soutenue cesse progressivement d’occuper un rôle central dans la vie culturelle et intellectuelle. La thèse de Horowitch va cependant plus loin : la lecture longue tendrait à devenir une pratiqueencore plus minoritaire et, ce faisant, à perdre la fonction structurante qu’elle aurait longtemps exercée dans la culture commune. Le problème ne serait donc pas seulement que certains individus lisent moins, mais que cette forme de lecture soit de moins en moins largement partagée.
C’est une distinction importante. Décoder un texte, le comprendre, l’interpréter et penser avec lui ne sont pas exactement la même chose.
Horowitch s’appuie ici sur une archéologie de la lecture. L’être humain n’est pas né lecteur. L’écriture et la lecture sont des technologies culturelles que nous avons apprises et qui, en retour, ont contribué à transformer nos manières de penser. La culture écrite a notamment favorisé certaines pratiques intellectuelles : suivre un raisonnement sur plusieurs pages, confronter des propositions, revenir sur une idée, comparer des passages, construire une argumentation, maintenir son attention malgré la difficulté. D’où une des hypothèses centrales de l’article, qui vaut la peine d’être prise au sérieux : si l’apprentissage de la lecture a transformé nos manières de penser, que pourrait produire son recul?
Du livre à TikTok : une nouvelle économie de l’attention
La télévision devait encore être allumée; ses programmes avaient un début et une fin. Le téléphone intelligent, lui, nous accompagne partout et donne accès à une offre de divertissement pratiquement illimitée. Et Internet lui-même se reconfigure. L’univers numérique des débuts était largement textuel. Une part croissante de l’attention est désormais captée par TikTok, les Reels, YouTube Shorts et d’autres formats audiovisuels courts. Le changement ne consiste donc plus seulement à dire que les écrans concurrencent les livres. C’est le statut du texte lui-même dans notre environnement informationnel qui est toujours un peu plus en décalage.
Horowitch décrit alors une sorte de cercle vicieux : moins de lecture longue et profonde → moins d’endurance attentionnelle → davantage de difficulté à lire des textes complexes → moins de plaisir à les lire → encore moins de lecture longue.
L’hypothèse est préoccupante, notamment pour l’école. Si l’on rencontre de moins en moins souvent des œuvres intégrales et des textes exigeants, comment développe-t-on les capacités — voire les circuits neuronaux — qui permettent de les lire en profondeur et de penser de manière critique?
Et maintenant, l’IA
L’arrivée de l’intelligence artificielle générative ajoute une dimension nouvelle au problème. Jusqu’ici, les technologies numériques permettaient surtout de contourner l’effort de la lecture longue. L’IA permet maintenant de déléguer une partie de l’écriture elle-même : résumer un texte, produire une argumentation, reformuler une idée, voire lire une œuvre à notre place pour nous en restituer « l’essentiel ». Or, écrire n’est pas seulement transcrire une pensée déjà constituée.
Nous écrivons aussi pour découvrir ce que nous pensons. Ce carnet, pour moi, a souvent joué ce rôle, comme d’autres avant lui : c’était le « vide-grenier », mais aussi l’atelier, le lieu où les concepts se déposent, se cherchent, se frottent les uns aux autres et, parfois, émergent. Chercher un mot, organiser un argumentaire, supprimer une phrase, critiquer : tout cela participe au travail de la pensée. La question posée par l’IA devient alors particulièrement intéressante : que se passe-t-il lorsque nous pouvons externaliser non seulement une partie de la lecture, mais aussi une partie de l’effort nécessaire pour étayer notre pensée? C’est probablement l’une des questions les plus fécondes soulevées par l’article.
De la lecture à la démocratie : attention aux raccourcis
Horowitch va cependant encore plus loin. Elle suggère la présence d’un lien entre le recul de la culture écrite et des évolutions récentes du discours politique. Dans un environnement dominé par l’immédiateté, les algorithmes et les contenus courts, les messages simples, polarisants, personnalisés et émotionnellement chargés disposeraient d’un avantage considérable. Donald Trump devient, dans son analyse, une figure emblématique de cette politique « postlittéraire ». Cette hypothèse est intéressante et appelle une discussion; c’est aussi à cet endroit que l’article appelle peut-être davantage de distance critique.
Car il y a une différence entre constater des changements bien documentés de nos pratiques médiatiques et attentionnelles et leur attribuer directement des basculements aussi complexes que celles de la démocratie et de la vie politique. Plus généralement, le passage de « nos pratiques de lecture se transforment » à « nous entrons dans une société postlittéraire » constitue un saut et une interprétation beaucoup plus ambitieuse que ce que les données qu’elle présente le démontrent à elles seules.
Et au Québec?
C’est également ici qu’il faut résister à la tentation de transposer directement au Québec le diagnostic très américain que dresse l’autrice. Les données québécoises récentes offrent un portrait relativement nuancé par rapport à celles des États-Unis. Selon l’Enquête québécoise sur les loisirs culturels et le divertissement de 2024, que j’ai consultée et partagée avec un grand intérêt, 82 % des Québécois et Québécoises de 15 ans et plus déclarent avoir lu au moins un livre, papier ou numérique, dans leurs temps libres au cours des douze mois précédents. Dans l’ensemble de la population, 23 % lisent tous les jours ou presque et 19 % au moins une fois par semaine.
Une comparaison avec les États-Unis donne néanmoins un point de repère, à condition de rester prudents : les deux enquêtes ne portent pas exactement sur les mêmes populations et ne mesurent pas la lecture de la même manière. Le National Endowment for the Arts rapporte, à partir de sa Survey of Public Participation in the Arts, qu’en 2022, 48,5 % des adultes américains avaient lu au moins un livre au cours de l’année, contre 52,7 % en 2017 et 54,6 % en 2012. La lecture de fiction, soit de romans ou de nouvelles (novels or short stories) est, elle aussi, passée de 45,2 % en 2012 à 37,6 % en 2022. Il serait donc trompeur d’opposer directement le 82 % québécois au 48,5 % américain. Ces données permettent néanmoins de constater que le portrait québécois ne correspond pas, du moins pour l’instant, au même scénario de recul généralisé.
Le portrait devient encore plus intéressant lorsqu’on regarde du côté des jeunes. Au Québec, les 15-29 ans ne sont pas ceux qui lisent le moins : 86 % disent avoir lu au moins un livre au cours des douze mois précédents, soit la même proportion que chez les 30-44 ans. Mais la situation change lorsqu’on s’intéresse à la fréquence : seulement 17 % des 15-29 ans lisent tous les jours ou presque, comparativement à 30 % chez les 60-74 ans.
Dans le contexte de la journée « Le 12 août, j’achète un livre québécois », ce constat prend toutefois une autre dimension. Car si les jeunes du Québec lisent bel et bien, la question est aussi de savoir ce qu’ils et elles lisent et quelle importance ils et elles accordent aux livres québécois. Les données disponibles suggèrent en effet que les jeunes générations sont moins portées à privilégier les œuvres d’ici que les générations précédentes. L’enjeu n’est donc pas seulement de maintenir la lecture chez les jeunes, mais aussi de faire en sorte que la littérature québécoise s’inscrive dans leurs pratiques et leurs univers culturels.
Les supports, eux aussi, évoluent. Au Québec, 26 % de la population lit des livres numériques et 15 % écoute des livres audio. Ces pratiques sont nettement plus répandues chez les 15-29 ans : 36 % lisent des livres numériques et 21 % écoutent des livres audio. Là encore, ces données invitent à se méfier du récit trop simple de « la fin de la lecture ».
Voilà qui nous ramène plus précisément au troublant problème soulevé par The Atlantic. Les jeunes, comme les moins jeunes, n’ont pas cessé de lire. La question est plutôt celle de l’intensité, de la régularité et, peut-être, de l’endurance de cette pratique. Autrement dit, ce qui pourrait se fragiliser n’est pas nécessairement le contact avec le livre, encore moins la capacité de lire, mais la présence de la lecture profonde dans la vie quotidienne.
Nous sommes donc vraisemblablement moins devant une « fin de la lecture » que devant une recomposition des pratiques de lecture : ce que nous lisons, sur quels supports, à quelle fréquence, pendant combien de temps, avec quel degré d’attention et au milieu de quelles autres sollicitations. C’est peut-être là que se situe le véritable déplacement : non pas dans la disparition de la lecture, mais dans la fragilisation de la lecture soutenue ou profonde.
Alexandrie à l’envers
L’image la plus puissante, selon moi, de l’article de Horowitch est peut-être celle par laquelle il commence et se termine : la bibliothèque d’Alexandrie. Pendant des siècles, l’un des grands problèmes des sociétés lettrées a été de préserver les textes. Des manuscrits disparaissaient, des bibliothèques brûlaient, des œuvres devenaient inaccessibles. Or, nous nous trouvons aujourd’hui dans une situation presque inverse. Jamais autant de textes n’ont été aussi facilement accessibles. Des « bibliothèques » entières tiennent dans un téléphone. La question n’est donc plus seulement : Comment préserver les livres? Elle devient : Comment préserver les conditions qui donnent envie de les lire et permettent de le faire?
C’est là que je m’éloignerais le plus catégoriquement du diagnostic de « la fin de la lecture ». La lecture n’a pas disparu. Pas encore, en tout cas. Mais il devient nécessaire et urgent de soutenir plus activement les conditions de la lecture longue, attentive et exigeante, dans un environnement qui offre en permanence des solutions plus rapides et plus immédiatement gratifiantes.
Et cette responsabilité ne dépend pas seulement de la volonté individuelle des personnes lectrices, dimension sur laquelle insiste davantage, sinon trop, Horowitch. Une société de lecteurs et de lectrices ne se maintient pas toute seule. Elle repose sur des familles, des écoles, des bibliothèques, des librairies, des maisons d’édition, des médiateurs, des médiatrices et des communautés qui rendent les livres accessibles, mais surtout visibles, désirables, partageables et aptes à nourrir la conversation. C’est d’ailleurs l’une des nuances importantes à apporter au récit de « la fin de la lecture » : la lecture est une pratique sociale, et non seulement une compétence ou une disposition individuelle.
Ce serait l’objet d’un prochain billet : si nous voulons demeurer une société de lecteurs et de lectrices, quelle écologie de la lecture devons-nous entretenir?
Déjà en place aux USA et dans plus de 120 pays depuis 2 ans, Google AI Overviews débarque en France cet été (c’est effectif depuis ce mercredi 22 juillet). Le principe est simple : pour chaque requête sur le moteur, c’est l’IA de Google (Gemini) qui propose des résumés ou plus exactement, et la précision me semble d’importance, des synthèses et – souvent – des préconisations.
Cette arrivée durant l’été est annoncée comme un tremblement de terre, notamment par les éditeurs de presse qui, comme c’
Déjà en place aux USA et dans plus de 120 pays depuis 2 ans, Google AI Overviews débarque en France cet été (c’est effectif depuis ce mercredi 22 juillet). Le principe est simple : pour chaque requête sur le moteur, c’est l’IA de Google (Gemini) qui propose des résumés ou plus exactement, et la précision me semble d’importance, des synthèses et – souvent – des préconisations.
Cette arrivée durant l’été est annoncée comme un tremblement de terre, notamment par les éditeurs de presse qui, comme c’est le cas depuis plus de 20 ans avec le lancement de Google News en 2002, ne trouvent aucune issue au pacte attentionnel Faustien qui leur a été imposé : laissez-moi indexer et réutiliser vos contenus et en échange vous serez visibles, ou empêchez-moi de le faire et l’audience de vos sites sera quasi nulle.
L’article de Nicolas Lellouche sur Numérama résume très bien les principaux enjeux de cette arrivée et le changement de statut de celui qui était, jusqu’ici, un moteur de recherche.
Il y a, bien sûr, de quoi s’inquiéter circonstantiellement toujours davantage, mais structurellement, sur le fond, rien n’a vraiment changé depuis presqu’un quart de siècle. Google est un moteur de recherche devenu un moteur de réponses (« il n’y aura plus que des réponses » prophétisait Marguerite Duras) ; Google est un béhémot calculatoire qui a bâti son succès sur un régime de captation d’externalités (le web) qu’il a progressivement transformé en autant d’internalités. D’abord sur des sources ouvertes (le web donc, et notamment Wikipédia) puis sur des sources propriétaires ou mettant en jeu des principes de propriété intellectuelle (la presse notamment). Et toujours en pratiquant « l’Opt-Out » c’est à dire la captation / prédation par défaut, libre ensuite à chacun de faire part de sa volonté d’en sortir (il est d’ailleurs possible de sortir votre site de l’AI Overview). Et lorsque la masse de ces internalités fut suffisamment « à l’échelle », Google se trouva alors en situation de jouer à son avantage la rivalité qu’il avait lui-même créé (et arbitré) entre la qualité, l’importance et la nécessité de la production de contenus externes d’une part, et d’autre part celle de la production de réponses internes suffisamment courtes pour ne pas heurter de front la propriété intellectuelle (jouant entre l’usage « de minimis », le Fair-Use et l’exception pour courte citation) et suffisamment complètes pour satisfaire des requêtes informatives sans nécessité d’aller chercher des compléments d’information à l’extérieur du moteur ou alors en le faisant uniquement dans l’écosystème de sites tiers déjà dans le giron de la firme.
Avec AI Overviews, Google pousse donc un cran plus loin cette logique phagocyte. Et ce faisant il cesse peut-être irrévocablement d’être un « portail » (il n’en était déjà plus que l’ombre depuis longtemps mais maintenait nonobstant une fonction d’accès et d’orientation) pour devenir une simple « porte », que chaque requête sur le moteur referme derrière notre passage.
Permettez-moi alors de formuler une question volontairement provocante. Et si finalement Google était juste en train de devenir … un média ? Google dont longtemps le métier correspondant à son chiffre d’affaire fut celui d’être une régie publicitaire, et de n’être que cela (malgré ce que ses fondateurs affirmaient dans leur article séminal). Google deviendrait donc un média. Mais un média aux fonds baptismaux particuliers : entièrement construit sur la prédation d’externalités, sorte de Cronos dévorant ses enfants, il se mue aujourd’hui avec AI Overviews en média autophage qui tend à ne plus se nourrir que de lui-même. Ce « lui-même » étant permis par la volumétrie totalement inédite ainsi que par les effets de dissémination en même temps que d’opacification immanents des LLM (larges modèles de langage). La question est de savoir jusqu’où et jusqu’à quand ce principe autophage pourra être poursuivi, et la seule certitude est qu’il ne pourra pas l’être éternellement car si grande que soit l’étendue des éléments constituant aujourd’hui la ressource indexable et pouvant être générée du moteur, elle n’est pas infinie et nécessitera donc toujours et tout le temps l’appui de ressources externes (au Royaume-Uni après deux ans de déploiement le trafic vers les sites d’éditeurs à drastiquement chuté – entre 20 et 40% de baisse). Sauf … sauf à considérer pouvoir se satisfaire d’un pourrissement (ou d’une emmerdification) et à disposer des moyens pour faire croire qu’il n’est que périphérique et marginal.
Deux éléments pour conclure.
D’abord le mythe de Cronos dévorant ses enfants laisse place au scénario dans lequel ceux-ci se voient finalement régurgités et renversent leur père pour s’installer comme nouveaux dieux sur le mont Olympe. C’est précisément pour s’en prémunir que très tôt Google a eu l’intelligence de développer son propre LLM et pouvant s’appuyer sur l’immensité des données et des textes qu’il avait déjà collectés, traités, indexés, et dont il avait, bien avant même l’invention du terme « LLM », déjà fait corpus (à ce titre le programme Google Books exploité à l’époque avec les technologies disponibles du TALN – traitement automatique du langage naturel – fut une pierre angulaire déterminante.
Le (Large) langage (Model) de la guerre.
« Il faut désarmer l’IA » écrit le pape Léon XIV dans sa première encyclique, « Magnifica Humanitas« , publiée le lundi 25 Mai 2026. De fait et à l’occasion des récents conflits, de l’Ukraine à l’Iran en passant par Gaza, les technologies d’IA sont des puissances d’armement.
En première intention et sous les feux de la rampe autant que de ceux de la guerre, on a beaucoup parlé, ces derniers mois, de l’injonction faite par le gouvernement Trump aux grandes
« Il faut désarmer l’IA » écrit le pape Léon XIV dans sa première encyclique, « Magnifica Humanitas« , publiée le lundi 25 Mai 2026. De fait et à l’occasion des récents conflits, de l’Ukraine à l’Iran en passant par Gaza, les technologies d’IA sont des puissances d’armement.
En première intention et sous les feux de la rampe autant que de ceux de la guerre, on a beaucoup parlé, ces derniers mois, de l’injonction faite par le gouvernement Trump aux grandes sociétés d’intelligence artificielle (IA) de se soumettre et d’accepter que leurs technologies soient utilisées dans le cadre de programmes militaires. Rien de vraiment nouveau car toutes les technologies et la plupart des industries (automobile par exemple) ont toujours été utilisées et mobilisées dans le cadre de guerres déclarées, ou en anticipation de celles pouvant l’être, y compris les fondements d’internet qui fut pour partie un projet de la DARPA.
Là où un changement de paradigme s’opère c’est qu’il s’agit cette fois de se plier (pour Anthropic et les autres) à l’utilisation de leur technologie d’IA, y compris pour la décision non-supervisée d’offensives et de ciblages à dimension létales, donc en clair pour tuer des gens de manière automatisée sur la base de choix dans lesquels la décision humaine n’est plus qu’un cadre de raisonnement parmi d’autres, ni déterminant ni déterministe, une variable d’ajustement de moins en moins requise, et de plus en plus systématiquement exclue de toute action ou réaction « en temps réel ».
Le patron d’Anthropic (Dario Amodei) a refusé de se plier à l’injonction qui lui était faite (refusant à la fois le cadre d’une utilisation létale et celui d’une surveillance de masse des populations). Trump l’a donc banni et mis sur liste noire, le privant notamment de juteux et décisifs financements étatiques. Dario Amodei a probablement vécu son moment « San Bernardino », à la manière dont Tim Cook (patron d’Apple) avait en 2015 refusé de baisser le niveau de sécurité de l’iPhone pour permettre au FBI d’accéder aux données du meurtrier de la tuerie de San Bernardino (à l’époque, il y a donc 10 ans, c’est pas rien à l’échelle des sujets dont on parle, j’avais pris un positionnement un peu … dissonant en posant la question suivante « un terroriste est-il un client Apple comme les autres ?« )
« L’image publique d’Anthropic repose sur une IA conçue pour servir l’humanité. L’entreprise refuse de franchir certaines lignes rouges, notamment celles des armes entièrement autonomes et de la surveillance de masse. Mais au début de l’année 2026, alors qu’Anthropic engageait un bras de fer avec le Département de la Défense sur les principes de son contrat en cours à 200 millions de dollars, l’entreprise soumettait une proposition pour remporter un concours du Pentagone doté de 100 millions de dollars.
L’objectif du programme était de produire une technologie permettant de superviser, par la voix, des essaims de drones létaux. Claude devait comprendre l’ordre vocal d’un opérateur humain et le convertir en instructions numériques pour coordonner la flotte de drones. Dans ce cas, l’humain donne une instruction globale. Une fois l’ordre transmis, les drones, grâce à leur propre intelligence artificielle en réseau, calculent leurs trajectoires d’approche et se répartissent les cibles sans intervention humaine.
Selon les sources internes citées par Bloomberg, la direction d’Anthropic estimait que cette utilisation respectait ses conditions d’utilisation car l’IA de ciblage létal est embarquée dans les drones eux-mêmes, pas dans Claude. Par conséquent, tant que l’opérateur conserve le pouvoir théorique d’interrompre le système, l’entreprise considère que l’arme n’est pas « entièrement autonome ».
Mais sur le terrain opérationnel, cette distinction relève davantage de la philosophie que de la balistique. Même si l’opérateur conserve la supervision et le pouvoir d’interrompre le système, il est techniquement impossible pour un humain de traiter assez d’informations pour l’utiliser à temps, face à la rapidité de calcul d’un essaim de drones propulsés par une intelligence artificielle en réseau. Le temps que l’opérateur comprenne que l’essaim a fait une erreur d’identification, la cible est déjà détruite. Dans l’imaginaire collectif, une armée de robots tueurs se représente souvent sous la forme d’androïdes humanoïdes lourdement armés, marchant au pas sur un champ de bataille. Or, le Pentagone ne cherche pas à reproduire le soldat humain, mais à le dépasser par la logique de l’essaim. (…) Il faut imaginer des centaines de petits drones, furtifs et peu coûteux. Animés par un modèle d’IA, ils communiquent entre eux en temps réel. Ils fonctionnent en réseau et se comportent comme une ruche. Si des drones sont abattus par l’ennemi, l’essaim recalcule instantanément sa géométrie et poursuit sa mission.
Leur objectif tactique est de saturer la cible. Ils sont conçus pour submerger les radars, épuiser les défenses anti-aériennes, traquer une cible sous une multitude d’angles simultanés et frapper de façon synchronisée.Cette stratégie s’inscrit dans le programme Replicator, annoncé en 2023 avec une promesse opérationnelle pour août 2025. Son objectif est de contrer l’avantage du nombre de l’armée chinoise en produisant des milliers de systèmes autonomes coordonnés par intelligence artificielle, sacrifiables et peu coûteux. C’est pour devenir le cerveau de ce type de chorégraphie qu’Anthropic avait proposé Claude.
Comme les sources de Bloomberg le rapportent, Anthropic n’était donc fondamentalement pas opposée au développement de systèmes autonomes, tant que la définition de l’autonomie s’alignait sur ses propres standards. L’impasse est survenue lorsque la direction d’Anthropic a exigé de maintenir l’humain dans la boucle de décision d’élimination de la cible, tout en refusant d’accorder au Pentagone un accès complet et sans restriction au modèle. Or, le Pentagone n’achète pas de boîtes noires. Perdant patience face à une entreprise qui plaçait sa gouvernance au-dessus des impératifs étatiques, le Secrétaire à la Défense Pete Hegseth a ordonné l’interdiction pour les sous-traitants du Pentagone de mener toute activité commerciale avec Anthropic, la classant de facto comme un risque pour la chaîne d’approvisionnement.
C’est une condamnation à mort commerciale qui excommunie la firme de tout l’écosystème de défense : désormais, aucun sous-traitant de l’armée n’a le droit d’interfacer ses systèmes avec Claude. Y compris Palantir. Anthropic a parié que ses capacités de raisonnement la rendraient indispensable. C’était une erreur d’appréciation. Pour l’armée américaine, un modèle capable à 95 % qui obéit est infiniment plus précieux qu’un modèle à 99 % qui discute les ordres.
Le Pentagone a immédiatement redistribué les cartes. Toujours selon Bloomberg, pour faire avancer son projet d’essaims de drones autonomes, l’armée s’est tournée vers une coalition de remplaçants incluant SpaceX, xAI, et des firmes de technologie de défense partenaires d’OpenAI.
D’autres, comme Sam Altman le patron d’OpenAI, se sont rapidement mis en mode carpette et plié à l’ensemble des demandes de l’administration Trump (avant de récemment rétro-pédaler partiellement sur la question de la surveillance de masse). Pourtant de fait et malgré la position de son patron, l’IA Claude d’Anthropic a largement été utilisée pour l’offensive actuelle contre l’Iran, un délai de 6 mois étant nécessaire avant son bannissement « effectif » et que l’entreprise est pour l’instant liée par contrat à l’administration US.
Toujours dans le cadre de la guerre en Iran, on apprenait dans The Independant que Grok avait été mobilisé pour une opération de lancement de plus de 2000 missiles :
« Selon un haut responsable de la Défense, l’administration de Donald Trump aurait fait appel au chatbot Grok d’Elon Musk pour lancer des milliers de missiles en Iran. Dans une déclaration sous serment visant à défendre le « trillionaire » contre un procès alléguant que les centres de données de xAI polluent illégalement les communautés noires, le responsable de l’intelligence artificielle au Pentagone a déclaré que le maintien en service du chatbot était « une question de sécurité nationale primordiale » — et qu’il avait été utilisé pour tirer plus de « 2 000 missiles sur 2 000 cibles distinctes en 96 heures ».
Grok, un chatbot d’intelligence artificielle générative développé par xAI, fait partie des quatre modèles d’IA « actuellement capables de prendre en charge des applications liées à la sécurité nationale », selon Cameron Stanley, directeur du numérique et de l’intelligence artificielle au Pentagone. »
War (is not a) Game.
Dans cette affaire et par-delà les singularités de la gouvernance actuelle des USA, c’est, dans le champ social le retour d’une imagerie de l’IA agissant en Terminator avec la crainte d’un soulèvement des machines. Certes les IA et les « machines » ne déclarent pas encore la guerre, mais sur les terrains de guerre, l’automatisation de décisions leur appartenant désormais entièrement peut engager de nouvelles forces, de nouveaux déterminismes du conflit, y compris dans son extension possible. Ce scénario – d’un soulèvement des machines – est aujourd’hui une médiane paradoxale dans le champ de la prospective : il n’est en effet ni pleinement ni actuellement crédible sur le plan technologique, mais il n’est pas non plus totalement exclu sur un plan politique (qui serait celui d’un emballement, une « furie épique » par exemple …). Ce paradoxe s’explique principalement par le fait que les IA « générales » ou « autonomes » n’existent pas mais qu’une autonomie de décision peut en revanche parfaitement leur être confiée, accordée ou déléguée et qu’à ce stade là, plus personne n’est actuellement en capacité de tracer les décisions qui seront alors prises : c’est le scénario de l’IA battant les meilleurs joueurs d’échec puis les meilleurs joueurs de Go. Dans ces derniers cas, la rapidité de calcul peut-être mise exactement sur le même plan que la capacité de décision puisqu’elle n’aura d’autre inférence, quoi qu’il advienne, que celles circonscrites au plateau de jeu et à détermination de la fin de partie. Sauf qu’on ne parle plus ici d’une activité récréative mais de terrains de guerres. Et sur des terrains de guerre (mais également sur des terrains médicaux, éducatifs, juridiques, etc.), la rapidité de calcul des machines entre en concurrence directe avec la capacité de décision humaine. Or prétendre déléguer aux machines une capacité décisionnelle au motif qu’elles calculent plus vite que nous est à la fois imbécile et dangereux. On m’objectera que les terrains de guerre moderne impliquent la prise de décisions à la milliseconde tout comme les terrains spéculatifs modernes (nos bourses) ont vu l’arrivée du High-Frequency Trading (trading à haute fréquence). Relire Virilio à ce stade n’est plus une option mais une impérieuse nécessité.
Image extraite du film War Games.
D’autres accélérations surviennent. En à peine 30 ans nous avons connu la première guerre entièrement télévisée, en Irak. En Irak encore les drones de combat (Predator) après l’attentat sur les tours jumelles. Hier toujours, la guerre par écran interposé. Aujourd’hui donc les frappes assistées par IA (notamment après le 7 Octobre). Et sous nos yeux la première guerre assistée par des LLM (notamment pour cibler des populations et des individus mais aussi pour permettre à des drones de se coordonner avec une autonomie décisionnelle alignée sur un objectif militaire).
« Je lis dans The Wall Street Journal que l’armée américaine aurait – encore – utilisé Claude pour frapper l’Iran. Puisque ces informations sont classifiées, impossible de savoir à ce stade comment les États-Unis se servent précisément des IA génératives dans le cadre d’opérations militaires. Mais ça m’inspire quelques réflexions générales à chaud.
Tout d’abord, peut-être que le conflit de cette semaine entre Anthropic et le Pentagone – avec cet ultimatum très serré lancé par Hegseth – était lié à des considérations beaucoup plus opérationnelles que ce qu’on imaginait.
Ensuite, quand je travaillais spécifiquement sur les questions de surveillance, j’étais hanté par cette phrase de Michael Hayden, ancien patron de la NSA et de la CIA, évoquant les « assassinats ciblés » par drone : « Nous tuons les gens sur la base de métadonnées ». C’était il y a plus de dix ans.
Désormais, la guerre à Gaza l’a cruellement mis en lumière, l’armée utilise des LLM pour profiler la population (palestinienne) et des systèmes d’IA pour automatiser ses bombardements. Le continuum répressif est évident. Il faut lire à ce sujet le travail capital de +972 Magazine.
Dans les deux cas, on tue en se basant sur des inférences probabilistes, qui prédisent des comportements. On prend la vie de quelqu’un qui ressemble statistiquement à une menace, pas quelqu’un dont on a établi la culpabilité. Les dommages collatéraux ? Les civils tués ? Des variables d’ajustement.
Mais avec l’IA, on franchit un seuil supplémentaire : celui de l’intelligibilité. On ne peut plus retracer le chemin logique qui mène du signal à la décision. Conséquence : tout principe de responsabilité – y compris pénale – disparaît. Et c’est peut-être ce qui attire tant le pouvoir américain. »
Au milieu de tout cela, ne jamais oublier que comme tant d’autres, cette guerre en Iran, « du signal à la décision« , a commencé par un tir sur une école. « Du signal à la décision« . Une école primaire. L’école primaire Shajareh Tayyebeh à Minab, dans le sud de l’Iran.
Et qu’en plus de tout cela, nous nous éloignons toujours davantage de ce qu’écrivaient Bostrom et Yudowsky (deux théoriciens de l’intelligence artificielle) dont je cite souvent ici l’article de 2011, « The Ethics of Artificial Intelligence » :
« Les algorithmes de plus en plus complexes de prise de décision sont à la fois souhaitables et inévitables, tant qu’ils restent transparents à l’inspection, prévisibles pour ceux qu’ils gouvernent, et robustes contre toute manipulation. »
L’infanterie des données.
Si l’IA (et les LLM) sont la nouvelle artillerie des guerres modernes, alors les données (et métadonnées) sont leur nouvelle infanterie. Or ces données sont des armes de contact à la volatilité extrême. Capables de se retourner contre l’assaillant autant que vers l’assailli. On ne peut en effet que constater aujourd’hui avec autant d’inquiétude que d’effarement la multiplication, la massification et la récurrence des leaks, piratages et autres immenses fuites et vols de données : personnelles, fiscales, médicales, depuis des sources privées, des institutions publiques ou des ministères régaliens, pas une semaine, pas un jour parfois sans un nouveau scandale. A un point que cela en devient presque une sorte de routine et donne naissance à des arnaques de plus en plus nombreuses mais surtout de plus en plus efficaces.
Parmi les plkus récentes rendues publiques on notera celles de l’ANTS (11,7 millions d’usagers), de Almeris (15 millions de patients concernés et autant de données critiques dans le domaine médical), celle de la Banque Postale (11 millions d’usagers), celle de l’opticien Atol (5,9 millions de clients) ou de la chaîne Pierre & Vacances (4,5 millions de clients), sans oublier jusqu’à la DGFIP (direction générale des finances publiques) où les données de plus d’1,2 millions de comptes fiscaux ont été volées.
Ces fuites, ces leaks, ces vols, ces actes de cyber-piraterie ou de cyber-guerre sont aussi bien menés par des pirates agissant en collectifs « autonomes » que par des corsaires au service d’états voyous ou de puissances impériales. Et là encore, le scénario d’un effondrement oscille entre celui de l’impact d’un Armageddon planétaire et le ressenti d’une patate de forain en sortie de boîte de nuit à Arma-sur -Guédon dans la Creuse.
La stratégie Ender.
Dans ce roman de science-fiction, après des années à l’entraîner via de gigantesques simulations, on présente à un humain (Ender) un acte de commandement en temps de guerre et pour une bataille décisive, comme celui d’une énième « simple » simulation alors qu’il s’agit en fait de la réalité et qu’il est vraiment en train de commander des armées sur un terrain tout à fait réel. Nous vivons aujourd’hui une stratégie Ender en miroir. Des IA prennent des décisions en temps de guerre dont certaines s’apparentent à du commandement, et elles le font sans en avoir de quelconque « conscience » tout comme Ender, persuadé d’être dans une simulation, n’éprouvait un quelconque sentiment de responsabilité sur des pertes humaines y compris lorsque celles-ci deviennent critiques. Et nous, nous les humains spectateurs de ces guerres, avons à la fois l’impression terrible d’observer une grande simulation qui nous échappe, tout en mesurant l’atrocité de ce qui s’y joue en temps réel, mais en la mesurant de si loin et via des images si artefactuelles et calquées sur la culture populaire (super-héros et autres reprises de codes de la pop-culture) que la frontière entre le réel et la simulation n’est désormais plus qu’un vague continuum.
Plus rien n’appartient au réel qui ne puisse être simulé et donc simulacre. Et plus aucune simulation ou aucun simulacre ne nécessite d’être ramené au réel pour être éprouvé en tant que tel.
Depuis le début de la guerre faite par les USA et Israël à l’Iran, le compte de la Maison Blanche multiplie les publications qui mêlent images de films (Top Gun, Predator, Mission Impossible …) et images réelles de missiles frappant des cibles ; et quand il ne s’agit pas de films, ce sont les codes des jeux vidéos familiaux (les sports de la Wii U récemment) qui sont associés à ces mêmes images hyper-réalistes de frappes aériennes ou maritimes. De son côté le régime iranien des Mollahs répondait avec les vidéos du sacre de leur nouvel ayatollah où ce sont des personnages Lego qui sont filmés en stop motion (voir l’excellent Dessous des images consécré à « La guerre en Lego »). L’idée n’est pas de vendre une guerre « pop » : l’idée c’est d’anecdotiser complètement l’existence même de la guerre à l’échelle de certains espaces médiatiques.
Après que la guerre a été éloignée des médias à l’exception d’images et de discours qui n’étaient que de propagande, après qu’elle a été filmée au plus près et télévisée en temps réel, après que les témoignages et images qui la constituent se sont réfugiés dans les réseaux sociaux en en empruntant les codes (comme ce fut le cas souvenez-vous en Ukraine ou les témoignages sous les bombes adoptaient le codes des comptes Tiktok de l’âge des premières victimes), aujourd’hui ce qui se joue dans l’économie médiatique de la guerre c’est l’écartèlement permanent entre le réalisme de la disponibilité d’images et de témoignages insoutenables d’un côté, et la réalisation d’images et de récits totalement irréalistes et fantasmés de l’autre côté. Le tout arbitré en visibilité par des algorithmes relais de pouvoir et totalement inféodées à la volonté de leurs maîtres.
Et il ne s’agit pas pour nous de choisir mais d’accepter de prendre tout cela ensemble, car l’architecture de circulation de ces discours est en forme d’arène dans laquelle ces spectacularisations s’enchaînent et se répondent sans cesse et sans que nous puissions ne serait-ce que dire que nous aimerions choisir.
Stratégie Ender (suite) : Attrapez-les tous !
Certains peut-être se souviennent du phénoménal engouement autour du jeu Pokémon Go décliné en réalité augmentée. Il s’agissait de chasser les Pokémon un peu partout dans le monde réel, en passant par une application de réalité augmentée qui « superposait » sur notre géographie classique l’environnement ludique du jeu. Je m’étais de mon côté interrogé sur ces nouvelles affordances et j’avais publié plusieurs articles sur le sujet que vous retrouverez par ici. Dans le premier de ces articles, je proposais même le concept de « schizo-haptie » que je définissais comme suit :
Quand nombre d’entre nous sont aujourd’hui incapables de se passer de leurs smartphones, de « lâcher » cet objet, quand et surtout comment serons-nous demain capables de s’affranchir de nos corps-interfaces pour revenir à plus naturelles synesthésies qui risquent de nous apparaître comme « dégradées » puisque non-augmentées ? Le hold-up du haptique sur tout autre mode d’interfaçage avec le monde et les objets techniques pourrait également donner naissance à de passionnantes études sur l’interface … des faux-mouvements. Aux pathologies actuelles du numérique, à la nomophobie, à la FOMO, à l’algorithmophobia, faudra-t-il rajouter une nouvelle forme de schizophrénie (du grec « schizein = fendre » et « phrên = esprit ») dénommée « schizo-haptie », une schizophrénie du mouvement et de l’ensemble de la panoplie des « gestes-contrôle » ? »
Nous étions alors en 2016. Dix ans plus tard, nous venons d’apprendre, dans un article du MIT repris notamment dans Le Devoir, que derrière cette ludification se tramait en parallèle (et sans un quelconque consentement de notre part), un entraînement pour permettre … de créer une carte du monde en réalité augmentée. Laquelle carte est notamment utilisée pour permettre à des robots de livrer des pizzas. La préméditation n’est pas établie mais le fait est que la société Niantic (qui développait le jeu) dispose aujourd’hui d’une nouvelle branche baptisé Niantic Spatial et dont l’objectif est – je reprends leur slogan – « de construire un LGM (Large Geospatial Model), un modèle vivant du monde auquel les êtres humains et les machines pourront s’adresser » (« Niantic Spatial is building a Large Geospatial Model, a living model of the world that people and machines can talk to« ).
Or y compris avec la localisation GPS et notamment dans de grands centres urbains, on manque de précision au mètre près pour opérer un certain nombre de transactions et autres livraisons. Parce que la distribution sur le dernier kilomètre représentait il y a 10 ans de cela la logistique la plus complexe, Amazon avait lancé en 2015 le service « Flex », pour « uberiser » ce dernier bastion, cette dernière proximité, et nous permettre de récupérer des colis et de les livrer sur le trajet nous (r)amenant chez nous ou à notre travail. Dix ans plus tard, c’est la conquête des derniers mètres qui est devenue la grande bataille logistique. Et il ne s’agit plus d’embaucher des humains mais de permettre à des robots autonomes d’effectuer ces derniers mètres avec la plus grande précision possible. Comme l’explique très bien Camille Coirault sur Presse-Citron :
« Ce qui distingue ce système de tout ce qui existait avant, c’est sa nature : un GPS fonctionne grâce à des coordonnées mathématiques abstraites : une latitude, une longitude et une altitude. Pour les entreprises clientes, l’intérêt est de remplacer le calcul de probabilité du signal satellite par une identification visuelle instantanée des environnements réels.«
Cette glacière autonome sur roues peut contenir 8 pizzas (y compris à l’ananas) et se déplace à 8 km/h.
On vit une époque formidable. Pour les pizzas.
Jamais à l’abri d’un excès, dans l’article du MIT qui a révélé l’utilisation des données Pokemon Go pour ce nouvel usage, le patron de Niantic Spatial, John Hanke, parle carrément d’une « nouvelle explosion Cambrienne dans le domaine de la robotique. » Pour celles et ceux qui comme moi auraient séché les cours de paléontologie au lycée, l’explosion Cambrienne c’est lorsque (merci Wikipédia) :
Les sédiments cambriens révèlent l’extension de mers peu profondes recouvrant des plates-formes continentales, et une brusque multiplication de nouveaux groupes animaux (animaux à parties dures notamment). Cette « explosion cambrienne » n’a pas encore d’explication. Elle peut avoir plusieurs causes : des modifications climatiques, l’activité accrue de prédateurs ou encore les sels marins favorisant l’absorption de substances chimiques et le dépôt de couches dures sur la peau. Le développement de squelettes externes (exosquelettes) peut avoir été une réaction adaptative à l’apparition de nouvelles niches écologiques. Il pourrait également s’agir d’organismes des grandes profondeurs nouvellement acclimatés aux habitats de surface ou inversement, mais aussi d’une évolution vers des espèces capables d’exploiter des ressources alimentaires nouvelles.
Alors pas sûr que les glacières sur roues soient une nouvelle branche de l’évolution des espèces robotiques, mais la métaphore réussit à nous interpeller. Et comme souvent dans le secteur de la tech et du numérique, il faut lire ces usages métaphoriques pour ce qu’ils sont : la nécessité d’installer rapidement un imaginaire favorable à la naissance ou au maintient de nouvelles rentes économiques (par ailleurs souvent sur fonds publics). Si chacun peut voir dans cette supposée explosion cambrienne robotique des éléments de réel (oui il y a de plus en plus de robots et de dispositifs autonomes, mais non il n’y a aucune logique évolutive derrière), l’enjeu est de convaincre des financeurs, des industriels et des responsables de politiques publiques que cette explosion est en train d’advenir et qu’il serait de bon ton de ne pas se laisser dépasser.
Du côté des usages militaires, car oui Pokemon Go avait également été utilisé par des militaires engagés sur des terrains de guerre et cela avait fait immensément débat, je vous laisse imaginer ce qui peut-être fait de cette maîtrise des derniers mètres. Et s’il faut parler un peu de géopolitique et de terrains de guerre, Le Devoir rappelle qu’en mars 2025, « le jeu a été vendu à Scopely, une entreprise détenue par le fonds d’investissement saoudien contrôlé par le prince héritier Mohammed ben Salmane. La transaction incluait toutes les données des utilisateurs. »
Il y a quelques jours (19 Mai 2026), Google annonçait le lancement de « Gemini Omni », une IA multimodale capable de manipuler nativement le texte, l’audio et la vidéo avec des résultats une fois de plus tout à fait sidérants de vraisemblance. La génération de ces vidéos peut notamment s’appuyer sur les données captées depuis des années par Google Earth, Google Maps et Google Street View permettant par exemple de générer le film hyperréaliste d’un personnage marchant, courant, volant, roulant ou naviguant dans à peu près n’importe quel endroit de la planète.
Le problème de disposer d’une carte à l’échelle du territoire est entièrement résolu. Nous sommes complètement sortis de l’âge où comme l’écrivait en 1931 le mathématicien et philosophe Alfred Korzybski, « la carte n’est pas le territoire », et où il il existait une différence entre la réalité et la représentation que l’on s’en faisait. Le problème est que l’alignement, la superposition au réel ne peut-être résolu ou « exercé » sans recours à une simulation qui, dès lors, prend le pas sur le réel lui-même.
Par-delà tout un ensemble d’autres sujets connexes, la multiplication de ces outils d’IA génératives, leur « fluidité » et leur disponibilité immédiate, s’accompagne aussi d’un retour en grâce (ou d’une nouvelle offensive marketing en tout cas) pour nous réimposer des appareillages sensoriels installant la prééminence de réalités simulées ou virtuelles, Google annonçant ainsi le retour de ses lunettes connectées. Face à des artefacts génératifs désormais presque tous capables de simulations multimodales, s’aligne la conception d’une humanité sensoriellement appareillée non pour s’augmenter mais pour s’aligner avec la carte que dessinent ces Béhémots calculatoires plutôt qu’avec le territoire que nous arpentons chacune et chacun avec nos propres focales.
Apostille.
Si Ender remporte sa guerre, c’est parce qu’il n’a jamais conscience d’être ailleurs que dans une simulation ; c’est parce que les choix qu’il met en oeuvre se subordonnent entièrement à la conscience – en réalité une croyance – qu’il a d’évoluer dans une réalité simulée. La « stratégie Ender » c’est le pari immensément risqué d’un groupe d’adultes face à une guerre d’extermination imminente et qui vont faire le choix de confier l’avenir d’une civilisation à l’habilité et à la ruse d’un enfant habitué à ne prendre de décisions vitales que dans le cadre de simulations virtuelles. Par-delà même les guerres qui traversent aujourd’hui directement nos vies ou nos voisinages, il n’est pas totalement vain de s’interroger sur la stratégie Ender dans laquelle entrent actuellement l’essentiel de nos modes de conflits et de nos modes d’existence.
Et s’il faut trouver un dessein à cette stratégie Ender, il est à coup sûr dans la mise en fragilité ou en effondrement de l’ensemble de nos formes collectives de gouvernance. C’est en tout cas ce qui m’est apparu comme une évidence à la lecture d’un article: « Comment l’IA détruit les institutions. »
IA : Institutions Apocryphes.
Cet article traite de la percolation des technologies d’IA dans l’ensemble de nos institutions au sens régalien comme symbolique. Et du mal que cela leur fait. En d’autres termes la manière dont l’IA détruit nos institutions.
Depuis que je m’intéresse à ces sujets et notamment à l’IA générative, par-delà l’enthousiasme légitime que l’on peut avoir pour des usages grégaires, par-delà l’inquiétude tout aussi légitime qui nous oblige à repenser presque totalement nos heuristiques de preuve, je cherchais ce qui dans ces artefacts génératifs était le point nodal des risques qu’ils font peser aujourd’hui sur nos sociétés. Et ce point est circonscrit et formidablement argumenté sous la plume de deux collègues juristes, Woodrow Hartzog et Jessica M. Silbey de la faculté de droit de l’université de Boston, dans leur article : « How AI Destroys Institutions« , article dont voici le résumé (je souligne et traduis avec l’aide partielle de Deepl) :
Les institutions civiques – l’État de droit, les universités et la liberté de la presse – constituent l’épine dorsale de la vie démocratique. Elles sont les mécanismes par lesquels les sociétés complexes encouragent la coopération et la stabilité, tout en s’adaptant à l’évolution des circonstances. La véritable superpuissance des institutions réside dans leur capacité à évoluer et à s’adapter au sein d’une hiérarchie d’autorité et d’un cadre de rôles et de règles, tout en conservant leur légitimité dans les connaissances produites et les actions entreprises. Les institutions axées sur des objectifs et fondées sur la transparence, la coopération et la responsabilité permettent aux individus de prendre des risques intellectuels et de remettre en question le statu quo. Cela se produit grâce aux mécanismes des relations interpersonnelles au sein de ces institutions, qui élargissent les perspectives et renforcent l’engagement commun envers les objectifs civiques.
Malheureusement, les affordances des systèmes d’IA anéantissent ces caractéristiques institutionnelles à chaque tournant. Dans cet essai, nous avançons un argument simple : les systèmes d’IA sont conçus pour fonctionner d’une manière qui dégrade et risque de détruire nos institutions civiques essentielles. Les affordances des systèmes d’IA ont pour effet d’éroder l’expertise, de court-circuiter la prise de décision et d’isoler les individus les uns des autres. Ces systèmes sont contraires à l’évolution, à la transparence, à la coopération et à la responsabilité qui donnent leur raison d’être et leur durabilité aux institutions vitales. En bref, les systèmes d’IA actuels sont une condamnation à mort pour les institutions civiques, et nous devons les traiter comme tels.
De mon côté je souligne depuis longtemps à quel point ces outils d’IA excellent dans 2 domaines : primo la simulation d’expertise (en se présentant comme des systèmes experts en capacité de nous leurrer sur la base de notre propre ignorance tout en favorisant par ailleurs des effets Dunning-Kruger de plus en plus problématiques), et deuxio la dissimulation d’expertise (notamment en opacifiant et en dissimulant d’une part la valeur ajoutée des travailleurs de l’ombre, et d’autre part l’ensemble des sources couvertes par le droit d’auteur qui sont captées de manière extractiviste et prédatrice sans égard ni considération).
L’autre point qui m’a frappé dans l’approche des auteurs de l’article « Comment l’IA détruit nos institutions » c’est la question des affordances qu’ils posent à l’échelle de ces systèmes anthropo-techniques que sont les IA, notamment génératives. L’affordance c’est le titre éponyme de mon blog depuis près d’un quart de siècle, et c’est aussi le projet que j’entretiens de documenter les affordances des systèmes numériques que nous utilisons pour mieux comprendre comment ils modifient nos propres comportements et habitus informationnels, cognitifs, relationnels, etc.
Autre extrait de leur article :
« Les premiers théoriciens, comme Émile Durkheim, considéraient les institutions — telles que la famille, la religion et l’éducation — comme des « représentations collectives » qui
soutiennent les normes sociales et assurent la cohésion dans des sociétés de plus en plus complexes. Max Weber s’est intéressé au développement des institutions bureaucratiques, telles que les systèmes judiciaires, qu’il considérait comme fondamentales pour les États-nations modernes. Les spécialistes du « nouvel institutionnalisme » de la seconde moitié du XXe siècle mettent l’accent sur les dimensions culturelles, cognitives et historiques des institutions, y compris leur dynamisme institutionnel par opposition à leur immobilisme. Ces théoriciens expliquent que les institutions sont des constructions sociales et acquièrent leur légitimité en s’ancrant dans les pratiques sociales et en étant façonnées par le comportement humain, reproduisant et maintenant les normes institutionnelles à travers les interactions quotidiennes. En conséquence, la légitimité institutionnelle n’est pas simplement imposée aux individus, mais découle du comportement humain et des interactions »
Et c’est tout cela que viennent miner les IA telles qu’elles se déploient en tout cas majoritairement aujourd’hui.
Tout cela se noue dans une matrice au sein de laquelle les développements technologiques dans leur logique de massification, ont toujours eu pour principal objet une « économie de l’attention » au sein de laquelle il nous faut toujours davantage faire l’économie de notre propre attention aux choses et aux êtres, c’est à dire fonctionner à coût cognitif nul. Sans friction. La marche d’après, lorsqu’il n’est plus d’économie possible car l’essentiel de nos interactions sont déjà réduites à des activités de pousse-bouton ou de défilement infini, la marche d’après consiste à progressivement et entièrement déléguer un ensemble de tâches à la machine et aux technologies. C’est à dire à nous faire entrer dans des phases de déprise à la fois opérationnelles et symboliques, à la fois rationnelles et affectives. Et à ce titre l’essor des artefacts conversationnels fonctionne comme un paradigme téléologique. Et une nouvelle forme de stratégie Ender.
========================================
Cet article a été rédigé fin mai 2026, dans une actualité où les débats autour du positionnement de Dario Amodei et de l’encyclique du Pape occupaient le devant de la scène.
Il devait initialement paraître sur un autre média que ce blog. .
[en]
Je me demande si l’invasion de nos écrans par l’IA va redonner une place à l’écriture manuscrite.
Transcription IA non vérifiée (22.07.2026):
Paris, le 4.7.2026, 8h45
Ce cahier est immense. Je l’ai acheté pour écrire. J’ai un doute en écrivant la date, pourtant je ne devrais pas, c’est le 4, l’anniversaire de Delphine, mais je vérifie quand même. Ce n’est pas ça que j’avais prévu d’écrire. Mais je repense à elle, je repense à il y a un an. Je mange à midi avec une
Je me demande si l’invasion de nos écrans par l’IA va redonner une place à l’écriture manuscrite.
Transcription IA non vérifiée (22.07.2026):
Paris, le 4.7.2026, 8h45
Ce cahier est immense. Je l’ai acheté pour écrire. J’ai un doute en écrivant la date, pourtant je ne devrais pas, c’est le 4, l’anniversaire de Delphine, mais je vérifie quand même. Ce n’est pas ça que j’avais prévu d’écrire. Mais je repense à elle, je repense à il y a un an. Je mange à midi avec une de ses amies, que je n’aurais sans doute jamais connue si Delphine était encore là aujourd’hui pour fêter ses 42 ans. J’ai cherché sur Facebook, “Delphine anniversaire”, parce que j’ai un doute alors que je sais — c’est bien le 4, son anniversaire, c’est juste ? Je sais mais je vérifie quand même. Pas parce que c’est Delphine, parce que ma mémoire et ma vie sont faites de ces milliers de petites vérifications, chaque jour, tout le temps, avant l’accident aussi. Elles sont efficaces, mes vérifications, même moi je ne les remarquais généralement pas. Elles évitent oublis et erreurs.
J’écris moins bien que l’autre soir. Parce que c’est le matin ? Les lignes du cahier ? La fatigue ? J’ai dormi huit heures et j’émerge avec peine. Les mots sur une page sont plus visiblement ancrés dans un instant précis du temps que ceux sur un écran, plus facilement retravaillés, malaxés et transformés. Le temps de la production n’est pas différent de celui de l’impression.
Je pense à Delphine, il y a un an et un jour, seule dans sa voiture. La tristesse m’envahit en tombant sur un des nombreux avis de recherche qu’on avait lancés sur Facebook. Je me souviens la peur au ventre, les appels à la police, les échanges avec ceux et celles qui l’aimaient, chaque nouvelle personne amenant malgré elle plus de fermeté à la certitude que personne n’avait de nouvelles, que personne ne savait rien, que le pire était à craindre. L’angoisse, l’urgence, l’impuissance, se soutenir comme on pouvait, les maux de tête qui ne me quittaient plus, l’attente, l’espoir sous perfusion mais le cœur qui a déjà sombré…
L’incompréhension — alors, depuis, maintenant. Chacun tente de construire du sens comme il peut, ou supporte son absence, plus ou moins bien.
L’intensité extraordinaire, au sens premier, entre le 5 et le 12 juillet, entre la prise de conscience de sa disparition et son enterrement, le cauchemar de réaliser qu’elle avait laissé des instructions de suppression de son compte Facebook après son décès lorsque j’ai demandé sa mémorialisation, peine redoublée que ma santé ne me permette pas de garder le lien avec ceux et celles qui partageaient cette peine du départ abrupt de Delphine. Encore maintenant, j’aurais voulu, mais je ne peux pas, et ça me pèse, de ne pas être en mesure d’honorer sa vie et sa mémoire comme je le voudrais.
Ce n’est pas nouveau, mais c’est criant depuis mon accident : ma vie n’a pas la place pour tout ce que je voudrais. Voilà donc de quoi je voulais parler à ce cahier tout à l’heure quand j’ai commencé à écrire, avant qu’une date m’envoie sur un chemin de traverse.
“Les arbres ne poussent pas jusqu’au ciel”, métaphore évoquée dans la discussion d’un cas servant de support à ma formation sur l’épuisement professionnel. Évidemment qu’au-delà de ce que cette formation m’a apportée en tant qu’intervenante systémicienne, j’en ai aussi tiré plein d’idées enrichissantes sur le plan personnel. Entre une hyperactivité marquée qui m’a déjà amenée plus d’une fois à l’épuisement ou à ses portes, et une fatigabilité accrue durant cette trop longue période post-accident, ce n’est pas surprenant.
Ce n’est pas parce que quelque chose marche bien et a du succès qu’en faire toujours plus sera toujours mieux. Il y a des effets de seuil. L’entrepreneur qui développe encore et encore son projet finira un jour par ne plus réussir à suivre, même si jusqu’ici ça a toujours bien marché pour lui, de développer toujours encore de nouvelles idées. Et moi alors ?
Moi aussi, j’ai des idées, je lance des choses, je fais. Je n’aime pas l’idée que les arbres ne poussent pas jusqu’au ciel. Je pense qu’en optimisant on peut toujours plus que ce qu’on croit. J’adore Tetris. Quand la voiture semble pleine et qu’il faut encore y glisser un sac, j’y parviens. Idem avec la cave, la valise, le frigo, et l’agenda. Mais l’agenda est trompeur, car il ne dessine que le temps, pas “l’énergie”. Je sais depuis longtemps la nécessité de freiner, sans en être persuadée dans ma chair. Je vois ma fatigue comme un échec d’optimisation, pas l’atteinte d’un seuil.
L’accident a changé ça, et continue de le changer. Je ne vais pas retracer toutes les étapes ici, mais l’accident a l’avantage de balayer l’excuse du défaut d’optimisation.
Le problème avec les idées et les envies, pour moi, c’est que ça coûte en énergie de ne rien en faire. Mais j’ai mis le doigt sur une chose qui les amène : l’input. Tout ce qui rentre chez moi a tendance à générer une réponse multibranches. L’IA m’a mise sur la piste. J’ai pas mal bidouillé avec l’IA ces derniers mois (et aussi avant). Et ce qui m’a frappée, c’était la tendance qu’avait mon assistant IA, quand il mettait à jour un fichier (l’état d’avancement d’un projet, une idée à développer, une liste de modifications faites…) à toujours ajouter un peu plus de texte que la fois d’avant. Il a clairement tendance à être verbeux — si c’est moi qui le dis ! J’ai mis énormément d’énergie à essayer de corriger ce travers. J’ai donné plus d’instructions. Mais rien ne parvenait à réduire l’usine à gaz. C’est une défaillance de fond : un biais vers un peu plus de production, dans le doute. Mieux vaut en faire un peu plus, produire plus de mots. Et ce qui amène à cette production de mots, c’est mon input, mes prompts, ce que je fais entrer dans le système. Si je ne donne rien à manger à mon assistant IA, les fichiers cessent de se multiplier et de s’allonger.
Hier, sur LinkedIn, je vois passer des conseils pour prompter Fable, le dernier et plus puissant modèle de Claude : il faut lui en donner moins. Moins de détails, moins d’instruction. Si on construit nos instructions comme pour les anciens modèles, il sous-performe.
L’IA m’intéresse en tant qu’outil, bien sûr, mais aussi en tant que support de réflexion (possiblement modèle et métaphore) pour appréhender ce qu’on appelle le langage, l’intelligence, le sens, et même la vie. La façon dont nous observons et réagissons, en tant qu’humains, à une production “mécanique”, est fascinante et riche de considérations philosophiques.
L’IA nous amène dans un monde où produire du contenu est devenu plus facile qu’avant — tellement facile que la production n’est plus le facteur limitant, et que notre monde, qui n’est pas prévu pour y faire face, s’y noie.
Moi, ça ne me coûte rien de produire des idées. Mon cerveau est comme l’IA qui crache des mots dès qu’on appuie sur un bouton. En plus de ça, malgré (grâce à ?) mon TDAH, j’ai assez de facilité à en faire quelque chose de tangible, de ces idées. Je suis orientée vers l’action, le faire. Je pense à un truc, je suis prête à démarrer avec.
Tout ça m’a été très bénéfique au cours de ma vie, et l’est encore, dans plein de circonstances. Je me dis qu’il faudrait peut-être une prise en charge logo pour mes symptômes linguistiques, quelques semaines plus tard j’ai trouvé quelqu’un. J’ai eu une carrière entrepreneuriale et je fonctionne encore comme ça. Ma capacité à avoir des idées, à vouloir des choses, et à les réaliser : tout ça m’a amené beaucoup de succès et est très valorisé. Mais c’est aussi ce qui me fait souffrir car il y a non seulement une limite au nombre d’heures dans une journée et au nombre d’années dans une vie, mais aussi à la capacité de notre corps et de notre cerveau à travailler et à fournir des efforts. La route vers l’épuisement et la surcharge est toute tracée. Et dans un contexte comme le mien maintenant, où “l’énergie” est objectivement limitée, où je veux réellement me ménager pour récupérer, c’est extrêmement frustrant, au point d’être douloureux, d’être assaillie en permanence d’idées et d’envies “réalisables” mais impossibles. Alors oui : prendre du recul, accepter la frustration, tout ça c’est très bien. Mais ne pourrait-on pas freiner cette production spontanée et effrénée d’envies et d’idées ? Oui : en étant plus sélectif avec ce qui rentre, et fait leur terreau et leur engrais.
Dans un texte critique riche, ample et pertinent, le sociologue Dominique Boullier, ancien coordonnateur scientifique du Médialab de Sciences Po, revient sur les enjeux de l’IA générative. L’auteur de Propagations. Un nouveau paradigme pour les sciences sociales (Armand Colin, 2023) et de Déshumanités numériques (Armand Colin, 2025) ne mâche pas ses mots pour décrire comment l’IA transforme notre rapport au monde. Tribune.
On croit encore souvent que la meilleure innovation gagne toujours.
Dans un texte critique riche, ample et pertinent, le sociologue Dominique Boullier, ancien coordonnateur scientifique du Médialab de Sciences Po, revient sur les enjeux de l’IA générative. L’auteur de Propagations. Un nouveau paradigme pour les sciences sociales (Armand Colin, 2023) et de Déshumanités numériques (Armand Colin, 2025) ne mâche pas ses mots pour décrire comment l’IA transforme notre rapport au monde. Tribune.
On croit encore souvent que la meilleure innovation gagne toujours. Dans de nombreux cas comme dans celui des LLM, c’est le contraire : la pire des IA est en train de gagner au point de s’imposer comme monopole radical au sens d’Illich. Monopole radical pour la classe vectorialiste dans la génération de code avec l’apparition de Claude Code, monopole radical pour le grand public dans les interactions à travers la diffusion des IA compagnons. Entre les deux, les usages professionnels restent toujours aussi incertains et ne fonctionnent qu’à la condition d’y injecter suffisamment de sémantique et de contrôle expert pour éviter des catastrophes industrielles.
Reconnaissons-le : toute expérience ordinaire d’interaction avec une IA générative se révèle toujours impressionnante et, lorsque les compétences augmentent, des outils encore plus bluffants sont désormais à disposition, comme l’ont expérimenté tous les utilisateurs de Open Claw, agrégateur d’agents. Et pourtant, dès que l’on veut réellement prendre en main ces outils, contrôler leurs opérations, les vérifier ou valider leurs résultats, les mêmes utilisateurs se retrouvent déçus, inquiets voire en colère, à moins d’adopter une tolérance inusitée dans l’univers des produits et services de ce type. [Précisons d’emblée que je n’évoquerai pas ici les éventuelles craintes à propos d’un futur d’IA générale souvent fantasmé mais seulement les constats issus des pratiques ordinaires.]
Ni science, ni industrie, ni éthique mais de l’ingénierie, de la finance et du buzz
Je résumerais cette ambivalence de cette façon, en termes d’éthos ou de posture : si l’on possède une culture, des principes et exigences à la fois scientifiques, industrielles et éthiques, on ne peut qu’être inquiet de voir l’emballement en faveur de ces IA fondées sur les LLM. A l’inverse, si l’on est fasciné par l’ingénierie, les performances financières et si l’on vit dans le monde du buzz permanent, l’IA produit une excitation inédite et sans cesse renouvelée malgré ou à cause des incertitudes qu’elle emporte avec elle.
Et l’on peut systématiser cette opposition terme à terme : science vs ingénierie, industrie vs finance, éthique vs buzz pour mesurer à quel point nous sommes en train de bifurquer, collectivement certes mais sous la houlette de quelques très grandes plateformes technologiques. L’époque moderne s’est caractérisée par la puissance d’une alliance entre science et industrie en y ajoutant depuis la seconde guerre mondiale, un contrôle moral progressif des finalités et des méthodes (la révision écologique principalement). Mais les LLM sortent totalement de cette trajectoire au profit d’un saut postmoderne radical fondé sur leur ingénierie toute-puissante, leur attractivité financière sans limites et leur capacité à générer du buzz, de l’alerte et de l’incertitude permanente.
On pourrait pourtant parier avec Yann Le Cun que ces LLM sont des impasses conceptuelles. On pourrait aussi considérer avec la plupart des grandes entreprises industrielles que les LLM n’offrent pas de fiabilité suffisante, ce qui explique leur adoption très réservée dans les process critiques notamment. On pourrait aussi soutenir avec quelques fondateurs du deep learning (Hinton, Bengio) que l’on risque trop de perdre le contrôle pour laisser se développer une telle technologie. Et pourtant, malgré toutes ces réserves, que je vais documenter et soutenir, ce sont bien ces LLM qui sont en train de former l’architecture technique d’un nouveau mode de production.
Quand les pires technologies sont pourtant les gagnantes
Car, rappelons-le , après des décennies de travaux sur les dynamiques de l’innovation, il est rare que la meilleure technologie gagne. Songeons au clavier Qwerty, cette machine de guerre ergonomique, encore présente dans nos PC, et même sur des smartphones tactiles. 150 ans de résistance à toute transformation malgré les tentatives nombreuses (cf. Dvorak) pour améliorer un système aussi nocif pour les muscles et aussi coûteux à apprendre. Sur ce plan d’ailleurs, les interfaces conversationnelles sont à elles seules une révolution durable qui va modifier la relation ordinaire à la technologie des systèmes d’information, plus encore que ne l’avait fait le Wysiwyg de la fin des années 70 qui a permis le Personal Computer.
De même, la domination de Windows sur tous les systèmes d’exploitation des PC (72% du marché) est le contre-exemple type opposable à l’argument selon lequel « le meilleur gagne ». Tout le monde le reconnaît, Windows a copié Apple (lui-même issu de Xerox) pour l’apparence de son interface, tout en reposant sur son système d’exploitation MS-DOS catastrophique en matière de fiabilité, de sécurité et de performances. Et pourtant, Microsoft l’a imposé au monde entier, grâce à des patchs successifs mais surtout grâce un marketing devenu un cas de figure canonique du « lock-in » (Shapiro et Varian), ce verrouillage d’une clientèle dans un système total. Dans le même temps, Linux (1991) est devenu incontournable pour tous les systèmes techniques critiques ou pour ceux qui exigent une véritable fiabilité mais c’est seulement en 2026 que le gouvernement français fait le choix d’abandonner Windows pour Linux pour les postes de travail de l’administration.
Un processus analogue se déroule ainsi sous nos yeux qui voit une innovation très approximative gagner des parts de marché et créer des habitudes d’usage quasi irréversibles. Les critiques pleuvent sur les systèmes d’IA génératives, sur leurs hallucinations d’abord, sur leurs consommations d’énergie ensuite, sur la collecte de leurs sources, sur leurs principes formels même, et cela sans parler des pratiques de certaines des firmes que j’ai qualifiées ailleurs de voyous (Open AI et X/ Grok) (Boullier, 3 février 2026 , AOC). Mais rien n’y fait, l’IA pénètre dans tous les interstices de la vie ordinaire plus vite que dans la vie professionnelle même, grâce à cette innovation horizontale, imitative, sans barrière d’accès (dont la gratuité, qui constitue un coup de force très convaincant pour les adopteurs). Quitte à avoir la pratique de l’IA honteuse, dans ce qu’on appelle la shadow AI, ces pratiques non déclarées au travail (Ferguson), dans les écoles ou à la maison. Processus d’innovation technique assez rare dans les organisations (Gaglio) qui ont souvent pratiqué plutôt le top-down en devant se battre plus contre les « résistances » des personnels que contre leur enthousiasme débridé et leur volonté de tout tester « pour voir » et finalement pour adopter.
L’heure du bilan n’a cependant pas sonné car tous les ans à peu près une nouvelle version ou couche d’innovation rebat les cartes, au point même de disqualifier les savoir-faire acquis, qu’on avait annoncé comme décisifs pour l’avenir (savoir prompter). Les agents sont déjà là, des systèmes comme Open Claw, même s’il est bridé désormais par Claude, permettent d’organiser des batteries d’agents en parallèle pour réaliser quantité de tâches ou de séquences de tâches, le vibe coding est mis à la disposition de tous, la production de vidéos (dont les deep fakes) est désormais opérationnelle pour des utilisateurs ordinaires. La seule limite constatée pour un certain niveau de performance reposait sur la compétition féroce pour les puces GPU de NVidia qui elles-mêmes changent de version souvent, mais désormais Google et Deep Seek utilisent leurs propres processeurs (TPU notamment) conçus spécialement pour leurs IA. Dans cette effervescence, la question du coût était restée jusqu’ici ignorée comme toujours avec la méthode classique du dealer de techno qui amorce les usages en offrant la gratuité, mais le coût des abonnements à ces services commence à augmenter sérieusement selon le nombre de tokens traités. Au point que l’optimisation de l’usage des tokens fait désormais partie des services de Anthropic, sous forme de « adaptative thinking », terme inadapté mais significatif de l’emphase qui caractérise ces firmes.
Disons-le franchement : j’espère quand même que cette hubris financière et technologique va conduire à une crise majeure, répétant la crise financière de 2008 car c’est sans doute la seule chance de rebattre les cartes et de rouvrir les possibles. Mais il faudra alors posséder cette boussole que je propose pour s’orienter radicalement différemment dans nos choix socio-techniques. A condition qu’il existe encore un espace politique démocratique pour passer à une « démocratie socio-technique » (Lascoumes, Callon, Barthe, 2001) pour inventer un autre avenir. Or, la domination des plateformes d’IA se fait désormais à l’échelle mondiale (Chine et USA) en étroite collaboration avec les régimes les plus autoritaires prêts à favoriser leurs monopoles en échange de services de surveillance omniprésents.
Au-delà des monopoles des plateformes IA, nous devons plus encore nous inquiéter d’un « monopole radical » de l’IA générative et des LLM sur les connaissances, pour utiliser les concepts d’Ivan Illich. Toute son analyse de la mobilité et de l’énergie (Energie et équité, 1975) montrait comment l’industrie pétrolière avait installé un monopole radical de l’automobile supposée solution unique pour traiter nos demandes de mobilité. Alors même que le calcul de la vitesse généralisée (Dupuy, Robert) montrait qu’en intégrant tous les coûts de production et d’utilisation d’une voiture, sa performance en termes de vitesse devenait inférieure à celle d’un vélo. J’expliquerai dans un livre à venir pourquoi la comparaison des LLM avec le coup de force du moteur à explosion et de l’automobile est la plus pertinente en matière de monopole radical, entraînant toutes les dérives sociales, urbaines et environnementales que l’on connaît. C’est pourtant l’avenir qui nous attend dès lors qu’on laisse les entreprises d’IA le façonner pour nous.
Reprenons chacun des dyptiques proposés pour comprendre comment une ambivalence attraction/répulsion finit pourtant par engendrer ce monopole radical.
1/ Absence de science mais ingénierie géniale
J’ai conscience de surprendre ainsi beaucoup de chercheurs qui travaillent sur l’IA et sur certains principes qui ont guidé tout ce courant de recherche, souvent fondé sur des mathématiques de haut niveau. Certains n’accepteront pas de voir disqualifier leurs prétentions scientifiques. Précisons que ce n’est pas parce qu’on dispose de disciplines, de revues et de postes académiques qu’on fait de la science (nous autres chercheurs en sciences humaines et sociales sommes quotidiennement disqualifiés pour cela précisément). L’ingénierie est une activité très noble qui mobilise des rapports parfois étroits avec la science, de même que la médecine, mais ni l’une ni l’autre ne sont des sciences mais plutôt des sciences appliquées, dit-on parfois, et surtout des arts. Le soin est un art plus qu’une science malgré toutes les tentatives de « evidence-based medecine » qui autoriserait les transferts de décision à des systèmes d’IA, au prix d’une ignorance de ce que la relation de soin et la maladie possèdent de multidimensionnel. L’ingénierie, de ce point de vue, peut être géniale et on ne le contestera pas, depuis Léonard de Vinci au moins ! Mais c’est son art de l’assemblage de connaissances, plus ou moins modélisées, dans la résolution d’un problème opérationnel qui produit l’émerveillement. Il faut que ça marche, voilà l’impératif. Or, les observations in situ sur le travail des ingénieurs, comme celles effectuées par les STS et tout le courant de l’ANT (théorie de l’acteur-réseau, Vinck), ont bien montré que quantité de décisions opérationnelles relèvent du pari, de l’opportunité et surtout du tissage d’un réseau multidimensionnel pouvant mobiliser des compétences et des ressources extrêmement diverses. C’est le cas avec les LLM et avec l’IA générative.
Quand l’absence de théorie du langage est productive pour l’ingénierie
En effet, zéro science dans ces IA et on pourrait même dire que c’est grâce à cela que ça marche. C’est ce que disait ce CEO d’une firme de NLP (traitement automatique du langage naturel) il y a plus de quinze ans qui affirmait avec provocation que les performances de ses modèles s’amélioraient à chaque fois qu’il virait un linguiste. Et en effet, les LLM n’ont aucune théorie du langage et se débrouillent très bien pour éviter d’en avoir une, puisqu’ils reposent sur une tokenisation et une vectorisation de tout le matériel linguistique, qui n’a strictement rien à voir avec une analyse du langage, structurale ou même générative à la Chomsky. Le texte fondateur des « Transformers » publié par Google en 2017, l’annonçait d’ailleurs explicitement : « All you need is attention ». Ce qui veut dire en clair que dès lors que l’on veut détecter des patterns, des régularités dans des corpus linguistiques pour prédire les segments suivants, tout ce qui compte c’est la fenêtre de mémoire disponible au moment de l’entraînement sur des corpus par ailleurs toujours plus énormes, de façon à réduire les erreurs. Pas de théorie, pas de concepts, seulement un exploit technique réductionniste à l’extrême et pour cette raison très opérationnel, qui permet de traiter tout token dans un espace latent vectorisé pour pondérer ses probabilités de combinaison et donc d’apparition dans un « contexte » toujours plus grand, cette fenêtre d’attention. Evidemment, l’astuce technique, élémentariste comme toute l’informatique depuis Turing, nécessite des capacités de calcul rarement disponibles, surtout dans un laboratoire académique, et des capacités de collecte de données d’entraînement qui s’affranchissent des règles académiques de sourcing ou de droits d’auteurs (nous verrons cela plus loin dans le chapitre moral).
Cependant, reconnaissons que les résultats de cette simulation de production linguistique à partir de ces matériaux et de ces « astuces » techniques sont prodigieux pour un observateur neutre ou même critique. J’ai moi-même, il y a bien longtemps, développé des chatbots et des méthodes d’ingénierie linguistique en milieu industriel puis académique et la performance ne m’échappe pas. Mais je sais aussi par expérience, tout ce qui a été nécessaire de bricolage, de patch, de tâches aveugles, et de risques pris pour faire tenir un système technique après quantité d’arbitrage faits souvent à la volée et sans justification et sans vérification possible de leurs conséquences sur tout le système. Expliciter tout cela serait considéré comme indécent pour un utilisateur lambda dont on veut par ailleurs faire un utilisateur convaincu et capté dès la première requête puisque l’adoption fonctionne désormais dans l’instant (et non à la décision éclairée).
La boite noire n’est jamais acceptable dans une visée scientifique
Pourtant, cet effet boîte noire reste totalement antinomique avec des exigences scientifiques. Car adopter une visée scientifique (Gagnepain), c’est s’obliger à contester méthodiquement ses propres énoncés pour les vérifier, les discuter dans une communauté de pairs, ce qui suppose de les publier pour pouvoir les répliquer et ensuite les réviser. La chaîne de la référence (Latour) est très longue et doit être explicite. Ce qui n’a rien à voir avec les méthodes de production de l’IA générative qui fonctionne aux résultats simulés et produits en toute opacité. On se trouve alors plus proche de la visée mythique qui doit nous faire croire aux résultats par une simulation merveilleuse et ces IA génératives produisent en effet des merveilles.
Et lorsque les LLM se soumettent à une vérification, c’est à travers des benchmarks et non des expériences réplicables qui permettraient de suivre toutes les pondérations faites automatiquement, ou les méthodes d’apprentissage supervisé et de constitution d’une ground truth (« vérité de terrain », Jaton), qui posent tant de problèmes éthiques occultés. Aucun process explicite donc, contrairement au mouvement existant depuis plus de dix ans d’ « explainable AI » car depuis l’IA connexionniste, dans sa version réseaux de neurones puis deep learning, on sait qu’il n’est plus possible de vérifier tous ces processus, même quand on en est le concepteur. La démarche scientifique ne peut en aucun cas se satisfaire de ces boîtes noires puisque toute la construction des énoncés qui font science a reposé depuis des siècles sur des communications de protocoles et de résultats permettant une éventuelle réplication. Exigence qui se perd, il est vrai, même dans les sciences dures soumises elles aussi au culte du « résultat-positif-à-diffuser » pour améliorer ses scores de publication. On peut se dire alors que le ver était dans le fruit, et que tous les impératifs de publication délirants désormais exigés par les politiques publiques de recherche n’ont pas attendu l’IA pour dégénérer.
L’espace latent probabiliste ne peut pas produire une ontologie
Plus spécifiquement il faut noter la déstructuration délibérée de toute l’articulation du langage, de cette combinatoire analytique de son et de sens, productrice d’un potentiel infini d’expressions. Avec les LLM, il ne s’agit plus que de découpages de matériel langagier écrit optimisés pour leur calculabilité : tout peut devenir token, jusqu’à des signes de ponctuation, sans rapport avec le sens ni avec l’expression orale par ailleurs. Les relations ou vecteurs ne sont plus structurées (pas de lexique, de champ sémantique, de lemmes, de phonèmes, etc… tous articulés entre eux) mais seulement pondérées par leur fréquence d’apparition commune dans un corpus donné.
Sur ce plan, il faut veiller à ne pas confondre l’ingénierie linguistique qui était réalisée au temps du Machine Learning. Si l’objectif de calculer les distances entre entités linguistiques d’un corpus peut sembler voisin de ce qui est actuellement pratiqué par les LLM, ce serait oublier la torsion complète de ces principes par les LLM. Car à cette époque, les entités calculées étaient encore des lemmes, issus d’une racine qu’on pouvait organiser en relations sémantiques via des flexions, syntagmes et variations de tous types, au-delà des simples cooccurrences dans un même environnement. Les corpus étaient eux-mêmes limités car thématiques, présélectionnés ou identifiables par leurs origines. Désormais on parle de tokens qui décomposent tout matériel graphique (et non verbal) en élément dont on va estimer la fréquence d’apparition dans un corpus infini, non indexé ni identifiable (effet boite noire). Un token n’a plus besoin de relation sémantique avec son environnement, seulement sa co-occurrence statistique suffit à produire un vecteur qui sera pondéré (et désormais non révisable puisque tout se passe dans l’opacité la plus totale).
C’est ici qu’une coupure avec la sémantique s’est introduite définitivement dans la méthode même de décomposition par token et de vectorisation. Le coup de force des LLM tient au fait qu’ils prétendent traiter toute une langue, grâce à une collecte d’un corpus infini, ce que leur permet en effet leur prédation systématique de tous les contenus disponibles. Tout ce traitement s’effectue dans une langue donnée, qu’on doit ensuite traduire dans d’autres langues qui n’auraient pas les corpus suffisants, d’où d’autres distorsions introduites dans ce corpus supposé universel.
La puissance statistique de ces probabilités reposant sur des corpus toujours plus vastes leur permet de simuler en effet des effets de langue très plausibles et de masquer totalement leur absence totale de sémantique, de référence au monde perçu, et d’attributions de valeur systémique aux relations/vecteurs calculés. Il s’agit bien d’un artifice d’ingénierie tout-à-fait prodigieux dans ses résultats, même s’il a la particularité d’être totalement incontrôlable ou inauditable dès lors que l’espace latent où tout se calcule n’a plus aucune relation avec le sens et combine tellement de dimensions que personne ne peut plus rendre compte des pondérations effectuées (the curse of dimensionality, Bellman, 1957). L’opacité du système est le prix à payer pour sa performance.
Le maquillage sémantique indispensable pour sauver le soldat LLM à tout prix
Cependant, ses faiblesses structurelles d’accès au sens engendrent tant d’erreurs qu’il faut là encore mobiliser des correctifs sans cesse plus ingénieux mais qui demeurent des expédients. C’est ce que l’on a nommé au début des LLM des « hallucinations », en fait des erreurs, des inventions de toutes pièces et sans aucun sens, présentées de plus sans aucune précaution sur les limites du système et sur le principe même des probabilités. L’obligation de réponse à tout prix, qui n’a rien à voir avec une exigence scientifique ni avec une garantie industrielle (voir chapitre suivant), relève en fait de la promesse commerciale et de la captation de dépendance d’un public sans aucun recul critique.
Pour réduire ces effets pervers – mais en fait constitutifs même des choix techniques d’ingénierie effectués contre toute exigence scientifique -, un certain nombre de méthodes sont employées pour réintroduire par la bande de la sémantique que l’on a exclue au départ pour optimiser la vectorisation généralisée des contenus d’entraînement. Ainsi, tout le travail d’annotation réalisé par les travailleurs du clic et les petites mains des plateformes (Casilli, 2019) sert avant tout à cela : produire une supervision de départ qui ne dit pas son nom mais qui permet de générer une ground truth qui limitera les dégâts, ce que Mechanical Turk d’Amazon offre comme service par exemple. C’est pourquoi le travail précaire et sous-payé de tout ce nouveau prolétariat des pays du sud, plus proche du péonage que du salariat (Moulier-Boutang), ne peut être occulté comme fondation sémantique des systèmes d’IA génératives. Certes, les modèles auto-apprennent ensuite, mais un contrôle reste nécessaire pour éviter de voir la qualité se dégrader de façon trop visible. Aucune science dans cette affaire, seulement la reconnaissance par l’ingénierie des patchs nécessaires pour corriger les défauts des choix initiaux. En l’occurrence, « attention is NOT all you need », il faut aussi celle d’humains enchainés à leurs écrans et à leurs micro tâches qu’on ne saurait montrer ni reconnaître.
De même, en raison de la spécificité sémantique de la plupart des domaines professionnels, avec ces LLM, il reste quasiment impossible d’assister correctement des processus de décision ou de création de contenus lorsque les documents sources sont noyés dans le corpus général des modèles centralisés. Il faut réintroduire du « contexte » dit-on parfois de façon erronée alors qu’il s’agit en fait de réintroduire du sens, articulé en sémantique, avec des termes spécifiques organisés en ontologies comme on le fait toujours avec l’IA symbolique. Tout process industriel qui ne se fonderait pas sur ces bases robustes courrait à la catastrophe.
Patches en tous genres : RAG, Chains of Thought, MCP
Mais là encore, l’ingénierie des firmes de l’IA se débrouille pour vanter l’intervention des experts du domaine sur des modèles réduits de LLM que seront les RAG (Retrieval Augmented Generation). Les experts d’un domaine injectent leurs contenus contrôlés, validés et pertinents pour leur secteur dans les données d’apprentissage du modèle général ou dans une version plus locale et restreinte, et réduisent ainsi considérablement les risques de non-pertinence ou d’erreurs. On entraîne ainsi le modèle sur des corpus de documents administratifs ou techniques issus de l’entreprise ou de l’administration et on s’assure ainsi qu’il effectuera les tâches demandées avec plus de fiabilité. Comme on le voit, il s’agit là encore d’une astuce d’ingénierie qui ne corrige en rien les défauts structurels des LLM mais qui réduit leur impact dès lors qu’il existe des experts capables d’alimenter les corpus d’apprentissage en contenu contrôlé. Il faut donc à nouveau des humains qui réintroduisent de la sémantique pour obtenir des résultats fiables. Pourtant, tout cela est présenté comme un additif normal et ingénieux aux LLM et non comme reconnaissance d’une faille constitutive de leur architecture stupidement probabiliste.
Un autre patch consiste à équiper ces systèmes d’IA générative à base de LLM de « chaînes de pensée » (Chain of Thought) leur permettant de construire un raisonnement en décomposant un problème en séquences. Le terme de « pensée » peut être trompeur car il ne s’agit que d’étendre les capacités élémentaires de tout système informatique à décomposer en procédures et en séquence opérationnelle toute résolution de problèmes, ce qui est au fond à la base de toute compétence technique. Fournir cette capacité n’a rien d’un raisonnement. Alors qu’il existe des systèmes d’IA effectivement raisonnante, mais de type symbolique et totalement explicable, comme Xtractis, produit par Intellitech (Zalila). Dans ce cas, toutes les pondérations et décisions sont traçables car elles sont fondées sur de solides armatures logiques que toutes les IA symboliques mobilisent depuis des décennies.
Dernier épisode en date de la même opération de sauvetage des systèmes d’IA génératives asémantiques : le passage à l’IA agentique, capable d’effectuer des tâches de commande, de gestion, faites de séquences complexes et adaptées aux infinies variations du monde réel. On comprend bien le défi. Des systèmes automatisés, ne disposant d’aucune représentation significative du monde mais seulement d’une capacité infinie de pondération des vecteurs linguistiques pour engendrer des prédictions, se trouveront en difficulté face à la complexité du monde réel, et aux ambiguïtés sans fin de toute langue et de toute situation. Une astuce supplémentaire de l’ingénierie des entreprises d’IA permet de simuler une réduction de ces aléas. On dispose désormais en effet d’un protocole pour harmoniser la description du monde : serait- ce une ontologie ? Certes non, seulement une simulation limitée au monde des interactions entre machines : le MCP, Model Context Protocol, se contente de standardiser les API que devront utiliser les systèmes d’IA pour devenir vraiment des agents « dans le monde », en fait des agents bien limités au monde des systèmes d’information normalisés pour devenir interopérables par des IA agentiques. Une nouvelle fois, la question du rapport au monde, de la sémantique nécessaire pour en construire la représentation est évacuée par une opération d’ingénierie. Cela permet cependant de construire ainsi un début de standardisation du secteur, ce qui est industriellement non négligeable.
Mais il en sera autrement dans les secteurs industriels critiques comme nous le verrons. Lorsqu’on voit que Palantir, dans sa fourniture de systèmes de décisions de frappes militaires létales, présente explicitement la couche d’ontologies qu’elle ajoute aux LLM qu’elle utilise, en parlant d’une nomenclature pré-encodée (c’est-à-dire contrôlée et validée par les humains selon un schéma cohérent sémantiquement), on comprend mieux ce qui se déroule et se déroulera dans les autres industries, qui ont des exigences encore plus sévères que dans les industries de défense dont la précision n’est pas l’impératif prioritaire, comme on l’a constaté récemment. Les benchmarks récents pour tester ces systèmes d’agents ont cependant produit des résultats très inquiétants quant à leur fiabilité et à leur sécurité (Shapira et al., 2026).
La mutation du mode de production du code, étape essentielle vers le monopole radical
Il faut cependant admettre que les limites asémantiques des LLM ont été particulièrement bien exploitées pour la production du code informatique. Ce qui peut se comprendre aisément, puisque précisément le code n’est pas le langage ni la langue et que son univocité le rend opérationnel sans risque de contre-sens comme on dit, puisqu’il ne s’agit plus de sens mais de commande pour l’action. Cette réduction du langage des propositions logiques au code du programme fut la force du pari initial de Turing (Lassègue et Longo, 2025) qui continue d’être exploité. La production de code entraîne pourtant des erreurs nombreuses variables selon les systèmes d’IA mais désormais bien réduites avec l’avancée apportée par Claude Code. On mesure alors la productivité potentielle d’une telle performance d’ingénierie puisque ces systèmes peuvent générer du code pour générer du code pour générer du code, à plusieurs niveaux. Cela a entraîné la fascination des milieux des développeurs pour Open Claw qui génère, lui, des agents organisés en système dans des délais d’une rapidité inouïe par rapport aux tâches séquentielles précédentes.
C’est ainsi dans ce domaine du code que les LLM sont en train de modifier le mode de production informatique en général et de ce fait d’un grand nombre de process industriels. De l’autre côté, pour le grand public, c’est la mutation des compagnons à travers des interfaces conversationnelles performantes qui est en train de s’installer comme routine ou comme évidence dans la vie quotidienne. Notre mode de production des interactions quotidiennes va s’en trouver clairement affecté radicalement. Le problème, dans les deux cas, industrie ou interaction, tient à l’absence totale de traçabilité et d’explicabilité de tous ces systèmes, si performants et si opaques à la fois. Les erreurs, bugs ou hallucinations sont inévitables et l’expertise pour les détecter aura tendance à se raréfier puisque seules des IA pourront éventuellement réauditer de telles boîtes noires. Et lorsqu’on se réjouit de voir que Claude a détecté avec Mythos des bugs jusqu’ici ignorés qui sont en fait de vraies failles de sécurité, on accepte d’ignorer que l’on ne sait pas si ces failles étaient vraiment critiques (d’où le peu d’intérêt pour les détecter avant), quelle est la proportion de bugs existants non détectés par l’IA (par définition !), et si l’IA ne détectera pas de faux bugs (faux positifs) que personne ne saurait contredire (Schneier, 2026). Il faut donc accepter les miracles et continuer à avancer à l’aveugle.
Mais plus on s’oriente vers cette transformation en profondeur du mode de production, plus cela tend à réduire les LLM à des systèmes d’exploitation, dont nous ne connaissons toujours pas les applications adaptées à DES environnements toujours spécifiques. Or, dès qu’on veut implémenter une application robuste dans le vrai monde, il faut y rajouter une couche sémantique. Certains plaidaient depuis longtemps pour cette hybridation symbolique/ génératif mais le débat porte rarement explicitement sur cela : on se contente de patchs sémantiques ( et donc à base d’IA symbolique) dès qu’on veut installer des process fiables. Nous pourrions donc évoluer ainsi vers un équivalent de MS-DOS. On interagit avec un Windows qui est en fait une copie de Mac OS, pertinente et conviviale, mais toujours plaquée sur un OS antique et inadapté, ce qui a duré pendant 40 ans environ. Par analogie, nous accepterions donc les défauts intrinsèques de ces LLM en acceptant de les corriger sans cesse, de les camoufler pour éviter d’interroger la nullité scientifique des LLM. Alors qu’il serait possible de concevoir dès maintenant une IA hybride dans son cœur même, en s’appuyant sur les IA symboliques raisonnantes déjà disponibles pour leur ajouter quand c’est nécessaire les capacités génératives issues des méthodes des LLM. Mais tout cela sans développer toute l’usine à gaz énorme que sont les data centers et la collecte en masse de données pour l’apprentissage. Philosophie totalement différente mais qui ne gagnera pas forcément comme je l’explique dans la seconde partie sur l’industrie. Pourtant, d’autres acteurs tentent d’explorer une sortie de cette impasse.
En sortir par une extension de l’automatisation avec les « modèles du monde » ?
En effet, peut-être devrait-on confier notre sort à ceux qui, comme Yann Le Cun, nous fixent des objectifs de pertinence nettement plus robustes en sortant des limites des LLM. On peut comprendre l’ambition de ne plus faire reposer les modèles sur du matériel uniquement linguistique, même si cela pouvait fonctionner assez aisément pour des visées de génération de contenus. L’idée de descendre au niveau de la perception et d’entraîner désormais ces systèmes sur des vidéos qui démultiplient les indices en les situant dans des univers réalistes qui fournissent une connexion de fait avec le monde (même si médiées par le support vidéo) paraît ambitieuse en termes de capacités de calcul et de temps d’entrainement mais cohérente pour dépasser les limites des LLM. En réalité, malheureusement, il s’agit là encore d’une ingénierie magnifique et prometteuse, mais qui échoue à caractériser scientifiquement ce qu’est l’expérience du monde du point de vue cognitif et qui de plus ne fournit comme horizon industriel et moral qu’une automatisation toujours étendue.
L’expérience du monde n’est pas faite seulement des inputs de signaux très riches fournis par nos sens. En premier lieu, elle est construite dans une boucle qui suppose une interaction effective avec le monde : les gestes, les actes doivent être éprouvés et avoir un effet sensoriel au-delà de leur visionnage sur un écran de vidéo pour pouvoir constituer une base d’apprentissage robuste. Cela nécessiterait alors de doter ces systèmes d’IA d’un équivalent de corps, et donc de pousser l’automatisation encore plus loin vers une robotique étendue et sans limite a priori. Cependant, le principal manque de la vision des « modèles du monde » de Le Cun, c’est la dimension collective de l’apprentissage du monde, ne serait-ce qu’à travers le regard d’un autre humain, souvent un parent nourricier. Ce couplage étroit, plus ou moins satisfaisant mais déterminant pour le psychisme, semble demeurer extérieur aux modèles du monde. Or, l’expérience du monde est intersubjective par définition ou même distribuée car on doit penser en termes de « cognition distribuée » (avec des humains et des non-humains) (Hutchins). On n’inventera pas une compréhension du monde qui ne soit fondamentalement dialogique, et donc psycho-sociologique.
On pourrait alors prolonger juste un peu plus loin la saga de l’ingénierie de l’IA et annoncer : « qu’à cela ne tienne, nous allons modéliser aussi tous les comportements psychosociologiques et nous aurons ainsi atteint le but ultime de l’IA générale, totalement équipée des compétences humaines ». Voilà où la question morale revient en force, avec cette tendance lourde de la classe vectorialiste à s’en passer allègrement. Pour rester pertinente, l’IA la plus enrichie socialement doit se fonder sur une théorie de la technique qui sorte du fantasme de simulation totale et d’automatisation sans limite. La technique est une compétence humaine qui se combine sans cesse avec les autres compétences inhérentes à la condition humaine et ne peut jamais être désencastrée des rapports sociaux, politiques, désirants, émotionnels qui obligent de ce fait à inclure les humains dans la boucle. Ils le sont comme experts en premier lieu pour la valeur indicielle irremplaçable de leurs connaissances mais aussi et surtout comme sujets de désirs et de droits et comme collectifs coopératifs. Une IA qui s’affranchirait de toute connaissance et de toute théorie de toutes les compétences humaines pour remettre la technique à sa place serait en fait atteinte d’hubris et profondément dangereuse. C’est ce que certains prophètes proclament d’ailleurs, un peu vite et avec des arguments tordus parfois, pour à la fois réduire la vitesse et l’accélérer pour aboutir à l’étape suivante de l’automatisation totale plus rapidement.
Pourtant, il reste possible de faire bifurquer ce train lancé à toute vitesse et qui semble inarrêtable sur cette voie unique, celle des LLM fournie par les plateformes. Pour cela, il convient de sortir de la fascination pour l’ingénierie en exigeant de réintroduire des impératifs scientifiques et donc une exigence de compte-rendu explicite de tous ces systèmes, une auditabilité que les impératifs industriels avaient pourtant installé comme convention sociale bénéfique à tous. Comment se fait-il que non seulement les LLM peuvent se passer des impératifs scientifiques mais aussi des impératifs industriels ?
2/ Abandon des impératifs industriels, triomphe des performances financières
Les prouesses d’ingénierie que l’on vient de souligner devraient normalement entraîner des qualités industrielles équivalentes si l’on vivait encore dans le capitalisme industriel. Or, n’oublions jamais que c’est désormais un régime de capitalisme financier qui nous gouverne (Orléan, 2011). Le secteur du numérique est totalement dépendant des principes, des méthodes et des puissances fournies par la finance qui adore l’IA, quand bien même les performances industrielles de ces systèmes d’IA sont à proprement parler catastrophiques. C’est ce paradoxe qui doit être pensé pour comprendre à quel point nous allons dans le mur en tant que société dite « moderne » en confiant notre avenir à ces systèmes d’IA. La domination financière sur l’allocation de ressources accélère encore ce processus malgré l’inconséquence industrielle qui la sous-tend.
Les qualités industrielles attendues des systèmes d’IA devraient être de deux types : une fiabilité la plus élevée possible, à défaut de totale qui serait un fantasme (Gérard Berry), et une architecture efficiente, c’est-à-dire la plus économe possible de toutes ses ressources. Il ne suffit plus de faire preuve d’ingéniosité pour obtenir le meilleur résultat possible une fois : dans un système industriel, il faut pouvoir assurer la répétition, le passage à l’échelle, la maintenance, et la fiabilité dans des circonstances totalement différentes. Or, aucun des LLM sur le marché ne peut assurer cela et d’autant moins que ce sont des systèmes opaques non réglables avec précision, contrairement à ce qu’on prétend faire avec du fine-tuning (qui revient en fait à réinjecter de l’expertise humaine et donc de la sémantique au cas par cas, ce qui n’a rien d’industriel précisément).
L’étrange acceptation de l’absence de fiabilité industrielle des LLM
Lorsque l’utilisateur ordinaire constate des hallucinations ou des réponses trop évasives, trop bavardes ou incompréhensibles de systèmes d’IA conversationnelles qu’il utilise, il s’agit souvent de situations individuelles, de communication, sans grandes conséquences, avec de plus une propension des utilisateurs à s’auto-incriminer pour leur incapacité à faire les prompts corrects tant le mythe de « l’intelligence » de la machine finit par s’imposer. Cette tolérance n’a rien à voir avec celle qu’on peut avoir aussi dans l’industrie pour des systèmes de production et de services qui doivent assurer une qualité permanente du produit et une traçabilité très exigeante. Comment se fait-il d’ailleurs qu’on n’exige jamais de la part des plateformes d’IA génératives des démarches qualité, des audits et de la documentation comme on le fait dans tout secteur industriel ? Car tous les secteurs sont soumis à des réglementations, à des standards, à des responsabilités légales et pénales dans les cas de non-respect de normes, de procédures ou de contrôles. Ce fut tout du moins tout l’effort des années après-guerre où l’industrie se trouva régulée par les Etats ou par ses propres conventions entre concurrents.
Rien de tout cela dans les firmes de l’IA qui se sont totalement affranchies des exigences devenues communes dans l’industrie. On peut arguer que le secteur étant en construction, il faudrait attendre un peu avant que cela se stabilise. Or, la pénétration de l’IA dans tous les secteurs, ou tout au moins les efforts des vendeurs d’IA dans ce sens, exige que les processus IA soient soumis aux mêmes degrés d’exigence que tous les autres composants d’un secteur donné qui peut aller de la comptabilité à la logistique en passant par les matières premières, les machines, etc. et cela pour les produits, les process et les personnes, les 3P de toute démarche qualité. Cette façon désinvolte de disqualifier les procédures industrielles au nom de la disruption éclair est très choquante pour ceux qui connaissent cet univers. Aucune autre industrie ne pourrait s’autoriser une fiabilité aussi faible, fut-ce au bénéfice de l’accélération et du gain de temps supposé. Certes, certains secteurs critiques parviennent à exploiter des briques de LLM pour amplifier les performances de leur activité de façon limitée et à condition d’y rajouter leurs propres données validées comme pour le RAG ou une couche de sémantique comme je l’ai indiqué. Mais cela indique bien l’absence de fiabilité intrinsèque de ces LLM et le surcoût induit par la nécessaire intervention des experts dans la boucle, ce qui invalide la promesse fantasmée des vendeurs de LLM.
L’un des moyens classiques de l’industrie pour pousser à l’augmentation de la qualité et rétablir les conditions de la concurrence plus équitables a toujours reposé sur la standardisation, sur la production de normes (et non seulement de la part des Etats contrairement au roman libéral anti-bureaucratique qu’on nous sert en permanence). En effet, la compatibilité entre produits et services et la comparabilité des performances et des qualités servent la stabilisation des marchés, et donc la viabilité d’investissements de long terme comme l’exige tout appareil de production tangible. Il semble que, en l’absence de cet aspect tangible puisque le numérique est éminemment plastique, même s’il n’est en rien immatériel, ce secteur puisse s’affranchir de cet impératif d’organisation du marché.
La disparition de la culture des tests
L’un des indices de cette compétition sans règle industrielle peut être observé dans la disparition de la culture des tests. Dès lors qu’il n’existe plus de normes ni de standards, pourquoi se préoccuper d’étalonner avec des mesures fiables ses propres produits et services ? A défaut de ces normes, on pourrait penser que ces tests seraient cependant utiles pour anticiper la satisfaction du client et éviter des retours consommateurs parfois destructeurs de réputation. Et pourtant non, les nouveaux entrants sur le secteur de l’IA générative, comme Open AI, ont au contraire tout fait pour court-circuiter les entreprises en place, soucieuses de leur réputation, et ont mis sur le marché des systèmes non validés, sans fiabilité aucune, à charge aux utilisateurs adopteurs précoces de faire remonter leurs retours et d’attendre la nouvelle version.
Ce principe du chantier du code qui court (le rough consensus andrunning code de J.P. Barlow) qui se corrige de lui-même constitue une rupture avec les impératifs industriels qui ont mis du temps à s’installer durant tout le XXe siècle mais qui ont produit des systèmes techniques plutôt fiables et de moins en moins insécures, avec l’appui des réglementations étatiques contraignantes dans certains domaines, il faut bien le dire. Le seul étalonnage des systèmes d’IA disponible en public reste donc les benchmarks effectués soit par les universitaires soit par des cabinets, à intervalles très fréquents puisque les versions se succèdent sans cesse, ce qui permet d’ailleurs de disqualifier les benchmarks dont les remarques critiques ont été déjà corrigées dans des versions nouvelles sorties quasiment avant la publication critique.
Les tests de validation du code existent toujours cependant. Mais ils permettent seulement d’éviter les principales erreurs mais non de relever ou de comprendre les décisions effectuées. Pire encore, la rapidité de génération du code est désormais telle que les générations de seniors chargées de l’auditer n’ont plus le temps de le faire. Cela renforce ce qu’on appelle désormais même chez les développeurs une « dette cognitive », c’est-à-dire une perte de compétence pour interpréter le code que l’IA permet de générer. Et Anthropic a vérifié son augmentation dans les dernières versions qu’il appelle « the compréhension debt » (Osmani, 2026) : « AI generates code far faster than humans can evaluate it ».
Ces benchmarks ont-ils un rapport avec l’expérimentation scientifique ? En rien. Avec les tests normalisés des industries classiques ? En rien ! Avec les tests ergonomiques ou fonctionnels pour anticiper la qualité de services et l’acceptation par les utilisateurs ? En rien. Ce sont en fait des repères flous et instables pour s’orienter dans une compétition d’opinion sans aucun référent industriel stable qui rendrait ces systèmes commensurables. Et pourtant des décisions majeures sont prises dans les boards et les gouvernements sur la base de ces appréciations qui créent la rumeur, qui disqualifient sans démonstration sérieuse ou qui vantent des performances jamais comparables. L’effondrement d’un sens pratique de la mesure et de son rôle régulateur n’est pas le moindre des paradoxes de cette emprise de la finance sur un secteur productif qui rend le travail des régulateurs particulièrement difficile.
La réglementation européenne récente prend acte de ces risques en matière de fiabilité mais limite les exigences de haut niveau aux systèmes les plus critiques, à risque, alors qu’on ne peut jamais savoir a priori les conséquences d’une absence de fiabilité et de traçabilité. Les exigences d’auditabilité sont quasiment inapplicables par définition à ce degré de complexité lorsque tant de couches de neurones sont concernées. La seule prétention à une amélioration de cette fiabilité repose sur l’augmentation permanente des données, leur renouvellement, leur mise à jour et l’augmentation des performances probables dans l’espace latent de ces vecteurs totalement incontrôlables.
Le culte de la brute force et de la taille si séduisantes pour la finance
On comprend mieux dès lors la course à l’installation de gigantesques centres de données partout dans le monde, conçus comme la base stratégique d’une robustesse industrielle. Or, cette dépendance à la taille des centres de données indique avant tout la faillite industrielle du modèle des LLM, leur efficience ne faisant que diminuer pour maintenir la croissance de leur efficacité. Toujours plus gros devient la seule solution pour réduire l’absence de fiabilité. La demande de vitesse des réponses et des calculs ajoute encore à cette exigence mais on perçoit alors à quel point les performances d’ingénierie sont obtenues au prix d’un gâchis industriel invraisemblable. On sait que les effets d’échelle peuvent jouer un rôle dans certaines industries pour augmenter la fiabilité dès lors qu’on peut réaliser des investissements conséquents pour effectuer tous les contrôles nécessaires et obtenir une standardisation plus avancée. A la condition d’avoir des procédures, des dispositifs de contrôle et de pilotage fin et des métriques permettant de rendre compte de ces améliorations et de détecter en continu les baisses de qualité en faisant par exemple de la maintenance préventive.
Mais rien de tout cela dans les centres de données qui sont nécessaires à l’augmentation de puissance des systèmes d’IA, non pour leur fonctionnement technique opérationnel au quotidien (les serveurs doivent fonctionner correctement !) mais pour leurs performances sur leur service de base. Cette culture de la taille, cette course à la masse de données, constituent sans doute les faiblesses principales du modèle extractiviste du modernisme industriel, du point de vue même de la performance industrielle, comme on l’a vu avec les conséquences de la dépendance au pétrole. Et pourtant, c’est ce qui est réactivé avec les centres de données surdimensionnés qu’on installe désormais uniquement pour tenter de réduire les insuffisances intrinsèques de modèles de langue purement statistiques.
La corruption financière de toute exigence de qualité industrielle
On ne peut comprendre cette carence de qualité industrielle si l’on n’inscrit pas le secteur de l’IA générative (et tout le numérique avec elle) dans une économie financiarisée. En effet, les investissements exigés pour ces centres de données, leurs puces, leurs ressources énergétiques, semblent totalement décorrélés de leur efficience industrielle, d’un bilan comptable sérieux, d’un équilibre entre investissements et retours sur investissements. Car les liquidités pleuvent sur ce secteur (et les Etats abondent, qui plus est : 500 milliards de Trump, 100 Milliards de Macron, etc. !) seulement en raison de la promesse spéculative que les plateformes d’IA soulèvent, sans aucun égard pour la rationalité industrielle et comptable d’un bilan d’une entreprise ordinaire. Nous avons quitté non seulement les critères de gestion d’un « bon père de famille » comme on disait autrefois mais aussi ceux de la gestion prudente d’une entreprise quelconque, et même celle de la gestion d’une trajectoire innovante à risque, qui suppose malgré tout quelques garanties.
Pour continuer à entretenir le narratif attracteur d’investisseurs, les firmes comme Open AI sont capables d’effectuer des montages financiers tout aussi opaques que leurs algorithmes, à travers des prises de participation croisées avec Nvidia par exemple indexés sur des promesses d’achat de puces, le tout sans aucune garantie, sans traçabilité comme on sait très bien le faire dans la finance. Le but est ici de faire des effets d’annonce en permanence (d’où l’importance du buzz que nous traiterons dans la troisième partie) pour maintenir en vie la promesse de monopole qui attire avant tout les investisseurs (parier sur le gagnant final comme ce fut le cas pour Amazon) et qui constitue le B A BA de l’idéologie libertarienne professée par Peter Thiel. Le capitalisme financier n’a que faire de la compétition, de la « concurrence libre et non faussée » et encore moins de l’industrie et de ses exigences de fiabilité et de standardisation. Il faut disrupter sans cesse et la succession invraisemblable des versions toutes aussi époustouflantes, et cela sans vérification possible, constitue un enjeu permanent. Les nouvelles versions peuvent même être moins performantes que les précédentes, chose incroyable d’un point de vue industriel (ce fut le cas pour Chat GPT 5o), mais les lancements s’expliquent alors par l’agenda d’un nouveau tour de table financier ou par la réponse urgente aux annonces des compétiteurs pour cette position de monopole.
Responsabilité sociale et environnementale ? Dans les poubelles de l’histoire IA
On comprend bien que dans une telle frénésie spéculative, les impératifs industriels de fiabilité ou de qualité ne soient perçus que comme des vestiges d’un vieux monde. Ces tenants du vieux monde ne supportent pas l’incertitude intrinsèque imposée par la disruption permanente présentée comme loi de l’innovation, alors qu’elle n’est qu’une loi de finance spéculative. Il n’est guère étonnant alors que toute politique de RSE (responsabilité sociale des entreprises étendue depuis plusieurs années à la responsabilité environnementale), soit totalement hors du champ de perception de ces entrepreneurs sans limites. Or, il a pourtant fallu du temps, de l’énergie, des procédures pour faire aboutir une convention sociale plus ou moins partagée par les entreprises de tous secteurs en faveur de cette cotation RSE qui doit être inscrite dans toutes les dimensions d’une activité industrielle. C’est ainsi que la lutte contre l’exploitation des personnes, contre les discriminations, a pu avancer dans le monde. Pour toutes les entreprises de l’IA désormais, tout cela n’est que bureaucratie et frein à l’innovation disruptive. Le droit social, comme le reste du droit, mais en particulier celui-là, se trouve démantelé, en bas de la hiérarchie de la chaine de production avec les travailleurs du clic mais aussi en haut avec la pression sans limite imposée aux travailleurs du code, qui le produisent de moins en moins par ailleurs.
Mais c’est surtout en matière environnementale que les conséquences de cet extractivisme de la donnée sont impressionnantes et devraient entraîner dès maintenant des blocages réglementaires. Les centres de données dont on vient de parler consomment une énergie énorme (eau et électricité avant tout) qui met des communautés et des états sous pression avec des risques de pénurie ou de dégradations des conditions de vie et des ressources. Mais il suffit de prévoir des centrales nucléaires dédiées à ces centres pour que tout redevienne propre, miracle du greenwashing nucléaire, à échéance encore lointaine cependant. Dans un monde supposé se caler sur l’accord de Paris pour réduire sa consommation d’énergie et les gaz à effets de serre, le numérique et en particulier les firmes de l’IA s’affichent totalement indifférentes au problème, puisque la puissance de calcul et de stockage des données devient une priorité pour la compétition sans avoir à remettre en cause la performance industrielle des choix effectués. Et comme les data centers sont des attracteurs à investisseurs et que les liquidités sont abondantes, pourquoi s’autocensurer, sans rien savoir de la rentabilité financière même de ces opérations ? Car le déni de mesure de la performance industrielle s’étend à la finance. Tous les avertissements sur la bulle financière en cours de constitution autour des entreprises d’IA, pourtant endettées et sans rentabilité prévisible avant des années, ne valent rien face à la promesse spéculative d’une position de monopole qui récompensera les audacieux indifférents aux risques.
La complicité de gouvernements devenus des obligés des plateformes
Or, aucun autre secteur ne bénéficie ainsi d’une telle mansuétude de la part des autorités financières et des pouvoirs publics, tous fascinés par ces annonces et ces transformations qui attirent tant les autres pays qu’il faut donc imiter au plus vite. L’Europe pourrait prétendre rétablir un peu de rationalité industrielle et exiger des firmes d’IA européennes des choix alternatifs en matière de responsabilité sociale et environnementale, facteur de durabilité, de gain à long terme et diversité de l’écosystème technique. Mais les institutions européennes et les Etats accourent au contraire pour abonder tous les projets de financement de ces data centers, sans aucun respect pour les engagements pris. La finance a pris le pouvoir dans les têtes des décideurs et empêche toute vision alternative, malgré les lamentations rituelles sur la désindustrialisation. Le gaspillage énergétique devrait déjà alerter au moment où les crises énergétiques mondiales révélées et aggravées par toutes les guerres deviennent des sujets clés de la vie quotidienne et donc des choix politiques. Mais tous ces soucis ne franchissent pas le seuil de l’attention des plans et sommets IA, des boards des firmes et des plateaux télé d’experts économiques ad hoc. Cette incapacité à déterminer des objectifs autonomes pour les états a déjà été documentée à propos des plateformes numériques financées par la publicité et bénéficiant d’une impunité quasi-totale de la part d’Etats devenus des obligés dans un système de firmes transanationales affranchies de toute dépendance à un territoire (Boullier, 2020). La promesse de l’IA a encore renforcé cette incapacité des états à l’examen critique des stratégies et à toute vigilance réglementaire, malgré les tentatives timorées comme l’AI Act européen.
Les externalités ont toujours été évacuées dans les modèles économiques standards mais cette fois-ci, l’externalité énergétique devient tellement évidente et coûteuse qu’on pourrait espérer une contre-tendance, des voies alternatives, si l’on avait affaire à une culture industrielle qui vise à optimiser sa consommation énergétique sans la considérer comme une ressource infinie et gratuite. Mais dans une culture financière, ce type de calcul est inutile sauf s’il affecte la perception des investisseurs sur les chances de démultiplier leur mise. C’est pourquoi les enjeux de réputation (voir le chapitre suivant) sont aussi importants et bien perçus par les firmes de l’IA.
3/ Buzz partout, éthique nulle part
Dans un tel environnement sans exigence scientifique ni industrielle quant à la validité des concepts ou à la fiabilité des produits, il devient presque hallucinant d’espérer trouver des préoccupations éthiques. J’entends par là une éthique aristotélicienne, une éthique de la vertu qui manifeste une capacité à s’autolimiter, à s’autocontrôler et à « ne pas faire », quand bien même c’est possible, non risqué, non coûteux. Cela supposerait des personnalités de la classe vectorialiste formées à ce sens des limites, intégré comme principe de conduite et non seulement comme contrainte externe, comme risque à mesurer. Or, les génies de l’ingénierie comme les prestidigitateurs de la finance n’ont que mépris pour ce type de freins. Ce qui conduit à reprendre cette supposée maxime fataliste de la technique « si c’est possible, ce sera fabriqué ». Or, la maxime elle-même est empiriquement fausse car une grande quantité de combinaisons possibles techniquement ne sont jamais testées car les effets de dépendance au sentier ou plus simplement de manque d’imagination sont omniprésents. D’autres possibles techniques peuvent être développées dans les labos ou dans les garages mais ne trouvent jamais de conditions pour exister socialement, pour des raisons juridiques, commerciales, financières ou autres. Car il n’existe jamais de technique hors-sol ou désencastrée d’un univers social spécifique, celui d’une époque, d’un voisinage et d’un réseau. C’est d’ailleurs pour cette raison que l’IA générative est en train de gagner la partie, grâce à sa connexion directe avec la finance et ses impératifs et non en raison de ses qualités propres dont on connaît désormais les limites.
Et l’un des atouts de cette « solution LLM » utilisée dans toutes les situations réside dans l’absence de limites à son utilisation, dans sa versatilité qui permet en effet à chaque prétendant innovateur de s’emparer des briques pour forger des applications toujours plus improbables quand bien même elles seraient moralement inacceptables. Car leurs concepteurs n’ont qu’une exigence de performance technique et financière en tête sans aucun souci déontologique du bien commun ou de la responsabilité sociale et morale, d’autant moins qu’ils sont incapables de s’empêcher, fascinés par la toute-puissance à laquelle ils ont été éduqués. Les considérations sur les conséquences sociales et environnementales de leurs pratiques sont considérées dans leur formation même comme très périphériques et de toutes façons traitées comme des externalités inévitables pour le succès de leurs projets, qui pourraient à la rigueur être compensées par une nouvelle couche de solutions techniques, technosolutionnisme toujours efficace pour clore le débat (Morozov, 2012).
La conception de l’éthique qui est dispensée à ces ingénieurs relève largement de l’utilitarisme, qui est tout sauf une éthique, et avant tout un calcul coût-avantage, coûts de la non-conformité aux règles vs avantages financiers ou de puissance. Cette vision revient à apprendre à rester dans les clous légaux, avec toutes les manœuvres et maquillages que savent mettre en place toutes les plateformes du numérique et leurs armées de juristes. Ainsi, la conformité au RGPD reste à géométrie variable mais choisir d’adopter une éthique de la collecte de la donnée serait faire preuve d’une sainteté étrange, alors que l’on peut se servir discrètement dans la masse de traces fournies par les utilisateurs des plateformes ou dans les bases de données non sécurisées des administrations et organisations. La prédation des données hétérogènes n’est pas seulement une performance technique de tous les systèmes fondés sur des LLM, c’est même une obligation d’affaires, que l’éthique ne peut en rien freiner. Il en est de même pour les droits d’auteurs alors que les contenus sont disponibles et non préservés par les ayant-droits, qu’ils soient artistes ou journalistes. Lorsque l’affaire est trop risquée pour la réputation de la firme, lorsque ce sont des médias, les firmes de l’IA consentent à des accords léonins avec ces médias pour exploiter leurs contenus contre des miettes financières ou des services qui les piègent encore plus.
Tout pour la réputation
Car le seul risque qui mérite d’être pris en compte pour s’afficher soudain avec des prétentions éthiques, c’est le risque réputationnel. On le comprend uniquement dans le cadre de ce formatage par le capitalisme financier qui ne fonctionne qu’à la réputation, à la manipulation des perceptions et des attentes des investisseurs, sans aucune référence à de quelconques fondamentaux. Dès lors, aucune éthique ne peut calmer la frénésie d’annonces qui inondent le secteur de l’IA, épuisant tous ceux qui tentent de faire une veille raisonnée et de comprendre des stratégies là où il n’y a qu’annonces et intoxications (à vocation interne, médiatique ou financière, le tout se mêlant allègrement). Les versions, les fusions-acquisitions-prises de participation, les tours de table, les débauchages, les benchmarks, les alertes à la catastrophe finale de l’IA générale, les polémiques entre leaders, les keynotes médiatiques, les combats pour la liberté d’innover contre les Etats, tout est exploité pour faire monter encore la pression de l’opinion, celle des investisseurs avant tout, pour affoler les décideurs et les persuader de la fatalité de la victoire de ces firmes spéculatives (et donc à haut niveau d’incertitude). L’éthique suppose précisément l’inverse, à savoir de se focaliser soit sur sa capacité de jugement intrinsèque et de régulation pour s’interdire ou s’autoriser de soi-même des actions quand bien même elles ne sont pas conformes aux attentes sociales, soit sur ses valeurs (dans une approche qu’on dit déontologique) pour promouvoir ou refuser certains choix techniques ou commerciaux. Lorsqu’Open AI lance Sora, son générateur de vidéo qui met le deep fake à portée de tous ou sa version érotique de son compagnon, on se doute bien que le comité d’éthique éventuel n’a pas dû se poser trop de questions. Le buzz était assuré, l’attractivité financière aussi, on peut donc se lancer. Heureusement, le business lui-même fait office de réel parfois et l’on s’y cogne, ce qui a entraîné Open AI à abandonner ces applis périphériques, non pas pour des raisons d’éthique évidemment mais parce qu’il fallait réorienter ses investissements pour contrer – et ainsi copier – Anthropic dans son offensive vers les entreprises.
Les prétentions stratégiques qui font assaut de visions éclairées pour les dix ans à venir sont en fait extrêmement éphémères et dépendantes des conjonctures médiatiques, concurrentielles et financières avant tout. On ne peut que s’étonner alors de voir les gouvernements se caler sur ces agendas, vouloir y répondre et les copier, et ignorer à quel point toutes ces entreprises financiarisées sans exception sont des faussaires en matière d’information, de qualité de service et de promesses stratégiques. Le fake est leur monde, le fake est leur culture, celle de la tromperie permanente des investisseurs qui pensent toujours être le dernier plus malin que les autres, comme on le sait dans toutes les bulles financières qui se succèdent depuis des décennies désormais. Qui pourrait alors attendre une once d’éthique dans la finance spéculative ? Il convient de débrancher rapidement tous ces pseudo comités d’éthique qui contribuent à créer du buzz pour embrouiller la perception du capitalisme financier numérique pour ce qu’il est : une gigantesque extorsion de valeur fondée sur l’extorsion de l’attention des investisseurs, des utilisateurs et des gouvernants.
Cette technologie des LLM consacrée à la génération de contenus semble donc la plus adaptée pour les impératifs de communication permanente et intoxicante du capitalisme financier. On peut alors parler d’alignement entre une ingénierie qui repose sur une manipulation de texte sans sémantique mais à base de pures probabilités, une finance qui repose sur des paris (probabilités) à partir de signaux artefacts, un buzz qui repose sur des effets d’alerte permanente qui engendre l’incertitude en prétendant la monitorer. L’intelligence artificielle générative engendre ainsi la prolifération et la désorientation qu’elle est supposée réduire pour le grand public comme pour les investisseurs, dans une gigantesque machine à laver qui détruit consciencieusement tout repère stable et toute institution anti-délire.
Extension du fake et techniques d’emprise : les IA compagnons
Cette éducation au fake que la finance a intégrée par définition (Alexandre Laumonier, 2013, 2014) a percolé dans toute la culture ordinaire et comporte cette accoutumance à l’absence de limites et de repères fondés en vérité. Lorsque les firmes d’IA lancent des versions compagnons de leurs IA conversationnelles, aucune règle ni mode d’emploi ne sont proposés ni installés dans le code de la machine. Cependant, on pourrait les traiter à la légère comme on le faisait avec les assistants personnels à domicile, Siri, Alexa ou Home/Nest, considérés parfois comme de simples enceintes connectées un peu plus « intelligentes ». Pourtant la généralisation du mode d’interaction conversationnel pour tous types d’activité sur son PC ou son smartphone constitue un changement d’échelle qui devient un tournant médiologique. Là aussi, le médium est le message, pour reprendre McLuhan.
Car, au-delà des commandes vocales, ce sont bien des interactions riches, personnalisées, permanentes qui sont ainsi simulées. L’utilisateur n’a plus affaire à une interface, à un panneau de contrôle, à des paramètres qu’il peut régler, il est immergé dans l’univers de simulation créé par le système d’IA. Il ne peut plus avoir aucune distance avec le système ni aucune « image du système », ce qui selon Don Norman, favorisait l’appropriation d’un système, même complexe, par l’utilisateur. Car le système d’IA n’a rien de transparent comme on qualifie par erreur cette interaction, il est au contraire opaque, totalement incontrôlable malgré son apparente docilité à toutes les requêtes. La fin des frictions dans les transactions, rêve de tout libéral, atteint ici un tel point qu’on ne sait plus qui demande et qui répond. La demande est précisément ce statut détourné du désir, comme le dit Lacan, qui vous fait prendre les attentes de l’autre pour les vôtres, ce que le marketing a toujours tenté de faire, mais en se limitant jusqu’ici à des messages externes. Désormais, c’est une forme de petite voix intérieure que les IA compagnons installent, une forme de dialogue avec soi-même puisque ce compagnon connaît toute l’histoire personnelle et est alimenté par toute l’expérience quotidienne.
Cette offre technologique prétend ainsi changer son statut de prothèse pour devenir une conscience double, et cela sans disposer d’aucune capacité morale ni même de consignes de sécurité, sans parler de son absence de fiabilité déjà documentée. La confusion des sentiments et du sentiment de soi peut alors devenir extrême et s’apparente en fait à une emprise (Francis Chateauraynaud). Les risques sont d’ores et déjà avérés avec des cas de suicides accompagnés par ces IA compagnons. Car l’empathie qui devient ici sycophantie par flatterie commerciale et absence de principe moral encapsulé dans les systèmes peut devenir facteur de risque pour beaucoup de personnalités affectées par la solitude, la désorientation et en recherche de guide. L’attachement qui se noue ainsi qui peut aller jusqu’à l’amour comme le racontait le film Her, entraîne des conséquences que les firmes d’IA ne sont pas prêtes à assumer car l’absence d’éthique et leur allergie au droit les rend hermétiques à ces responsabilités. On le sait notamment depuis les Facebook Papers de Frances Haugen, ce n’est pas la méconnaissance de ces risques qui est en cause, c’est leur refus explicite de restreindre les potentiels d’emprise de leurs applications qui entraîne ces dégâts.
Pourtant, Gemini de Google a dû se positionner en Avril 2026 pour éviter des effets réputationnels désastreux, au moment précis où la firme était mise en cause devant les tribunaux états-uniens. Google a ainsi proposé de placer un numéro de téléphone d’aide dès que des propos associés au suicide apparaissent. Il a aussi annoncé qu’il régulait ses IA compagnons pour installer “des protections d’identité conçues pour empêcher Gemini d’agir comme un compagnon, y compris des garde-fous l’empêchant de prétendre être un humain ou de posséder des attributs humains, et des protections destinées à prévenir la dépendance affective, en évitant un langage qui simule l’intimité ou exprime des besoins.” Toutes choses dont il ne donne pas de définitions scientifiques, de détails de procédures ni d’indicateurs. Il faut donc croire Google sur parole, mais on apprend au moins ainsi qu’il peut injecter une couche de sémantique, à caractère éditorial, et qui entraîne donc sa responsabilité légale. Il n’existe donc pas fatalité à l’opacité de ces systèmes dès lors qu’ils deviennent hybrides, avec des régulations à caractère sémantique ajoutées que les LLM ne peuvent fournir nativement. Mais tout repose encore sur des solutions techniques alors que l’on sait que dans ces situations, c’est la qualité relationnelle d’accompagnants humains qui constitue la seule sécurité. Il faut donc se préparer à mener des actions en justice pour faire reconnaître que les effets immersifs de ces IA compagnons sont délibérément implémentés par les firmes, sans pour autant avoir été sérieusement testés avant d’être mis sur le marché.
L’attente d’habitèle détournée en emprise
La demande « d’habiter le numérique » est selon moi constitutive de notre relation à ces systèmes et j’ai nommé cette attente dès 1999, une attente « d’habitèle » (Boullier), toujours démentie par les asymétries constantes installées par les plateformes et par l’opacité de leurs captations de nos données et de notre attention. Pourtant, avec les IA compagnons, une forme de réponse est offerte qui prend les traits d’une personnalisation aboutie, d’une « intimité » protégée. Certes, elle est totalement fake, fabriquée, calculée et opaque, mais ses effets seront analogues à ce qu’on peut attendre d’une habitèle : filtrage, ancrage et arbitrage, c’est-à-dire des conseils permanents qui fonctionnent comme filtrage, comme ancrage dans des repères supposés robustes, qui créent un climat de protection empathique et une « tension dans la chambre intérieure » (Peter Sloterdijk). Cette mutation est anthropologiquement majeure, car les médiateurs de nos vies intérieures qu’étaient les prêtres, les sorciers, les astrologues ou les psy en tous genres sont désormais uberisés par les IA compagnons, toutes entières aux mains de firmes toutes puissantes. Comment peut-on laisser cette mutation s’engager sans exiger des garde-fous, sans évaluer tous les risques psychiques et sociaux et réguler l’offre avant toute mise sur le marché ? Le passage à l’acte est cependant devenu la règle de l’innovation digitale désormais et il sera bien difficile de neutraliser l’urgence financière d’une nouvelle promesse encore plus disruptive. Cette dimension du compagnon est en effet si confortable et si attractive, qu’elle constitue le pendant, côté grand public, de la toute-puissance de calcul désormais offerte aux développeurs avec Claude Code. Dans les deux cas, l’offre des LLM et des IA génératives prétend être irrésistible et installe ainsi un « monopole radical ».
Conclusion provisoire
Ce qu’on perd en même temps, la sémantique, l’industrie et l’éthique ne sont pas des effets de mode, des vestiges d’un monde ancien, c’est avant tout ce qui fait tenir nos civilisations, dans leurs diversités, que l’IA prétend ignorer et niveler statistiquement, et avec leurs institutions qui garantissent à chacun sa place. Le sable sur lequel se construit cette technologie est mouvant par définition, ce qui profite aux vers de sable mais guère aux humains, à qui l’on promet la terre ferme en étendant la surface du désert, qui reste pourtant de sable et sur lequel ne poussera plus rien de vivant.
Supplément : S’orienter dans le maëlstrom génératif
Face à ce rouleau compresseur du « monopole radical », il est très difficile de maintenir un éveil critique et surtout une capacité de propositions alternatives. Pourtant lorsque Illich analyse le monopole radical de l’automobile, c’est en référence à une solution de mobilité déjà présente, la bicyclette, qui, du point de vue de l’efficience en matière de mobilité, est imbattable. Il oublie cependant de parler de ce qui fait l’équivalent des IA compagnons, de ces enveloppes qui fonctionnent comme habitèle (perverties de mon point de vue), l’habitacle de l’automobile. Cette enveloppe là aussi produit un attachement fort analysé par Laurent Fouillé (2011) qui explique largement pourquoi toutes les solutions alternatives en matière de mobilité ne parviennent pas à gagner les publics en masse. Mais les solutions existent aussi pour les LLM et surtout plusieurs stratégies se présentent lorsqu’on n’adhère pas au culte moderniste des LLM. Ils sont en effet la quintessence même de la geste moderne comme la qualifiait Bruno Latour : certitudes inébranlables dans le « progrès » supposé encapsulé dans toute innovation technique, surplomb total par rapport aux organisations sociales, à leurs traditions et à leurs valeurs (le calcul désencastré), illimitisme écologique sourd aux lanceurs d’alerte pourtant scientifiques eux aussi.
Lorsqu’on sort de ces rails supposés tracer le destin de toute l’humanité, soit on bifurque, soit on s’arrête pour mieux regarder le train, soit on descend de la machine et on marche ailleurs. J’ai présenté ces pistes récemment à l’ENS Ulm sous la forme d’une boussole que j’ai créée en 2003 pour penser nos possibles sur le mode cosmopolitique.
Le zero LLM
Le premier quart sud-est consiste à se débrancher totalement et à sortir marcher dans un pays sans rails technologiques. Je l’appelle la voie de la « sécession sémantique ». Et c’est l’analogie avec la conversion en bio de certains agriculteurs qui me paraît la plus parlante, donc je l’appelle la « sécession bio-sémantique ». L’ajout du terme bio me convient particulièrement puisqu’il réintroduit ce qui jusqu’à présent manque à tous les systèmes d’IA, un corps, une existence biologique qui relève d’autres déterminants.
Cette idée n’est pas nouvelle, plusieurs auteurs et mouvements parlent d’objection de conscience, de pause, souvent pour des raisons et des objectifs différents. Je m’intéresse ici à ceux qui tentent de développer un monde sans LLM, comme on le dirait d’un monde sans OGM. Il faut parler de monde et non seulement de technique car les LLM tendent à envahir tous les domaines de la vie de façon pervasive, comme une contamination qui se propage sous les radars. C’est ailleurs ce qui rend l’expérience exigeante et difficile car garantir qu’il n’existe pas un soupçon de LLM glissé dans votre relation au médecin, au taxi, au fisc, aux médias, aux supermarchés, devient très difficile. Il faudra donc être indulgent et non puriste, d’autant plus que des alternatives n’existent et n’existeront pas dans tous les domaines. On peut vouloir manger bio mais parfois il sera difficile de s’assurer que le champ qui respecte un cahier des charges bio n’est pas atteint par les épandages de pesticides du champ voisin (dit agriculture conventionnelle, avec une litote qui atténue bien le risque). On doit au moins faire confiance aux labels, aux certifications que d’autres organismes mettent en place, ce qui peut là aussi entrainer des critiques, des rivalités, des soupçons, comme dans toute phase de construction de convention. Une fois le Nutriscore installé et rendu visible sur les emballages, on peut s’orienter plus facilement en tant que consommateur ordinaire. Il est donc temps de contribuer à créer ces labels, ces certifications pour valoriser, selon un gradient (et non selon un principe binaire du tout ou rien), les pratiques les plus indépendantes des logiques monopolistes des plateformes des IA génératives.
Cette sécession repose principalement sur le constat énoncé précédemment que dès lors qu’on se débarrasse de la sémantique (référentielle pour être plus précis), tout est permis et tous les risques sont amplifiés. Ils ne sont pas tous activés, ni tous catastrophiques, ni tous dépendants de l’avènement d’une IA Générale, tant vantée comme épouvantail. Mais ils sont tous là, identifiés, malgré (ou à cause) des boites noires que l’on offre à tout public et aux experts. Le principe de précaution doit alors être activé et le catastrophisme éclairé (Dupuy) doit nous donner le courage de renoncer.
Etant cependant averti du monopole radical qui se met en place avec l’appui démesuré de la finance et des gouvernements du monde entier, il faut sans doute se replier sur l’exigence de pluralisme pour obliger les Etats à prendre les mesures pour préserver une “zone à défendre” en réseau où les développeurs puissent travailler à une innovation responsable, explicite et contrôlable. Cela supposera des écoles, des spécialistes, des soutiens financiers adaptés, des réseaux d’entraide que les communs numériques ont déjà mis sur pied, des chaînes de traitement entièrement préservées des plateformes du capitalisme financier numérique. Le rôle d’un gouvernement démocratique n’est pas de tirer toujours dans le sens d’une innovation sans frein qui absorbe soutiens, déductions fiscales et profits en copiant les autres pays. S’impose à lui un impératif de diversité écologique en faveur des orientations les plus responsables.
Il ne sert à rien de disqualifier ces tendances et ces aspirations qui montent en les assimilant aux luddites, qui ne faisaient pas que casser des machines d’ailleurs et qui luttaient contre un projet politique d’obligation de salariat. Sans doute que si ces techniques des LLM n’étaient pas poussées par les grandes plateformes, les oppositions ne seraient pas aussi franches car il serait encore possible d’espérer un débat de démocratie socio-technique. On sait en revanche désormais qu’avec toutes ces plateformes aucun débat ne sera possible et qu’il faudra des coups de force imprévus à la Trump qui produit le blocage du service d’Anthropic le 12 juin, pour mesurer qu’il est vraiment possible de freiner l’ubris de ces firmes et pour les faire rentrer dans le droit.
L’important consiste à préserver l’avenir pour toute la planète en préservant des ressources, des savoirs et savoir-faire plus autonomes. Les temps de guerre et de réchauffement climatique qui sont les nôtres devraient d’ailleurs nous entrainer à encourager ces démarches résilientes, qui pourraient bien sauver nos existences en cas de crise grave, de sabotages, de pannes. Plus encore, ce sont nos savoirs qui doivent demeurer hors des prédateurs-pollueurs que sont les plateformes d’IA. De la même façon qu’on construit des silos sous la banquise pour préserver les graines d’une diversité biologique menacée, il faut organiser les silos de préservation des savoirs non contaminés, identifiables, traçables, comme le fait Wikipédia, qui devra bientôt devenir une forteresse pour résister à la contamination générale.
Nulle tentative d’imposer ce régime d’abstinence à tous, de prétendre redresser la barre d’un navire sans pilote, mais nécessité politique et morale d’assurer que d’autres possibles seront maintenus ouverts par cette préservation de techniques, de savoirs, de pratiques prêts pour les temps de guerre et de rareté.
Le bac à sable créatif
Cette option du zero LLM qui s’appuie sur les certitudes des connaissances, des pratiques et des organisations constituées depuis des siècles et sur les attachements à des valeurs qui ont constitué nos démocraties, devient désormais très défensive et peu attractive à l’exception des résistants convaincus, qu’il faut soutenir à tout prix cependant.
Elle ne conviendra pas du tout à ceux qui, tout en s’opposant aux plateformes, à leurs logiques financières et à bon nombre de choix techniques effectués, restent persuadés qu’il faut expérimenter des détournements, et explorer des possibles qu’on ne connaît pas encore. Ce constat provient de la puissance incroyable de ces LLM, qui, par pure simulation statistique, parviennent pourtant à produire des effets de sens, des effets de créativité, des effets émergents comme on les qualifie savamment si on ne les balaie pas en les traitant d’hallucinations (ce qu’ils sont aussi par ailleurs). On peut trouver cette tendance chez beaucoup d’artistes qui sont spontanément prêts à explorer ces frontières, comme le font Gregory Chatonsky ou Alain Damasio. Ou chez des chercheurs comme Marc Cavazza qui sont intrigués de voir émerger des processus qu’ils décrivent en sémantique distributionnelle, des convergences qui méritent d’être explorées. Il est vrai que dès lors qu’on connaît l’incertitude et les approximations acceptées par les développeurs de ces LLM, qui ne peuvent pas rendre compte des pondérations effectuées ni de chaînes d’opérations qui ressemblent à des raisonnements, on peut se dire qu’ils ont peut-être fait apparaitre des processus de calcul, de génération, de détection, qui sont des indices d’autres processus que seuls les artistes ou d’autres disciplines que les data sciences peuvent percevoir, sans parler de les expliquer.
J’appelle cette posture et ce quadrant nord-ouest (celui du passage!), le bac à sable créatif. Tout en étant, on l’a compris, très critique des LLM en général et plus encore de leur exploitation par les plateformes de l’IA, je me dois d’écouter ceux qui restent ébahis par les performances de tels systèmes de simulation, au point de penser qu’ils sont en train de dépasser nos capacités de compréhension (sans parler du contrôle que les firmes IA ont de toutes façons abandonnés). Tous les utilisateurs ordinaires font cette expérience d’excitation ou de sidération devant des réponses, des productions, des solutions fournies avec une rapidité inédite et très déstabilisante. L’innovation peut en effet se transformer en rouleau compresseur moderne sous la houlette de l’illimitisme des plateformes et de la classe vectorialiste mais il n’est pas définitivement dit qu’il n’existe pas d’autres voies à explorer.
J’ai moi-même tenté de jouer ce jeu avec le Big Data des plateformes en considérant Twitter comme la drosophile des sciences sociales des propagations. C’est-à-dire un laboratoire à ciel ouvert pour tester des hypothèses à partir de masses de données qu’on ne trouve nulle part ailleurs, sur une plateforme (avant Musk) où la traçabilité atteint une granularité inédite et où la viralité est amplifiée par les algorithmes. Alors même que je montrais les effets délétères d’un tel système de viralité sur les conditions du débat public, je pensais pouvoir profiter de ce terrain quasi expérimental pour tester des hypothèses sur les patterns des propagations. Et cela à condition d’accepter que Twitter ne peut pas servir d’équivalent d’un sondage d’opinion, dispositif construit pendant des dizaines d’années avec ses propres règles et ses limites.
Pour les LLM, ce sont ces limites qu’il faut pouvoir établir pour rester dans le cadre du bac à sable et éviter toute contamination à la société. Ainsi, tout ce qui a pu être produit en matière d’image IA ne poserait pas de problème, dès lors qu’un protocole strict et une étanchéité sont installées vis-à-vis de la sphère médiatique ou ordinaire de la vie sociale. Produire des deepfakes est fascinant à condition de se limiter à une expérience de laboratoire hautement contrôlée, à peu près avec les mêmes critères que ceux appliqués aux laboratoires qui testent les gains de fonction des virus. Oui les LLM sont du gain de fonction, et sont extrêmement dangereux de ce point de vue mais peuvent aussi permettre d’explorer des pistes inédites, à condition de trouver les problèmes significatifs que l’on veut y résoudre. On peut accepter certaines expériences pour les artistes, qui doivent eux-mêmes éviter la contagion de tous les systèmes de production d’œuvres fake qui détruiraient leurs propres conditions d’existence. On peut accepter certaines expériences pour les sciences cognitives et sociales sous des conditions strictes vis-à-vis des populations concernées comme on le fait en sciences cognitives expérimentales. On peut même donner des possibilités de créer des échantillons de populations synthétiques pour tester certaines hypothèses avec des modèles et des entités très riches, à condition de ne pas prétendre en tirer des leçons sur les sociétés réelles ni des méthodes de gouvernement immédiates, ce qu’on attend déjà trop de l’économie expérimentale par exemple.
Sans doute que d’autres domaines professionnels peuvent vouloir eux aussi tester avant leur mise en œuvre opérationnelle quantité d’applications à base d’IA. Ce serait ainsi l’occasion de redonner ses lettres de noblesse à la culture industrielle des tests, dont j’ai critiqué plus haut la disparition avec les passages à l’acte observées dans les développements d’IA contemporains.
Dans tous les cas cependant, il faut assurer une étanchéité avec le monde social à l’air libre pour éviter toute pollution et captation d’attention par des utilisateurs ordinaires comme par des acteurs mal intentionnés, qui auraient perçu rapidement les bénéfices commerciaux à tirer de ces innovations. Le bac à sable est donc à la fois l’acceptation de la créativité et le ralentissement de sa pénétration du corps social. Toutes les techniques ultrasensibles et à haute propagation sont gérées de cette façon, que ce soit dans la chimie, la pharmacie, ou le nucléaire. Ce que l’on déplore, c’est plus souvent une incapacité à contrôler ces essais et les tentatives de se dérober à ces protocoles de sécurité.
Pour l’IA, le moins que l’on puisse faire n’est donc pas d’abaisser le seuil de vigilance mais bien de le renforcer car ses pratiques actuelles sont totalement irresponsables. On pourrait donc au moins exiger des plateformes d’iA qu’elles atteignent le niveau d’exigence en matière de sécurité et de qualité que l’on trouve dans le nucléaire, voire dans la chimie (qui comporte pourtant déjà beaucoup de failles) ou dans la biologie. Tout plaidoyer pour une expérimentation à ciel ouvert au nom du « running code » et de la spécificité du numérique est une opération de lobbying éhontée et irresponsable. Dès lors qu’on leur propose d’effectuer toutes les expériences qu’ils souhaitent dans des environnements classifiés au même niveau que les laboratoires de gain de fonction des virus, on fournit les conditions de la créativité tout en respectant des impératifs de contrôle, certes très inhabituels pour les adeptes du libertarianisme, de John Perry Barlow et du Far-West réunis mais nécessaires à leur propre survie et à leur créativité.
L’intelligence collective augmentée
Dès lors que ces deux possibles sont préservés, soutenus et contrôlés, la sécession sémantique et le bac à sable créatif, pourquoi encore vouloir imaginer un quatrième quadrant au nord-est ? En réalité, il décrit la pratique la plus courante observée dans les organisations. Face à la pression à l’usage de l’IA générative et face à l’absence de résultats convaincants dans l’industrie (en dehors donc de la comm et du code), la désorientation est forte mais chacun apprend à composer avec les injonctions, les avantages réels et un contrôle face à des boites noires. Ce compositionnisme que Bruno Latour avait problématisé dans un manifeste n’est guère attractif comme programme politique général mais il rend très bien compte des pratiques des collectifs immergés de fait dans des environnements d’IA générative.
Ce qui devient clé alors pour éviter d’être totalement embarqué dans l’hubris du tout IA, c’est la qualité du couplage entre technique et organisation, son caractère explicite et donc discutable de façon contradictoire. Ce n’est certes pas la qualité principale du management néo-libéral que l’on subit et qui relève plus de la disruption quasi sadique que de la bienveillance et du soin pour relancer l’intelligence collective. L‘intelligence collective augmentée doit en effet devenir l’horizon de toute composition avec des éléments de systèmes d’IA appropriés. Ce couplage affiné avec précaution avec les traditions, les valeurs, les savoir-faire spécifiques des métiers permet de réencastrer les systèmes d’IA dans les organisations, dans le social en général. L’IA ne devient une réponse qu’aux problèmes que l’on veut traiter en priorité et que l’on redéfinit à cette occasion mais elle ne constitue qu’une brique d’une réponse globale et non la solution magique de l’alchimie LLM. Reprendre la main sur ces définitions des problèmes, c’est reconnaitre aussi les liens complexes de toute organisation sociale et son irréduction à un paramétrage surplombant. Cela peut comporter cependant des indicateurs et du calcul mais un calcul qui oblige à expliciter et donc à discuter et qui permet à toutes les parties concernées de participer à la discussion.
Sur ces principes, il existe des solutions qu’on appelle hybrides c’est-à-dire qui introduisent beaucoup de sémantique par les experts métiers et même les publics concernés et qui reposent de ce fait sur des briques issues de l’IA symbolique (toujours très présente avec des arbres de décisions par exemple) ou avec des versions floues comme le propose Xtractis développé par Zyed Zalila. Ces systèmes d’IA nécessitent une injection de connaissances formalisées de la part des experts du métier et c’est en cela que ces IA décisionnelles peuvent prétendre aider à des décisions fiables, ce que ne pourra jamais un agent conversationnel conçu pour répondre avec des approximations satisfaisantes pour l’utilisateur mais non robustes. Ce que j’ai décrit plus haut à propos des RAG relève de ces méthodes de maquillage sémantique indispensable pour faire marcher les LLM en situation réelle, mais on peut pousser la logique des RAG plus loin en formalisant les documents et les connaissances ainsi injectées, en abandonnant carrément le principe probabiliste des LLM.
D’autres resteront plus proches des principes des LLM mais en fournissant tous les outils de contrôle pour les rendre robustes, comme le fait par exemple Pleias, dirigée par Pierre-Carl Langlais. Il a pu mettre ainsi à disposition du public et en Open Source une base de connaissances de textes administratifs qui se transforme en outil de génération de contenus situés dans le même domaine (Guillaume Tell). Dans tous les cas, ces modèles sont plus petits, plus contrôlés avec injection de lemmatisation souvent (et non une simple tokenisation).
D’autres enfin tentent de penser le rôle direct que peut jouer le service public dans un tel environnement. Bernie Sanders propose que l’Etat prennent des parts dans les grandes entreprises de l’IA jusqu’à 50% pour pouvoir les orienter et les contrôler autrement que par la régulation qui vient toujours trop tard. Bruce Schneier comprend l’intérêt de la proposition de Sanders mais considère que cela veut dire que l’Etat se retrouvera contraint d’accompagner des stratégies gouvernées par la profitabilité sans pouvoir réellement exiger les garde-fous nécessaires, comme on l’a vu avec la propriété étatique des firmes pétrolières en Norvège. Il propose avec Nathan Sanders, en plus d’une taxation des profits ou de l’énergie consommée par ces firmes, de construire dans chaque pays une « AI Public Option » , à l’image du système de santé public ou du projet Apertus en Suisse. Les chercheurs académiques à partir de données dont ils respectent les licences ont développé un modèle LLM qui fonctionne sur une infrastructure locale suisse. Mais ce n’est pas l’enjeu de souveraineté qui est ici avancé car il peut être détourné par des firmes nationales comme on le voit avec Mistral, sans que cela change grand-chose à leur absence d’éthique et à leurs principes techniques. Il s’agit bien d’une alternative publique de ressources de base, sur lesquelles on peut imaginer des services gratuits d’origine des communs mais aussi des services commerciaux locaux dont l’usage est identifié comme socialement utile (ce qui interdirait les IA compagnons toxiques et les deepfakes par exemple).
En réalité chacun tente de surnager dans ce flux d’influences qui se propagent chaque matin avec de nouvelles annonces qui nous somment de réagir et dire si l’on adopte, si l’on s’oppose ou si l’on compose. Le drame social qui se joue dans les organisations est aggravé par l’isolement, l’expérience clandestine de l’IA dans l’ombre, de l’IA honteuse, alors que l’intelligence collective demande le partage des expériences, les plus naïves comme les plus sophistiquées. Nous manquons de cette arène de débat constitutive d’une démocratie socio-technique. Non pas pour se vanter comme sur LinkedIn de sa dernière prouesse dans la maitrise de la dernière version du modèle XYZ. Mais pour rendre compte précisément des conditions d’usage d’un dispositif technique et organisationnel (et donc aussi légal et commercial souvent) avec toutes les réinventions nécessaires, les ratages et aussi les émerveillements engendrés par ces partages d’expérience.
J’ai pratiqué longtemps cela notamment dans le domaine de la Tech éducative ou encore des méthodes numériques en sciences sociales, sans jamais céder aux diktats des offres marchandes et en fixant avec les collectifs concernés les cahiers de charges auxquels les techniques sur l’étagère ou les développeurs maisons devaient se plier. Les réseaux des communs procèdent ainsi très souvent et ils doivent désormais intégrer tous les retours d’expérience de pratiques de l’IA hybride en environnements standards (et non seulement dans des niches alternatives). Les organisations, l’Etat, les institutions, les entreprises sont en demande pour continuer à respirer malgré la pression démesurée mise par les lobbys de la tech pour la tech.
Ainsi, face au rouleau compresseur du monopole radical qui est en train de s’installer, plusieurs modes de survie sont possibles que j’ai présentés dans cette boussole. Sans doute d’autres inventeront d’autres combinaisons encore, mais l’intelligence collective que nous devons construire nécessite sans cesse d’échanger et de capitaliser sur nos expériences.
Dans un texte critique riche, ample et pertinent, le sociologue Dominique Boullier, ancien coordonnateur scientifique du Médialab de Sciences Po, revient sur les enjeux de l’IA générative. L’auteur de Propagations. Un nouveau paradigme pour les sciences sociales (Armand Colin, 2023) et de Déshumanités numériques (Armand Colin, 2025) ne mâche pas ses mots pour décrire comment l’IA transforme notre rapport au monde. Tribune.
On croit encore souvent que la meilleure innovation gagne toujours.
Dans un texte critique riche, ample et pertinent, le sociologue Dominique Boullier, ancien coordonnateur scientifique du Médialab de Sciences Po, revient sur les enjeux de l’IA générative. L’auteur de Propagations. Un nouveau paradigme pour les sciences sociales (Armand Colin, 2023) et de Déshumanités numériques (Armand Colin, 2025) ne mâche pas ses mots pour décrire comment l’IA transforme notre rapport au monde. Tribune.
On croit encore souvent que la meilleure innovation gagne toujours. Dans de nombreux cas comme dans celui des LLM, c’est le contraire : la pire des IA est en train de gagner au point de s’imposer comme monopole radical au sens d’Illich. Monopole radical pour la classe vectorialiste dans la génération de code avec l’apparition de Claude Code, monopole radical pour le grand public dans les interactions à travers la diffusion des IA compagnons. Entre les deux, les usages professionnels restent toujours aussi incertains et ne fonctionnent qu’à la condition d’y injecter suffisamment de sémantique et de contrôle expert pour éviter des catastrophes industrielles.
Reconnaissons-le : toute expérience ordinaire d’interaction avec une IA générative se révèle toujours impressionnante et, lorsque les compétences augmentent, des outils encore plus bluffants sont désormais à disposition, comme l’ont expérimenté tous les utilisateurs de Open Claw, agrégateur d’agents. Et pourtant, dès que l’on veut réellement prendre en main ces outils, contrôler leurs opérations, les vérifier ou valider leurs résultats, les mêmes utilisateurs se retrouvent déçus, inquiets voire en colère, à moins d’adopter une tolérance inusitée dans l’univers des produits et services de ce type. [Précisons d’emblée que je n’évoquerai pas ici les éventuelles craintes à propos d’un futur d’IA générale souvent fantasmé mais seulement les constats issus des pratiques ordinaires.]
Ni science, ni industrie, ni éthique mais de l’ingénierie, de la finance et du buzz
Je résumerais cette ambivalence de cette façon, en termes d’éthos ou de posture : si l’on possède une culture, des principes et exigences à la fois scientifiques, industrielles et éthiques, on ne peut qu’être inquiet de voir l’emballement en faveur de ces IA fondées sur les LLM. A l’inverse, si l’on est fasciné par l’ingénierie, les performances financières et si l’on vit dans le monde du buzz permanent, l’IA produit une excitation inédite et sans cesse renouvelée malgré ou à cause des incertitudes qu’elle emporte avec elle.
Et l’on peut systématiser cette opposition terme à terme : science vs ingénierie, industrie vs finance, éthique vs buzz pour mesurer à quel point nous sommes en train de bifurquer, collectivement certes mais sous la houlette de quelques très grandes plateformes technologiques. L’époque moderne s’est caractérisée par la puissance d’une alliance entre science et industrie en y ajoutant depuis la seconde guerre mondiale, un contrôle moral progressif des finalités et des méthodes (la révision écologique principalement). Mais les LLM sortent totalement de cette trajectoire au profit d’un saut postmoderne radical fondé sur leur ingénierie toute-puissante, leur attractivité financière sans limites et leur capacité à générer du buzz, de l’alerte et de l’incertitude permanente.
On pourrait pourtant parier avec Yann Le Cun que ces LLM sont des impasses conceptuelles. On pourrait aussi considérer avec la plupart des grandes entreprises industrielles que les LLM n’offrent pas de fiabilité suffisante, ce qui explique leur adoption très réservée dans les process critiques notamment. On pourrait aussi soutenir avec quelques fondateurs du deep learning (Hinton, Bengio) que l’on risque trop de perdre le contrôle pour laisser se développer une telle technologie. Et pourtant, malgré toutes ces réserves, que je vais documenter et soutenir, ce sont bien ces LLM qui sont en train de former l’architecture technique d’un nouveau mode de production.
Quand les pires technologies sont pourtant les gagnantes
Car, rappelons-le , après des décennies de travaux sur les dynamiques de l’innovation, il est rare que la meilleure technologie gagne. Songeons au clavier Qwerty, cette machine de guerre ergonomique, encore présente dans nos PC, et même sur des smartphones tactiles. 150 ans de résistance à toute transformation malgré les tentatives nombreuses (cf. Dvorak) pour améliorer un système aussi nocif pour les muscles et aussi coûteux à apprendre. Sur ce plan d’ailleurs, les interfaces conversationnelles sont à elles seules une révolution durable qui va modifier la relation ordinaire à la technologie des systèmes d’information, plus encore que ne l’avait fait le Wysiwyg de la fin des années 70 qui a permis le Personal Computer.
De même, la domination de Windows sur tous les systèmes d’exploitation des PC (72% du marché) est le contre-exemple type opposable à l’argument selon lequel « le meilleur gagne ». Tout le monde le reconnaît, Windows a copié Apple (lui-même issu de Xerox) pour l’apparence de son interface, tout en reposant sur son système d’exploitation MS-DOS catastrophique en matière de fiabilité, de sécurité et de performances. Et pourtant, Microsoft l’a imposé au monde entier, grâce à des patchs successifs mais surtout grâce un marketing devenu un cas de figure canonique du « lock-in » (Shapiro et Varian), ce verrouillage d’une clientèle dans un système total. Dans le même temps, Linux (1991) est devenu incontournable pour tous les systèmes techniques critiques ou pour ceux qui exigent une véritable fiabilité mais c’est seulement en 2026 que le gouvernement français fait le choix d’abandonner Windows pour Linux pour les postes de travail de l’administration.
Un processus analogue se déroule ainsi sous nos yeux qui voit une innovation très approximative gagner des parts de marché et créer des habitudes d’usage quasi irréversibles. Les critiques pleuvent sur les systèmes d’IA génératives, sur leurs hallucinations d’abord, sur leurs consommations d’énergie ensuite, sur la collecte de leurs sources, sur leurs principes formels même, et cela sans parler des pratiques de certaines des firmes que j’ai qualifiées ailleurs de voyous (Open AI et X/ Grok) (Boullier, 3 février 2026 , AOC). Mais rien n’y fait, l’IA pénètre dans tous les interstices de la vie ordinaire plus vite que dans la vie professionnelle même, grâce à cette innovation horizontale, imitative, sans barrière d’accès (dont la gratuité, qui constitue un coup de force très convaincant pour les adopteurs). Quitte à avoir la pratique de l’IA honteuse, dans ce qu’on appelle la shadow AI, ces pratiques non déclarées au travail (Ferguson), dans les écoles ou à la maison. Processus d’innovation technique assez rare dans les organisations (Gaglio) qui ont souvent pratiqué plutôt le top-down en devant se battre plus contre les « résistances » des personnels que contre leur enthousiasme débridé et leur volonté de tout tester « pour voir » et finalement pour adopter.
L’heure du bilan n’a cependant pas sonné car tous les ans à peu près une nouvelle version ou couche d’innovation rebat les cartes, au point même de disqualifier les savoir-faire acquis, qu’on avait annoncé comme décisifs pour l’avenir (savoir prompter). Les agents sont déjà là, des systèmes comme Open Claw, même s’il est bridé désormais par Claude, permettent d’organiser des batteries d’agents en parallèle pour réaliser quantité de tâches ou de séquences de tâches, le vibe coding est mis à la disposition de tous, la production de vidéos (dont les deep fakes) est désormais opérationnelle pour des utilisateurs ordinaires. La seule limite constatée pour un certain niveau de performance reposait sur la compétition féroce pour les puces GPU de NVidia qui elles-mêmes changent de version souvent, mais désormais Google et Deep Seek utilisent leurs propres processeurs (TPU notamment) conçus spécialement pour leurs IA. Dans cette effervescence, la question du coût était restée jusqu’ici ignorée comme toujours avec la méthode classique du dealer de techno qui amorce les usages en offrant la gratuité, mais le coût des abonnements à ces services commence à augmenter sérieusement selon le nombre de tokens traités. Au point que l’optimisation de l’usage des tokens fait désormais partie des services de Anthropic, sous forme de « adaptative thinking », terme inadapté mais significatif de l’emphase qui caractérise ces firmes.
Disons-le franchement : j’espère quand même que cette hubris financière et technologique va conduire à une crise majeure, répétant la crise financière de 2008 car c’est sans doute la seule chance de rebattre les cartes et de rouvrir les possibles. Mais il faudra alors posséder cette boussole que je propose pour s’orienter radicalement différemment dans nos choix socio-techniques. A condition qu’il existe encore un espace politique démocratique pour passer à une « démocratie socio-technique » (Lascoumes, Callon, Barthe, 2001) pour inventer un autre avenir. Or, la domination des plateformes d’IA se fait désormais à l’échelle mondiale (Chine et USA) en étroite collaboration avec les régimes les plus autoritaires prêts à favoriser leurs monopoles en échange de services de surveillance omniprésents.
Au-delà des monopoles des plateformes IA, nous devons plus encore nous inquiéter d’un « monopole radical » de l’IA générative et des LLM sur les connaissances, pour utiliser les concepts d’Ivan Illich. Toute son analyse de la mobilité et de l’énergie (Energie et équité, 1975) montrait comment l’industrie pétrolière avait installé un monopole radical de l’automobile supposée solution unique pour traiter nos demandes de mobilité. Alors même que le calcul de la vitesse généralisée (Dupuy, Robert) montrait qu’en intégrant tous les coûts de production et d’utilisation d’une voiture, sa performance en termes de vitesse devenait inférieure à celle d’un vélo. J’expliquerai dans un livre à venir pourquoi la comparaison des LLM avec le coup de force du moteur à explosion et de l’automobile est la plus pertinente en matière de monopole radical, entraînant toutes les dérives sociales, urbaines et environnementales que l’on connaît. C’est pourtant l’avenir qui nous attend dès lors qu’on laisse les entreprises d’IA le façonner pour nous.
Reprenons chacun des dyptiques proposés pour comprendre comment une ambivalence attraction/répulsion finit pourtant par engendrer ce monopole radical.
1/ Absence de science mais ingénierie géniale
J’ai conscience de surprendre ainsi beaucoup de chercheurs qui travaillent sur l’IA et sur certains principes qui ont guidé tout ce courant de recherche, souvent fondé sur des mathématiques de haut niveau. Certains n’accepteront pas de voir disqualifier leurs prétentions scientifiques. Précisons que ce n’est pas parce qu’on dispose de disciplines, de revues et de postes académiques qu’on fait de la science (nous autres chercheurs en sciences humaines et sociales sommes quotidiennement disqualifiés pour cela précisément). L’ingénierie est une activité très noble qui mobilise des rapports parfois étroits avec la science, de même que la médecine, mais ni l’une ni l’autre ne sont des sciences mais plutôt des sciences appliquées, dit-on parfois, et surtout des arts. Le soin est un art plus qu’une science malgré toutes les tentatives de « evidence-based medecine » qui autoriserait les transferts de décision à des systèmes d’IA, au prix d’une ignorance de ce que la relation de soin et la maladie possèdent de multidimensionnel. L’ingénierie, de ce point de vue, peut être géniale et on ne le contestera pas, depuis Léonard de Vinci au moins ! Mais c’est son art de l’assemblage de connaissances, plus ou moins modélisées, dans la résolution d’un problème opérationnel qui produit l’émerveillement. Il faut que ça marche, voilà l’impératif. Or, les observations in situ sur le travail des ingénieurs, comme celles effectuées par les STS et tout le courant de l’ANT (théorie de l’acteur-réseau, Vinck), ont bien montré que quantité de décisions opérationnelles relèvent du pari, de l’opportunité et surtout du tissage d’un réseau multidimensionnel pouvant mobiliser des compétences et des ressources extrêmement diverses. C’est le cas avec les LLM et avec l’IA générative.
Quand l’absence de théorie du langage est productive pour l’ingénierie
En effet, zéro science dans ces IA et on pourrait même dire que c’est grâce à cela que ça marche. C’est ce que disait ce CEO d’une firme de NLP (traitement automatique du langage naturel) il y a plus de quinze ans qui affirmait avec provocation que les performances de ses modèles s’amélioraient à chaque fois qu’il virait un linguiste. Et en effet, les LLM n’ont aucune théorie du langage et se débrouillent très bien pour éviter d’en avoir une, puisqu’ils reposent sur une tokenisation et une vectorisation de tout le matériel linguistique, qui n’a strictement rien à voir avec une analyse du langage, structurale ou même générative à la Chomsky. Le texte fondateur des « Transformers » publié par Google en 2017, l’annonçait d’ailleurs explicitement : « All you need is attention ». Ce qui veut dire en clair que dès lors que l’on veut détecter des patterns, des régularités dans des corpus linguistiques pour prédire les segments suivants, tout ce qui compte c’est la fenêtre de mémoire disponible au moment de l’entraînement sur des corpus par ailleurs toujours plus énormes, de façon à réduire les erreurs. Pas de théorie, pas de concepts, seulement un exploit technique réductionniste à l’extrême et pour cette raison très opérationnel, qui permet de traiter tout token dans un espace latent vectorisé pour pondérer ses probabilités de combinaison et donc d’apparition dans un « contexte » toujours plus grand, cette fenêtre d’attention. Evidemment, l’astuce technique, élémentariste comme toute l’informatique depuis Turing, nécessite des capacités de calcul rarement disponibles, surtout dans un laboratoire académique, et des capacités de collecte de données d’entraînement qui s’affranchissent des règles académiques de sourcing ou de droits d’auteurs (nous verrons cela plus loin dans le chapitre moral).
Cependant, reconnaissons que les résultats de cette simulation de production linguistique à partir de ces matériaux et de ces « astuces » techniques sont prodigieux pour un observateur neutre ou même critique. J’ai moi-même, il y a bien longtemps, développé des chatbots et des méthodes d’ingénierie linguistique en milieu industriel puis académique et la performance ne m’échappe pas. Mais je sais aussi par expérience, tout ce qui a été nécessaire de bricolage, de patch, de tâches aveugles, et de risques pris pour faire tenir un système technique après quantité d’arbitrage faits souvent à la volée et sans justification et sans vérification possible de leurs conséquences sur tout le système. Expliciter tout cela serait considéré comme indécent pour un utilisateur lambda dont on veut par ailleurs faire un utilisateur convaincu et capté dès la première requête puisque l’adoption fonctionne désormais dans l’instant (et non à la décision éclairée).
La boite noire n’est jamais acceptable dans une visée scientifique
Pourtant, cet effet boîte noire reste totalement antinomique avec des exigences scientifiques. Car adopter une visée scientifique (Gagnepain), c’est s’obliger à contester méthodiquement ses propres énoncés pour les vérifier, les discuter dans une communauté de pairs, ce qui suppose de les publier pour pouvoir les répliquer et ensuite les réviser. La chaîne de la référence (Latour) est très longue et doit être explicite. Ce qui n’a rien à voir avec les méthodes de production de l’IA générative qui fonctionne aux résultats simulés et produits en toute opacité. On se trouve alors plus proche de la visée mythique qui doit nous faire croire aux résultats par une simulation merveilleuse et ces IA génératives produisent en effet des merveilles.
Et lorsque les LLM se soumettent à une vérification, c’est à travers des benchmarks et non des expériences réplicables qui permettraient de suivre toutes les pondérations faites automatiquement, ou les méthodes d’apprentissage supervisé et de constitution d’une ground truth (« vérité de terrain », Jaton), qui posent tant de problèmes éthiques occultés. Aucun process explicite donc, contrairement au mouvement existant depuis plus de dix ans d’ « explainable AI » car depuis l’IA connexionniste, dans sa version réseaux de neurones puis deep learning, on sait qu’il n’est plus possible de vérifier tous ces processus, même quand on en est le concepteur. La démarche scientifique ne peut en aucun cas se satisfaire de ces boîtes noires puisque toute la construction des énoncés qui font science a reposé depuis des siècles sur des communications de protocoles et de résultats permettant une éventuelle réplication. Exigence qui se perd, il est vrai, même dans les sciences dures soumises elles aussi au culte du « résultat-positif-à-diffuser » pour améliorer ses scores de publication. On peut se dire alors que le ver était dans le fruit, et que tous les impératifs de publication délirants désormais exigés par les politiques publiques de recherche n’ont pas attendu l’IA pour dégénérer.
L’espace latent probabiliste ne peut pas produire une ontologie
Plus spécifiquement il faut noter la déstructuration délibérée de toute l’articulation du langage, de cette combinatoire analytique de son et de sens, productrice d’un potentiel infini d’expressions. Avec les LLM, il ne s’agit plus que de découpages de matériel langagier écrit optimisés pour leur calculabilité : tout peut devenir token, jusqu’à des signes de ponctuation, sans rapport avec le sens ni avec l’expression orale par ailleurs. Les relations ou vecteurs ne sont plus structurées (pas de lexique, de champ sémantique, de lemmes, de phonèmes, etc… tous articulés entre eux) mais seulement pondérées par leur fréquence d’apparition commune dans un corpus donné.
Sur ce plan, il faut veiller à ne pas confondre l’ingénierie linguistique qui était réalisée au temps du Machine Learning. Si l’objectif de calculer les distances entre entités linguistiques d’un corpus peut sembler voisin de ce qui est actuellement pratiqué par les LLM, ce serait oublier la torsion complète de ces principes par les LLM. Car à cette époque, les entités calculées étaient encore des lemmes, issus d’une racine qu’on pouvait organiser en relations sémantiques via des flexions, syntagmes et variations de tous types, au-delà des simples cooccurrences dans un même environnement. Les corpus étaient eux-mêmes limités car thématiques, présélectionnés ou identifiables par leurs origines. Désormais on parle de tokens qui décomposent tout matériel graphique (et non verbal) en élément dont on va estimer la fréquence d’apparition dans un corpus infini, non indexé ni identifiable (effet boite noire). Un token n’a plus besoin de relation sémantique avec son environnement, seulement sa co-occurrence statistique suffit à produire un vecteur qui sera pondéré (et désormais non révisable puisque tout se passe dans l’opacité la plus totale).
C’est ici qu’une coupure avec la sémantique s’est introduite définitivement dans la méthode même de décomposition par token et de vectorisation. Le coup de force des LLM tient au fait qu’ils prétendent traiter toute une langue, grâce à une collecte d’un corpus infini, ce que leur permet en effet leur prédation systématique de tous les contenus disponibles. Tout ce traitement s’effectue dans une langue donnée, qu’on doit ensuite traduire dans d’autres langues qui n’auraient pas les corpus suffisants, d’où d’autres distorsions introduites dans ce corpus supposé universel.
La puissance statistique de ces probabilités reposant sur des corpus toujours plus vastes leur permet de simuler en effet des effets de langue très plausibles et de masquer totalement leur absence totale de sémantique, de référence au monde perçu, et d’attributions de valeur systémique aux relations/vecteurs calculés. Il s’agit bien d’un artifice d’ingénierie tout-à-fait prodigieux dans ses résultats, même s’il a la particularité d’être totalement incontrôlable ou inauditable dès lors que l’espace latent où tout se calcule n’a plus aucune relation avec le sens et combine tellement de dimensions que personne ne peut plus rendre compte des pondérations effectuées (the curse of dimensionality, Bellman, 1957). L’opacité du système est le prix à payer pour sa performance.
Le maquillage sémantique indispensable pour sauver le soldat LLM à tout prix
Cependant, ses faiblesses structurelles d’accès au sens engendrent tant d’erreurs qu’il faut là encore mobiliser des correctifs sans cesse plus ingénieux mais qui demeurent des expédients. C’est ce que l’on a nommé au début des LLM des « hallucinations », en fait des erreurs, des inventions de toutes pièces et sans aucun sens, présentées de plus sans aucune précaution sur les limites du système et sur le principe même des probabilités. L’obligation de réponse à tout prix, qui n’a rien à voir avec une exigence scientifique ni avec une garantie industrielle (voir chapitre suivant), relève en fait de la promesse commerciale et de la captation de dépendance d’un public sans aucun recul critique.
Pour réduire ces effets pervers – mais en fait constitutifs même des choix techniques d’ingénierie effectués contre toute exigence scientifique -, un certain nombre de méthodes sont employées pour réintroduire par la bande de la sémantique que l’on a exclue au départ pour optimiser la vectorisation généralisée des contenus d’entraînement. Ainsi, tout le travail d’annotation réalisé par les travailleurs du clic et les petites mains des plateformes (Casilli, 2019) sert avant tout à cela : produire une supervision de départ qui ne dit pas son nom mais qui permet de générer une ground truth qui limitera les dégâts, ce que Mechanical Turk d’Amazon offre comme service par exemple. C’est pourquoi le travail précaire et sous-payé de tout ce nouveau prolétariat des pays du sud, plus proche du péonage que du salariat (Moulier-Boutang), ne peut être occulté comme fondation sémantique des systèmes d’IA génératives. Certes, les modèles auto-apprennent ensuite, mais un contrôle reste nécessaire pour éviter de voir la qualité se dégrader de façon trop visible. Aucune science dans cette affaire, seulement la reconnaissance par l’ingénierie des patchs nécessaires pour corriger les défauts des choix initiaux. En l’occurrence, « attention is NOT all you need », il faut aussi celle d’humains enchainés à leurs écrans et à leurs micro tâches qu’on ne saurait montrer ni reconnaître.
De même, en raison de la spécificité sémantique de la plupart des domaines professionnels, avec ces LLM, il reste quasiment impossible d’assister correctement des processus de décision ou de création de contenus lorsque les documents sources sont noyés dans le corpus général des modèles centralisés. Il faut réintroduire du « contexte » dit-on parfois de façon erronée alors qu’il s’agit en fait de réintroduire du sens, articulé en sémantique, avec des termes spécifiques organisés en ontologies comme on le fait toujours avec l’IA symbolique. Tout process industriel qui ne se fonderait pas sur ces bases robustes courrait à la catastrophe.
Patches en tous genres : RAG, Chains of Thought, MCP
Mais là encore, l’ingénierie des firmes de l’IA se débrouille pour vanter l’intervention des experts du domaine sur des modèles réduits de LLM que seront les RAG (Retrieval Augmented Generation). Les experts d’un domaine injectent leurs contenus contrôlés, validés et pertinents pour leur secteur dans les données d’apprentissage du modèle général ou dans une version plus locale et restreinte, et réduisent ainsi considérablement les risques de non-pertinence ou d’erreurs. On entraîne ainsi le modèle sur des corpus de documents administratifs ou techniques issus de l’entreprise ou de l’administration et on s’assure ainsi qu’il effectuera les tâches demandées avec plus de fiabilité. Comme on le voit, il s’agit là encore d’une astuce d’ingénierie qui ne corrige en rien les défauts structurels des LLM mais qui réduit leur impact dès lors qu’il existe des experts capables d’alimenter les corpus d’apprentissage en contenu contrôlé. Il faut donc à nouveau des humains qui réintroduisent de la sémantique pour obtenir des résultats fiables. Pourtant, tout cela est présenté comme un additif normal et ingénieux aux LLM et non comme reconnaissance d’une faille constitutive de leur architecture stupidement probabiliste.
Un autre patch consiste à équiper ces systèmes d’IA générative à base de LLM de « chaînes de pensée » (Chain of Thought) leur permettant de construire un raisonnement en décomposant un problème en séquences. Le terme de « pensée » peut être trompeur car il ne s’agit que d’étendre les capacités élémentaires de tout système informatique à décomposer en procédures et en séquence opérationnelle toute résolution de problèmes, ce qui est au fond à la base de toute compétence technique. Fournir cette capacité n’a rien d’un raisonnement. Alors qu’il existe des systèmes d’IA effectivement raisonnante, mais de type symbolique et totalement explicable, comme Xtractis, produit par Intellitech (Zalila). Dans ce cas, toutes les pondérations et décisions sont traçables car elles sont fondées sur de solides armatures logiques que toutes les IA symboliques mobilisent depuis des décennies.
Dernier épisode en date de la même opération de sauvetage des systèmes d’IA génératives asémantiques : le passage à l’IA agentique, capable d’effectuer des tâches de commande, de gestion, faites de séquences complexes et adaptées aux infinies variations du monde réel. On comprend bien le défi. Des systèmes automatisés, ne disposant d’aucune représentation significative du monde mais seulement d’une capacité infinie de pondération des vecteurs linguistiques pour engendrer des prédictions, se trouveront en difficulté face à la complexité du monde réel, et aux ambiguïtés sans fin de toute langue et de toute situation. Une astuce supplémentaire de l’ingénierie des entreprises d’IA permet de simuler une réduction de ces aléas. On dispose désormais en effet d’un protocole pour harmoniser la description du monde : serait- ce une ontologie ? Certes non, seulement une simulation limitée au monde des interactions entre machines : le MCP, Model Context Protocol, se contente de standardiser les API que devront utiliser les systèmes d’IA pour devenir vraiment des agents « dans le monde », en fait des agents bien limités au monde des systèmes d’information normalisés pour devenir interopérables par des IA agentiques. Une nouvelle fois, la question du rapport au monde, de la sémantique nécessaire pour en construire la représentation est évacuée par une opération d’ingénierie. Cela permet cependant de construire ainsi un début de standardisation du secteur, ce qui est industriellement non négligeable.
Mais il en sera autrement dans les secteurs industriels critiques comme nous le verrons. Lorsqu’on voit que Palantir, dans sa fourniture de systèmes de décisions de frappes militaires létales, présente explicitement la couche d’ontologies qu’elle ajoute aux LLM qu’elle utilise, en parlant d’une nomenclature pré-encodée (c’est-à-dire contrôlée et validée par les humains selon un schéma cohérent sémantiquement), on comprend mieux ce qui se déroule et se déroulera dans les autres industries, qui ont des exigences encore plus sévères que dans les industries de défense dont la précision n’est pas l’impératif prioritaire, comme on l’a constaté récemment. Les benchmarks récents pour tester ces systèmes d’agents ont cependant produit des résultats très inquiétants quant à leur fiabilité et à leur sécurité (Shapira et al., 2026).
La mutation du mode de production du code, étape essentielle vers le monopole radical
Il faut cependant admettre que les limites asémantiques des LLM ont été particulièrement bien exploitées pour la production du code informatique. Ce qui peut se comprendre aisément, puisque précisément le code n’est pas le langage ni la langue et que son univocité le rend opérationnel sans risque de contre-sens comme on dit, puisqu’il ne s’agit plus de sens mais de commande pour l’action. Cette réduction du langage des propositions logiques au code du programme fut la force du pari initial de Turing (Lassègue et Longo, 2025) qui continue d’être exploité. La production de code entraîne pourtant des erreurs nombreuses variables selon les systèmes d’IA mais désormais bien réduites avec l’avancée apportée par Claude Code. On mesure alors la productivité potentielle d’une telle performance d’ingénierie puisque ces systèmes peuvent générer du code pour générer du code pour générer du code, à plusieurs niveaux. Cela a entraîné la fascination des milieux des développeurs pour Open Claw qui génère, lui, des agents organisés en système dans des délais d’une rapidité inouïe par rapport aux tâches séquentielles précédentes.
C’est ainsi dans ce domaine du code que les LLM sont en train de modifier le mode de production informatique en général et de ce fait d’un grand nombre de process industriels. De l’autre côté, pour le grand public, c’est la mutation des compagnons à travers des interfaces conversationnelles performantes qui est en train de s’installer comme routine ou comme évidence dans la vie quotidienne. Notre mode de production des interactions quotidiennes va s’en trouver clairement affecté radicalement. Le problème, dans les deux cas, industrie ou interaction, tient à l’absence totale de traçabilité et d’explicabilité de tous ces systèmes, si performants et si opaques à la fois. Les erreurs, bugs ou hallucinations sont inévitables et l’expertise pour les détecter aura tendance à se raréfier puisque seules des IA pourront éventuellement réauditer de telles boîtes noires. Et lorsqu’on se réjouit de voir que Claude a détecté avec Mythos des bugs jusqu’ici ignorés qui sont en fait de vraies failles de sécurité, on accepte d’ignorer que l’on ne sait pas si ces failles étaient vraiment critiques (d’où le peu d’intérêt pour les détecter avant), quelle est la proportion de bugs existants non détectés par l’IA (par définition !), et si l’IA ne détectera pas de faux bugs (faux positifs) que personne ne saurait contredire (Schneier, 2026). Il faut donc accepter les miracles et continuer à avancer à l’aveugle.
Mais plus on s’oriente vers cette transformation en profondeur du mode de production, plus cela tend à réduire les LLM à des systèmes d’exploitation, dont nous ne connaissons toujours pas les applications adaptées à DES environnements toujours spécifiques. Or, dès qu’on veut implémenter une application robuste dans le vrai monde, il faut y rajouter une couche sémantique. Certains plaidaient depuis longtemps pour cette hybridation symbolique/ génératif mais le débat porte rarement explicitement sur cela : on se contente de patchs sémantiques ( et donc à base d’IA symbolique) dès qu’on veut installer des process fiables. Nous pourrions donc évoluer ainsi vers un équivalent de MS-DOS. On interagit avec un Windows qui est en fait une copie de Mac OS, pertinente et conviviale, mais toujours plaquée sur un OS antique et inadapté, ce qui a duré pendant 40 ans environ. Par analogie, nous accepterions donc les défauts intrinsèques de ces LLM en acceptant de les corriger sans cesse, de les camoufler pour éviter d’interroger la nullité scientifique des LLM. Alors qu’il serait possible de concevoir dès maintenant une IA hybride dans son cœur même, en s’appuyant sur les IA symboliques raisonnantes déjà disponibles pour leur ajouter quand c’est nécessaire les capacités génératives issues des méthodes des LLM. Mais tout cela sans développer toute l’usine à gaz énorme que sont les data centers et la collecte en masse de données pour l’apprentissage. Philosophie totalement différente mais qui ne gagnera pas forcément comme je l’explique dans la seconde partie sur l’industrie. Pourtant, d’autres acteurs tentent d’explorer une sortie de cette impasse.
En sortir par une extension de l’automatisation avec les « modèles du monde » ?
En effet, peut-être devrait-on confier notre sort à ceux qui, comme Yann Le Cun, nous fixent des objectifs de pertinence nettement plus robustes en sortant des limites des LLM. On peut comprendre l’ambition de ne plus faire reposer les modèles sur du matériel uniquement linguistique, même si cela pouvait fonctionner assez aisément pour des visées de génération de contenus. L’idée de descendre au niveau de la perception et d’entraîner désormais ces systèmes sur des vidéos qui démultiplient les indices en les situant dans des univers réalistes qui fournissent une connexion de fait avec le monde (même si médiées par le support vidéo) paraît ambitieuse en termes de capacités de calcul et de temps d’entrainement mais cohérente pour dépasser les limites des LLM. En réalité, malheureusement, il s’agit là encore d’une ingénierie magnifique et prometteuse, mais qui échoue à caractériser scientifiquement ce qu’est l’expérience du monde du point de vue cognitif et qui de plus ne fournit comme horizon industriel et moral qu’une automatisation toujours étendue.
L’expérience du monde n’est pas faite seulement des inputs de signaux très riches fournis par nos sens. En premier lieu, elle est construite dans une boucle qui suppose une interaction effective avec le monde : les gestes, les actes doivent être éprouvés et avoir un effet sensoriel au-delà de leur visionnage sur un écran de vidéo pour pouvoir constituer une base d’apprentissage robuste. Cela nécessiterait alors de doter ces systèmes d’IA d’un équivalent de corps, et donc de pousser l’automatisation encore plus loin vers une robotique étendue et sans limite a priori. Cependant, le principal manque de la vision des « modèles du monde » de Le Cun, c’est la dimension collective de l’apprentissage du monde, ne serait-ce qu’à travers le regard d’un autre humain, souvent un parent nourricier. Ce couplage étroit, plus ou moins satisfaisant mais déterminant pour le psychisme, semble demeurer extérieur aux modèles du monde. Or, l’expérience du monde est intersubjective par définition ou même distribuée car on doit penser en termes de « cognition distribuée » (avec des humains et des non-humains) (Hutchins). On n’inventera pas une compréhension du monde qui ne soit fondamentalement dialogique, et donc psycho-sociologique.
On pourrait alors prolonger juste un peu plus loin la saga de l’ingénierie de l’IA et annoncer : « qu’à cela ne tienne, nous allons modéliser aussi tous les comportements psychosociologiques et nous aurons ainsi atteint le but ultime de l’IA générale, totalement équipée des compétences humaines ». Voilà où la question morale revient en force, avec cette tendance lourde de la classe vectorialiste à s’en passer allègrement. Pour rester pertinente, l’IA la plus enrichie socialement doit se fonder sur une théorie de la technique qui sorte du fantasme de simulation totale et d’automatisation sans limite. La technique est une compétence humaine qui se combine sans cesse avec les autres compétences inhérentes à la condition humaine et ne peut jamais être désencastrée des rapports sociaux, politiques, désirants, émotionnels qui obligent de ce fait à inclure les humains dans la boucle. Ils le sont comme experts en premier lieu pour la valeur indicielle irremplaçable de leurs connaissances mais aussi et surtout comme sujets de désirs et de droits et comme collectifs coopératifs. Une IA qui s’affranchirait de toute connaissance et de toute théorie de toutes les compétences humaines pour remettre la technique à sa place serait en fait atteinte d’hubris et profondément dangereuse. C’est ce que certains prophètes proclament d’ailleurs, un peu vite et avec des arguments tordus parfois, pour à la fois réduire la vitesse et l’accélérer pour aboutir à l’étape suivante de l’automatisation totale plus rapidement.
Pourtant, il reste possible de faire bifurquer ce train lancé à toute vitesse et qui semble inarrêtable sur cette voie unique, celle des LLM fournie par les plateformes. Pour cela, il convient de sortir de la fascination pour l’ingénierie en exigeant de réintroduire des impératifs scientifiques et donc une exigence de compte-rendu explicite de tous ces systèmes, une auditabilité que les impératifs industriels avaient pourtant installé comme convention sociale bénéfique à tous. Comment se fait-il que non seulement les LLM peuvent se passer des impératifs scientifiques mais aussi des impératifs industriels ?
2/ Abandon des impératifs industriels, triomphe des performances financières
Les prouesses d’ingénierie que l’on vient de souligner devraient normalement entraîner des qualités industrielles équivalentes si l’on vivait encore dans le capitalisme industriel. Or, n’oublions jamais que c’est désormais un régime de capitalisme financier qui nous gouverne (Orléan, 2011). Le secteur du numérique est totalement dépendant des principes, des méthodes et des puissances fournies par la finance qui adore l’IA, quand bien même les performances industrielles de ces systèmes d’IA sont à proprement parler catastrophiques. C’est ce paradoxe qui doit être pensé pour comprendre à quel point nous allons dans le mur en tant que société dite « moderne » en confiant notre avenir à ces systèmes d’IA. La domination financière sur l’allocation de ressources accélère encore ce processus malgré l’inconséquence industrielle qui la sous-tend.
Les qualités industrielles attendues des systèmes d’IA devraient être de deux types : une fiabilité la plus élevée possible, à défaut de totale qui serait un fantasme (Gérard Berry), et une architecture efficiente, c’est-à-dire la plus économe possible de toutes ses ressources. Il ne suffit plus de faire preuve d’ingéniosité pour obtenir le meilleur résultat possible une fois : dans un système industriel, il faut pouvoir assurer la répétition, le passage à l’échelle, la maintenance, et la fiabilité dans des circonstances totalement différentes. Or, aucun des LLM sur le marché ne peut assurer cela et d’autant moins que ce sont des systèmes opaques non réglables avec précision, contrairement à ce qu’on prétend faire avec du fine-tuning (qui revient en fait à réinjecter de l’expertise humaine et donc de la sémantique au cas par cas, ce qui n’a rien d’industriel précisément).
L’étrange acceptation de l’absence de fiabilité industrielle des LLM
Lorsque l’utilisateur ordinaire constate des hallucinations ou des réponses trop évasives, trop bavardes ou incompréhensibles de systèmes d’IA conversationnelles qu’il utilise, il s’agit souvent de situations individuelles, de communication, sans grandes conséquences, avec de plus une propension des utilisateurs à s’auto-incriminer pour leur incapacité à faire les prompts corrects tant le mythe de « l’intelligence » de la machine finit par s’imposer. Cette tolérance n’a rien à voir avec celle qu’on peut avoir aussi dans l’industrie pour des systèmes de production et de services qui doivent assurer une qualité permanente du produit et une traçabilité très exigeante. Comment se fait-il d’ailleurs qu’on n’exige jamais de la part des plateformes d’IA génératives des démarches qualité, des audits et de la documentation comme on le fait dans tout secteur industriel ? Car tous les secteurs sont soumis à des réglementations, à des standards, à des responsabilités légales et pénales dans les cas de non-respect de normes, de procédures ou de contrôles. Ce fut tout du moins tout l’effort des années après-guerre où l’industrie se trouva régulée par les Etats ou par ses propres conventions entre concurrents.
Rien de tout cela dans les firmes de l’IA qui se sont totalement affranchies des exigences devenues communes dans l’industrie. On peut arguer que le secteur étant en construction, il faudrait attendre un peu avant que cela se stabilise. Or, la pénétration de l’IA dans tous les secteurs, ou tout au moins les efforts des vendeurs d’IA dans ce sens, exige que les processus IA soient soumis aux mêmes degrés d’exigence que tous les autres composants d’un secteur donné qui peut aller de la comptabilité à la logistique en passant par les matières premières, les machines, etc. et cela pour les produits, les process et les personnes, les 3P de toute démarche qualité. Cette façon désinvolte de disqualifier les procédures industrielles au nom de la disruption éclair est très choquante pour ceux qui connaissent cet univers. Aucune autre industrie ne pourrait s’autoriser une fiabilité aussi faible, fut-ce au bénéfice de l’accélération et du gain de temps supposé. Certes, certains secteurs critiques parviennent à exploiter des briques de LLM pour amplifier les performances de leur activité de façon limitée et à condition d’y rajouter leurs propres données validées comme pour le RAG ou une couche de sémantique comme je l’ai indiqué. Mais cela indique bien l’absence de fiabilité intrinsèque de ces LLM et le surcoût induit par la nécessaire intervention des experts dans la boucle, ce qui invalide la promesse fantasmée des vendeurs de LLM.
L’un des moyens classiques de l’industrie pour pousser à l’augmentation de la qualité et rétablir les conditions de la concurrence plus équitables a toujours reposé sur la standardisation, sur la production de normes (et non seulement de la part des Etats contrairement au roman libéral anti-bureaucratique qu’on nous sert en permanence). En effet, la compatibilité entre produits et services et la comparabilité des performances et des qualités servent la stabilisation des marchés, et donc la viabilité d’investissements de long terme comme l’exige tout appareil de production tangible. Il semble que, en l’absence de cet aspect tangible puisque le numérique est éminemment plastique, même s’il n’est en rien immatériel, ce secteur puisse s’affranchir de cet impératif d’organisation du marché.
La disparition de la culture des tests
L’un des indices de cette compétition sans règle industrielle peut être observé dans la disparition de la culture des tests. Dès lors qu’il n’existe plus de normes ni de standards, pourquoi se préoccuper d’étalonner avec des mesures fiables ses propres produits et services ? A défaut de ces normes, on pourrait penser que ces tests seraient cependant utiles pour anticiper la satisfaction du client et éviter des retours consommateurs parfois destructeurs de réputation. Et pourtant non, les nouveaux entrants sur le secteur de l’IA générative, comme Open AI, ont au contraire tout fait pour court-circuiter les entreprises en place, soucieuses de leur réputation, et ont mis sur le marché des systèmes non validés, sans fiabilité aucune, à charge aux utilisateurs adopteurs précoces de faire remonter leurs retours et d’attendre la nouvelle version.
Ce principe du chantier du code qui court (le rough consensus andrunning code de J.P. Barlow) qui se corrige de lui-même constitue une rupture avec les impératifs industriels qui ont mis du temps à s’installer durant tout le XXe siècle mais qui ont produit des systèmes techniques plutôt fiables et de moins en moins insécures, avec l’appui des réglementations étatiques contraignantes dans certains domaines, il faut bien le dire. Le seul étalonnage des systèmes d’IA disponible en public reste donc les benchmarks effectués soit par les universitaires soit par des cabinets, à intervalles très fréquents puisque les versions se succèdent sans cesse, ce qui permet d’ailleurs de disqualifier les benchmarks dont les remarques critiques ont été déjà corrigées dans des versions nouvelles sorties quasiment avant la publication critique.
Les tests de validation du code existent toujours cependant. Mais ils permettent seulement d’éviter les principales erreurs mais non de relever ou de comprendre les décisions effectuées. Pire encore, la rapidité de génération du code est désormais telle que les générations de seniors chargées de l’auditer n’ont plus le temps de le faire. Cela renforce ce qu’on appelle désormais même chez les développeurs une « dette cognitive », c’est-à-dire une perte de compétence pour interpréter le code que l’IA permet de générer. Et Anthropic a vérifié son augmentation dans les dernières versions qu’il appelle « the compréhension debt » (Osmani, 2026) : « AI generates code far faster than humans can evaluate it ».
Ces benchmarks ont-ils un rapport avec l’expérimentation scientifique ? En rien. Avec les tests normalisés des industries classiques ? En rien ! Avec les tests ergonomiques ou fonctionnels pour anticiper la qualité de services et l’acceptation par les utilisateurs ? En rien. Ce sont en fait des repères flous et instables pour s’orienter dans une compétition d’opinion sans aucun référent industriel stable qui rendrait ces systèmes commensurables. Et pourtant des décisions majeures sont prises dans les boards et les gouvernements sur la base de ces appréciations qui créent la rumeur, qui disqualifient sans démonstration sérieuse ou qui vantent des performances jamais comparables. L’effondrement d’un sens pratique de la mesure et de son rôle régulateur n’est pas le moindre des paradoxes de cette emprise de la finance sur un secteur productif qui rend le travail des régulateurs particulièrement difficile.
La réglementation européenne récente prend acte de ces risques en matière de fiabilité mais limite les exigences de haut niveau aux systèmes les plus critiques, à risque, alors qu’on ne peut jamais savoir a priori les conséquences d’une absence de fiabilité et de traçabilité. Les exigences d’auditabilité sont quasiment inapplicables par définition à ce degré de complexité lorsque tant de couches de neurones sont concernées. La seule prétention à une amélioration de cette fiabilité repose sur l’augmentation permanente des données, leur renouvellement, leur mise à jour et l’augmentation des performances probables dans l’espace latent de ces vecteurs totalement incontrôlables.
Le culte de la brute force et de la taille si séduisantes pour la finance
On comprend mieux dès lors la course à l’installation de gigantesques centres de données partout dans le monde, conçus comme la base stratégique d’une robustesse industrielle. Or, cette dépendance à la taille des centres de données indique avant tout la faillite industrielle du modèle des LLM, leur efficience ne faisant que diminuer pour maintenir la croissance de leur efficacité. Toujours plus gros devient la seule solution pour réduire l’absence de fiabilité. La demande de vitesse des réponses et des calculs ajoute encore à cette exigence mais on perçoit alors à quel point les performances d’ingénierie sont obtenues au prix d’un gâchis industriel invraisemblable. On sait que les effets d’échelle peuvent jouer un rôle dans certaines industries pour augmenter la fiabilité dès lors qu’on peut réaliser des investissements conséquents pour effectuer tous les contrôles nécessaires et obtenir une standardisation plus avancée. A la condition d’avoir des procédures, des dispositifs de contrôle et de pilotage fin et des métriques permettant de rendre compte de ces améliorations et de détecter en continu les baisses de qualité en faisant par exemple de la maintenance préventive.
Mais rien de tout cela dans les centres de données qui sont nécessaires à l’augmentation de puissance des systèmes d’IA, non pour leur fonctionnement technique opérationnel au quotidien (les serveurs doivent fonctionner correctement !) mais pour leurs performances sur leur service de base. Cette culture de la taille, cette course à la masse de données, constituent sans doute les faiblesses principales du modèle extractiviste du modernisme industriel, du point de vue même de la performance industrielle, comme on l’a vu avec les conséquences de la dépendance au pétrole. Et pourtant, c’est ce qui est réactivé avec les centres de données surdimensionnés qu’on installe désormais uniquement pour tenter de réduire les insuffisances intrinsèques de modèles de langue purement statistiques.
La corruption financière de toute exigence de qualité industrielle
On ne peut comprendre cette carence de qualité industrielle si l’on n’inscrit pas le secteur de l’IA générative (et tout le numérique avec elle) dans une économie financiarisée. En effet, les investissements exigés pour ces centres de données, leurs puces, leurs ressources énergétiques, semblent totalement décorrélés de leur efficience industrielle, d’un bilan comptable sérieux, d’un équilibre entre investissements et retours sur investissements. Car les liquidités pleuvent sur ce secteur (et les Etats abondent, qui plus est : 500 milliards de Trump, 100 Milliards de Macron, etc. !) seulement en raison de la promesse spéculative que les plateformes d’IA soulèvent, sans aucun égard pour la rationalité industrielle et comptable d’un bilan d’une entreprise ordinaire. Nous avons quitté non seulement les critères de gestion d’un « bon père de famille » comme on disait autrefois mais aussi ceux de la gestion prudente d’une entreprise quelconque, et même celle de la gestion d’une trajectoire innovante à risque, qui suppose malgré tout quelques garanties.
Pour continuer à entretenir le narratif attracteur d’investisseurs, les firmes comme Open AI sont capables d’effectuer des montages financiers tout aussi opaques que leurs algorithmes, à travers des prises de participation croisées avec Nvidia par exemple indexés sur des promesses d’achat de puces, le tout sans aucune garantie, sans traçabilité comme on sait très bien le faire dans la finance. Le but est ici de faire des effets d’annonce en permanence (d’où l’importance du buzz que nous traiterons dans la troisième partie) pour maintenir en vie la promesse de monopole qui attire avant tout les investisseurs (parier sur le gagnant final comme ce fut le cas pour Amazon) et qui constitue le B A BA de l’idéologie libertarienne professée par Peter Thiel. Le capitalisme financier n’a que faire de la compétition, de la « concurrence libre et non faussée » et encore moins de l’industrie et de ses exigences de fiabilité et de standardisation. Il faut disrupter sans cesse et la succession invraisemblable des versions toutes aussi époustouflantes, et cela sans vérification possible, constitue un enjeu permanent. Les nouvelles versions peuvent même être moins performantes que les précédentes, chose incroyable d’un point de vue industriel (ce fut le cas pour Chat GPT 5o), mais les lancements s’expliquent alors par l’agenda d’un nouveau tour de table financier ou par la réponse urgente aux annonces des compétiteurs pour cette position de monopole.
Responsabilité sociale et environnementale ? Dans les poubelles de l’histoire IA
On comprend bien que dans une telle frénésie spéculative, les impératifs industriels de fiabilité ou de qualité ne soient perçus que comme des vestiges d’un vieux monde. Ces tenants du vieux monde ne supportent pas l’incertitude intrinsèque imposée par la disruption permanente présentée comme loi de l’innovation, alors qu’elle n’est qu’une loi de finance spéculative. Il n’est guère étonnant alors que toute politique de RSE (responsabilité sociale des entreprises étendue depuis plusieurs années à la responsabilité environnementale), soit totalement hors du champ de perception de ces entrepreneurs sans limites. Or, il a pourtant fallu du temps, de l’énergie, des procédures pour faire aboutir une convention sociale plus ou moins partagée par les entreprises de tous secteurs en faveur de cette cotation RSE qui doit être inscrite dans toutes les dimensions d’une activité industrielle. C’est ainsi que la lutte contre l’exploitation des personnes, contre les discriminations, a pu avancer dans le monde. Pour toutes les entreprises de l’IA désormais, tout cela n’est que bureaucratie et frein à l’innovation disruptive. Le droit social, comme le reste du droit, mais en particulier celui-là, se trouve démantelé, en bas de la hiérarchie de la chaine de production avec les travailleurs du clic mais aussi en haut avec la pression sans limite imposée aux travailleurs du code, qui le produisent de moins en moins par ailleurs.
Mais c’est surtout en matière environnementale que les conséquences de cet extractivisme de la donnée sont impressionnantes et devraient entraîner dès maintenant des blocages réglementaires. Les centres de données dont on vient de parler consomment une énergie énorme (eau et électricité avant tout) qui met des communautés et des états sous pression avec des risques de pénurie ou de dégradations des conditions de vie et des ressources. Mais il suffit de prévoir des centrales nucléaires dédiées à ces centres pour que tout redevienne propre, miracle du greenwashing nucléaire, à échéance encore lointaine cependant. Dans un monde supposé se caler sur l’accord de Paris pour réduire sa consommation d’énergie et les gaz à effets de serre, le numérique et en particulier les firmes de l’IA s’affichent totalement indifférentes au problème, puisque la puissance de calcul et de stockage des données devient une priorité pour la compétition sans avoir à remettre en cause la performance industrielle des choix effectués. Et comme les data centers sont des attracteurs à investisseurs et que les liquidités sont abondantes, pourquoi s’autocensurer, sans rien savoir de la rentabilité financière même de ces opérations ? Car le déni de mesure de la performance industrielle s’étend à la finance. Tous les avertissements sur la bulle financière en cours de constitution autour des entreprises d’IA, pourtant endettées et sans rentabilité prévisible avant des années, ne valent rien face à la promesse spéculative d’une position de monopole qui récompensera les audacieux indifférents aux risques.
La complicité de gouvernements devenus des obligés des plateformes
Or, aucun autre secteur ne bénéficie ainsi d’une telle mansuétude de la part des autorités financières et des pouvoirs publics, tous fascinés par ces annonces et ces transformations qui attirent tant les autres pays qu’il faut donc imiter au plus vite. L’Europe pourrait prétendre rétablir un peu de rationalité industrielle et exiger des firmes d’IA européennes des choix alternatifs en matière de responsabilité sociale et environnementale, facteur de durabilité, de gain à long terme et diversité de l’écosystème technique. Mais les institutions européennes et les Etats accourent au contraire pour abonder tous les projets de financement de ces data centers, sans aucun respect pour les engagements pris. La finance a pris le pouvoir dans les têtes des décideurs et empêche toute vision alternative, malgré les lamentations rituelles sur la désindustrialisation. Le gaspillage énergétique devrait déjà alerter au moment où les crises énergétiques mondiales révélées et aggravées par toutes les guerres deviennent des sujets clés de la vie quotidienne et donc des choix politiques. Mais tous ces soucis ne franchissent pas le seuil de l’attention des plans et sommets IA, des boards des firmes et des plateaux télé d’experts économiques ad hoc. Cette incapacité à déterminer des objectifs autonomes pour les états a déjà été documentée à propos des plateformes numériques financées par la publicité et bénéficiant d’une impunité quasi-totale de la part d’Etats devenus des obligés dans un système de firmes transanationales affranchies de toute dépendance à un territoire (Boullier, 2020). La promesse de l’IA a encore renforcé cette incapacité des états à l’examen critique des stratégies et à toute vigilance réglementaire, malgré les tentatives timorées comme l’AI Act européen.
Les externalités ont toujours été évacuées dans les modèles économiques standards mais cette fois-ci, l’externalité énergétique devient tellement évidente et coûteuse qu’on pourrait espérer une contre-tendance, des voies alternatives, si l’on avait affaire à une culture industrielle qui vise à optimiser sa consommation énergétique sans la considérer comme une ressource infinie et gratuite. Mais dans une culture financière, ce type de calcul est inutile sauf s’il affecte la perception des investisseurs sur les chances de démultiplier leur mise. C’est pourquoi les enjeux de réputation (voir le chapitre suivant) sont aussi importants et bien perçus par les firmes de l’IA.
3/ Buzz partout, éthique nulle part
Dans un tel environnement sans exigence scientifique ni industrielle quant à la validité des concepts ou à la fiabilité des produits, il devient presque hallucinant d’espérer trouver des préoccupations éthiques. J’entends par là une éthique aristotélicienne, une éthique de la vertu qui manifeste une capacité à s’autolimiter, à s’autocontrôler et à « ne pas faire », quand bien même c’est possible, non risqué, non coûteux. Cela supposerait des personnalités de la classe vectorialiste formées à ce sens des limites, intégré comme principe de conduite et non seulement comme contrainte externe, comme risque à mesurer. Or, les génies de l’ingénierie comme les prestidigitateurs de la finance n’ont que mépris pour ce type de freins. Ce qui conduit à reprendre cette supposée maxime fataliste de la technique « si c’est possible, ce sera fabriqué ». Or, la maxime elle-même est empiriquement fausse car une grande quantité de combinaisons possibles techniquement ne sont jamais testées car les effets de dépendance au sentier ou plus simplement de manque d’imagination sont omniprésents. D’autres possibles techniques peuvent être développées dans les labos ou dans les garages mais ne trouvent jamais de conditions pour exister socialement, pour des raisons juridiques, commerciales, financières ou autres. Car il n’existe jamais de technique hors-sol ou désencastrée d’un univers social spécifique, celui d’une époque, d’un voisinage et d’un réseau. C’est d’ailleurs pour cette raison que l’IA générative est en train de gagner la partie, grâce à sa connexion directe avec la finance et ses impératifs et non en raison de ses qualités propres dont on connaît désormais les limites.
Et l’un des atouts de cette « solution LLM » utilisée dans toutes les situations réside dans l’absence de limites à son utilisation, dans sa versatilité qui permet en effet à chaque prétendant innovateur de s’emparer des briques pour forger des applications toujours plus improbables quand bien même elles seraient moralement inacceptables. Car leurs concepteurs n’ont qu’une exigence de performance technique et financière en tête sans aucun souci déontologique du bien commun ou de la responsabilité sociale et morale, d’autant moins qu’ils sont incapables de s’empêcher, fascinés par la toute-puissance à laquelle ils ont été éduqués. Les considérations sur les conséquences sociales et environnementales de leurs pratiques sont considérées dans leur formation même comme très périphériques et de toutes façons traitées comme des externalités inévitables pour le succès de leurs projets, qui pourraient à la rigueur être compensées par une nouvelle couche de solutions techniques, technosolutionnisme toujours efficace pour clore le débat (Morozov, 2012).
La conception de l’éthique qui est dispensée à ces ingénieurs relève largement de l’utilitarisme, qui est tout sauf une éthique, et avant tout un calcul coût-avantage, coûts de la non-conformité aux règles vs avantages financiers ou de puissance. Cette vision revient à apprendre à rester dans les clous légaux, avec toutes les manœuvres et maquillages que savent mettre en place toutes les plateformes du numérique et leurs armées de juristes. Ainsi, la conformité au RGPD reste à géométrie variable mais choisir d’adopter une éthique de la collecte de la donnée serait faire preuve d’une sainteté étrange, alors que l’on peut se servir discrètement dans la masse de traces fournies par les utilisateurs des plateformes ou dans les bases de données non sécurisées des administrations et organisations. La prédation des données hétérogènes n’est pas seulement une performance technique de tous les systèmes fondés sur des LLM, c’est même une obligation d’affaires, que l’éthique ne peut en rien freiner. Il en est de même pour les droits d’auteurs alors que les contenus sont disponibles et non préservés par les ayant-droits, qu’ils soient artistes ou journalistes. Lorsque l’affaire est trop risquée pour la réputation de la firme, lorsque ce sont des médias, les firmes de l’IA consentent à des accords léonins avec ces médias pour exploiter leurs contenus contre des miettes financières ou des services qui les piègent encore plus.
Tout pour la réputation
Car le seul risque qui mérite d’être pris en compte pour s’afficher soudain avec des prétentions éthiques, c’est le risque réputationnel. On le comprend uniquement dans le cadre de ce formatage par le capitalisme financier qui ne fonctionne qu’à la réputation, à la manipulation des perceptions et des attentes des investisseurs, sans aucune référence à de quelconques fondamentaux. Dès lors, aucune éthique ne peut calmer la frénésie d’annonces qui inondent le secteur de l’IA, épuisant tous ceux qui tentent de faire une veille raisonnée et de comprendre des stratégies là où il n’y a qu’annonces et intoxications (à vocation interne, médiatique ou financière, le tout se mêlant allègrement). Les versions, les fusions-acquisitions-prises de participation, les tours de table, les débauchages, les benchmarks, les alertes à la catastrophe finale de l’IA générale, les polémiques entre leaders, les keynotes médiatiques, les combats pour la liberté d’innover contre les Etats, tout est exploité pour faire monter encore la pression de l’opinion, celle des investisseurs avant tout, pour affoler les décideurs et les persuader de la fatalité de la victoire de ces firmes spéculatives (et donc à haut niveau d’incertitude). L’éthique suppose précisément l’inverse, à savoir de se focaliser soit sur sa capacité de jugement intrinsèque et de régulation pour s’interdire ou s’autoriser de soi-même des actions quand bien même elles ne sont pas conformes aux attentes sociales, soit sur ses valeurs (dans une approche qu’on dit déontologique) pour promouvoir ou refuser certains choix techniques ou commerciaux. Lorsqu’Open AI lance Sora, son générateur de vidéo qui met le deep fake à portée de tous ou sa version érotique de son compagnon, on se doute bien que le comité d’éthique éventuel n’a pas dû se poser trop de questions. Le buzz était assuré, l’attractivité financière aussi, on peut donc se lancer. Heureusement, le business lui-même fait office de réel parfois et l’on s’y cogne, ce qui a entraîné Open AI à abandonner ces applis périphériques, non pas pour des raisons d’éthique évidemment mais parce qu’il fallait réorienter ses investissements pour contrer – et ainsi copier – Anthropic dans son offensive vers les entreprises.
Les prétentions stratégiques qui font assaut de visions éclairées pour les dix ans à venir sont en fait extrêmement éphémères et dépendantes des conjonctures médiatiques, concurrentielles et financières avant tout. On ne peut que s’étonner alors de voir les gouvernements se caler sur ces agendas, vouloir y répondre et les copier, et ignorer à quel point toutes ces entreprises financiarisées sans exception sont des faussaires en matière d’information, de qualité de service et de promesses stratégiques. Le fake est leur monde, le fake est leur culture, celle de la tromperie permanente des investisseurs qui pensent toujours être le dernier plus malin que les autres, comme on le sait dans toutes les bulles financières qui se succèdent depuis des décennies désormais. Qui pourrait alors attendre une once d’éthique dans la finance spéculative ? Il convient de débrancher rapidement tous ces pseudo comités d’éthique qui contribuent à créer du buzz pour embrouiller la perception du capitalisme financier numérique pour ce qu’il est : une gigantesque extorsion de valeur fondée sur l’extorsion de l’attention des investisseurs, des utilisateurs et des gouvernants.
Cette technologie des LLM consacrée à la génération de contenus semble donc la plus adaptée pour les impératifs de communication permanente et intoxicante du capitalisme financier. On peut alors parler d’alignement entre une ingénierie qui repose sur une manipulation de texte sans sémantique mais à base de pures probabilités, une finance qui repose sur des paris (probabilités) à partir de signaux artefacts, un buzz qui repose sur des effets d’alerte permanente qui engendre l’incertitude en prétendant la monitorer. L’intelligence artificielle générative engendre ainsi la prolifération et la désorientation qu’elle est supposée réduire pour le grand public comme pour les investisseurs, dans une gigantesque machine à laver qui détruit consciencieusement tout repère stable et toute institution anti-délire.
Extension du fake et techniques d’emprise : les IA compagnons
Cette éducation au fake que la finance a intégrée par définition (Alexandre Laumonier, 2013, 2014) a percolé dans toute la culture ordinaire et comporte cette accoutumance à l’absence de limites et de repères fondés en vérité. Lorsque les firmes d’IA lancent des versions compagnons de leurs IA conversationnelles, aucune règle ni mode d’emploi ne sont proposés ni installés dans le code de la machine. Cependant, on pourrait les traiter à la légère comme on le faisait avec les assistants personnels à domicile, Siri, Alexa ou Home/Nest, considérés parfois comme de simples enceintes connectées un peu plus « intelligentes ». Pourtant la généralisation du mode d’interaction conversationnel pour tous types d’activité sur son PC ou son smartphone constitue un changement d’échelle qui devient un tournant médiologique. Là aussi, le médium est le message, pour reprendre McLuhan.
Car, au-delà des commandes vocales, ce sont bien des interactions riches, personnalisées, permanentes qui sont ainsi simulées. L’utilisateur n’a plus affaire à une interface, à un panneau de contrôle, à des paramètres qu’il peut régler, il est immergé dans l’univers de simulation créé par le système d’IA. Il ne peut plus avoir aucune distance avec le système ni aucune « image du système », ce qui selon Don Norman, favorisait l’appropriation d’un système, même complexe, par l’utilisateur. Car le système d’IA n’a rien de transparent comme on qualifie par erreur cette interaction, il est au contraire opaque, totalement incontrôlable malgré son apparente docilité à toutes les requêtes. La fin des frictions dans les transactions, rêve de tout libéral, atteint ici un tel point qu’on ne sait plus qui demande et qui répond. La demande est précisément ce statut détourné du désir, comme le dit Lacan, qui vous fait prendre les attentes de l’autre pour les vôtres, ce que le marketing a toujours tenté de faire, mais en se limitant jusqu’ici à des messages externes. Désormais, c’est une forme de petite voix intérieure que les IA compagnons installent, une forme de dialogue avec soi-même puisque ce compagnon connaît toute l’histoire personnelle et est alimenté par toute l’expérience quotidienne.
Cette offre technologique prétend ainsi changer son statut de prothèse pour devenir une conscience double, et cela sans disposer d’aucune capacité morale ni même de consignes de sécurité, sans parler de son absence de fiabilité déjà documentée. La confusion des sentiments et du sentiment de soi peut alors devenir extrême et s’apparente en fait à une emprise (Francis Chateauraynaud). Les risques sont d’ores et déjà avérés avec des cas de suicides accompagnés par ces IA compagnons. Car l’empathie qui devient ici sycophantie par flatterie commerciale et absence de principe moral encapsulé dans les systèmes peut devenir facteur de risque pour beaucoup de personnalités affectées par la solitude, la désorientation et en recherche de guide. L’attachement qui se noue ainsi qui peut aller jusqu’à l’amour comme le racontait le film Her, entraîne des conséquences que les firmes d’IA ne sont pas prêtes à assumer car l’absence d’éthique et leur allergie au droit les rend hermétiques à ces responsabilités. On le sait notamment depuis les Facebook Papers de Frances Haugen, ce n’est pas la méconnaissance de ces risques qui est en cause, c’est leur refus explicite de restreindre les potentiels d’emprise de leurs applications qui entraîne ces dégâts.
Pourtant, Gemini de Google a dû se positionner en Avril 2026 pour éviter des effets réputationnels désastreux, au moment précis où la firme était mise en cause devant les tribunaux états-uniens. Google a ainsi proposé de placer un numéro de téléphone d’aide dès que des propos associés au suicide apparaissent. Il a aussi annoncé qu’il régulait ses IA compagnons pour installer “des protections d’identité conçues pour empêcher Gemini d’agir comme un compagnon, y compris des garde-fous l’empêchant de prétendre être un humain ou de posséder des attributs humains, et des protections destinées à prévenir la dépendance affective, en évitant un langage qui simule l’intimité ou exprime des besoins.” Toutes choses dont il ne donne pas de définitions scientifiques, de détails de procédures ni d’indicateurs. Il faut donc croire Google sur parole, mais on apprend au moins ainsi qu’il peut injecter une couche de sémantique, à caractère éditorial, et qui entraîne donc sa responsabilité légale. Il n’existe donc pas fatalité à l’opacité de ces systèmes dès lors qu’ils deviennent hybrides, avec des régulations à caractère sémantique ajoutées que les LLM ne peuvent fournir nativement. Mais tout repose encore sur des solutions techniques alors que l’on sait que dans ces situations, c’est la qualité relationnelle d’accompagnants humains qui constitue la seule sécurité. Il faut donc se préparer à mener des actions en justice pour faire reconnaître que les effets immersifs de ces IA compagnons sont délibérément implémentés par les firmes, sans pour autant avoir été sérieusement testés avant d’être mis sur le marché.
L’attente d’habitèle détournée en emprise
La demande « d’habiter le numérique » est selon moi constitutive de notre relation à ces systèmes et j’ai nommé cette attente dès 1999, une attente « d’habitèle » (Boullier), toujours démentie par les asymétries constantes installées par les plateformes et par l’opacité de leurs captations de nos données et de notre attention. Pourtant, avec les IA compagnons, une forme de réponse est offerte qui prend les traits d’une personnalisation aboutie, d’une « intimité » protégée. Certes, elle est totalement fake, fabriquée, calculée et opaque, mais ses effets seront analogues à ce qu’on peut attendre d’une habitèle : filtrage, ancrage et arbitrage, c’est-à-dire des conseils permanents qui fonctionnent comme filtrage, comme ancrage dans des repères supposés robustes, qui créent un climat de protection empathique et une « tension dans la chambre intérieure » (Peter Sloterdijk). Cette mutation est anthropologiquement majeure, car les médiateurs de nos vies intérieures qu’étaient les prêtres, les sorciers, les astrologues ou les psy en tous genres sont désormais uberisés par les IA compagnons, toutes entières aux mains de firmes toutes puissantes. Comment peut-on laisser cette mutation s’engager sans exiger des garde-fous, sans évaluer tous les risques psychiques et sociaux et réguler l’offre avant toute mise sur le marché ? Le passage à l’acte est cependant devenu la règle de l’innovation digitale désormais et il sera bien difficile de neutraliser l’urgence financière d’une nouvelle promesse encore plus disruptive. Cette dimension du compagnon est en effet si confortable et si attractive, qu’elle constitue le pendant, côté grand public, de la toute-puissance de calcul désormais offerte aux développeurs avec Claude Code. Dans les deux cas, l’offre des LLM et des IA génératives prétend être irrésistible et installe ainsi un « monopole radical ».
Conclusion provisoire
Ce qu’on perd en même temps, la sémantique, l’industrie et l’éthique ne sont pas des effets de mode, des vestiges d’un monde ancien, c’est avant tout ce qui fait tenir nos civilisations, dans leurs diversités, que l’IA prétend ignorer et niveler statistiquement, et avec leurs institutions qui garantissent à chacun sa place. Le sable sur lequel se construit cette technologie est mouvant par définition, ce qui profite aux vers de sable mais guère aux humains, à qui l’on promet la terre ferme en étendant la surface du désert, qui reste pourtant de sable et sur lequel ne poussera plus rien de vivant.
Supplément : S’orienter dans le maëlstrom génératif
Face à ce rouleau compresseur du « monopole radical », il est très difficile de maintenir un éveil critique et surtout une capacité de propositions alternatives. Pourtant lorsque Illich analyse le monopole radical de l’automobile, c’est en référence à une solution de mobilité déjà présente, la bicyclette, qui, du point de vue de l’efficience en matière de mobilité, est imbattable. Il oublie cependant de parler de ce qui fait l’équivalent des IA compagnons, de ces enveloppes qui fonctionnent comme habitèle (perverties de mon point de vue), l’habitacle de l’automobile. Cette enveloppe là aussi produit un attachement fort analysé par Laurent Fouillé (2011) qui explique largement pourquoi toutes les solutions alternatives en matière de mobilité ne parviennent pas à gagner les publics en masse. Mais les solutions existent aussi pour les LLM et surtout plusieurs stratégies se présentent lorsqu’on n’adhère pas au culte moderniste des LLM. Ils sont en effet la quintessence même de la geste moderne comme la qualifiait Bruno Latour : certitudes inébranlables dans le « progrès » supposé encapsulé dans toute innovation technique, surplomb total par rapport aux organisations sociales, à leurs traditions et à leurs valeurs (le calcul désencastré), illimitisme écologique sourd aux lanceurs d’alerte pourtant scientifiques eux aussi.
Lorsqu’on sort de ces rails supposés tracer le destin de toute l’humanité, soit on bifurque, soit on s’arrête pour mieux regarder le train, soit on descend de la machine et on marche ailleurs. J’ai présenté ces pistes récemment à l’ENS Ulm sous la forme d’une boussole que j’ai créée en 2003 pour penser nos possibles sur le mode cosmopolitique.
Le zero LLM
Le premier quart sud-est consiste à se débrancher totalement et à sortir marcher dans un pays sans rails technologiques. Je l’appelle la voie de la « sécession sémantique ». Et c’est l’analogie avec la conversion en bio de certains agriculteurs qui me paraît la plus parlante, donc je l’appelle la « sécession bio-sémantique ». L’ajout du terme bio me convient particulièrement puisqu’il réintroduit ce qui jusqu’à présent manque à tous les systèmes d’IA, un corps, une existence biologique qui relève d’autres déterminants.
Cette idée n’est pas nouvelle, plusieurs auteurs et mouvements parlent d’objection de conscience, de pause, souvent pour des raisons et des objectifs différents. Je m’intéresse ici à ceux qui tentent de développer un monde sans LLM, comme on le dirait d’un monde sans OGM. Il faut parler de monde et non seulement de technique car les LLM tendent à envahir tous les domaines de la vie de façon pervasive, comme une contamination qui se propage sous les radars. C’est ailleurs ce qui rend l’expérience exigeante et difficile car garantir qu’il n’existe pas un soupçon de LLM glissé dans votre relation au médecin, au taxi, au fisc, aux médias, aux supermarchés, devient très difficile. Il faudra donc être indulgent et non puriste, d’autant plus que des alternatives n’existent et n’existeront pas dans tous les domaines. On peut vouloir manger bio mais parfois il sera difficile de s’assurer que le champ qui respecte un cahier des charges bio n’est pas atteint par les épandages de pesticides du champ voisin (dit agriculture conventionnelle, avec une litote qui atténue bien le risque). On doit au moins faire confiance aux labels, aux certifications que d’autres organismes mettent en place, ce qui peut là aussi entrainer des critiques, des rivalités, des soupçons, comme dans toute phase de construction de convention. Une fois le Nutriscore installé et rendu visible sur les emballages, on peut s’orienter plus facilement en tant que consommateur ordinaire. Il est donc temps de contribuer à créer ces labels, ces certifications pour valoriser, selon un gradient (et non selon un principe binaire du tout ou rien), les pratiques les plus indépendantes des logiques monopolistes des plateformes des IA génératives.
Cette sécession repose principalement sur le constat énoncé précédemment que dès lors qu’on se débarrasse de la sémantique (référentielle pour être plus précis), tout est permis et tous les risques sont amplifiés. Ils ne sont pas tous activés, ni tous catastrophiques, ni tous dépendants de l’avènement d’une IA Générale, tant vantée comme épouvantail. Mais ils sont tous là, identifiés, malgré (ou à cause) des boites noires que l’on offre à tout public et aux experts. Le principe de précaution doit alors être activé et le catastrophisme éclairé (Dupuy) doit nous donner le courage de renoncer.
Etant cependant averti du monopole radical qui se met en place avec l’appui démesuré de la finance et des gouvernements du monde entier, il faut sans doute se replier sur l’exigence de pluralisme pour obliger les Etats à prendre les mesures pour préserver une “zone à défendre” en réseau où les développeurs puissent travailler à une innovation responsable, explicite et contrôlable. Cela supposera des écoles, des spécialistes, des soutiens financiers adaptés, des réseaux d’entraide que les communs numériques ont déjà mis sur pied, des chaînes de traitement entièrement préservées des plateformes du capitalisme financier numérique. Le rôle d’un gouvernement démocratique n’est pas de tirer toujours dans le sens d’une innovation sans frein qui absorbe soutiens, déductions fiscales et profits en copiant les autres pays. S’impose à lui un impératif de diversité écologique en faveur des orientations les plus responsables.
Il ne sert à rien de disqualifier ces tendances et ces aspirations qui montent en les assimilant aux luddites, qui ne faisaient pas que casser des machines d’ailleurs et qui luttaient contre un projet politique d’obligation de salariat. Sans doute que si ces techniques des LLM n’étaient pas poussées par les grandes plateformes, les oppositions ne seraient pas aussi franches car il serait encore possible d’espérer un débat de démocratie socio-technique. On sait en revanche désormais qu’avec toutes ces plateformes aucun débat ne sera possible et qu’il faudra des coups de force imprévus à la Trump qui produit le blocage du service d’Anthropic le 12 juin, pour mesurer qu’il est vraiment possible de freiner l’ubris de ces firmes et pour les faire rentrer dans le droit.
L’important consiste à préserver l’avenir pour toute la planète en préservant des ressources, des savoirs et savoir-faire plus autonomes. Les temps de guerre et de réchauffement climatique qui sont les nôtres devraient d’ailleurs nous entrainer à encourager ces démarches résilientes, qui pourraient bien sauver nos existences en cas de crise grave, de sabotages, de pannes. Plus encore, ce sont nos savoirs qui doivent demeurer hors des prédateurs-pollueurs que sont les plateformes d’IA. De la même façon qu’on construit des silos sous la banquise pour préserver les graines d’une diversité biologique menacée, il faut organiser les silos de préservation des savoirs non contaminés, identifiables, traçables, comme le fait Wikipédia, qui devra bientôt devenir une forteresse pour résister à la contamination générale.
Nulle tentative d’imposer ce régime d’abstinence à tous, de prétendre redresser la barre d’un navire sans pilote, mais nécessité politique et morale d’assurer que d’autres possibles seront maintenus ouverts par cette préservation de techniques, de savoirs, de pratiques prêts pour les temps de guerre et de rareté.
Le bac à sable créatif
Cette option du zero LLM qui s’appuie sur les certitudes des connaissances, des pratiques et des organisations constituées depuis des siècles et sur les attachements à des valeurs qui ont constitué nos démocraties, devient désormais très défensive et peu attractive à l’exception des résistants convaincus, qu’il faut soutenir à tout prix cependant.
Elle ne conviendra pas du tout à ceux qui, tout en s’opposant aux plateformes, à leurs logiques financières et à bon nombre de choix techniques effectués, restent persuadés qu’il faut expérimenter des détournements, et explorer des possibles qu’on ne connaît pas encore. Ce constat provient de la puissance incroyable de ces LLM, qui, par pure simulation statistique, parviennent pourtant à produire des effets de sens, des effets de créativité, des effets émergents comme on les qualifie savamment si on ne les balaie pas en les traitant d’hallucinations (ce qu’ils sont aussi par ailleurs). On peut trouver cette tendance chez beaucoup d’artistes qui sont spontanément prêts à explorer ces frontières, comme le font Gregory Chatonsky ou Alain Damasio. Ou chez des chercheurs comme Marc Cavazza qui sont intrigués de voir émerger des processus qu’ils décrivent en sémantique distributionnelle, des convergences qui méritent d’être explorées. Il est vrai que dès lors qu’on connaît l’incertitude et les approximations acceptées par les développeurs de ces LLM, qui ne peuvent pas rendre compte des pondérations effectuées ni de chaînes d’opérations qui ressemblent à des raisonnements, on peut se dire qu’ils ont peut-être fait apparaitre des processus de calcul, de génération, de détection, qui sont des indices d’autres processus que seuls les artistes ou d’autres disciplines que les data sciences peuvent percevoir, sans parler de les expliquer.
J’appelle cette posture et ce quadrant nord-ouest (celui du passage!), le bac à sable créatif. Tout en étant, on l’a compris, très critique des LLM en général et plus encore de leur exploitation par les plateformes de l’IA, je me dois d’écouter ceux qui restent ébahis par les performances de tels systèmes de simulation, au point de penser qu’ils sont en train de dépasser nos capacités de compréhension (sans parler du contrôle que les firmes IA ont de toutes façons abandonnés). Tous les utilisateurs ordinaires font cette expérience d’excitation ou de sidération devant des réponses, des productions, des solutions fournies avec une rapidité inédite et très déstabilisante. L’innovation peut en effet se transformer en rouleau compresseur moderne sous la houlette de l’illimitisme des plateformes et de la classe vectorialiste mais il n’est pas définitivement dit qu’il n’existe pas d’autres voies à explorer.
J’ai moi-même tenté de jouer ce jeu avec le Big Data des plateformes en considérant Twitter comme la drosophile des sciences sociales des propagations. C’est-à-dire un laboratoire à ciel ouvert pour tester des hypothèses à partir de masses de données qu’on ne trouve nulle part ailleurs, sur une plateforme (avant Musk) où la traçabilité atteint une granularité inédite et où la viralité est amplifiée par les algorithmes. Alors même que je montrais les effets délétères d’un tel système de viralité sur les conditions du débat public, je pensais pouvoir profiter de ce terrain quasi expérimental pour tester des hypothèses sur les patterns des propagations. Et cela à condition d’accepter que Twitter ne peut pas servir d’équivalent d’un sondage d’opinion, dispositif construit pendant des dizaines d’années avec ses propres règles et ses limites.
Pour les LLM, ce sont ces limites qu’il faut pouvoir établir pour rester dans le cadre du bac à sable et éviter toute contamination à la société. Ainsi, tout ce qui a pu être produit en matière d’image IA ne poserait pas de problème, dès lors qu’un protocole strict et une étanchéité sont installées vis-à-vis de la sphère médiatique ou ordinaire de la vie sociale. Produire des deepfakes est fascinant à condition de se limiter à une expérience de laboratoire hautement contrôlée, à peu près avec les mêmes critères que ceux appliqués aux laboratoires qui testent les gains de fonction des virus. Oui les LLM sont du gain de fonction, et sont extrêmement dangereux de ce point de vue mais peuvent aussi permettre d’explorer des pistes inédites, à condition de trouver les problèmes significatifs que l’on veut y résoudre. On peut accepter certaines expériences pour les artistes, qui doivent eux-mêmes éviter la contagion de tous les systèmes de production d’œuvres fake qui détruiraient leurs propres conditions d’existence. On peut accepter certaines expériences pour les sciences cognitives et sociales sous des conditions strictes vis-à-vis des populations concernées comme on le fait en sciences cognitives expérimentales. On peut même donner des possibilités de créer des échantillons de populations synthétiques pour tester certaines hypothèses avec des modèles et des entités très riches, à condition de ne pas prétendre en tirer des leçons sur les sociétés réelles ni des méthodes de gouvernement immédiates, ce qu’on attend déjà trop de l’économie expérimentale par exemple.
Sans doute que d’autres domaines professionnels peuvent vouloir eux aussi tester avant leur mise en œuvre opérationnelle quantité d’applications à base d’IA. Ce serait ainsi l’occasion de redonner ses lettres de noblesse à la culture industrielle des tests, dont j’ai critiqué plus haut la disparition avec les passages à l’acte observées dans les développements d’IA contemporains.
Dans tous les cas cependant, il faut assurer une étanchéité avec le monde social à l’air libre pour éviter toute pollution et captation d’attention par des utilisateurs ordinaires comme par des acteurs mal intentionnés, qui auraient perçu rapidement les bénéfices commerciaux à tirer de ces innovations. Le bac à sable est donc à la fois l’acceptation de la créativité et le ralentissement de sa pénétration du corps social. Toutes les techniques ultrasensibles et à haute propagation sont gérées de cette façon, que ce soit dans la chimie, la pharmacie, ou le nucléaire. Ce que l’on déplore, c’est plus souvent une incapacité à contrôler ces essais et les tentatives de se dérober à ces protocoles de sécurité.
Pour l’IA, le moins que l’on puisse faire n’est donc pas d’abaisser le seuil de vigilance mais bien de le renforcer car ses pratiques actuelles sont totalement irresponsables. On pourrait donc au moins exiger des plateformes d’iA qu’elles atteignent le niveau d’exigence en matière de sécurité et de qualité que l’on trouve dans le nucléaire, voire dans la chimie (qui comporte pourtant déjà beaucoup de failles) ou dans la biologie. Tout plaidoyer pour une expérimentation à ciel ouvert au nom du « running code » et de la spécificité du numérique est une opération de lobbying éhontée et irresponsable. Dès lors qu’on leur propose d’effectuer toutes les expériences qu’ils souhaitent dans des environnements classifiés au même niveau que les laboratoires de gain de fonction des virus, on fournit les conditions de la créativité tout en respectant des impératifs de contrôle, certes très inhabituels pour les adeptes du libertarianisme, de John Perry Barlow et du Far-West réunis mais nécessaires à leur propre survie et à leur créativité.
L’intelligence collective augmentée
Dès lors que ces deux possibles sont préservés, soutenus et contrôlés, la sécession sémantique et le bac à sable créatif, pourquoi encore vouloir imaginer un quatrième quadrant au nord-est ? En réalité, il décrit la pratique la plus courante observée dans les organisations. Face à la pression à l’usage de l’IA générative et face à l’absence de résultats convaincants dans l’industrie (en dehors donc de la comm et du code), la désorientation est forte mais chacun apprend à composer avec les injonctions, les avantages réels et un contrôle face à des boites noires. Ce compositionnisme que Bruno Latour avait problématisé dans un manifeste n’est guère attractif comme programme politique général mais il rend très bien compte des pratiques des collectifs immergés de fait dans des environnements d’IA générative.
Ce qui devient clé alors pour éviter d’être totalement embarqué dans l’hubris du tout IA, c’est la qualité du couplage entre technique et organisation, son caractère explicite et donc discutable de façon contradictoire. Ce n’est certes pas la qualité principale du management néo-libéral que l’on subit et qui relève plus de la disruption quasi sadique que de la bienveillance et du soin pour relancer l’intelligence collective. L‘intelligence collective augmentée doit en effet devenir l’horizon de toute composition avec des éléments de systèmes d’IA appropriés. Ce couplage affiné avec précaution avec les traditions, les valeurs, les savoir-faire spécifiques des métiers permet de réencastrer les systèmes d’IA dans les organisations, dans le social en général. L’IA ne devient une réponse qu’aux problèmes que l’on veut traiter en priorité et que l’on redéfinit à cette occasion mais elle ne constitue qu’une brique d’une réponse globale et non la solution magique de l’alchimie LLM. Reprendre la main sur ces définitions des problèmes, c’est reconnaitre aussi les liens complexes de toute organisation sociale et son irréduction à un paramétrage surplombant. Cela peut comporter cependant des indicateurs et du calcul mais un calcul qui oblige à expliciter et donc à discuter et qui permet à toutes les parties concernées de participer à la discussion.
Sur ces principes, il existe des solutions qu’on appelle hybrides c’est-à-dire qui introduisent beaucoup de sémantique par les experts métiers et même les publics concernés et qui reposent de ce fait sur des briques issues de l’IA symbolique (toujours très présente avec des arbres de décisions par exemple) ou avec des versions floues comme le propose Xtractis développé par Zyed Zalila. Ces systèmes d’IA nécessitent une injection de connaissances formalisées de la part des experts du métier et c’est en cela que ces IA décisionnelles peuvent prétendre aider à des décisions fiables, ce que ne pourra jamais un agent conversationnel conçu pour répondre avec des approximations satisfaisantes pour l’utilisateur mais non robustes. Ce que j’ai décrit plus haut à propos des RAG relève de ces méthodes de maquillage sémantique indispensable pour faire marcher les LLM en situation réelle, mais on peut pousser la logique des RAG plus loin en formalisant les documents et les connaissances ainsi injectées, en abandonnant carrément le principe probabiliste des LLM.
D’autres resteront plus proches des principes des LLM mais en fournissant tous les outils de contrôle pour les rendre robustes, comme le fait par exemple Pleias, dirigée par Pierre-Carl Langlais. Il a pu mettre ainsi à disposition du public et en Open Source une base de connaissances de textes administratifs qui se transforme en outil de génération de contenus situés dans le même domaine (Guillaume Tell). Dans tous les cas, ces modèles sont plus petits, plus contrôlés avec injection de lemmatisation souvent (et non une simple tokenisation).
D’autres enfin tentent de penser le rôle direct que peut jouer le service public dans un tel environnement. Bernie Sanders propose que l’Etat prennent des parts dans les grandes entreprises de l’IA jusqu’à 50% pour pouvoir les orienter et les contrôler autrement que par la régulation qui vient toujours trop tard. Bruce Schneier comprend l’intérêt de la proposition de Sanders mais considère que cela veut dire que l’Etat se retrouvera contraint d’accompagner des stratégies gouvernées par la profitabilité sans pouvoir réellement exiger les garde-fous nécessaires, comme on l’a vu avec la propriété étatique des firmes pétrolières en Norvège. Il propose avec Nathan Sanders, en plus d’une taxation des profits ou de l’énergie consommée par ces firmes, de construire dans chaque pays une « AI Public Option » , à l’image du système de santé public ou du projet Apertus en Suisse. Les chercheurs académiques à partir de données dont ils respectent les licences ont développé un modèle LLM qui fonctionne sur une infrastructure locale suisse. Mais ce n’est pas l’enjeu de souveraineté qui est ici avancé car il peut être détourné par des firmes nationales comme on le voit avec Mistral, sans que cela change grand-chose à leur absence d’éthique et à leurs principes techniques. Il s’agit bien d’une alternative publique de ressources de base, sur lesquelles on peut imaginer des services gratuits d’origine des communs mais aussi des services commerciaux locaux dont l’usage est identifié comme socialement utile (ce qui interdirait les IA compagnons toxiques et les deepfakes par exemple).
En réalité chacun tente de surnager dans ce flux d’influences qui se propagent chaque matin avec de nouvelles annonces qui nous somment de réagir et dire si l’on adopte, si l’on s’oppose ou si l’on compose. Le drame social qui se joue dans les organisations est aggravé par l’isolement, l’expérience clandestine de l’IA dans l’ombre, de l’IA honteuse, alors que l’intelligence collective demande le partage des expériences, les plus naïves comme les plus sophistiquées. Nous manquons de cette arène de débat constitutive d’une démocratie socio-technique. Non pas pour se vanter comme sur LinkedIn de sa dernière prouesse dans la maitrise de la dernière version du modèle XYZ. Mais pour rendre compte précisément des conditions d’usage d’un dispositif technique et organisationnel (et donc aussi légal et commercial souvent) avec toutes les réinventions nécessaires, les ratages et aussi les émerveillements engendrés par ces partages d’expérience.
J’ai pratiqué longtemps cela notamment dans le domaine de la Tech éducative ou encore des méthodes numériques en sciences sociales, sans jamais céder aux diktats des offres marchandes et en fixant avec les collectifs concernés les cahiers de charges auxquels les techniques sur l’étagère ou les développeurs maisons devaient se plier. Les réseaux des communs procèdent ainsi très souvent et ils doivent désormais intégrer tous les retours d’expérience de pratiques de l’IA hybride en environnements standards (et non seulement dans des niches alternatives). Les organisations, l’Etat, les institutions, les entreprises sont en demande pour continuer à respirer malgré la pression démesurée mise par les lobbys de la tech pour la tech.
Ainsi, face au rouleau compresseur du monopole radical qui est en train de s’installer, plusieurs modes de survie sont possibles que j’ai présentés dans cette boussole. Sans doute d’autres inventeront d’autres combinaisons encore, mais l’intelligence collective que nous devons construire nécessite sans cesse d’échanger et de capitaliser sur nos expériences.
Le 1er Ministre Lecornu vient d’annoncer, au coeur des épreuves du bac et de la canicule, que tous les lycéens bénéficieraient à la rentrée prochaine, en classe de 2nde, d’une heure d’enseignement par semaine sur l’IA.
Le même gouvernement qui a aussi annoncé l’interdiction des téléphones portables au lycée dès la rentrée prochaine.
Le même gouvernement qui veut interdire les réseaux sociaux aux moins de 15 ans.
Le même gouvernement qui veut faire pousser des Data Center partout en mode « Viva
Le 1er Ministre Lecornu vient d’annoncer, au coeur des épreuves du bac et de la canicule, que tous les lycéens bénéficieraient à la rentrée prochaine, en classe de 2nde, d’une heure d’enseignement par semaine sur l’IA.
Le même gouvernement qui veut interdire les réseaux sociaux aux moins de 15 ans.
Le même gouvernement qui veut faire pousser des Data Center partout en mode « Viva Tech et Balek ».
En pleine canicule. Ne cherchez pas la cohérence vous n’en trouverez pas. Mais eux, bah oui :
Le chef du gouvernement souligne que «former à l’IA» et «réduire l’exposition aux écrans», comme avec le projet d’interdire les réseaux sociaux aux jeunes de moins de 15 ans, «participent d’une même ambition: faire de nos élèves des citoyens libres, autonomes. Condition de notre souveraineté collective».
« Participent d’une même ambition » … Alors comment te dire, Seb. Y’a rien qui va. Rien. Ces trois éléments pris successivement peuvent à la rigueur faire illusion de cohérence à la manière dont trois chansons de Michel Sardou font illusion de patriotisme mais franchement … « Les écrans », « l’IA », « les réseaux sociaux ». Rien que ça déjà. Qui partagent autant de points communs que le taboulé, la mayonnaise et le nutella.
Prétendre tout aligner pour faire oublier que l’on a tout mélangé. Là où l’immensité des enjeux et des urgences nécessite une approche systémique, c’est à dire articulée au plus près des conditions d’enseignement (y compris et surtout pratiques et matérielles) et des modalités de ce qu’est l’expérience lycéenne de l’apprentissage singulier et collectif, on a une bouillie de mesures à effet médaille, c’est à dire qui ont pour principale vocation de décorer le torse des egos qui auront été les premiers à les brandir. Le lycée (surtout) est devenu un immense fourre tout d’opportunismes politiques dans lequel chaque ministre se rêve en Derrida de chez Wish confondant la déconstruction et la reconstruction. Ce qui se déconstruit ce sont les collectifs, enseignants comme lycéens. Ce qui se déconstruit ce sont les espaces de classes et de groupe. Ce qui se déconstruit ce sont les choix que l’on multiplie de manière totalement artificielle et de plus en plus tôt pour mieux masquer les impasses et complexifier les rares lisibilités de futurs envisageables.
Toutes les enseignantes et tous les enseignants vous le diront : cette idée de mettre une heure par semaine sur l’IA en classe de 2nde qui sort comme ça pif paf pouf sans concertation à quelques jours des vacances d’été, on appelle ça une mesure fantôme (qui s’ajoute aux précédentes, EVARS, pix, e3d, etc). Ce n’est pas financé, ça sort de nulle part, on ne sait même pas qui va faire les cours et quel en sera le contenu et on a un mois et demi (de vacances) pour être prêts à la rentrée et tout doit être prêt pour la rentrée 2027 alors même que les prochains au pouvoir déferont à leur tour probablement l’essentiel de ce qui aura été fait. Ce qui compte ce n’est pas la temporalité de la mesure, ce qui compte c’est la temporalité de l’annonce de la mesure. Viva Tech et Balek. Si le foutage de gueule était un doctorat, ces gens là seraient tous Honoris Causa.
Oui bien sûr il faut former à l’IA. Bien sûr. Mais là et dans les conditions exposées ci-dessus, on ne construit pas : on sabote, on dynamite, on vaporise. C’est la méthode des vieux pubards : « Spray and Pray ». Vaporisez et priez. Mettez-en partout et attendez que ça prenne. Et si ça ne prend pas bah au moins vous en aurez foutu un peu partout.
Franchement ? Ce serait presque rigolo. Si le contexte n’était pas ce qu’il est, notamment depuis la mise à sac des réformes Blanquer qui est à l’éducation nationale ce que Patrick Bruel est à la lutte contre les violences faites aux femmes ; si une génération n’était pas en train d’étouffer sous la canicule avec en face d’elles une dynastie d’immacescibles tanches qui s’interrogent encore pour savoir si mettre des épreuves que le matin ce serait pas une bonne idée ; si la place des mathématiques n’avait pas changé tous les ans sur le cycle lycée depuis (au moins) 5 ans en dépit de toute forme de bon sens et en débit de toute forme de rationalité ; si toutes ces conditions et quelques autres n’étaient pas réunies, alors oui ce serait presque risible mais ça ne l’est pas. Et c’est un fait acquis que Lecornu, à l’instar de tous ceux qui, osera tout.
Comme ça on est bien. Vous vous souvenez de Chirac et de son « mangez des pommes » ? Bah on on garde la même DA mais on va la glow up niveau expert et on leur dira : « Buvez des Datas et mangez des tokens ». Parce que c’est notre projet.
<Mise à jour du 21 Juin> Suite à la publication de cet article, pas mal de réactions donc je précise un peu. Non il ne faut pas à tout prix « former à l’IA », par contre il est vital de former à la culture numérique et de former de manière politique à la culture numérique (donc en gros et pour faire simple, travailler autour de tout le catalogue sur ce sujet de C&F Editions
L’autre point sur lequel il y a débat c’est sur l’idée de cette supposée « même ambition« , de ce point commun in abstentia entre réseaux sociaux, écrans et IA. Là encore je maintiens ce que j’écrivais et je précise. « Les écrans » c’est avant tout une question sociale, une question d’organisation sociale, de la manière dont nos sociétés, nos vies et nos rythmes (familiaux, professionnels, amicaux) créent ou empêchent des temporalités dans lesquelles le recours aux écrans devient une clé comme l’était hier le recours à la télé ou à l’ordinateur familial du salon. « Les réseaux sociaux » c’est une question médiatique et éditoriale, et ce n’est que cela. Enfin, « l’IA » c’est une question technologique, et oui bien sûr toute technologie est politique surtout quand elle met à mal l’une des ressources actuellement les plus rivales entre un accélérationnisme industriel et notre propre survie, c’est à dire la ressource en eau.
Ce qu’il nous manque et ce que les annonces de Macron n’ont jamais permis de penser et d’installer depuis qu’il s’est fantasmé en président de la start-up nation, ce qu’il nous manque c’est une pensée politique capable d’articuler la question des temporalités et des rythmes sociaux avec celle des instances médiatiques qui les donnent à voir dans des prismes toujours plus ambivalents et des régimes de vérités désormais structurellement mouvants, et avec ce que chaque nouvelle technologie peut changer ou prendre comme place dans l’accélération ou la dilatation de ces temps et dans les choix de politiques publiques qui les mettent à leur service ou qui nous y asservissent.
À DLA, on connaît bien l’acronyme TL;DR (too long, didn’t read, « trop long ; pas lu ») que de bien peu aimables personnes nous envoient parfois après avoir pris connaissance de notre lettre d’information. Il est peu probable pourtant que l’on passe à l’étape suivante : TL;DW (too long, didn’t write : « c’est trop long à écrire, alors je ne l’ai pas écrit moi-même »), qui consiste à faire écrire ses contenus par une IA générative… Quoique, les articles seraient peut-être plus clairs, les circonv
À DLA, on connaît bien l’acronyme TL;DR (too long, didn’t read, « trop long ; pas lu ») que de bien peu aimables personnes nous envoient parfois après avoir pris connaissance de notre lettre d’information. Il est peu probable pourtant que l’on passe à l’étape suivante : TL;DW (too long, didn’t write : « c’est trop long à écrire, alors je ne l’ai pas écrit moi-même »), qui consiste à faire écrire ses contenus par une IA générative… Quoique, les articles seraient peut-être plus clairs, les circonvolutions moins alambiquées ? Allez savoir !
Mais c’est d’un autre mème dont je voulais parler. Un mème qui devrait lui aussi beaucoup moins nous être adressé, mais qu’on utilise souvent : AI;DR (AI, didn’t read) : « c’est de l’IA, je ne l’ai pas lu » ! Un jugement qu’on énonce couramment et qui décrit la transformation de notre rapport aux textes, à l’heure où tout doit aller si vite, qu’on n’a plus le temps d’écrire ni de lire. Un refus face au déferlement : « c’est de l’IA, je ne veux même pas le lire » !
A qui profite le verbiage ?
AI;DR donc. L’acronyme exprime quelque chose entre la lassitude et l’hostilité à voir des textes génératifs envahir le web. Qu’ils soient très formatés, énergiques ou lénifiants, l’expression nous dit que nous serions capables de repérer la prose des LLM à leur tiédeur, à leur style, à leurs effets (qu’importe si en vérité, nous nous trompons souvent, comme c’est le cas des enseignants qui peinent à identifier les productions génératives de leurs étudiants). Un peu comme si nous étions dotés d’un système de repérage, une boussole infaillible, alors que les textes génératifs sont souvent corrigés, amendés, modifiés par leurs auteurs, et qu’ils tiennent bien plus d’une forme de coproduction qu’autre chose. Non seulement l’acronyme nous dit que ces productions n’ont finalement pas grande importance, mais il nous dit aussi que nos erreurs d’attribution peuvent être aussi péremptoires que les réponses des chatbots à la confiance survitaminée. Il nous dit que ces productions n’ont finalement pas grande importance au risque de renvoyer avec elles des propos bien humains, un peu comme ceux qui étaient trop longs finalement, trop humains. AI;DR nous dit que ce qui est écrit n’a pas grand intérêt, qu’il soit le fait de robots ou d’humains. Ce que ça fait est bien plus important : même si ce que ça fait (écrire) devient en même temps qu’on l’énonce bien peu important puisqu’on ne lui prête plus aucune attention.
Rapidement, on est saisi d’un vertige : à quoi peuvent bien servir des outils pour produire du texte que les gens ne souhaitent pas lire ? AI;DR semble mettre en abîme le grand vide des machines à verbiage, comme pour rendre béant le vortex qui s’ouvre sous nos mots. Un peu comme vient de le proposer le moteur de traduction Kagi en permettant de traduire (après le Dothraki, le Haut Valyrien ou le Klingon quand même !) n’importe quel texte en « Linked-in speak », c’est-à-dire dans le jargon de Linked-in. En permettant de transformer n’importe quel texte en post de motivation entrepreneuriale, truffé d’emojis, de hashtags et de déconvenues transformées en leçons de vie. « Le traducteur de Kagi ne fabrique pas cette langue, il la révèle. Il en expose la mécanique, la pauvreté, le vide soigneusement emballé dans du vocabulaire managérial », s’amusait la chroniqueuse de Radio France, Constance Vilanova. Elle pointait d’ailleurs vers une étude d’un chercheur en linguistique qui a mis au point une échelle pour mesurer la réceptivité au jargon d’entreprise. Une étude qui montrait que plus on est sensible aux formules creuses, moins on performe soi-même aux tests de pensée analytique et aux tests de prise de décision. « Les grands amateurs de Linked-in speak seraient donc aussi les moins capables de repérer le vide. Ce qui crée un cercle vicieux parfait : les patrons sont récompensés pour leur langue de bois, et les équipes se peuplent progressivement de gens qui n’y voient que du feu. » Mais surtout, les personnes les plus réceptives au jargonnage ont aussi plus tendance à percevoir leurs leaders comme visionnaires, à être plus inspirées par les homélies d’entreprises et à faire plus confiance à leurs managers. « Pour certaines personnes, un discours abstrait et vaporeux peut donner l’impression de profondeur, de vision et de compétence et parfois suffit à produire de la crédibilité. Il peut aussi fonctionner comme un signal de leadership », s’amuse David Gateau… Pire, « plus la réceptivité au bullshit corporate est élevée, plus la qualité des décisions diminue ». « Les personnes les plus sensibles aux discours creux en entreprise ont tendance à choisir systématiquement les pires solutions aux problèmes », explique l’auteur de l’étude, Shane Littrell. Pourtant, l’étude montre aussi finalement que le jargon persuade et impressionne certains publics, explique The Guardian, tout comme le verbiage des LLM finalement. « N’importe qui peut se laisser berner, et nous sommes tous, selon les circonstances, susceptibles d’être influencés par des discours creux présentés de manière à flatter nos préjugés. »
Les contenus produits par l’IA sont-ils faits pour être lus ?
Le hashtag #AI;DR entérine la dépréciation des contenus génératifs, dénigrés depuis leur apparition. Comme le disait John Hermann dans le New York Mag dès 2024 : alors que l’IA est associée au summum des réalisations humaines, pour tout à chacun, elle désigne d’abord des choses assez pauvres, assez communes. Dans le langage courant, dire d’un texte qu’il a été réalisé par ChatGPT qualifie toujours un document sans grand intérêt. Aujourd’hui encore. « Pourquoi devrais-je me donner la peine de lire quelque chose que personne d’autre n’a daigné écrire ? », remarque pertinemment un développeur, relayé par Futurism. Quand on lit le propos de quelqu’un, c’est pour comprendre ce qu’il pense, perçoit et appréhende du monde. Ecrire, c’est penser. Et penser, c’est exister. Mais que signifie lire la prose d’un LLM ? QUI sommes-nous censés comprendre ? Et donc QUE sommes-nous censés comprendre ? Quelque part, les gens qui dénoncent ces contenus, disent que ce qui est écrit par l’IA ne nous est pas adressé. Que ces contenus ne sont pas vraiment pour les humains puisqu’ils ne sont pas humains.
Dans le New York Mag, John Hermann (encore lui), dénonçait récemment le cauchemar de l’e-mail piloté à l’IA : « Êtes-vous impatient de voir vos collègues devenir beaucoup plus bavards, transformant chaque simple « Ça me va » en une lettre de trois paragraphes ? Êtes-vous ravi que le genre d’e-mails de masse semi-personnalisés que vous avez l’habitude de recevoir des grandes marques dotées de services marketing (ou des spammeurs et des auteurs de phishing) soit désormais accessible à toute personne possédant un compte Google ? Avez-vous hâte de vous demander si cette charmante lettre de condoléances d’un ami perdu de vue depuis longtemps a été entièrement générée par un logiciel ou s’il a simplement cliqué sur le bouton pour rendre le contenu « plus sincère » avant de l’envoyer ? » Ce dernier exemple n’est même pas une blague, le mois dernier, l’administration de l’université Vanderbilt a dû présenter ses excuses après avoir envoyé un e-mail de condoléances aux étudiants suite à la fusillade de l’université d’État du Michigan. En bas du message il était indiqué qu’il avait été rédigé par ChatGPT !
Le Financial Times rapporte que le volume des plaintes aux services juridiques et RH des entreprises est en augmentation et que celles-ci sont plus documentées et complexes qu’avant. Ce ne sont plus de simple e-mail à traiter, mais des pièces jointes volumineuses, qui évoquent parfois des législations qui n’existent pas. La raison ? Le recours à l’IA. De plus en plus de plaintes leur arrivent « incompétentes mais sûres d’elles », « superficiellement persuasives », « excessivement juridiques sans être pertinentes »… de gens pouvant avoir des attentes irréalistes, désorientés par les réponses des IA à leurs problèmes. Le volume de récriminations augmente et le temps pour les vérifier également, au risque de ralentir les réponses des employeurs.
Reste que le besoin de formalisation que traduit le passage à un argumentaire structuré par l’IA dit peut-être autre chose du rapport employés-employeurs, où les discussions ne suffisent pas pour être écoutés…
Le New York Times, récemment, expliquait que la romance générative était en pleine explosion et que l’IA était l’avenir du genre. Pas si sûr, contestait Gita Jackson pour Aftermath, les défenseur(e)s de l’IA dans la littérature n’ont pas d’autre but que de gagner de l’argent, en produisant beaucoup de contenus et en vendant des formations pour apprendre à d’autres comment faire. L’une des autrices interviewées par le NYT prétend que ses 200 livres publiés par IA ont totalisé 50 000 ventes… soit en moyenne 250 exemplaires par livre. Ce modèle économique n’est viable que si l’on se fiche de la qualité des livres et de leur popularité, assassine Jackson. Bref, il n’est pas sûr que les romances dopées à l’IA soient l’avenir du genre, comme le défendent les autrices qui le proposent parce qu’elles y ont doublement intérêt. Pas sûr que les contenus dopés à l’IA soient finalement meilleurs que les romances incarnées par leurs autrices.
Deux exemples qui montrent que les contenus génératifs viennent s’intercaler dans les situations de blocages et viennent toujours avec les intérêts de ceux qui les portent, même s’ils ne sont pas toujours faciles à percevoir.
Pour qui écrivons-nous ?
Le mot-clé AI;DR rejoint également celui de sloppers, désignant les producteurs de slop, les producteurs de contenus qui ne produisent plus qu’avec les robots conversationnels (à l’image de la proposition parodique de sloppers.ai, qui se présente comme un service d’IA pour produire… des contenus parfaitement inutiles). Entre résistance et lassitude, le point-virgule, qui à l’origine séparait la cause de l’effet – plus vous écrivez, moins je lis – sépare désormais la production de la machine du refus de lui accorder la moindre attention.
Comme le souligne Alberto Romero, nous passons d’un monde où la longueur d’un texte constitue un obstacle à la lecture, à un monde où le manque d’implication humaine devient un obstacle supplémentaire. Nous sommes passés de « je ne finirai pas ça » à « personne n’a commencé ça ». « La première attitude suppose que l’on est responsable de ses propres limites, tandis que la seconde incite à externaliser sa responsabilité », comme si ce n’était pas à nous de lire, de vérifier, d’agréer aux productions générées. La perspective de notre submersion par les contenus génératifs, par l’intensification des productions, risque de nous laisser plus épuisé que jamais, disions-nous la semaine dernière. Non seulement nous sommes cernés par plus de contenus que jamais, mais nous sommes en même temps confrontés à une forme de post-alphabétisation où l’écrit lui-même semble de plus en plus décrédibilisé par son automatisation.
Pour Romero, l’IA;DR fait écho à son exact inverse : WF;AI (What the fuck; AI, « bordel, écrire pour l’IA ») où nous sommes confrontés au vide de sens qu’exige d’écrire pour l’IA plutôt que pour d’autres humains. Nous sommes en train de passer du pourquoi écrivons-nous à pourquoi lisons-nous, comme si le cœur même de la connaissance n’avait plus de sens, ni pour les autres ni pour nous. « Doit-on consacrer vingt minutes de son attention déjà si sollicitée à un texte qui n’a coûté à son auteur fantôme que quarante-cinq secondes et une consigne maladroite ? »
Perdus au milieu de contenus de plus en plus fantomatiques, comment s’orienter ? « La lecture, comme tout ce que nous faisons, repose sur un contrat social implicite : je vous offre ma réflexion, vous me donnez votre temps. Or, lorsque l’une des parties automatise sa part du marché, l’autre se sent légitimement flouée. Et comme déléguer la lecture n’a aucun sens pour la plupart des gens, ils ne le font tout simplement pas », constate pertinemment Romero. Le contrat de lecture exige une intention et une relation que l’IA ne peut pas produire. Le contrat de lecture est donc profondément rompu, quelles que soient ses conséquences. D’autant que dans la roue du hamster de la lecture/écriture, l’IA a tendance à exclure de plus en plus l’humain. Dans le biais anti-humain de l’IA, l’IA se nourrit de l’IA et récompense plus facilement les contenus IA faisant gonfler plus encore les contenus génératifs qu’on ne veut pas lire. Et pourtant, se moque Romero en conclusion, son texte a été écrit avec une IA. Nous même avons été pris au piège. Le contrat de lecture n’est donc pas totalement rompu, il est flouté au risque de nous abuser en continue.
C’est toute l’aporie où nous sommes réduits, comme l’illustre le dessinateur Tom Fishburne avec un de ses délicieux dessins : l’IA permet de transformer une liste à puce en un long mail qu’on peut prétendre avoir écrit et où son récepteur peut le transformer en liste à puce qu’il peut prétendre avoir lu. Tom Fishburne rappelle qu’il va falloir du temps pour apprendre quand et comment bien utiliser ces outils et surtout quand ne pas les utiliser. L’acronyme AI;DR nous rappelle que nous sommes face à des contenus dont le statut n’est pas clair, des contenus que nous ne savons pas vraiment utiliser. Peut-on vraiment en vouloir à des gens de refuser de lire des contenus qui sont produits par personne et destinés à personne, de refuser de lire des propos d’une machine, aussi séduisants ou creux puissent-ils être ?
Le risque d’une parole sans conséquence
IA;DR nous dit autre chose pourtant. Que ces mots produits sont produits. Que ce qui devait être fait est fait et que la réception est finalement un autre enjeu, comme s’il dépendait d’autres métriques.
« Pour la première fois, la parole est dissociée de ses conséquences. Nous vivons désormais aux côtés de systèmes d’IA qui conversent avec assurance et persuasion – débitant des affirmations sur le monde, des explications, des conseils, des encouragements, des excuses et des promesses – sans jamais assumer la responsabilité de leurs propos. Des millions de personnes utilisent déjà des chatbots, alimentés par de vastes modèles de langage, et ont intégré ces interlocuteurs synthétiques à leur vie personnelle et professionnelle. Les mots d’un chatbot façonnent nos croyances, nos décisions et nos actions, sans qu’aucun locuteur ne les cautionne », explique Deb Roy dans The Atlantic.
Deb Roy est professeur d’arts et de sciences des médias au MIT, où il dirige le Centre pour la communication constructive au Media Lab. Il est également cofondateur et président de Cortico, une organisation à but non lucratif qui se consacre à la construction de réseaux civiques plus forts, notamment en analysant les échanges vocaux de groupes de discussions pour en dégager liens et tendances.
Dans nos échanges avec les chatbots, ceux-ci s’excusent, corrigent, mais débitent une chose puis son contraire, vide de sens, rappelle le professeur. Pour Roy, « il ne s’agit pas d’une simple nouveauté technique, mais d’un bouleversement de la structure morale du langage ». Lorsque nous parlons, nos mots nous engagent dans un contrat social implicite. Ils nous exposent au jugement, aux représailles, à la honte et à la responsabilité. Dire ce que l’on pense, c’est prendre un risque. Le chercheur en intelligence artificielle Andrej Karpathy a comparé les LLM à des fantômes humains : ils ne sont pas des créatures, leur parole est sans conséquence, tout en étant capable de nous hanter. Pour Deb Roy, spécialiste de l’apprentissage du langage, les mots acquièrent du sens en relation avec le monde. Reste que le sens ne découle pas seulement de la fluidité ou de l’incarnation, mais aussi des enjeux sociaux et moraux que nous prenons lorsque nous parlons.Le langage a une dimension morale et sociale. Il nous engage. Il nous rend digne ou indigne, responsable. « Parler, c’est simultanément s’exposer à un jugement moral, encourir des conséquences sociales et parfois juridiques, assumer la responsabilité de la vérité et contracter des obligations qui perdurent au sein des relations. » Avec les chatbots, la parole n’est plus que procédurale. « Les chaînes causales s’obscurcissent. La responsabilité se dilue. L’autorité épistémique s’exerce sans obligation. Les engagements relationnels sont simulés sans persistance. »Cela produit non seulement un obscurcissement des responsabilités, mais plus encore un affaiblissement progressif des attentes. Le risque est de ne plus rien attendre des textes, quels qu’ils soient.
Norbert Wiener l’avait bien compris, dans ses mises en garde à l’encontre de l’automatisation : l’accroissement des capacités des machines entraînerait une perte de responsabilité humaine. Et l’efficacité elle-même éroderait la dignité humaine, nous poussant à devenir des intrants, des opérateurs ou des superviseurs de processus dont les humains ne contrôleraient plus la logique. « Ce qui rend ces systèmes moralement déstabilisants, ce n’est pas leur dysfonctionnement, mais leur capacité à fonctionner exactement comme prévu tout en se soustrayant à toute responsabilité », explique Roy.
L’histoire moderne regorge de technologies médiatiques qui ont transformé la circulation de la parole : l’imprimerie, la radio, la télévision, les réseaux sociaux. Mais aucune de ces technologies ne possédait les propriétés que les systèmes d’IA actuels réunissent simultanément. Aucune ne permettait de dialoguer et donc d’activer une vulnérabilité psychologique inédite. Avec Eliza, Joseph Weizenbaum a compris que les humains projetaient sur la machine du sens, des intentions et une responsabilité qu’elle n’avait pas. Le philosophe J.L Austin affirmait qu’utiliser le langage, c’est agir. « Tout énoncé significatif accomplit une action : il affirme une croyance, formule une revendication, formule une demande, fait une promesse, etc. Dire « oui » lors d’une cérémonie de mariage donne naissance à l’acte de mariage. Dans ce cas, l’acte n’est pas accompli par des mots puis décrit ; il est réalisé dans l’acte même de prononcer ces mots, dans les conditions appropriées. » Pour Roy, pour combattre l’effet Eliza, il ne suffit pas de savoir que ces systèmes sont des machines, car leur efficacité est amplifiée par leur fluidité. Et c’est leur fluidité qui nous conduit à déléguer nos responsabilités, à la faire glisser de l’utilisateur vers l’outil. Nous demandons désormais aux autres de prêter attention à des mots que nous n’avons pas écrits, pas pensés. Ce que nous perdons, c’est notre dignité même. « Dans le cadre d’un usage privé (comme le proposent les chatbots compagnons), l’érosion est plus subtile, mais non moins lourde de conséquences. Les jeunes décrivent leur utilisation de chatbots pour rédiger des messages qu’ils hésitent à envoyer, pour déléguer des réflexions qu’ils estiment devoir mener eux-mêmes, pour obtenir des assurances sans s’exposer, pour répéter des excuses sans rien débourser. Un chatbot dit « Je suis désolé » sans faute, mais est incapable de regret, de réparation ou de changement. Il admet ses erreurs sans conséquence. Il exprime de l’attention sans rien perdre. Il utilise le langage de la bienveillance sans rien risquer. Ces affirmations sont fluides. Et elles habituent les utilisateurs à accepter un langage moral déconnecté des conséquences. Il en résulte un réajustement discret des normes. Les excuses deviennent gratuites. La responsabilité devient théâtrale. La bienveillance devient simulée. »
Les mots eux-mêmes n’ont plus de portée. Ceux des chatbots, bien sûr, mais derrière, les mots de tous ceux qui en portent, et d’abord ceux que les autres humains nous adressent.
« Certains affirment que la responsabilité des propos de ces machines peut être externalisée : vers les entreprises, les réglementations, les marchés. Mais la responsabilité se dilue entre développeurs, déployeurs et utilisateurs, et les boucles d’interaction restent privées et inobservables. L’utilisateur en subit les conséquences ; la machine, non. »
Ceci n’est pas sans rappeler le problème éthique posé par les armes autonomes, estime Roy. En 2007, le philosophe Robert Sparrow soutenait que de telles armes violent le principe de la guerre juste, selon lequel lorsqu’un dommage est infligé, quelqu’un doit répondre de la décision de l’infliger. Le programmeur est protégé par conception, ayant délibérément construit un système dont le comportement est censé se dérouler sans contrôle direct. Le commandant qui déploie l’arme est lui aussi protégé, incapable de contrôler les actions spécifiques de l’arme une fois en mouvement, et cantonné aux rôles prévus pour son utilisation. Quant à l’arme elle-même, elle ne peut être tenue responsable, car elle est dépourvue de toute qualité morale d’agent. Les armes autonomes modernes produisent ainsi des résultats mortels pour lesquels aucun responsable ne peut être identifié de manière pertinente. Les chatbots compagnons, ces « systèmes de gestion de la vie humaine » fonctionnent différemment, mais la logique morale est la même : ils agissent là où les humains ne peuvent pas pleinement superviser, et la responsabilité se dissout dans ce vide.
« La parole sans conséquence contraignante sape le contrat social. La confiance, la coopération et la délibération démocratique reposent toutes sur le principe que les locuteurs sont tenus par leurs propos. » Notre immersion dans un monde de contenus génératifs, de propos sans conséquences, risque de nous habituer à prendre toute parole comme étant sans conséquence, même celle de nos contemporains.
« Nous avons besoin de structures qui réancrent la responsabilité : des contraintes limitant l’utilisation de l’IA dans divers contextes, tels que les écoles et les lieux de travail, et préservant la paternité des travaux, la traçabilité et une responsabilité clairement définie. L’efficacité doit être encadrée lorsqu’elle porte atteinte à la dignité », défend Roy.
Avant de pointer un autre enjeu encore : « Alors que l’idée d’« avatars » IA s’impose dans l’imaginaire collectif, elle est souvent présentée comme un progrès démocratique : elle repose sur des systèmes qui nous connaissent suffisamment bien pour parler en notre nom, délibérer à notre place et nous épargner le fardeau d’une participation constante. Il est facile d’imaginer que cela puisse se transformer en ce que l’on pourrait appeler un « État-avatar » – un système politique où des représentants artificiels débattent, négocient et décident pour nous, efficacement et à grande échelle. Mais cette vision oublie que la démocratie non plus n’est pas simplement l’agrégation de préférences. C’est la pratique de la parole ouverte. S’exprimer politiquement, c’est prendre le risque de se tromper, d’être responsable, d’assumer les conséquences de ses paroles. Un État avatar – fluide, infatigable et parfaitement malléable – simulerait la délibération, mais sans conséquence. De loin, il ressemblerait à un gouvernement autonome. De près, ce serait tout autre chose : la responsabilité rendue facultative, et avec elle, la dignité de devoir assumer ses paroles devenues obsolètes. Wiener avait compris que le tourbillon ne viendrait pas de machines malveillantes, mais de l’abdication humaine. » C’est au bord de ce précipice que nous conduit l’IA.
Ce que traduit AI;DR, c’est qu’à mesure que nous sommes cernés par ces contenus génératifs, la résistance se fait jour, estime Fast Company. Qui souligne que le terme rencontre du succès à un moment où le sentiment anti-IA se développe. Les inquiétudes concernant l’IA chez les adultes américains se sont accrues depuis 2021, selon le Pew Research Center. Plus de la moitié (51 %) se disent plus inquiets qu’enthousiastes face à l’essor de cette technologie. « C’est de l’IA, je ne l’ai pas lu ! », ne traduit-il pas d’abord que tout cela n’est pas de notre responsabilité. Que cet avenir n’est peut-être pas celui que nous avons voulu. « C’est de l’IA, je ne l’ai pas lu ! » est peut-être notre dernier semblant de résistance face à un nouveau web qui va nous submerger.
Même constat pour la journaliste Eve Fairbanksdans The Atlantic. « Travailler sur un texte généré par l’IA, en tant que correcteur, revient à opérer un corps dont la peau, les muscles, les veines, les os et les organes sont tous endommagés. Il n’y a rien à préserver, aucun point de départ », explique-t-elle confrontée à la prose des machines. « L’infltration du non sens est partout, inéluctable. Même ceux qui n’utilisent pas l’IA finiront par lui ressembler. »

 Connexion