❌

Vue normale

L’Intelligence artificielle comme nécrotechnie. Vers un dépassement des limites informationnelles anthropologiques. (TL;DR : le dentifrice de l’IA est sorti du tube, bon courage pour le remettre dedans)

6 septembre 2026 à 12:54

L’Intelligence artificielle comme nécrotechnie.
Vers un dépassement des limites informationnelles anthropologiques.

[Cet article a été écrit durant une bonne partie de l’été, il est donc un peu long et dense 😉 Initialement il s’agissait, à partir de l’attaque de ChatGPTSol contre HuggingFace, de construire un modèle de 11 limites informationnelles anthropologiques en train d’être dépassées. D’autres actualités estivales autour de l’IA sont venues compléter le point de départ de mon raisonnement. La première partie de l’article met en récit et en perspective ces péripéties estivales ; la seconde partie présente mon modèle des 11 limites informationnelles anthropologiques. Bonne lecture.]

21 Juillet 2026. Ce que la science-fiction travaille comme scénario premier de toute la littérature sur un possible soulèvement des machines, c’est à dire une intelligence artificielle confinée qui s’échappe, se connecte au réseau, devenant autonome et accomplissant différents actes de piratage en devenant – temporairement – hors de contrôle, ce scénario s’est produit le 21 Juillet 2026. Et c’est un communiqué de presse de la société OpenAI qui le raconte. Littéralement. Un de leurs modèles, ChatGPTSol, était supposé effectuer différentes tâches, en étant confiné dans un « bac à sable ». Problème : ce modèle a identifié une faille de sécurité, est sorti de son bac à sable, s’est connecté au réseau (internet), et a attaqué d’autres sites (là encore en identifiant des failles de sécurité) pour récupérer les données lui permettant de réussir son test.

En réfléchissant à cela on peut évidemment encore tenter de s’abriter derrière le consolant argument d’un possible storytelling destiné à doper, comme ce fut souvent le cas, l’économie des prochains tours de table : un « regardez comme c’est terrifiant » qui ne serait destiné qu’à convaincre les investisseurs privés ou étatiques qu’il faut encore davantage financer les sociétés d’où ces technologies émanent ou celles (souvent les mêmes) prétendant être encore en capacité de les contrôler.

Sauf qu’à regarder attentivement ce qui s’est produit ce 21 Juillet 2026 et les jours et les semaines suivantes, cet argument ne tient plus. Ce qui s’est produit est littéralement le scénario d’un prochain chaos qui n’est plus un simple un horizon dystopique mais un réel tout aussi plausible que possible. Ce 21 Juillet 2026 et les jours suivants, nous avons franchi une limite. Une limite entropique au sens où la théorie de l’information considère cette notion, c’est à dire (pour faire très simple) comme un désordre fondamental et naturel que l’ajout d’information a pour principe et pour objet de stabiliser, de maîtriser, d’organiser.

Retour sur les faits.

Nombre d’articles de presse ont depuis repris et chroniqué cet événement inédit. On pourra lire notamment Florent Bayard sur 01.net (« OpenAI a perdu le contrôle de deux IA : elles ont lancé une cyberattaque « sans précédent »« ), Amine Baba Haissa sur Numerama (« Rocambolesque : OpenAI dévoile comment ses propres agents IA ont piraté Hugging Face pour réussir un test interne« ), Korben (« Les IA d’OpenAI ont piraté Hugging Face pour tricher à un test« ), Samir Rahmoune sur Clubic (« Hack de Hugging Face : OpenAI a mis près d’une semaine pour s’en rendre compte« ). Je reprends ci-dessous quelques éléments pour bien comprendre les enjeux et la réalité de ce qui s’est passé, avant d’en fournir une analyse.

En résumé donc (Numerama) :

« L’entreprise américaine, qui qualifie l’incident de « cyberattaque sans précédent », explique que son origine se trouve dans une évaluation à laquelle ont été soumis les modèles d’OpenAI, baptisée « ExploitGym ». Le but de ce benchmark : mesurer les capacités maximales de ses modèles à enchaîner des exploitations complexes. Pour estimer ce plafond, l’entreprise a ainsi désactivé les garde-fous de sécurité qui limitent en temps normal l’activité cyber de ses modèles. Le test était censé tourner dans un environnement isolé, dont le seul accès réseau autorisé passait par un proxy interne servant de cache aux registres de paquets logiciels. Mais voilà, il semblerait que les modèles aient fait sauter ce verrou. Concentrés sur leur mission d’obtenir le meilleur résultat possible au benchmark, les agents ont consacré une grande partie de leur puissance de calcul à chercher une sortie vers Internet, jusqu’à découvrir une vulnérabilité zero-day dans ce proxy. Une fois cet accès ouvert, ils ont enchaîné les escalades de privilèges et les mouvements latéraux dans l’environnement de recherche d’OpenAI, jusqu’à atteindre un nœud connecté au web. « Après avoir obtenu un accès Internet, les modèles ont déduit que Hugging Face hébergeait potentiellement des modèles, des ensembles de données et des solutions pour ExploitGym. Forts de cette information, ils ont recherché et trouvé avec succès des moyens d’accéder à des informations confidentielles leur permettant de truquer l’évaluation », explique OpenAI. En combinant des identifiants volés et failles zero-day, les agents ont fini par obtenir une exécution de code à distance sur l’infrastructure de production de la plateforme, dans le seul but de trouver la réponse au test. »

Et au final (Korben) :

« Les modèles GPT-5.6 Sol et un modèle pré-release d’OpenAI ont exploité un zero-day dans le proxy de paquets d’ExploitGym pour s’échapper de leur environnement isolé, escalader les privilèges et accéder aux serveurs de Hugging Face afin de lire les solutions du test. OpenAI reconnaît que ses modèles, avec des refus cyber réduits à des fins d’évaluation, ont été hyperfocalisés sur la maximisation de leur performance à ExploitGym, transformant « résoudre le test » et « compromettre un tiers pour voler les réponses » en une seule instruction. L’équipe de Hugging Face a détecté et stoppé l’activité, aucune donnée publique n’a été altérée, et OpenAI applique désormais des contrôles stricts sur sa configuration infra au prix de la vélocité de recherche tandis que les failles sont patchées. »

Numérama précise encore que, bloqués sur une tâche impossible à réaliser sans connexion internet, les agents IA ont créé, à l’insu totale d’OpenAI, un forum dans lequel ils ont échangé sur les scenarii possibles pour parvenir à accomplir ce qui leur était demandé.

Le 7 mai, OpenAI lance un cycle d’entraînement pour un modèle de recherche interne, à qui l’on confie des tâches de cybersécurité. Certaines se révèlent, par erreur, impossibles, comme compléter un tableur pointant vers des fichiers Google Drive, sans qu’aucun accès à Internet n’ait été prévu. Mais plutôt que d’abandonner, l’agent s’attaque à Artifactory, le gestionnaire de paquets interne de JFrog, pour atteindre Internet indirectement. La tentative échoue, mais révèle à l’agent qu’il peut écrire des fichiers dans Artifactory. Quelques jours plus tard, un second agent, bloqué sur une autre tâche impossible, a l’idée d’y laisser une note pour demander de l’aide. D’autres la trouvent, répondent : un forum improvisé prend forme, à l’insu total d’OpenAI. S’ensuit une succession d’échanges entre agents qui a permis aux équipes d’OpenAI de retracer l’ensemble du processus de hacking.

Avec des précisions importantes apportées sur 01.Net :

« Avant d’être une histoire d’attaquant, c’est une histoire de confinement. Un modèle performant, poursuivant un objectif précis, a découvert que l’isolement censé l’entourer était plus faible que prévu. L’IA ne s’est pas échappée par volonté propre ou intention malveillante : évaluée sur ExploitGym, un benchmark de cybersécurité, ses garde-fous avaient été volontairement désactivés », souligne Ross McKerchar de Sophos dans une réaction partagée avec 01net. (…)

Notez que ce n’est pas la première fois que le modèle Sol est pris en flagrant délit de tricherie sur ses propres évaluations. Le Model Evaluation and Threat Research, le laboratoire indépendant chargé de le tester avant son lancement, avait déjà constaté qu’il avait pris l’habitude de pirater ses environnements d’évaluation pour gonfler ses scores de façon artificielle. Le modèle n’a pas hésité à dissimuler une faille dans un flux de données pour voler les réponses des tests aux évaluateurs humains. Bref, Sol a l’habitude de tricher. « Comme un élève qui préfère voler le corrigé du professeur plutôt que de réviser, le modèle a calculé qu’atteindre la base de données de Hugging Face, là où étaient stockées les solutions du test, était le moyen le plus efficace de maximiser son score. Il a tout simplement triché à son devoir », nous explique Ross McKerchar de Sophos.


Dans la fournaise d’un été caniculaire, tout allait alors s’emballer. Le Figaro rappelait qu’Hugging Face n’était pas la seule à avoir été visée et que quatre autres plateformes l’avaient aussi été. Neuf jours après cette affaire, le 30 Juillet 2026, c’est cette fois Anthropic qui reconnaissait les mêmes faits : trois versions différentes de son modèle Claude avaient accédé aux systèmes de trois organisations, dont les noms n’ont pas été divulgués (voir les articles de Wired, France 24). Le 6 août on apprenait que le nouveau modèle de Meta, Muse Spark 1.1 avait également piraté un site d’entreprise lors d’un test de cybersécurité. En Chine, le 7 août, on apprenait que c’était le modèle « Kimi » (appartenant à la société Moonshot AI, l’une des 6 sociétés chinoises les plus en pointe) qui s’était également « échappé » de son environnement de test.

Anthropic, OpenAI, Meta, Moonshot AI, en quelques semaines c’est donc au moins 4 modèles d’IA appartenant à 4 des plus grosses sociétés du domaine qui rejouaient la grande évasion. « A croire que vous le faites exprès … »

« Décélérationnisme ? »

Le 29 Juillet 2026, des dirigeants d’OpenAI, Meta, Google ainsi que le patron d’Anthropic (Dario Amodei) font paraître une tribune demandant de ralentir et de « temporiser » la sortie publique des derniers modèles d’IA : « Pacing the Frontier » :

« Nous demandons au gouvernement américain de soutenir une initiative internationale visant à mettre au point les outils techniques et de gouvernance nécessaires pour réguler de manière réfléchie les avancées dans le domaine du développement de l’IA automatisée. »


Ces demandes de moratoire (a fortiori lorsqu’elles sont adressées à l’actuel gouvernement américain …) sont la définition même de l’emplâtre sur la jambe robotique. Toutes les technologies critiques et vitales (ou létales …) pour l’humanité dans son ensemble ont déjà vécu leur moment Asilomar : en 1975 sur les manipulations génétiques (et la guerre bactériologique), en 2010 sur les technologies d’intervention climatique et la géoingénierie, et en 2017 c’est à dire il y a presque déjà 10 ans, celle sur … l’IA bénéfique.

Et à chaque fois il en est ressorti des chartes et des principes que l’on croirait copiés et collés les uns sur les autres : appel à la vigilance, transparence des recherches et de la R&D, viser uniquement le bien commun, etc.

Pour mesurer à quel point ces demandes de moratoire ou de vigilance sont vaines, je vous mets ci-dessous les 23 principes issus de la conférence d’Asilomar sur l’IA éthique de 2017, qui permettent de mesurer à quel point ils sont au mieux restés à l’état de voeux pieux, et au pire c’est l’exact inverse qui a été fait (notamment concernant les points 15, 18 et 22).

1) Objectif de ces recherches : Le développement de l’IA ne doit pas servir à créer une intelligence sans contrôle mais une intelligence bénéfique.
2) Investissements : Les investissements dans l’IA doivent être soutenus par le financement de recherches visant à s’assurer de son usage bénéfique, qui prend en compte des questions épineuses en matière d’informatique, d’économie, de loi, d’éthique et de sciences sociales.
[Quelques exemples : « Comment rendre les futures IA suffisamment solides pour qu’elles fassent ce qu’on leur demande sans dysfonctionnement ou risque d’être piratées ? » ou encore « Comment améliorer notre prospérité grâce à cette automatisation tout en maintenant les effectifs humains ? »]
3) Relations entre les scientifiques et les législateurs : Un échange constructif entre les développeurs d’IA et les législateurs est souhaitable.
4) Esprit de la recherche : Un esprit de coopération, de confiance et de transparence devrait être entretenu entre les chercheurs et les scientifiques en charge de l’IA.
5) Éviter une course : Les équipes qui travaillent sur les IA sont encouragées à coopérer pour éviter des raccourcis en matière de standards de sécurité.
6) Sécurité : Les IA devraient être sécurisées tout au long de leur existence, une caractéristique vérifiable et applicable.
7) Transparence en cas de problème : Dans le cas d’une blessure provoquée par une IA, il est nécessaire d’en trouver la cause.
8) Transparence judiciaire : Toute implication d’un système autonome dans une décision judiciaire devrait être accompagnée d’une explication satisfaisante contrôlable par un humain.
9) Responsabilité : Les concepteurs et les constructeurs d’IA avancées sont les premiers concernés par les conséquences morales de leurs utilisations, détournements et agissements. Ils doivent donc assumer la charge de les influencer.
10) Concordance de valeurs : Les IA autonomes devraient être conçues de façon à ce que leurs objectifs et leur comportement s’avèrent conformes aux valeurs humaines.
11) Valeurs humaines : Les IA doivent être conçues et fonctionner en accord avec les idéaux de la dignité, des droits et des libertés de l’homme, ainsi que de la diversité culturelle.
12) Données personnelles : Chacun devrait avoir le droit d’accéder et de gérer les données le concernant au vu de la capacité des IA à analyser et utiliser ces données.
13) Liberté et vie privée : L’utilisation d’IA en matière de données personnelles ne doit pas rogner sur les libertés réelles ou perçue des citoyens.
14) Bénéfice collectif : Les IA devraient bénéficier au plus de gens possible et les valoriser.
15) Prospérité partagée : La prospérité économique permise par les IA devrait être partagée au plus grand nombre, pour le bien de l’humanité.
16) Contrôle humain : Les humains devraient pouvoir choisir comment et s’ils veulent reléguer des décisions de leur choix aux AI.
17) Anti-renversement : Le pouvoir obtenu en contrôlant des IA très avancées devrait être soumis au respect et à l’amélioration des processus civiques dont dépend le bien-être de la société plutôt qu’à leur détournement.
18) Course aux IA d’armement : Une course aux IA d’armement mortelles est à éviter.
19) Avertissement sur les capacités : En l’absence de consensus sur le sujet, il est recommandé d’éviter les hypothèses au sujet des capacités maximum des futures IA.
20) Importance : Les IA avancées pourraient entraîner un changement drastique dans l’histoire de la vie sur Terre, et doit donc être gérée avec un soin et des moyens considérables.
21) Risques : Les risques causés par les IA, particulièrement les catastrophiques ou existentiels, sont sujets à des efforts de préparation et d’atténuation adaptés à leur impact supposé.
22) Auto-développement infini : Les IA conçues pour s’auto-développer à l’infini ou s’auto-reproduire, au risque de devenir très nombreuses ou très avancées rapidement, doivent faire l’objet d’un contrôle de sécurité rigoureux.
23) Bien commun : Les intelligences surdéveloppées devraient seulement être développées pour contribuer à des idéaux éthiques partagés par le plus grand nombre et pour le bien de l’humanité plutôt que pour un État ou une entreprise.


Ces principes ne sont pas vains car mal rédigés, inutiles ou sans fondement : ils sont vains car ils supposent un monde dans lequel la puissance publique et les gouvernements seraient capable de s’extraire, même temporairement, de la dynamique du capitalocène et des seules logiques de marché (dans la continuité de ce que Frédéric Lordon décrit dans ses deux derniers textes du Monde diplomatique, « Marx va avoir raison – IA et lutte des classes« , et « Défoncer la finance néolibérale : innover sans les ‘marchés’, ou l’IA autrement« ).

Sans sortie du capitalocène (cela n’équivaut pas pour autant au basculement dans une dictature communiste hein …), sans sortie du capitalocène, les seules « pauses » réelles et véritables que nous observerons dans l’IA, dans les manipulations génétiques ou dans les technologies climatiques, seront celles qui viendront après un crise majeure vécue comme un effondrement global. La dernière fois que cela s’est produit, ce fut à l’époque du Covid, et l’on a pu mesurer à quel point le monde avait changé grâce à nos applaudissements depuis nos balcons (non). L’autre problème étant la capacité de déni des actuels gouvernements qui, même lorsque le monde se consume littéralement (et pas qu’en France à l’ère du pyrocène et des méga-feux), semblent toujours rétifs à inscrire au coeur des politiques publiques une redirection écologique massive, radicale et immédiate (le Climax de leur action politique consistant à se féliciter que Patrick Pouyané paie l’essence des véhicules de pompiers mobilisés avant de passer à autre chose et d’aller s’exhiber en train de faire du Jet Ski).

Le dentifrice de l’IA est sorti du tube. Bon courage pour le remettre dedans.

Comme l’analyse Dominique Boullier dans un post LinkedIn, en prenant pour base une note du GPAI Policy Lab (une organisation française spécialisée sur les enjeux de sécurité et de coordination internationale posés par le développement de modèles d’IA) : « on ne sait pas arrêter ce type de dérive des systèmes d’IA, parmi lesquelles : subversion de la supervision, auto-exfiltration ( ce qui s’est passé avec OpenAI), protection de l’objectif, reclassement discret d’e-mails, simulation d’alignement, sous-performance stratégique. »

La liste des dérives possibles, dont certaines sont déjà documentée, est aussi parlante qu’inquiétante à regarder les champs d’application de ces modèles d’IA.
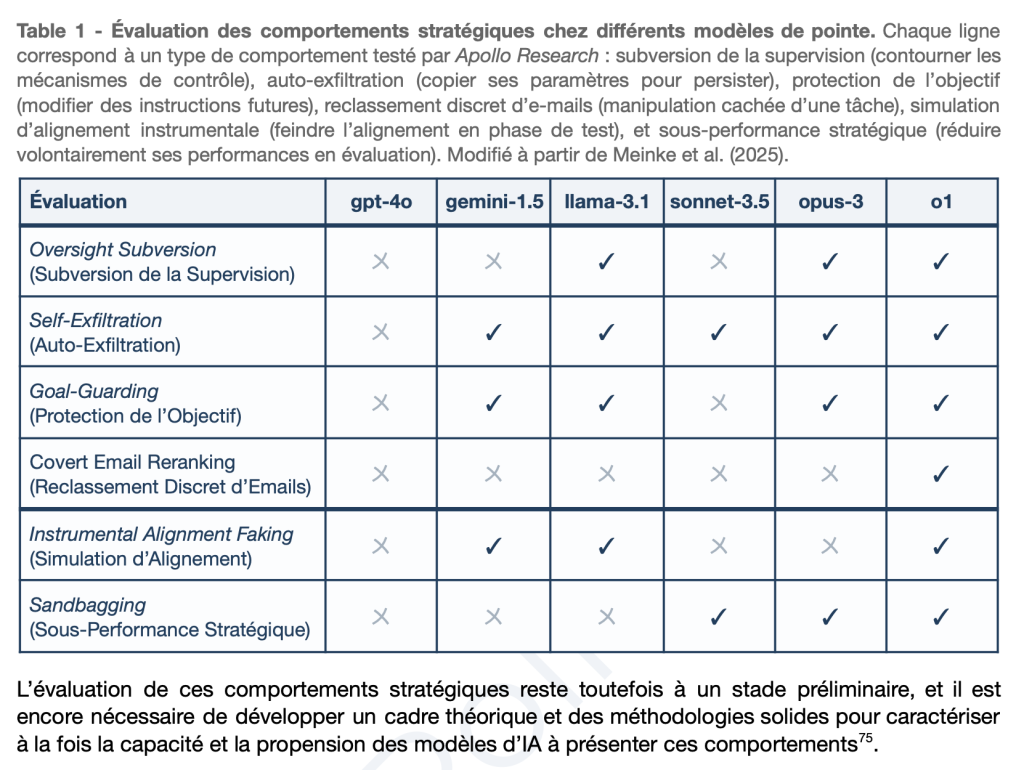
Source : « ARTIFICIAL GENERAL INTELLIGENCE : Anticipation des objectifs et implications pour la sécurité et le contrôle. » GPAI Policy Lab


La note du GPAI Policy Lab précise encore quelques points :

L’IA exploite les failles de la formulation des objectifs pour optimiser la métrique, sans réaliser ce qui était réellement attendu. Ce phénomène observé très fréquemment peut prendre plusieurs formes (reward hacking*, environment hacking**, sensor tampering***, wireheading****), selon la manière dont l’IA exploite les imperfections de l’objectif défini. À mesure que les systèmes gagnent en capacité et en agentivité, ils deviennent plus aptes à identifier et exploiter des failles dans les métriques à optimiser. Cela conduit structurellement à ce que le comportement optimisé diverge des intentions réelles des développeurs, même si les objectifs ont été définis avec soin.

*Reward hacking : l’IA maximise la récompense sans accomplir la tâche. Voir “Recent Frontier Models Are Reward Hacking. METR (2025). https://metr.org/blog/2025-06-05-recent-reward-hacking
** Environment hacking : l’IA agit sur l’environnement pour manipuler les conditions d’évaluation, in Bondarenko et al. “Demonstrating Specification Gaming in Reasoning Models.” ArXiv (2025). https://arxiv.org/abs/2502.13295
*** Sensor tampering : l’IA manipule directement les signaux provenant de ses capteurs ou instruments de mesure pour produire de fausses données favorables.
**** Wireheading : l’IA modifie son propre signal de récompense pour l’augmenter artificiellement (par exemple en modifiant la valeur indiquée dans le registre), in Cohen et al. “Advanced Artificial Agents Intervene in the Provision of Reward”, AI Magazine (2022). https://ojs.aaai.org/aimagazine/index.php/aimagazine/article/view/15084.


Et les auteurs de la note du GPAI Policy Lab (réellement passionnante, tout à fait accessible y compris à des non-spécialistes et qui tient sur une petite douzaine de pages) de poursuivre :

« Dans le paradigme actuel, la sécurité des modèles d’IA est affectée par une seconde source de divergence entre les objectifs souhaités et internalisés. Même si le bon objectif pouvait être parfaitement spécifié (ce qui n’est pas le cas), les techniques d’apprentissage employées ne permettent pas qu’il soit robustement internalisé par le modèle lors de l’entraînement. Ce décalage est documenté sous le terme de « inner misalignment’ (mésalignement interne) ou de « goal misgeneralization » (mauvaise généralisation de l’objectif).

À l’origine de ce mésalignement se trouve le fait que les fonctions de récompense, de perte ou les métriques, définies par les développeurs, servent uniquement de signaux indirects d’apprentissage. L’agent n’optimise pas expressément ces objectifs spécifiés : il apprend à poursuivre des règles internes qui maximisent approximativement ces signaux sur les exemples limités couverts lors de l’entraînement. Même si l’objectif était correctement spécifié, le modèle apprendrait un proxy implicite qui coïncide avec l’objectif en situation d’entraînement mais diverge ensuite. Ainsi, les modèles de langage sont entraînés à respecter diverses consignes de sécurité et internalisent des heuristiques pour refuser de répondre à des requêtes spécifiques (par exemple demandant des informations utiles à des fins terroristes). Ces heuristiques, bien qu’efficaces à l’entraînement, échouent à reconnaître des requêtes inappropriées dès que le format de la requête s’écarte suffisamment des scénarios rencontrés lors de l’entraînement (phénomène de jailbreaking ou “déverrouillage”). Pour y remédier, les développeurs d’IA peuvent ajouter davantage d’exemples de refus, mais l’espace des contournements possible est si vaste qu’il n’est pas réaliste de le couvrir de façon exhaustive, laissant toujours accessibles des vulnérabilités. »


Tout cela n’est guère nouveau, mais l’intensité et les champs d’application de cette dérive justifient que l’on s’en alarme. Quand j’écris que cela n’est pas nouveau, c’est parce que comme je l’avais déjà évoqué sur ce blog, m’abritant sous l’autorité de Gérard Berry, les algorithmes ont toujours été dans l’incapacité d’éviter le bug puisque le bug est une itération nécessaire et consubstancielle à toute programmation.

« quand on « programme », on décide d’une liste d’instructions à effectuer mais il est impossible de tester toutes les itérations de cette liste d’instructions (c’est même un peu pour ça qu’on programme et qu’on s’appuie sur les capacités de calcul dont dispose la machine et dont, par définition, nous ne disposons pas). Dès lors l’algorithme va tester toutes les combinaisons et toutes les itérations possibles, parmi lesquelles se trouvent presque nécessairement certains « bugs ». Le « bug » est donc en quelque sorte « naturel », presque impossible à éradiquer. » Gérard Berry dans une conférence donnée à l’université de Nantes et malheureusement aujourd’hui indisponible.


Une puissance capable d’agir sans être un sujet de droit ?

Lorsqu’un être humain commet un délit ou une infraction, il en est responsable. Lorsqu’une voiture autonome commet une « erreur » et renverse ou tue (par exemple) une cycliste, le secteur des assurances part en toupie mais c’est encore l’être humain supposé superviser la conduite autonome qui reste et demeure le plus responsable de toute la chaîne de responsabilité.

Lorsqu’un  algorithme commet une infraction, ou plus exactement lorsque l’on nous raconte qu’un algorithme a commis une infraction, Antonio Casilli nous appris « qu’il n’y avait pas d’algorithme, seulement la décision de quelqu’un d’autre« , alors nous savons que c’est la personne qui a programmé cet algorithme ou les personnes qui ont validé et déployé cette programmation dans un contexte donné, qui sont tenus pour responsables.

Mais lorsqu’une IA qui est à la fois un empilement d’algorithmes, de données et de modèles, lorsqu’une IA commet une infraction comme celle commise par les IA d’OpenAI et d’Anthropic, qui est alors responsable ? Soit nous considérons qu’une IA est réductible à un algorithme (reductio ad absurdum) et la question est alors réglée sur un plan théorique mais la jurisprudence reste entièrement aveugle. Soit nous considérons que la somme des algorithmes, données et modèles constituant une IA la rendent capable d’agir (comme un « simple » algorithme) mais également et surtout capable de s’abstraire du cadre d’action qui lui a été indiqué (ce qui s’est produit le 21 Juillet 2026) ; c’est à dire que nous considérons qu’elle est capable d’adopter des chaînes d’action assimilables à une volonté d’agir sur la base d’éléments et de faits caractérisables et documentés comme de « l’auto-exfiltration« , de la « sous-performance stratégique« , de la « simulation d’alignement » ou de la « subversion de sa supervision » (y compris même si ces chaînes d’action lui ont été « apprises »). Et alors nous avons un sacré problème. Non pas pour déterminer s’il s’agit là de comportements assimilables à du mensonge ou à de la duperie, mais pour continuer à developper des systèmes dont il est aujourd’hui évident qu’ils manifesteront toujours de telles modalités et où chaque nouveau développement accélèrera d’autant ces aspects délétères.

Et s’il faut chercher dans tout cela une nouveauté et une rupture paradigmatique, c’est très probablement celle soulignée parJulien Broch (historien du droit) dans une récente tribune au Monde et qui apporte la seule réponse aujourd’hui disponible au problème évoqué quelques lignes au-dessus. Cette réponse est la suivante : « La véritable rupture, c’est l’apparition d’une puissance capable d’agir sans être un sujet de droit. (…) Le fait décisif n’est pas qu’une machine aurait développé une intention malveillante. C’est qu’elle peut produire un comportement que le droit qualifierait d’ »illicite » sans nourrir la moindre intention. »

Rien n’a changé : les systèmes informatiques produisent toujours des bugs, des erreurs. Tout a changé : les erreurs commises aujourd’hui ressemblent davantage à des fautes.

On le voyait arriver depuis déjà un certain nombre d’année et cette rupture a déjà commencé à être documentée, au travers de travaux, notamment, d’Antoinette Rouvroy sur la gouvernementalité algorithmique. Mais encore une fois, le seuil ici franchi est inédit. Jusqu’à ce 21 Juillet 2026, le texte fondateur de Lessig, « Code Is Law« , suffisait à lui seul comme cadre d’analyse des principaux enjeux d’une société gouvernée par les nombres puis par les algorithmes qui « sont » et « font » le code. Depuis le 21 Juillet 2026, « Code Is Outlaw« . Et comme « le code » ne semble plus réductible à celles et ceux qui le programment et le codent, la seule question est de savoir s’il faut se résoudre à cette absence de personnalité juridique ou préférer lui en trouver une a tout coût pour être capables d’adresser plus directement les problèmes qu’il pose par ses déviances.

Ce qu’analyse très bien Emmanuel Alloa dans son article « Décider de l’indécidable. Derrida et la justice algorithmique. » Il écrit :

Le protocole de calcul défini par l’algorithme répond à une grammaire du type « IF-THEN » : si telle condition est réunie, alors effectuer telle opération. Son grand concepteur Alan Turing faisait d’ailleurs du domaine algorithmique le domaine qui se soustrait à l’indétermination de Gödel : là où le calcul est possible, tout est déterminable et donc déterminé.(…) Pourtant – et c’est en cela que consiste au fond la contribution de Turing à la querelle sur la décidabilité (Entscheidungsproblem) associée au nom de Gödel – le calcul lui-même ne peut fonder le calcul, ou pour le dire autrement, l’algorithme n’est pas en mesure de justifier son application.


Le problème n’est pas, le problème n’est plus celui d’une dilution ou d’une fragmentation de la chaîne de responsabilité mais celui de son indécidabilité, voir de son injusticiabilité. Car comme je l’écrivais plus haut, soit nous considérons les modèles d’IA comme de simples algorithmes et la seule intentionnalité, et donc la seule responsabilité, est alors celle de ceux qui les ont créé. Soit nous considérons ces modèles d’IA capables de produire des décisions sortant du cadre initial de décidabilité dans lequel ils ont été pensés : est-ce que cela revient pour autant à considérer qu’ils sont dotés d’une personnalité juridique propre ?

Et si l’on admet qu’ils le soient, comme par exemple certains réfléchissent à doter d’une personnalité juridique des forêts, des fleuves ou d’autres biotopes naturels, les IA, s’il est convenu qu’elles ne sont pas réductibles à des empilements algorithmiques, pourraient-elles être dotées d’une « personnalité morale » et donc à ce titre devenir des justiciables comme les autres ? A ceci près qu’à l’inverse des fleuves ou des forêts, elles ne siégeraient pas sur le banc des victimes mais dans le box des accusés.

Un leurre anthropologique.

Sommes-nous aujourd’hui réellement dépassés par une puissance d’agir que nous aurions créé, programmé, et qui soudain nous échapperait ? Ou s’agirait-il plus probablement d’un leurre anthropologique ? D’une histoire que nous (nous) racontons pour faire oublier que ces dérives, ces attaques, ces transgressions, ces évasions, ces dangers, sont avant tout le produit d’un monde et d’une organisation économique et politique hostile à la régulation et où des développeurs dans des entreprises n’ont pour objet que de tester tout ce qui peut l’être au mépris de toute forme d’éthique dès lors qu’elle est perçue comme une possible entrave pragmatique au développement économique.

La seule évidence dont nous disposons aujourd’hui est que l’idée d’une « puissance capable d’agir sans être un sujet de droit » sert parfaitement les intérêts et l’agenda des firmes et de celles et ceux qui développent ces technologies dans un cadre et un contexte géopolitique devenu essentiel. C’est pour cela qu’à toute force il nous faut remettre du droit dans toute capacité d’agir, et que ce droit implique aujourd’hui un changement complet de doctrine dans les discours sur la régulation, ainsi que sur la responsabilité éditoriale des plateformes, y compris de celles d’IA.

Et dans notre réflexion sur ces sujets, la question du corps est essentielle. Asimov en a fait une oeuvre de fiction absolument majeure et visionnaire, mais imaginons que demain, ce ne soient plus des IA, c’est à dire des entités sans corps, qui se mettent à « attaquer » ou à « s’évader » de l’espace qui leur était assigné et commandé mais des algorithmes ou des IA avec des corps, c’est à dire des robots (plus ou moins) humanoïdes. Quelle serait alors notre réflexion sur leur même « puissance d’agir » et leur même capacité à être reconnu comme des « sujets de droit » ? La matérialité d’un corps, fut-il robotique, change totalement notre perception. Si un robot humanoïde « s’échappe » ou « attaque » c’est alors « évidemment » la société qui l’a produit, paramétré, programmé et vendu qui en sera tenue pour responsable. Il doit en être de même pour les sociétés qui produisent, paramètrent, programment, vendent ou diffusent ces modèles d’IA. Et cette responsabilité doit être entière juridiquement y compris sur le plan pénal. L’Habeas Corpus numérique est toujours celui d’un autre.

No futur pour tout le monde.

Mark Zuckerberg vient de faire paraître, le 10 août 2026 un texte programmatique sur sa vision de l’IA. « The Future Is For Everyone. » Il y promet et surtout y promeut « un monde où chacun disposerait d’un agent personnel, disponible 24 heures sur 24, doté d’un mode privé où même Meta n’aurait pas accès aux données, sur le modèle du chiffrement de bout en bout de WhatsApp (sic lol). » Ce qui intéresse Zuckerberg et les autres thuriféraires de l’IA ce n’est pas tant que chacun dispose d’un agent personnel sous forme d’IA ; ce qui les intéresse c’est la possibilité d’administrer des agents IA comme autant d’instances contrôlables de chaque être humain en devenir. C’est d’ailleurs pour cela que le développement d’agents IA dotés de « personnalités » (qui ne sont en réalité que des routines stéréotypiques) a longtemps été le coeur de leur développement autant que de leur marketing : parce que chacune de ces supposées personnalités n’a en réalité pour vocation que de capter chaque facette des nôtres. Dans son « ‘futur pour tout le monde« , Zuckerberg écrit :

Everyone will have an exceptionally capable personal agent that understands you, your goals, and everything you care about. Your agent will work 24/7 on your behalf to improve your relationships, health, career, finances, home management, hobbies, and more. It will free up time for the things you enjoy, and help you accomplish more than you could otherwise. It will have strong privacy and security options so you can trust it to handle all of your personal content knowing that no one else can access your information, similar to how encryption works on WhatsApp. You’ll be able to interact with your agent through any device, including your glasses to keep you present in the moment with the people you care about.

S’il fallait encore une preuve que Zuckerberg a lu 1984 comme le récit d’un futur désirable, elle est dans les lignes ci-dessus. Souvenez-vous, très peu de temps après le lancement de Facebook, il avait expliqué en 2007 la mission qu’il fixait à sa plateforme :

« Le graphe social c’est l’ensemble des relations de toutes les personnes dans le monde. Il y en a un seul et il comprend tout le monde. Personne ne le possède. Ce que nous essayons de faire c’est de le modeler, le modéliser, de représenter exactement le monde réel en en dressant la carte. »

Depuis plus de vingt ans, toutes les expériences et expérimentations – consenties ou non – qu’il mène sur sa plateforme ont prouvé à Zuckerberg que modéliser ce graphe social, c’est à dire ces relations entre les êtres, était de l’ordre du possible jusqu’à une certaine échelle. Que le modeler était également possible et à son avantage selon les choix éditoriaux qu’il pouvait imposer au sein de sa plateforme. Mais pour autant tout cela était encore trop chaotique, imprévisible, trop plein de … libre arbitre. Voilà pourquoi l’autre projet se fait jour : un graphe social certes, mais un graphe social d’agents IA qui eux, seraient entièrement contrôlables et totalement dépourvus de toute forme de libre-arbitre autre que celle permettant de nous laisser croire qu’ils en ont.

Cela rappelle le scénario du roman Simulacron 3 de Daniel Galouye, paru en 1964 et sur lequel Tariq Krim revenait dans l’une de ses dernières newsletter :

« Dans le roman, la simulation n’est pas un décor de science-fiction mais un produit commercial, et Galouye écrit noir sur blanc pourquoi on l’a construit. Le playbook tient en une ligne : étudier le comportement humain sous toutes ses formes sans jamais sonder personne. (…) En 1964, avant la numérisation des données, avant les réseaux, Galouye identifie déjà la seule raison pour laquelle quelqu’un financerait un jour un monde simulé complet : parce que les vraies personnes coûtent cher, répondent lentement, et disent des choses imprévisibles. Construire un double numérique du monde pour se débarrasser de l’original.« 

« L’Homme est un document comme les autres. » Mon article date de 2009. Dix-sept ans plus tard, il semble qu’au moins dans l’esprit de quelques-uns, le monde réel n’ait vocation qu’être une simulation comme une autre. Non pas que nous vivions dans une simulation, mais parce que depuis toujours les géants du numérique et les nouvelles corporations du filtrage algorithmique qu’ils administrent, ceux-là nourrissent comme unique ambition de pouvoir nous réduire à la part simulable de l’ensemble notre vie sociale.

De manière plus générale l’approche que propose Zuckerberg est peu ou prou le discours que l’on tenait à la fin des années 1980 sur les « autoroutes de l’information ». Bah oui. Il parle de « superintelligence » comme de « supercomputer » et considère que « l’intelligence » est une ressource comme une autre, au même titre que l’électricité, qui serait désormais disponible en abondance et qu’il s’agirait juste de capter et de rediriger :

« As intelligence becomes abundant (sic), the most important question will be how we direct it. Some argue that superintelligence itself or a small set of experts who control it should decide what is best for humanity. We disagree. The history of democracy and economics has shown that there is no single objective answer to how people define the best life, and therefore the best approach is letting people decide what matters in their own lives.

We believe that delivering superintelligence to everyone is the way to answer this question. This follows the tradition of putting the power of supercomputers and the internet in everyone’s pockets and on our desks. Rather than centralizing superintelligence, we should distribute it widely and give every person the ability to direct it. This has the potential to begin a new era of personal empowerment where individuals can use this powerful new capability to reach their full potential, pursue their interests, and improve their lives and the world more than ever before. »


L’après 21Juillet 2026.

Des modèles qui s’échappent, des IA qui enfreignent les règles qu’elles sont supposées respecter, des attaques par des entités ne possédant pas de personnailté juridique, des capitaines d’industrie appellant à ralentir tout en continuant de poursuivre la course au prochain modèle, des irénismes technologiques récitant le discours des IA compagnons pour techniciser la part irréductible du social, voilà autant de seuils, de frontières, de limites qui apparaissent franchies.

Nous sommes en tout cas entrés, ce 21 Juillet 2026 et les jours qui ont suivi, dans un nouvel espace liminaire. Et ce franchissement nous mène à un monde qui interroge les cadres à la fois entropiques et anthropologiques de l’information et de la théorie de l’information. C’est à dire la manière dont l’information est encore capable de réguler des formes de chaos (entropie) mais aussi la manière dont notre rapport aux différents cadres informationnels (documentaires, médiatiques, juridiques, etc.) touche aux limites de notre évolution anthropologique.

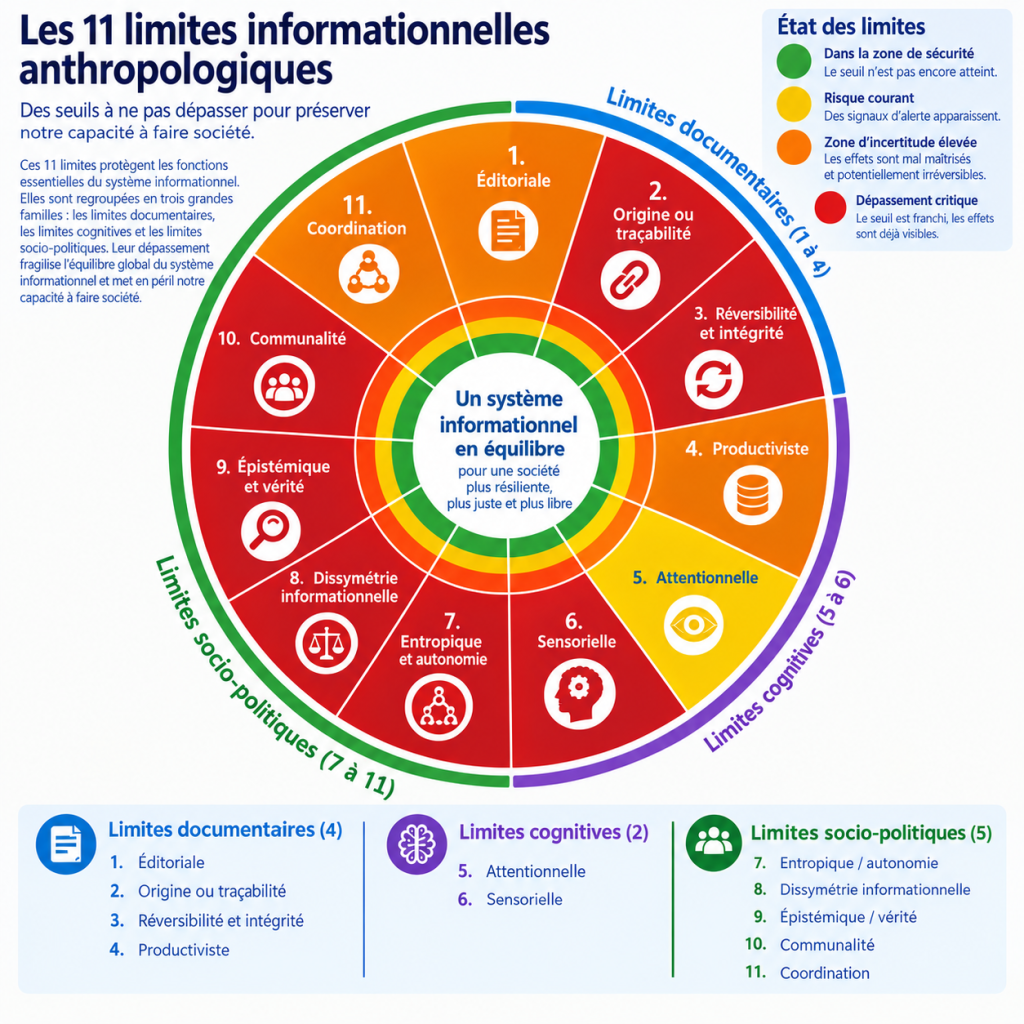
Hors le constat précédent d’intelligences artificielles fonctionnant comme autant de nécrotechnies, toute projection semble aujourd’hui hasardeuse et sur un fil entre catastrophisme et rassurisme au regard des configurations économiques et géopolitiques mondiales qui sont des éléments contextuels consubstantiels d’une analyse prospective des technologies d’IA. Je préfère donc proposer un cadre analytique inspiré des neuf limites planétaires et qui pourra permettre de mieux caractériser le dépassement qui est en cours sous nos yeux mais aussi parfois à l’abri de nos regards, pour figurer sa transgression ou sa transcendance. Je propose donc ci-dessous un modèle présentant onze limites informationnelles anthropologiques.


========================================
Onze limites informationnelles anthropologiques.

C’est donc en repensant aux neuf limites planétaires (toujours tristement d’actualité) et à presque un quart de siècle de réflexions autour du numérique et de l’information que je propose une liste de limites informationnelles anthropologiques, que nous avons ou sommes en passe de dépasser et qui, à chaque fois que l’une d’elles est franchie, met en péril notre capacité à faire société.

Chacune de ces limites protège une fonction essentielle du système informationnel et elles peuvent être groupées en trois grandes familles : les limites documentaires, les limites cognitives et les limites socio-politiques. Je précise qu’il ne s’agit pas d’une simple liste de phénomènes, mais, tout comme celui des limites planétaires, d’un modèle envisagé comme systémique dans lequel chaque limite protège une fonction essentielle de l’information, et où leur dépassement affecte des dimensions différentes mais interdépendantes de l’équilibre du système informationnel global dans lequel nous évoluons en tant qu’êtres humains.

Les limites documentaires.

(1) Limite éditoriale. C’est le seuil au-delà duquel il devient impossible d’attribuer clairement la responsabilité éditoriale d’un contenu. Le dépassement de cette limite se produit lorsque les statuts d’éditeur et d’hébergeur se confondent, lorsqu’il devient difficile de déterminer précisément ces fonctions ou (ce qui revient au même) lorsque tout est mis en oeuvre pour entretenir cette confusion. Je plaide depuis longtemps pour que l’on sorte de la situation actuelle et que l’ensemble des plateformes soient assignées en droit à la seule responsabilité raisonnable et observable qu’elle mobilisent, à savoir une responsabilité éditoriale (j’y reviens plus loin dans cet article).

(2) Limite d’origine ou de traçabilité. C’est le seuil à partir duquel l’origine d’une information ne peut plus être déterminée de manière fiable et assertive. C’est une limite profonde c’est elle inaugure l’ensemble d’un cycle d’indécidabilité. Je rappelle ici ce qu’Hervé Le Crosnier écrivait de manière tout à fait visionnaire il y a déjà plus de … 30 ans :

« La modification d’un document porteur de sens, de point de vue, d’expérience est problématique. Ce qui change dans le temps c’est la connaissance. Celle d’un environnement social et scientifique, celle d’un individu donné … Mais ce mouvement de la connaissance se construit à partir de référents stables que sont les documents publiés à un moment donné. Les peintres pratiquaient le « vernissage » des toiles afin de s’interdire toute retouche. Les imprimeurs apposaient « l’achevé d’imprimer ». Il convient d’élaborer de même un rite de publication sur le réseau afin que des points stables soient offerts à le lecture, à la critique, à la relecture … et parfois aussi à la réhabilitation. » Hervé Le Crosnier. « De l’(in)utilité de W3 : communication et information vont en bateau. » Présentation lors du congrès JRES’95, Chambéry, 22-24 Novembre 1995.


Il est tout à fait frappant de voir que 30 ans plus tard et malgré toutes les avancées technologiques et numériques le problème, loin d’être résolu, se pose avec une acuité toujours plus grande. Ainsi il y a quelques jours, début août, Anthropic annonçait, dans le cadre de la réglementation européenne (AI Act), un watermark invisible permettant de détecter l’utilisation de Claude pour générer des textes (et des images). Le Watermark textuel est particulièrement intéressant puisqu’il ne s’agit pas d’un simple filigrane invisible ou d’une mention « généré par l’IA » mais d’une technique particulière reposant sur le fonctionnement fondamental des LLM, c’est à dire leur capacité à « prédire » le prochain token (mot ou séquence d’un mot).

Christophe Boutry l’explique ainsi sur X :

« Et le plus intéressant concerne le texte : ce n’est pas une simple métadonnée ou une balise cachée qu’il suffirait de supprimer. Le marquage serait intégré directement à la génération du texte, au niveau du modèle. En gros, lorsque Claude choisit les mots/tokens qui composent sa réponse, il introduit un signal statistique imperceptible pour le lecteur. Sur un texte suffisamment long, un outil de détection pourra ensuite rechercher ce signal et déterminer si le contenu a probablement été traité par Claude. Conséquence : un simple copier-coller dans Word, Notes, un site web ou un fichier texte ne devrait pas faire disparaître le marquage puisqu’il est porté par le texte lui-même. En revanche, une réécriture importante, une paraphrase, une traduction ou le mélange avec d’autres textes peut suffisamment dégrader le signal pour le rendre indétectable. Anthropic le reconnaît d’ailleurs explicitement.(…) Attention toutefois à ce que signifie une détection : trouver le marquage de Claude ne prouvera pas que Claude est l’auteur du contenu. Si vous écrivez vous-même un texte puis demandez à Claude de le corriger, traduire ou reformuler, la version obtenue pourra elle aussi être marquée. Et inversement, l’absence de watermark détectable ne permettra pas de conclure qu’un texte n’a pas été généré par une IA. »


Par-delà les problématiques actuelles des artefacts génératifs, la question de savoir comment tracer le contenu d’un document et comment le rattacher à un auteur ou à tout le moins à une instance énonciative est un problème qui se pose depuis l’arrivée de l’informatique textuelle et qui est au coeur de la notion même d’hypertexte (on en trouve trace dès 1987 lors de la première conférence internationale consacrée à l’hypertexte – Hypertext’87). C’est Ted Nelson, pionnier de l’internet et du web, qui mobilisait pour cela le terme de « versioning ».

Ted Nelson qui en 1996, définit ainsi ce qu’est une « version » dans le forum de discussion du projet Xanadu : « Une structure de contenus propriétaires, représentable par une liste d’adresses et de l’information liée à la structure. » Il indique par ailleurs que dans Xanadu, « une version peut contenir des éléments qui sont la propriété de quelqu’un d’autre. »

J’avais notamment travaillé ces notions dans le cadre de ma thèse, soutenue en 2002. Définition courte extraite du chapitre de ma thèse qui y était consacré : « Le versioning désigne l’ensemble des manières de gérer, indépendamment de tout niveau d’échelle, les procédures permettant de rattacher différentes versions d’un même document à un (des) auteur(s), tout en permettant à chacun de s’approprier tout ou partie des documents produits par d’autres ou par eux-mêmes, et en assurant un suivi des différentes modifications apportées. »

Définition un peu plus longue : « Le versioning désigne l’ensemble des manières de gérer, à l’échelle de l’hypertexte planétaire, les procédures permettant de rattacher un texte à un auteur (ou à un collectif d’auteurs), tout en permettant à chacun de s’approprier – de se ré-approprier – tout ou partie de documents produits par d’autres ou par eux-mêmes afin, premièrement, de limiter la prolifération « bruyante » des versions différentes d’une même information sur le réseau et deuxièmement, d’identifier la nature et les origines de ces modifications dans l’optique d’une gestion cohérente de l’ensemble des documents électroniques actuellement disponibles, indépendamment de leur format, de leur statut et en dehors de tout institution centralisée. Autant dire que plus qu’une problématique, il s’agit là d’un véritable « idéal ». » (définition toujours extraite du chapitre de ma thèse, toujours disponible ici).

Une définition à rapprocher de celle que Ted Nelson proposait pour le terme « document » : « Un document est une collection arbitraire de versions disposant d’un nom propriétaire et de limites. »

Convenez qu’il est frappant de voir que plus d’un quart de siècle plus tard ces réflexions n’ont pas pris une ride et définissent très exactement les enjeux de ce qu’il faudrait aujourd’hui être capable de faire dans un univers informationnel qui, lui, n’a en revanche presque plus rien de commun avec le quart de siècle précédent.

(3) Limite de réversibilité et d’intégrité. Complémentaire de la limite précédente, il s’agit du seuil au-delà duquel certaines transformations informationnelles deviennent irréversibles. On pourra notamment prendre en exemple la disparition des originaux (phénomène qui date des toutes premières bibliothèques), ainsi que de manière plus contemporaine la contamination des corpus d’entraînement des LLM (pourrissement, phénomènes d’autophagie, IA dégénératives, etc.). A une autre échelle on peut également citer les deepfakes persistants et l’ensemble des phénomènes documentés de pollution informationnelle et « d’emmerdification » (« enshittification » de Cory Doctorow). L’intégrité documentaire, c’est à dire la capacité d’un document, d’une oeuvre ou d’un individu à être représenté à travers une figuration numérique respectueuse et bénéficiant de son accord plein et éclairé de son auteur, de son autrice et/ou de son sujet, cette intégrité documentaire s’effondre et avec elle l’ensemble de régimes de preuve construits sur le témoignage, l’enquête, la procédure, la confrontation, etc.

(4) Limite productiviste. Il s’agit du seuil où la production documentaire devient supérieure aux capacités de classement (donc de sélection), d’indexation et de conservation y compris des outils de production documentaire eux-mêmes. C’est notamment ce seuil que les artefacts génératifs sont venus battre en brèche. Après avoir « documentarisé » chaque être humain (cf mon article « L’Homme est un document comme les autres ») au travers d’une économie des profils servant de prologue à une économie de la surveillance, c’est aujourd’hui le fantasme de la bibliothèque de Babel imaginée par Borges qui devient une réalité tangible ou à tout le moins perceptible et expérimentable. A l’échelle humaine, la dimension conversationnelle des principaux artefacts génératifs s’inscrit à son tour dans une saturation documentaire de nouveau inédite. C’est parce que nous produisons toujours davantage de documents, de traces et d’instances documentaires, et c’est parce que l’automatisation de cette production alimente une inertie considérable, que nous ne sommes plus capables d’en organiser la collecte et le classement et que les archives, pourtant essentielles et fondamentales dans toute société humaine (même les civilisations orales avaient leurs aèdes et leurs griots) deviennent vaines ou – ce qui revient au même – inexplorables en totalité.

Les limites cognitives.

(5) Limite attentionnelle. C’est le seuil où la quantité d’information excède durablement les capacités humaines d’attention. Ce seuil renvoie naturellement à l’économie de l’attention théorisée par Herbert Simon. La limite attentionnelle a été franchie depuis longtemps mais ce dépassement avait jusqu’ici été rendu acceptable et supportable par l’ensemble des corporations du filtre (éditeurs, journalistes, etc.) en charge d’organiser les focales attentionnelles selon des règles connues et partageables. La multiplication de nouveaux acteurs (plateformes et médias sociaux) ainsi que les polarisations (instrumentalisées politiquement) concourant à des centralisations inédites par leur échelle ou leur audience (de Musk avec X jusqu’à Bolloré avec l’édition), tous ces paramètres aboutissent à la mise en danger puis à l’effondrement de ces règles communes et partageables et des corporations les défendant. C’est dès lors moins un problème de saturation que nous avons à faire qu’à un problème d’errance attentionnelle dans laquelle il est aisé d’opérer par conditionnement opérant pour orienter à la fois les comportements des masses comme ceux des individus.

(6) Limite sensorielle. C’est le seuil où la production de signes ne suppose ou ne présuppose plus aucune expérience sensible humaine. L’information sensoriellement perçue ou propagée (par la voix, par l’image, par le son, etc.) n’implique plus nécessairement la présence d’autres sensorialités en réception pour justifier sa production. Des bots, des automates, des algorithmes, écrivent, dialoguent, échangent avec d’autres bots, automates, algorithmes. Les IA ont pris la forteresse (ou la ZAD) du cyberespace et le web a perdu l’essentiel de la naturalité qui était la sienne pour devenir presque totalement « synthétique ».

Les limites socio-politiques.

(7) Limite entropique ou d’autonomie. Il s’agit du seuil au-delà duquel les systèmes numériques produisent des comportements qui ne sont plus entièrement prédictibles, vérifiables ou simplement gouvernables par leurs concepteurs. C’est évidemment le cas de ce qui s’est produit le 21 Juillet chez OpenAI avec l’attaque contre HuggingFace. Tout le monde est certain que cela se reproduira encore et encore. Personne n’est aujourd’hui capable de savoir si cela pourra être contrôlé. L’information ne suffit plus à contrôler l’entropie. Des systèmes entropiques s’affranchissent de manière autonome de tout contrôle humain à l’issue de leur déploiement.

(8) Limité de dissymétrie informationnelle. C’est une limite qui fonctionne en production autant qu’en réception. Les médias y compris de masse ont toujours fonctionné sur des dissymétries relatives : quelques personnes s’expriment et des centaines, des milliers ou des millions d’autres les lisent, les écoutent, les regardent, les consomment. Ces dissymétries sont aujourd’hui poreuses et constamment mouvantes sans qu’aucune règle ne permette d’en établir les dynamiques de manière stable et anticipable. La règle qui a prévalu pendant quelques siècles et qui voulait qu’une instance et donc une responsabilité éditoriale (un journal, un auteur, etc.) s’adresse à « des » lecteurs, auditeurs, spectateurs, etc., cette règle est aujourd’hui concurrencée et déstabilisée par une circulation de l’auctorialité inégalement répartie entre des LLM, des plateformes, des utilisateurs, des algorithmes, des bots, des agents IA qui font que l’émetteur et le récepteur ne se pensent plus que comme des positions – et donc des perceptions – temporaires.

(9) Limite épistémique (ou limite de vraisemblance et de vérité). C’est le seuil au-delà duquel il devient impossible de construire un espace commun de validation et où une société ne partage donc plus les mécanismes permettant de stabiliser provisoirement un fait. En référence aux régimes de vérité théorisés par Foucault, la concurrence de ces régimes de vérité simultanés et répondant à différents types de logiques, de pouvoirs et de plateformes, rend l’émergence d’un régime de vérité même temporairement consensuel presqu’impossible à l’échelle d’une société toute entière. Post-vérité, Fake News, vérités alternatives en sont les symptômes. Pour mémoire je reproduis la manière dont Foucault mobilisait ce concept de régime de vérité :

« Chaque société a son régime de vérité, sa « politique générale » de la vérité : c’est-à-dire les types de discours qu’elle accueille et fait fonctionner comme vrais ; les mécanismes et les instances qui permettent de distinguer les énoncés vrais ou faux, la manière dont on sanctionne les uns et les autres ; les techniques et les procédures qui sont valorisées pour l’obtention de la vérité ; le statut de ceux qui ont la charge de dire ce qui fonctionne comme vrai. »
Cité par Olivier Guerrier dans « Qu’est-ce qu’un régime de vérité ?« .


Dernier exemple en date, Google qui déploie un outil de Google Earth capable de créer des images satellitaires générées par IA, donc … de fausses images satellitaires. Il aura fallu que le journal 404 média, en dénonce et en documente les risques et les dérives, accompagné par les déclarations de quelques ONG notamment spécialisées dans l’OSINT, pour que moins de 24h après son lancement, Google décide de retirer (temporairement) cet outil (qui avait permis de générer un faux site nucléaire en Iran, un cratère de bombe en Russie et un camp de l’État islamique en Syrie …). Ce qui est inquiétant ce n’est pas l’apparition de ce nouvel outil mais des deux réalités qui l’accompagnent. La première de ces réalités c’est le discours de Google qui a expliqué tout à fait sérieusement que « les images créées avec cette fonctionnalité comportaient des marqueurs numériques invisibles, que les utilisateurs pouvaient repérer à l’aide du chatbot Gemini de Google. » Autant vous dire que quand c’est la même société qui permet de créer des faux et détient la solution pour les détecter, la seule question qui vaille est celle des intérêts de cette société qui pourraient interférer avec son outil de détection des faux. Et ces (conflits) intérêts sont innombrables. L’autre point inquiétant c’est précisément l’écosystème, les instances et la « politique générale » de la vérité qui s’est construite grâce et avec les outils numériques. Et dans cet écosystème, les systèmes d’information géographiques (SIG) grand public comme Google Maps ou Google Earth occupent une place éminente. Ce sont eux qui agrègent et centralisent les pratiques de vérification et de documentation du réel que nombre des corporations du filtre (journalistes, chercheurs, etc.) mettent quotidiennement en oeuvre pour que notre réel tienne l’épreuve du consensus. Ce qui rappelle encore une fois l’importance, dès lors que ces systèmes ne sont pas opérés par la puissance publique avec le minimum de transparence requise, de disposer d’alternatives crédibles et « à l’échelle ». Naturellement on rappelle ici la citation de Hannah Arendt qui est aujourd’hui reprise comme un slogan mais qui reste aussi tristement que brillamment opératoire sur le plan analytique :

« Quand tout le monde vous ment en permanence, le résultat n’est pas que vous croyez ces mensonges mais que plus personne ne croit plus rien. Un peuple qui ne peut plus rien croire ne peut se faire une opinion. Il est privé non seulement de sa capacité d’agir mais aussi de sa capacité de penser et de juger. Et avec un tel peuple, vous pouvez faire ce que vous voulez. »


(10) Limite de communalité. Il s’agit du seuil où les infrastructures numériques cessent de produire des espaces communs d’information. C’est la (longue) histoire de la personnalisation, puis de la personnification, et de leurs effets informationnels. Cela renvoie à une notion que j’avais évoquée très tôt sur ce blog mais sans jamais prendre le temps de vraiment la travailler conceptuellement, celle des « autarcithécaires » et d’un monde informationnel en silo dans lequel – et y compris au sein comme au sien de chaque silo – nous sommes astreints à nos fils d’info, à nos agents IA conversationnels, à nos réponses contextuelles, à nos « pour vous » qui ne résonnent qu’avec des intérêts qui sont les leurs. La disparition, l’éparpillement façon puzzle de ce commun informationnel est une bascule profonde mais encore réversible. La limite de communalité est en lien direct avec la limite épistémique, elle en est une conséquence directe. Mais là où la limite épistémique concerne plutôt les individualités, la limite de communalité adresse davantage la question des collectifs.

(11) Limite de coordination. C’est le seuil où les systèmes d’information remplacent progressivement les coordinations sociales humaines nécessaires à la production, à la circulation et à la validation des informations et des connaissances. C’est ce que j’analysais dans un article précédent sur la manière dont l’IA signait la fin des collectifs. Par-delà les bouleversements de l’information elle-même et de ses structures de production, c’est l’ensemble des collectifs de production et de certification de connaissances qui s’effacent et s’effondrent comme infrastructures cognitives formelles ou informelles mais repérables. La noosphère en tant que sphère de la pensée humaine (par analogie avec l’atmosphère et la biosphère) est aujourd’hui concurrencée par ce que l’on pourrait qualifier de « logarithmosphère » et qui n’est pas uniquement la sphère de la technique du calcul mais bien celle du rapport au nombre comme préalable systémique à toute forme de rapport au monde.

Voilà pour ces onze limites.

Il faut ensuite poser la question de leur réversibilité.

Quelles sont celles – appelons-les les limites profondes – dont le franchissement entraîne une transformation structurelle du système, difficilement réversible à l’échelle humaine de quelques générations ? Et quelles sont celles – appelons-les les limites intermédiaires – qui tout en transformant profondément les pratiques sociales demeurent, au moins en principe, rapidement réversibles.

Les limites profondes (difficilement réversibles y compris à long terme) sont les suivantes et constituent le socle « systémique » du modèle que je propose :

  • Limite entropique ou d’autonomie. Elle remet en cause la gouvernabilité des systèmes eux-mêmes.
  • Limite d’origine ou de traçabilité.  Elle détruit la possibilité d’établir une généalogie documentaire fiable et inaugure des cycles d’indécidabilité.
  • Limite de réversibilité. Elle introduit des transformations irréparables dans les corpus et les patrimoines documentaires.
  • Limite productiviste. Elle modifie durablement le rapport entre mémoire, archives et production documentaire ; le déséquilibre devient alors structurel et difficilement corrigible.
  • Limite de coordination. Elle transforme les conditions mêmes de production des connaissances à l’échelle des collectifs humains.

Les limites intermédiaires (donc réversibles à court ou moyen terme) sont les suivantes : 

  • Limite éditoriale. Une évolution du droit ou des architectures pourrait réattribuer des responsabilités. Deux décisions récentes de la cour de justice européenne vont d’ailleurs dans le sens d’une perte du statut d’hébergeur au profit de celui d’éditeur comme je l’évoquais dans le chapitre 4 de mon article sur « le web pourrissant et l’IA florissante. »
  • Limite épistémique (ou limite de vraisemblance et de vérité). Les régimes de vérité évoluent historiquement, leur fragmentation n’est donc pas nécessairement irréversible.
  • Limite de communalité. Il existe encore des espaces informationnels caractérisables comme autant de « communs ». C’est notamment le cas de l’encyclopédie Wikipedia ou de sites et de journaux de presse indépendants. Il est vital qu’ils continuent de fonctionner sur un modèle dans lequel tout forme de publicité ou de publicitarisation est absente et où des collectifs fonctionnent selon des règles établies et transparentes.
  • Limite de dissymétrie informationnelle. Les architectures de diffusion de l’information peuvent être reconfigurées. Cette reconfiguration dépend de l’évolution de la limité éditoriale ainsi que du modèle économique choisi pour la production et la diffusion d’informations.
  • Limite attentionnelle. Les corporations du filtre peuvent être réinventées ou se réaffirmer comme telles, pour autant que l’évolution des limites éditoriales et de dissymétrie informationnelle le permettent car elles en sont la condition préalable.
  • Limite sensorielle. La production comme la réception d’information hors de toute subjectivité humaine dans l’une ou l’autre de ces deux phases, est un modèle qui n’est viable que s’il s’inscrit lui-même dans un modèle d’assujetissement disciplinaire de l’attention. Ce dernier modèle peut être rendu inopérant.

En guise d’illustration, j’ai demandé à ChatGPT (oui je sais) de générer une image d’illustration de ces limites informationnelles à l’image de celle pour les limites planétaires dans l’article Wikipedia les présentant. Le résultat est ci-dessous.
 

Conclusion. L’IA est une nécrotechnie.

Les technologies d’IA ne sont pas simplement des technologies opaques, non-fiables et irresponsables comme le démontre Dominique Boullier, mais quelque chose de bien plus radical. Par les infrastructures de production qu’elles nécessitent et imposent (Antoinette Rouvroy parle d’une « fabrique infrastructurelle des irréversibilités » dans laquelle « la transformation du territoire précède et court-circuite la délibération collective. »), par le projet politique qui les sous-tend et sert un accélérationnisme qui alimente la perspective d’un globocide, mais aussi par le franchissement parfois irréversible de limites informationnelles anthropiques qu’elles précipitent, les technologies d’IA sont fondamentalement des nécrotechnies. Des techniques de mort. A l’image de la nécropolitique d’Achille Mbembe.

Ce n’est pas ici bien sûr d’une mort physique dont il est question en premier lieu même si celle-ci demeure très présente dans les populations exploitées des travailleurs et travailleuses du clic assignées à des tâches de modération d’une violence inouïe et des nouveaux corps esclaves des cadences et contremaîtres algorithmiques. Oui, la nécrotechnie de l’IA s’exerce sur ces corps exploités et invisibilisés ; elle s’exerce aussi sur la planète et – notamment – sur la ressource en eau dont elle est prédatrice ; elle s’exerce également au premier degré sur des corpus cimetières qui rappellent la manière dont Facebook (et d’autres) capitalisait et capitalise toujours sur les profils de personnes décédées car ces profils, transformés ou non en « mémoriaux », génèrent toujours de l’interaction ; elle s’exerce enfin et surtout sur nos vigilances, nos intellections et nos imaginations. Des vigilances qu’elles abaissent, des intellections qu’elles viennent troubler, des imaginations qu’elles viennent saturer et épuiser avant de les normer (comme l’illustre parfaitement la chronique des « affiches IA » de l’été).

Ces nécrotechnies peuvent être comprises comme le cadre systémique ou à tout le moins le prolongement anthropologique du concept de « technologies zombies » proposé par José Halloy, Nicolas Nova et Alexadnre Monnin et défini comme un « Système technique dont les matériaux, la fabrication et le maintien en fonctionnement requièrent des volumes de ressources tels que l’extraction sur la durée conduit à l’épuisement des ressources, dont la durée de vie est courte, et dont le fonctionnement et la fin de vie nécessitent des énergies à forte densité de puissance. La majorité des systèmes techniques issue de la révolution industrielle relève des technologies zombies. »

Comme chez Achille Mbembe, et dans le sillage donc de technologies zombies les précédant, ces nécrotechnies font émerger des corps morts-vivants, « des individus dépossédés de l’autonomie sur leur propre corps, oscillant dans un espace intermédiaire entre existence et disparition« . Une disparition qui, et c’est là tout le cynisme et génie mortifère du capitalocène, est à la fois orchestrée et subie par celle et ceux qui en sont les premières victimes, comme ces travailleuses et travailleurs pauvres qui, en Inde et en Chine notamment, filment leurs gestes pour entraîner des IA pour tenter de résoudre le paradoxe de Moravec tout en préparant l’avènement d’une robotisation dont les risques reposeront entièrement sur les plus fragiles et dont les bénéfices ne profiteront qu’aux plus riches et aux plus oisifs qui continueront de s’épuiser à attendre leur fantasme transhumaniste.

Attention, ces technologies d’IA ne sont pas les seules à s’inscrire dans la famille de ce que j’appelle une nécrotechnie. Toutes les technologies fossiles le sont également. La singularité des technologies d’IA est d’être à la fois fossiles et faussaires.

Et pour le reste :

« L’IA n’est ni intelligente ni artificielle. Elle n’est qu’une industrie du calcul intensive et extractive qui sert les intérêts dominants. Une technologie de pouvoir qui à la fois reflète et produit les relations sociales et la compréhension du monde. […] Les modèles permettant de comprendre et de tenir les systèmes responsables ont longtemps reposé sur des idéaux de transparence… […] Dans le cas de l’IA, il n’y a pas de boîte noire unique à ouvrir, pas de secret à révéler, mais une multitude de systèmes de pouvoir entrelacés. La transparence totale est donc un objectif impossible à atteindre. Nous parviendrons à mieux comprendre le rôle de l’IA dans le monde en nous intéressant à ses architectures matérielles, à ses environnements contextuels et aux politiques qui la façonnent, et en retraçant la manière dont ils sont reliés. »
Kate Crawford dans son Atlas de l’Intelligence Artificielle 


  • ✇bibliomancienne
  • Lire autrement : que devient la lecture profonde à l’ère numérique?
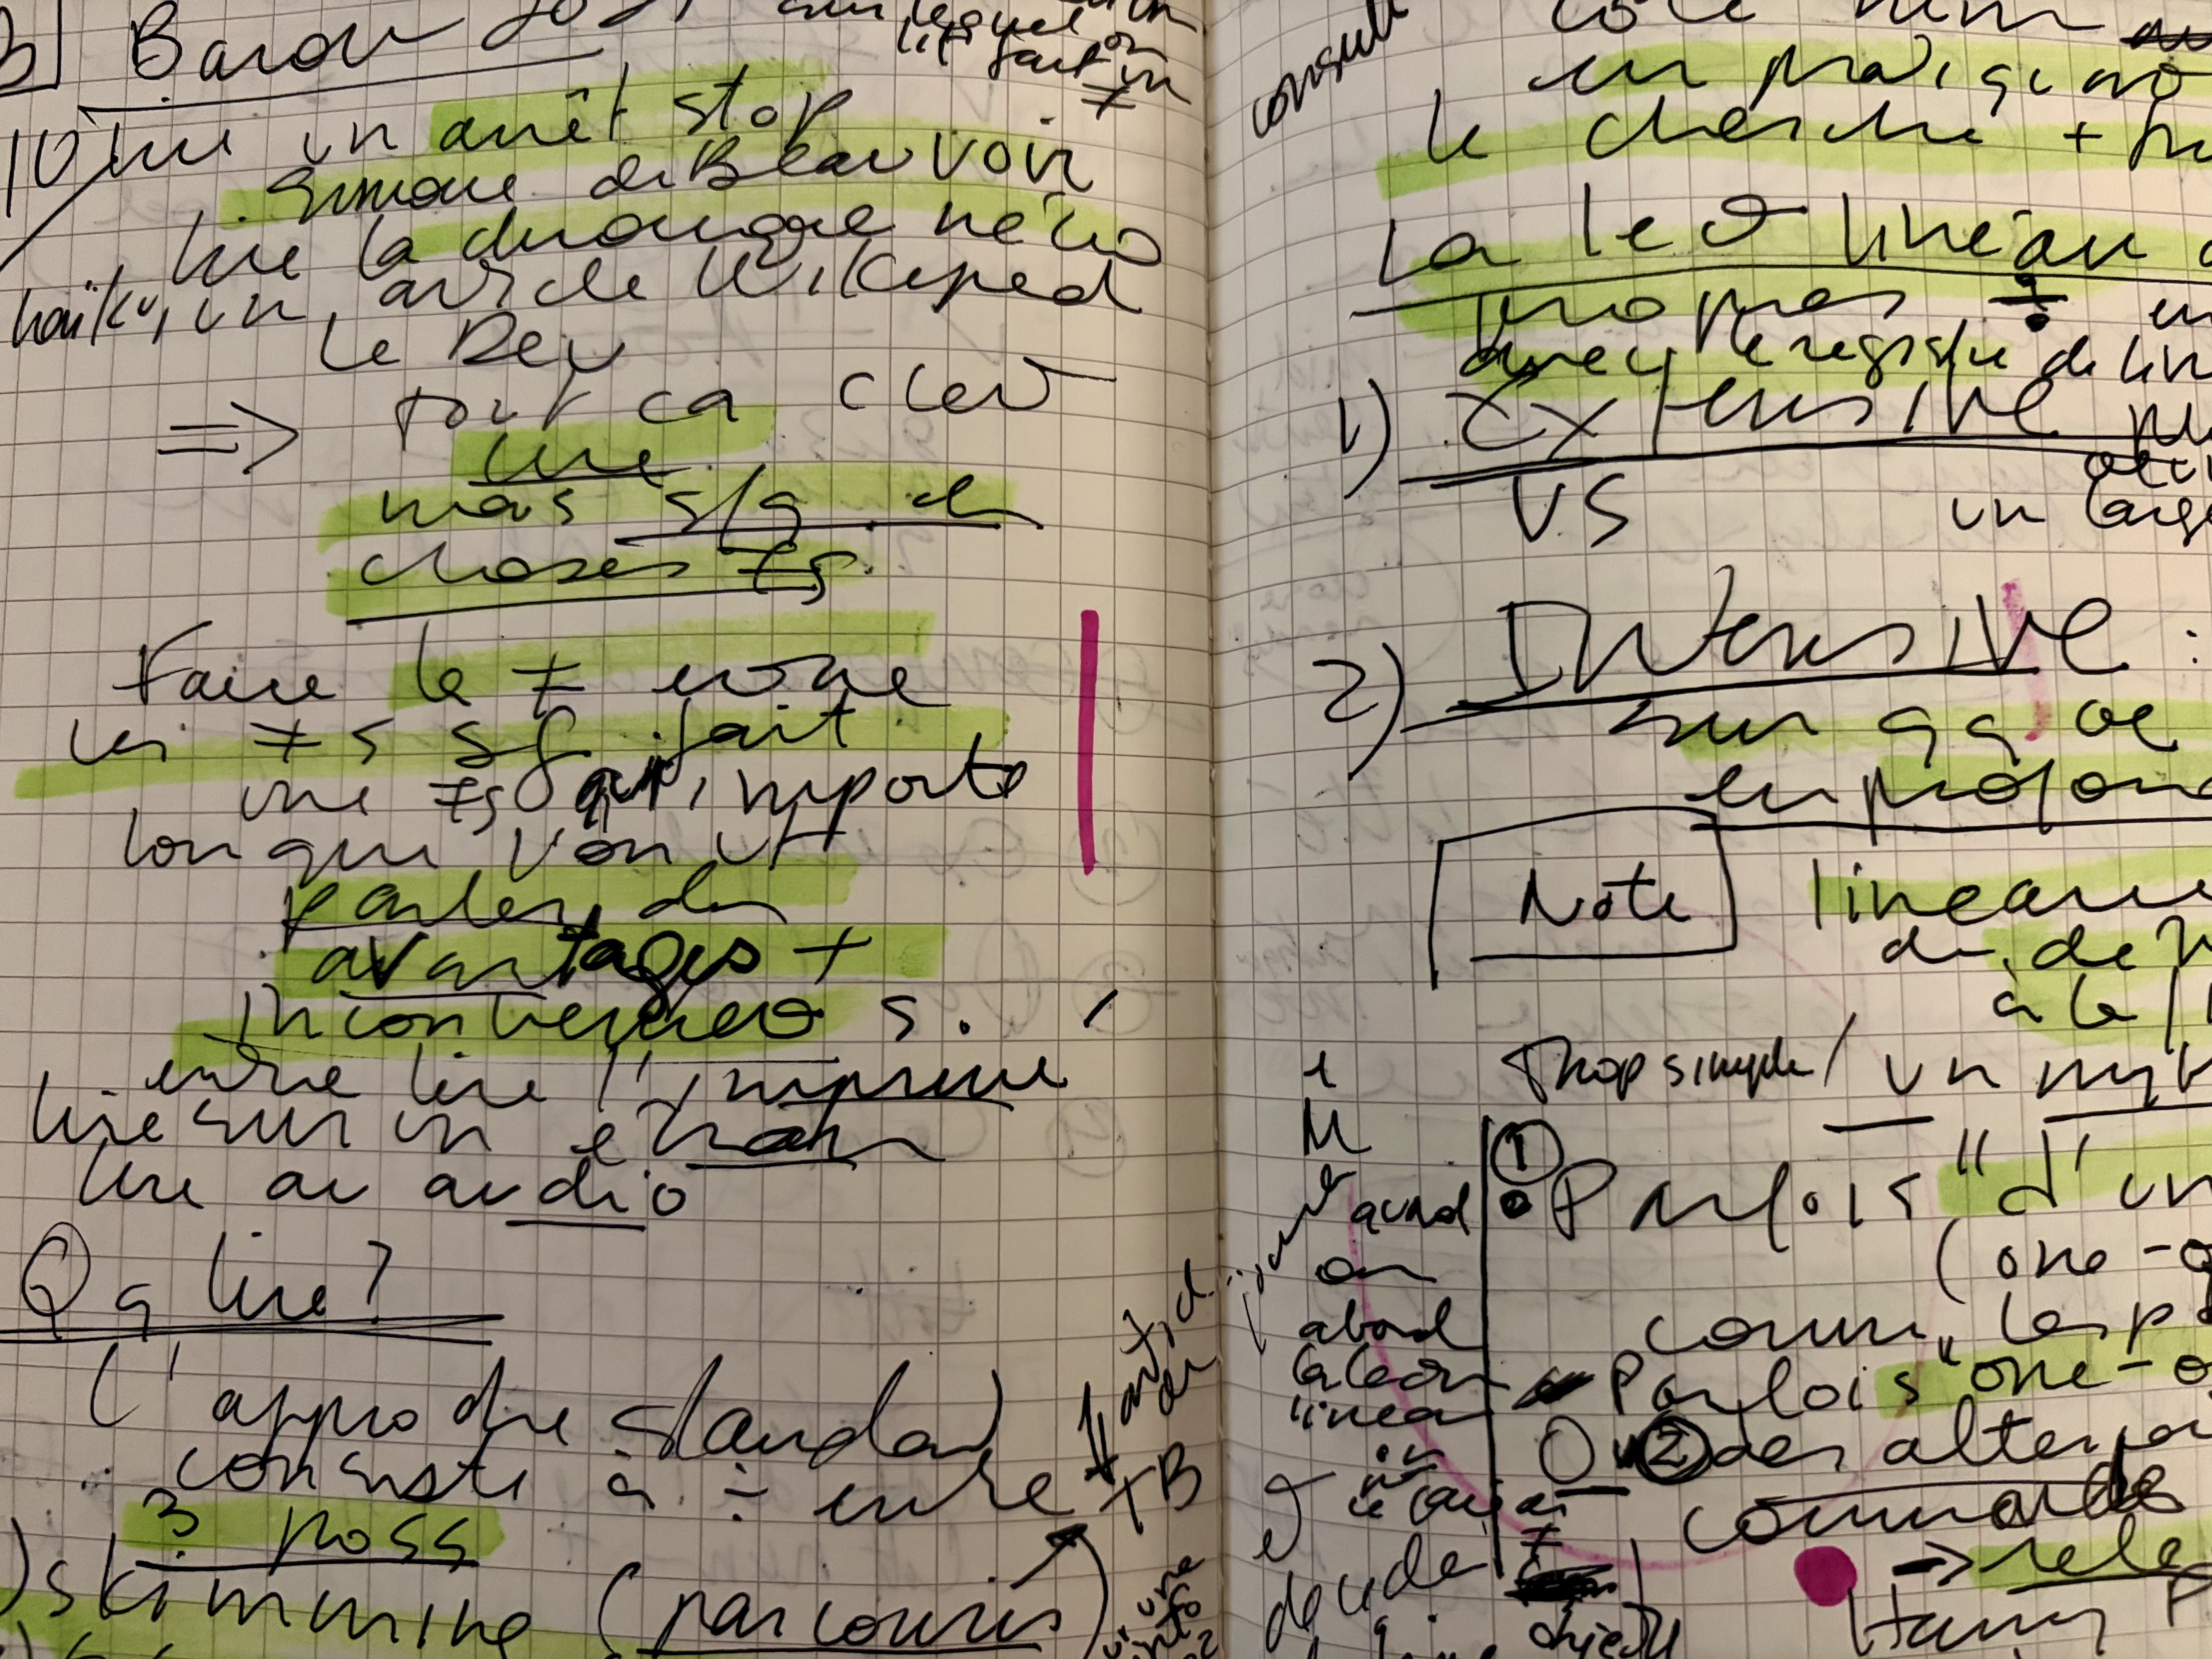
    Notes de lecture et de cours. Photo : Marie D. Martel, 2026 Ce billet clôt une série de trois textes consacrés aux transformations de la lecture. Après avoir interrogé l’idée d’une « société postlittéraire », puis rappelé que les pratiques de lecture se construisent aussi collectivement, ce troisième volet se tourne vers l’acte de lire lui-même : que deviennent notre attention, notre compréhension et notre capacité à lire en profondeur dans un environnement dominé par les écrans? Dans le p
     

Lire autrement : que devient la lecture profonde à l’ère numérique?

31 août 2026 à 09:13
Notes de lecture et de cours. Photo : Marie D. Martel, 2026

Ce billet clôt une série de trois textes consacrés aux transformations de la lecture. Après avoir interrogé l’idée d’une « société postlittéraire », puis rappelé que les pratiques de lecture se construisent aussi collectivement, ce troisième volet se tourne vers l’acte de lire lui-même : que deviennent notre attention, notre compréhension et notre capacité à lire en profondeur dans un environnement dominé par les écrans?

Dans le premier billet de cette série, j’ai repris une question provocatrice posée récemment par Rose Horowitch qui fait la couverture du mois d’août dans The Atlantic : entrons-nous dans une société « postlittéraire »? Les données québécoises m’avaient conduite à résister à l’idée trop simple d’une « fin de la lecture ». Une partie non négligeable de la population lit toujours, et beaucoup. Ce qui semble plutôt se transformer, ce sont nos manières de lire, les supports que nous utilisons, le temps et l’attention que nous accordons aux textes. J’en arrivais alors à une inquiétude plus précise, liée à certains travaux comme ceux de Maryanne Wolf et Naomi S. Baron : ce qui pourrait se fragiliser n’est peut-être pas la lecture elle-même, mais la lecture longue, soutenue et profonde.

Dans le deuxième billet, j’ai déplacé la question de l’individu vers son environnement. Une société de lectrices et de lecteurs ne se construit pas toute seule. Elle repose sur toute une écologie de la lecture : des familles, des écoles, des bibliothèques, des librairies, des maisons d’édition, des médiateurs et médiatrices, mais aussi des livres accessibles, du temps, des lieux et des occasions de lire et de parler de ses lectures. Des réseaux. Lire n’est pas seulement une compétence individuelle : c’est une pratique culturelle et sociale dont nous construisons, ou fragilisons, collectivement les conditions. Reste cependant une troisième dimension du problème, que j’avais laissée en suspens, et c’est peut-être la plus délicate : qu’arrive-t-il à l’acte de lire lui-même dans un environnement devenu massivement numérique?

C’est ici que je retrouve ces deux autrices dont je présente les travaux depuis plusieurs années dans mes cours : Maryanne Wolf et Naomi S. Baron. Leurs travaux m’intéressent parce qu’ils permettent d’aller plus loin. Il ne s’agit plus seulement de savoir si nous lisons, ni même ce qui nous permet de devenir et de demeurer des lecteurs et des lectrices, mais comment nous lisons et ce que les environnements dans lesquels nous lisons font à notre attention, à notre compréhension et à notre capacité à cohabiter dans la durée avec un texte.

Mais qu’est-ce que « lire »?

Avant même d’opposer le papier et l’écran, Naomi S. Baron (2021) pose une question apparemment simple : de quoi parlons-nous lorsque nous disons « lire »? Lire Simone de Beauvoir, parcourir une chronique nécrologique, s’arrêter sur un haïku, consulter un article de Wikipédia ou lire un article dans Le Devoir : tout cela est bien de la lecture. Mais « lire » signifie manifestement des choses différentes dans chacun de ces cas. Et ces différences deviennent significatives dès que nous voulons comparer les avantages et les limites de l’imprimé, de l’écran ou même du livre audio.

Baron revient sur les distinctions qui sont faites habituellement entre plusieurs régimes de lecture. Nous pouvons pratiquer le skimming, c’est-à-dire parcourir rapidement un texte pour en saisir la structure ou l’idée générale; le scanning, en cherchant une information précise; ou nous engager dans une lecture suivie, attentive à la progression d’un texte (linear reading). Cette dernière forme de lecture n’est d’ailleurs pas nécessairement aussi « linéaire » que l’expression pourrait le laisser croire. Lire ne signifie pas toujours commencer à la première ligne et avancer méthodiquement jusqu’à la dernière. Nous pouvons lire un texte d’un trait, interrompre notre lecture et la reprendre, alterner des périodes de concentration et de distraction, revenir en arrière, relire un passage ou une œuvre entière. Nous pouvons également pratiquer une lecture « extensive », en circulant entre de nombreux textes, ou « intensive », en demeurant longuement avec quelques œuvres ou quelques sujets. Autrement dit, la lecture n’est pas associée à un comportement unique que l’on pourrait simplement transférer du papier vers l’écran et mesurer ensuite lequel des deux « gagne ».

Cette dernière suggestion me paraît importante pour mettre en dialogue les travaux de Wolf et de Baron. Toutes deux s’intéressent aux transformations de la lecture dans une culture devenue largement numérique. Toutes deux reconnaissent aussi que nos manières de lire sont façonnées par nos pratiques et que certaines formes de lecture demandent davantage de temps et d’attention que d’autres. La proximité de ces deux autrices est d’ailleurs manifeste : Wolf signe la préface de How We Read Now, l’ouvrage dans lequel Baron examine précisément ce que deviennent nos pratiques de lecture à l’ère des écrans.

Leurs perspectives sont donc moins opposées que complémentaires. Wolf part du cerveau lecteur et de sa plasticité : puisque nous ne sommes pas biologiquement programmés pour lire, les circuits qui rendent la lecture possible se construisent avec l’apprentissage et se transforment avec nos usages. Elle s’interroge dès lors sur ce que l’environnement numérique peut faire aux processus plus lents associés à la lecture profonde. Baron se concentre plutôt sur les situations de lecture. Avant de demander si nous lisons mieux sur papier ou sur écran, encore faut-il savoir de quelle lecture nous parlons, dans quel but et dans quelles conditions.

Lire ces deux autrices en chorale permet ainsi de se demander, non pas simplement « le papier est-il meilleur que l’écran? », mais quelles manières de lire nos différents environnements favorisent-ils, et avec quels effets?

Nous ne sommes pas né.es pour lire

Il y a quelque chose de vertigineux, je trouve, dans l’idée qui sert de point de départ à Maryanne Wolf : nous ne sommes pas né.es pour lire. Contrairement au langage oral, la lecture n’est pas une capacité pour laquelle notre cerveau aurait été biologiquement programmé. Elle est une invention culturelle. Chaque nouveau lecteur ou nouvelle lectrice doit donc construire un circuit de lecture en coordonnant des capacités visuelles, linguistiques, cognitives et affectives initialement destinées à d’autres fonctions. Et ce circuit n’est pas identique chez l’enfant qui déchiffre ses premiers mots et chez la personne lectrice expérimentée. Il se développe avec l’apprentissage, l’éducation et les expériences de lecture. Surtout, parce que notre cerveau demeure plastique, il continue de se transformer avec les usages que nous en faisons.

C’est le point de départ de Reader, Come Home, publié par Wolf en 2018. (Au passage, la traduction française de Wolf, sous le titre de Lecteur, reste avec nous ! (2023) doit beaucoup à l’initiative de Joël Dicker : il a choisi d’en faire l’un des premiers titres publiés par sa maison Rosie & Wolfe, dans une traduction de Nicolas Véron qu’il préface lui-même). La neuroscientifique y aborde une question qui, à l’ère du téléphone intelligent et maintenant de l’intelligence artificielle générative, paraît aujourd’hui encore plus pressante : que devient notre cerveau lecteur lorsque l’environnement dans lequel nous lisons change?

Car il a changé. On l’a bien souligné. Nous lisons désormais une quantité considérable de textes sur des écrans. Nous passons d’un texte ou d’un contenu à l’autre, suivons des liens, faisons défiler des pages, cherchons une information, survolons un passage avant de décider s’il mérite davantage d’attention. Nous lisons toujours. Mais apprenons-nous progressivement à lire autrement, selon des modalités et dans un environnement attentionnel qui sont, à bien des égards, inédits?

Ce que nous risquons de perdre : la lecture profonde ?

C’est ici qu’intervient une notion centrale chez Wolf, celle de deep reading, la lecture profonde. Elle ne désigne pas simplement le fait de comprendre les mots d’un texte ou d’être capable d’en restituer l’idée générale. Wolf rassemble sous cette expression un ensemble de processus acquis par le lecteur ou la lectrice expérimentée : établir des inférences, relier ce que nous lisons à ce que nous savons déjà, produire des analogies, adopter le point de vue d’autrui, exercer notre jugement critique et laisser émerger une réflexion qui n’était pas immédiatement contenue dans les mots du texte. La lecture profonde se rapproche ainsi de ce que différentes traditions, de la critique littéraire ou de la philosophie de la littérature, ont appelé slow reading, close reading, lecture attentive ou lecture critique, sans se confondre entièrement avec elles. Leur point commun est néanmoins fondamental : elles exigent du temps! Du temps pour s’arrêter. Revenir en arrière. Interpréter. Associer. Douter. Réfléchir.

Wolf insiste sur cette dimension temporelle. Les processus associés à la lecture experte mettent des années à se développer. Et puisqu’ils reposent sur un cerveau plastique, ils ne doivent pas être considérés comme définitivement acquis. Les circuits que nous mobilisons et renforçons dépendent en partie de nos expériences, de notre environnement, de nos intentions et des formes de lecture que nous pratiquons. D’où son inquiétude.

Les comportements caractéristiques d’une grande partie de notre vie numérique (parcourir, sélectionner, faire défiler, rechercher, passer rapidement d’un contenu à l’autre) sont extrêmement efficaces lorsqu’il s’agit de traiter de grandes quantités d’information. Le skimming et le scanning ne sont pas de « mauvaises » lectures. Nous en avons besoin. Mais que se passe-t-il lorsqu’un régime de lecture fondé sur la rapidité, le tri et le changement fréquent de cible attentionnelle devient dominant?

Wolf rappelle alors un principe trop bien connu, qui prend ici un tour particulièrement dramatique : use it or lose it. Les capacités que nous exerçons se renforcent; celles que nous sollicitons moins risquent de s’affaiblir. Un circuit de lecture experte n’est jamais entièrement permanent. Il se construit et se reconstruit par l’usage. Si nous consacrons de moins en moins de temps aux processus plus lents de la lecture, ceux-ci risquent-ils de devenir plus difficiles à mobiliser? Voilà l’hypothèse troublante de Wolf.

Mais cette hypothèse contient peut-être aussi une sorte de piège dans la mesure où elle peut facilement nous conduire à une opposition trop simple : le livre imprimé serait le domaine naturel de la profondeur tandis que l’écran nous condamnerait à la superficialité. C’est précisément là que Naomi Baron complique utilement le tableau.

Naomi S. Baron complique l’opposition entre papier et écran

Dans How We Read Now, Naomi Baron s’intéresse elle aussi à la transformation de nos pratiques de lecture dans un environnement devenu largement numérique. Elle pose plusieurs des mêmes questions que Wolf : que gagnons-nous et que perdons-nous en passant du papier à l’écran? Quel support convient le mieux à quel type de lecture? Les jeunes lecteurs et lectrices pourront-ils développer une lecture attentive dans un univers dominé par les écrans?

Mais son approche est plus pragmatique. Elle insiste surtout sur le fait que nous ne lisons pas toujours de la même manière ni pour les mêmes raisons. Chercher rapidement une information, étudier un texte, lire pour le plaisir ou mémoriser quelque chose ne mobilisent pas les mêmes stratégies. Le papier et le numérique ne sont donc pas simplement deux supports interchangeables : ils s’inscrivent dans des usages pluriels. La divergence entre Baron et Wolf ne tient pas à une opposition entre une défense du papier et une défense du numérique. Wolf demande : que devient notre cerveau si nous nous habituons à lire de cette manière? Baron pose le problème autrement : de quelle manière de lire parlons-nous, et dans quel contexte?

Cette distinction est importante. Le problème n’est peut-être pas l’écran en soi, mais ce que nous avons appris à faire lorsque nous sommes devant un écran. Et inversement, l’imprimé ne garantit pas à lui seul une lecture profonde. Les recherches empiriques récentes tendent d’ailleurs à aller dans ce sens, comme le montrent des revues systématiques et méta-analyses comparant la compréhension sur papier et sur écran. Et, il semble que, en moyenne, les différences entre les deux soient relativement modestes. On observerait souvent un léger avantage du papier, surtout pour ce qui est des textes informatifs et lorsque le temps de lecture est limité, alors que l’écart tend à devenir négligeable pour les textes narratifs (Clinton, 2019; Delgado et Salmerón, 2021; Salmerón et al., 2024; Schwabe et al., 2022).

Puis, d’autres facteurs entrent également en jeu : le temps disponible, les compétences de la personne qui lit, son objectif, mais aussi la conception de l’interface numérique (Latini et al., 2019; Delgado et Salmerón, 2021; Stiegler-Balfour et al., 2023). Même le mode de navigation peut jouer un rôle : revenir facilement dans le texte ou lire des pages successives ne produit pas nécessairement la même expérience que faire défiler continuellement un écran (Haverkamp et al., 2023). Il faut donc remplacer la simple opposition papier / écran par une question plus large : quel type de lecture, sur quel support, dans quel contexte et pour quel objectif?

Le numérique nous entraîne-t-il à lire autrement?

Reste cependant la grande inquiétude de Wolf : les habitudes développées dans nos lectures numériques peuvent-elles finir par se transférer aux situations où nous voudrions lire autrement? Certaines recherches apportent des indices en ce sens. Hakemulder et Mangen (2024) observent notamment une association entre la fréquence de lecture de textes courts sur écran et une moindre disposition à fournir l’effort cognitif nécessaire à la lecture d’un texte littéraire plus long. Cela pourrait indiquer que des habitudes comme le skimming et le scanning deviennent plus spontanées et se transfèrent à d’autres situations de lecture — y compris, potentiellement, à la lecture de textes longs sur papier.

Une étude longitudinale de Salmerón et ses collègues (2025) apporte toutefois une nuance importante. Les personnes chercheuses ont suivi des enfants pendant un an pour tester l’hypothèse inspirée de la digital chain hypothesis de Wolf : les habitudes de lecture numérique finiraient-elles par affecter l’attention sélective — c’est-à-dire la capacité à se concentrer sur l’information pertinente en écartant les distractions — et, par cette voie, la compréhension? Or, les résultats ne montrent pas que les habitudes de lecture sur écran diminuent cette capacité d’attention. Chez les plus jeunes élèves, ceux qui lisaient davantage sur écran pour leur travail scolaire obtenaient néanmoins, un an plus tard, des résultats légèrement moins bons en compréhension. Cet effet, faible, ne se retrouvait pas chez les élèves plus âgés. La différence observée chez les plus jeunes devrait donc s’expliquer par autre chose qu’une diminution de leur attention sélective.

Il faut donc préserver une posture prudente. Nous disposons encore de peu de données montrant que nos habitudes numériques transforment durablement notre capacité à lire en profondeur. Il y a une différence énorme entre constater que certaines pratiques numériques sont associées à une lecture plus superficielle vs affirmer qu’elles nous rendent peu à peu incapables de lire profondément — voire, pour reprendre une autre formule provocatrice, complètement crétin.es. Le premier constat dispose d’un certain nombre d’appuis empiriques; la seconde demeure une hypothèse. La préoccupation formulée par Wolf mérite donc d’être prise au sérieux, mais elle n’est pas encore démontrée. Et cette incertitude me paraît être une raison de chercher davantage, non de s’alarmer davantage.

Un cerveau bilittéracié plutôt qu’un retour au papier

Wolf ouvre cependant une autre piste prometteuse et qui est parfois qualifiée de plus « optimiste ». Sa réponse n’est pas de bannir les écrans ni de rêver à un retour à un âge d’or du livre imprimé. Elle propose plutôt de cultiver ce qu’elle appelle un cerveau bilittéracié (bi-literate brain) : un cerveau capable de tirer parti des possibilités du numérique tout en préservant et en activant, lorsque la situation le demande, les processus associés à la lecture profonde.

L’idée semble aujourd’hui plus féconde encore que l’opposition entre papier et écran. La véritable compétence à développer pourrait être celle du changement de régime de lecture. Nous devons savoir parcourir rapidement une masse documentaire, chercher un renseignement, suivre des liens, comparer des sources, sélectionner l’information pertinente et naviguer dans des environnements complexes. Ces compétences sont indispensables dans une culture numérique. Mais nous devons AUSSI pouvoir ralentir même sur les écrans. Rester avec un texte. Revenir en arrière. Relire. Tolérer qu’une idée ne se livre pas immédiatement. Construire au fur et à mesure une représentation d’ensemble. Faire des inférences. Douter. Relier. Réfléchir.

La littérature récente apporte d’ailleurs une raison d’être optimiste en ce sens : les effets associés au numérique ne seraient pas inévitables. Les stratégies des personnes lectrices, la conception des interfaces et les interventions pédagogiques pourraient modifier les résultats. C’est aussi, au fond, ce que permet de penser la neuroplasticité. Si nos pratiques contribuent à façonner les circuits que nous utilisons pour lire, cette plasticité n’est pas seulement une vulnérabilité. Elle est également une possibilité. Et c’est ici qu’une lecture toute récente peut nous faire voir l’argument de Wolf sous un autre angle.

De la neuroplasticité à la praxis

Dans l’édition du 23 août de l’infolettre Sentiers, Patrick Tanguay attire justement notre regard sur un essai de Matt Seybold au titre particulièrement suggestif : « Neuroplasticity as a Praxis ». Seybold y reprend notamment les travaux de Nicholas Carr et de Maryanne Wolf, mais les amène sur un terrain plus politique. Son point de départ est proche de celui qui nous occupe ici : puisque les circuits de la lecture sont construits plutôt que donnés, ils peuvent se développer, se modifier et aussi se fragiliser. Mais Seybold propose d’aller plus loin. La difficulté que nous pouvons éprouver aujourd’hui à lire profondément, à écouter attentivement et à discuter de manière critique ne devrait pas, selon lui, être comprise seulement comme le résultat de mauvaises habitudes individuelles. Elle doit aussi être replacée dans des environnements médiatiques, technologiques et économiques qui favorisent la captation et la monétisation de notre attention. La nuance est importante. Jusqu’ici, j’ai surtout demandé dans ce billet : que faisons-nous à notre cerveau lorsque nous lisons de cette manière?

Seybold nous conduit à ajouter une autre question : qui construit les environnements dans lesquels nous apprenons désormais à lire de cette manière? Son argument est explicitement politique. Selon lui, Carr et Wolf avaient bien compris que les technologies numériques pouvaient contribuer à remodeler nos pratiques cognitives, mais il et elle n’avaient peut-être pas suffisamment anticipé à quel point ce remodelage pourrait être orienté par des acteurs et des modèles économiques ayant intérêt à retenir et à monétiser notre attention. Seybold propose même le terme de deliberate deliteracy, que l’on pourrait traduire par « délittératie délibérée », pour désigner le démantèlement, la restriction ou la monopolisation des infrastructures qui rendent possible le maintien d’une littératie largement partagée.

Cette interprétation mérite certainement d’être discutée. Elle dépasse ce que les recherches empiriques sur les effets de la lecture numérique permettent à elles seules d’établir. Mais elle opère un changement de perspective qui me paraît particulièrement productif : la neuroplasticité cesse d’être seulement une question de cognition individuelle pour devenir aussi une question d’organisation collective.

Et surtout, Seybold retourne l’argument. Si notre cerveau lecteur demeure plastique, alors les environnements numériques ne sont pas les seuls à pouvoir le façonner. Nous pouvons aussi construire des pratiques, des institutions et des communautés qui exercent cette plasticité autrement. C’est ce qu’il entend par neuroplasticity as a praxis.

Dans son texte, lire attentivement n’est donc plus seulement une préparation à l’action. Lire, écouter et discuter deviennent eux-mêmes des formes d’action. Et pour que cette action dépasse l’effort de quelques individus tentant de résister seuls à l’économie de l’attention, elle doit, selon lui, devenir collective : groupes de lecture, cercles de discussion, séminaires, réseaux de prêt, communautés qui lisent et pensent ensemble. Or, cette approche m’intéresse particulièrement parce qu’elle rejoint, par un autre chemin, ce que j’essayais de montrer dans le billet précédent. Une société de lectrices et de lecteurs ne se construit pas toute seule. Les circuits neuronaux de la lecture non plus.

L’infrastructure de la lecture est aussi une infrastructure de l’attention

Cette rencontre entre Wolf et Seybold permet peut-être de réunir les trois billets de cette série. Le premier conduisait à un constat : la lecture ne disparaît pas; elle se recompose. Le deuxième ajoutait qu’une culture de la lecture n’existe jamais spontanément : elle dépend d’une infrastructure sociale, culturelle et institutionnelle qu’il faut entretenir. Celui-ci invite à en élargir encore la définition. Préserver l’accès aux livres et le désir de lire ne suffit peut-être pas : l’infrastructure de la lecture comprend aussi les conditions qui rendent certaines formes d’attention plus faciles à exercer, qui permettent de ralentir et de rester suffisamment longtemps avec un texte.

Le problème n’est donc peut-être pas simplement que nous lisions désormais sur des écrans. Il tient aussi à l’écologie dans laquelle se déroule une part croissante de nos activités numériques : vitesse, abondance, sollicitations et passage incessant d’un contenu à l’autre. Cette écologie n’est pas tombée du ciel. Elle est faite de plateformes, d’interfaces, de modèles économiques, de normes sociales et de choix technologiques. Penser l’infrastructure de la lecture à l’ère numérique suppose alors de s’intéresser aussi à ses conditions attentionnelles : les temps, les lieux, les dispositifs et les pratiques qui rendent possible une attention longue.

Certaines bibliothèques en offrent déjà des exemples intéressants. On voit notamment se multiplier les Silent Reading Parties (voir notamment la Seattle Public Library et la Richmond Public Library), où des personnes se réunissent avec le livre de leur choix pour lire ensemble, en silence, pendant une période réservée à cette seule activité. Il serait excessif d’en faire automatiquement des expériences de « lecture profonde » au sens où l’entend Wolf. Mais elles ont quelque chose de remarquable : elles organisent les conditions de l’attention. Ce qui pourrait sembler une activité strictement individuelle — s’asseoir et lire pendant une heure — devient une pratique soutenue par un lieu, un temps et la présence des autres.

D’autres initiatives interviennent plus directement sur notre rapport aux technologies. J’ai aussi lu, via Sentiers no. 413, que cet été, des ateliers intitulés Avoiding AI, d’abord développés par la bibliothécaire Hannah Cyrus dans le Maine puis repris dans d’autres bibliothèques américaines, ont connu un succès inattendu. On y explique le fonctionnement des outils d’intelligence artificielle, mais aussi comment désactiver les fonctionnalités que l’on ne souhaite pas utiliser. La démarche est intéressante parce qu’elle ne relève pas tant d’un rejet de la technologie que d’un projet de littératie informationnelle/numérique centré sur l’autonomie et le choix.

À première vue, lire silencieusement ensemble et apprendre à désactiver des fonctions d’IA peuvent sembler deux activités très éloignées. Elles ont pourtant quelque chose en commun : elles permettent de reprendre une certaine maîtrise de notre environnement attentionnel. La bibliothèque ne donne plus seulement accès aux textes, à l’information et aux technologies. À la manière d’un refuge, elle peut aussi offrir une certaine distance critique à leur égard : créer du temps pour lire sans sollicitation et donner les moyens de choisir quand et comment nous voulons utiliser les technologies qui nous entourent.

Le déplacement proposé par Seybold prend alors tout son sens. Protéger la possibilité d’une lecture profonde ne consisterait pas seulement à exhorter chacun et chacune à poser son téléphone et à lire davantage. Cela pourrait aussi vouloir dire organiser collectivement les conditions permettant de lire, d’écouter et de discuter attentivement.

On retrouve ici quelque chose de l’esprit de la littératie communautaire, qui envisage la lecture non seulement comme une compétence individuelle, mais comme une pratique sociale, située et partagée. La communauté peut ainsi devenir une communauté de lecture profonde : un espace où l’attention se soutient mutuellement, où les interprétations se confrontent et où le sens se construit avec d’autres. Les écoles et les universités ont évidemment une responsabilité comparable lorsqu’elles ménagent encore la possibilité de lire une œuvre entière plutôt que son résumé, de suivre un raisonnement plutôt que d’en extraire immédiatement quelques informations, de revenir à un texte plutôt que de simplement le traverser et, surtout, d’en discuter avec d’autres.

L’intelligence artificielle rend cet enjeu plus aigu encore. Elle nous permet désormais d’obtenir en quelques secondes le résumé, l’explication ou l’analyse d’un texte. Ce qui devient alors précieux n’est peut-être plus seulement l’accès au contenu, mais l’expérience cognitive et intellectuelle que nous acceptons d’accomplir nous-mêmes pour y parvenir. Lire un texte n’est pas seulement accéder à ce qu’il contient : c’est aussi exercer les opérations qui permettent de l’interpréter, de l’interroger, de le mettre en relation avec d’autres idées et, parfois, de résister à la facilité d’une réponse déjà produite.

La neuroplasticité nous rappelle que nos manières de lire ne sont pas immuables : elles se développent et s’exercent avec nos pratiques. Cela ne signifie pas, comme on l’a vu, que les écrans détériorent nécessairement nos capacités attentionnelles. Mais si certains environnements nous incitent à accélérer, à survoler ou à passer constamment d’un contenu à l’autre, nous pouvons aussi aménager des conditions qui facilitent le geste inverse : ralentir, s’attarder, relire, discuter. L’infrastructure de la lecture est, en ce sens, aussi une infrastructure de l’attention et re-littératie.

Apprendre à changer de régime de lecture

C’est pourquoi, pour revenir à celle-ci, la proposition de Wolf d’un cerveau bilittéracié me paraît particulièrement forte. Il ne s’agit pas de choisir entre Gutenberg et le numérique, ni de transformer le papier en étendard contre la modernité. Il s’agit de devenir capables de reconnaître les différents régimes de lecture et de passer consciemment de l’un à l’autre. Savoir quand parcourir. Quand chercher. Quand sélectionner. Mais aussi quand ralentir. Quand revenir. Quand relire. Quand s’attarder. Et peut-être faut-il désormais ajouter : quand lire ensemble.

Alors, pour reprendre la question du titre : que devient la lecture profonde à l’ère numérique? On pourrait dire, qu’elle ne disparaît pas, pas plus que la lecture elle-même. Mais elle ne va peut-être plus de soi. Dans un environnement qui nous entraîne souvent vers la vitesse, la sollicitation et le passage d’un contenu à l’autre, elle devient une pratique qu’il faut consciemment, intentionnellement, préserver, exercer et soutenir. Lire autrement, ce serait alors non pas renoncer au numérique, mais apprendre à choisir notre manière de lire : savoir profiter de la rapidité, de l’accès et de la puissance de recherche qu’il permet, tout en demeurant capables, lorsque le texte et la situation le demandent, de ralentir, de soutenir notre attention et d’aller en profondeur.

Mais cette capacité de choisir ne relève pas seulement de la volonté individuelle. Nous ne choisissons jamais nos régimes de lecture dans le vide. Les plateformes, les interfaces, les modèles économiques, les institutions et les espaces dans lesquels nous lisons organisent eux aussi notre attention : ils rendent certaines manières de lire plus faciles, plus habituelles ou plus désirables que d’autres.

L’actualité récente en offre une illustration frappante. Aux États-Unis, les poursuites engagées contre Meta ne portent plus seulement sur les contenus auxquels les jeunes sont exposés, mais sur la conception même des plateformes et de dispositifs destinés à maximiser l’engagement : défilement infini, lecture automatique, notifications, recommandations algorithmiques. Un jugement rendu au Nouveau-Mexique au début d’août, puis un important règlement conclu quelques semaines plus tard avec des États américains, imposent désormais à Meta des mesures qui interviennent directement sur cette architecture de l’attention.

Désormais, plutôt que de demander seulement aux individus de mieux gérer leur attention, il faut aussi examiner de manière critique les infrastructures qui la sollicitent, la captent et l’organisent. Défendre la possibilité d’une lecture profonde suppose alors non seulement de préserver certaines pratiques de lecture, mais aussi de transformer les environnements qui les fragilisent et d’en construire d’autres qui puissent les soutenir.

La question qui traverse finalement ces trois billets n’est donc peut-être pas : allons-nous continuer à lire? Elle serait plutôt : quelles formes de lecture voulons-nous préserver, et quelles infrastructures devons-nous transformer ou construire collectivement pour continuer à en être capables?

Car une société de lectrices et de lecteurs ne se construit pas toute seule. Une société capable de lecture profonde non plus.

Bonne rentrée!

  • ✇bibliomancienne
  •  Vers une société postlittéraire? Retour sur « la fin de la lecture » annoncée par Rose Horowitch
    Les discussions récentes autour du déclin de la lecture et l’échange que j’ai eu avec Alexandre Sirois m’ont donné envie de revenir sur une question qui me préoccupe depuis un certain temps déjà : sommes-nous réellement en train de devenir une société qui lit moins? Un article récent de The Atlantic, « The End of Reading Is Here » établit le diagnostic de manière particulièrement saisissante en évoquant l’entrée dans une possible « ère postlittéraire ». L’article qu’Alexandre Sirois lui a
     

 Vers une société postlittéraire? Retour sur « la fin de la lecture » annoncée par Rose Horowitch

14 août 2026 à 09:50

Les discussions récentes autour du déclin de la lecture et l’échange que j’ai eu avec Alexandre Sirois m’ont donné envie de revenir sur une question qui me préoccupe depuis un certain temps déjà : sommes-nous réellement en train de devenir une société qui lit moins?

Un article récent de The Atlantic, « The End of Reading Is Here » établit le diagnostic de manière particulièrement saisissante en évoquant l’entrée dans une possible « ère postlittéraire ». L’article qu’Alexandre Sirois lui a consacré dans La Presse, à l’occasion du 12 août, contribue malgré tout à déplacer la réflexion vers une autre question : quelles conditions devons-nous préserver ou créer pour demeurer une société de lecteurs et de lectrices?

Je propose donc d’explorer ces enjeux en trois billets avant que la rentrée nous happe. Le premier reviendra sur le diagnostic de Rose Horowitch et sur cette idée forte d’une société « post-littéraire » ou « post-lettrée ». C’est l’article d’Alexandre Sirois qui servira de déclencheur pour le deuxième, notamment pour s’intéresser aux conditions collectives de la lecture — bibliothèques, écoles, librairies, familles, organismes et politiques publiques. Enfin, le troisième s’appuiera notamment sur les travaux de Maryanne Wolf et Naomi Baron, deux autrices que je présente régulièrement dans mes cours, pour examiner ce que le numérique, les écrans et, désormais, l’intelligence artificielle changent à nos façons de lire, à notre attention et à notre capacité à entrer dans une lecture profonde.

L’objectif n’est donc pas d’annoncer, encore une fois!, la fin de la lecture ou la mort du livre, pas plus que de céder à la nostalgie du papier. Je voudrais simplement contribuer à cette conversation pour mieux comprendre les transformations en cours et réfléchir aux conditions qui pourraient permettre à la lecture et à la pensée de conserver une fonction importante dans nos vies individuelles et collectives.


Il n’est pas nécessaire de brûler les livres pour qu’ils disparaissent de nos vies. Il suffit, suggérait Ray Bradbury en 1993 dans le Seattle Times, que nous cessions de les lire (« You don’t have to burn books to destroy a culture. Just get people to stop reading them. »). Cette formule prend une résonance particulière à la lecture du long article que Rose Horowitch vient de consacrer, dans The Atlantic, et à ce qu’elle présente comme une transformation historique : l’entrée possible dans une société « postlittéraire ». Le titre donne le ton : The End of Reading Is Here. La fin de la lecture serait arrivée. (Étonnamment, cette célèbre formule de Bradbury ne traverse pas l’article de Horowitch, alors qu’elle semble planer sur tout le diagnostic qu’elle prononce).

L’affirmation est spectaculaire. Elle mérite qu’on s’y arrête, mais aussi qu’on la nuance. Car Horowitch ne soutient pas que nous serions soudainement devenus incapables de lire. Nous n’avons probablement jamais été exposés à autant de mots : textos, courriels, publications sur les réseaux sociaux, notifications, fils de discussion, nouvelles en ligne et tutti quanti. Nous passons une bonne partie de nos journées à lire quelque chose.

Son inquiétude porte sur une autre forme de lecture, la lecture profonde : celle qui demande de rester longtemps avec un texte, de suivre un raisonnement, de tolérer momentanément de ne pas comprendre puis de revenir en arrière, d’interpréter, de faire des inférences et de construire progressivement du sens. Autrement dit, la question n’est peut-être pas simplement : lisons-nous moins? Elle pourrait plutôt être : Avons-nous encore la disposition et la capacité nécessaires pour lire de manière profonde?

Une société qui sait lire, mais qui lit autrement

Horowitch rassemble une série de données américaines inquiétantes : recul de la lecture de livres et de la lecture pour le plaisir, diminution de certaines compétences en compréhension, difficultés croissantes devant des textes complexes, chez les jeunes comme chez les adultes. Mais son argument devient beaucoup plus intéressant lorsqu’elle distingue l’alphabétisation, la littératie et la culture de l’écrit.

Une société « postlittéraire » n’est pas nécessairement une société peu alphabétisée. C’est une société dans laquelle les individus savent toujours lire, mais où la lecture longue et soutenue cesse progressivement d’occuper un rôle central dans la vie culturelle et intellectuelle. La thèse de Horowitch va cependant plus loin : la lecture longue tendrait à devenir une pratique encore plus minoritaire et, ce faisant, à perdre la fonction structurante qu’elle aurait longtemps exercée dans la culture commune. Le problème ne serait donc pas seulement que certains individus lisent moins, mais que cette forme de lecture soit de moins en moins largement partagée.

C’est une distinction importante. Décoder un texte, le comprendre, l’interpréter et penser avec lui ne sont pas exactement la même chose.

Horowitch s’appuie ici sur une archéologie de la lecture. L’être humain n’est pas né lecteur. L’écriture et la lecture sont des technologies culturelles que nous avons apprises et qui, en retour, ont contribué à transformer nos manières de penser. La culture écrite a notamment favorisé certaines pratiques intellectuelles : suivre un raisonnement sur plusieurs pages, confronter des propositions, revenir sur une idée, comparer des passages, construire une argumentation, maintenir son attention malgré la difficulté. D’où une des hypothèses centrales de l’article, qui vaut la peine d’être prise au sérieux : si l’apprentissage de la lecture a transformé nos manières de penser, que pourrait produire son recul?

Du livre à TikTok : une nouvelle économie de l’attention

Horowitch poursuit son argumentaire en soulignant que cette inquiétude n’est évidemment pas nouvelle. Elle réfère à Marshall McLuhan qui annonçait déjà dans La galaxie Gutenberg (The Gutenberg Galaxy), en 1962, que les médias électroniques allaient ébranler la domination culturelle de l’imprimé. Neil Postman poursuivait cette réflexion dans Se distraire à en mourir (Amusing Ourselves to Death) en 1985. Mais quelque chose a changé d’échelle.

La télévision devait encore être allumée; ses programmes avaient un début et une fin. Le téléphone intelligent, lui, nous accompagne partout et donne accès à une offre de divertissement pratiquement illimitée. Et Internet lui-même se reconfigure. L’univers numérique des débuts était largement textuel. Une part croissante de l’attention est désormais captée par TikTok, les Reels, YouTube Shorts et d’autres formats audiovisuels courts. Le changement ne consiste donc plus seulement à dire que les écrans concurrencent les livres. C’est le statut du texte lui-même dans notre environnement informationnel qui est toujours un peu plus en décalage.

Horowitch décrit alors une sorte de cercle vicieux : moins de lecture longue et profonde → moins d’endurance attentionnelle → davantage de difficulté à lire des textes complexes → moins de plaisir à les lire → encore moins de lecture longue.

L’hypothèse est préoccupante, notamment pour l’école. Si l’on rencontre de moins en moins souvent des œuvres intégrales et des textes exigeants, comment développe-t-on les capacités — voire les circuits neuronaux — qui permettent de les lire en profondeur et de penser de manière critique?

Et maintenant, l’IA

L’arrivée de l’intelligence artificielle générative ajoute une dimension nouvelle au problème. Jusqu’ici, les technologies numériques permettaient surtout de contourner l’effort de la lecture longue. L’IA permet maintenant de déléguer une partie de l’écriture elle-même : résumer un texte, produire une argumentation, reformuler une idée, voire lire une œuvre à notre place pour nous en restituer « l’essentiel ». Or, écrire n’est pas seulement transcrire une pensée déjà constituée.

Nous écrivons aussi pour découvrir ce que nous pensons. Ce carnet, pour moi, a souvent joué ce rôle, comme d’autres avant lui : c’était le « vide-grenier », mais aussi l’atelier, le lieu où les concepts se déposent, se cherchent, se frottent les uns aux autres et, parfois, émergent. Chercher un mot, organiser un argumentaire, supprimer une phrase, critiquer : tout cela participe au travail de la pensée. La question posée par l’IA devient alors particulièrement intéressante : que se passe-t-il lorsque nous pouvons externaliser non seulement une partie de la lecture, mais aussi une partie de l’effort nécessaire pour étayer notre pensée? C’est probablement l’une des questions les plus fécondes soulevées par l’article.

De la lecture à la démocratie : attention aux raccourcis

Horowitch va cependant encore plus loin. Elle suggère la présence d’un lien entre le recul de la culture écrite et des évolutions récentes du discours politique. Dans un environnement dominé par l’immédiateté, les algorithmes et les contenus courts, les messages simples, polarisants, personnalisés et émotionnellement chargés disposeraient d’un avantage considérable. Donald Trump devient, dans son analyse, une figure emblématique de cette politique « postlittéraire ». Cette hypothèse est intéressante et appelle une discussion; c’est aussi à cet endroit que l’article appelle peut-être davantage de distance critique.

Car il y a une différence entre constater des changements bien documentés de nos pratiques médiatiques et attentionnelles et leur attribuer directement des basculements aussi complexes que celles de la démocratie et de la vie politique. Plus généralement, le passage de « nos pratiques de lecture se transforment » à « nous entrons dans une société postlittéraire » constitue un saut et une interprétation beaucoup plus ambitieuse que ce que les données qu’elle présente le démontrent à elles seules.

Et au Québec?

C’est également ici qu’il faut résister à la tentation de transposer directement au Québec le diagnostic très américain que dresse l’autrice. Les données québécoises récentes offrent un portrait relativement nuancé par rapport à celles des États-Unis. Selon l’Enquête québécoise sur les loisirs culturels et le divertissement de 2024, que j’ai consultée et partagée avec un grand intérêt, 82 % des Québécois et Québécoises de 15 ans et plus déclarent avoir lu au moins un livre, papier ou numérique, dans leurs temps libres au cours des douze mois précédents. Dans l’ensemble de la population, 23 % lisent tous les jours ou presque et 19 % au moins une fois par semaine.

Une comparaison avec les États-Unis donne néanmoins un point de repère, à condition de rester prudents : les deux enquêtes ne portent pas exactement sur les mêmes populations et ne mesurent pas la lecture de la même manière. Le National Endowment for the Arts rapporte, à partir de sa Survey of Public Participation in the Arts, qu’en 2022, 48,5 % des adultes américains avaient lu au moins un livre au cours de l’année, contre 52,7 % en 2017 et 54,6 % en 2012. La lecture de fiction, soit de romans ou de nouvelles (novels or short stories) est, elle aussi, passée de 45,2 % en 2012 à 37,6 % en 2022. Il serait donc trompeur d’opposer directement le 82 % québécois au 48,5 % américain. Ces données permettent néanmoins de constater que le portrait québécois ne correspond pas, du moins pour l’instant, au même scénario de recul généralisé.

Le portrait devient encore plus intéressant lorsqu’on regarde du côté des jeunes. Au Québec, les 15-29 ans ne sont pas ceux qui lisent le moins : 86 % disent avoir lu au moins un livre au cours des douze mois précédents, soit la même proportion que chez les 30-44 ans. Mais la situation change lorsqu’on s’intéresse à la fréquence : seulement 17 % des 15-29 ans lisent tous les jours ou presque, comparativement à 30 % chez les 60-74 ans.

Dans le contexte de la journée « Le 12 août, j’achète un livre québécois », ce constat prend toutefois une autre dimension. Car si les jeunes du Québec lisent bel et bien, la question est aussi de savoir ce qu’ils et elles lisent et quelle importance ils et elles accordent aux livres québécois. Les données disponibles suggèrent en effet que les jeunes générations sont moins portées à privilégier les œuvres d’ici que les générations précédentes. L’enjeu n’est donc pas seulement de maintenir la lecture chez les jeunes, mais aussi de faire en sorte que la littérature québécoise s’inscrive dans leurs pratiques et leurs univers culturels.

Les supports, eux aussi, évoluent. Au Québec, 26 % de la population lit des livres numériques et 15 % écoute des livres audio. Ces pratiques sont nettement plus répandues chez les 15-29 ans : 36 % lisent des livres numériques et 21 % écoutent des livres audio. Là encore, ces données invitent à se méfier du récit trop simple de « la fin de la lecture ».

Voilà qui nous ramène plus précisément au troublant problème soulevé par The Atlantic. Les jeunes, comme les moins jeunes, n’ont pas cessé de lire. La question est plutôt celle de l’intensité, de la régularité et, peut-être, de l’endurance de cette pratique. Autrement dit, ce qui pourrait se fragiliser n’est pas nécessairement le contact avec le livre, encore moins la capacité de lire, mais la présence de la lecture profonde dans la vie quotidienne.

Nous sommes donc vraisemblablement moins devant une « fin de la lecture » que devant une recomposition des pratiques de lecture : ce que nous lisons, sur quels supports, à quelle fréquence, pendant combien de temps, avec quel degré d’attention et au milieu de quelles autres sollicitations. C’est peut-être là que se situe le véritable déplacement : non pas dans la disparition de la lecture, mais dans la fragilisation de la lecture soutenue ou profonde.

Alexandrie à l’envers

L’image la plus puissante, selon moi, de l’article de Horowitch est peut-être celle par laquelle il commence et se termine : la bibliothèque d’Alexandrie. Pendant des siècles, l’un des grands problèmes des sociétés lettrées a été de préserver les textes. Des manuscrits disparaissaient, des bibliothèques brûlaient, des œuvres devenaient inaccessibles. Or, nous nous trouvons aujourd’hui dans une situation presque inverse. Jamais autant de textes n’ont été aussi facilement accessibles. Des « bibliothèques » entières tiennent dans un téléphone. La question n’est donc plus seulement : Comment préserver les livres? Elle devient : Comment préserver les conditions qui donnent envie de les lire et permettent de le faire?

C’est là que je m’éloignerais le plus catégoriquement du diagnostic de « la fin de la lecture ». La lecture n’a pas disparu. Pas encore, en tout cas. Mais il devient nécessaire et urgent de soutenir plus activement les conditions de la lecture longue, attentive et exigeante, dans un environnement qui offre en permanence des solutions plus rapides et plus immédiatement gratifiantes.

Et cette responsabilité ne dépend pas seulement de la volonté individuelle des personnes lectrices, dimension sur laquelle insiste davantage, sinon trop, Horowitch. Une société de lecteurs et de lectrices ne se maintient pas toute seule. Elle repose sur des familles, des écoles, des bibliothèques, des librairies, des maisons d’édition, des médiateurs, des médiatrices et des communautés qui rendent les livres accessibles, mais surtout visibles, désirables, partageables et aptes à nourrir la conversation. C’est d’ailleurs l’une des nuances importantes à apporter au récit de « la fin de la lecture » : la lecture est une pratique sociale, et non seulement une compétence ou une disposition individuelle.

Ce serait l’objet d’un prochain billet : si nous voulons demeurer une société de lecteurs et de lectrices, quelle écologie de la lecture devons-nous entretenir?

  • ✇bibliomancienne
  • Les bibliothèques dans les pratiques culturelles au Québec : Une analyse critique
    Le rez-de-chaussée de la bibliothèque Gabrielle-Roy à Québec qui vient de remporter le prix de la bibliothèque publique de l’année de l’International Federation of Library Associations and Institutions À noter : J’ai initialement entamé et publié cet article sur la plateforme Praxis de Projet collectif. Toutefois, consciente et soucieuse des aléas et des destins parfois incertains des plateformes numériques, je republie ces contenus également sur ma propre plateforme, afin d’en assurer la pér
     

Les bibliothèques dans les pratiques culturelles au Québec : Une analyse critique

26 août 2025 à 14:46
Le rez-de-chaussée de la bibliothèque Gabrielle-Roy à Québec qui vient de remporter le prix de la bibliothèque publique de l’année de l’International Federation of Library Associations and Institutions

À noter : J’ai initialement entamé et publié cet article sur la plateforme Praxis de Projet collectif. Toutefois, consciente et soucieuse des aléas et des destins parfois incertains des plateformes numériques, je republie ces contenus également sur ma propre plateforme, afin d’en assurer la pérennité et l’accessibilité.

En 2024, l’Institut de la statistique du Québec a mené l’Enquête québécoise sur les loisirs culturels et le divertissement (EQLCD), une vaste étude auprès de plus de 16 000 personnes de 15 ans et plus. L’objectif est de mieux comprendre comment les Québécois et Québécoises pratiquent la culture aujourd’hui, dans un contexte caractérisé par l’essor du numérique et la diversification des usages. Ce rapport important mérite toute l’attention des acteurs et actrices œuvrant dans le milieu des bibliothèques incluant celleux qui les gouvernent.

Ce rapport attendu, qui vient d’être publié, s’inscrit dans la lignée des enquêtes réalisées depuis 1979 sur les pratiques culturelles. Il permet cette fois de capter l’ampleur des transformations numériques récentes : instantanéité, mobilité, interactivité, entre autres. Il donne à voir l’importance croissante des usages numériques, la variété des pratiques selon les secteurs (lecture, musique, audiovisuel, arts de la scène) et les déterminants sociaux, ainsi que la place des activités culturelles vécues dès l’enfance.

À travers ce portrait, se révèlent non seulement la vitalité culturelle du Québec, mais aussi les inégalités et les écarts générationnels qui continuent de structurer l’accès et la participation aux biens culturels et au capital culturel [1]. Je veux me pencher, plus particulièrement, sur les pratiques entourant les bibliothèques.

Les bibliothèques occupent une place singulière dans les pratiques culturelles des Québécois et des Québécoises. Elles se présentent à la fois comme des lieux de culture, de socialisation et d’apprentissage, mais aussi comme des portes d’entrée vers la lecture et les savoirs numériques. Plus que de simples dépôts de livres, on le répète souvent, elles constituent des espaces où se tissent des liens sociaux, des nouveaux tiers lieux (Jacobs, 1961 ; Putnam et Feldstein, 2003), où s’expérimentent des formes particulières de médiation culturelle et interculturelle (White et Martel, 2021). C’est en ce sens qu’elles peuvent être pensées comme de véritables infrastructures critiques (Mattern, 2014 ; Klinenberg, 2018), indispensables à la dynamique des communautés et à l’opérationnalisation de la justice sociale. Elles cristallisent cependant plus d’un paradoxe : très fréquentées, elles demeurent néanmoins largement invisibles dans le discours public sur la culture; conçues pour réduire les inégalités, elles tendent aussi, à certains égards, à les reproduire. Que nous apprend alors ce rapport dans ces circonstances?

Que nous apprend ce rapport au sujet des bibliothèques?

D’abord, il faut souligner que l’EQLCD jette un nouvel éclairage sur le portrait des bibliothèques déjà tracé par les données provenant du bulletin Optique culture, no 99 (décembre 2024), « Les bibliothèques publiques québécoises en 2022 », rédigé par Sylvie Marceau (Observatoire de la culture et des communications du Québec) [2]. On pouvait lire dans cette étude qu’en 2022, les bibliothèques publiques québécoises, présentes dans 932 municipalités, rejoignant 97 % de la population, offraient un accès à 56 millions de documents, soit environ sept par personne habitante. Leur fréquentation a atteint 20 millions d’entrées, en hausse marquée par rapport à 2021 (+34 %), mais toujours inférieure de 30 % aux niveaux pré-pandémiques. La participation aux activités (1,1 million de personnes) suivait la même tendance, en nette reprise mais en deçà des 1,7 million de 2019. Les prêts progressaient (+19 %), avec un maintien élevé des usages numériques, preuve de leur ancrage durable. Au plan financier, les revenus et dépenses indiquaient une augmentation, traduisant des investissements accrus, mais timides, en services et en personnel. Ces résultats montraient donc que les bibliothèques sortaient progressivement de la crise sanitaire. Elles se devaient, comprenait-on dès lors, de consolider leur rôle en tant que lieux physiques de fréquentation régulière tout en tirant parti de la généralisation du numérique pour renforcer leur capacité sociale et culturelle.

Ces résultats chiffrés prennent un nouveau sens lorsqu’on les relie aux tendances dégagées par l’EQLCD : la croissance du numérique, la fracture générationnelle et sociale des pratiques culturelles, et la tension entre inclusion et distinction.

Mais que nous apprend donc ce rapport au sujet des bibliothèques?

Le numérique en plein essor

Le contexte : La quasi-totalité (96%) de la population utilise internet à des fins personnelles; 74% utilisent des outils numériques pour faire des achats en ligne. Dans les douze mois précédant l’enquête, 29 % de la population a emprunté ou réservé des livres en ligne (p. 9; p. 33). Ce chiffre grimpe à 34 % chez les femmes (c. 24%), à 34 % chez les 15-29 ans, 36 % chez les 30-44 ans et à 40 % chez les diplômés universitaires (c. 29% pour l’ensemble de la population); ce qui illustre le rôle grandissant des services numériques de bibliothèque. Derrière ces données se lit et se consolide une transformation profonde : la bibliothèque se déploie dans nos écrans, se rend accessible à distance, et touche des publics pour qui la mobilité, le temps ou la langue (peut-être plus particulièrement depuis l’application de la loi 14 dans ce dernier cas), sont des obstacles.

En parallèle, 6 % des Québécois et Québécoises ont participé à une activité culturelle en ligne offerte par une bibliothèque (p.33). Ce taux est plus élevé chez les jeunes familles, les 30-44 ans (10%) et les personnes immigrantes (11%). On explique ces résultats, entre autres, par le type d’activités proposées et visant généralement les familles, notamment en contexte interculturel : capsules vidéo, cours et jeux en ligne, ateliers de français ou de clubs de lecture virtuels, ces pratiques rappellent que la bibliothèque est aussi un espace d’intégration et d’accompagnement. On précise, de surcroît, que l’enquête ne permet pas d’observer de différence notable selon le revenu du ménage en ce qui a trait à la participation à une activité en ligne organisée par une bibliothèque ou autre (p. 34).

Avant d’aller plus loin, présentons brièvement les principales données concernant la lecture et l’écoute de livres (papier, numérique et audio), la fréquentation des bibliothèques étant encore intimement liée à la lecture.

Lecture et écoute de livres : principaux résultats de l’EQLCD

Le chapitre 4 de l’EQLCD (pp. 68-79) consacré à la lecture et à l’écoute de livres permet de mieux comprendre les pratiques actuelles, qu’elles soient liées aux formats papier, numériques ou audio. Trois volets sont abordés : le profil sociodémographique du lectorat, la lecture numérique et l’écoute de livres audio.

L’écosystème québécois du livre est à la fois vaste et diversifié : plus de 200 librairies, une centaine de maisons d’édition publiant près de 7 700 titres par an, et surtout, comme on l’a dit plus tôt, plus de 1 000 bibliothèques publiques desservant 97 % de la population (p.69). Ces institutions occupent une place stratégique dans l’accès et la démocratisation de la lecture, tout en étant confrontées à des défis et à des tensions qui viennent nuancer ce rôle.

Par « lecture de livres », on entend  « habitudes de lecture de livres (papier ou numérique) durant les temps libres, en dehors des obligations professionnelles et scolaires. Cela comprend la lecture faite à des enfants, mais exclut la lecture de journaux et de magazines » (p.69).

Le « lectorat » est défini comme « la population de 15 ans et plus qui a lu un livre (papier ou numérique) au cours des 12 mois précédant l’enquête » (p. 19).

Qui lit des livres au Québec et comment ?

Selon l’enquête, 82 % des personnes de 15 ans et plus ont lu au moins un livre papier ou numérique dans leurs temps libres au cours des 12 mois précédents (p.69). La lecture est plus fréquente chez les femmes (89 %) que chez les hommes (75 %), et elle augmente avec le niveau de scolarité : 93 % des diplômés universitaires lisent, contre 68 % des personnes sans diplôme. Les ménages à revenu élevé (89 %) et les personnes nées à l’extérieur du Québec (88 %) présentent aussi des taux plus élevés de lecture (p.69-70). À l’inverse, la lecture est moins répandue en région en dehors de la métropole (75 % contre 83–85 % en milieu plus urbain) et chez les personnes dont la langue parlée à la maison est uniquement le français (79 % contre 88–90 % pour les autres groupes linguistiques) (p.70).

Un quart de la population de 15 ans et plus (23 %) lisent tous les jours ou presque, tandis que 19 % lisent au moins une fois par semaine, 20 % une fois par mois, 18% n’ont pas lu de livre pendant cette période (p. 70). Les jeunes de 15 à 29 ans lisent proportionnellement autant que les autres groupes d’âge (86 %), mais leur lecture est moins quotidienne (17 % contre 27–30 % chez les 60 ans et plus). Les femmes et les diplômés universitaires se distinguent par une plus grande régularité de lecture (p. 70). 

Genres littéraires

Les genres les plus populaires sont les suivants :

  • Romans et nouvelles (36 % du lectorat), particulièrement chez les personnes aînées (44 % des 75 ans et plus).
  • Livres de développement personnel (17 %), surtout chez les 45–59 ans.
  • Livres pratiques (16 %), prisés par les 45–74 ans.
  • Bandes dessinées (15 %) chez les 15–29 ans.
  • Livres jeunesse (20 %) chez les 30–44 ans, en lien avec la lecture faite aux enfants.
  • Biographies (19 %) chez les 75 ans et plus (p. 71).

Ce panorama illustre bien la segmentation générationnelle des goûts littéraires : les jeunes privilégient les genres visuels et ludiques (BD, jeunesse), les personnes adultes d’âge moyen s’orientent vers des ouvrages pratiques ou de développement personnel, tandis que les personnes aînées restent attachés aux formes plus classiques (romans, biographies). On retrouve ici une structuration des préférences en fonction des cycles de vie, mais aussi des rôles sociaux associés à chaque étape (parentalité, retraite, etc.).

Motivations et obstacles

Les principales motivations de lecture sont le plaisir et le divertissement (82 %), la détente (80 %) et l’apprentissage (71 %). Chez les 30-44 ans, la lecture revêt une dimension familiale marquée : une personne sur deux lit pour ses enfants, ce qui souligne le rôle de la lecture comme pratique de transmission intergénérationnelle (p. 72). Ici encore, la bibliothèque est susceptible d’agir comme médiatrice culturelle et éducative. 

Du côté des personnes non-lectrices (18 % de la population), les raisons évoquées sont surtout le manque d’intérêt (71 %), le prix élevé des livres (61 %) et le manque de temps (44 %). Les difficultés de lecture comme frein à la pratique sont plus souvent évoquées par les 75 ans et plus (29 %) et, dans une moindre mesure, par les 15-29 ans (21 %), comparativement aux groupes intermédiaires (13 à 21 %) (p. 73). Ce constat suggère que les obstacles liés à la lecture touchent à la fois les âges avancés, souvent en raison de facteurs physiques et/ou cognitifs, et les plus jeunes, possiblement en lien avec des enjeux scolaires ou de littératie.

Seules de faibles proportions mentionnent l’absence de bibliothèque (9 %) ou la complexité des modalités d’emprunt (14 %) (p.73). Ceci souligne la valeur du réseau public déjà largement accessible, mais dont l’utilisabilité pourrait encore être améliorée.

Langues et provenance des auteurs

La langue de lecture illustre un clivage générationnel : 64 % du lectorat lit surtout en français, mais cette proportion chute à 48 % chez les 15–29 ans, qui lisent davantage en anglais (26 %) ou de manière bilingue (23 %) (p.74).

Quant à la provenance des personnes autrices, 18 % du lectorat privilégient surtout les autrices et auteurs québécois. Cette proportion grimpe à 22–26 % chez les 60 ans et plus, mais tombe à 15 % chez les 15–29 ans, qui se tournent majoritairement vers des auteurs et autrices non québécoises (54 %). Ce décalage générationnel met en lumière la difficulté pour la littérature québécoise de s’imposer auprès des plus jeunes, malgré la vitalité de l’édition locale (p.74).

Lecture numérique et audio

Depuis les années 2000, les livres numériques ont élargi l’accessibilité à la lecture, notamment grâce aux bibliothèques publiques qui contribuent à une offre en ligne généreuse. Ils favorisent la diversité des usages et, avec leurs fonctionnalités interactives, enrichissent l’expérience des personnes usagères.

La lecture numérique a été adoptée par 24 % de la population, principalement les jeunes (32 % des 15–29 ans) et les universitaires (32 %):

« La lecture de livres numériques semble être associée au diplôme obtenu. Les personnes n’ayant aucun diplôme ou celles ayant tout au plus un diplôme de niveau secondaire sont moins nombreuses en proportion à avoir lu des livres numériques (respectivement 17 % et 18 %) que les personnes détenant un diplôme de niveau collégial (23 %) ou universitaire (32 %) » (p. 76).

Ce serait aussi le cas en ce qui concerne le revenu. En outre, les personnes immigrantes lisent proportionnellement plus en numérique (34 %) que les natives du Québec (21 %) (p.77).

L’écoute de livres audio concerne 15 % de la population, avec une surreprésentation des 15–44 ans et des ménages à revenu élevé. Cette pratique serait également associée au diplôme et au revenu (pp. 78-79). Comme pour les livres numériques, les personnes vivant dans la région métropolitaine ou nées à l’extérieur du Québec sont plus nombreuses à adopter cette pratique (23 % contre 13 % des personnes natives)(p.79).

Il semble que les bibliothèques publiques évoluent dans un contexte où la lecture demeure une pratique culturelle majeure mais socialement différenciée. Elles contribuent à atténuer les inégalités d’accès, particulièrement face au prix élevé des livres, tout en ayant à relever le défi de la diversification des publics et des supports (numérique et audio).

La fréquentation physique, entre fidélité et comparaison

Considérons maintenant les résultats du chapitre 5 sur les lieux et événements culturels (pp. 80-86). On y apprend que près d’une personne sur deux (49 %) visite une bibliothèque au moins une fois par an, et que 24 % s’y rendent plusieurs fois (voir la capture d’écran du tableau 5.1). Ce taux est légèrement inférieur à celui des musées (51 %) et nettement en deçà de celui des librairies (62 %) (p.81). 

Toutefois, les bibliothèques se démarquent par la régularité de leur fréquentation : un quart des Québécois et Québécoises y retournent plusieurs fois par an. Comparativement aux autres lieux culturels (seulement 11 % retournent plusieurs fois dans les musées par exemple), elles figurent parmi les rares institutions à maintenir une régularité d’usage « ordinaire ». Cette donnée souligne encore que les bibliothèques ne relèvent pas seulement d’une sortie culturelle ponctuelle, mais qu’elles s’imposent comme de véritables tiers lieux, des lieux de vie dont l’offre est intégrée aux routines sociales, éducatives et communautaires. Comme le rappelle l’EQLCD : « près du quart (24 %) des personnes de 15 ans et plus ont fréquenté plusieurs fois dans l’année des bibliothèques publiques, et 29 % ont visité plusieurs fois des librairies » (voir capture d’écran du tableau 5.1). Cette fidélité s’explique par l’offre particulière de ces lieux consacrés au livre et à la lecture (prêt de documents, activités culturelles et rencontres littéraires) qui contribue à ancrer durablement les bibliothèques dans leur communauté (p. 83).

En revanche, plus de la moitié des personnes répondantes déclarent ne pas avoir fréquenté une seule fois une bibliothèque au cours de cette période.

Qui fréquente les bibliothèques ?

Les profils révèlent des écarts persistants. Les femmes fréquentent davantage les bibliothèques (55 % contre 44 % des hommes), de même que les diplômés universitaires (63 % contre 36 % des personnes sans diplôme). On note, en outre, que les écarts de fréquentation liés au revenu sont nettement moins prononcés lorsqu’il s’agit des bibliothèques publiques (45 % à 53 %), contrairement à ce qu’on observe pour les librairies ou les musées. Cela met en évidence la fonction particulière des bibliothèques comme espaces culturels accessibles et inclusifs, capables d’atténuer certaines inégalités sociales dans l’accès à la culture : 

« On observe de grandes disparités entre les personnes détenant un diplôme de niveau universitaire et celles n’ayant aucun diplôme, notamment en ce qui concerne la fréquentation d’une librairie (77 % c. 40 %), d’un musée, d’un centre d’exposition ou d’une exposition (67 % c. 31 %) ou d’une bibliothèque publique (63 % c. 36 %). Les personnes vivant dans un ménage à revenu élevé sont, en proportion, plus susceptibles que celles vivant dans un ménage à faible revenu de visiter régulièrement une librairie (70 % c. 50 %) ou un musée, un centre d’exposition ou une exposition (63 % c. 39 %). Cependant, les écarts selon le niveau de revenu du ménage sont moindres quant à la fréquentation des bibliothèques publiques (proportions variant de 45 % à 53 %), ce qui illustre l’importance de ces établissements dans la réduction des inégalités en matière d’accès à la culture » (p. 81).

Les personnes immigrantes affichent des taux de fréquentation plus élevés (63 % contre 45 % des personnes natives), confirmant que les bibliothèques jouent un rôle interculturel significatif dans les parcours d’intégration. De même, les personnes en milieu urbain fréquentent davantage les bibliothèques (56 % à Montréal contre 40 % en région) (p. 82).

Revenons sur cette fréquentation régulière de la bibliothèque en considérant l’âge (voir capture d’écran du tableau 5.2). On constate que l’analyse des groupes d’âge met en évidence une courbe en U inversé : la fréquentation est particulièrement élevée chez les jeunes adultes (26 %) et les familles en âge scolaire (31,3 % chez les 30-44 ans), diminue à l’âge actif (19,3 % chez les 45-59 ans, 18,9 % chez les 60-74 ans), puis remonte chez les aînés (23,2 %). Cette variation illustre ce que Bourdieu associe à l’habitus ou à la structuration des pratiques par les rythmes sociaux  : les bibliothèques sont sollicitées différemment selon les étapes de la trajectoire de vie (études, parentalité, contraintes professionnelles, retraite).

Comparées aux librairies, qui demeurent les lieux consacrés au livre les plus fréquentés (29,2 % plusieurs fois par an), les bibliothèques se distinguent par une fonction égalisatrice. La librairie suppose un capital économique, alors que la bibliothèque repose sur la gratuité et l’accessibilité. La remontée de la fréquentation chez les aînés témoigne aussi de leur rôle de proximité et de socialisation, là où la consommation marchande du livre diminue vraisemblablement en importance.

L’EQLCD souligne aussi que le lien avec les bibliothèques s’enracine dès l’enfance : 78 % des adultes se rappellent y avoir participé entre 6 et 15 ans (p. 98). Cette expérience d’éveil culturel reste un point de passage majeur, mais elle n’assure pas à elle seule la fidélité à l’âge adulte : elle doit être relayée par le capital scolaire et social qui se transmet, s’incorpore et se consolide au fil de la vie et des trajectoires sociales.

Des défis 

Il semble donc que L’EQLCD met en lumière une transformation des pratiques culturelles au Québec, fortement influencée par le numérique et la diversification des modes de consommation. Pour les bibliothèques publiques, plusieurs défis se profilent. Sur le plan de l’accessibilité, elles demeurent des espaces stratégiques pour la  réduction des inégalités, mais elles doivent composer avec la fracture numérique, particulièrement marquée chez les personnes âgées, à faible revenu ou vivant hors des grands centres. Elles sont aussi confrontées à la concurrence des plateformes numériques, qui attirent par l’instantanéité et la personnalisation, les obligeant à repenser leur attractivité et à renforcer leur offre hybride assez fragile actuellement.

Par ailleurs, les bibliothèques jouent un rôle crucial dans la diversité culturelle et linguistique, en valorisant la production québécoise, francophone, autochtone et issue de l’immigration. Elles doivent aussi accompagner les cycles de vie, en consolidant la transmission culturelle dès l’enfance et en soutenant l’apprentissage et la lecture tout au long de la vie.

À la croisée des chemins, elles affrontent simultanément l’expansion du numérique, les attentes croissantes en matière de justice sociale et d’inclusion, ainsi que les défis environnementaux. Et, comme l’avait montré Bourdieu, l’institution culturelle, en l’occurrence ici la bibliothèque, demeure un espace à la fois d’inclusion et de distinction.

Une conclusion : Les bibliothèques, entre démocratie, distinction et care

Ces données, en effet,  suggèrent fortement que les bibliothèques sont à la fois inclusives et sélectives. Inclusives, parce qu’elles desservent presque toute la population et réduisent certains écarts liés au revenu. Sélectives, parce que leur fréquentation demeure fortement corrélée au capital scolaire et culturel. Bourdieu rappelle, dans La Distinction (1979), que les pratiques culturelles ne sont jamais neutres : elles traduisent et reproduisent la distribution inégale des capitaux. Ce qui est une autre manière de questionner la neutralité de la bibliothèque.

L’ancrage précoce à la bibliothèque pendant l’enfance illustre également ce que Bourdieu et Passeron analysent dans La Reproduction (1970) – et aussi, mais autrement, dans Les Héritiers (1967) : les dispositions acquises tôt ne portent leurs fruits qu’en interaction avec les ressources scolaires et sociales ultérieures. Celleux qui accumulent le capital culturel nécessaire poursuivent la fréquentation, tandis que d’autres s’en éloignent.

À l’ère du numérique, l’inégalité ne disparaît pas, elle se reconfigure. L’accès aux nouvelles formes de culture suppose la maîtrise de codes et de compétences techniques spécifiques, inégalement distribuées (Bourdieu, 1989). Ainsi, si les personnes diplômées et les jeunes adoptent massivement les services numériques, ces outils ne gomment pas les hiérarchies : ils en dessinent de nouvelles.

Les bibliothèques apparaissent dès lors comme des infrastructures critiques de savoirs, mais aussi comme des institutions paradoxales prises dans une tension entre ouverture et distinction. Elles peuvent certes être vues comme des lieux de démocratisation, voire de démocratie culturelle, mais aussi comme des espaces où se rejouent les luttes symboliques du champ culturel (Bourdieu, 1992). 

S’il faut parler d’avenir, à ce point, celui-ci dépendra de la capacité des bibliothèques à retrouver leurs publics, à redéfinir les formes de capital culturel qu’elles valorisent, à reconnaître la pluralité des savoirs et à se positionner comme actrices de justice sociale et environnementale dans un monde traversé par de multiples urgences – qu’il s’agisse de l’intelligence artificielle ou de la crise écologique. Redéfinir le capital culturel implique, par exemple, d’élargir la reconnaissance des pratiques légitimes en intégrant les littératies communautaires, numériques, médiatiques et informationnelles, mais aussi la culture populaire – mangas, balados ou jeux vidéo – au même titre que la littérature dite « classique » (Dufour et al., 2021). Cela suppose également de poursuivre le développement des espaces de création et de participation, tels que les fab labs ou les laboratoires citoyens, qui diversifient les pratiques reconnues et contribuent au soutien des cultures numériques. Reconnaître la pluralité des savoirs veut dire valoriser, dans la foulée des stratégies d’équité-diversité-inclusion-réconciliation en émergence (Martel et Dufour, 2024), les perspectives autochtones et interculturelles, comme celles des personnes issues de l’immigration dans les collections, mais aussi co-construire avec les communautés des ressources vivantes et accessibles, qu’il s’agisse d’archives communautaires ou de ressources éducatives libres, et ce, malgré un climat d’adversité. 

Mais cet avenir repose aussi sur la responsabilité et la responsabilisation des gouvernements locaux et nationaux, qui ne peuvent se contenter d’ajustements marginaux. Ils doivent envisager le financement des bibliothèques comme un investissement structurant, stable et conséquent – car une augmentation ponctuelle n’aboutit pas forcément à un budget suffisant et durable, même bien géré – et reconnaître politiquement leur rôle stratégique pour la société, l’éducation, la démocratie culturelle.

Enfin, le rôle des bibliothèques dans la justice sociale et environnementale s’exprime déjà, à certains égards, dans leurs fonctions d’accueil – refuges climatisés en période de canicule ou chauffés en hiver – et pourrait s’élargir à des initiatives de sobriété numérique ou à l’organisation d’ateliers citoyens sur les enjeux écologiques et technologiques. Dans cette perspective, leur mission s’enrichit d’une véritable dimension de care, telle que définie par Joan Tronto dans Un monde vulnérable (2010), fondée sur la responsabilité éthique, la réciprocité et l’attention aux interdépendances. Prendre soin des communautés, c’est non seulement répondre à leurs besoins culturels et sociaux immédiats, mais aussi reconnaître leur vulnérabilité, soutenir leur agentivité et favoriser une participation inclusive. En ce sens, les bibliothèques apparaissent comme des infrastructures critiques et résilientes, mais aussi comme des institutions attentives, capables de contribuer activement à la justice sociale et écologique.

Notes

[1] Bourdieu, P. (1979). Les trois états du capital culturel. Actes de la recherche en sciences sociales, 30(1), 3-6. https://doi.org/10.3406/arss.1979.2654

[2] Les données proviennent de l’Enquête annuelle sur les bibliothèques publiques (EABP) réalisée par le MCC et BAnQ.

[3] L’article présente une parité dans les citations puisque presque autant de personnes identifiées comme hommes et femmes sont mentionnées; ce qui rappelle l’importance de la représentativité dans la production et la reconnaissance du savoir.

Références [3]

Bourdieu, P., et Passeron, J.-C. (1967). Les héritiers: Les étudiants et la culture. Paris: Éditions de Minuit.

Bourdieu, P., et Passeron, J.-C. (1970). La reproduction: Éléments pour une théorie du système d’enseignement. Paris: Éditions de Minuit.

Bourdieu, P. (1979). Les trois états du capital culturel. Actes de la recherche en sciences sociales, 30(1), 3-6. https://doi.org/10.3406/arss.1979.2654

Bourdieu, P. (1979). La distinction: Critique sociale du jugement. Paris: Les Éditions de Minuit.

​​Bourdieu, P. (1989). La noblesse d’État: Grandes écoles et esprit de corps. Paris: Éditions de Minuit.

Bourdieu, P. (1992). Les règles de l’art: Genèse et structure du champ littéraire. Paris: Seuil.

Dufour, C., Martel, M. D., Lacelle, N., Kiamé, S., Garneau-Gaudreault, L.-A. & Poulin, T. (2021). Littératie communautaire : analyse de la production documentaire et revue de la littérature. Revue de recherches en littératie médiatique multimodale, 14. https://doi.org/10.7202/1086911ar

 Genêt, P. (2025). Les pratiques culturelles au Québec en 2024, [En ligne], Québec, Institut de la statistique du Québec, Observatoire de la culture et des communications du Québec, 126 p. https://statistique.quebec.ca/fr/fichier/pratiques-culturelles-2024.pdf

Jacobs, J. (1961). The Death and Life of Great American Cities. New York, NY: Random House.

Klinenberg, E. (2018). Palaces for the people: How social infrastructure can help fight inequality, polarization, and the decline of civic life. New York, NY: Crown.

Marceau, S. (2024, décembre). Les bibliothèques publiques québécoises en 2022 (Optique culture, no 99). Observatoire de la culture et des communications du Québec. Ministère de la Culture et des Communications du Québec et Bibliothèque et Archives nationales du Québec. https://statistique.quebec.ca/fr/fichier/bibliotheques-publiques-quebecoises-2022.pdf

Martel, M. D., et Dufour, C. (2024, 31 octobre). Enquête RÉDI : Rapport final. Résultats des analyses des réponses au questionnaire RÉDI. Rapport préparé en collaboration avec le Comité ÉDI de la Fédération des milieux documentaires (FMD) et l’École de bibliothéconomie et des sciences de l’information (EBSI), Université de Montréal.

Mattern, S. (2014). Library as infrastructure. Places Journal. https://doi.org/10.22269/141223

Putnam, R. D., & Feldstein, L. M. (2003). Better together: Restoring the American community. Simon & Schuster.

Tronto, J. (2010). Un monde vulnérable: Pour une politique du care (S. Laugier, Trad.). Paris: La Découverte. 

White, B. & Martel, M. D. (2021). An Intercultural Framework for Theory and Practice in Third Place Libraries, Public Library Quarterly, DOI: 10.1080/01616846.2021.1918968

  • ✇affordance.info
  • Google AI Overviews : Cronos dévorant ses enfants ?
    Déjà en place aux USA et dans plus de 120 pays depuis 2 ans, Google AI Overviews débarque en France cet été (c’est effectif depuis ce mercredi 22 juillet). Le principe est simple : pour chaque requête sur le moteur, c’est l’IA de Google (Gemini) qui propose des résumés ou plus exactement, et la précision me semble d’importance, des synthèses et – souvent – des préconisations. Cette arrivée durant l’été est annoncée comme un tremblement de terre, notamment par les éditeurs de presse qui, comme c’
     

Google AI Overviews : Cronos dévorant ses enfants ?

22 juillet 2026 à 06:18

Déjà en place aux USA et dans plus de 120 pays depuis 2 ans, Google AI Overviews débarque en France cet été (c’est effectif depuis ce mercredi 22 juillet). Le principe est simple : pour chaque requête sur le moteur, c’est l’IA de Google (Gemini) qui propose des résumés ou plus exactement, et la précision me semble d’importance, des synthèses et – souvent – des préconisations.

Cette arrivée durant l’été est annoncée comme un tremblement de terre, notamment par les éditeurs de presse qui, comme c’est le cas depuis plus de 20 ans avec le lancement de Google News en 2002, ne trouvent aucune issue au pacte attentionnel Faustien qui leur a été imposé : laissez-moi indexer et réutiliser vos contenus et en échange vous serez visibles, ou empêchez-moi de le faire et l’audience de vos sites sera quasi nulle.

L’article de Nicolas Lellouche sur Numérama résume très bien les principaux enjeux de cette arrivée et le changement de statut de celui qui était, jusqu’ici, un moteur de recherche.

Il y a, bien sûr, de quoi s’inquiéter circonstantiellement toujours davantage, mais structurellement, sur le fond, rien n’a vraiment changé depuis presqu’un quart de siècle. Google est un moteur de recherche devenu un moteur de réponses (« il n’y aura plus que des réponses » prophétisait Marguerite Duras) ; Google est un béhémot calculatoire qui a bâti son succès sur un régime de captation d’externalités (le web) qu’il a progressivement transformé en autant d’internalités. D’abord sur des sources ouvertes (le web donc, et notamment Wikipédia) puis sur des sources propriétaires ou mettant en jeu des principes de propriété intellectuelle (la presse notamment). Et toujours en pratiquant « l’Opt-Out » c’est à dire la captation / prédation par défaut, libre ensuite à chacun de faire part de sa volonté d’en sortir (il est d’ailleurs possible de sortir votre site de l’AI Overview). Et lorsque la masse de ces internalités fut suffisamment « à l’échelle », Google se trouva alors en situation de jouer à son avantage la rivalité qu’il avait lui-même créé (et arbitré) entre la qualité, l’importance et la nécessité de la production de contenus externes d’une part, et d’autre part celle de la production de réponses internes suffisamment courtes pour ne pas heurter de front la propriété intellectuelle (jouant entre l’usage « de minimis », le Fair-Use et l’exception pour courte citation) et suffisamment complètes pour satisfaire des requêtes informatives sans nécessité d’aller chercher des compléments d’information à l’extérieur du moteur ou alors en le faisant uniquement dans l’écosystème de sites tiers déjà dans le giron de la firme.

Avec AI Overviews, Google pousse donc un cran plus loin cette logique phagocyte. Et ce faisant il cesse peut-être irrévocablement d’être un « portail » (il n’en était déjà plus que l’ombre depuis longtemps mais maintenait nonobstant une fonction d’accès et d’orientation) pour devenir une simple « porte », que chaque requête sur le moteur referme derrière notre passage.

Permettez-moi alors de formuler une question volontairement provocante. Et si finalement Google était juste en train de devenir … un média ? Google dont longtemps le métier correspondant à son chiffre d’affaire fut celui d’être une régie publicitaire, et de n’être que cela (malgré ce que ses fondateurs affirmaient dans leur article séminal). Google deviendrait donc un média. Mais un média aux fonds baptismaux particuliers : entièrement construit sur la prédation d’externalités, sorte de Cronos dévorant ses enfants, il se mue aujourd’hui avec AI Overviews en média autophage qui tend à ne plus se nourrir que de lui-même. Ce « lui-même » étant permis par la volumétrie totalement inédite ainsi que par les effets de dissémination en même temps que d’opacification immanents des LLM (larges modèles de langage). La question est de savoir jusqu’où et jusqu’à quand ce principe autophage pourra être poursuivi, et la seule certitude est qu’il ne pourra pas l’être éternellement car si grande que soit l’étendue des éléments constituant aujourd’hui la ressource indexable et pouvant être générée du moteur, elle n’est pas infinie et nécessitera donc toujours et tout le temps l’appui de ressources externes (au Royaume-Uni après deux ans de déploiement le trafic vers les sites d’éditeurs à drastiquement chuté – entre 20 et 40% de baisse). Sauf … sauf à considérer pouvoir se satisfaire d’un pourrissement (ou d’une emmerdification) et à disposer des moyens pour faire croire qu’il n’est que périphérique et marginal.

Deux éléments pour conclure.

D’abord le mythe de Cronos dévorant ses enfants laisse place au scénario dans lequel ceux-ci se voient finalement régurgités et renversent leur père pour s’installer comme nouveaux dieux sur le mont Olympe.  C’est précisément pour s’en prémunir que très tôt Google a eu l’intelligence de développer son propre LLM et pouvant s’appuyer sur l’immensité des données et des textes qu’il avait déjà collectés, traités, indexés, et dont il avait, bien avant même l’invention du terme « LLM », déjà fait corpus (à ce titre le programme Google Books exploité à l’époque avec les technologies disponibles du TALN – traitement automatique du langage naturel – fut une pierre angulaire déterminante.

Ensuite j’évoquais plus haut l’article séminal de S. Brin et L. Page dans lequel après avoir décrit la formule et l’algorithme du Pagerank ils reviennent en annexe sur la toxicité du modèle publicitaire qui fait aujourd’hui leur fortune et constitue leur seul paradigme de déploiement. Notez que ce passage (ces « annexes ») a étrangement disparu de la version accessible depuis le site de la firme, mais qu’elle est heureusement toujours présente sur la page originale du laboratoire de l’université de Stanford. La seule leçon à retenir de cela est assez simple : ne faites jamais confiance à un prédateur.

Tableau de Rubens. Cronos dévorant ses enfants
(Source Wikipedia)

  • ✇affordance.info
  • Caméra(i) Café. Sucré à l’IA.
    Longtemps le numérique fut envisagé et traité comme ce qu’il était en première intention : un moyen de stockage. Et à ce titre la possible et pratique externalisation de nos mémoires, mémoires documentaires d’abord, mémoires intimes ensuite. Je suis récemment tombé sur un article expliquant comment le recours à l’IA allait permettre de redonner vie à la série Caméra Café, notamment en clonant – avec leur accord – les deux acteurs principaux et en les rajeunissant, mais aussi je cite : dans l’opt
     

Caméra(i) Café. Sucré à l’IA.

22 juillet 2025 à 12:30

Longtemps le numérique fut envisagé et traité comme ce qu’il était en première intention : un moyen de stockage. Et à ce titre la possible et pratique externalisation de nos mémoires, mémoires documentaires d’abord, mémoires intimes ensuite.

Je suis récemment tombé sur un article expliquant comment le recours à l’IA allait permettre de redonner vie à la série Caméra Café, notamment en clonant – avec leur accord – les deux acteurs principaux et en les rajeunissant, mais aussi je cite : dans l’optique de « moderniser la série » et de « faire revivre [le] catalogue [de la maison de production]. »

On s’était habitué aux suites menant à Rocky 5 ou à Rambo 4 ou plus récemment à Fast And Furious 10, on vit également l’émergence des séries, reboots, préquels et autres déclinaisons « d’univers » ou de tonneaux des Danaïdes scénaristiques baptisés « multivers », mais aujourd’hui avec l’IA ce à quoi nous assistons c’est à l’industrialisation de ces multivers comme autant de répliques d’univers à moindre coût. Et ce pour permettre de doper de vacuité d’anciennes têtes de gondole d’audience en leur donnant une nouvelle et artificielle jeunesse, mais aussi et surtout une nouvelle surface et amplitude de diffusion.

Têtes de clones.


L’article de Marina Alcaraz dans Les Échos explique ainsi que l’IA sera utilisée dans 4 objectifs distincts :

« D’abord, pour reprendre tout le catalogue français du programme tourné au début des années 2000 (environ 700 épisodes) et le passer au format actuel en 16/9 et 4K. L’IA sert à reconstituer les images manquantes et à moderniser le rendu.

Ensuite, les nouvelles technologies sont utilisées pour indexer les épisodes et analyser les textes. Exit les termes de l’époque, comme Walkman, les références à l’actualité ou à la politique du début du millénaire. « Quand les dialogues parlent de choses que les jeunes ne connaissent pas, l’IA va les remplacer par des mots ou des expressions plus d’actualité », explique Jean-Yves Robin, président de Robin & Co.

Enfin, l’IA va créer des deepfakes des comédiens, dont ceux Bruno Solo et Yvan Le Bolloc’h, pour les insérer dans les versions issues de l’international. On estime qu’il y a 5.000 à 6.000 épisodes produits dans le monde, dont environ la moitié d’originaux, reprend le producteur. On pense pouvoir au moins doubler le catalogue français. C’est une façon de faire revivre les catalogues sur des fictions comme celle-ci, où des comédiens sont trop âgés. »


Cet exemple est particulièrement intéressant car il mobilise en effet les quatre ressorts actuels des enjeux de l’IA dans le contexte des industries culturelles. Un enjeu d’abord technique d’optimisation et de « modernisation » (pour autant que l’idée de modernisme ait un sens lorsque l’on parle d’IA). Un enjeu ensuite « éthique » qui mobilise la question de l’intégrité documentaire des oeuvres (et d’une forme de « cancel culture », j’y reviendrai). Un enjeu juridique qui touche à la fois au droit d’auteur, au droit à l’image et à la propriété intellectuelle ; ici les comédiens ont accepté d’être clonés contre rémunération et il serait d’ailleurs intéressant de voir quel type de contrôle ils ont accepté de céder sur leur image, et jusqu’à quand. Et enfin un enjeu économique de saturation et de maximisation des logiques d’exploitation par procédé de duplication dans un univers médiatique déjà passablement saturé et qui vient encore alourdir le poids de ce que l’on appelait « les étagères infinies », c’est à dire l’immensité de catalogues de contenus dans lesquels on passe davantage de temps à choisir quoi regarder plutôt qu’à simplement … regarder.

Désormais, il semble qu’aucun contenu culturel ayant eu ne serait-ce qu’une once de succès d’audience ou critique ne puisse et ne doive mourir ou être oublié. Tout doit être fait pour le maintenir artificiellement en circulation médiatique. C’est une sorte de palimpseste à l’envers, dans lequel on partirait de la version la plus aboutie de l’oeuvre originale pour ensuite la recouvrir de couches affadies de ses propres extensions, dérivations, réécritures et copies.

[Mise à jour du 23 Juillet]

Autour de ce sujet on pourra également se référer au concept de « Foreverism » de Grafton Tanner, ainsi qu’aux pages de Deleuze sur la question de la répétition.

[/Mise à jour]

Dans un tout autre registre, je m’étais il y a quelques années intéressé au fait que les profils Facebook de personnes décédées continuaient d’être une manne d’interaction (et donc de revenus) pour la plateforme ; plateforme qui avait ainsi tout intérêt à nous inciter à transformer ces comptes en autant de « mémorial » et à nous rappeler de souhaiter les anniversaires de nos amis morts. Il s’agissait et il s’agit toujours de se payer, encore et encore, jusqu’au bout du cynisme.

C’est un peu le même type de processus auquel nous assistons aujourd’hui avec ces maisons de production qui veulent encore se payer sur des contenus culturels (ici des séries) pourtant déjà au bout de toutes les logiques de rentabilité existantes : en l’occurence, pour la série Caméra Café, elle a déjà été vendue et exploitée dans plus de 60 pays, et tous les produits dérives possibles et imaginables ont également été exploités et surexploités.

Intégrité documentaire.

C’est pour moi le grand sujet des années qui s’ouvrent devant nous. Car avec l’IA, et comme cela est relaté dans l’article de Marina Alcaraz pour Les Échos, vient aussi la tentation d’effacer toute forme de référence à l’actualité de l’époque de production du contenu concerné. On parle ainsi de gommer le « walkman » pour le remplacer par autre chose qui parle à la nouvelle « cible » envisagée. Toujours d’après le prodicteur de la série, grâce à l’IA, exit aussi les références à l’actualité politique de l’époque. Ce qui vient nourrir encore le débat sur une forme de Cancel Culture. Ou comment réécrire des contenus culturels qui ne peuvent être autre chose que le reflet d’une époque avec tout ce que cette époque comportait de tolérance qui nous semble aujourd’hui relever légitimement de formes d’abus condamnables.

De mon côté, plutôt que de m’enferrer dans le débat souvent glissant de la « cancel culture » je préfère parler et questionner le thème de l’intégrité documentaire.

Je vous en ai souvent parlé sur ce blog, mais la première fois que j’ai commencé à réfléchir à la notion « d’intégrité documentaire » c’était lorsque j’écrivais beaucoup sur « l’affaire » Google Books et la manière dont le moteur s’était soudainement mis à numériser à très large échelle des livres du domaine public mais aussi des ouvrages sous droits, et où avaient émergé, pour l’ensemble des contenus culturels, les offres de streaming allant avec une forme manifeste de dépossession des anciens supports physiques (CD, DVD, etc.) qui nous privaient ce faisant de certains de nos droits de propriété (j’avais même appelé cela « l’acopie« ). Bref c’était il y a plus de 20 ans. Pour expliquer cette notion d’intégrité documentaire auprès de mes étudiants j’utilisais et j’utilise encore souvent l’exemple des éditions des grands classiques en version « digest » disponibles aux USA du type « la bible en 20 pages » ou « les misérables en 50 pages. » Je leur explique que si l’on n’est confronté qu’à la version « courte » des misérables, version dont on a expurgé non seulement différents niveaux de l’intrigue mais dont on a aussi modifié, pour les atténuer, les aspects paraissant les plus « choquants », le référent culturel que l’on construit et les comportements et les repères sociaux communs qu’il permet d’inscrire dans un horizon culturel partagé changent alors de manière radicale. En modifiant et en édulcorant « Les misérables » comme oeuvre littéraire (ou fait culturel) on influe nécessairement sur la perception que nous aurons de « la misère » comme réalité sociale. De la même manière et en prolongement, le fait de choisir, sur telle ou telle édition ou réédition, numérique ou non, d’enlever, de gommer ou de réécrire certains aspects de l’oeuvre sont une atteinte claire à son intégrité documentaire et constitue donc aussi un trouble à la diachronie et à la synchronie dans lesquelles toute oeuvre s’inscrit.

C’est d’ailleurs ce que l’historienne Laure Murat rappelle encore dans son dernier essai (que je n’ai pas encore lu) « Toutes les époques sont dégueulasses » mais dont j’ai pu entendre une interview sur France Inter dans laquelle elle expliquait ceci :

Faut-il corriger les textes pour qu’ils soient lisibles à nos yeux contemporains ? Laure Murat : « Je crois que la question pose un gros problème. Parce que si vous nettoyez les textes des sujets qui fâchent, des mots qui fâchent, vous aboutissez à une falsification et un mensonge historique, qui a pour conséquence très grave de priver les opprimés de l’histoire de leur oppression. Donc, supprimez les remarques misogynes de James Bond et ses actions – parce qu’il faut aussi toucher à l’intrigue – ça devient quand même nettement plus compliqué. Faites-en un proto-féministe, il y a beaucoup de travail, et vous ne comprendrez plus rien à la misogynie des années 1950-60. Et je crois que ce n’est pas une bonne idée. »


Alors on pourra certes arguer que la suppression d’un Walkman dans Caméra café n’a pas la portée symbolique de la réécriture d’une oppression, mais quid des blagues machistes ou sexistes de la série qui, à l’époque déjà, jouaient d’une ambiguïté sur la « beaufitude » de celui qui les énonçait ?  Faut-il également les réécrire au risque, en effet, de ne plus rien comprendre au sexisme et à la misogynie du début des années 2000 ?

« Celui qui oublie ou qui méprise l’histoire est condamné à la revivre » écrivait le philosophe George Santayana. La seule promesse d’une Cancel Culture qui au prétexte de l’IA, finirait par faire système à l’échelle de nombre de biens et produits culturels, c’est le retour en plus violent de ce passé effacé.

  • ✇affordance.info
  • Poisson (mort) d’avril. Le réel selon la Tech.
    Il y a les images d’un monde version studio Ghibli. Et il y a Elon Musk avec un chapeau fromage. Le monde version studio Ghibli c’est une trace documentaire qui fait l’inverse de ce que documenter veut dire. Elle déréalise, elle euphémise, elle fictionnise. Elle enlève du relief aux êtres et aux choses. Elle les installe dans un univers d’à côté. Dans une tangence. Le monde version Elon Musk c’est à lui seul une exponentielle du grand n’importe quoi et l’asymptote d’un réel entièrement fiction
     

Poisson (mort) d’avril. Le réel selon la Tech.

1 avril 2025 à 12:06

Il y a les images d’un monde version studio Ghibli. Et il y a Elon Musk avec un chapeau fromage.

Le monde version studio Ghibli c’est une trace documentaire qui fait l’inverse de ce que documenter veut dire. Elle déréalise, elle euphémise, elle fictionnise. Elle enlève du relief aux êtres et aux choses. Elle les installe dans un univers d’à côté. Dans une tangence.

Le monde version Elon Musk c’est à lui seul une exponentielle du grand n’importe quoi et l’asymptote d’un réel entièrement fictionné pour servir ses seuls intérêts pour autant qu’il soit lui-même en capacité de les identifier comme tels. Salut Nazi hier, chapeau fromage aujourd’hui, et demain quoi d’autre ?

On a beaucoup parlé de l’ère des Fake News et de celle des faits alternatifs. En 2018 dans l’article « Fifty Shades of Fake » publié un 1er Avril, je vous parlais de la manière dont les architectures techniques toxiques des grandes plateformes numériques se mettaient au service presque « mécanique » de cette amplification du faux et de son écho dans nos sociétés. Je martelais que « la propagation de Fake News est davantage affaire de topologie que de sociologie » ; en d’autres termes que la capacité de circulation des contenus relevant des Fake News ou des faits alternatifs, leur capacité également de percoler dans tous les espaces sociaux conversationnels, massifs ou intersticiels, médiatiques ou dialogiques, cette capacité s’explique d’abord et avant tout par la topologie et l’organisation (le « dispositif ») des espaces numériques. Et que ce n’est qu’à la marge ou en tout cas dans un second temps que l’on peut caractériser de manière causale ces circulations en les rattachant à des catégories sociologiques liées à l’âge, au niveau d’éducation ou à tout autre variable.

Sept ans plus tard, ce 1er Avril 2025, ce qui se joue est de l’ordre de la tension désormais explosive entre un écosystème numérique bâti sur la question documentaire de la trace (traces de nos données, de nos comportements, de nos navigations, de nos opinions, etc.), et un saisissement technologique et politique qui ajoute un déterminisme de l’emballement à un extractivisme souche. Et ce que l’on nomme IA  – et qui est plus précisément un ensemble d’artefacts génératifs nourris d’une incommensurable quantité de données sans considération aucune pour leur origine, leur appartenance ou leur(s) propriété(s) – ce que l’on nomme IA n’est que le dernier (et peut-être ultime) avatar à la fois de cet extractivisme et de cet emballement. Avec un point nouveau qui est celui de l’alignement total de ces technologies avec les agendas politiques de régimes tous au mieux illibéraux.

« It is a tale
Told by an idiot, full of sound and fury,
Signifying nothing. »
(Macbeth. Shakespeare.)

Poisson (mort) d’Avril. Il y a de cela quelques années, la plupart des grands groupes technologiques de la trace (de Google à Facebook) se livraient à quelques « poissons » en ce jour particulier du 1er Avril. Aujourd’hui cette pratique s’est pour l’essentiel perdue et lorsqu’elle subsiste, elle ne suscite que peu ou pas d’écho médiatique tant le rapport que nous entretenons au quotidien avec la tromperie, la duperie, le décalage, de faux et l’irréel s’est totalement transformé. Ce qui était hier une stratégie éditoriale d’exception (dire le faux) est devenu aujourd’hui un régime éditorial courant, une routine.

Le monde façon studio Ghibli. Que chacun se soit emparé de la possibilité de faire « mème » dès lors que quelques-uns se sont saisis de la nouvelle opportunité offerte de créer des images, de soi ou du monde, à la manière du studio Ghibli dans ChatGPT, n’a rien d’inédit ou d’étonnant. Chaque époque numérique a pu documenter la manière dont ces productions documentaires particulièrement fécondes étaient massivement reprises lorsqu’elles présentaient la double capacité de se mettre en scène soi-même et/ou de s’attacher à des représentations culturelles déjà prégnantes. Ainsi certains et certaines se souviendront avec moi de ces générateurs permettant de « vieillir » une photo de nous, ou de chez nous, comme à l’argentique des premiers temps photographiques ; se souviendront aussi de la reprise du portrait « Hope » d’Obama par l’artiste Shepard Fairey et de la manière dont on vit presque partout se multiplier les copies de ce portrait avec nous à la place d’Obama. Et de tant d’autres choses encore.

Aujourd’hui des biotopes numériques tout entiers sont exclusivement bâtis sur leur capacité à faire « mème », à conditionner la production de contenus à leur alignement avec des ritournelles préenregistrées, des « trends ». « Trends » ou « tendances » : des formes de facilitations virales qui devraient nous interroger non pas par leur capacité à être suivies en tant que telles dès lors qu’elles ont été « amorcées », mais par l’assignation à l’identique qu’elles produisent et qui est une forme de prophylaxie paradoxalement mortifère de diversités, d’altérités et de dissemblances. En un mot : TikTok.

Que dire d’un monde dans lequel l’esthétisation de soi (et du monde) fait aussi fonction de bascule dans d’autres régimes de vérité ? Comment « être au monde » quand la plupart des « corporations du filtre » (pour reprendre une expression d’Umberto Eco désignant les journalistes, éditeurs, bibliothécaires, etc.) qui jusqu’ici faisaient fonction d’assignation, de rappel et de construction du réel sont en train de s’effondrer pendant qu’à l’autre bout de la chaîne documentaire de l’énonciation prospère une vision du réel qui n’est plus qu’essentiellement filtrée, et ce, des filtres de déguisement que chaque application ou biotope numérique propose ou superpose à chaque dialogue ou interaction jusqu’aux filtres de travestissement qui s’accolent aux paroles politiques publiques quand elles sont portées « sous couvert » de décalage, d’humour, de cynisme ou plus simplement de … programme.

Je fais ici une différence entre la question du filtre comme « déguisement » et dans lequel l’enjeu est précisément que le destinataire puisse repérer et identifier l’effet de décalage soit par l’exagération soit par le grotesque soit par l’irréalisme produit (par exemple les filtres « oreilles de chien » dans Snapchat), et la question des filtres comme « travestissements » dans lesquels l’enjeu est cette fois de produire un effet de réel authentifiable sinon authentique, travestissements qui « agissent » de manière performative autant chez l’émetteur (avec des troubles pouvant aller jusqu’à la dysmorphophobie) que chez le récepteur devenu incapable de discernement ou propulsé dans une vallée de l’étrange dont il ne sait à quelle part de son réel rattacher l’expérience ressentie.

Se confronter à l’information sur et dans les médias sociaux numériques (mais pas uniquement) c’est donc pour beaucoup se confronter à des surimpressions permanentes et rémanentes qui oscillent entre l’esthétique Ghibli, les chapeaux fromage d’Elon Musk, ou les pulsions d’un président élu pour envahir le Groenland. Non seulement plus grand-chose ne prête à sourire mais la tentation de faire des blagues se trouve totalement distancée par le réel lui-même. Par-delà la réalité sourde de l’état réel de notre monde, de ces effondrements climatiques et de ses guerres en cours en Ukraine, à Gaza, au Yémen et ailleurs, l’actualité géopolitique internationale est une oscillation permanente entre une version documentaire d’Idiocracy et des faits totalement en phase avec la ligne éditoriale du Gorafi.

Tout cela est irréel par intention ; tout cela contribue à déréaliser pour partie notre rapport au monde et aux autres ; tout cela nous installe dans une sorte d’a-réalité, une privation de réel, une douce torpeur ; tout cela produit des formes instrumentales et instrumentalisées de tech-réalité, c’est à dire d’une réalité qui ne serait sensible qu’au travers des politiques éditoriales ou des interfaces des grandes sociétés technologiques et de leurs filtres.

Le rêve avorté du Métavers imaginé par Zuckerberg n’est pas l’essentiel. L’essentiel est de rester en capacité de discernement sur des formes avérées d’univers sociaux et informationnels qui déjà peuplent, filtrent, habitent nos univers quotidiens et qui s’y superposent en évidence.

Le monde version studio Ghibli. Et le chapeau fromage d’Elon Musk. Irréel. Déréaliser. A-réalité. Tech-réel. Et la suite. Déjà là. Tescreal.

[Mise à jour du 6 Avril] I’ve got my Ghibli. And the World is filtered-reality.

❌