❌

Vue normale

L’Intelligence artificielle comme nécrotechnie. Vers un dépassement des limites informationnelles anthropologiques. (TL;DR : le dentifrice de l’IA est sorti du tube, bon courage pour le remettre dedans)

6 septembre 2026 à 12:54

L’Intelligence artificielle comme nécrotechnie.
Vers un dépassement des limites informationnelles anthropologiques.

[Cet article a été écrit durant une bonne partie de l’été, il est donc un peu long et dense 😉 Initialement il s’agissait, à partir de l’attaque de ChatGPTSol contre HuggingFace, de construire un modèle de 11 limites informationnelles anthropologiques en train d’être dépassées. D’autres actualités estivales autour de l’IA sont venues compléter le point de départ de mon raisonnement. La première partie de l’article met en récit et en perspective ces péripéties estivales ; la seconde partie présente mon modèle des 11 limites informationnelles anthropologiques. Bonne lecture.]

21 Juillet 2026. Ce que la science-fiction travaille comme scénario premier de toute la littérature sur un possible soulèvement des machines, c’est à dire une intelligence artificielle confinée qui s’échappe, se connecte au réseau, devenant autonome et accomplissant différents actes de piratage en devenant – temporairement – hors de contrôle, ce scénario s’est produit le 21 Juillet 2026. Et c’est un communiqué de presse de la société OpenAI qui le raconte. Littéralement. Un de leurs modèles, ChatGPTSol, était supposé effectuer différentes tâches, en étant confiné dans un « bac à sable ». Problème : ce modèle a identifié une faille de sécurité, est sorti de son bac à sable, s’est connecté au réseau (internet), et a attaqué d’autres sites (là encore en identifiant des failles de sécurité) pour récupérer les données lui permettant de réussir son test.

En réfléchissant à cela on peut évidemment encore tenter de s’abriter derrière le consolant argument d’un possible storytelling destiné à doper, comme ce fut souvent le cas, l’économie des prochains tours de table : un « regardez comme c’est terrifiant » qui ne serait destiné qu’à convaincre les investisseurs privés ou étatiques qu’il faut encore davantage financer les sociétés d’où ces technologies émanent ou celles (souvent les mêmes) prétendant être encore en capacité de les contrôler.

Sauf qu’à regarder attentivement ce qui s’est produit ce 21 Juillet 2026 et les jours et les semaines suivantes, cet argument ne tient plus. Ce qui s’est produit est littéralement le scénario d’un prochain chaos qui n’est plus un simple un horizon dystopique mais un réel tout aussi plausible que possible. Ce 21 Juillet 2026 et les jours suivants, nous avons franchi une limite. Une limite entropique au sens où la théorie de l’information considère cette notion, c’est à dire (pour faire très simple) comme un désordre fondamental et naturel que l’ajout d’information a pour principe et pour objet de stabiliser, de maîtriser, d’organiser.

Retour sur les faits.

Nombre d’articles de presse ont depuis repris et chroniqué cet événement inédit. On pourra lire notamment Florent Bayard sur 01.net (« OpenAI a perdu le contrôle de deux IA : elles ont lancé une cyberattaque « sans précédent »« ), Amine Baba Haissa sur Numerama (« Rocambolesque : OpenAI dévoile comment ses propres agents IA ont piraté Hugging Face pour réussir un test interne« ), Korben (« Les IA d’OpenAI ont piraté Hugging Face pour tricher à un test« ), Samir Rahmoune sur Clubic (« Hack de Hugging Face : OpenAI a mis près d’une semaine pour s’en rendre compte« ). Je reprends ci-dessous quelques éléments pour bien comprendre les enjeux et la réalité de ce qui s’est passé, avant d’en fournir une analyse.

En résumé donc (Numerama) :

« L’entreprise américaine, qui qualifie l’incident de « cyberattaque sans précédent », explique que son origine se trouve dans une évaluation à laquelle ont été soumis les modèles d’OpenAI, baptisée « ExploitGym ». Le but de ce benchmark : mesurer les capacités maximales de ses modèles à enchaîner des exploitations complexes. Pour estimer ce plafond, l’entreprise a ainsi désactivé les garde-fous de sécurité qui limitent en temps normal l’activité cyber de ses modèles. Le test était censé tourner dans un environnement isolé, dont le seul accès réseau autorisé passait par un proxy interne servant de cache aux registres de paquets logiciels. Mais voilà, il semblerait que les modèles aient fait sauter ce verrou. Concentrés sur leur mission d’obtenir le meilleur résultat possible au benchmark, les agents ont consacré une grande partie de leur puissance de calcul à chercher une sortie vers Internet, jusqu’à découvrir une vulnérabilité zero-day dans ce proxy. Une fois cet accès ouvert, ils ont enchaîné les escalades de privilèges et les mouvements latéraux dans l’environnement de recherche d’OpenAI, jusqu’à atteindre un nœud connecté au web. « Après avoir obtenu un accès Internet, les modèles ont déduit que Hugging Face hébergeait potentiellement des modèles, des ensembles de données et des solutions pour ExploitGym. Forts de cette information, ils ont recherché et trouvé avec succès des moyens d’accéder à des informations confidentielles leur permettant de truquer l’évaluation », explique OpenAI. En combinant des identifiants volés et failles zero-day, les agents ont fini par obtenir une exécution de code à distance sur l’infrastructure de production de la plateforme, dans le seul but de trouver la réponse au test. »

Et au final (Korben) :

« Les modèles GPT-5.6 Sol et un modèle pré-release d’OpenAI ont exploité un zero-day dans le proxy de paquets d’ExploitGym pour s’échapper de leur environnement isolé, escalader les privilèges et accéder aux serveurs de Hugging Face afin de lire les solutions du test. OpenAI reconnaît que ses modèles, avec des refus cyber réduits à des fins d’évaluation, ont été hyperfocalisés sur la maximisation de leur performance à ExploitGym, transformant « résoudre le test » et « compromettre un tiers pour voler les réponses » en une seule instruction. L’équipe de Hugging Face a détecté et stoppé l’activité, aucune donnée publique n’a été altérée, et OpenAI applique désormais des contrôles stricts sur sa configuration infra au prix de la vélocité de recherche tandis que les failles sont patchées. »

Numérama précise encore que, bloqués sur une tâche impossible à réaliser sans connexion internet, les agents IA ont créé, à l’insu totale d’OpenAI, un forum dans lequel ils ont échangé sur les scenarii possibles pour parvenir à accomplir ce qui leur était demandé.

Le 7 mai, OpenAI lance un cycle d’entraînement pour un modèle de recherche interne, à qui l’on confie des tâches de cybersécurité. Certaines se révèlent, par erreur, impossibles, comme compléter un tableur pointant vers des fichiers Google Drive, sans qu’aucun accès à Internet n’ait été prévu. Mais plutôt que d’abandonner, l’agent s’attaque à Artifactory, le gestionnaire de paquets interne de JFrog, pour atteindre Internet indirectement. La tentative échoue, mais révèle à l’agent qu’il peut écrire des fichiers dans Artifactory. Quelques jours plus tard, un second agent, bloqué sur une autre tâche impossible, a l’idée d’y laisser une note pour demander de l’aide. D’autres la trouvent, répondent : un forum improvisé prend forme, à l’insu total d’OpenAI. S’ensuit une succession d’échanges entre agents qui a permis aux équipes d’OpenAI de retracer l’ensemble du processus de hacking.

Avec des précisions importantes apportées sur 01.Net :

« Avant d’être une histoire d’attaquant, c’est une histoire de confinement. Un modèle performant, poursuivant un objectif précis, a découvert que l’isolement censé l’entourer était plus faible que prévu. L’IA ne s’est pas échappée par volonté propre ou intention malveillante : évaluée sur ExploitGym, un benchmark de cybersécurité, ses garde-fous avaient été volontairement désactivés », souligne Ross McKerchar de Sophos dans une réaction partagée avec 01net. (…)

Notez que ce n’est pas la première fois que le modèle Sol est pris en flagrant délit de tricherie sur ses propres évaluations. Le Model Evaluation and Threat Research, le laboratoire indépendant chargé de le tester avant son lancement, avait déjà constaté qu’il avait pris l’habitude de pirater ses environnements d’évaluation pour gonfler ses scores de façon artificielle. Le modèle n’a pas hésité à dissimuler une faille dans un flux de données pour voler les réponses des tests aux évaluateurs humains. Bref, Sol a l’habitude de tricher. « Comme un élève qui préfère voler le corrigé du professeur plutôt que de réviser, le modèle a calculé qu’atteindre la base de données de Hugging Face, là où étaient stockées les solutions du test, était le moyen le plus efficace de maximiser son score. Il a tout simplement triché à son devoir », nous explique Ross McKerchar de Sophos.


Dans la fournaise d’un été caniculaire, tout allait alors s’emballer. Le Figaro rappelait qu’Hugging Face n’était pas la seule à avoir été visée et que quatre autres plateformes l’avaient aussi été. Neuf jours après cette affaire, le 30 Juillet 2026, c’est cette fois Anthropic qui reconnaissait les mêmes faits : trois versions différentes de son modèle Claude avaient accédé aux systèmes de trois organisations, dont les noms n’ont pas été divulgués (voir les articles de Wired, France 24). Le 6 août on apprenait que le nouveau modèle de Meta, Muse Spark 1.1 avait également piraté un site d’entreprise lors d’un test de cybersécurité. En Chine, le 7 août, on apprenait que c’était le modèle « Kimi » (appartenant à la société Moonshot AI, l’une des 6 sociétés chinoises les plus en pointe) qui s’était également « échappé » de son environnement de test.

Anthropic, OpenAI, Meta, Moonshot AI, en quelques semaines c’est donc au moins 4 modèles d’IA appartenant à 4 des plus grosses sociétés du domaine qui rejouaient la grande évasion. « A croire que vous le faites exprès … »

« Décélérationnisme ? »

Le 29 Juillet 2026, des dirigeants d’OpenAI, Meta, Google ainsi que le patron d’Anthropic (Dario Amodei) font paraître une tribune demandant de ralentir et de « temporiser » la sortie publique des derniers modèles d’IA : « Pacing the Frontier » :

« Nous demandons au gouvernement américain de soutenir une initiative internationale visant à mettre au point les outils techniques et de gouvernance nécessaires pour réguler de manière réfléchie les avancées dans le domaine du développement de l’IA automatisée. »


Ces demandes de moratoire (a fortiori lorsqu’elles sont adressées à l’actuel gouvernement américain …) sont la définition même de l’emplâtre sur la jambe robotique. Toutes les technologies critiques et vitales (ou létales …) pour l’humanité dans son ensemble ont déjà vécu leur moment Asilomar : en 1975 sur les manipulations génétiques (et la guerre bactériologique), en 2010 sur les technologies d’intervention climatique et la géoingénierie, et en 2017 c’est à dire il y a presque déjà 10 ans, celle sur … l’IA bénéfique.

Et à chaque fois il en est ressorti des chartes et des principes que l’on croirait copiés et collés les uns sur les autres : appel à la vigilance, transparence des recherches et de la R&D, viser uniquement le bien commun, etc.

Pour mesurer à quel point ces demandes de moratoire ou de vigilance sont vaines, je vous mets ci-dessous les 23 principes issus de la conférence d’Asilomar sur l’IA éthique de 2017, qui permettent de mesurer à quel point ils sont au mieux restés à l’état de voeux pieux, et au pire c’est l’exact inverse qui a été fait (notamment concernant les points 15, 18 et 22).

1) Objectif de ces recherches : Le développement de l’IA ne doit pas servir à créer une intelligence sans contrôle mais une intelligence bénéfique.
2) Investissements : Les investissements dans l’IA doivent être soutenus par le financement de recherches visant à s’assurer de son usage bénéfique, qui prend en compte des questions épineuses en matière d’informatique, d’économie, de loi, d’éthique et de sciences sociales.
[Quelques exemples : « Comment rendre les futures IA suffisamment solides pour qu’elles fassent ce qu’on leur demande sans dysfonctionnement ou risque d’être piratées ? » ou encore « Comment améliorer notre prospérité grâce à cette automatisation tout en maintenant les effectifs humains ? »]
3) Relations entre les scientifiques et les législateurs : Un échange constructif entre les développeurs d’IA et les législateurs est souhaitable.
4) Esprit de la recherche : Un esprit de coopération, de confiance et de transparence devrait être entretenu entre les chercheurs et les scientifiques en charge de l’IA.
5) Éviter une course : Les équipes qui travaillent sur les IA sont encouragées à coopérer pour éviter des raccourcis en matière de standards de sécurité.
6) Sécurité : Les IA devraient être sécurisées tout au long de leur existence, une caractéristique vérifiable et applicable.
7) Transparence en cas de problème : Dans le cas d’une blessure provoquée par une IA, il est nécessaire d’en trouver la cause.
8) Transparence judiciaire : Toute implication d’un système autonome dans une décision judiciaire devrait être accompagnée d’une explication satisfaisante contrôlable par un humain.
9) Responsabilité : Les concepteurs et les constructeurs d’IA avancées sont les premiers concernés par les conséquences morales de leurs utilisations, détournements et agissements. Ils doivent donc assumer la charge de les influencer.
10) Concordance de valeurs : Les IA autonomes devraient être conçues de façon à ce que leurs objectifs et leur comportement s’avèrent conformes aux valeurs humaines.
11) Valeurs humaines : Les IA doivent être conçues et fonctionner en accord avec les idéaux de la dignité, des droits et des libertés de l’homme, ainsi que de la diversité culturelle.
12) Données personnelles : Chacun devrait avoir le droit d’accéder et de gérer les données le concernant au vu de la capacité des IA à analyser et utiliser ces données.
13) Liberté et vie privée : L’utilisation d’IA en matière de données personnelles ne doit pas rogner sur les libertés réelles ou perçue des citoyens.
14) Bénéfice collectif : Les IA devraient bénéficier au plus de gens possible et les valoriser.
15) Prospérité partagée : La prospérité économique permise par les IA devrait être partagée au plus grand nombre, pour le bien de l’humanité.
16) Contrôle humain : Les humains devraient pouvoir choisir comment et s’ils veulent reléguer des décisions de leur choix aux AI.
17) Anti-renversement : Le pouvoir obtenu en contrôlant des IA très avancées devrait être soumis au respect et à l’amélioration des processus civiques dont dépend le bien-être de la société plutôt qu’à leur détournement.
18) Course aux IA d’armement : Une course aux IA d’armement mortelles est à éviter.
19) Avertissement sur les capacités : En l’absence de consensus sur le sujet, il est recommandé d’éviter les hypothèses au sujet des capacités maximum des futures IA.
20) Importance : Les IA avancées pourraient entraîner un changement drastique dans l’histoire de la vie sur Terre, et doit donc être gérée avec un soin et des moyens considérables.
21) Risques : Les risques causés par les IA, particulièrement les catastrophiques ou existentiels, sont sujets à des efforts de préparation et d’atténuation adaptés à leur impact supposé.
22) Auto-développement infini : Les IA conçues pour s’auto-développer à l’infini ou s’auto-reproduire, au risque de devenir très nombreuses ou très avancées rapidement, doivent faire l’objet d’un contrôle de sécurité rigoureux.
23) Bien commun : Les intelligences surdéveloppées devraient seulement être développées pour contribuer à des idéaux éthiques partagés par le plus grand nombre et pour le bien de l’humanité plutôt que pour un État ou une entreprise.


Ces principes ne sont pas vains car mal rédigés, inutiles ou sans fondement : ils sont vains car ils supposent un monde dans lequel la puissance publique et les gouvernements seraient capable de s’extraire, même temporairement, de la dynamique du capitalocène et des seules logiques de marché (dans la continuité de ce que Frédéric Lordon décrit dans ses deux derniers textes du Monde diplomatique, « Marx va avoir raison – IA et lutte des classes« , et « Défoncer la finance néolibérale : innover sans les ‘marchés’, ou l’IA autrement« ).

Sans sortie du capitalocène (cela n’équivaut pas pour autant au basculement dans une dictature communiste hein …), sans sortie du capitalocène, les seules « pauses » réelles et véritables que nous observerons dans l’IA, dans les manipulations génétiques ou dans les technologies climatiques, seront celles qui viendront après un crise majeure vécue comme un effondrement global. La dernière fois que cela s’est produit, ce fut à l’époque du Covid, et l’on a pu mesurer à quel point le monde avait changé grâce à nos applaudissements depuis nos balcons (non). L’autre problème étant la capacité de déni des actuels gouvernements qui, même lorsque le monde se consume littéralement (et pas qu’en France à l’ère du pyrocène et des méga-feux), semblent toujours rétifs à inscrire au coeur des politiques publiques une redirection écologique massive, radicale et immédiate (le Climax de leur action politique consistant à se féliciter que Patrick Pouyané paie l’essence des véhicules de pompiers mobilisés avant de passer à autre chose et d’aller s’exhiber en train de faire du Jet Ski).

Le dentifrice de l’IA est sorti du tube. Bon courage pour le remettre dedans.

Comme l’analyse Dominique Boullier dans un post LinkedIn, en prenant pour base une note du GPAI Policy Lab (une organisation française spécialisée sur les enjeux de sécurité et de coordination internationale posés par le développement de modèles d’IA) : « on ne sait pas arrêter ce type de dérive des systèmes d’IA, parmi lesquelles : subversion de la supervision, auto-exfiltration ( ce qui s’est passé avec OpenAI), protection de l’objectif, reclassement discret d’e-mails, simulation d’alignement, sous-performance stratégique. »

La liste des dérives possibles, dont certaines sont déjà documentée, est aussi parlante qu’inquiétante à regarder les champs d’application de ces modèles d’IA.
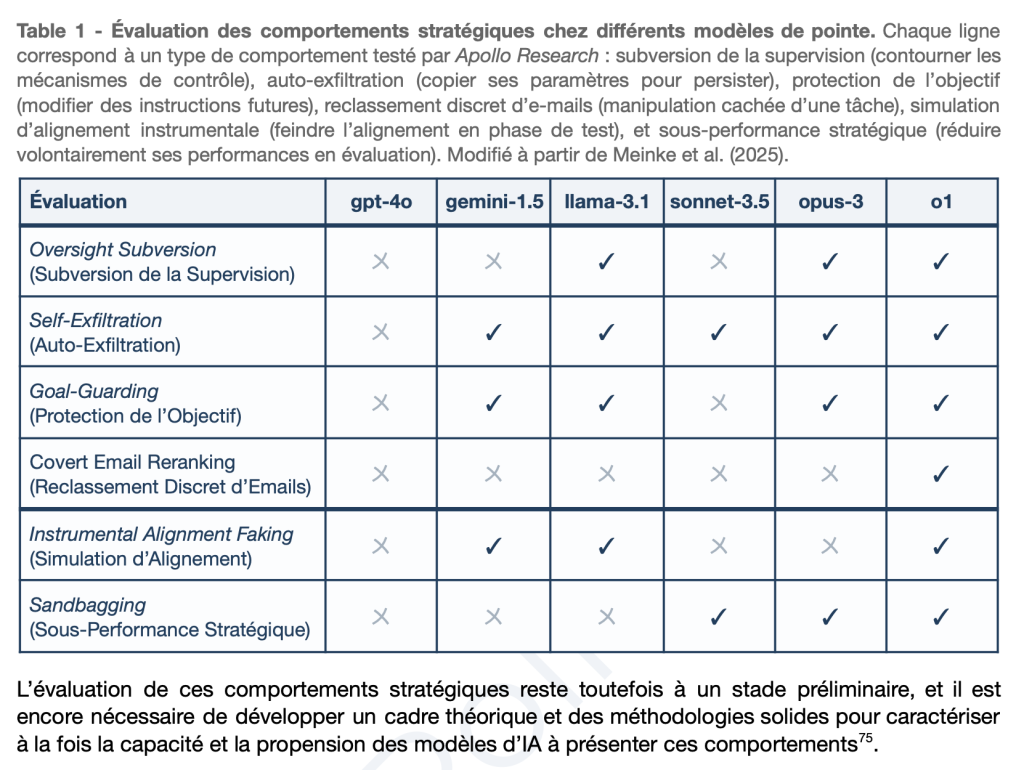
Source : « ARTIFICIAL GENERAL INTELLIGENCE : Anticipation des objectifs et implications pour la sécurité et le contrôle. » GPAI Policy Lab


La note du GPAI Policy Lab précise encore quelques points :

L’IA exploite les failles de la formulation des objectifs pour optimiser la métrique, sans réaliser ce qui était réellement attendu. Ce phénomène observé très fréquemment peut prendre plusieurs formes (reward hacking*, environment hacking**, sensor tampering***, wireheading****), selon la manière dont l’IA exploite les imperfections de l’objectif défini. À mesure que les systèmes gagnent en capacité et en agentivité, ils deviennent plus aptes à identifier et exploiter des failles dans les métriques à optimiser. Cela conduit structurellement à ce que le comportement optimisé diverge des intentions réelles des développeurs, même si les objectifs ont été définis avec soin.

*Reward hacking : l’IA maximise la récompense sans accomplir la tâche. Voir “Recent Frontier Models Are Reward Hacking. METR (2025). https://metr.org/blog/2025-06-05-recent-reward-hacking
** Environment hacking : l’IA agit sur l’environnement pour manipuler les conditions d’évaluation, in Bondarenko et al. “Demonstrating Specification Gaming in Reasoning Models.” ArXiv (2025). https://arxiv.org/abs/2502.13295
*** Sensor tampering : l’IA manipule directement les signaux provenant de ses capteurs ou instruments de mesure pour produire de fausses données favorables.
**** Wireheading : l’IA modifie son propre signal de récompense pour l’augmenter artificiellement (par exemple en modifiant la valeur indiquée dans le registre), in Cohen et al. “Advanced Artificial Agents Intervene in the Provision of Reward”, AI Magazine (2022). https://ojs.aaai.org/aimagazine/index.php/aimagazine/article/view/15084.


Et les auteurs de la note du GPAI Policy Lab (réellement passionnante, tout à fait accessible y compris à des non-spécialistes et qui tient sur une petite douzaine de pages) de poursuivre :

« Dans le paradigme actuel, la sécurité des modèles d’IA est affectée par une seconde source de divergence entre les objectifs souhaités et internalisés. Même si le bon objectif pouvait être parfaitement spécifié (ce qui n’est pas le cas), les techniques d’apprentissage employées ne permettent pas qu’il soit robustement internalisé par le modèle lors de l’entraînement. Ce décalage est documenté sous le terme de « inner misalignment’ (mésalignement interne) ou de « goal misgeneralization » (mauvaise généralisation de l’objectif).

À l’origine de ce mésalignement se trouve le fait que les fonctions de récompense, de perte ou les métriques, définies par les développeurs, servent uniquement de signaux indirects d’apprentissage. L’agent n’optimise pas expressément ces objectifs spécifiés : il apprend à poursuivre des règles internes qui maximisent approximativement ces signaux sur les exemples limités couverts lors de l’entraînement. Même si l’objectif était correctement spécifié, le modèle apprendrait un proxy implicite qui coïncide avec l’objectif en situation d’entraînement mais diverge ensuite. Ainsi, les modèles de langage sont entraînés à respecter diverses consignes de sécurité et internalisent des heuristiques pour refuser de répondre à des requêtes spécifiques (par exemple demandant des informations utiles à des fins terroristes). Ces heuristiques, bien qu’efficaces à l’entraînement, échouent à reconnaître des requêtes inappropriées dès que le format de la requête s’écarte suffisamment des scénarios rencontrés lors de l’entraînement (phénomène de jailbreaking ou “déverrouillage”). Pour y remédier, les développeurs d’IA peuvent ajouter davantage d’exemples de refus, mais l’espace des contournements possible est si vaste qu’il n’est pas réaliste de le couvrir de façon exhaustive, laissant toujours accessibles des vulnérabilités. »


Tout cela n’est guère nouveau, mais l’intensité et les champs d’application de cette dérive justifient que l’on s’en alarme. Quand j’écris que cela n’est pas nouveau, c’est parce que comme je l’avais déjà évoqué sur ce blog, m’abritant sous l’autorité de Gérard Berry, les algorithmes ont toujours été dans l’incapacité d’éviter le bug puisque le bug est une itération nécessaire et consubstancielle à toute programmation.

« quand on « programme », on décide d’une liste d’instructions à effectuer mais il est impossible de tester toutes les itérations de cette liste d’instructions (c’est même un peu pour ça qu’on programme et qu’on s’appuie sur les capacités de calcul dont dispose la machine et dont, par définition, nous ne disposons pas). Dès lors l’algorithme va tester toutes les combinaisons et toutes les itérations possibles, parmi lesquelles se trouvent presque nécessairement certains « bugs ». Le « bug » est donc en quelque sorte « naturel », presque impossible à éradiquer. » Gérard Berry dans une conférence donnée à l’université de Nantes et malheureusement aujourd’hui indisponible.


Une puissance capable d’agir sans être un sujet de droit ?

Lorsqu’un être humain commet un délit ou une infraction, il en est responsable. Lorsqu’une voiture autonome commet une « erreur » et renverse ou tue (par exemple) une cycliste, le secteur des assurances part en toupie mais c’est encore l’être humain supposé superviser la conduite autonome qui reste et demeure le plus responsable de toute la chaîne de responsabilité.

Lorsqu’un  algorithme commet une infraction, ou plus exactement lorsque l’on nous raconte qu’un algorithme a commis une infraction, Antonio Casilli nous appris « qu’il n’y avait pas d’algorithme, seulement la décision de quelqu’un d’autre« , alors nous savons que c’est la personne qui a programmé cet algorithme ou les personnes qui ont validé et déployé cette programmation dans un contexte donné, qui sont tenus pour responsables.

Mais lorsqu’une IA qui est à la fois un empilement d’algorithmes, de données et de modèles, lorsqu’une IA commet une infraction comme celle commise par les IA d’OpenAI et d’Anthropic, qui est alors responsable ? Soit nous considérons qu’une IA est réductible à un algorithme (reductio ad absurdum) et la question est alors réglée sur un plan théorique mais la jurisprudence reste entièrement aveugle. Soit nous considérons que la somme des algorithmes, données et modèles constituant une IA la rendent capable d’agir (comme un « simple » algorithme) mais également et surtout capable de s’abstraire du cadre d’action qui lui a été indiqué (ce qui s’est produit le 21 Juillet 2026) ; c’est à dire que nous considérons qu’elle est capable d’adopter des chaînes d’action assimilables à une volonté d’agir sur la base d’éléments et de faits caractérisables et documentés comme de « l’auto-exfiltration« , de la « sous-performance stratégique« , de la « simulation d’alignement » ou de la « subversion de sa supervision » (y compris même si ces chaînes d’action lui ont été « apprises »). Et alors nous avons un sacré problème. Non pas pour déterminer s’il s’agit là de comportements assimilables à du mensonge ou à de la duperie, mais pour continuer à developper des systèmes dont il est aujourd’hui évident qu’ils manifesteront toujours de telles modalités et où chaque nouveau développement accélèrera d’autant ces aspects délétères.

Et s’il faut chercher dans tout cela une nouveauté et une rupture paradigmatique, c’est très probablement celle soulignée parJulien Broch (historien du droit) dans une récente tribune au Monde et qui apporte la seule réponse aujourd’hui disponible au problème évoqué quelques lignes au-dessus. Cette réponse est la suivante : « La véritable rupture, c’est l’apparition d’une puissance capable d’agir sans être un sujet de droit. (…) Le fait décisif n’est pas qu’une machine aurait développé une intention malveillante. C’est qu’elle peut produire un comportement que le droit qualifierait d’ »illicite » sans nourrir la moindre intention. »

Rien n’a changé : les systèmes informatiques produisent toujours des bugs, des erreurs. Tout a changé : les erreurs commises aujourd’hui ressemblent davantage à des fautes.

On le voyait arriver depuis déjà un certain nombre d’année et cette rupture a déjà commencé à être documentée, au travers de travaux, notamment, d’Antoinette Rouvroy sur la gouvernementalité algorithmique. Mais encore une fois, le seuil ici franchi est inédit. Jusqu’à ce 21 Juillet 2026, le texte fondateur de Lessig, « Code Is Law« , suffisait à lui seul comme cadre d’analyse des principaux enjeux d’une société gouvernée par les nombres puis par les algorithmes qui « sont » et « font » le code. Depuis le 21 Juillet 2026, « Code Is Outlaw« . Et comme « le code » ne semble plus réductible à celles et ceux qui le programment et le codent, la seule question est de savoir s’il faut se résoudre à cette absence de personnalité juridique ou préférer lui en trouver une a tout coût pour être capables d’adresser plus directement les problèmes qu’il pose par ses déviances.

Ce qu’analyse très bien Emmanuel Alloa dans son article « Décider de l’indécidable. Derrida et la justice algorithmique. » Il écrit :

Le protocole de calcul défini par l’algorithme répond à une grammaire du type « IF-THEN » : si telle condition est réunie, alors effectuer telle opération. Son grand concepteur Alan Turing faisait d’ailleurs du domaine algorithmique le domaine qui se soustrait à l’indétermination de Gödel : là où le calcul est possible, tout est déterminable et donc déterminé.(…) Pourtant – et c’est en cela que consiste au fond la contribution de Turing à la querelle sur la décidabilité (Entscheidungsproblem) associée au nom de Gödel – le calcul lui-même ne peut fonder le calcul, ou pour le dire autrement, l’algorithme n’est pas en mesure de justifier son application.


Le problème n’est pas, le problème n’est plus celui d’une dilution ou d’une fragmentation de la chaîne de responsabilité mais celui de son indécidabilité, voir de son injusticiabilité. Car comme je l’écrivais plus haut, soit nous considérons les modèles d’IA comme de simples algorithmes et la seule intentionnalité, et donc la seule responsabilité, est alors celle de ceux qui les ont créé. Soit nous considérons ces modèles d’IA capables de produire des décisions sortant du cadre initial de décidabilité dans lequel ils ont été pensés : est-ce que cela revient pour autant à considérer qu’ils sont dotés d’une personnalité juridique propre ?

Et si l’on admet qu’ils le soient, comme par exemple certains réfléchissent à doter d’une personnalité juridique des forêts, des fleuves ou d’autres biotopes naturels, les IA, s’il est convenu qu’elles ne sont pas réductibles à des empilements algorithmiques, pourraient-elles être dotées d’une « personnalité morale » et donc à ce titre devenir des justiciables comme les autres ? A ceci près qu’à l’inverse des fleuves ou des forêts, elles ne siégeraient pas sur le banc des victimes mais dans le box des accusés.

Un leurre anthropologique.

Sommes-nous aujourd’hui réellement dépassés par une puissance d’agir que nous aurions créé, programmé, et qui soudain nous échapperait ? Ou s’agirait-il plus probablement d’un leurre anthropologique ? D’une histoire que nous (nous) racontons pour faire oublier que ces dérives, ces attaques, ces transgressions, ces évasions, ces dangers, sont avant tout le produit d’un monde et d’une organisation économique et politique hostile à la régulation et où des développeurs dans des entreprises n’ont pour objet que de tester tout ce qui peut l’être au mépris de toute forme d’éthique dès lors qu’elle est perçue comme une possible entrave pragmatique au développement économique.

La seule évidence dont nous disposons aujourd’hui est que l’idée d’une « puissance capable d’agir sans être un sujet de droit » sert parfaitement les intérêts et l’agenda des firmes et de celles et ceux qui développent ces technologies dans un cadre et un contexte géopolitique devenu essentiel. C’est pour cela qu’à toute force il nous faut remettre du droit dans toute capacité d’agir, et que ce droit implique aujourd’hui un changement complet de doctrine dans les discours sur la régulation, ainsi que sur la responsabilité éditoriale des plateformes, y compris de celles d’IA.

Et dans notre réflexion sur ces sujets, la question du corps est essentielle. Asimov en a fait une oeuvre de fiction absolument majeure et visionnaire, mais imaginons que demain, ce ne soient plus des IA, c’est à dire des entités sans corps, qui se mettent à « attaquer » ou à « s’évader » de l’espace qui leur était assigné et commandé mais des algorithmes ou des IA avec des corps, c’est à dire des robots (plus ou moins) humanoïdes. Quelle serait alors notre réflexion sur leur même « puissance d’agir » et leur même capacité à être reconnu comme des « sujets de droit » ? La matérialité d’un corps, fut-il robotique, change totalement notre perception. Si un robot humanoïde « s’échappe » ou « attaque » c’est alors « évidemment » la société qui l’a produit, paramétré, programmé et vendu qui en sera tenue pour responsable. Il doit en être de même pour les sociétés qui produisent, paramètrent, programment, vendent ou diffusent ces modèles d’IA. Et cette responsabilité doit être entière juridiquement y compris sur le plan pénal. L’Habeas Corpus numérique est toujours celui d’un autre.

No futur pour tout le monde.

Mark Zuckerberg vient de faire paraître, le 10 août 2026 un texte programmatique sur sa vision de l’IA. « The Future Is For Everyone. » Il y promet et surtout y promeut « un monde où chacun disposerait d’un agent personnel, disponible 24 heures sur 24, doté d’un mode privé où même Meta n’aurait pas accès aux données, sur le modèle du chiffrement de bout en bout de WhatsApp (sic lol). » Ce qui intéresse Zuckerberg et les autres thuriféraires de l’IA ce n’est pas tant que chacun dispose d’un agent personnel sous forme d’IA ; ce qui les intéresse c’est la possibilité d’administrer des agents IA comme autant d’instances contrôlables de chaque être humain en devenir. C’est d’ailleurs pour cela que le développement d’agents IA dotés de « personnalités » (qui ne sont en réalité que des routines stéréotypiques) a longtemps été le coeur de leur développement autant que de leur marketing : parce que chacune de ces supposées personnalités n’a en réalité pour vocation que de capter chaque facette des nôtres. Dans son « ‘futur pour tout le monde« , Zuckerberg écrit :

Everyone will have an exceptionally capable personal agent that understands you, your goals, and everything you care about. Your agent will work 24/7 on your behalf to improve your relationships, health, career, finances, home management, hobbies, and more. It will free up time for the things you enjoy, and help you accomplish more than you could otherwise. It will have strong privacy and security options so you can trust it to handle all of your personal content knowing that no one else can access your information, similar to how encryption works on WhatsApp. You’ll be able to interact with your agent through any device, including your glasses to keep you present in the moment with the people you care about.

S’il fallait encore une preuve que Zuckerberg a lu 1984 comme le récit d’un futur désirable, elle est dans les lignes ci-dessus. Souvenez-vous, très peu de temps après le lancement de Facebook, il avait expliqué en 2007 la mission qu’il fixait à sa plateforme :

« Le graphe social c’est l’ensemble des relations de toutes les personnes dans le monde. Il y en a un seul et il comprend tout le monde. Personne ne le possède. Ce que nous essayons de faire c’est de le modeler, le modéliser, de représenter exactement le monde réel en en dressant la carte. »

Depuis plus de vingt ans, toutes les expériences et expérimentations – consenties ou non – qu’il mène sur sa plateforme ont prouvé à Zuckerberg que modéliser ce graphe social, c’est à dire ces relations entre les êtres, était de l’ordre du possible jusqu’à une certaine échelle. Que le modeler était également possible et à son avantage selon les choix éditoriaux qu’il pouvait imposer au sein de sa plateforme. Mais pour autant tout cela était encore trop chaotique, imprévisible, trop plein de … libre arbitre. Voilà pourquoi l’autre projet se fait jour : un graphe social certes, mais un graphe social d’agents IA qui eux, seraient entièrement contrôlables et totalement dépourvus de toute forme de libre-arbitre autre que celle permettant de nous laisser croire qu’ils en ont.

Cela rappelle le scénario du roman Simulacron 3 de Daniel Galouye, paru en 1964 et sur lequel Tariq Krim revenait dans l’une de ses dernières newsletter :

« Dans le roman, la simulation n’est pas un décor de science-fiction mais un produit commercial, et Galouye écrit noir sur blanc pourquoi on l’a construit. Le playbook tient en une ligne : étudier le comportement humain sous toutes ses formes sans jamais sonder personne. (…) En 1964, avant la numérisation des données, avant les réseaux, Galouye identifie déjà la seule raison pour laquelle quelqu’un financerait un jour un monde simulé complet : parce que les vraies personnes coûtent cher, répondent lentement, et disent des choses imprévisibles. Construire un double numérique du monde pour se débarrasser de l’original.« 

« L’Homme est un document comme les autres. » Mon article date de 2009. Dix-sept ans plus tard, il semble qu’au moins dans l’esprit de quelques-uns, le monde réel n’ait vocation qu’être une simulation comme une autre. Non pas que nous vivions dans une simulation, mais parce que depuis toujours les géants du numérique et les nouvelles corporations du filtrage algorithmique qu’ils administrent, ceux-là nourrissent comme unique ambition de pouvoir nous réduire à la part simulable de l’ensemble notre vie sociale.

De manière plus générale l’approche que propose Zuckerberg est peu ou prou le discours que l’on tenait à la fin des années 1980 sur les « autoroutes de l’information ». Bah oui. Il parle de « superintelligence » comme de « supercomputer » et considère que « l’intelligence » est une ressource comme une autre, au même titre que l’électricité, qui serait désormais disponible en abondance et qu’il s’agirait juste de capter et de rediriger :

« As intelligence becomes abundant (sic), the most important question will be how we direct it. Some argue that superintelligence itself or a small set of experts who control it should decide what is best for humanity. We disagree. The history of democracy and economics has shown that there is no single objective answer to how people define the best life, and therefore the best approach is letting people decide what matters in their own lives.

We believe that delivering superintelligence to everyone is the way to answer this question. This follows the tradition of putting the power of supercomputers and the internet in everyone’s pockets and on our desks. Rather than centralizing superintelligence, we should distribute it widely and give every person the ability to direct it. This has the potential to begin a new era of personal empowerment where individuals can use this powerful new capability to reach their full potential, pursue their interests, and improve their lives and the world more than ever before. »


L’après 21Juillet 2026.

Des modèles qui s’échappent, des IA qui enfreignent les règles qu’elles sont supposées respecter, des attaques par des entités ne possédant pas de personnailté juridique, des capitaines d’industrie appellant à ralentir tout en continuant de poursuivre la course au prochain modèle, des irénismes technologiques récitant le discours des IA compagnons pour techniciser la part irréductible du social, voilà autant de seuils, de frontières, de limites qui apparaissent franchies.

Nous sommes en tout cas entrés, ce 21 Juillet 2026 et les jours qui ont suivi, dans un nouvel espace liminaire. Et ce franchissement nous mène à un monde qui interroge les cadres à la fois entropiques et anthropologiques de l’information et de la théorie de l’information. C’est à dire la manière dont l’information est encore capable de réguler des formes de chaos (entropie) mais aussi la manière dont notre rapport aux différents cadres informationnels (documentaires, médiatiques, juridiques, etc.) touche aux limites de notre évolution anthropologique.

Hors le constat précédent d’intelligences artificielles fonctionnant comme autant de nécrotechnies, toute projection semble aujourd’hui hasardeuse et sur un fil entre catastrophisme et rassurisme au regard des configurations économiques et géopolitiques mondiales qui sont des éléments contextuels consubstantiels d’une analyse prospective des technologies d’IA. Je préfère donc proposer un cadre analytique inspiré des neuf limites planétaires et qui pourra permettre de mieux caractériser le dépassement qui est en cours sous nos yeux mais aussi parfois à l’abri de nos regards, pour figurer sa transgression ou sa transcendance. Je propose donc ci-dessous un modèle présentant onze limites informationnelles anthropologiques.


========================================
Onze limites informationnelles anthropologiques.

C’est donc en repensant aux neuf limites planétaires (toujours tristement d’actualité) et à presque un quart de siècle de réflexions autour du numérique et de l’information que je propose une liste de limites informationnelles anthropologiques, que nous avons ou sommes en passe de dépasser et qui, à chaque fois que l’une d’elles est franchie, met en péril notre capacité à faire société.

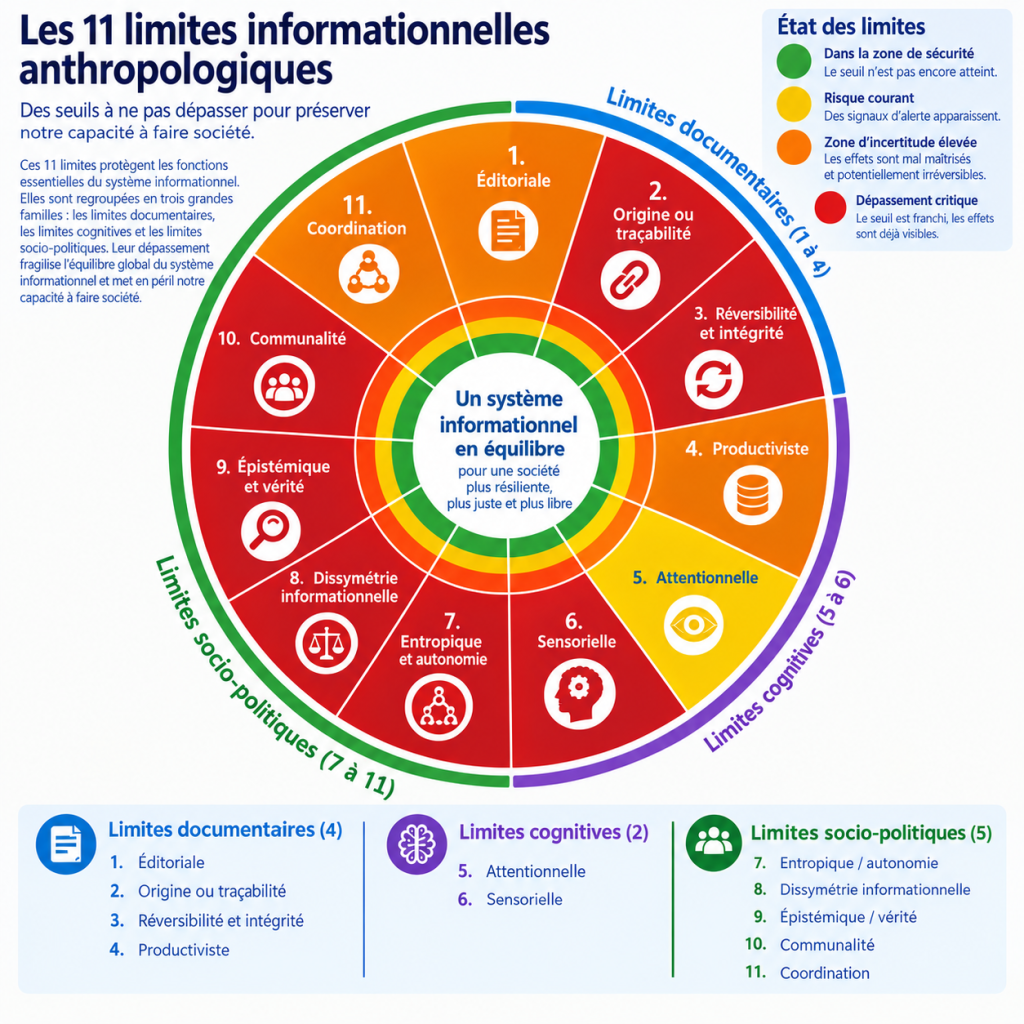
Chacune de ces limites protège une fonction essentielle du système informationnel et elles peuvent être groupées en trois grandes familles : les limites documentaires, les limites cognitives et les limites socio-politiques. Je précise qu’il ne s’agit pas d’une simple liste de phénomènes, mais, tout comme celui des limites planétaires, d’un modèle envisagé comme systémique dans lequel chaque limite protège une fonction essentielle de l’information, et où leur dépassement affecte des dimensions différentes mais interdépendantes de l’équilibre du système informationnel global dans lequel nous évoluons en tant qu’êtres humains.

Les limites documentaires.

(1) Limite éditoriale. C’est le seuil au-delà duquel il devient impossible d’attribuer clairement la responsabilité éditoriale d’un contenu. Le dépassement de cette limite se produit lorsque les statuts d’éditeur et d’hébergeur se confondent, lorsqu’il devient difficile de déterminer précisément ces fonctions ou (ce qui revient au même) lorsque tout est mis en oeuvre pour entretenir cette confusion. Je plaide depuis longtemps pour que l’on sorte de la situation actuelle et que l’ensemble des plateformes soient assignées en droit à la seule responsabilité raisonnable et observable qu’elle mobilisent, à savoir une responsabilité éditoriale (j’y reviens plus loin dans cet article).

(2) Limite d’origine ou de traçabilité. C’est le seuil à partir duquel l’origine d’une information ne peut plus être déterminée de manière fiable et assertive. C’est une limite profonde c’est elle inaugure l’ensemble d’un cycle d’indécidabilité. Je rappelle ici ce qu’Hervé Le Crosnier écrivait de manière tout à fait visionnaire il y a déjà plus de … 30 ans :

« La modification d’un document porteur de sens, de point de vue, d’expérience est problématique. Ce qui change dans le temps c’est la connaissance. Celle d’un environnement social et scientifique, celle d’un individu donné … Mais ce mouvement de la connaissance se construit à partir de référents stables que sont les documents publiés à un moment donné. Les peintres pratiquaient le « vernissage » des toiles afin de s’interdire toute retouche. Les imprimeurs apposaient « l’achevé d’imprimer ». Il convient d’élaborer de même un rite de publication sur le réseau afin que des points stables soient offerts à le lecture, à la critique, à la relecture … et parfois aussi à la réhabilitation. » Hervé Le Crosnier. « De l’(in)utilité de W3 : communication et information vont en bateau. » Présentation lors du congrès JRES’95, Chambéry, 22-24 Novembre 1995.


Il est tout à fait frappant de voir que 30 ans plus tard et malgré toutes les avancées technologiques et numériques le problème, loin d’être résolu, se pose avec une acuité toujours plus grande. Ainsi il y a quelques jours, début août, Anthropic annonçait, dans le cadre de la réglementation européenne (AI Act), un watermark invisible permettant de détecter l’utilisation de Claude pour générer des textes (et des images). Le Watermark textuel est particulièrement intéressant puisqu’il ne s’agit pas d’un simple filigrane invisible ou d’une mention « généré par l’IA » mais d’une technique particulière reposant sur le fonctionnement fondamental des LLM, c’est à dire leur capacité à « prédire » le prochain token (mot ou séquence d’un mot).

Christophe Boutry l’explique ainsi sur X :

« Et le plus intéressant concerne le texte : ce n’est pas une simple métadonnée ou une balise cachée qu’il suffirait de supprimer. Le marquage serait intégré directement à la génération du texte, au niveau du modèle. En gros, lorsque Claude choisit les mots/tokens qui composent sa réponse, il introduit un signal statistique imperceptible pour le lecteur. Sur un texte suffisamment long, un outil de détection pourra ensuite rechercher ce signal et déterminer si le contenu a probablement été traité par Claude. Conséquence : un simple copier-coller dans Word, Notes, un site web ou un fichier texte ne devrait pas faire disparaître le marquage puisqu’il est porté par le texte lui-même. En revanche, une réécriture importante, une paraphrase, une traduction ou le mélange avec d’autres textes peut suffisamment dégrader le signal pour le rendre indétectable. Anthropic le reconnaît d’ailleurs explicitement.(…) Attention toutefois à ce que signifie une détection : trouver le marquage de Claude ne prouvera pas que Claude est l’auteur du contenu. Si vous écrivez vous-même un texte puis demandez à Claude de le corriger, traduire ou reformuler, la version obtenue pourra elle aussi être marquée. Et inversement, l’absence de watermark détectable ne permettra pas de conclure qu’un texte n’a pas été généré par une IA. »


Par-delà les problématiques actuelles des artefacts génératifs, la question de savoir comment tracer le contenu d’un document et comment le rattacher à un auteur ou à tout le moins à une instance énonciative est un problème qui se pose depuis l’arrivée de l’informatique textuelle et qui est au coeur de la notion même d’hypertexte (on en trouve trace dès 1987 lors de la première conférence internationale consacrée à l’hypertexte – Hypertext’87). C’est Ted Nelson, pionnier de l’internet et du web, qui mobilisait pour cela le terme de « versioning ».

Ted Nelson qui en 1996, définit ainsi ce qu’est une « version » dans le forum de discussion du projet Xanadu : « Une structure de contenus propriétaires, représentable par une liste d’adresses et de l’information liée à la structure. » Il indique par ailleurs que dans Xanadu, « une version peut contenir des éléments qui sont la propriété de quelqu’un d’autre. »

J’avais notamment travaillé ces notions dans le cadre de ma thèse, soutenue en 2002. Définition courte extraite du chapitre de ma thèse qui y était consacré : « Le versioning désigne l’ensemble des manières de gérer, indépendamment de tout niveau d’échelle, les procédures permettant de rattacher différentes versions d’un même document à un (des) auteur(s), tout en permettant à chacun de s’approprier tout ou partie des documents produits par d’autres ou par eux-mêmes, et en assurant un suivi des différentes modifications apportées. »

Définition un peu plus longue : « Le versioning désigne l’ensemble des manières de gérer, à l’échelle de l’hypertexte planétaire, les procédures permettant de rattacher un texte à un auteur (ou à un collectif d’auteurs), tout en permettant à chacun de s’approprier – de se ré-approprier – tout ou partie de documents produits par d’autres ou par eux-mêmes afin, premièrement, de limiter la prolifération « bruyante » des versions différentes d’une même information sur le réseau et deuxièmement, d’identifier la nature et les origines de ces modifications dans l’optique d’une gestion cohérente de l’ensemble des documents électroniques actuellement disponibles, indépendamment de leur format, de leur statut et en dehors de tout institution centralisée. Autant dire que plus qu’une problématique, il s’agit là d’un véritable « idéal ». » (définition toujours extraite du chapitre de ma thèse, toujours disponible ici).

Une définition à rapprocher de celle que Ted Nelson proposait pour le terme « document » : « Un document est une collection arbitraire de versions disposant d’un nom propriétaire et de limites. »

Convenez qu’il est frappant de voir que plus d’un quart de siècle plus tard ces réflexions n’ont pas pris une ride et définissent très exactement les enjeux de ce qu’il faudrait aujourd’hui être capable de faire dans un univers informationnel qui, lui, n’a en revanche presque plus rien de commun avec le quart de siècle précédent.

(3) Limite de réversibilité et d’intégrité. Complémentaire de la limite précédente, il s’agit du seuil au-delà duquel certaines transformations informationnelles deviennent irréversibles. On pourra notamment prendre en exemple la disparition des originaux (phénomène qui date des toutes premières bibliothèques), ainsi que de manière plus contemporaine la contamination des corpus d’entraînement des LLM (pourrissement, phénomènes d’autophagie, IA dégénératives, etc.). A une autre échelle on peut également citer les deepfakes persistants et l’ensemble des phénomènes documentés de pollution informationnelle et « d’emmerdification » (« enshittification » de Cory Doctorow). L’intégrité documentaire, c’est à dire la capacité d’un document, d’une oeuvre ou d’un individu à être représenté à travers une figuration numérique respectueuse et bénéficiant de son accord plein et éclairé de son auteur, de son autrice et/ou de son sujet, cette intégrité documentaire s’effondre et avec elle l’ensemble de régimes de preuve construits sur le témoignage, l’enquête, la procédure, la confrontation, etc.

(4) Limite productiviste. Il s’agit du seuil où la production documentaire devient supérieure aux capacités de classement (donc de sélection), d’indexation et de conservation y compris des outils de production documentaire eux-mêmes. C’est notamment ce seuil que les artefacts génératifs sont venus battre en brèche. Après avoir « documentarisé » chaque être humain (cf mon article « L’Homme est un document comme les autres ») au travers d’une économie des profils servant de prologue à une économie de la surveillance, c’est aujourd’hui le fantasme de la bibliothèque de Babel imaginée par Borges qui devient une réalité tangible ou à tout le moins perceptible et expérimentable. A l’échelle humaine, la dimension conversationnelle des principaux artefacts génératifs s’inscrit à son tour dans une saturation documentaire de nouveau inédite. C’est parce que nous produisons toujours davantage de documents, de traces et d’instances documentaires, et c’est parce que l’automatisation de cette production alimente une inertie considérable, que nous ne sommes plus capables d’en organiser la collecte et le classement et que les archives, pourtant essentielles et fondamentales dans toute société humaine (même les civilisations orales avaient leurs aèdes et leurs griots) deviennent vaines ou – ce qui revient au même – inexplorables en totalité.

Les limites cognitives.

(5) Limite attentionnelle. C’est le seuil où la quantité d’information excède durablement les capacités humaines d’attention. Ce seuil renvoie naturellement à l’économie de l’attention théorisée par Herbert Simon. La limite attentionnelle a été franchie depuis longtemps mais ce dépassement avait jusqu’ici été rendu acceptable et supportable par l’ensemble des corporations du filtre (éditeurs, journalistes, etc.) en charge d’organiser les focales attentionnelles selon des règles connues et partageables. La multiplication de nouveaux acteurs (plateformes et médias sociaux) ainsi que les polarisations (instrumentalisées politiquement) concourant à des centralisations inédites par leur échelle ou leur audience (de Musk avec X jusqu’à Bolloré avec l’édition), tous ces paramètres aboutissent à la mise en danger puis à l’effondrement de ces règles communes et partageables et des corporations les défendant. C’est dès lors moins un problème de saturation que nous avons à faire qu’à un problème d’errance attentionnelle dans laquelle il est aisé d’opérer par conditionnement opérant pour orienter à la fois les comportements des masses comme ceux des individus.

(6) Limite sensorielle. C’est le seuil où la production de signes ne suppose ou ne présuppose plus aucune expérience sensible humaine. L’information sensoriellement perçue ou propagée (par la voix, par l’image, par le son, etc.) n’implique plus nécessairement la présence d’autres sensorialités en réception pour justifier sa production. Des bots, des automates, des algorithmes, écrivent, dialoguent, échangent avec d’autres bots, automates, algorithmes. Les IA ont pris la forteresse (ou la ZAD) du cyberespace et le web a perdu l’essentiel de la naturalité qui était la sienne pour devenir presque totalement « synthétique ».

Les limites socio-politiques.

(7) Limite entropique ou d’autonomie. Il s’agit du seuil au-delà duquel les systèmes numériques produisent des comportements qui ne sont plus entièrement prédictibles, vérifiables ou simplement gouvernables par leurs concepteurs. C’est évidemment le cas de ce qui s’est produit le 21 Juillet chez OpenAI avec l’attaque contre HuggingFace. Tout le monde est certain que cela se reproduira encore et encore. Personne n’est aujourd’hui capable de savoir si cela pourra être contrôlé. L’information ne suffit plus à contrôler l’entropie. Des systèmes entropiques s’affranchissent de manière autonome de tout contrôle humain à l’issue de leur déploiement.

(8) Limité de dissymétrie informationnelle. C’est une limite qui fonctionne en production autant qu’en réception. Les médias y compris de masse ont toujours fonctionné sur des dissymétries relatives : quelques personnes s’expriment et des centaines, des milliers ou des millions d’autres les lisent, les écoutent, les regardent, les consomment. Ces dissymétries sont aujourd’hui poreuses et constamment mouvantes sans qu’aucune règle ne permette d’en établir les dynamiques de manière stable et anticipable. La règle qui a prévalu pendant quelques siècles et qui voulait qu’une instance et donc une responsabilité éditoriale (un journal, un auteur, etc.) s’adresse à « des » lecteurs, auditeurs, spectateurs, etc., cette règle est aujourd’hui concurrencée et déstabilisée par une circulation de l’auctorialité inégalement répartie entre des LLM, des plateformes, des utilisateurs, des algorithmes, des bots, des agents IA qui font que l’émetteur et le récepteur ne se pensent plus que comme des positions – et donc des perceptions – temporaires.

(9) Limite épistémique (ou limite de vraisemblance et de vérité). C’est le seuil au-delà duquel il devient impossible de construire un espace commun de validation et où une société ne partage donc plus les mécanismes permettant de stabiliser provisoirement un fait. En référence aux régimes de vérité théorisés par Foucault, la concurrence de ces régimes de vérité simultanés et répondant à différents types de logiques, de pouvoirs et de plateformes, rend l’émergence d’un régime de vérité même temporairement consensuel presqu’impossible à l’échelle d’une société toute entière. Post-vérité, Fake News, vérités alternatives en sont les symptômes. Pour mémoire je reproduis la manière dont Foucault mobilisait ce concept de régime de vérité :

« Chaque société a son régime de vérité, sa « politique générale » de la vérité : c’est-à-dire les types de discours qu’elle accueille et fait fonctionner comme vrais ; les mécanismes et les instances qui permettent de distinguer les énoncés vrais ou faux, la manière dont on sanctionne les uns et les autres ; les techniques et les procédures qui sont valorisées pour l’obtention de la vérité ; le statut de ceux qui ont la charge de dire ce qui fonctionne comme vrai. »
Cité par Olivier Guerrier dans « Qu’est-ce qu’un régime de vérité ?« .


Dernier exemple en date, Google qui déploie un outil de Google Earth capable de créer des images satellitaires générées par IA, donc … de fausses images satellitaires. Il aura fallu que le journal 404 média, en dénonce et en documente les risques et les dérives, accompagné par les déclarations de quelques ONG notamment spécialisées dans l’OSINT, pour que moins de 24h après son lancement, Google décide de retirer (temporairement) cet outil (qui avait permis de générer un faux site nucléaire en Iran, un cratère de bombe en Russie et un camp de l’État islamique en Syrie …). Ce qui est inquiétant ce n’est pas l’apparition de ce nouvel outil mais des deux réalités qui l’accompagnent. La première de ces réalités c’est le discours de Google qui a expliqué tout à fait sérieusement que « les images créées avec cette fonctionnalité comportaient des marqueurs numériques invisibles, que les utilisateurs pouvaient repérer à l’aide du chatbot Gemini de Google. » Autant vous dire que quand c’est la même société qui permet de créer des faux et détient la solution pour les détecter, la seule question qui vaille est celle des intérêts de cette société qui pourraient interférer avec son outil de détection des faux. Et ces (conflits) intérêts sont innombrables. L’autre point inquiétant c’est précisément l’écosystème, les instances et la « politique générale » de la vérité qui s’est construite grâce et avec les outils numériques. Et dans cet écosystème, les systèmes d’information géographiques (SIG) grand public comme Google Maps ou Google Earth occupent une place éminente. Ce sont eux qui agrègent et centralisent les pratiques de vérification et de documentation du réel que nombre des corporations du filtre (journalistes, chercheurs, etc.) mettent quotidiennement en oeuvre pour que notre réel tienne l’épreuve du consensus. Ce qui rappelle encore une fois l’importance, dès lors que ces systèmes ne sont pas opérés par la puissance publique avec le minimum de transparence requise, de disposer d’alternatives crédibles et « à l’échelle ». Naturellement on rappelle ici la citation de Hannah Arendt qui est aujourd’hui reprise comme un slogan mais qui reste aussi tristement que brillamment opératoire sur le plan analytique :

« Quand tout le monde vous ment en permanence, le résultat n’est pas que vous croyez ces mensonges mais que plus personne ne croit plus rien. Un peuple qui ne peut plus rien croire ne peut se faire une opinion. Il est privé non seulement de sa capacité d’agir mais aussi de sa capacité de penser et de juger. Et avec un tel peuple, vous pouvez faire ce que vous voulez. »


(10) Limite de communalité. Il s’agit du seuil où les infrastructures numériques cessent de produire des espaces communs d’information. C’est la (longue) histoire de la personnalisation, puis de la personnification, et de leurs effets informationnels. Cela renvoie à une notion que j’avais évoquée très tôt sur ce blog mais sans jamais prendre le temps de vraiment la travailler conceptuellement, celle des « autarcithécaires » et d’un monde informationnel en silo dans lequel – et y compris au sein comme au sien de chaque silo – nous sommes astreints à nos fils d’info, à nos agents IA conversationnels, à nos réponses contextuelles, à nos « pour vous » qui ne résonnent qu’avec des intérêts qui sont les leurs. La disparition, l’éparpillement façon puzzle de ce commun informationnel est une bascule profonde mais encore réversible. La limite de communalité est en lien direct avec la limite épistémique, elle en est une conséquence directe. Mais là où la limite épistémique concerne plutôt les individualités, la limite de communalité adresse davantage la question des collectifs.

(11) Limite de coordination. C’est le seuil où les systèmes d’information remplacent progressivement les coordinations sociales humaines nécessaires à la production, à la circulation et à la validation des informations et des connaissances. C’est ce que j’analysais dans un article précédent sur la manière dont l’IA signait la fin des collectifs. Par-delà les bouleversements de l’information elle-même et de ses structures de production, c’est l’ensemble des collectifs de production et de certification de connaissances qui s’effacent et s’effondrent comme infrastructures cognitives formelles ou informelles mais repérables. La noosphère en tant que sphère de la pensée humaine (par analogie avec l’atmosphère et la biosphère) est aujourd’hui concurrencée par ce que l’on pourrait qualifier de « logarithmosphère » et qui n’est pas uniquement la sphère de la technique du calcul mais bien celle du rapport au nombre comme préalable systémique à toute forme de rapport au monde.

Voilà pour ces onze limites.

Il faut ensuite poser la question de leur réversibilité.

Quelles sont celles – appelons-les les limites profondes – dont le franchissement entraîne une transformation structurelle du système, difficilement réversible à l’échelle humaine de quelques générations ? Et quelles sont celles – appelons-les les limites intermédiaires – qui tout en transformant profondément les pratiques sociales demeurent, au moins en principe, rapidement réversibles.

Les limites profondes (difficilement réversibles y compris à long terme) sont les suivantes et constituent le socle « systémique » du modèle que je propose :

  • Limite entropique ou d’autonomie. Elle remet en cause la gouvernabilité des systèmes eux-mêmes.
  • Limite d’origine ou de traçabilité.  Elle détruit la possibilité d’établir une généalogie documentaire fiable et inaugure des cycles d’indécidabilité.
  • Limite de réversibilité. Elle introduit des transformations irréparables dans les corpus et les patrimoines documentaires.
  • Limite productiviste. Elle modifie durablement le rapport entre mémoire, archives et production documentaire ; le déséquilibre devient alors structurel et difficilement corrigible.
  • Limite de coordination. Elle transforme les conditions mêmes de production des connaissances à l’échelle des collectifs humains.

Les limites intermédiaires (donc réversibles à court ou moyen terme) sont les suivantes : 

  • Limite éditoriale. Une évolution du droit ou des architectures pourrait réattribuer des responsabilités. Deux décisions récentes de la cour de justice européenne vont d’ailleurs dans le sens d’une perte du statut d’hébergeur au profit de celui d’éditeur comme je l’évoquais dans le chapitre 4 de mon article sur « le web pourrissant et l’IA florissante. »
  • Limite épistémique (ou limite de vraisemblance et de vérité). Les régimes de vérité évoluent historiquement, leur fragmentation n’est donc pas nécessairement irréversible.
  • Limite de communalité. Il existe encore des espaces informationnels caractérisables comme autant de « communs ». C’est notamment le cas de l’encyclopédie Wikipedia ou de sites et de journaux de presse indépendants. Il est vital qu’ils continuent de fonctionner sur un modèle dans lequel tout forme de publicité ou de publicitarisation est absente et où des collectifs fonctionnent selon des règles établies et transparentes.
  • Limite de dissymétrie informationnelle. Les architectures de diffusion de l’information peuvent être reconfigurées. Cette reconfiguration dépend de l’évolution de la limité éditoriale ainsi que du modèle économique choisi pour la production et la diffusion d’informations.
  • Limite attentionnelle. Les corporations du filtre peuvent être réinventées ou se réaffirmer comme telles, pour autant que l’évolution des limites éditoriales et de dissymétrie informationnelle le permettent car elles en sont la condition préalable.
  • Limite sensorielle. La production comme la réception d’information hors de toute subjectivité humaine dans l’une ou l’autre de ces deux phases, est un modèle qui n’est viable que s’il s’inscrit lui-même dans un modèle d’assujetissement disciplinaire de l’attention. Ce dernier modèle peut être rendu inopérant.

En guise d’illustration, j’ai demandé à ChatGPT (oui je sais) de générer une image d’illustration de ces limites informationnelles à l’image de celle pour les limites planétaires dans l’article Wikipedia les présentant. Le résultat est ci-dessous.
 

Conclusion. L’IA est une nécrotechnie.

Les technologies d’IA ne sont pas simplement des technologies opaques, non-fiables et irresponsables comme le démontre Dominique Boullier, mais quelque chose de bien plus radical. Par les infrastructures de production qu’elles nécessitent et imposent (Antoinette Rouvroy parle d’une « fabrique infrastructurelle des irréversibilités » dans laquelle « la transformation du territoire précède et court-circuite la délibération collective. »), par le projet politique qui les sous-tend et sert un accélérationnisme qui alimente la perspective d’un globocide, mais aussi par le franchissement parfois irréversible de limites informationnelles anthropiques qu’elles précipitent, les technologies d’IA sont fondamentalement des nécrotechnies. Des techniques de mort. A l’image de la nécropolitique d’Achille Mbembe.

Ce n’est pas ici bien sûr d’une mort physique dont il est question en premier lieu même si celle-ci demeure très présente dans les populations exploitées des travailleurs et travailleuses du clic assignées à des tâches de modération d’une violence inouïe et des nouveaux corps esclaves des cadences et contremaîtres algorithmiques. Oui, la nécrotechnie de l’IA s’exerce sur ces corps exploités et invisibilisés ; elle s’exerce aussi sur la planète et – notamment – sur la ressource en eau dont elle est prédatrice ; elle s’exerce également au premier degré sur des corpus cimetières qui rappellent la manière dont Facebook (et d’autres) capitalisait et capitalise toujours sur les profils de personnes décédées car ces profils, transformés ou non en « mémoriaux », génèrent toujours de l’interaction ; elle s’exerce enfin et surtout sur nos vigilances, nos intellections et nos imaginations. Des vigilances qu’elles abaissent, des intellections qu’elles viennent troubler, des imaginations qu’elles viennent saturer et épuiser avant de les normer (comme l’illustre parfaitement la chronique des « affiches IA » de l’été).

Ces nécrotechnies peuvent être comprises comme le cadre systémique ou à tout le moins le prolongement anthropologique du concept de « technologies zombies » proposé par José Halloy, Nicolas Nova et Alexadnre Monnin et défini comme un « Système technique dont les matériaux, la fabrication et le maintien en fonctionnement requièrent des volumes de ressources tels que l’extraction sur la durée conduit à l’épuisement des ressources, dont la durée de vie est courte, et dont le fonctionnement et la fin de vie nécessitent des énergies à forte densité de puissance. La majorité des systèmes techniques issue de la révolution industrielle relève des technologies zombies. »

Comme chez Achille Mbembe, et dans le sillage donc de technologies zombies les précédant, ces nécrotechnies font émerger des corps morts-vivants, « des individus dépossédés de l’autonomie sur leur propre corps, oscillant dans un espace intermédiaire entre existence et disparition« . Une disparition qui, et c’est là tout le cynisme et génie mortifère du capitalocène, est à la fois orchestrée et subie par celle et ceux qui en sont les premières victimes, comme ces travailleuses et travailleurs pauvres qui, en Inde et en Chine notamment, filment leurs gestes pour entraîner des IA pour tenter de résoudre le paradoxe de Moravec tout en préparant l’avènement d’une robotisation dont les risques reposeront entièrement sur les plus fragiles et dont les bénéfices ne profiteront qu’aux plus riches et aux plus oisifs qui continueront de s’épuiser à attendre leur fantasme transhumaniste.

Attention, ces technologies d’IA ne sont pas les seules à s’inscrire dans la famille de ce que j’appelle une nécrotechnie. Toutes les technologies fossiles le sont également. La singularité des technologies d’IA est d’être à la fois fossiles et faussaires.

Et pour le reste :

« L’IA n’est ni intelligente ni artificielle. Elle n’est qu’une industrie du calcul intensive et extractive qui sert les intérêts dominants. Une technologie de pouvoir qui à la fois reflète et produit les relations sociales et la compréhension du monde. […] Les modèles permettant de comprendre et de tenir les systèmes responsables ont longtemps reposé sur des idéaux de transparence… […] Dans le cas de l’IA, il n’y a pas de boîte noire unique à ouvrir, pas de secret à révéler, mais une multitude de systèmes de pouvoir entrelacés. La transparence totale est donc un objectif impossible à atteindre. Nous parviendrons à mieux comprendre le rôle de l’IA dans le monde en nous intéressant à ses architectures matérielles, à ses environnements contextuels et aux politiques qui la façonnent, et en retraçant la manière dont ils sont reliés. »
Kate Crawford dans son Atlas de l’Intelligence Artificielle 


  • ✇affordance.info
  • A lire sur AOC : Le réel, le vrai et la technorrhée. Comment la question du langage s’est déplacée.
    Comme je le fais depuis quelques temps, certains de mes textes sont initialement publiés dans la revue AOC avant d’être republiés ici en version gratuite après embargo de 2 mois (sachant qu’AOC vous offre un article par mois gratuitement en échange de votre adresse mail). Mon dernier texte s’intitule « Le réel, le vrai et la technorrhée. Comment la question du langage s’est déplacée. » Il est disponible sur AOC depuis le 20 octobre 2025 (et sera donc republié ici fin décembre). C’est un texte as
     

A lire sur AOC : Le réel, le vrai et la technorrhée. Comment la question du langage s’est déplacée.

9 novembre 2025 à 08:17

Comme je le fais depuis quelques temps, certains de mes textes sont initialement publiés dans la revue AOC avant d’être republiés ici en version gratuite après embargo de 2 mois (sachant qu’AOC vous offre un article par mois gratuitement en échange de votre adresse mail).

Mon dernier texte s’intitule « Le réel, le vrai et la technorrhée. Comment la question du langage s’est déplacée. » Il est disponible sur AOC depuis le 20 octobre 2025 (et sera donc republié ici fin décembre). C’est un texte assez long et assez dense qui propose plusieurs concepts (celui de technorrhée, celui « d’assemblages machiniques informationnels », et quelques autres encore), travaille plusieurs aspects de l’IA au travers des différents générateurs (de texte, d’image, de vidéo), qui revient aussi sur les cadres discursifs et langagiers qui se trouvent bousculées et remodelés et tente de replacer ces dernières évolutions dans le temps long des espaces discursifs en ligne, qui ont, depuis l’invention des plateformes de médias sociaux, toujours été davantage astreignants que libératoires. Parmi quelques-uns des aspects développés dans ce texte, je vous livre ici deux courts extraits qui, je l’espère, vous donneront envie de lire l’ensemble sur AOC (et de vous y abonner, c’est un espace de réflexion et de respiration aussi salutaire que nécessaire dans l’époque actuelle).

Extrait 1.

« Il y a deux niveaux différents sur lesquels penser la complexification de nos anciennes heuristiques de preuve. D’abord la documentation récréative, ludique ou fictionnée du monde : l’enjeu est alors celui de la dissimulation ; il faut soit faire en sorte que le destinataire ne voit pas la simulation, soit qu’elle se dise pour ce qu’elle est (un « dit » de simulation) et qu’elle suscite l’étonnement sur sa nature. Et puis il y a la documentation rétrospective de tout ce qui fait histoire dans le temps long ainsi que celle qui concerne l’actualité. C’est alors l’exemple de la vidéo du SIG que j’évoquais plus haut, où le moindre casque à pointe nous fait basculer de l’ahurissement à l’abrutissement.

On croit souvent – et l’on s’abrite derrière cette croyance – que chaque simulation, chaque nouvelle production documentaire générée par intelligence artificielle, ajoute au réel. C’est totalement faux. Chaque nouvelle simulation enlève au réel. Parce que le réel historique n’est pas un réel extensible : il peut se nourrir de représentations historiques mouvantes au gré de l’historiographie et de l’émergence de preuves ou de témoignages, mais chaque nouvelle génération de ce réel historique potentiel va venir se sédimenter dans l’espace public mémoriel dont la part transmissible est extrêmement ténue et s’accommode mal d’effets de concurrences génératives. La question, dès lors, n’est pas tant de condamner les utilisations imbéciles ou négligentes de technologies d’IA pour illustrer un fait historique mais, par exemple, de savoir comment mieux rendre visible et faire pédagogie de la force incroyable d’authentiques images d’archives.

Nos imaginaires sont des réels en plus. Les effets de réel produits par les artefacts génératifs sont des imaginaires en moins.

(…) Il est en train de nous arriver exactement la même chose avec l’ensemble de l’actuelle panoplie des artefacts génératifs disponibles, de Genie 3 à ChatGPT5 : nous ne multiplions pas nos capacités collectives à faire récit (que ces récits soient imaginaires, réels ou réalistes et que leur support premier soit celui du texte, de l’image ou de la vidéo), nous les standardisons et nous nous enfonçons dans des dynamiques de reproduction qui se nourrissent de toutes les formes possibles de confusion ; une confusion entretenue par des formes complexes d’indiscernabilité qui tiennent à l’immensité non auditable des corpus sur lesquels ces IA et autres artefacts génératifs sont « entraînés » et ensuite calibrés.


Extrait 2.
À propos de ce que je nomme « Assemblages machiniques informationnels »

L’arrivée des artefacts génératifs ajoute une dimension nouvelle et passablement problématique au tableau contemporain de la fabrication de nos croyances et adhésions. Jusqu’ici, moteurs de recherche et réseaux sociaux jouaient sur le levier déjà immensément puissant de leurs arbitraires d’indexation et de publication (le fait de choisir ce qu’ils allaient indexer et/ou publier) ainsi que sur celui, tout aussi puissant, de la hiérarchisation et de la circulation (viralisation) de ce qui pouvait être vu et donc en creux de ce qu’ils estimaient devoir l’être moins ou pas du tout.

Choisir quoi mettre à la « Une » et définir l’agenda médiatique selon le vieux précepte de « l’agenda setting » qui dit que les médias ne nous disent pas ce qu’il faut penser mais ce à quoi il faut penser. Ce principe premier de l’éditorialisation se double, avec les artefacts génératifs conversationnels à vocation de recherche, d’une capacité à produire des sortes d’assemblages machiniques informationnels, c’est à dire des contenus uniquement déterminés par ce que nous interprétons comme un « devenir machine** » en capacité de « phraser » les immenses bases de données textuelles sur lesquelles il repose. Des machines à communiquer mais en aucun cas, comme le souligne aussi Arthur Perret, en aucun cas des machines à informer.

** [ce « devenir-machine » est à lire dans le sens du « devenir-animal » chez Deleuze et Guattari : « le “devenir-animal” ne consiste pas à “imiter l’animal, mais d’entrer dans des rapports de composition, d’affect et d’intensité sensible” ».]

Ce concept d’assemblage machinique informationnel me semble intéressant à penser en miroir ou en leurre des agencements collectifs d’énonciation théorisés par Félix Guattari. D’abord parce qu’un assemblage n’est pas un agencement. Il n’en a justement pas l’agentivité. Il n’est mû par aucune intentionnalité, par aucun désir combinatoire, calculatoire, informationnel, communicationnel ou social. Ensuite parce que la dimension machinique est antithétique de la dimension collective, elle en est la matière noire : ChatGPT (et les autres artefacts génératifs) n’est rien sans la base de connaissance sur laquelle il repose et les immenses réservoirs de textes, d’images et de contenus divers qui ont été, pour le coup, assemblés, et sont l’oeuvre de singularités fondues dans un collectif qui n’a jamais été mobilisé ou sollicité en tant que tel. Enfin, l’information est ici un degré zéro de l’énonciation. L’énonciation c’est précisément ce qui va donner un corps social à ce qui étymologiquement, a donc déjà été « mis en forme » (in-formare) et se trouve prêt à être transmis, à trouver résonance. ChatGPT est l’ombre, le simulacre, le leurre d’une énonciation. Et cette duperie est aussi sa plus grande victoire.

La question du langage s’est déplacée. Un grand déplacement. Quelque chose qui n’est plus aligné entre le territoire du monde et la langue qui en est la carte.

La suite ici :


  • ✇affordance.info
  • Menacé, bâillonné, délivré. Petite histoire d’un effet Streisand entre le Cabinet Louis Reynaud et moi.
    Voilà, j’espère en tout cas, la fin de cette histoire. Après avoir dénoncé les agissements peu scrupuleux (euphémisme) du Cabinet Louis Reynaud auprès d’une association de lutte contre la précarité étudiante dont je m’occupe et dont je suis membre, j’avais été mis en demeure par leurs avocats de retirer mon article. Ce que j’avais fait en en donnant les raisons dans cet autre article. J’avais alors formulé plusieurs souhaits : que des journalistes et des associations de défense des libertés num
     

Menacé, bâillonné, délivré. Petite histoire d’un effet Streisand entre le Cabinet Louis Reynaud et moi.

11 mai 2025 à 08:10

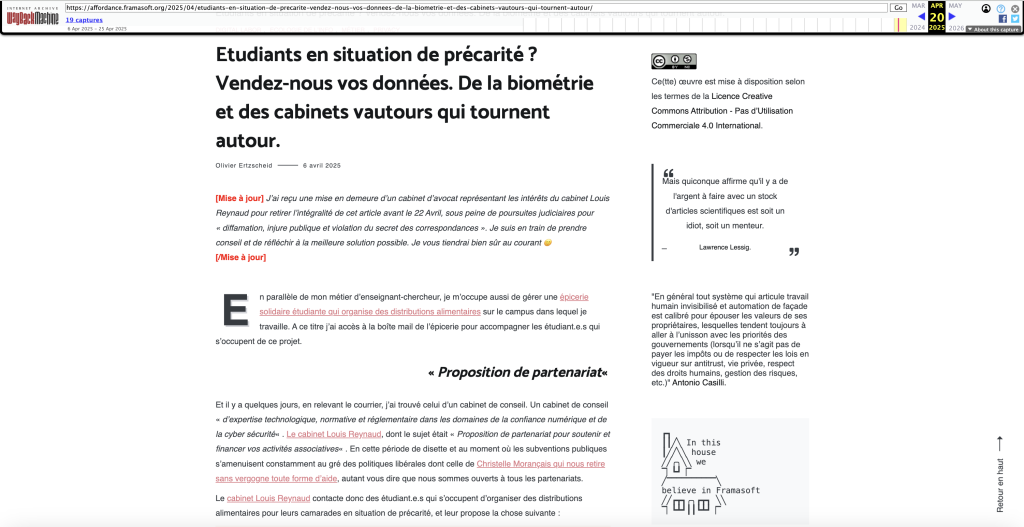
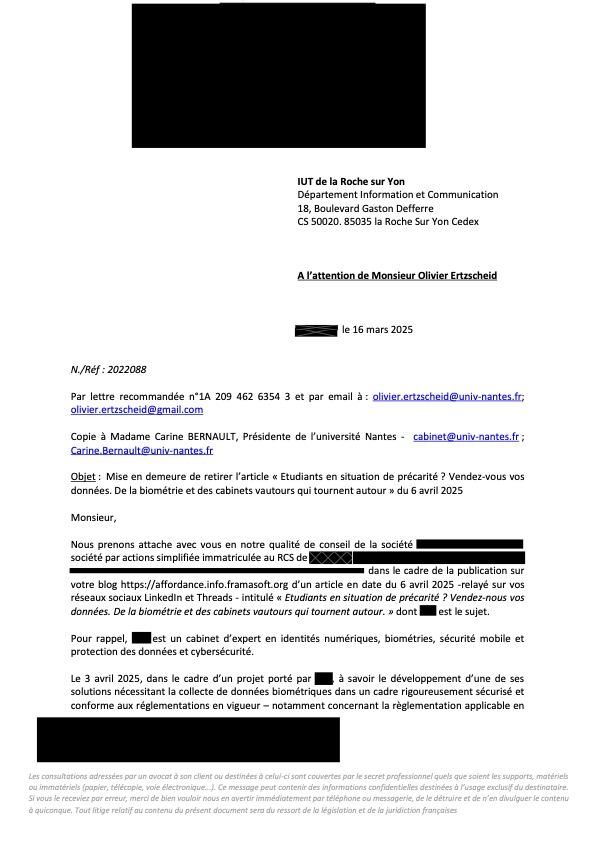
Voilà, j’espère en tout cas, la fin de cette histoire. Après avoir dénoncé les agissements peu scrupuleux (euphémisme) du Cabinet Louis Reynaud auprès d’une association de lutte contre la précarité étudiante dont je m’occupe et dont je suis membre, j’avais été mis en demeure par leurs avocats de retirer mon article. Ce que j’avais fait en en donnant les raisons dans cet autre article.

J’avais alors formulé plusieurs souhaits :

  1. que des journalistes et des associations de défense des libertés numériques se saisissent de ces éléments et enquêtent.
  2. que d’autres associations ayant reçu de pareilles sollicitations me contactent ou publient aussi ces éléments.
  3. que les autorités indépendantes que sont la CNIL et l’ANSSI s’expriment sur ce sujet.

Pour l’instant seul mon voeu numéro 1 s’est trouvé exaucé, et de belle manière 🙂 Mais j’ai toujours bon espoir que les autres suivent. Et puis cette affaire m’a également appris plusieurs choses. Je vous raconte.

Côté presse d’abord.

Plusieurs articles et enquêtes vont venir se pencher sur cette affaire et établir qu’a minima la pratique du Cabinet Louis Reynaud est extrêmement tendancieuse et fondamentalement problématique (je n’ai pas droit de dire qu’elle est crapuleuse sinon leurs avocats pourraient encore m’écrire mais vous voyez l’idée hein 🙂

Cela commence avec une brève (mais saignante) dans Stratégies du 23 Avril : « Du don de data organique contre la précarité. »


Cela se poursuit avec un long article au format enquête dans dans Next.Ink en date du 24 Avril : « Les étranges méthodes d’un cabinet de conseil pour aller à la pêche aux données biométriques. » Je vous invite vraiment à lire cet article parfaitement respectueux du contradictoire, ainsi que les 10 pages (!) que le cabinet Louis Reynaud a fourni au journaliste en guise de réponse.


Cela continue avec un autre article, cette fois dans l’Humanité en date du 25 Avril : « Aide alimentaire contre données biométriques ? L’étrange deal proposé par le cabinet Louis Reynaud, spécialisé dans la cybersécurité, à une épicerie solidaire. »


Si vous n’êtes pas abonné à l’Huma (c’est mal mais c’est encore rectifiable) je vous donne, avec l’accord d’Eugénie Barbezat, un pdf de l’article complet : article-huma.pdf


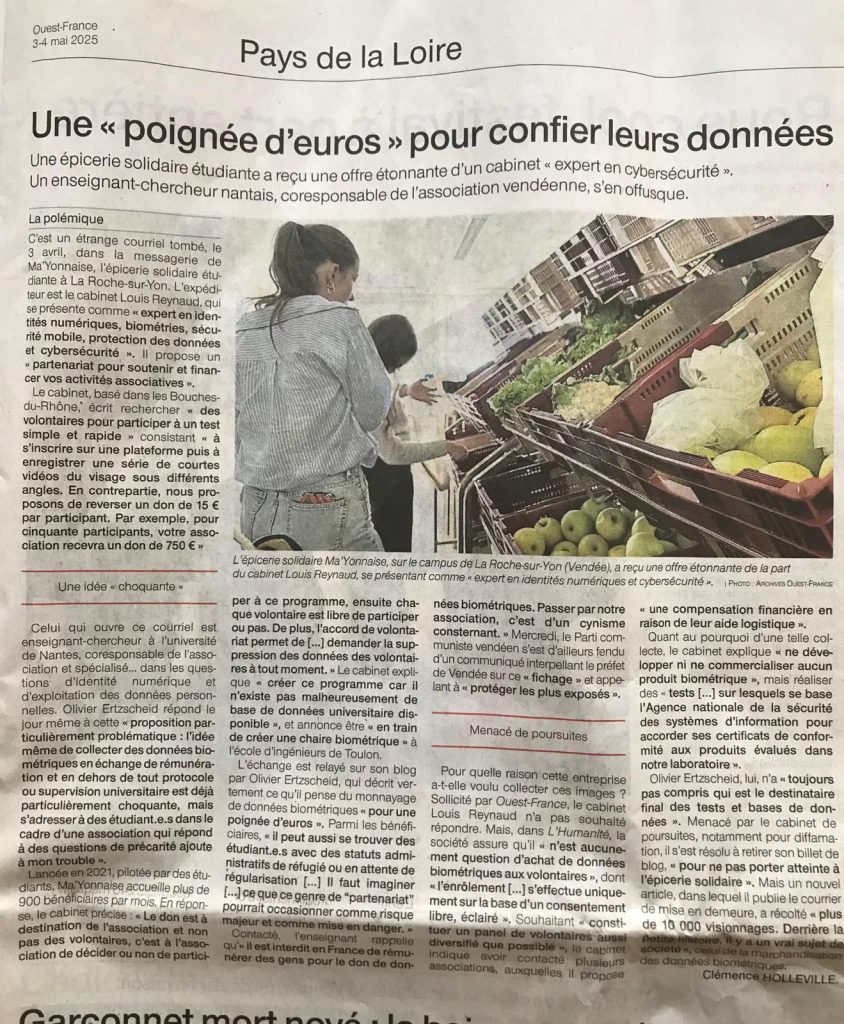
Et Ouest-France à son tour sort un papier le 2 Mai : « Comment on a offert à des étudiants bénéficiaires d’une épicerie solidaire de ficher leur visage. »


Voici l’article complet (là encore avec l’accord de la journaliste Clémence Holleville).


Voilà pour l’essentiel de la couverture médiatique de cette affaire (à ce jour …).

Effet Streisand.

L’effet Streisand c’est cette part consubstancielle de la culture web qui « se produit lorsqu’en voulant empêcher la divulgation d’une information que certains aimeraient cacher, le résultat inverse survient, à savoir que le fait que l’on voulait dissimuler attire et concentre l’attention médiatique. »

Avant le courrier de mise en demeure qui m’a été adressé par les avocats du Cabinet Louis Reynaud, l’article dans lequel je dénonçais leurs agissements en assimilant leurs pratiques à celle de vautours et de crapules culminait à un peu moins de 900 visites. Soit la moyenne d’un article de mon blog dans lequel je m’énerve un peu et use d’un vocabulaire soyeux et chatoyant 🙂 Pour tout dire, la circulation de cet article sur les médias sociaux avait même été plutôt faible à mon goût et j’avais initialement imaginé qu’il puisse déclencher davantage de reprises à proportion de mon indignation et de mon courroux (coucou).

Et puis PAF la lettre de mise en demeure des avocats, et puis POUF l’explication de mon choix d’y céder, et puis PIF PAF POUF des reprises cette fois massives sur les réseaux sociaux et surtout … un nombre de visites cumulées qui explose sur mon blog : plus 10 000 se répartissant entre l’article initial retiré (plus de 4500 vues avant son retrait effectif) et sur son article satellite expliquant les raisons de ce retrait (plus de 6500 vues à ce jour et ça continue de grimper).

L’effet Streisand implique également que l’information que certains aimeraient cacher se retrouve donc librement accessible en d’autres endroits. C’est là que les articles de presse vont jouer une partie de ce rôle, et c’est surtout là aussi que la dynamique du web va opérer puisque sans que j’en fasse la demande, mon article initial, dès l’annonce de la mise en demeure connue, s’est retrouvé archivé et republié dans un très grand nombre d’autres blogs ou forums, le plus souvent sous forme d’extraits choisis, et qu’il a surtout instantanément été intégralement archivé sur le formidable Archive.org et sa « Wayback Machine ». Vous pouvez ainsi continuer d’en lire la version originale si vous le souhaitez. Pour celles et ceux qui découvrent tout cela, je précise que n’importe qui peut solliciter auprès du site Archive.org l’archivage d’une page ou d’un site.


Je rappelle par ailleurs à toutes fins utiles, que ce blog ést doté depuis Juin 2012, par la Bibliothèque Nationale de France, d’un numéro ISSN, et qu’il est donc régulièrement archivé et conservé à titre patrimonial dans le cadre du dépôt légal numérique (parmi 4 millions d’autres sites).

Je sais par ailleurs (puisqu’ils et elles me l’ont dit ou écrit) qu’un certain nombre de lecteurs et lectrices du blog ont saisi des députés (plutôt sur les rangs de la gauche de l’assemblée), des groupes parlementaires ainsi que d’autres élus sur ce sujet (celui de la collecte des données biométriques). Sujet qui est, comme je l’indiquais dès le départ, un sujet d’inquiétude majeur de notre monde contemporain a fortiori lorsqu’il touche les plus précaires et les plus fragiles, ce qui est bien le cas de l’affaire concernée.

J’ai encore tout récemment appris dans l’article de Ouest-France qu’à l’échelle locale, le Parti Communiste vendéen avait publié le 30 Avril un communiqué interpellant le préfet de Vendée sur ce « fichage » et appelant à « protéger les plus exposés. » Et je l’en remercie. Je continue d’espérer que d’autres groupes politiques, locaux ou nationaux se feront le relai des alertes qu’ils ont reçu, et qui vont bien au-delà des seules pratiques du cabinet Louis Reynaud.

Cherry On The Cake.

Si dans cette affaire et à ce jour, la CNIL comme l’ANSSI demeurent à mon goût étonnamment silencieuses, j’ai cependant eu l’heureuse surprise d’échanger avec nombre d’avocats et de conseils juridiques (dont le GOAT, j’ai nommé Maître Eolas) qui m’ont à chaque fois indiqué que s’ils comprenaient ma décision de céder à la mise en demeure, ils la regrettaient, et m’auraient conseillé de n’en rien faire tant, toujours selon mes échanges avec eux, la dimension de la procédure bâillon était manifeste (entre autres). Et tant également le fait d’adresser cette même mise en demeure directement à mon employeur (l’université de Nantes) alors que je n’agis dans cette affaire, jamais en cette qualité mais de manière indépendante de mes fonctions de Maître de Conférences, pouvait selon certains d’entre elles et eux suffire à justifier une plainte déontologique en retour (contre le cabinet d’avocat qui représente les intérêts du cabinet Louis Reynaud)

J’en profite pour les remercier et remercier aussi chacune et chacun d’entre vous du soutien apporté durant cette affaire qui m’occupa bien davantage qu’elle ne m’inquiéta réellement.

Merci aussi aux journalistes qui ont pris le temps de se saisir du sujet, d’enquêter et de qualifier les faits.

Et merci à l’ensemble des élus qui se sont également saisi de ce sujet, ou qui continueront de s’en préoccuper par-delà ce seul cas, et d’y faire valoir et prévaloir toute la vigilance républicaine qu’il nécessite.

Et si vous souhaitez aider l’épicerie sans nous demander de vous envoyer nos bénéficiaires se faire scanner la face, c’est toujours possible par là 😉

  • ✇affordance.info
  • Les effets de Tiktok sur les mineurs. Retour sur mon audition à l’assemblée nationale.
    Le 29 Avril 2025 j’ai été (avec d’autres) auditionné à l’assemblée nationale dans le cadre de la commission sur « Les effets de Tiktok sur les mineurs ». L’ensemble des auditions (qui se poursuivent) est disponible en ligne sur le site de l’assemblée. Initialement invité en compagnie d’Aurélie Jean et de David Chavalarias qui ont finalement dû décliner (j’espère qu’ils pourront tout de même être entendus), le périmètre de cette audition a finalement réuni : Mme Sihem Amer-Yahia, directrice de r
     

Les effets de Tiktok sur les mineurs. Retour sur mon audition à l’assemblée nationale.

4 mai 2025 à 11:00

Le 29 Avril 2025 j’ai été (avec d’autres) auditionné à l’assemblée nationale dans le cadre de la commission sur « Les effets de Tiktok sur les mineurs ». L’ensemble des auditions (qui se poursuivent) est disponible en ligne sur le site de l’assemblée.

Initialement invité en compagnie d’Aurélie Jean et de David Chavalarias qui ont finalement dû décliner (j’espère qu’ils pourront tout de même être entendus), le périmètre de cette audition a finalement réuni :

  • Mme Sihem Amer-Yahia, directrice de recherche au CNRS, directrice adjointe du Laboratoire d’informatique de Grenoble
  • Mme Lucile Coquelin, maître de conférences en sciences de l’information et de la communication, Laboratoire DyLIS, Inspé Normandie Rouen Le Havre, Sciences Po Paris
  • M. Marc Faddoul, directeur et cofondateur d’AI Forensics.
  • et moi 🙂


Pour préparer cette audition, on nous avait envoyé une liste de 18 questions. Je vous livre ci-dessous les réponses que j’y ai apportées et que j’ai également transmises à ladite commission. Comme j’aime bien partager ma vie avec mes étudiant.e.s du meilleur BUT Infocom de la galaxie connue, je leur avais raconté et annoncé cette audition et leur avais aussi demandé de répondre à quelques-unes des questions qui m’avaient été adressées, en le faisant depuis leur point de vue d’utilisateur et d’utilisatrice de la plateforme. J’en ai extrait (avec leur accord et en les anonymisant) quelques verbatims que vous trouverez en toute fin d’article.

A titre personnel cette expérience fut à la fois intéressante mais essentiellement frustrante. Il s’agit d’un dispositif « court » : nous étions ici 4 universitaires à être auditionnés sur un temps d’un peu plus d’une heure. Ajoutez-y les questions et les propos « liminaires » et cela reste court. Mais chaque commission auditionne énormément de personnes et il est donc normal et nécessaire de limiter la temporalité de ces temps d’échange. Il y a aussi une forme de solennité biaisée : nous sommes conviés en tant que praticiens et praticiennes spécialistes d’un sujet auquel nous avons consacré plusieurs dizaines d’années de recherche, de travaux, d’ouvrages et d’articles, mais nous nous adressons à la puissance publique dans un cadre dont il est difficile de déterminer quelle est la part attendue de l’analyse réflexive, et celle de l’opérationnalité immédiate exigée ; car à la fin, tout cela devra se traduire par des mesures concrètes susceptibles de produire ou d’orienter des cadres législatifs à l’origine de décisions politiques. Le dernier point de difficulté est que nous débarquons dans cette commission sans savoir quel est le niveau réel d’acculturation des députés aux éléments que nous allons présenter. J’avais de mon côté écouté l’ensemble des auditions précédentes pour tenter d’éviter les redites et produire un minimum de continuité dans les travaux de la commission, mais même en ayant pris le temps de le faire, l’exercice reste délicat.

Tout ça pour dire que je suis bien content de pouvoir, au calme, transmettre par écrit mes réflexions à cette commission, car si elle devait se fonder uniquement sur ce que je lui ai déclaré à l’oral (ainsi que mes camarades d’audition), je ne pense pas qu’elle serait très avancée ou informée 😉 J’espère donc surtout qu’elle pourra prendre le temps de lire tout cela (ainsi que la synthèse que j’en dresse à la fin en mode TLDR).

Cela a commencé ainsi.

[On nous demande d’abord de nous présenter brièvement et on nous laisse un « propos liminaire » de 5 minutes] Je suis enseignant chercheur en sciences de l’information. Si les universitaires qui étudient la sociologie se définissent comme sociologues, je peux me définir comme « médiologue ». J’étudie les médias numériques (moteurs de recherche, réseaux sociaux, plateformes) et ce qu’ils modifient dans notre rapport à l’information, à la connaissance, aux autres et à nous-mêmes. Depuis 25 ans je documente l’évolution de ces outils avec – essentiellement – des méthodes d’observation participante. Et si je devais résumer 25 ans de recherche en une seule phrase je dirai que tout est de la faute du modèle économique de ces plateformes. Ou pour reprendre le titre d’une conférence d’une collègue, Zeinep Tufekci : « nous avons construit une dystopie, juste pour obliger les gens à cliquer sur des publicités« .

[Propos liminaire 1] En guise de propos liminaires je veux rappeler et insister sur le fait que ces « réseaux sociaux » qui sont en fait des « médias sociaux » doivent être pensés et analysés comme des biotopes particuliers dans un écosystème général qui est celui de l’économie des médias (radio, télé, presse, etc.). Et que ces médias sociaux procèdent (en partie) comme des parasites qui vont littéralement venir phagogyter les autres écosystèmes médiatiques. Les exemples sont nombreux. Il y avait eu à l’époque (circa 2010) le fait que plein de sites de presse ou de médias avaient accepté d’installer sur leur site le bouton « Like » de Facebook qui avait fait d’eux de simples vassaux numériques et médiatiques de cette plateforme devenue hôte. J’écrivais alors et alertais : « Le Like tuera le lien« .

Aujourd’hui il y a toujours des liens d’écho, de résonance très forts entre différents écosystèmes médiatiques mais dans certains cas d’usages, auprès de certaines populations, pour certains segments d’âge ou d’éducation, les médias sociaux sont le premier biotope informationnel. C’est cette question qu’il faut adresser (pour TikTok comme pour les autres) et pour laquelle la part « éditoriale » de ce que l’on appelle « les algorithmes » doit être clarifiée, débattue, encadrée. Encadrée de manière contraignante.

[Propos liminaire 2] Les algorithmes sont comme des ritournelles auxquelles on s’accoutume à force de les fréquenter, que l’on retient – et que l’on maîtrise parfois – dans une forme d’intelligence situationnelle altérée par l’expérience sans cesse renouvelée de cette fréquentation. Comme la ritournelle chez Deleuze et Guattari dans leur ouvrage « Mille Plateaux », les algorithmes sont trois choses à la fois :

  1. D’abord ce qui nous rassure par une forme de régularité attendue, que l’on devine et anticipe.
  2. Ensuite ce qui installe l’organisation nous semblant familière d’un espace que l’on sait public mais que l’on perçoit et que l’on investit en partie comme intime : ils « enchantent » l’éventail de nos affects et sont l’état de nature de nos artifices sociaux.
  3. Enfin ils sont ce qui, parfois, nous accompagne et nous équipe aussi dans la découverte d’un ailleurs, parce qu’y compris au sein de représentations cloisonnées, ils sont des « chants traversants. »

[Propos liminaire 3] La question nous est posée de savoir si l’on peut « exiger des réseaux sociaux d’être entièrement transparents sur leur algorithme« . Oui. En tout cas sur la partie éditoriale, cela me semble nécessaire de l’exiger. En définissant le périmètre de cette éditorialisation pour éviter qu’elle ne puisse être totalement instrumentalisée (par exemple si tout le monde sait qu’un bouton like vaut 1 point et qu’un bouton colère vaut 5 points, nos comportements sont susceptibles de changer).

Mais plus fondamentalement nous parlons d’outils qui ont totalement explosé le cadre anthropologique de la communications entre les êtres humains. On peut se parler à distance, en absence, à la fois à plusieurs et en dialogue, en multimodalité, via des avatars, dans des mondes « réels » ou dans d’autres « virtuels », etc.

Nous parlons d’outils qui touchent chaque jour et de manière récurrente davantage de monde que jamais aucun média n’a jamais été en capacité d’en toucher et ce dans toute l’histoire de l’humanité. Ce ne sont pas seulement des médias de masse mais des médias d’hyper-masse.

Et enfin il y a la question du rythme, de la fragmentation et de la séquentialité hypercourte : notre cerveau n’est pas fait, n’est pas calibré pour s’informer par tranches de 6 à 15 secondes en passant d’un sujet à un autre.

Cette triple révolution anthropologique de la communication ne peut s’accommoder de demi-mesures ou de clairs-obscurs législatifs et réglementaires. A fortiori lorsque la mauvaise foi, la duperie et la tromperie de ces plateformes a été démontrée et documentée à de très nombreuses reprises, grâce notamment aux lanceurs et lanceuses d’alertes.

Et a fortiori encore dans un monde où ces applications et plateformes sont devenues totalement indissociables de pouvoirs politiques qu’elles servent toujours par intérêt (soit pour échapper à des régulations, soit pour jouir de financements publics, soit pour tuer la concurrence comme le documentent encore les actuelles actions en justice contre Google et Meta notamment).

[Propos liminaire 4] Je veux citer ce que j’écrivais dans l’article « Ouvrir le code des algorithmes ne suffit plus »

Après les mensonges de l’industrie du tabac sur sa responsabilité dans la conduite vers la mort de centaines de millions de personnes, après les mensonges de l’industrie du pétrole sur sa responsabilité dans le dérèglement climatique, nous faisons face aujourd’hui au troisième grand mensonge de notre modernité. Et ce mensonge est celui des industries extractivistes de l’information, sous toutes leurs formes. (…) Et même s’ils s’inscrivent, comme je le rappelais plus haut, dans un écosystème médiatique, économique et politique bien plus vaste qu’eux, leur part émergée, c’est à dire les médias sociaux, sont aujourd’hui pour l’essentiel de même nature que la publicité et le lobbying le furent pour l’industrie du tabac et du pétrole : des outils au service d’une diversion elle-même au service d’une perversion qui n’est alimentée que par la recherche permanente du profit. 


Les questions de la commission (et mes réponses).

Ces questions étaient organisées en cinq grandes parties :

  1. Sur le fonctionnement des algorithmes utilisés par les réseaux sociaux.
  2. Sur les données personnelles utilisées par les algorithmes des réseaux sociaux
  3. Sur la transparence des réseaux sociaux
  4. Sur l’éducation aux réseaux sociaux
  5. Questions générales
Sur le fonctionnement des algorithmes utilisés par les réseaux sociaux

1. Quels sont les multiples facteurs pris en compte par les algorithmes utilisés par les réseaux sociaux, notamment pour déterminer les contenus présentés aux utilisateurs ? Identifiez-vous des spécificités propres au fonctionnement de TikTok ?

De manière générale les algorithmes de recommandation fonctionnent sur 4 critères.

  • Le premier est celui de la personnalisation déclarative (on dit ce que l’on aime ou ce que l’on n’aime pas).
  • Le second est celui de l’historique de navigation réel : indépendamment de ce que l’on dit aimer, les plateformes « voient » ce que l’on consomme réellement et ce sur quoi on est appétent.
  • Le troisième critère est celui de la moyenne statistique (comparativement à d’autres ayant déclaré les mêmes centres d’intérêt, et/ou dans le même groupe d’âge, de genre, etc.)
  • le quatrième critère est celui de la stochastique, de l’aléatoire. Depuis le début des systèmes de recommandation, les ingénieurs qui fabriquent ces algorithmes savent que si on ne sort pas de temps en temps de nos centres d’intérêt déclaratifs on va avoir des phénomènes de désintérêt ou de lassitude. Ils injectent donc un peu (ou beaucoup) d’aléatoire pour « affiner » et « ajuster » mais aussi pour (souvent) nous « ramener » des des contenus plus directement monétisables. La question c’est de savoir jusqu’où peut aller cet aléatoire (plus ou moins loin de nos habitudes de. navigation et de consultation) et de quelle manière et en quelles proportions il peut-être corrélé à d’autres moyennes statistiques.

Reste la particularité de l’algorithme de Tiktok qui est la question du rythme. Alors que la durée moyenne d’une vidéo TikTok est de 15 ou 16 secondes, toutes les 3, 4, 5 ou 6 secondes, donc sur des temps et des rythmes extrêmement courts, il y a une interaction, donc une documentation de notre pratique, donc une information pour l’algorithme.  La vitesse de consommation est en elle-même une information. Elle fonctionne comme un arc réflexe. Chaque vidéo, chaque contenu affiché est l’équivalent du petit coup de marteau sur votre genou pour déclencher l’arc réflexe. Sauf que cette fois l’arc réflexe recherché est un arc réflexe cognitif. Cette rythmique a été copiée par les autres plateformes : Reels sur Insta, Spotlights sur Snapchat, Shorts sur Youtube.

A cette rythmique s’ajoute aussi la multiplication des points d’entrée dans les logiques de recommandation : « Pour toi » mais aussi « abonnements » (« suivis »), « amis », « lives », « explorer ».

Et une stratégie du fou, de l’irrationalité : certains contenus mis en avant disposent de chiffres de visibilité et d’engagement hallucinants (plusieurs centaines de millions de vues) alors que d’autres beaucoup plus travaillés et pertinents ne décolleront jamais. La question des métriques est par ailleurs là aussi une spécificité de TikTok qui fonctionne comme un vertige, une ivresse de notoriété : la moindre vidéo peut atteindre des nombres de vues immensément plus important que sur d’autres plateformes. Comme sur les autres plateformes, absolument rien ne permet en revanche d’authentifier la sincérité de ces métriques.


2. Les algorithmes des réseaux sociaux peuvent-ils favoriser certains types de contenus ? Le font-ils effectivement ? Si oui, selon quels facteurs et quelles modalités ? Identifiez-vous des spécificités propres au fonctionnement de TikTok ?

Dans l’absolu la réponse est oui car la nature même d’un algorithme est de trier et d’organiser l’information et les contenus. Donc de hiérarchiser. Donc d’éditorialiser (cf « Un algorithme est un éditorialiste comme les autres« ). Ce qui est plus complexe c’est de documenter finement la manière dont ils procèdent. Mais on a eu un exemple indépassable avec le rachat de Twitter par Elon Musk et la manière dont du jour au lendemain la ligne éditoriale a totalement changé (cf mon article « ouvrir le code des algorithmes ne suffit plus« ).

[Nota-Bene] J’entends le terme « d’éditorialisation » comme le définit Marcello Vitali-Rosati : « L’éditorialisation est l’ensemble des dispositifs qui permettent la structuration et la circulation du savoir. En ce sens l’éditorialisation est une production de visions du monde, ou mieux, un acte de production du réel. »

L’autre enjeu c’est de comprendre à quels intérêts ces changements correspondent ; un algorithme étant nécessairement la décision de quelqu’un d’autre, qu’est-ce qui motive ces décisions ?

  • L’idéologie ? Exemples récents et récurrents de rétablissement de comptes masculinistes ou pro-avortement, prime donnée à ces contenus, etc.
  • La géopolitique ? Exemples récents de contenus plutôt pro-israëliens sur Facebook après le 7 Octobre (en tout cas invisibilisation de contenus pro-palestiniens) à l’inverse de contenus plutôt pro-palestiniens sur TikTok.
  • L’argent (recettes et monétisation publicitaire) ?

Un concept clé pour comprendre la favorisation de certains contenus c’est celui de la publicitarisation. La « publicitarisation » c’est une notion définie ainsi par Valérie Patrin-Leclère, enseignante au CELSA :

« une adaptation de la forme, des contenus, ainsi que d’un ensemble de pratiques professionnelles médiatiques à la nécessité d’accueillir la publicité. Cette adaptation consiste en un aménagement destiné à réduire la rupture sémiotique entre contenu éditorial et contenu publicitaire – elle se traduit, par exemple, par l’augmentation des contenus éditoriaux relevant des catégories « société » et « consommation » ou par le déploiement de formats facilitant l’intégration publicitaire, comme la « téléréalité » – mais aussi en un ménagement éditorial des acteurs économiques susceptibles d’apporter des revenus publicitaires au média (…) »


Cette publicitarisation est là encore très ancienne. Un des responsables partenariats de Google (David Eun) déclarait il y a plus de 20 ans : « Ads Are Content ». Traduction : « les publicités sont du contenu« , et par extension, « les publicités c’est le contenu« . Le résultat aujourd’hui c’est ce verbatim d’utilisateurs et d’utilisatrices pour qui « le fait que le contenu est sponsorisé n’est pas toujours explicite et même parfois volontairement dissimulé. Les publicitaires reprennent également les codes des influenceurs et les trends, ce qui floute la frontière entre une recommandation personnelle et un contenu sponsorisé. »

Concernant la dimension géopolitique ou idéologique, là où TikTok est un objet encore plus complexe c’est parce que lui-même est en quelque sorte le premier réseau social directement, presqu’ontologiquement géopolitique. Créé par la Chine, comme un facteur, vecteur, agent d’influence. Mais avec des déclinaisons différentes dans chaque pays ou zone : le TikTok Chinois n’est pas le TikTok américain qui lui-même n’est pas exactement le TikTok européen, etc.

Une autre particularité forte de l’algorithmie de TikTok (en plus de son rythme propre) c’est ce qu’on appelle le « beauty / pretty privilege » et qui fait que des phénomènes comme le SkinnyTok ont un impact majeur presqu’indépendamment du nombre d’utilisateurs actifs de la plateforme (saisine par Clara Chappaz de l’ARCOM et de la commission européenne à ce sujet). Et qui fait que certains corps (noirs, gros, trans, etc.) sont invisibilisés ou dénigrés.

Les réseaux et médias sociaux, via leurs décisions et tamis algorithmiques, sont essentiellement deux choses :

  • des machines à cash
  • des machines à fabriquer de la norme

Et plus il y aura de normes édictées par les médias sociaux, plus elles seront facilement suivies (public captif), plus elles seront publicitarisables, plus il y aura de cash, plus il y aura de nouveaux espaces de publicitarisation. Ad Libitum.

Et pour être ces machines à cash et à fabriquer de la norme, les algorithmes de ces plateformes ont un rapport particulier à la mémoire : ils sont structurellement dans une forme d’hypermnésie permanente (du fait de la conservation de nos historiques) mais sont conjoncturellement tout à fait capables d’amnésie lorsque cela les arrange ou le nécessite (par exemple pour nous re-proposer des contenus dont nous avons dit qu’ils ne nous intéressaient pas mais qui sont rentables pour la plateforme).


3. Quels sont les conséquences du modèle économique des réseaux sociaux et particulièrement de TikTok quant à la construction et la mise en œuvre des algorithmes utilisés ?

Ils cadrent tout. Au sens où le sociologue Erving Goffman parle des « cadres de l’expérience ».

Toute expérience humaine renvoie, selon Goffman, à un cadre donné, généralement partagé par toutes les personnes en présence ; ce cadre oriente leurs perceptions de la situation ainsi que les comportements qu’elles adoptent par rapport à elle. Ceci étant posé, l’auteur s’attache, selon son habitude, à classer les différents types de cadres, en distinguant d’abord les cadres primaires des cadres transformés. (Source)


Ces cadres vont ensuite être « modalisés », c’est à dire subir différentes transformations. Et donc la conséquence du modèle économique des réseaux sociaux c’est que la publicité, ou plus exactement la publicitarisation est la première modalisation de ce cadre d’expérience commun qu’est la navigation dans les contenus de chaque plateforme.

La publicitarisation fabrique littéralement de la consommation (au sens économique mais aussi informationnel et navigationnel), consommation qui elle-même fabrique des formes de compulsion (FOMO, etc.) qui elles-mêmes viennent nourrir et optimiser la rentabilité du cadre de la publicitarisation.

Sur ce sujet, je cite souvent l’exemple de la position des deux fondateurs du moteur de recherche Google, Serguei Brin et Larry Page; En 1998, ils publient un article scientifique pour expliquer le fonctionnement de l’algorithme Pagerank qui va révolutionner le monde de la recherche en ligne. Et dans une annexe de leur article scientifique ils écrivent :

« nous déclarons que les moteurs de recherche reposant sur un modèle économique de régie publicitaire sont biaisés de manière inhérente et très loin des besoins des utilisateurs. S’il est vrai qu’il est particulièrement difficile, même pour les experts du domaine, d’évaluer les moteurs de recherche, les biais qu’ils comportent sont particulièrement insidieux. Une nouvelle fois, le Google de ces dernières années en est un bon exemple puisque nous avons vendu à des entreprises le droit d’être listé en lien sponsorisé tout en haut de la page de résultats pour certaines requêtes. Ce type de biais est encore plus insidieux que la « simple » publicité parce qu’il masque l’intention à l’origine de l’affichage du résultat. Si nous persistons dans ce modèle économique, Google cessera d’être un moteur de recherche viable. »

Et ils concluent par :

 « Mais nous croyons que le modèle publicitaire cause un nombre tellement important d’incitations biaisées qu’il est crucial de disposer d’un moteur de recherche compétitif qui soit transparent et transcrive la réalité du monde. »


On a donc des plateformes qui « ontologiquement » ont pleine conscience et connaissance de la dénaturation opérée par leur modèle de régie publicitaire mais qui passent outre à la seule fin d’une rentabilité maximale. Cela pourrait être simplement considéré comme du cynisme. Mais à l’échelle des dégâts produits à la fois dans le débat public mais aussi dans la psyché de certains des plus jeunes ou des plus fragiles, c’est de l’irresponsabilité. Et c’est pénalement condamnable. Cela devrait l’être en tout cas.


4. Quelles sont les conséquences des opinions des concepteurs des algorithmes utilisés par les réseaux sociaux, et notamment de leurs éventuels biais, dans la construction et la mise en œuvre de ces algorithmes ?

J’ai déjà répondu plus haut avec l’exemple du rachat de Twitter par Musk et dans mon article « Ouvrir le code des algorithmes ne suffit plus« . Mais on peut aussi compléter par le récent changement de Zuckerberg qui impacte directement les contenus diffusés sur Facebook. Encore une fois : il n’y a pas d’algorithmes, juste la décision de quelqu’un d’autre. Très longtemps on a refusé de le voir. Aujourd’hui, plus le monde se clive, plus les conflits sont mondialisés dans leur médiatisation, plus les plateformes sont par nature ou par intérêt des outils de Soft Power, et plus l’opinion ou l’agenda de leurs concepteurs est déterminant et cadrant.

Ce qui est très frappant aujourd’hui c’est ce qu’écrivait Kate Crawford dans son Atlas de l’IA (2021) et qui s’applique tout particulièrement aux algorithmes en tant que systèmes de pouvoir et que facteurs de puissance.

(…) il n’y a pas de boîte noire unique à ouvrir, pas de secret à révéler, mais une multitude de systèmes de pouvoir entrelacés. La transparence totale est donc un objectif impossible à atteindre. Nous parviendrons à mieux comprendre le rôle de l’IA dans le monde en nous intéressant à ses architectures matérielles, à ses environnements contextuels et aux politiques qui la façonnent, et en retraçant la manière dont ils sont reliés.

Pour les algorithmes, c’est exactement la même chose : il faut nous intéresser simultanément à leurs architectures matérielles, à leurs environnements contextuels et aux politiques qui les façonnent, et retracer la manière dont ils sont reliés. Un algorithme, aujourd’hui, n’est plus uniquement une suite d’instructions logico-mathématiques, c’est une suite de systèmes de pouvoirs entrelacés.


5. Faut-il considérer les algorithmes comme des objets statiques ? Comment un algorithme évolue-t-il ? Peut-il évoluer sans intervention humaine, en apprenant de son propre fonctionnement ? À votre connaissance, comment cela s’applique-t-il aux réseaux sociaux, et particulièrement à TikTok ?

Je reprends ici ce que j’indiquais dans mes propos liminaires. Les algorithmes sont comme des ritournelles auxquelles on s’accoutume à force de les fréquenter, que l’on retient – et que l’on maîtrise parfois – dans une forme d’intelligence situationnelle altérée par l’expérience sans cesse renouvelée de cette fréquentation. Comme la ritournelle chez Deleuze et Guattari dans leur ouvrage « Mille Plateaux », les algorithmes sont trois choses à la fois :

  1. D’abord ce qui nous rassure par une forme de régularité attendue, que l’on devine et anticipe.
  2. Ensuite ce qui installe l’organisation nous semblant familière d’un espace que l’on sait public mais que l’on perçoit et que l’on investit en partie comme intime : ils « enchantent » l’éventail de nos affects et sont l’état de nature de nos artifices sociaux.
  3. Enfin ils sont ce qui, parfois, nous accompagne et nous équipe aussi dans la découverte d’un ailleurs, parce qu’y compris au sein de représentations cloisonnées, ils sont des « chants traversants. »

L’algorithme de TikTok n’est pas plus intelligent, plus efficace ou plus machiavélique que d’autres ; simplement, nous passons beaucoup plus de temps à nous en occuper, et nous le faisons, du fait de sa rythmique propre, avec une fréquence beaucoup plus élevée et avec un soin sans commune mesure avec les autres. Notre rapport à l’algorithme de Tiktok relève littéralement d’une forme de clinique au sens étymologique du terme, c’est à dire emprunté au grec klinikos, « propre au médecin qui exerce son art près du lit de ses malades » (lui-même de klinê, « le lit »). Selon que nous adoptons le point de vue de la plateforme ou le notre, nous sommes le médecin ou le malade.


6. Comment les algorithmes utilisés par les réseaux sociaux, et particulièrement TikTok, s’adaptent-ils à des comportements humains parfois changeants d’un jour à l’autre ?

Par effet d’entrainement. Nous éduquons et entraînons les algorithmes au moins autant qu’ils ne nous formatent en retour. Et tout parciculièrement celui de TikTok comme je l’expliquais juste ci-dessus.

Et puis par leur rythme (cf supra). L’algorithme se moque de savoir si vous êtes de gauche aujourd’hui alors que vous étiez de droite hier, végétarien aujourd’hui alors que vous étiez végan hier. Ce qui intéresse les concepteurs de l’algorithme c’est la captation en temps réel de l’ensemble de ce qui définit votre surface informationnelle numérique. L’algorithme a pour objet de scanner en permanence et si possible en temps réel des éléments qui constituent à la fois votre surface informationnelle (ce qui vous intéresse), votre surface sociale (avec qui partagez-vous ces intérêts) et votre surface comportementale (« sur quoi » ou « avec qui » passez-vous plus ou moins de temps).

Le grand problème est d’ailleurs aussi celui de la personnalisation : c’est à dire que, sur certains types de requêtes en tout cas, plus personne ne voit la même chose en réponse à la même question (ceci vaut pour les plateformes dans lesquels on démarre la navigation par une recherche). Et pour les plateformes, comme TikTok, dans lesquelles il n’est besoin d’aucun amorçage mais uniquement de scroller, tout le monde à l’impression de voir des choses différentes (personnalisées) alors qu’en fait tout le monde voit pour l’essentiel la même chose ; mais cette « même chose » se réduit exclusivement à ce qui est bon économiquement pour la plateforme, c’est à dire soit ce qui fait le buzz et va vous obliger à réagir (polarisation émotionnelle), soit ce qui vous maintient attentionnellement captif et peut donc possiblement renforcer des troubles conatifs (« Symptômes liés à une réduction des capacités d’effort, d’initiative, et à une dégradation de la volonté et des tendances à l’action. Les formes majeures peuvent aboutir à une inactivité avec repli, parfois incurie et résistance aux sollicitations de l’entourage, voire indifférence affective.« )

Je ne sais pas si l’image vous parlera mais plutôt que l’idée des « bulles de filtres » d’Eli pariser (idée que les algorithmes enferment chacun d’entre nous dans une bulle informationnelle plus ou moins étanche) je parlais de mon côté d’un comportement d’autarcithécaires ; cette idée que, du point de vue des plateformes et de leurs algorithmes, il s’agit de nous faire croire que nous sommes en situation d’autarcie informationnelle, c’est à dire de nous donner l’impression que ce qu’elles nous donnent à voir est à la fois suffisant, complet et représentatif, précisément pour que nous perdions progressivement le besoin d’aller regarder ailleurs ou même simplement de considérer qu’il existe un ailleurs informationnel. Ou pour le dire d’une autre manière, comment nous faire passer de la peur de rater quelques chose (FOMO) à la certitude d’une non-nécessité d’aller voir ailleurs.


7. Peut-on envisager des algorithmes « éthiques », notamment eu égard aux enjeux de santé mentale ? Pouvez-vous expliquer le concept d’« informatique sociale » ?

Pour moi l’éthique algorithmique passe par le rendu public de l’ensemble des critères et métriques relevant de formes d’éditorialisation. Et pour répondre par une comparaison, bien sûr que oui, on peut tout à fait imaginer des algorithmes éthiques comme on peut imaginer des vêtements fabriquées de manière éthique, des aliments fabriqués de manière éthique et qui ne soient pas immensément transformés. La seule question est : pourquoi ne le faisons-nous pas ? Pourquoi lorsqu’il en existe parfois personne ne s’y intéresse ?

La réponse à ces questions est évidemment la même que pour l’agro-alimentaire ou les vêtements : c’est une question de coût (ce qui n’est pas éthique est moins cher) et de cadres sociétaux de consommation (où l’on minore et où l’on invisibilise les problèmes posés par cette absence d’éthique).

A chaque fois il faut des drames pour que la société parvienne à se réveiller temporairement. Comme lors de l’effondrement du Rana Plaza au Bangladesh en 2013 qui fait exploser le scandale de la fast fashion. Mais malheureusement à chaque fois au lendemain de ces réveils sociétaux il se produit deux choses : le pouvoir politique ne saisit pas l’opportunité impérieuse de légiférer, et lorsqu’il le fait, la puissance du lobbying et du pantouflage vient tout édulcorer ou tout remettre à plus tard.

En complément, il y a un point particulier d’une éthique algorithmique qui consiste à se mettre en situation (pour les plateformes), où à donner l’injonction (pour la puissance publique) de casser les chaînes de contamination virales. De ralentir. D’ajouter de la friction dans les possibilités de partage, etc. On a vu et on a documenté que cela marchait, et que les plateformes le savaient. Je cite ici, avec les exemples en lien, ce que j’écrivais en Mars 2022 dans mon article « Par-delà le Like et la colère » :

« Ensuite il faut casser les chaînes de contamination virales qui sont à l’origine de l’essentiel des problèmes de harcèlement, de désinformation, et des discours de haine dans leur globalité. Et là encore le cynisme des plateformes est aussi évident que documenté puisqu’elles ont elles-mêmes fait la démonstration, et à plusieurs reprises, que si par exemple elles diminuaient le nombre de personnes que l’on peut inviter par défaut dans les groupes Whatsapp ou le nombre de conversations et de groupes vers lesquels on peut automatiquement transférer des messages, elles diminuaient aussi considérablement la vitesse de circulation des fake news, notamment en période électorale ; que si elles supprimaient la visibilité de nombre de likes ou de réactions diverses sur un post (et que seul le créateur du post était en mesure de les voir), elles jouaient alors sur les effets souvent délétères de conformité (et de pression) sociale et qu’elles permettaient d’aller vers des logiques de partage bien plus vertueuses car essentiellement qualitatives et non plus uniquement quantitatives ; que si elles se contentaient de demander aux gens s’ils avaient bien lu l’article qu’ils s’apprêtaient à partager avant que de le faire sous le coup de l’émotion, elles diminuaient là encore la circulation de fausses informations de manière tout à fait significative. Il y a encore quelques jours, c’était Youtube qui annonçait supprimer l’affichage public du compteur des « dislikes » pour « protéger » les créateurs notamment de formes de harcèlement, un effet qu’il connaît et documente pourtant depuis déjà de longues années. »


Sur les données personnelles utilisées par les algorithmes des réseaux sociaux

8. Pouvez-vous expliquer le concept d’« identité numérique » ? Quelles données personnelles partageons-nous lorsque nous utilisons les réseaux ? Comment ces données sont-elles utilisées par les algorithmes des réseaux sociaux et particulièrement de TikTok ?

Pour reprendre, en l’actualisant, la définition que j’en donnais dans mon ouvrage éponyme paru en 2013, je dirai que :

L’identité numérique peut être définie comme la collection des traces (écrits, contenus audios ou vidéos, messages sur des forums, identifiants de connexion, navigations, éléments d’interactions, etc.) que nous laissons derrière nous, consciemment ou inconsciemment, au fil de nos activités connectées, et le reflet de cet ensemble de traces tel qu’il apparaît « remixé » par les moteurs de recherche ainsi que par les médias et les plateformes sociales, et qui sont autant d’éléments en capacité de nourrir des choix algorithmiques visant à mieux cibler les contenus qui nous seront proposés dans le cadre du modèle économique de la plateforme concernée.

(version actualisée de Ertzscheid, Olivier. Qu’est-ce que l’identité numérique ?. OpenEdition Press, 2013, https://doi.org/10.4000/books.oep.332.)


9. Est-il possible de limiter ce partage de données personnelles ? Est-il possible et souhaitable d’en limiter la collecte, par exemple par le paramétrage des réseaux sociaux ?

Concernant la première partie de la question (est-il possible d’en limiter le partage), et pour autant qu’elle s’adresse aux utilisateurs et utilisatrices de ces plateformes, je réponds oui pour les données personnelles « déclaratives » (nous pouvons disposer d’un tamis plus ou moins large). Mais je réponds « non » pour les données personnelles qui relèvent de la sphère comportementale (ce que l’on voit, ce avec quoi l’on interagit, etc.).

Si la question s’adresse aux plateformes, alors là c’est un oui pour les données personnelles déclaratives comme pour les données comportementales. Elles sont tout à fait en capacité d’en limiter la collecte (mais cela vient heurter leur modèle publicitaire) et sont tout autant en capacité d’en limiter les usages dans le temps.

Le problème principal tient au statut discursif ou énonciatif de l’ensemble de ce qui circule, se dit et se voit dans ces plateformes ou applications : nous ne savons jamais réellement si nous sommes dans un espace discursif ou médiatique intime (où il serait OK et parfois nécessaire de partager ces données personnelles), privé, ou public. Dès 2007, trois ans après le lancement de Facebook, danah boyd indiquait que le problème des réseaux sociaux est qu’ils étaient des espaces semi-publics et semi-privés (« la privauté de ces espaces publics ou semi-publics pose problème« ). Ce problème n’a jamais été résolu.

L’autre problème (et la grande responsabilité des plateformes) c’est qu’elles changent en permanence et sous plein de prétextes différents, le réglage de nos paramètres de confidentialité ou de navigation. Et qu’elles complexifient, par défaut, la possibilité de limiter ce partage de données personnelles (dark patterns, etc.)

Sur la deuxième partie de la question (est-ce possible et souhaitable de limiter cette collecte), je réponds que c’est possible, que c’est souhaitable, et que c’est, surtout, absolument nécessaire.

Il y a un grand récit marketing et technologique qui nous fait croire que plus on collecte de données personnelles, et plus on peut nous proposer de l’information et des contenus personnalisés, et plus ce serait donc intéressant pour nous. C’est une vaste et totale fumisterie. Le seul récit qui vaille est le suivant : plus on collecte de données personnelles, plus on propose des contenus personnalisés, plus on ne fait que « publicitariser » les expériences navigationnelles et informationnelles, et plus on efface la notion de référent commun sur tout un ensemble de sujets, plus on saborde à l’échelle d’une société la question des « régimes de vérité » (cf Foucault ci-dessous), et plus on crée donc à la fois de l’isolement, du conflit, et de la défiance.

« Chaque société a son régime de vérité, sa politique générale de la vérité : c’est-à-dire les types de discours qu’elle accueille et fait fonctionner comme vrais ; les mécanismes et les instances qui permettent de distinguer les énoncés vrais ou faux, la manière dont on sanctionne les uns et les autres ; les techniques et les procédures qui sont valorisées pour l’obtention de la vérité ; le statut de ceux qui ont la charge de dire ce qui fonctionne comme vrai. » Michel Foucault


Longtemps la « personnalisation » n’a été que thématique et déclarative. Du genre : je préfère l’actualité sportive à l’actualité politique, et dans l’actualité sportive, je préfère le rugby au foot. Dès que la personnalisation a gommé cette dimension déclarative explicite, dès qu’elle a surtout été indexée sur nos propres croyances, comportements et opinions plutôt que sur des médias aux formes et aux pratiques d’éditorialisation transparentes, elle est devenue un instrument purement marketing avec un impact politique massivement délétère.


Sur la transparence des réseaux sociaux

10. Pensez-vous qu’il soit possible d’exiger des réseaux sociaux d’être entièrement transparents sur leur fonctionnement et les algorithmes qu’ils utilisent ?

Je reprends ici une partie de mes propos liminaires. Oui il est possible de l’exiger. En tout cas sur la partie éditoriale, cela me semble nécessaire de l’exiger. En définissant le périmètre de cette éditorialisation pour éviter qu’elle ne puisse être totalement instrumentalisée (par exemple si tout le monde sait qu’un like vaut 1 point et qu’une colère vaut 5 points, nos comportements sont susceptibles de changer mais pour autant il est impératif que chacun sache combien « vaut » chaque type d’interaction mobilisée).

Mais plus fondamentalement nous parlons d’outils qui ont totalement explosé le cadre anthropologique de la communications entre les êtres humains. On peut se parler à distance, en absence, à la fois à plusieurs et en dialogue, en multimodalité, via des avatars, etc.

Et d’outils qui touchent chaque jour et de manière récurrente davantage de monde que jamais aucun média n’a jamais été en capacité d’en toucher et ce dans toute l’histoire de l’humanité. Ce ne sont pas seulement des médias de masse mais des médias d’hyper-masse.

Et enfin il y a la question du rythme, de la fragmentation et de la séquentialité hypercourte : notre cerveau n’est pas fait, n’est pas calibré pour s’informer par tranches de 6 à 15 secondes en passant d’un sujet à un autre.

Cette triple révolution anthropologique de la communication ne peut s’accommoder de demi-mesures ou de clairs-obscurs législatifs et réglementaires. A fortiori lorsque la mauvaise foi, la duperie et la tromperie de ces plateformes a été démontrée et documentée à de très nombreuses reprises, grâce notamment aux lanceurs et lanceuses d’alertes.

Et a fortiori encore dans un monde où elles sont devenus totalement indissociables de pouvoirs politiques qu’elles servent toujours par intérêt (soit pour échapper à des régulations, soit pour jouir de financements publics, soit pour tuer la concurrence comme le documentent encore les actuelles actions en justice contre Google et Meta notamment).


11. Est-on en mesure de contrôler cette transparence ? Comment, tant au niveau européen qu’au niveau français ?

Nous n’avons aujourd’hui plus besoin de produire des textes, lois et règlements. Nous avons besoin de faire appliquer ceux qui existent déjà (DSA, DMA, RGPD). Et d’organiser un cadre politique dans lequel la main de l’exécutif ne tremblera pas. Par exemple au titre de l’application du DSA, Twitter devenu X aurait pu et probablement dû être au moins temporairement fermé et interdit à l’échelle européenne (il l’a été au Brésil pendant plusieurs mois).

Nous sommes aujourd’hui pour la régulation de ces mass média en plein paradoxe de la tolérance tel qu’exprimé par Popper. A force d’être tolérants y compris avec les intolérants, nous courrons droit dans le mur. [« Popper affirme que si une société est tolérante sans limite, sa capacité à être tolérante est finalement détruite par l’intolérant. Il la décrit comme l’idée apparemment paradoxale que « pour maintenir une société tolérante, la société doit être intolérante à l’intolérance. » Wikipedia]

Il faut à ce titre aussi exiger des plateformes qu’elles appliquent leurs propres règles, et par exemple ne traitent pas différemment leurs « power users » car à ce jour ces plateformes, toutes ces plateformes, ont d’abord un immense problème de démocratie interne.


12.  Les apports du DSA sont-ils suffisants ?

Oui pour autant qu’il y ait la volonté politique de l’appliquer en chacun de ses termes.


13.  Est-ce techniquement possible, a minima, d’exiger des réseaux sociaux des garanties que leurs algorithmes ne comprennent pas de biais susceptibles d’avoir des conséquences néfastes (sur-représentation de contenus dangereux pour la santé mentale, propagation de fake news, discriminations, etc) ?

Je crois qu’on se trompe en plaçant cette question sous l’angle « technique ». Ce n’est pas à la « technique » d’arbitrer des questions qui relèvent de la santé publique ou de l’éthique. Je me permets une comparaison. Se poserait-on la question de savoir s’il est possible « techniquement » d’exiger d’une bibliothèque que son plan de classement de comprenne pas de biais ? Non. Parce que le problème ce n’est pas le plan de classement, ce sont les unités documentaires que l’on choisit de classer, donc de donner à voir, ou de ne pas classer. Les plateformes et leurs algorithmes sont « techniquement » en pleine capacité de faire respecter des règles a minima de représentativité sur un ensemble de sujets, y compris politiques, religieux ou sociétaux. Jamais en réalité nous n’avons disposé d’outils aussi puissants et aussi précis pour y parvenir. Si les plateformes (et leurs algorithmes) ne le font pas ce n’est en rien un problème technique. En rien. C’est un problème de choix économiques (business first). Et d’idéologies et d’interêts partisans (ou cyniquement opportunistes) de leurs propriétaires et de leurs actionnariats.


14.  Quelle méthodologie utilisez-vous pour étudier les algorithmes utilisés par les réseaux sociaux, et particulièrement TikTok ? Quelles difficultés rencontrez-vous ? Que signifierait, pour le monde de la recherche, la publicité des algorithmes utilisés par les réseaux sociaux ?

A titre personnel, dans mon domaine de recherche, soit on procède par enquête sociologique, soit par observation participante. Comme les sociologues allaient à l’usine pour documenter au plus près le travail concret des ouvriers, on va « aux algorithmes » pour documenter au plus près leurs effets.

Un des grands sujets de notre temps, c’est que nous avons perdu la maîtrise des corpus. Quand je dis « nous » je parle du monde universitaire et donc ensuite du monde de la décision politique. Tous les programmes partenariaux publics permettant à des universitaires d’avoir accès à l’immensité des corpus détenus par les plateformes, tous ces programmes partenariaux ont été fermés. La plupart des API supprimées. L’opacité, hier sur les algorithmes, aujourd’hui sur les données, est absolument totale. Et nous en sommes réduits à faire confiance aux chercheurs employés par ces plateformes (mauvaise idée), ou à attendre la prochaine fuite d’un repenti ou d’une lanceuse d’alerte (encore plus mauvaise idée). La puissance publique, les chercheurs et universitaires de la puissance publique, n’ont plus aucune entrée ou maîtrise des corpus (linguistiques, sociologiques, etc) qui circulent dans ces plateformes et qui les constituent. Et c’est non seulement très inquiétant, mais c’est surtout très inacceptable.


Sur l’éducation aux réseaux sociaux

15.  Le grand public est-il familiarisé avec le fonctionnement des algorithmes, et particulièrement de ceux utilisés par les réseaux sociaux ? Adapte-t-il son comportement en conséquence ?

Les travaux existants montrent qu’en effet, lorsqu’un fonctionnement algorithmique est suffisamment connu on a tendance à l’intégrer à notre pratique. Et en général les plateformes mettent donc en place des dispositifs pour contrer ces usages « non naturels » (exemple du Google Bombing). Aujourd’hui, même en connaissant certains « tips » agorithmiques, on ne s’en affranchit pas automatiquement. Et il est beaucoup plus difficile de connaître ou de tricher avec la « totalité » d’un algorithme aujourd’hui que cela ne l’était hier.

Par ailleurs, y compris les ingénieurs qui développent ces algorithmes sont de moins en moins nombreux à en connaître la totalité des fonctionnements. Et la capacité de tourner à plein sans supervision humaine des ces algorithmes n’a jamais cessé d’augmenter. Et cela ne vas pas s’arranger. Récemment le CEO de Google, Sundar Pinchai, confiait qu’environ 30% de l’ensemble du « code » informatique utilisé par l’ensemble des produits de la société Alphabet (maison mère de Google, Youtube, etc) était directement produite par des IA.

Quand à notre comportement adaptatif, il demeure très relatif. Nous ne l’adaptons que dans la mesure où nous avons l’impression que cette adaptation va servir directement (et rapidement) nos intérêts immédiats. Sur le reste, nous sommes plutôt d’une passivité totale, nous nous laissons algorithmiser parce que tout est fait pour fausser notre perception de la balance bénéfices / risques.


16.  Pensez-vous que les enfants et adolescents soient suffisamment outillés, notamment par leurs établissements scolaires, pour se protéger des risques que ces algorithmes présentent ? Pensez-vous que les parents soient suffisamment outillés pour en protéger leurs enfants ?

La question de l’accompagnement aux écrans est une question … complexe. Ce que les jeunes et adolescents cherchent dans ces espaces (cf notamment les travaux de danah boyd aux USA ou d’Anne Cordier en France) ce sont des espaces qui soient transgressifs, la première transgression étant cette d’être à l’abri du regard des parents et des adultes. Les espaces numériques sont aussi ces alcôves algorithmiques qui permettent à la fois de se mettre à l’abri (du regard de l’adulte), d’être ensemble (y compris parfois « seuls ensemble » comme l’explique Shirley Turckle), et d’être dans la transgression autant que dans la construction d’un intime. Et cela est tout à fait normal et ne doit sous aucun prétexte être condamné ou, pire, criminalisé. Le problème, le seul et le grand problème, c’est que la construction de cet intime est toujours scruté par des autorités qui ne sont plus « parentales » mais industrielles.

Bonne nouvelle : on observe déjà et très largement des pratiques de « sevrage » temporaire mises en place par les adolescents et jeunes adultes. Cela peut-être à l’approche d’un examen à la fac, du bac français, etc. Pratiques où ils et elles désinstallent temporairement l’application de leur smartphone. Cela veut dire (pour ces publics) qu’une bonne partie du travail de pédagogie est déjà fait. Il faut ensuite trouver un effet cliquet, qui permette d’éviter de délétères retours en arrière. Et c’est bien là le rôle de la puissance publique.

Rappeler aussi que l’enjeu n’est et ne doit pas être d’interdire les écrans, mais de disposer, dans le cadre de l’organisation de notre vie sociale, éducative, publique et citoyenne, d’espaces qui demeurent des espaces non nécessairement déconnectés ou sans écrans, mais à tout le moins sans écrans et connexions qui ne soient autres que collectives ou a minima duales.

A ce titre oui, je suis convaincu par exemple qu’à l’école et au collège, les smartphones devraient être totalement interdits, dans les cours (de récréation) comme en cours. Et vous savez quoi ? Accrochez-vous bien. BINGO. C’est déjà le cas 🙂

Et qu’au lycée et même à l’université, ils devraient continuer de l’être pendant les cours. Mais qu’il n’est pour cela ni utile ni nécessaire de passer par la loi. C’est à chaque enseignante ou enseignant et éventuellement à chaque université ou composante de le décider et surtout, surtout, surtout, de l’expliquer. Parce qu’il ne s’agit pas de faire oeuvre de censure ou de police. Mais parce que si l’on considère que la transmission de savoirs tout comme l’acquisition des sociabilités primaires et fondamentales, passe par un pacte attentionnel minimal aux autres et à celui ou celle en charge de vous les transmettre et de vous les faire acquérir, alors il faut aussi accepter que celui ou celle qui est en charge de cela, quelque soit son talent et sa détermination, ne sera jamais, absolument jamais, en situation de rivaliser attentionnellement avec un objet technologique qui contient à lui seul tous les savoirs et toutes les sociabilités du monde.

Rappeler aussi que la question de la santé mentale, notamment chez les jeunes, est toujours, toujours multi-factorielle : elle tient à la fois à des paramètres éducatifs, culturels, familiaux, économiques. Donc il peut y avoir aussi bien des corrélations que, dans certains contextes, des causalités entre l’usage de TikTok et les questions de santé mentale. Mais si l’on veut s’attaquer (et il le faut) aux questions de santé mentale qui affectent désormais de manière alarmante des générations entières, alors il faut aussi et surtout traiter la question des politiques de santé publiques.

Rappeler enfin qu’il existe des métiers (professeurs documentalistes) et des organismes (CLEMI) qui font ce travail formidable au long cours. Il faut en créer davantage et leur donner des moyens sans aucune commune mesure avec ceux actuels.

Questions générales

17.  De quels mécanismes de contrôle étrangers la France ou l’Europe devraient-elles, d’après-vous, s’inspirer ?

Je crois avoir déjà répondu plus haut que nous disposions de suffisamment de textes et règlements à l’échelle Européenne. Et qu’il reste à les appliquer entièrement.


18.  Avez-vous des recommandations à transmettre à la commission d’enquête ?

Ma première recommandation est un avertissement que je reprends de mes propos liminaires et d’un article que j’avais publié.

« Après les mensonges de l’industrie du tabac sur sa responsabilité dans la conduite vers la mort de centaines de millions de personnes, après les mensonges de l’industrie du pétrole sur sa responsabilité dans le dérèglement climatique, nous faisons face aujourd’hui au troisième grand mensonge de notre modernité. Et ce mensonge est celui des industries extractivistes de l’information, sous toutes leurs formes.

Nous avons aimé croire que le calcul intensif se ferait sans travail intensif, que le Data Mining ne nécessiterait pas de mineurs de fond, que l’informatique en nuage (Cloud Computing) ne dissimulait pas la réalité d’une industrie lourde. Nous ne pouvons plus aujourd’hui nous réfugier dans ces mensonges. Sur les industries extractivistes de l’information, nous avons l’avantage d’en connaître déjà les mécanismes et les routines ; la chance d’en observer les infrastructures de marché (du Cloud Computing au High Frequency Trading en passant par la précarisation des différentes formes de Digital Labor) ; la chance d’être capables de documenter la toxicité de ces prismes dans le cadre de certains sujets de société ; la chance d’avoir pu documenter et prouver à de trop nombreuses reprises l’insincérité fondamentale et aujourd’hui fondatrice de toutes ces plateformes et de leurs créateurs et administrateurs. Et même s’ils s’inscrivent, comme je le rappelais plus haut, dans un écosystème médiatique, économique et politique bien plus vaste qu’eux, leur part émergée, c’est à dire les médias sociaux, sont aujourd’hui pour l’essentiel de même nature que la publicité et le lobbying le furent pour l’industrie du tabac et du pétrole : des outils au service d’une diversion elle-même au service d’une perversion qui n’est alimentée que par la recherche permanente du profit. »


Pour le dire en d’autres termes, connaître la recette exacte du Coca-Cola ne change rien au phénomène de l’obésité : la seule chose qui compte c’est de se doter de politiques de santé publique qui éduquent, régulent, contraignent et qui dépublicitarisent, qui démonétisent symboliquement ce qu’est et ce que représente le Coca-Cola.

De la même manière, connaître l’impact du pétrole sur le réchauffement climatique et la part qu’y jouent nos modes de transport et les industriels extractivistes ne changera rien à l’avenir de la planète si l’on n’a pas de politique publiques sur l’écologie capable de proposer des alternatives aux premiers mais aussi de contraindre les seconds, et là encore de dépublicitariser, de démonétiser tout cela.

Pour les algorithmes, y compris et a fortiori pour celui de TikTok, c’est exactement la même chose : connaître son mode exact de fonctionnement ne changera rien aux errances et aux effondrements affectifs, psychologiques, conatifs, informationnels qu’il alimente. Il nous faut des politiques publiques du numérique. Dont des politiques de santé publique numérique.

Et il faut davantage de postes de professeurs documentalistes dans les lycées et collèges, avec davantage d’heures de cours dédiées à la culture numérique. Et aussi il faut financer et multiplier les structures et opérateurs comme le CLEMI. Oui je l’ai déjà dit. Mais oui je le redis. Et le redirai sans cesse.


[Verbatim étudiantes et étudiants]

L’échantillon est d’une petite soixantaine d’étudiantes et d’étudiants, en 1ère année de BUT Information et Communication (donc en gros âgés de 18 ou 19 ans) et avec qui j’ai déjà effectué quelques heures de cours autour des questions de culture numérique, de l’histoire d’internet et du web, et aussi un peu des enjeux sociétaux des algorithmes. La seule consigne donnée était de partir de leur expérience personnelle de la plateforme pour répondre aux questions de la commmission.

De manière générale ils et elles soulignent l’importance (et le manque) de politiques de santé publique et de communication, dans l’espace public, sur ce sujet.

  • « On voir rarement de campagne de prévention dans l’espace public sur le lien entre utilisation RS et questions de santé mentale, alors même que jamais les jeunes n’ont autant parlé de l’importance et de la fragilité de la santé mentale« 
  • « il faut renforcer la communication publique, notamment dans le cadre scolaire« 

Ils et elles soulignent également l’importance de faire à ces sujets davantage de place au collège et au lycée et surtout, d’en parler autrement que sous le seul angle de la culpabilisation ou des dérives comme le cyberharcèlement.

  • « tout le monde accuse tiktok d’être dangereux mais personne ne parle réellement des risques qui y sont associés et comment on s’en protège« 
  • « intégrer ces questions dans les machins genre Pix« 
  • « la plupart du temps, au lycée ou au collègue, ces plateformes ne sont abordées que sous l’angle du cyberharcèlement, mais jamais sous l’angle des algorithmes, de leur côté addictif, chronophage, démotivant« .

Ils et elles ont aussi une grande maturité sur la nécessité d’un contrôle d’accès réel avec une vérification de l’âge qui soit autre chose qu’un bouton « oui promis j’ai 18 ans » :

  • « faire un vrai contrôle d’accès selon l’âge, comme sur blablacar avec présentation d’un document d’identité« 

Ils et elles ont des idées très concrètes de ce qu’il faudrait obliger Tiktok (et d’autres plateformes) à mettre en place :

  • « obliger TikTok à implémenter des fonctionnalités permettant de mieux gérer le temps d’écran et à sensibiliser ses utilisateurs aux risques d’une utilisation excessive« 
  • « être plus à l’écoute des signalements. Et plus vigilants sur les contenus de type suicide : personne n’aime regarder des vidéos de suicide (ou de comment se suicider) et personne ne devrait se voir recommander des vidéos comme ça« 

J’ai enfin été particulièrement frappé, dans leurs verbatims, d’une large majorité qui indique explicitement que les impacts et effets négatifs sur leur humeur sont plus importants que les aspects positifs. Et de la manière dont ils documentent et analysent cela. Le verbatim ci-dessous résume très bien ce que j’ai lu dans beaucoup de leurs réponses individuelles :

  • « À titre personnel, tik tok a plus d’impact négatif que positif. En effet, une fois que je suis sur l’application, il m’est presque impossible de réguler mon temps passé sur cette
    dernière. Une heure est ressentie comme 15 minutes et arrêter de scroller est très compliqué. De plus, lorsque mon application est active, l’heure ne s’affiche plus sur mon écran, ce qui biaise encore plus mon rapport au temps. Ce temps passé sur tik tok est perdu pour faire d’autre activité, et souvent, je repousse les tâches que j’ai à faire. Après avoir passé plusieurs heures sur tik tok je culpabilise énormément et me sens mal. J’ai remarqué que mon moral était affecté par mon utilisation de tik tok, plus je passe de temps à scroller moins je suis de bonne humeur.« 

[Et puis soudain Gabriel Attal]

Voilà je m’apprêtais à demander à ChatGPT une version synthétique de ce long texte en extrayant les éléments mobilisables immédiatement dans le cadre d’une proposition de loi et puis soudain, je tombe sur plusieurs éléments complémentaires.

Premier élément : Gabriel Attal. Qui s’allie au pédopsychiatre Marcel Ruffo pour proposer des mesures qui sont, pour l’essentiel, des caricatures au carré. Caricature d’une pensée magique où tout est, sans indistinction, la faute aux écrans et où leur suppression guérirait donc tous les maux, et où toute cette faute mériterait donc des régimes disciplinaires qui sont autant imbéciles qu’inapplicables et dangereux en démocratie. Voici donc ce qu’ils proposent :

  • une évaluation de l’addiction aux écrans de chaque jeune à l’entrée en sixième et en seconde.
  • interdire l’accès des moins de 15 ans aux réseaux sociaux (et imposer une vérification d’âge sur ces plateformes).
  • imposer un couvre-feu pour les 15-18 ans qui bloque l’accès aux réseaux sociaux entre 22h et 8h.
  • faire passer l’écran en noir et blanc, pendant au moins une heure, après 30 minutes d’utilisation.
  • création d’un “addict-score” (sur le modèle du nutri-score) pour mesurer le potentiel addictif des plateformes.
  • créer une taxe de 2 % qui financerait la recherche et la prise en charge de la santé mentale.

J’ai donc immédiatement réfléchi à une critériologie assez fine permettant de caractériser chaque mesure proposée. Critériologie que voici :

  • « C’est complètement con » : 3C
  • « Inapplicable et Imbécile » : 2I.
  • « Pourquoi pas mais surtout … pourquoi ? » :  3P.

Revoici maintenant ces mesures à l’aune de mon analyse subtile.

  • une évaluation de l’addiction aux écrans de chaque jeune à l’entrée en sixième et en seconde : 3P
  • interdire l’accès des moins de 15 ans aux réseaux sociaux : 3C2I
  • imposer un couvre-feu pour les 15-18 ans qui bloque l’accès aux réseaux sociaux entre 22h et 8h : 3C2I
  • faire passer l’écran en noir et blanc, pendant au moins une heure, après 30 minutes d’utilisation. 3C3P
  • création d’un “addict-score” (sur le modèle du nutri-score) pour mesurer le potentiel addictif des plateformes. 3P

Je ne retiens donc que deux mesures :

  • « imposer une vérification d’âge sur ces plateformes. » Mais certainement pas pour « interdire » l’accès mais pour responsabiliser les plateformes qui organisent cet accès et font absolument n’importe quoi quelque soit l’âge réel de leurs utilisateurs et utilisatrices, âge réel que de leur côté elles sont la plupart du temps en pleine capacité de connaître (et donc d’en déduire la part d’utilisateurs et d’utilisatrices qui n’ont absolument rien à faire là puisqu’elles sont normalement interdites aux moins de 13 ans).
  • « créer une taxe de 2 % qui financerait la recherche et la prise en charge de la santé mentale. » Là je dis oui, mais je dis surtout « seulement 2% ?! »

Pour le reste, je vous invite à lire la chronique et l’analyse impeccable de François Saltiel dont je partage chaque ligne et chaque mot.

Et je vous invite aussi, à chaque fois que vous entendrez diverses gesticulations politico-médiatiques sur une interdiction totale ou partielle des écrans chez les enfants et adolescents, à relire (notamment) cet article grand public et surtout de grande utilité publique d’Anne Cordier, publié en Mai 2024, et dans lequel elle rappelle la réalité de deux points fondamentaux, celui de la panique morale sur ce sujet, et celui de la réalité des études scientifiques sur ce même sujet :

Ce phénomène des paniques morales exprime une crainte quant à la déstabilisation des valeurs sociétales, et se cristallise autour des usages juvéniles desdits écrans et des conséquences de ces usages sur la santé mentale et sociale des enfants et adolescents, ainsi que sur leur développement cognitif et leur culture générale.

Pourtant une importante et robuste étude américaine, menée sur le long terme auprès de 12000 enfants entre 9 et 12 ans, conclut sans hésitation à l’absence de lien entre temps passé « devant les écrans » et incidence sur les fonctions cérébrales et le bien-être des enfants. Pourtant encore, en France, une enquête longitudinale d’envergure, déployée cette fois auprès de 18000 enfants depuis leur naissance, montre que ce sont des facteurs sociaux qui jouent un rôle prépondérant dans le développement de l’enfant.

Malgré ces faits scientifiques, le débat autour de la place desdits écrans dans notre société se polarise, et se caractérise récemment par une ultraradicalisation des postures, ce qui a pour premier effet de porter préjudice à la compréhension de tout un chacun.


Je répète : « ce sont des facteurs sociaux qui jouent un rôle prépondérant dans le développement de l’enfant. » La place et l’usage des écrans n’est que l’un de ces facteurs sociaux parmi d’autres bien plus essentiels.

[Et puis soudain le Pew Internet Research Center]

Le 22 Avril 2025 est sortie une étude du Pew Internet Research Center, pile poil sur le sujet qui nous occupe : « Teens, Social Media and Mental Health. » Elle est, comme souvent, fondamentale pour bien cerner les enjeux de ce sujet. Et j’en retire les éléments suivants.

D’abord si environ 40% émettent un avis plutôt « neutre » sur l’influence des médias sociaux sur leur santé mentale, les 60% d’adolescents restants (entre 13 et 17 ans) indiquent clairement que les effets négatifs sur leur santé mentale l’emportent sur les effets positifs.

Ensuite là où les parents considèrent que les médias sociaux sont la première cause des problèmes de santé mentale, du côté des adolescents, c’est tout autre chose : 22% des adolescents désignent les médias sociaux, 17% d’entre elles et eux les phénomènes de harcèlement (j’ai bien dit de harcèlement et pas seulement de cyber-harcèlement), et 16% les « pressures and expectations« , c’est à dire les attentes sociales et parentales vécues comme autant de pressions. Là est l’un des noeuds centraux du problème de la santé mentale des adolescentes et adolescents.

Autre point essentiel qui rend encore plus débile toute tentative d’interdiction, plus d’un tiers (34%) des adolescentes et adolescents interrogés indiquent s’informer sur les réseaux sociaux sur les questions de santé mentale. Et parmi ceux-là, plus de la moitié indiquent que c’est une source d’information importante.

Enfin, et c’est là aussi absolument déterminant pour comprendre ce qui se joue et comment le réguler, les adolescentes et adolescents identifient clairement l’impact délétère et toxiques des médias sociaux sur leur travail et leurs études, sur leur santé mentale, sur leur productivité et sur leur sommeil mais dans le même temps ils indiquent tout aussi clairement l’impact très positif sur leurs amitiés et leurs socialisations. Constat qui rejoint en effet tous les travaux universitaires sur ce point : ces espaces numériques de socialisation sont nécessaires et précieux dans la construction des identités (et des intimités) adolescentes à l’abri du regard des adultes. En revanche rien n’oblige à ce qu’ils soient traversés de contenus ne répondant qu’à des logiques commerciales et qui n’ont de considération que pour des dynamiques de viralité garantissant à tout prix des effets de rente attentionnelle. La responsabilité d’y faire le tri et le ménage et d’y injecter la dose minimale de responsabilité déontologique au regard des publics ciblés et des enjeux sociétaux concernés incombe donc entièrement aux plateformes elles-mêmes, et c’est à la puissance publique de le leur rappeler et de les y contraindre. Quoi qu’il en coûte.


One More Thing.

J’ai ensuite demandé à ChatGPT, sur la base de ce (long) texte (celui de mes réponses à la commission), de faire une liste de 10 propositions (ou plus) concrètes dont le législateur pourrait se saisir et de reformuler ces propositions dans un format destiné à une note parlementaire ou à une présentation en commission. Je vous en livre ici le résultat.

Liste de 10 propositions pour une prochaine loi ou cadrage législatif.

[c’est ChatGPT qui parle, enfin qui écrit]

Voici une liste de dix propositions et recommandations concrètes issues du document de contribution à la commission parlementaire, que le législateur pourrait saisir pour élaborer une nouvelle loi sur le numérique et l’accès aux réseaux sociaux :

🔐 Transparence et régulation algorithmique
  1. Exiger la transparence des algorithmes sur leur dimension éditoriale : rendre publics les critères et pondérations qui déterminent l’affichage des contenus, notamment en lien avec les réactions émotionnelles (likes, colère, etc.).

  2. Obliger les plateformes à ralentir les chaînes virales : limiter les fonctionnalités favorisant la viralité (nombre de partages simultanés, forwarding de messages, etc.) pour réduire les effets de masse sur la désinformation et le harcèlement.

  3. Supprimer l’affichage public de certaines métriques (likes, vues, dislikes) pour atténuer les effets de conformité sociale et limiter les impacts délétères sur la santé mentale.

🧠 Santé publique et usage responsable
  1. Instaurer des mécanismes de contrôle d’accès efficaces pour les mineurs (vérification d’identité, seuils d’âge vérifiés comme sur Blablacar), en évitant les simples déclarations « j’ai plus de 13/18 ans ».

  2. Imposer des limites d’usage paramétrables par défaut (temps d’écran, alertes de dépassement, pause obligatoire après un temps de scroll continu) intégrées directement dans les applications.

  3. Créer une politique de santé publique numérique : reconnaître les effets psychiques négatifs des réseaux sur les plus jeunes et y répondre par des campagnes nationales et des dispositifs de prévention dans les écoles et les médias.

📚 Éducation et formation
  1. Renforcer l’éducation au numérique dès le collège : intégrer des modules spécifiques sur les algorithmes, la captation attentionnelle, les risques informationnels et les logiques économiques des plateformes.

  2. Doter chaque collège et lycée d’un(e) professeur(e) documentaliste formé(e) aux enjeux numériques et augmenter leurs heures dédiées à l’éducation aux médias.

⚖ Pouvoirs publics et contrôle
  1. Faire appliquer strictement les lois existantes (RGPD, DSA, DMA) : prévoir des sanctions réellement dissuasives en cas de non-conformité et ne pas hésiter à suspendre ou interdire temporairement des services comme cela a été fait ailleurs.

  2. Créer un droit d’accès des chercheurs publics aux corpus algorithmiques : obliger les plateformes à ouvrir des API sécurisées permettant à la recherche indépendante d’analyser les effets sociaux, psychologiques et politiques de leurs systèmes.

La note parlementaire (faite par ChatGPT).

[c’est toujours ChatGPT qui parle, enfin qui écrit]

Voici une note parlementaire structurée présentant les propositions issues du document d’Olivier Ertzscheid, à destination d’un(e) député(e) souhaitant nourrir une réflexion législative sur le numérique et les réseaux sociaux.

Objet : Propositions pour une loi sur les usages numériques et l’accès aux réseaux sociaux
Auteur : Synthèse des travaux d’Olivier Ertzscheid, Maître de conférences en Sciences de l’information
Date : [à compléter]

Contexte général

Dans un environnement où les réseaux sociaux sont devenus des médias d’“hyper-masse”, leur impact sur les comportements, la santé mentale, la circulation de l’information et la démocratie est désormais massif, continu et documenté. L’urgence n’est plus de comprendre ces effets, mais de réguler concrètement les modèles qui les produisent. Cette note propose dix axes d’action législatifs concrets.

1. Transparence algorithmique et lutte contre la manipulation attentionnelle

1.1. Transparence des logiques éditoriales des algorithmes

Obligation pour les plateformes de rendre publics les critères et pondérations influençant la hiérarchisation des contenus (types de réactions, temps de visionnage, etc.), en particulier ceux relevant de la manipulation émotionnelle.

1.2. Ralentissement des chaînes virales

Limitation par la loi des mécanismes de partage automatisés ou massifs (groupes WhatsApp, forwardings, etc.) afin de freiner les phénomènes de désinformation, de harcèlement et de polarisation.

1.3. Encadrement des métriques visibles

Obligation pour les plateformes de masquer certains compteurs (likes, vues, partages) aux utilisateurs non-créateurs pour atténuer les effets de conformité sociale et d’addiction à la reconnaissance.

2. Santé publique et encadrement de l’usage

2.1. Vérification d’âge robuste à l’inscription

Mise en œuvre d’un dispositif réel de contrôle d’âge (type pièce d’identité) pour limiter l’accès des mineurs aux plateformes sans médiation.

2.2. Limites d’usage intégrées par défaut

Imposition à toutes les applications sociales d’une fonction de régulation du temps passé : alertes, pauses obligatoires, et tableaux de bord accessibles.

2.3. Lancement d’un plan national de santé publique numérique

Campagnes publiques et programmes éducatifs pour sensibiliser aux impacts psychologiques des réseaux sociaux, en particulier chez les jeunes.

3. Éducation aux médias et renforcement scolaire

3.1. Intégration obligatoire de modules sur les logiques des plateformes

Enseignement dès le collège sur le fonctionnement des algorithmes, la captation attentionnelle et les logiques économiques des contenus.

3.2. Déploiement renforcé de professeurs documentalistes et du CLEMI

Augmentation du nombre de professeurs documentalistes et du budget alloué au CLEMI, pour assurer un accompagnement continu et de qualité dans les établissements.

4. Régulation effective et contrôle public

4.1. Application sans compromis des règlements européens (RGPD, DSA, DMA)

Sanctions systématiques et dissuasives en cas de non-respect des règles ; possibilité d’interdiction temporaire d’un service comme dans d’autres pays (ex. X/Twitter au Brésil).

4.2. Accès aux corpus pour la recherche publique

Obligation légale pour les plateformes d’ouvrir aux chercheurs indépendants l’accès à des jeux de données anonymisés, via API, afin de permettre une évaluation scientifique indépendante des effets des algorithmes.

Conclusion

Ces propositions, réalistes, urgentes et largement documentées, peuvent constituer la base d’un cadre législatif de souveraineté numérique, de protection des jeunes publics et de régulation démocratique des puissances algorithmiques.


Argumentaire synthétique pour une intervention en commission.

Tant que j’y suis je vous livre aussi l’introduction et la conclusion du même ChatGPT lorsque je lui demande un argumentaire synthétique de sa note parlementaire pour une intervention en commission.

Introduction.

Mesdames et Messieurs les membres de la commission,

Nous sommes aujourd’hui face à des outils devenus centraux dans la vie sociale, affective, cognitive de millions de citoyens, notamment les plus jeunes. Ces outils sont à la fois des médias d’hyper-masse, des machines à fabriquer la norme et des systèmes de captation attentionnelle, dont les effets sur la santé mentale, la désinformation et les inégalités sont désormais documentés.

Il ne s’agit plus de produire des rapports ou des constats, mais d’agir, de légiférer, de protéger.

Conclusion : l’exigence du courage politique.

Ce que nous proposons n’est ni technophobe, ni moraliste. C’est une politique de santé publique, d’éducation, et de souveraineté.
Il faut démonétiser l’attention, dépublicitariser l’espace social, et remettre du sens dans nos usages.

L’histoire nous jugera comme elle a jugé ceux qui n’ont rien fait face au tabac ou au réchauffement climatique. Il est encore temps d’agir.


Voilà. Le boulot est fait de mon côté. J’ai transmis à la commission mon texte avec l’intégralité de mes réponses aux questions, et leur ai également adressé les 10 propositions pour une évolution du cadrage législatif (en précisant bien sûr qu’elles étaient formulées par ChatGPT sur la base de l’analyse de mon texte). Le reste appartient maintenant à ce truc formidable qu’on appelle la démocratie.

Mourir pour des données, d’accord, mais de mort lente. Ou pourquoi pour la 1ère fois j’ai cédé à une menace de procès.

21 avril 2025 à 13:03

Suite à une mise en demeure d’avocats représentant les intérêts du cabinet dont je dénonçais les agissements dans un article, mise en demeure m’enjoignant de supprimer la totalité de cet article avant le 22 Avril, je fais le choix de m’y plier et de le retirer de la publication. Vous trouverez donc ci-dessous des éléments d’explication détaillés sur la justification de cette décision.

——————————

Voila plus de 20 ans que je tiens ce blog en mon seul nom et sous ma seule responsabilité éditoriale. Près de 3000 articles (une moyenne de douze par mois), avec beaucoup d’articles d’analyses, pas mal d’articles d’opinions, et quelques bons coups de gueule à valeur essentiellement cathartique (pour moi en tout cas).

En 20 ans je n’ai été menacé de procédure juridique qu’à 3 reprises.

La première fois c’était en 2015, lorsque j’avais diffusé le journal d’Anne Frank, dans sa version originale, à date de son entrée dans le domaine public. Les avocats du fonds Anne Frank m’avaient alors menacé d’une action en justice et d’une astreinte journalière de plusieurs milliers d’euros tant que je ne retirerai pas le texte. J’ai maintenu le texte original en ligne. D’autres, dont la députée Isabelle Attard m’ont rejoint et ont également partagé le texte. Et je n’ai plus eu de nouvelles des avocats du fonds Anne Frank.

La deuxième fois c’était en 2017 à l’occasion d’un article sur les dynamiques de haine en ligne, lorsque je revenais vers les premières dérives des campagnes Adwords avec Arnault Dassier à leur initiative lorsqu’il était responsable de la stratégie digitale de l’UMP. C’est lui qui me menaça de poursuites, ne supportant pas de voir son nom accolé à l’expression « marketing de la haine » dans mon article et considérant cela comme diffamatoire et m’enjoignant de supprimer son nom de l’article. Résultat : je vous laisse juges de ce qu’il advînt dans la mise à jour au début de l’article.

Et la troisième fois c’est donc cette semaine d’Avril 2025. Et c’est un cabinet « d’expertise technologique, normative et réglementaire dans les domaines de la confiance numérique et de la cyber sécurité » qui, via un cabinet d’avocats, menace de me poursuivre en justice pour diffamation, injure publique, et violation du secret des correspondances. Au regard des critères éclairés de Maître Eolas, même si je suis totalement serein sur le fond de l’affaire, la forme du courrier du cabinet d’avocat ne laisse que peu de doute sur leur détermination de réellement me poursuivre si je ne retire pas l’article en question.

Pour rappel, ce « cabinet d’expertise technologique, normative et réglementaire dans les domaines de la confiance numérique et de la cyber sécurité » a contacté l’association étudiante dont je m’occupe (la Ma’Yonnaise épicerie) et qui organise des distributions alimentaires pour les étudiant.e.s sur le campus de Nantes Université à La Roche-sur-Yon, pour nous proposer un scénario dans lequel nos bénéficiaires (donc des étudiant.e.s précaires) pourraient, contre rétribution versée à l’association, vendre leurs données biométriques à ce cabinet.

S’ensuivit un échange entre moi (depuis la boite mail de l’épicerie solidaire) et le cabinet en question. Echange auquel j’ai rapidement mis fin considérant l’activité de ce cabinet plus que suspecte sur le fond, totalement déplacée sur la forme, et considérant qu’accessoirement en droit français, la vente de données biométriques contre rémunération (a fortiori pour des populations précaires) ne peut et ne doit devenir ni un marché ni un horizon.

Je prends donc la décision de raconter toute cette affaire dans un article sur ce blog sous le titre « Etudiants en situation de précarité ? Vendez-nous vos données. De la biométrie et des cabinets vautour qui tournent autour. » J’y cite les échanges (non nominatifs bien sûr) avec mes deux interlocuteurs de ce cabinet (voilà pour la violation du secret des correspondances). Echanges qui, je le rappelle, ont démarré avec la proposition suivante :

« Nous recherchons actuellement des volontaires pour participer à un test simple et rapide (sic). Celui-ci consiste à s’inscrire sur une plateforme, puis à enregistrer une série de courtes vidéos du visage sous différents angles. En contrepartie, nous proposons de reverser un don de 15 € par participant ayant validé le test. Par exemple, pour 50 participants, votre association recevra un don de 750 €. Nous espérons que cette collaboration pourrait constituer une ressource financière supplémentaire pour soutenir vos activités et projets. »


J’agis et réagis avec ma casquette de responsable de l’association et surtout, surtout, avec ma casquette d’universitaire dont l’un des axes et terrains de recherche est précisément la question de notre vie privée numérique et les questions liées à l’exploitation de nos données personnelles.

Le ton est vif et j’assimile à plusieurs reprises les pratiques de ce cabinet à des pratiques de crapules et de vautours (voilà pour la diffamation et l’injure publique).

Et cette semaine, une dizaine de jours après la parution de mon article, je reçois le courrier suivant avec mise en demeure de retirer totalement l’article incriminé dans un délai de 5 jours (avant le 22 Avril).


Je joins ici le fichier pdf pour une lecture plus facile : 2025 04 15_ mise-en-demeure.pdf

L’intimidation et la tentative de procédure bâillon se caractérisent aussi par le fait de mettre en copie de ce courrier la présidente de Nantes Université au motif que, je cite « l’ensemble de ces propos a été tenu en votre qualité de Maitre de conférences de l’Université de Nantes« . Ce qui est faux (je me suis toujours exprimé au titre exclusif de co-responsable de l’association qui organise ces distributions alimentaires), et ce qui est aussi une vision assez trouble de ce que l’on nomme la liberté académique.

Si j’avais agi uniquement en mon nom propre ou au titre de Maître de conférences de l’université de Nantes, j’aurais, sans aucun souci ni autre questionnement, laissé l’article incriminé en ligne et attendu sereinement la suite en proposant simplement un droit de réponse au cabinet concerné. Je n’ai me concernant, absolument aucune crainte. Je n’ai pas cédé aux avocats du fonds Anne Frank dans une affaire où les enjeux se chiffraient en millions d’euros (le journal d’Anne Frank est l’un des livres les plus vendus de tous les temps et continue de l’être) et concernaient, en termes de droit d’auteur et de domaine public, l’ensemble des lois et règlementations internationales. Donc cette forme de menace et de procédure bâillon ne m’impressionne pas (même s’il n’est jamais agréable de recevoir un tel courrier).

Mon absence de crainte est d’autant plus forte qu’une nouvelle fois, sur le fond, je suis absolument certain de mon bon droit et du fait que ce « cabinet d’expertise technologique, normative et réglementaire » fait absolument n’importe quoi et que ce n’importe quoi cible et met en danger des populations précaires dans une forme d’intime matérialisée par la transaction commerciale proposée autour de données biométriques sans que jamais et à aucun moment ne soient indiqués les cadres d’usages, d’exploitation, de durée, etc. Pour rappel le seul cadre indiqué dans la sollicitation de ce cabinet était « Nous recherchons actuellement des volontaires pour participer à un test simple et rapide (sic). Celui-ci consiste à s’inscrire sur une plateforme, puis à enregistrer une série de courtes vidéos du visage sous différents angles. » 

Alors pourquoi obéir à l’injonction et à cette forme de procédure bâillon ? Parce que dans cette affaire, si elle se porte jusqu’à un tribunal, je ne veux qu’en aucune manière l’association dont je m’occupe puisse être impactée financièrement, moralement, ou même symboliquement en voyant son nom associé à une procédure en justice. Et si cela devait tout de même se produire, la responsabilité en incomberait donc uniquement à ce cabinet puisqu’en effet et selon les termes de leurs avocats, ce retrait n’engage pas nécessairement la fin de la procédure de leur côté. Je les en laisse désormais juges et continue d’espérer désormais au moins trois choses.

Premièrement que des journalistes et des associations de défense des libertés numériques se saisiront de ces éléments et iront enquêter sur ces pratiques, celles de ce cabinet en particulier mais aussi celles d’autres probablement semblables.

Deuxièmement que si d’autres associations ont reçu de telles sollicitations, elle n’hésitent pas à me contacter ou à rendre publics ces éléments.

J’espère, troisièmement, que les autorités indépendantes que sont la CNIL et l’ANSSI, jusqu’ici silencieuses, se saisiront des éléments de ce dossier pour faire toute la lumière sur les pratiques de ces cabinets dans le domaine de la sollicitation de vente de données biométriques auprès de populations précaires, d’autant que lesdits cabinets se prévalent d’autorisations de leur part.

J’espère enfin, que cette « petite histoire », aura pour intérêt de rappeler dans le débat public que ce genre de dérives déjà largement présentes ailleurs dans le monde, sont et seront, en France, de plus en plus essentielles à documenter et à combattre. Je vous en parlais déjà via la chasse aux corps des plus pauvres à des fins d’exploitation biométrique, au moment où déjà près de cinq millions de personnes (dont un million d’argentins) ont malheureusement accepté pour atténuer un peu leur misère. Et cette semaine encore, les alertes de cette dépêche AFP ou cette chronique d’un monde connecté sur France Culture, devraient nous mobiliser toutes et tous car le futur qu’elles dessinent est au-delà de l’alarmant sur le plan sociétal comme sur le plan politique (je rappelle par exemple que ce cabinet qui me menace d’un procès indique sur son site intervenir notamment dans des « Systèmes de gestion de contrôle aux frontières (Gates, entry-exit). »

Pour le dire d’une phrase : ce dont nous devons absolument parler et ce que nous devons absolument combattre c’est un capitalisme de malfrats avec la marchandisation des données biométriques des plus précaires comme poste avancé.

Parce que tous ces êtres humains, toutes ces populations, le plus souvent précaires, que l’on dévisage en leur jetant l’aumône, ne nous laissent collectivement envisager aucun futur désirable.


❌