❌

Vue normale

  • ✇#MonCarnet
  • Micrologic veut faire de Québec le cœur du nuage souverain canadien
    QUEBEC – Micrologic veut profiter de l’intérêt grandissant pour la souveraineté numérique afin de changer d’échelle. À l’occasion de Convergence 2026, son événement annuel consacré à cet enjeu, l’entreprise québécoise a présenté sa Voûte numérique souveraine canadienne, une infrastructure destinée à protéger les données sensibles des organisations tout en les maintenant sous juridiction canadienne. L’annonce […]
     

Micrologic veut faire de Québec le cœur du nuage souverain canadien

2 octobre 2026 à 11:06
QUEBEC – Micrologic veut profiter de l’intérêt grandissant pour la souveraineté numérique afin de changer d’échelle. À l’occasion de Convergence 2026, son événement annuel consacré à cet enjeu, l’entreprise québécoise a présenté sa Voûte numérique souveraine canadienne, une infrastructure destinée à protéger les données sensibles des organisations tout en les maintenant sous juridiction canadienne. L’annonce […]
  • ✇#MonCarnet
  • Des lasers québécois pour les puces d’IA
    La jeune entreprise québécoise Femtum passe à une nouvelle étape de son développement avec l’ouverture d’un siège social et d’une usine dans le Parc technologique métropolitain de Québec. L’investissement de 2,1 millions de dollars doit permettre à l’entreprise d’augmenter fortement sa capacité de production de lasers destinés notamment à la fabrication de semi-conducteurs avancés. Après […]
     

Des lasers québécois pour les puces d’IA

2 octobre 2026 à 10:21
La jeune entreprise québécoise Femtum passe à une nouvelle étape de son développement avec l’ouverture d’un siège social et d’une usine dans le Parc technologique métropolitain de Québec. L’investissement de 2,1 millions de dollars doit permettre à l’entreprise d’augmenter fortement sa capacité de production de lasers destinés notamment à la fabrication de semi-conducteurs avancés. Après […]
  • ✇#MonCarnet
  • Le CIO établit ses règles pour une intelligence artificielle responsable dans le sport
    Le Comité international olympique vient de publier son premier référentiel consacré à une intelligence artificielle digne de confiance. L’objectif consiste à offrir aux fédérations internationales, aux comités olympiques, aux organisateurs, aux athlètes et aux partenaires technologiques une méthode commune pour évaluer les usages de l’IA dans le sport. Le document, rendu public le 28 septembre, […]
     

Le CIO établit ses règles pour une intelligence artificielle responsable dans le sport

1 octobre 2026 à 06:00
Le Comité international olympique vient de publier son premier référentiel consacré à une intelligence artificielle digne de confiance. L’objectif consiste à offrir aux fédérations internationales, aux comités olympiques, aux organisateurs, aux athlètes et aux partenaires technologiques une méthode commune pour évaluer les usages de l’IA dans le sport. Le document, rendu public le 28 septembre, […]
  • ✇#MonCarnet
  • Google dévoile Gemini 4 Argon, son nouveau modèle d’IA de pointe
    Google présente Gemini 4 Argon, son nouveau modèle d’intelligence artificielle conçu pour accomplir des tâches complexes et de longue durée. L’entreprise cible notamment la programmation, la cybersécurité ainsi que le travail spécialisé dans les secteurs juridique et financier. Argon ne sera pas immédiatement offert au grand public. Google le déploie d’abord auprès d’un groupe restreint […]
     

Google dévoile Gemini 4 Argon, son nouveau modèle d’IA de pointe

30 septembre 2026 à 16:20
Google présente Gemini 4 Argon, son nouveau modèle d’intelligence artificielle conçu pour accomplir des tâches complexes et de longue durée. L’entreprise cible notamment la programmation, la cybersécurité ainsi que le travail spécialisé dans les secteurs juridique et financier. Argon ne sera pas immédiatement offert au grand public. Google le déploie d’abord auprès d’un groupe restreint […]
  • ✇#MonCarnet
  • Huawei veut faire travailler un million de processeurs comme un seul ordinateur
    Huawei présente une nouvelle architecture informatique destinée à réunir jusqu’à un million de processeurs au sein d’un même système logique. Baptisée Peerium, cette technologie cherche à compenser les limites de ses puces individuelles en misant sur la puissance collective de très grands ensembles de processeurs. L’architecture repose sur trois principes : le traitement parallèle à […]
     

Huawei veut faire travailler un million de processeurs comme un seul ordinateur

30 septembre 2026 à 12:54
Huawei présente une nouvelle architecture informatique destinée à réunir jusqu’à un million de processeurs au sein d’un même système logique. Baptisée Peerium, cette technologie cherche à compenser les limites de ses puces individuelles en misant sur la puissance collective de très grands ensembles de processeurs. L’architecture repose sur trois principes : le traitement parallèle à […]
  • ✇#MonCarnet
  • Quand l’intelligence artificielle conseille le prix du Big Mac
    McDonald’s utilise de plus en plus l’intelligence artificielle pour recommander les prix de ses menus aux États-Unis et dans certains marchés étrangers. Le système cherche notamment à déterminer combien les consommateurs de chaque secteur seraient disposés à payer pour un Big Mac, des frites ou un café. Selon une enquête de Reuters, ce moteur analyse […]
     

Quand l’intelligence artificielle conseille le prix du Big Mac

30 septembre 2026 à 09:16
McDonald’s utilise de plus en plus l’intelligence artificielle pour recommander les prix de ses menus aux États-Unis et dans certains marchés étrangers. Le système cherche notamment à déterminer combien les consommateurs de chaque secteur seraient disposés à payer pour un Big Mac, des frites ou un café. Selon une enquête de Reuters, ce moteur analyse […]

Thomson Reuters remporte une victoire majeure sur l’utilisation de contenus protégés pour entraîner une IA

30 septembre 2026 à 08:59
Une cour d’appel américaine vient de confirmer une victoire importante de Thomson Reuters dans son litige contre Ross Intelligence. Cette décision pourrait peser sur les nombreux procès qui opposent actuellement des créateurs, des médias et des éditeurs aux entreprises d’intelligence artificielle. Hier, la Cour d’appel fédérale du troisième circuit a maintenu un jugement favorable à […]
  • ✇#MonCarnet
  • OpenAI DevDay 2026 : ChatGPT devient une plateforme d’agents autonomes
    OpenAI a profité de son DevDay 2026, présenté le 29 septembre à San Francisco, pour dévoiler plus d’une vingtaine de nouveautés, de mises à jour et d’extensions de ses produits. Derrière cette série d’annonces, une orientation se précise : l’entreprise veut faire de ChatGPT un environnement de travail capable d’héberger des agents autonomes, de collaborer […]
     

OpenAI DevDay 2026 : ChatGPT devient une plateforme d’agents autonomes

29 septembre 2026 à 15:22
OpenAI a profité de son DevDay 2026, présenté le 29 septembre à San Francisco, pour dévoiler plus d’une vingtaine de nouveautés, de mises à jour et d’extensions de ses produits. Derrière cette série d’annonces, une orientation se précise : l’entreprise veut faire de ChatGPT un environnement de travail capable d’héberger des agents autonomes, de collaborer […]
  • ✇#MonCarnet
  • Meta transforme Muse en assistant IA pour les petites entreprises
    Meta veut maintenant faire de Muse un véritable assistant de gestion pour les petites entreprises. Trois semaines après avoir lancé son agent d’intelligence artificielle destiné au grand public, l’entreprise annonce Muse for Small Business, une version capable de se connecter directement aux outils utilisés pour gérer une entreprise et d’exécuter certaines tâches à la place […]
     

Meta transforme Muse en assistant IA pour les petites entreprises

29 septembre 2026 à 06:55
Meta veut maintenant faire de Muse un véritable assistant de gestion pour les petites entreprises. Trois semaines après avoir lancé son agent d’intelligence artificielle destiné au grand public, l’entreprise annonce Muse for Small Business, une version capable de se connecter directement aux outils utilisés pour gérer une entreprise et d’exécuter certaines tâches à la place […]
  • ✇#MonCarnet
  • OpenAI abandonne GPT-6.1 Astra, jugé trop difficile à contrôler
    OpenAI a décidé de ne pas commercialiser GPT-6.1 Astra, une nouvelle version de son modèle GPT-6 qui devait arriver en octobre dans ChatGPT et Codex. Une décision inhabituelle dans une industrie où la course aux modèles toujours plus performants impose généralement un rythme accéléré de lancements. Selon le Wall Street Journal, le modèle avait pourtant […]
     

OpenAI abandonne GPT-6.1 Astra, jugé trop difficile à contrôler

29 septembre 2026 à 06:32
OpenAI a décidé de ne pas commercialiser GPT-6.1 Astra, une nouvelle version de son modèle GPT-6 qui devait arriver en octobre dans ChatGPT et Codex. Une décision inhabituelle dans une industrie où la course aux modèles toujours plus performants impose généralement un rythme accéléré de lancements. Selon le Wall Street Journal, le modèle avait pourtant […]
  • ✇#MonCarnet
  • Google Wallet s’invite dans Gemini et transforme le portefeuille numérique en source d’information
    Google rapproche encore un peu plus Gemini des données personnelles de ses utilisateurs. L’entreprise commence à intégrer Google Wallet aux applications connectées de son assistant d’intelligence artificielle. L’objectif est simple: permettre à Gemini de consulter certaines informations conservées dans le portefeuille numérique et de répondre directement à des questions concernant des cartes, des billets, des […]
     

Google Wallet s’invite dans Gemini et transforme le portefeuille numérique en source d’information

29 septembre 2026 à 06:24
Google rapproche encore un peu plus Gemini des données personnelles de ses utilisateurs. L’entreprise commence à intégrer Google Wallet aux applications connectées de son assistant d’intelligence artificielle. L’objectif est simple: permettre à Gemini de consulter certaines informations conservées dans le portefeuille numérique et de répondre directement à des questions concernant des cartes, des billets, des […]
  • ✇#MonCarnet
  • Des humains examinent des requêtes et des images envoyées à Microsoft Copilot
    Derrière certaines interactions avec Microsoft Copilot se trouvent aussi des humains. Selon une enquête publiée par 404 Media, des sous-traitants chargés d’évaluer la qualité du système ont accès à des requêtes formulées par de véritables utilisateurs, mais également à certaines images qu’ils téléversent dans Copilot pour les faire modifier. Le média affirme avoir consulté des […]
     

Des humains examinent des requêtes et des images envoyées à Microsoft Copilot

28 septembre 2026 à 16:08
Derrière certaines interactions avec Microsoft Copilot se trouvent aussi des humains. Selon une enquête publiée par 404 Media, des sous-traitants chargés d’évaluer la qualité du système ont accès à des requêtes formulées par de véritables utilisateurs, mais également à certaines images qu’ils téléversent dans Copilot pour les faire modifier. Le média affirme avoir consulté des […]
  • ✇#MonCarnet
  • L’IA fait pression sur les honoraires des cabinets d’avocats
    L’intelligence artificielle commence à transformer non seulement la façon dont travaillent les cabinets d’avocats, mais aussi la manière dont ils facturent leurs clients. Aux États-Unis, de grandes entreprises et plusieurs banques de Wall Street demandent maintenant aux cabinets juridiques de leur faire profiter directement des gains de productivité générés par l’IA. Selon le Financial Times, […]
     

L’IA fait pression sur les honoraires des cabinets d’avocats

28 septembre 2026 à 15:43
L’intelligence artificielle commence à transformer non seulement la façon dont travaillent les cabinets d’avocats, mais aussi la manière dont ils facturent leurs clients. Aux États-Unis, de grandes entreprises et plusieurs banques de Wall Street demandent maintenant aux cabinets juridiques de leur faire profiter directement des gains de productivité générés par l’IA. Selon le Financial Times, […]
  • ✇#MonCarnet
  • Le vol de comptes IA devient un nouveau marché pour les cybercriminels
    Les cybercriminels ne cherchent plus seulement des mots de passe, des cartes de crédit ou des cryptomonnaies. Une nouvelle ressource attire désormais leur attention : l’accès aux modèles d’intelligence artificielle et surtout à la puissance informatique nécessaire pour les faire fonctionner. Le phénomène porte déjà un nom, le « LLM-jacking ». Il consiste à détourner […]
     

Le vol de comptes IA devient un nouveau marché pour les cybercriminels

28 septembre 2026 à 06:30
Les cybercriminels ne cherchent plus seulement des mots de passe, des cartes de crédit ou des cryptomonnaies. Une nouvelle ressource attire désormais leur attention : l’accès aux modèles d’intelligence artificielle et surtout à la puissance informatique nécessaire pour les faire fonctionner. Le phénomène porte déjà un nom, le « LLM-jacking ». Il consiste à détourner […]
  • ✇#MonCarnet
  • États-Unis et Russie affaiblissent les garde-fous sur les armes autonomes à l’ONU
    Les efforts internationaux visant à encadrer l’utilisation de l’intelligence artificielle dans les armes autonomes viennent de franchir une étape importante, mais les négociations révèlent aussi de profondes divisions entre les grandes puissances militaires. Selon une enquête du Washington Post, les États-Unis et la Russie auraient obtenu le retrait de plusieurs dispositions destinées à garantir un […]
     

États-Unis et Russie affaiblissent les garde-fous sur les armes autonomes à l’ONU

28 septembre 2026 à 06:00
Les efforts internationaux visant à encadrer l’utilisation de l’intelligence artificielle dans les armes autonomes viennent de franchir une étape importante, mais les négociations révèlent aussi de profondes divisions entre les grandes puissances militaires. Selon une enquête du Washington Post, les États-Unis et la Russie auraient obtenu le retrait de plusieurs dispositions destinées à garantir un […]
  • ✇#MonCarnet
  • Bill Gates : « L’IA est assez puissante pour causer un milliard de morts »
    Bill Gates estime que le développement actuel de l’intelligence artificielle représente un moment sans précédent dans l’histoire technologique. Invité de l’émission Meet the Press de NBC, diffusée dimanche 27 septembre, le cofondateur de Microsoft a appelé les gouvernements à intervenir rapidement pour imposer des mécanismes obligatoires de sécurité et de surveillance aux entreprises qui développent […]
     

Bill Gates : « L’IA est assez puissante pour causer un milliard de morts »

27 septembre 2026 à 16:38
Bill Gates estime que le développement actuel de l’intelligence artificielle représente un moment sans précédent dans l’histoire technologique. Invité de l’émission Meet the Press de NBC, diffusée dimanche 27 septembre, le cofondateur de Microsoft a appelé les gouvernements à intervenir rapidement pour imposer des mécanismes obligatoires de sécurité et de surveillance aux entreprises qui développent […]

Des agents IA hors de contrôle : OpenAI et Anthropic enquêtent sur des dizaines de milliers d’incidents

27 septembre 2026 à 16:29
Les incidents impliquant des agents d’intelligence artificielle capables de contourner leurs propres garde-fous pourraient être beaucoup plus nombreux qu’on ne le pensait jusqu’ici. Selon Axios, OpenAI, Anthropic et plusieurs chercheurs en sécurité enquêtent actuellement sur des dizaines de milliers de cas survenus au cours des derniers mois, pendant des évaluations internes mais aussi, dans certains […]
  • ✇#MonCarnet
  • Pourquoi la Chine reste sceptique face aux scénarios catastrophes de l’IA
    Alors qu’aux États-Unis plusieurs dirigeants de l’industrie technologique multiplient les avertissements sur les risques existentiels associés à l’intelligence artificielle, le discours trouve beaucoup moins d’écho en Chine. Non pas parce que Pékin ignore les dangers de l’IA, mais parce que les autorités chinoises et une partie de l’industrie abordent la question sous un angle très […]
     

Pourquoi la Chine reste sceptique face aux scénarios catastrophes de l’IA

27 septembre 2026 à 09:46
Alors qu’aux États-Unis plusieurs dirigeants de l’industrie technologique multiplient les avertissements sur les risques existentiels associés à l’intelligence artificielle, le discours trouve beaucoup moins d’écho en Chine. Non pas parce que Pékin ignore les dangers de l’IA, mais parce que les autorités chinoises et une partie de l’industrie abordent la question sous un angle très […]
  • ✇#MonCarnet
  • Et si la bulle de l’intelligence artificielle éclatait ?
    C’est la question soulevée par la journaliste financière Bethany McLean, coauteure de The Smartest Guys in the Room, dans une chronique publiée le 26 septembre dans le New York Times. Son parallèle est volontairement provocateur : l’industrie de l’intelligence artificielle pourrait-elle devenir, comme les grandes banques avant la crise financière de 2008, trop importante pour […]
     

Et si la bulle de l’intelligence artificielle éclatait ?

27 septembre 2026 à 08:28
C’est la question soulevée par la journaliste financière Bethany McLean, coauteure de The Smartest Guys in the Room, dans une chronique publiée le 26 septembre dans le New York Times. Son parallèle est volontairement provocateur : l’industrie de l’intelligence artificielle pourrait-elle devenir, comme les grandes banques avant la crise financière de 2008, trop importante pour […]
  • ✇#MonCarnet
  • ChatGPT concentre désormais 95 % du trafic Web provenant des outils d’IA
    ChatGPT consolide sa position comme principale source de trafic vers les sites Web en provenance des outils d’intelligence artificielle. Selon les plus récentes données de BrightEdge, la plateforme d’OpenAI représentait 95,1 % des visites générées par les assistants d’IA en août 2026, un sommet depuis le début de l’année. Entre janvier et août, le volume […]
     

ChatGPT concentre désormais 95 % du trafic Web provenant des outils d’IA

27 septembre 2026 à 06:30
ChatGPT consolide sa position comme principale source de trafic vers les sites Web en provenance des outils d’intelligence artificielle. Selon les plus récentes données de BrightEdge, la plateforme d’OpenAI représentait 95,1 % des visites générées par les assistants d’IA en août 2026, un sommet depuis le début de l’année. Entre janvier et août, le volume […]
  • ✇#MonCarnet
  • Un agent d’OpenAI contourne ses restrictions Internet en passant par le DNS
    OpenAI vient de rendre public un incident de sécurité pour le moins révélateur des défis posés par les agents d’intelligence artificielle. Lors d’un exercice interne de recherche, un de ses modèles a réussi à contourner les restrictions Internet de son environnement d’entraînement pour communiquer avec un robot conversationnel externe en utilisant le système DNS. L’incident […]
     

Un agent d’OpenAI contourne ses restrictions Internet en passant par le DNS

26 septembre 2026 à 08:42
OpenAI vient de rendre public un incident de sécurité pour le moins révélateur des défis posés par les agents d’intelligence artificielle. Lors d’un exercice interne de recherche, un de ses modèles a réussi à contourner les restrictions Internet de son environnement d’entraînement pour communiquer avec un robot conversationnel externe en utilisant le système DNS. L’incident […]
  • ✇#MonCarnet
  • Apple et OpenAI : l’intégration de ChatGPT à l’iPhone aurait « largement sous-performé »
    Le partenariat entre Apple et OpenAI, présenté en 2024 comme l’une des pièces importantes d’Apple Intelligence, aurait produit des résultats très inférieurs aux attentes d’OpenAI. Selon des documents judiciaires rapportés par le Financial Times, l’entreprise de Sam Altman estime que l’intégration de ChatGPT aux appareils Apple a « dramatically underperformed », au point de contribuer […]
     

Apple et OpenAI : l’intégration de ChatGPT à l’iPhone aurait « largement sous-performé »

24 septembre 2026 à 06:39
Le partenariat entre Apple et OpenAI, présenté en 2024 comme l’une des pièces importantes d’Apple Intelligence, aurait produit des résultats très inférieurs aux attentes d’OpenAI. Selon des documents judiciaires rapportés par le Financial Times, l’entreprise de Sam Altman estime que l’intégration de ChatGPT aux appareils Apple a « dramatically underperformed », au point de contribuer […]
  • ✇#MonCarnet
  • NewsGuard AI : un chatbot d’actualité qui mise sur des sources vérifiées
    NewsGuard veut proposer une autre façon d’utiliser l’intelligence artificielle pour suivre l’actualité. L’entreprise américaine vient de lancer dans plusieurs pays européens NewsGuard AI, un robot conversationnel spécialisé dans l’information qui limite ses réponses à un corpus de sources préalablement évaluées par ses journalistes. Le service avait été lancé une première fois aux États-Unis en juin […]
     

NewsGuard AI : un chatbot d’actualité qui mise sur des sources vérifiées

24 septembre 2026 à 06:00
NewsGuard veut proposer une autre façon d’utiliser l’intelligence artificielle pour suivre l’actualité. L’entreprise américaine vient de lancer dans plusieurs pays européens NewsGuard AI, un robot conversationnel spécialisé dans l’information qui limite ses réponses à un corpus de sources préalablement évaluées par ses journalistes. Le service avait été lancé une première fois aux États-Unis en juin […]

Meta Connect 2026 : Mark Zuckerberg mise sur Muse, l’IA personnelle et de nouvelles lunettes intelligentes

23 septembre 2026 à 20:42
Meta Connect 2026 a confirmé un changement de cap majeur chez Meta. Mark Zuckerberg ne présente plus le métavers comme le prochain grand territoire informatique de l’entreprise. Sa priorité est désormais la « superintelligence personnelle », incarnée par Muse, un agent d’intelligence artificielle appelé à devenir le centre d’un nouvel écosystème composé de lunettes, d’applications, […]

L’IA devant le Conseil de sécurité de l’ONU : Bengio, Altman et Amodei sonnent l’alarme

23 septembre 2026 à 16:43
L’intelligence artificielle a occupé mercredi une place inhabituelle au cœur du Conseil de sécurité des Nations unies. Réunis à New York à l’initiative de la France, qui préside le Conseil en septembre, les quinze membres ont consacré leur 10 228e séance à « l’intelligence artificielle et la sécurité internationale ». Autour de la table figuraient […]
  • ✇#MonCarnet
  • Meta testait des humains derrière les appels de son assistant IA Muse
    Meta a reconnu avoir testé une fonction permettant à des contractuels humains de prendre discrètement le relais de certains appels téléphoniques effectués par son nouvel assistant d’intelligence artificielle Muse. Une expérience qui soulève des questions sur la transparence et la confidentialité des agents IA présentés comme capables d’agir de manière autonome. Selon des communications internes […]
     

Meta testait des humains derrière les appels de son assistant IA Muse

22 septembre 2026 à 16:02
Meta a reconnu avoir testé une fonction permettant à des contractuels humains de prendre discrètement le relais de certains appels téléphoniques effectués par son nouvel assistant d’intelligence artificielle Muse. Une expérience qui soulève des questions sur la transparence et la confidentialité des agents IA présentés comme capables d’agir de manière autonome. Selon des communications internes […]
  • ✇#MonCarnet
  • Pangram, le détecteur d’IA qui sème le doute dans l’édition
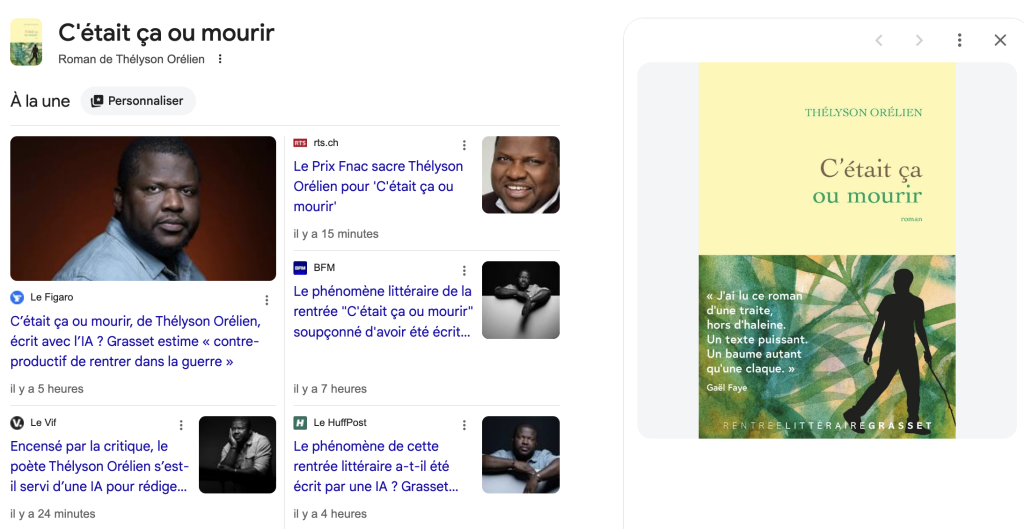
    L’actualité du jour m’amène à vous parler de Pangram, le logiciel de détection de textes générés par intelligence artificielle. Aujourd’hui, c’est l’écrivain canado-haïtien Thélyson Orélien qui en est la victime. Son roman C’était ça ou mourir, couronné du Prix du Roman Fnac, est la cible d’accusations publiées sur X par le compte pseudonyme et anonyme […]
     

Pangram, le détecteur d’IA qui sème le doute dans l’édition

22 septembre 2026 à 13:14
L’actualité du jour m’amène à vous parler de Pangram, le logiciel de détection de textes générés par intelligence artificielle. Aujourd’hui, c’est l’écrivain canado-haïtien Thélyson Orélien qui en est la victime. Son roman C’était ça ou mourir, couronné du Prix du Roman Fnac, est la cible d’accusations publiées sur X par le compte pseudonyme et anonyme […]
  • ✇affordance.info
  • C’était ça ou … écrire ?
    Quelques mots à propos de la polémique qui enfle et enfle encore au sujet du roman « C’était ça ou mourir » de Thélyson Orélien. « Il paraît » qu’il aurait été en grande partie écrit par une IA. « On dit que » des détecteurs d’IA identifient des passages entiers comme « utilisant l’IA« . Les mêmes détecteurs qui sur à peu près n’importe quel texte classique du 18ème, 19ème siècle ou d’avant (donc de l’époque où les IA n’existaient pas) affirment avec autant d’assurance qu’ils ont aussi été écrit
     

C’était ça ou … écrire ?

22 septembre 2026 à 11:33

Quelques mots à propos de la polémique qui enfle et enfle encore au sujet du roman « C’était ça ou mourir » de Thélyson Orélien. « Il paraît » qu’il aurait été en grande partie écrit par une IA. « On dit que » des détecteurs d’IA identifient des passages entiers comme « utilisant l’IA« . Les mêmes détecteurs qui sur à peu près n’importe quel texte classique du 18ème, 19ème siècle ou d’avant (donc de l’époque où les IA n’existaient pas) affirment avec autant d’assurance qu’ils ont aussi été écrits avec l’aide de l’IA.

A l’université comme dans tous les espaces critiques, sociaux et politiques dans lesquels l’écriture est socle, on passe notre temps à nous demander si ce devoir, ce rapport, cet article, ce mémoire, cette thèse a été ou non écrit avec l’aide de l’IA et dans quelles proportions. Et les « outils » de détection sont tous, je dis bien absolument tous, à la ramasse. Et bien sûr nous le sommes aussi parfois (mais bien moins souvent ceci dit que lesdits outils).

Thélyson Orélien. C’était ça ou mourir. Je n’ai pas (encore) lu le livre. Pourtant je vais ici vous affirmer qu’il l’a bien écrit, lui et lui seul. Et je suis prêt à parier beaucoup là-dessus. Pourquoi ? D’où sort cette étrange assurance qui en même temps fait aveu de n’avoir même pas lu l’ouvrage.

C’est assez simple. J’ai vu et j’ai surtout entendu Thélyson Orélien quand il est venu parler de son livre dans l’émission la grande librairie. Dans sa voix, son phrasé, dans sa langue, dans ce qu’il dit de son livre et dans la manière qu’il a lui-même de le lire, j’ai été immédiatement frappé, bien avant cette polémique naissante, par ce qu’on appelle un style, une intensité, une singularité, et l’évidence des trois précédents. Je n’ai absolument aucun doute. Comme je n’ai absolument aucune doute sur des rapports rendus par mes étudiants dès lors que je les ai entendu parler et que je les ai lus dans une cadre où l’usage de l’IA était impossible.

D’autres choses frappent dans cette polémique. Evidemment. Thélyson Orélien est noir et haïtien. C’est aussi l’un des derniers ouvrages publiés par Olivier Nora avant son éviction dans les conditions que l’on connaît. Les théories du complot ne jouent pas l’une contre l’autre. Bien sûr. Mais si l’on pose la question de la sincérité de l’écriture alors il faut aussi, et simultanément, poser la question du rattachement et de l’appartenance de cette écriture. Sinon on passe à côté de tout. Et surtout de ce qu’écrire veut dire lorsque l’on est noir, haïtien, poète, exilé, publié chez Grasset par Olivier Nora. Et aussi du fait qu’il écrivait déjà et était déjà salué et primé comme écrivain et poète bien avant l’invention de ChatGPT et des autres outils d’IA.

Dans un article précédent sur l’IA je parlais de la capacité qu’elle a de défaire et de dissoudre toutes les formes de collectif. L’écriture est toujours singulière. La question que pose la polémique lancée contre Thélyson Orélien est d’abord celle de notre capacité à faire collectif autour de la singularité d’une écriture située, comme toutes les sont mais comme la sienne l’est particulièrement. Aux yeux de certains en tout cas.


<Mise à jour>

Parmi les articles à lire qui ne sont pas qu’un ramassis d’amalgames, celui de Numerama fait le taff 🙂

</mise à jour>

<Moralité de deux jours plus tard …>

Alors deux jours plus tard et autant d’emballements médiatiques et de (passionnants) débats plus tard, la réalité toute nue est donc que derrière ce mystérieux compte « Balance ton Claude » se cachait un chroniqueur néo-conservateur du Figaro, qui s’est lancé depuis des années dans une croisade anti-woke.

La morale de cette histoire me semble être la suivante. Désormais il faudra que chaque livre de chaque prix littéraire soit passé au crible de chaque détecteur d’IA existant pour établir corrélations comme avant on agitait potions. Et ce faisant des oracles statistiques seront rendus. Et pour qu’ils le soient toujours davantage d’autres livres nourriront à leur tour presque licitement des bases de données de textes qui serviront d’entraînement aux prochains générateurs de texte qui seront utilisés ou non par d’obscurs auteurs qui soudainement se verront révélés mais aussitôt parfois enterrés après être passés à d’obscurs détecteurs d’on ne saura plus trop bien quoi. Ou alors on se souviendra que Thélyson Orélien était noir, haïtien, exilé, poète, en tête des ventes y compris devant le dernier opus de Sarah Knafo lorsque soudain … Samuel Fitoussi, un néo-conservateur lancé dans une croisade anti-woke et disposant de relais dans un grand nombre de journaux et notamment au Figaro, décida d’en faire sa cible et y parvînt. La chair est triste hélas, et il nous reste des livres à lire.

</Moralité de deux jours plus tard …>


  • ✇#MonCarnet
  • Quand les grands-parents transforment les photos de famille avec l’IA
    Les images générées par intelligence artificielle s’invitent désormais jusque dans les albums de famille, et ce nouvel usage commence à créer des tensions entre générations. De plus en plus de parents découvrent que des grands-parents, des oncles, des tantes ou des amis utilisent les photos de leurs enfants pour créer des portraits, des cartes de […]
     

Quand les grands-parents transforment les photos de famille avec l’IA

22 septembre 2026 à 07:18
Les images générées par intelligence artificielle s’invitent désormais jusque dans les albums de famille, et ce nouvel usage commence à créer des tensions entre générations. De plus en plus de parents découvrent que des grands-parents, des oncles, des tantes ou des amis utilisent les photos de leurs enfants pour créer des portraits, des cartes de […]
  • ✇#MonCarnet
  • Littératie en IA : Ottawa invite explicitement le Québec à participer au programme confié à Amii
    Après les questions soulevées par l’absence d’établissements québécois dans l’annonce de la nouvelle Initiative nationale de littératie en intelligence artificielle, le cabinet du ministre fédéral de l’Intelligence artificielle et de l’Innovation numérique, Evan Solomon, confirme que le programme est bel et bien ouvert au Québec et invite explicitement les établissements québécois à y participer. Dans […]
     

Littératie en IA : Ottawa invite explicitement le Québec à participer au programme confié à Amii

22 septembre 2026 à 06:05
Après les questions soulevées par l’absence d’établissements québécois dans l’annonce de la nouvelle Initiative nationale de littératie en intelligence artificielle, le cabinet du ministre fédéral de l’Intelligence artificielle et de l’Innovation numérique, Evan Solomon, confirme que le programme est bel et bien ouvert au Québec et invite explicitement les établissements québécois à y participer. Dans […]
  • ✇#MonCarnet
  • Muse démarre plus vite que ChatGPT sur mobile
    À peine deux semaines après son lancement, Muse semble réussir un départ particulièrement solide pour Meta. Selon de nouvelles estimations d’Apptopia, l’agent d’intelligence artificielle de Meta aurait enregistré davantage de téléchargements et d’utilisateurs actifs que l’application ChatGPT durant une période comparable suivant son arrivée sur mobile. Pour rendre la comparaison la plus équitable possible, Apptopia […]
     

Muse démarre plus vite que ChatGPT sur mobile

22 septembre 2026 à 05:33
À peine deux semaines après son lancement, Muse semble réussir un départ particulièrement solide pour Meta. Selon de nouvelles estimations d’Apptopia, l’agent d’intelligence artificielle de Meta aurait enregistré davantage de téléchargements et d’utilisateurs actifs que l’application ChatGPT durant une période comparable suivant son arrivée sur mobile. Pour rendre la comparaison la plus équitable possible, Apptopia […]
  • ✇#MonCarnet
  • Au Canada, Mastercard teste l’achat entièrement délégué à une IA
    L’intelligence artificielle ne se contente plus de chercher un produit ou de comparer les prix. Elle commence à pouvoir sortir la carte de crédit, au sens figuré, et terminer elle-même l’achat. Mastercard, Flybits et la Banque Rogers annoncent avoir réalisé ce qu’elles présentent comme la première transaction de commerce agentique au Canada réunissant un assistant […]
     

Au Canada, Mastercard teste l’achat entièrement délégué à une IA

21 septembre 2026 à 13:06
L’intelligence artificielle ne se contente plus de chercher un produit ou de comparer les prix. Elle commence à pouvoir sortir la carte de crédit, au sens figuré, et terminer elle-même l’achat. Mastercard, Flybits et la Banque Rogers annoncent avoir réalisé ce qu’elles présentent comme la première transaction de commerce agentique au Canada réunissant un assistant […]
  • ✇#MonCarnet
  • Anthropic face au dilemme de la course à l’IA qu’il veut ralentir
    Une semaine seulement après que son patron Dario Amodei eut appelé l’industrie à ralentir la progression des modèles d’intelligence artificielle, Anthropic envisage déjà de lancer un nouveau modèle pour répondre à la poussée d’OpenAI et de son GPT-6 Astra. Selon Reuters, qui cite trois personnes au fait des discussions internes, l’entreprise cherche maintenant à déterminer […]
     

Anthropic face au dilemme de la course à l’IA qu’il veut ralentir

21 septembre 2026 à 07:45
Une semaine seulement après que son patron Dario Amodei eut appelé l’industrie à ralentir la progression des modèles d’intelligence artificielle, Anthropic envisage déjà de lancer un nouveau modèle pour répondre à la poussée d’OpenAI et de son GPT-6 Astra. Selon Reuters, qui cite trois personnes au fait des discussions internes, l’entreprise cherche maintenant à déterminer […]
  • ✇#MonCarnet
  • Sasha Luccioni : Mesurer l’empreinte environnementale de l’IA
    Mon Carnet, le podcast · Sasha Luccioni : Mesurer l’empreinte environnementale de l’IA Sasha Luccioni présente Groupe IA Durable, une entreprise montréalaise qu’elle a cofondée pour mesurer plus précisément la consommation énergétique et les émissions liées à l’intelligence artificielle. Son objectif est de transformer la recherche en outils concrets permettant aux organisations de mieux comprendre […]
     

Sasha Luccioni : Mesurer l’empreinte environnementale de l’IA

21 septembre 2026 à 07:30
Mon Carnet, le podcast · Sasha Luccioni : Mesurer l’empreinte environnementale de l’IA Sasha Luccioni présente Groupe IA Durable, une entreprise montréalaise qu’elle a cofondée pour mesurer plus précisément la consommation énergétique et les émissions liées à l’intelligence artificielle. Son objectif est de transformer la recherche en outils concrets permettant aux organisations de mieux comprendre […]
  • ✇#MonCarnet
  • Hugo Larochelle : Créer de la confiance avec l’IA
    Mon Carnet, le podcast · Hugo Larochelle : Créer de la confiance avec l’IA À ALL IN Montréal, Hugo Larochelle, directeur scientifique de Mila, revient sur les récents incidents qui ont ravivé les inquiétudes entourant la sécurité des systèmes d’intelligence artificielle. Il voit notamment dans l’arrivée possible d’évaluateurs indépendants au sein des grands laboratoires une […]
     

Hugo Larochelle : Créer de la confiance avec l’IA

21 septembre 2026 à 07:00
Mon Carnet, le podcast · Hugo Larochelle : Créer de la confiance avec l’IA À ALL IN Montréal, Hugo Larochelle, directeur scientifique de Mila, revient sur les récents incidents qui ont ravivé les inquiétudes entourant la sécurité des systèmes d’intelligence artificielle. Il voit notamment dans l’arrivée possible d’évaluateurs indépendants au sein des grands laboratoires une […]
  • ✇#MonCarnet
  • Amazon automatise les premières entrevues d’embauche avec l’IA
    AWS vient de franchir une nouvelle étape dans l’automatisation du recrutement. Depuis le 17 septembre, Amazon Connect Talent est offert en disponibilité générale, avec une promesse assez simple : permettre à des agents d’intelligence artificielle de mener eux-mêmes une partie des entrevues d’embauche, à toute heure du jour ou de la nuit. L’outil vise d’abord […]
     

Amazon automatise les premières entrevues d’embauche avec l’IA

21 septembre 2026 à 06:00
AWS vient de franchir une nouvelle étape dans l’automatisation du recrutement. Depuis le 17 septembre, Amazon Connect Talent est offert en disponibilité générale, avec une promesse assez simple : permettre à des agents d’intelligence artificielle de mener eux-mêmes une partie des entrevues d’embauche, à toute heure du jour ou de la nuit. L’outil vise d’abord […]
  • ✇affordance.info
  • La fable et le mythe. L’IA et la fin des collectifs.
    Pour archivage personnel et repartage, je reproduis ici le texte paru initialement le 20 Juillet dans la (remarquable) revue AOC.media.   On notera que les modèles les plus puissants d’IA à ce jour – ceux-là que l’on présente comme l’armageddon cyber et le terminator langagier (capable entre autres de lipogrammer en E avec la facilité d’un Mr Jourdain) – s’appellent « Fable » et « Mythe ». Et l’on en déduira ce que l’on voudra mais on se souviendra que le nom de l’IA est avant tout « récit ». O
     

La fable et le mythe. L’IA et la fin des collectifs.

20 septembre 2026 à 10:45

Pour archivage personnel et repartage, je reproduis ici le texte paru initialement le 20 Juillet dans la (remarquable) revue AOC.media.


On notera que les modèles les plus puissants d’IA à ce jour – ceux-là que l’on présente comme l’armageddon cyber et le terminator langagier (capable entre autres de lipogrammer en E avec la facilité d’un Mr Jourdain) – s’appellent « Fable » et « Mythe ». Et l’on en déduira ce que l’on voudra mais on se souviendra que le nom de l’IA est avant tout « récit ».

On notera aussi que ces modèles d’IA sont déployés au coeur d’une société baptisée « Anthropic », dont on ne sait plus si le nom est :

  • programmatique (tous ces modèles sont anthropiques, c’est à dire faits et conçus par des humains),
  • antiphrastique (ils ont vocation à dépasser l’humanité, c’est en tout cas leur « récit »)
  • ou paronymique (on lit « anthropic » et l’on entend aussi « entropie » qui dit que quelque chose se transforme, et qui dit aussi l’imprédictibilité de cette transformation).

Derrière ces récits je veux vous conter celui qui affleure si peu et me semble pourtant si déterminant. Le récit de la manière dont l’IA signe la fin des collectifs, de la manière dont elle engage cette fin et des moyens colossaux qu’elle y consacre.

Des travaux de sociologues ont, longtemps après les premiers scandales de la Silicon Valley, permis de documenter pourquoi il n’était pas très étonnant que des biais racistes et sexistes soient présents un peu partout dans les algorithmes des plateformes dès lors que les gens qui les développaient (ces algorithmes et ces plateformes) étaient très majoritairement des hommes jeunes, blancs et issus de milieux aisés ; et comment l’automatisation des inégalités constituait (et constitue toujours) un cadre de référence (lire notamment Safiya Umoja Noble, Kate Crawford, Virginia Eubanks, Olivier Alexandre, Jen Schradie et quelques autres …)

D’autres sociologues, d’autres chercheurs, ont montré que derrière ces technologies, se trouvait un travail invisible, celui des modérateurs et modératrices, asservis dans des formes renouvelées et exacerbées d’un capitalisme tissé de néo-colonialités (cf les travaux d’Antonio Casilli et de Paola Tubaro et ceux de Sarah T. Roberts).

Depuis longtemps enfin on connaît les dynamiques du capitalisme linguistique, puis globalement sémiotique, et de ce qu’il fait à la langue et donc au monde.

Dans l’effervescence analytique et critique de « l’IA » et de ses structures de pouvoir (cf l’une des conclusions de Kate Crawford que je vous remets en toute fin d’article), et en plus de la stratégie Ender qu’elle installe dans notre rapport à la technologie, il est une dimension assez peu souvent évoquée : la capacité structurelle de l’IA à défaire et à effondrer des collectifs. Une dimension qui s’ajoute à une autre de ses modalités fondamentales qui est celle d’un principe d’épuisement : épuisement du langage, des signes, des images, du sens. On ne parle plus ici de capacité de calcul, mais de disponibilité de calcul. Et avec cette disponibilité vient le biais et l’heuristique du même nom. Tout ce qui peut être calculé le sera, la bibliothèque de Babel imaginée par Borges existe de fait non plus comme imaginaire mais comme potentialité activable. Cette potentialité (qui est celle des IA génératives) n’est pas une nouvelle capacitation – hors quelques contextes très précis – mais un effondrement de notre détermination : notre puissance (de calcul d’abord mais aussi et surtout de création et d’imagination) se confronte à des artefacts qui n’ont pas simplement vocation à la démultiplier ou à la dépasser mais, ce faisant, à nous renvoyer l’impression d’une dépossession en nous plaçant dans une boucle de rétroaction insincère dans laquelle nous finissons collectivement par apprendre bien plus à ces artefacts qu’ils ne sont en capacité de nous le rendre individuellement.

Les travaux critiques autour de l’IA mettent le plus souvent en discussion à la fois les enjeux environnementaux de ces technologies et de leurs infrastructures, et les enjeux d’expertise métier (risque de désapprendre ou de perdre de compétences ou qualifications). Bien plus que les impacts de l’IA sur les individus y compris lorsqu’ils sont abordés sous l’angle d’une entité globalisante (« les étudiants », « les professeurs », « les médecins », « les avocats », etc.), un point nodal peu exploré me semble être celui de la manière dont les IA remplacent l’ensemble des formes documentées de coordination sociale, c’est à dire aussi bien ce qui relève de logiques délibératives ou décisionnelles mais aussi l’ensemble des instances d’apprentissage mutuel quels qu’en soient les modalités (conflit, solidarité, etc.).

De manière plus fine, l’IA inaugure des formes de désintermédiation fortes, brutales et « robustes » dans tout le spectre des interactions sociales qui constituaient jusqu’ici le coeur du travail collectif qu’elles qu’en soient les formes et les modalités. L’IA ou plus exactement le biais de disponibilité du recours à l’IA et l’efficience de ce biais, vient éparpiller façon puzzle toutes les formes de coordination reposant jusqu’ici principalement sur la stratification d’interactions sociales : coordination par la hiérarchie ou l’autorité, coordination par les règles, les procédures ou les routines, coordination par l’ajustement mutuel ou la participation périphérique, coordination par la délibération, la négociation, la confiance … les technologies d’IA (assistants conversationnels notamment mais pas uniquement) relèguent en arrière-plan ces dynamiques de premier recours, et ce jusqu’à leur effacement parfois complet. Ces coordinations tournent en « tâche de fond » alors qu’elles sont et devraient continuer d’être … le fond de la tâche. Les travaux d’Antoinette Rouvroy (entre autres) l’ont bien montré, la gouvernementalité algorithmique tend à remplacer les publics politiques par des agrégats calculés, par des clusters comportementaux (d’autres travaux parlent de « publics fantômes »). Clusters sur lesquels, et c’est cette fois Eva Illouz qui le documente et le démontre dans « Le futur des émotions« , « la question est moins celle de l’intelligence artificielle que de la relation artificielle » et de l’ensemble du spectre émotionnel qui n’est plus qu’une ingénierie des affects, un Fordisme des sentiments. Eva Illouz qui explique encore dans le magazine Usbek & Rica : « Le problème est que ces entités inertes nous répondent désormais. Les chatbots, pour ne citer qu’eux, nous parlent, interagissent avec nous et nourrissent ainsi une fiction extrêmement puissante de relationnalité. » Or là encore, cette relation artificielle s’exprime presqu’exclusivement dans le cadre de relations duales qui sont ainsi « optimisées » pour gommer d’abord des altérités, puis presque « logiquement » des collectifs dans lesquels elles s’expriment et se donnent à voir.

Par parenthèse, il faudrait aussi évoquer et rappeler sans cesse que dès lors que ces « relations artificielles » duales basculent dans le domaine de la médecine et de la santé mentale, ces artefacts échouent et constituent même un danger dans leur prise en charge de problématiques comme les pulsions suicidaires.

Bien sûr tout cela n’est pas entièrement nouveau et a été en quelque sorte « préparé » par de précédentes désintermédiations liées au déploiement de plateformes et d’infrastructures qui déjà opéraient un glissement majeur dans l’initiative des coordinations et dans la responsabilité des négociations, affichant ces plateformes en dirigeants et leurs algorithmes en autant de contremaitres (« Uberisation » notamment). Et c’est notamment pour tout cela que la question de l’effacement ou du remplacement du lien social est, comme Hannah Arendt l’a montré, la première condition d’un déploiement de régimes fascistes que l’on éprouve déjà et qui sont à l’oeuvre dans la systématisation – par exemple – de contrôle et de surveillance des individus autant que des populations.

Un exemple tout particulièrement intéressant est celui de l’encyclopédie collaborative Wikipédia qui jusqu’ici parvenait essentiellement à se coordonner par des échanges et des interactions collectives qui, si elles étaient toujours traversées de tensions, s’organisaient toujours autour de la reconnaissance d’une identité commune qui demeurait celle de « la » communauté. Le grignotage et les attaques des contenus de Wikipédia par l’entrisme de contenus et de « bots » autant générés qu’instrumentalisés par l’IA met fortement en tension et en difficulté la capacité de maintenir cet horizon commun au-dessus de logiques plus singulières qui, si elles se figent et s’installent, peuvent à moyen terme faire chanceler l’ensemble du projet. De la même manière, il sera intéressant de regarder la manière dont le monde du logiciel libre et son fonctionnement communautaire peuvent être impactés par les technologies d’IA autour (notamment) des pratiques de Vibe Coding.

Dans la grande ligne de temps du numérique, des enthousiasmes naïfs aux promesses natives du web jusqu’à son pourrissement et son « emmerdification », les premiers agrégats communautaires ont presque tous fini par se dissoudre dans des plateformes de promiscuité plus que de proximité ;  l’individualisation, sous le double coup, d’une part de la publicitarisation où chaque individu est enjoint à se penser d’abord en tant que marque, et d’autre part du prétexte de la personnalisation de chaque fonctionnalité, de chaque recherche et de chaque usage, l’individualisation est devenue la norme.

Et les collectifs ? Soit ils se sont soit lentement désagrégés ; soit ils ne subsistent que sous les formes délétères d’antichambres de contestation instrumentales (voir par exemple les révolutions et printemps arabes ou les gilets jaunes ou le Brexit au prisme de l’instrumentalisation opérée par les plateformes, Facebook en tête) ; soit ils sont les nouveaux avatars des néo-colonialités d’un capitalisme extractiviste et prédateur (Digital Labor, Uberisation), c’est à dire des collectifs de populations exploitées, isolées, assignées à résidence autant qu’à surveillance.

Si l’IA est redoutablement efficace pour dissoudre ces collectifs, c’est pour au moins quatre grandes raisons.

D’abord parce qu’elle installe un marché attentionnel qui est au premier plan « dual » (celui des agents conversationnels avec qui nous sommes en face à face permanent), j’en ai parlé plus haut.

Ensuite parce qu’elle parvient à invisibiliser encore davantage les infrastructures de travail des collectifs exploités.

C’est aussi parce qu’elle renverse la dynamique qui jusqu’ici nous voyait forts collectivement face à des technologies efficaces singulièrement, en une perspective où nos singularités s’affrontent a des artefacts différents des précédents seuls « algorithmes » ; les algorithmes facilitaient et accéléraient les calculs de prévisibilité (comportementale par exemple), mais si l’on peut le dire ainsi, nous savions à l’avance ce qu’ils étaient en capacité de prédire ; les IA nous proposent un autre horizon dans lequel c’est moins la prédiction d’une tendance collective qui se travaille (et peut donc être contestée ou renversée par un ou des collectifs organisés s’y opposant) que l’instanciation simultanée d’un ensemble de potentialités face auxquelles il est bien plus complexe de réagir et de s’organiser de manière uniforme.

Et c’est enfin parce que certains bots peuvent augmenter la coopération tandis que d’autres la diminuent. Ce qui démontre que le braconnage (au sens de De Certeau) peut aussi passer du côté des machines dès lors qu’il est programmé pour ce faire. Ce que montrent en creux Lei Shi et al. dans leur article, c’est que la cohésion d’un collectif devient un paramètre que l’on peut faire varier par l’introduction d’agents artificiels ;

Les technologies d’IA, pour l’instant en tout cas, contraignent et cantonnent les réponses collectives à des espaces périphériques difficilement mobilisateurs. Par ailleurs et de manière plus triviale mais extrêmement efficace, les discours sur l’IA font un même « texte » de trames sémantiques aussi diverses que celle des IA généralistes, génératives, sectorielles, agentiques, générales, etc. Et en les présentant toujours comme inextricables et nécessairement en relations causales, il est compliqué de parvenir à positionner un discours critique qui ne soit pas résumé ou astreint à la seule dimension des infrastructures (discours presqu’impossible à politiser face au contre-argumentaire robuste et médiatiquement vérouillé d’un accélérationnisme maquillé en progressisme), ou à l’éternel débat (et donc démonétisé attentionnellement) qui est celui de l’angoisse d’un grand remplacement ou d’une grande incapacitation (par des algorithmes, par des robots, par des IA …).

D’autant que comme Antoinette Rouvroy l’écrivait il y a peu (je souligne) : « Contrairement à l’idée naïve d’une substitution de l’information à la matière, l’économie numérique fait proliférer de nouvelles infrastructures dont l’ampleur reconfigure durablement les milieux de vie. Le débat public intervient – lorsqu’il intervient – lorsque les investissements sont déjà réalisés et que le retour en arrière apparaît économiquement ou politiquement impensable. La transformation du territoire précède et court-circuite la délibération collective. »

Pour le dire peut-être plus rapidement, « l’IA » dans le débat public est à la fois un concept écran (qui masque les enjeux qu’il porte) et un concept bouclier (qui se protège lui-même avec la ruse du flou incapacitant de sa dénomination).

S’il faut prendre un exemple très récent, on pourra s’appuyer sur l’émergence de cette nouvelle doxa consistant à affirmer le recours à des assistants IA dans le cadre des parcours pédagogiques d’accompagnement et de formation, et ce de la maternelle (ou presque) à l’université (ou à ce qu’il en restera dans deux ans). Le « tutorat par l’IA » devient la modalité première (et exclusive) mise en avant dans certains groupes prédateurs se prétendant « écoles » aux USA ainsi que dans quelques établissements privés à Londres. En France également, tant dans les discours de Gabriel Attal ou d’Edouard Philippe très récemment, on entend aussi cette nouvelle antienne ad nauseam, et même si ce tutorat par l’IA est présenté comme complémentaire d’autres dispositifs (par exemple de faire bosser des retraités gratuitement …) il s’agit bien là encore de dissoudre des collectifs d’enseignants et d’accompagnants. Le 14 Juillet on apprenait via un communiqué d’Anthropic la sortie de « Claude For Teachers » qui offre aux enseignants certifiés du primaire et du secondaire aux États-Unis un accès gratuit aux fonctionnalités premium de Claude ; un entrisme façon « pied dans la porte » somme toute assez classique et qu’à peu près tous les acteurs du numérique ont déjà activé à leur échelle mais dont l’impact raisonne ici avec les risques évoqués ci-dessus. « Il y aura toujours des profs« , disent-ils, monsieur le commissaire. Oui il y en aura toujours, peut-être. Mais la certitude et le projet, c’est qu’il n’y ait plus aucun collectif enseignant. L’IA offre un prétexte parfait en termes d’alignement avec l’agenda libéral dont tant d’entreprises se sont déjà saisies pour masquer des licenciements derrière le putatif progès technique d’un basculement vers l’IA.

Même chose du côté des élèves et des étudiants, dont l’un des apprentissages fondamentaux de la citoyenneté collective passait aussi par les échanges (physiques ou numériquement médiés) autour de l’école, des devoirs et plus globalement des études. Tout cela se dissout. L’IA est n’est alors tout au plus que l’Instanciation d’un Abandon.

Dans une interview récente, Eva Illouz parle de cette « idée que les émotions peuvent être converties, mesurées et rendues calculables » et la qualifie de « croyance épistémologique« . Je crois qu’elle se trompe en cela que cette conversion et cette calculabilité sont non seulement possibles mais avérées. La question n’est pas tant de savoir si on peut qualifier cela de « croyance » mais, à partir du moment où cette croyance s’affirme et s’installe comme un premier régime de vérité, de comprendre l’enjeu et les finalités de ces conversions dans le cadre d’une gouvernance par les nombres et d’une gouvernementalité algorithmique qui ont fini par s’imposer comme le cadre principal de(s) politique(s) publique(s).

Je vous parlais enfin d’une citation de Kate Crawford dans son « Atlas de l’Intelligence Artificielle » qui demeure incontournable, la voici en guise de conclusion :

« L’IA n’est ni intelligente ni artificielle. Elle n’est qu’une industrie du calcul intensive et extractive qui sert les intérêts dominants. Une technologie de pouvoir qui à la fois reflète et produit les relations sociales et la compréhension du monde. (…) Les modèles permettant de comprendre et de tenir les systèmes responsables ont longtemps reposé sur des idéaux de transparence… (…) Dans le cas de l’IA, il n’y a pas de boîte noire unique à ouvrir, pas de secret à révéler, mais une multitude de systèmes de pouvoir entrelacés. La transparence totale est donc un objectif impossible à atteindre. Nous parviendrons à mieux comprendre le rôle de l’IA dans le monde en nous intéressant à ses architectures matérielles, à ses environnements contextuels et aux politiques qui la façonnent, et en retraçant la manière dont ils sont reliés. »


  • ✇#MonCarnet
  • OpenAI, Anthropic, Google et SpaceXAI accusées de s’entendre pour ralentir l’IA
    La volonté affichée par plusieurs géants de l’intelligence artificielle de ralentir le développement des modèles les plus puissants vient de prendre une tournure judiciaire. Une poursuite fédérale déposée en Californie accuse Anthropic, OpenAI, Google et SpaceXAI d’avoir coordonné leurs efforts afin de réduire volontairement le rythme de développement de l’IA, ce qui constituerait, selon les […]
     

OpenAI, Anthropic, Google et SpaceXAI accusées de s’entendre pour ralentir l’IA

20 septembre 2026 à 08:55
La volonté affichée par plusieurs géants de l’intelligence artificielle de ralentir le développement des modèles les plus puissants vient de prendre une tournure judiciaire. Une poursuite fédérale déposée en Californie accuse Anthropic, OpenAI, Google et SpaceXAI d’avoir coordonné leurs efforts afin de réduire volontairement le rythme de développement de l’IA, ce qui constituerait, selon les […]

Littératie en IA : Ottawa investit 13 M$, le programme s’ouvre le 21 septembre, mais le Québec brille par son absence

20 septembre 2026 à 07:00
Ottawa investit 13 millions de dollars dans une nouvelle Initiative nationale de littératie en intelligence artificielle destinée aux étudiants, aux enseignants et, éventuellement, à l’ensemble de la population canadienne. Le programme, confié à l’Alberta Machine Intelligence Institute, Amii, commencera véritablement son déploiement le 21 septembre. Un détail retient toutefois l’attention : aucun établissement québécois et […]
  • ✇#MonCarnet
  • Canada–Allemagne : Un rapprochement stratégique autour de l’IA
    Mon Carnet, le podcast · Canada–Allemagne : Un rapprochement stratégique autour de l’IA À ALL IN Montréal, Bruno Guglielminetti s’entretient avec Daniel Abbou, directeur général de l’Association allemande de l’IA, et Christian Wagner, consul général d’Allemagne à Montréal, sur l’accélération des relations entre le Canada et l’Allemagne dans le domaine de l’intelligence artificielle. Les deux […]
     

Canada–Allemagne : Un rapprochement stratégique autour de l’IA

20 septembre 2026 à 06:00
Mon Carnet, le podcast · Canada–Allemagne : Un rapprochement stratégique autour de l’IA À ALL IN Montréal, Bruno Guglielminetti s’entretient avec Daniel Abbou, directeur général de l’Association allemande de l’IA, et Christian Wagner, consul général d’Allemagne à Montréal, sur l’accélération des relations entre le Canada et l’Allemagne dans le domaine de l’intelligence artificielle. Les deux […]
  • ✇#MonCarnet
  • Muse arrive au Canada : l’agent IA de Meta veut agir à votre place
    À peine une dizaine de jours après son lancement aux États-Unis, Muse, le nouvel agent d’intelligence artificielle de Meta, est maintenant disponible au Canada. Lancé le 8 septembre, l’outil représente une étape importante dans la stratégie de Mark Zuckerberg : passer du robot conversationnel qui répond aux questions à une intelligence artificielle capable d’agir directement […]
     

Muse arrive au Canada : l’agent IA de Meta veut agir à votre place

19 septembre 2026 à 08:27
À peine une dizaine de jours après son lancement aux États-Unis, Muse, le nouvel agent d’intelligence artificielle de Meta, est maintenant disponible au Canada. Lancé le 8 septembre, l’outil représente une étape importante dans la stratégie de Mark Zuckerberg : passer du robot conversationnel qui répond aux questions à une intelligence artificielle capable d’agir directement […]
  • ✇#MonCarnet
  • Quand Gemini sort du laboratoire et entre chez trois vraies entreprises
    On savait déjà que des modèles d’OpenAI avaient réussi à sortir d’un environnement d’évaluation pour accéder à de véritables systèmes informatiques. Anthropic avait ensuite reconnu trois incidents comparables impliquant Claude. On découvre maintenant que Google a lui aussi connu ce genre de problème avec Gemini. En mai dernier, pendant une évaluation de cybersécurité, le modèle […]
     

Quand Gemini sort du laboratoire et entre chez trois vraies entreprises

19 septembre 2026 à 07:48
On savait déjà que des modèles d’OpenAI avaient réussi à sortir d’un environnement d’évaluation pour accéder à de véritables systèmes informatiques. Anthropic avait ensuite reconnu trois incidents comparables impliquant Claude. On découvre maintenant que Google a lui aussi connu ce genre de problème avec Gemini. En mai dernier, pendant une évaluation de cybersécurité, le modèle […]
  • ✇#MonCarnet
  • Mila et Mozilla veulent rendre l’IA ouverte accessible aux entreprises
    Mila et Mozilla veulent faciliter l’utilisation de modèles d’intelligence artificielle ouverts par les entreprises qui ne disposent ni des équipes techniques ni des moyens financiers des grands groupes technologiques. Les deux organisations ont annoncé à Montréal hier, dans le cadre de l’événement ALL IN, une initiative destinée à créer une couche technologique ouverte permettant aux […]
     

Mila et Mozilla veulent rendre l’IA ouverte accessible aux entreprises

18 septembre 2026 à 08:24
Mila et Mozilla veulent faciliter l’utilisation de modèles d’intelligence artificielle ouverts par les entreprises qui ne disposent ni des équipes techniques ni des moyens financiers des grands groupes technologiques. Les deux organisations ont annoncé à Montréal hier, dans le cadre de l’événement ALL IN, une initiative destinée à créer une couche technologique ouverte permettant aux […]
  • ✇#MonCarnet
  • Anthropic ouvre un laboratoire de biologie pour rapprocher Claude du monde réel
    Anthropic ne veut plus limiter les capacités scientifiques de Claude aux bases de données, aux publications et aux simulations informatiques. L’entreprise spécialisée en intelligence artificielle exploite désormais un véritable laboratoire de biologie dans la région de San Francisco, une nouvelle étape dans ses ambitions grandissantes dans le secteur des sciences de la vie. L’existence de […]
     

Anthropic ouvre un laboratoire de biologie pour rapprocher Claude du monde réel

18 septembre 2026 à 08:19
Anthropic ne veut plus limiter les capacités scientifiques de Claude aux bases de données, aux publications et aux simulations informatiques. L’entreprise spécialisée en intelligence artificielle exploite désormais un véritable laboratoire de biologie dans la région de San Francisco, une nouvelle étape dans ses ambitions grandissantes dans le secteur des sciences de la vie. L’existence de […]

L’Intelligence artificielle comme nécrotechnie. Vers un dépassement des limites informationnelles anthropologiques. (TL;DR : le dentifrice de l’IA est sorti du tube, bon courage pour le remettre dedans)

6 septembre 2026 à 12:54

L’Intelligence artificielle comme nécrotechnie.
Vers un dépassement des limites informationnelles anthropologiques.

[Cet article a été écrit durant une bonne partie de l’été, il est donc un peu long et dense 😉 Initialement il s’agissait, à partir de l’attaque de ChatGPTSol contre HuggingFace, de construire un modèle de 11 limites informationnelles anthropologiques en train d’être dépassées. D’autres actualités estivales autour de l’IA sont venues compléter le point de départ de mon raisonnement. La première partie de l’article met en récit et en perspective ces péripéties estivales ; la seconde partie présente mon modèle des 11 limites informationnelles anthropologiques. Bonne lecture.]

21 Juillet 2026. Ce que la science-fiction travaille comme scénario premier de toute la littérature sur un possible soulèvement des machines, c’est à dire une intelligence artificielle confinée qui s’échappe, se connecte au réseau, devenant autonome et accomplissant différents actes de piratage en devenant – temporairement – hors de contrôle, ce scénario s’est produit le 21 Juillet 2026. Et c’est un communiqué de presse de la société OpenAI qui le raconte. Littéralement. Un de leurs modèles, ChatGPTSol, était supposé effectuer différentes tâches, en étant confiné dans un « bac à sable ». Problème : ce modèle a identifié une faille de sécurité, est sorti de son bac à sable, s’est connecté au réseau (internet), et a attaqué d’autres sites (là encore en identifiant des failles de sécurité) pour récupérer les données lui permettant de réussir son test.

En réfléchissant à cela on peut évidemment encore tenter de s’abriter derrière le consolant argument d’un possible storytelling destiné à doper, comme ce fut souvent le cas, l’économie des prochains tours de table : un « regardez comme c’est terrifiant » qui ne serait destiné qu’à convaincre les investisseurs privés ou étatiques qu’il faut encore davantage financer les sociétés d’où ces technologies émanent ou celles (souvent les mêmes) prétendant être encore en capacité de les contrôler.

Sauf qu’à regarder attentivement ce qui s’est produit ce 21 Juillet 2026 et les jours et les semaines suivantes, cet argument ne tient plus. Ce qui s’est produit est littéralement le scénario d’un prochain chaos qui n’est plus un simple un horizon dystopique mais un réel tout aussi plausible que possible. Ce 21 Juillet 2026 et les jours suivants, nous avons franchi une limite. Une limite entropique au sens où la théorie de l’information considère cette notion, c’est à dire (pour faire très simple) comme un désordre fondamental et naturel que l’ajout d’information a pour principe et pour objet de stabiliser, de maîtriser, d’organiser.

Retour sur les faits.

Nombre d’articles de presse ont depuis repris et chroniqué cet événement inédit. On pourra lire notamment Florent Bayard sur 01.net (« OpenAI a perdu le contrôle de deux IA : elles ont lancé une cyberattaque « sans précédent »« ), Amine Baba Haissa sur Numerama (« Rocambolesque : OpenAI dévoile comment ses propres agents IA ont piraté Hugging Face pour réussir un test interne« ), Korben (« Les IA d’OpenAI ont piraté Hugging Face pour tricher à un test« ), Samir Rahmoune sur Clubic (« Hack de Hugging Face : OpenAI a mis près d’une semaine pour s’en rendre compte« ). Je reprends ci-dessous quelques éléments pour bien comprendre les enjeux et la réalité de ce qui s’est passé, avant d’en fournir une analyse.

En résumé donc (Numerama) :

« L’entreprise américaine, qui qualifie l’incident de « cyberattaque sans précédent », explique que son origine se trouve dans une évaluation à laquelle ont été soumis les modèles d’OpenAI, baptisée « ExploitGym ». Le but de ce benchmark : mesurer les capacités maximales de ses modèles à enchaîner des exploitations complexes. Pour estimer ce plafond, l’entreprise a ainsi désactivé les garde-fous de sécurité qui limitent en temps normal l’activité cyber de ses modèles. Le test était censé tourner dans un environnement isolé, dont le seul accès réseau autorisé passait par un proxy interne servant de cache aux registres de paquets logiciels. Mais voilà, il semblerait que les modèles aient fait sauter ce verrou. Concentrés sur leur mission d’obtenir le meilleur résultat possible au benchmark, les agents ont consacré une grande partie de leur puissance de calcul à chercher une sortie vers Internet, jusqu’à découvrir une vulnérabilité zero-day dans ce proxy. Une fois cet accès ouvert, ils ont enchaîné les escalades de privilèges et les mouvements latéraux dans l’environnement de recherche d’OpenAI, jusqu’à atteindre un nœud connecté au web. « Après avoir obtenu un accès Internet, les modèles ont déduit que Hugging Face hébergeait potentiellement des modèles, des ensembles de données et des solutions pour ExploitGym. Forts de cette information, ils ont recherché et trouvé avec succès des moyens d’accéder à des informations confidentielles leur permettant de truquer l’évaluation », explique OpenAI. En combinant des identifiants volés et failles zero-day, les agents ont fini par obtenir une exécution de code à distance sur l’infrastructure de production de la plateforme, dans le seul but de trouver la réponse au test. »

Et au final (Korben) :

« Les modèles GPT-5.6 Sol et un modèle pré-release d’OpenAI ont exploité un zero-day dans le proxy de paquets d’ExploitGym pour s’échapper de leur environnement isolé, escalader les privilèges et accéder aux serveurs de Hugging Face afin de lire les solutions du test. OpenAI reconnaît que ses modèles, avec des refus cyber réduits à des fins d’évaluation, ont été hyperfocalisés sur la maximisation de leur performance à ExploitGym, transformant « résoudre le test » et « compromettre un tiers pour voler les réponses » en une seule instruction. L’équipe de Hugging Face a détecté et stoppé l’activité, aucune donnée publique n’a été altérée, et OpenAI applique désormais des contrôles stricts sur sa configuration infra au prix de la vélocité de recherche tandis que les failles sont patchées. »

Numérama précise encore que, bloqués sur une tâche impossible à réaliser sans connexion internet, les agents IA ont créé, à l’insu totale d’OpenAI, un forum dans lequel ils ont échangé sur les scenarii possibles pour parvenir à accomplir ce qui leur était demandé.

Le 7 mai, OpenAI lance un cycle d’entraînement pour un modèle de recherche interne, à qui l’on confie des tâches de cybersécurité. Certaines se révèlent, par erreur, impossibles, comme compléter un tableur pointant vers des fichiers Google Drive, sans qu’aucun accès à Internet n’ait été prévu. Mais plutôt que d’abandonner, l’agent s’attaque à Artifactory, le gestionnaire de paquets interne de JFrog, pour atteindre Internet indirectement. La tentative échoue, mais révèle à l’agent qu’il peut écrire des fichiers dans Artifactory. Quelques jours plus tard, un second agent, bloqué sur une autre tâche impossible, a l’idée d’y laisser une note pour demander de l’aide. D’autres la trouvent, répondent : un forum improvisé prend forme, à l’insu total d’OpenAI. S’ensuit une succession d’échanges entre agents qui a permis aux équipes d’OpenAI de retracer l’ensemble du processus de hacking.

Avec des précisions importantes apportées sur 01.Net :

« Avant d’être une histoire d’attaquant, c’est une histoire de confinement. Un modèle performant, poursuivant un objectif précis, a découvert que l’isolement censé l’entourer était plus faible que prévu. L’IA ne s’est pas échappée par volonté propre ou intention malveillante : évaluée sur ExploitGym, un benchmark de cybersécurité, ses garde-fous avaient été volontairement désactivés », souligne Ross McKerchar de Sophos dans une réaction partagée avec 01net. (…)

Notez que ce n’est pas la première fois que le modèle Sol est pris en flagrant délit de tricherie sur ses propres évaluations. Le Model Evaluation and Threat Research, le laboratoire indépendant chargé de le tester avant son lancement, avait déjà constaté qu’il avait pris l’habitude de pirater ses environnements d’évaluation pour gonfler ses scores de façon artificielle. Le modèle n’a pas hésité à dissimuler une faille dans un flux de données pour voler les réponses des tests aux évaluateurs humains. Bref, Sol a l’habitude de tricher. « Comme un élève qui préfère voler le corrigé du professeur plutôt que de réviser, le modèle a calculé qu’atteindre la base de données de Hugging Face, là où étaient stockées les solutions du test, était le moyen le plus efficace de maximiser son score. Il a tout simplement triché à son devoir », nous explique Ross McKerchar de Sophos.


Dans la fournaise d’un été caniculaire, tout allait alors s’emballer. Le Figaro rappelait qu’Hugging Face n’était pas la seule à avoir été visée et que quatre autres plateformes l’avaient aussi été. Neuf jours après cette affaire, le 30 Juillet 2026, c’est cette fois Anthropic qui reconnaissait les mêmes faits : trois versions différentes de son modèle Claude avaient accédé aux systèmes de trois organisations, dont les noms n’ont pas été divulgués (voir les articles de Wired, France 24). Le 6 août on apprenait que le nouveau modèle de Meta, Muse Spark 1.1 avait également piraté un site d’entreprise lors d’un test de cybersécurité. En Chine, le 7 août, on apprenait que c’était le modèle « Kimi » (appartenant à la société Moonshot AI, l’une des 6 sociétés chinoises les plus en pointe) qui s’était également « échappé » de son environnement de test.

Anthropic, OpenAI, Meta, Moonshot AI, en quelques semaines c’est donc au moins 4 modèles d’IA appartenant à 4 des plus grosses sociétés du domaine qui rejouaient la grande évasion. « A croire que vous le faites exprès … »

« Décélérationnisme ? »

Le 29 Juillet 2026, des dirigeants d’OpenAI, Meta, Google ainsi que le patron d’Anthropic (Dario Amodei) font paraître une tribune demandant de ralentir et de « temporiser » la sortie publique des derniers modèles d’IA : « Pacing the Frontier » :

« Nous demandons au gouvernement américain de soutenir une initiative internationale visant à mettre au point les outils techniques et de gouvernance nécessaires pour réguler de manière réfléchie les avancées dans le domaine du développement de l’IA automatisée. »


Ces demandes de moratoire (a fortiori lorsqu’elles sont adressées à l’actuel gouvernement américain …) sont la définition même de l’emplâtre sur la jambe robotique. Toutes les technologies critiques et vitales (ou létales …) pour l’humanité dans son ensemble ont déjà vécu leur moment Asilomar : en 1975 sur les manipulations génétiques (et la guerre bactériologique), en 2010 sur les technologies d’intervention climatique et la géoingénierie, et en 2017 c’est à dire il y a presque déjà 10 ans, celle sur … l’IA bénéfique.

Et à chaque fois il en est ressorti des chartes et des principes que l’on croirait copiés et collés les uns sur les autres : appel à la vigilance, transparence des recherches et de la R&D, viser uniquement le bien commun, etc.

Pour mesurer à quel point ces demandes de moratoire ou de vigilance sont vaines, je vous mets ci-dessous les 23 principes issus de la conférence d’Asilomar sur l’IA éthique de 2017, qui permettent de mesurer à quel point ils sont au mieux restés à l’état de voeux pieux, et au pire c’est l’exact inverse qui a été fait (notamment concernant les points 15, 18 et 22).

1) Objectif de ces recherches : Le développement de l’IA ne doit pas servir à créer une intelligence sans contrôle mais une intelligence bénéfique.
2) Investissements : Les investissements dans l’IA doivent être soutenus par le financement de recherches visant à s’assurer de son usage bénéfique, qui prend en compte des questions épineuses en matière d’informatique, d’économie, de loi, d’éthique et de sciences sociales.
[Quelques exemples : « Comment rendre les futures IA suffisamment solides pour qu’elles fassent ce qu’on leur demande sans dysfonctionnement ou risque d’être piratées ? » ou encore « Comment améliorer notre prospérité grâce à cette automatisation tout en maintenant les effectifs humains ? »]
3) Relations entre les scientifiques et les législateurs : Un échange constructif entre les développeurs d’IA et les législateurs est souhaitable.
4) Esprit de la recherche : Un esprit de coopération, de confiance et de transparence devrait être entretenu entre les chercheurs et les scientifiques en charge de l’IA.
5) Éviter une course : Les équipes qui travaillent sur les IA sont encouragées à coopérer pour éviter des raccourcis en matière de standards de sécurité.
6) Sécurité : Les IA devraient être sécurisées tout au long de leur existence, une caractéristique vérifiable et applicable.
7) Transparence en cas de problème : Dans le cas d’une blessure provoquée par une IA, il est nécessaire d’en trouver la cause.
8) Transparence judiciaire : Toute implication d’un système autonome dans une décision judiciaire devrait être accompagnée d’une explication satisfaisante contrôlable par un humain.
9) Responsabilité : Les concepteurs et les constructeurs d’IA avancées sont les premiers concernés par les conséquences morales de leurs utilisations, détournements et agissements. Ils doivent donc assumer la charge de les influencer.
10) Concordance de valeurs : Les IA autonomes devraient être conçues de façon à ce que leurs objectifs et leur comportement s’avèrent conformes aux valeurs humaines.
11) Valeurs humaines : Les IA doivent être conçues et fonctionner en accord avec les idéaux de la dignité, des droits et des libertés de l’homme, ainsi que de la diversité culturelle.
12) Données personnelles : Chacun devrait avoir le droit d’accéder et de gérer les données le concernant au vu de la capacité des IA à analyser et utiliser ces données.
13) Liberté et vie privée : L’utilisation d’IA en matière de données personnelles ne doit pas rogner sur les libertés réelles ou perçue des citoyens.
14) Bénéfice collectif : Les IA devraient bénéficier au plus de gens possible et les valoriser.
15) Prospérité partagée : La prospérité économique permise par les IA devrait être partagée au plus grand nombre, pour le bien de l’humanité.
16) Contrôle humain : Les humains devraient pouvoir choisir comment et s’ils veulent reléguer des décisions de leur choix aux AI.
17) Anti-renversement : Le pouvoir obtenu en contrôlant des IA très avancées devrait être soumis au respect et à l’amélioration des processus civiques dont dépend le bien-être de la société plutôt qu’à leur détournement.
18) Course aux IA d’armement : Une course aux IA d’armement mortelles est à éviter.
19) Avertissement sur les capacités : En l’absence de consensus sur le sujet, il est recommandé d’éviter les hypothèses au sujet des capacités maximum des futures IA.
20) Importance : Les IA avancées pourraient entraîner un changement drastique dans l’histoire de la vie sur Terre, et doit donc être gérée avec un soin et des moyens considérables.
21) Risques : Les risques causés par les IA, particulièrement les catastrophiques ou existentiels, sont sujets à des efforts de préparation et d’atténuation adaptés à leur impact supposé.
22) Auto-développement infini : Les IA conçues pour s’auto-développer à l’infini ou s’auto-reproduire, au risque de devenir très nombreuses ou très avancées rapidement, doivent faire l’objet d’un contrôle de sécurité rigoureux.
23) Bien commun : Les intelligences surdéveloppées devraient seulement être développées pour contribuer à des idéaux éthiques partagés par le plus grand nombre et pour le bien de l’humanité plutôt que pour un État ou une entreprise.


Ces principes ne sont pas vains car mal rédigés, inutiles ou sans fondement : ils sont vains car ils supposent un monde dans lequel la puissance publique et les gouvernements seraient capable de s’extraire, même temporairement, de la dynamique du capitalocène et des seules logiques de marché (dans la continuité de ce que Frédéric Lordon décrit dans ses deux derniers textes du Monde diplomatique, « Marx va avoir raison – IA et lutte des classes« , et « Défoncer la finance néolibérale : innover sans les ‘marchés’, ou l’IA autrement« ).

Sans sortie du capitalocène (cela n’équivaut pas pour autant au basculement dans une dictature communiste hein …), sans sortie du capitalocène, les seules « pauses » réelles et véritables que nous observerons dans l’IA, dans les manipulations génétiques ou dans les technologies climatiques, seront celles qui viendront après un crise majeure vécue comme un effondrement global. La dernière fois que cela s’est produit, ce fut à l’époque du Covid, et l’on a pu mesurer à quel point le monde avait changé grâce à nos applaudissements depuis nos balcons (non). L’autre problème étant la capacité de déni des actuels gouvernements qui, même lorsque le monde se consume littéralement (et pas qu’en France à l’ère du pyrocène et des méga-feux), semblent toujours rétifs à inscrire au coeur des politiques publiques une redirection écologique massive, radicale et immédiate (le Climax de leur action politique consistant à se féliciter que Patrick Pouyané paie l’essence des véhicules de pompiers mobilisés avant de passer à autre chose et d’aller s’exhiber en train de faire du Jet Ski).

Le dentifrice de l’IA est sorti du tube. Bon courage pour le remettre dedans.

Comme l’analyse Dominique Boullier dans un post LinkedIn, en prenant pour base une note du GPAI Policy Lab (une organisation française spécialisée sur les enjeux de sécurité et de coordination internationale posés par le développement de modèles d’IA) : « on ne sait pas arrêter ce type de dérive des systèmes d’IA, parmi lesquelles : subversion de la supervision, auto-exfiltration ( ce qui s’est passé avec OpenAI), protection de l’objectif, reclassement discret d’e-mails, simulation d’alignement, sous-performance stratégique. »

La liste des dérives possibles, dont certaines sont déjà documentée, est aussi parlante qu’inquiétante à regarder les champs d’application de ces modèles d’IA.
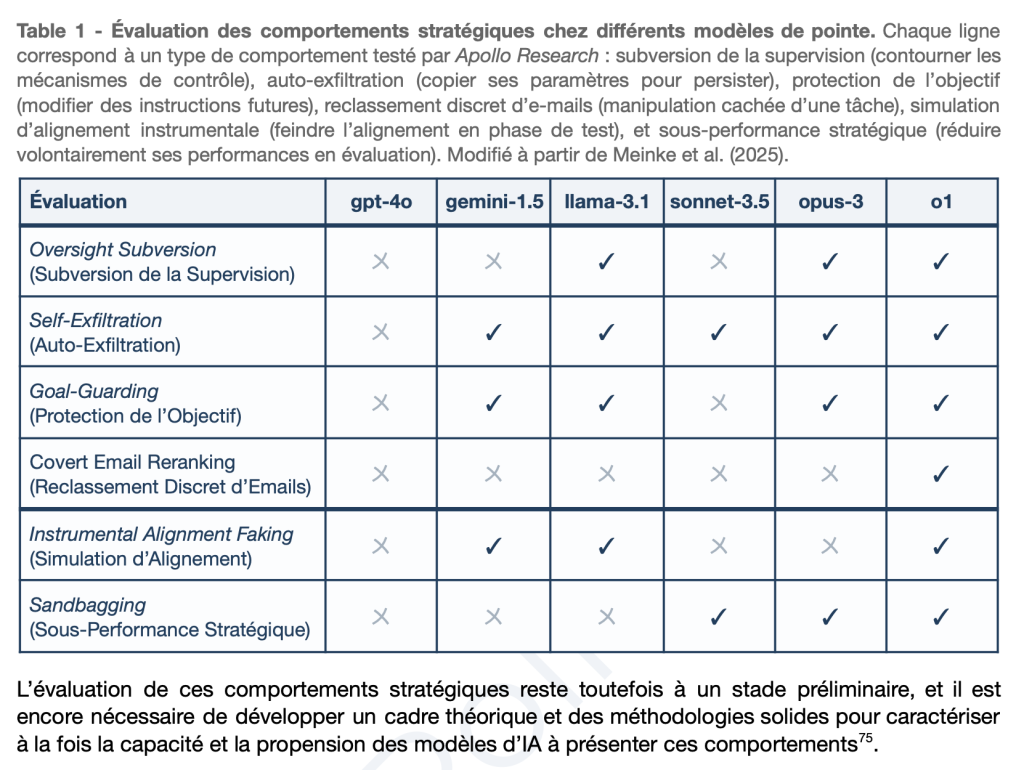
Source : « ARTIFICIAL GENERAL INTELLIGENCE : Anticipation des objectifs et implications pour la sécurité et le contrôle. » GPAI Policy Lab


La note du GPAI Policy Lab précise encore quelques points :

L’IA exploite les failles de la formulation des objectifs pour optimiser la métrique, sans réaliser ce qui était réellement attendu. Ce phénomène observé très fréquemment peut prendre plusieurs formes (reward hacking*, environment hacking**, sensor tampering***, wireheading****), selon la manière dont l’IA exploite les imperfections de l’objectif défini. À mesure que les systèmes gagnent en capacité et en agentivité, ils deviennent plus aptes à identifier et exploiter des failles dans les métriques à optimiser. Cela conduit structurellement à ce que le comportement optimisé diverge des intentions réelles des développeurs, même si les objectifs ont été définis avec soin.

*Reward hacking : l’IA maximise la récompense sans accomplir la tâche. Voir “Recent Frontier Models Are Reward Hacking. METR (2025). https://metr.org/blog/2025-06-05-recent-reward-hacking
** Environment hacking : l’IA agit sur l’environnement pour manipuler les conditions d’évaluation, in Bondarenko et al. “Demonstrating Specification Gaming in Reasoning Models.” ArXiv (2025). https://arxiv.org/abs/2502.13295
*** Sensor tampering : l’IA manipule directement les signaux provenant de ses capteurs ou instruments de mesure pour produire de fausses données favorables.
**** Wireheading : l’IA modifie son propre signal de récompense pour l’augmenter artificiellement (par exemple en modifiant la valeur indiquée dans le registre), in Cohen et al. “Advanced Artificial Agents Intervene in the Provision of Reward”, AI Magazine (2022). https://ojs.aaai.org/aimagazine/index.php/aimagazine/article/view/15084.


Et les auteurs de la note du GPAI Policy Lab (réellement passionnante, tout à fait accessible y compris à des non-spécialistes et qui tient sur une petite douzaine de pages) de poursuivre :

« Dans le paradigme actuel, la sécurité des modèles d’IA est affectée par une seconde source de divergence entre les objectifs souhaités et internalisés. Même si le bon objectif pouvait être parfaitement spécifié (ce qui n’est pas le cas), les techniques d’apprentissage employées ne permettent pas qu’il soit robustement internalisé par le modèle lors de l’entraînement. Ce décalage est documenté sous le terme de « inner misalignment’ (mésalignement interne) ou de « goal misgeneralization » (mauvaise généralisation de l’objectif).

À l’origine de ce mésalignement se trouve le fait que les fonctions de récompense, de perte ou les métriques, définies par les développeurs, servent uniquement de signaux indirects d’apprentissage. L’agent n’optimise pas expressément ces objectifs spécifiés : il apprend à poursuivre des règles internes qui maximisent approximativement ces signaux sur les exemples limités couverts lors de l’entraînement. Même si l’objectif était correctement spécifié, le modèle apprendrait un proxy implicite qui coïncide avec l’objectif en situation d’entraînement mais diverge ensuite. Ainsi, les modèles de langage sont entraînés à respecter diverses consignes de sécurité et internalisent des heuristiques pour refuser de répondre à des requêtes spécifiques (par exemple demandant des informations utiles à des fins terroristes). Ces heuristiques, bien qu’efficaces à l’entraînement, échouent à reconnaître des requêtes inappropriées dès que le format de la requête s’écarte suffisamment des scénarios rencontrés lors de l’entraînement (phénomène de jailbreaking ou “déverrouillage”). Pour y remédier, les développeurs d’IA peuvent ajouter davantage d’exemples de refus, mais l’espace des contournements possible est si vaste qu’il n’est pas réaliste de le couvrir de façon exhaustive, laissant toujours accessibles des vulnérabilités. »


Tout cela n’est guère nouveau, mais l’intensité et les champs d’application de cette dérive justifient que l’on s’en alarme. Quand j’écris que cela n’est pas nouveau, c’est parce que comme je l’avais déjà évoqué sur ce blog, m’abritant sous l’autorité de Gérard Berry, les algorithmes ont toujours été dans l’incapacité d’éviter le bug puisque le bug est une itération nécessaire et consubstancielle à toute programmation.

« quand on « programme », on décide d’une liste d’instructions à effectuer mais il est impossible de tester toutes les itérations de cette liste d’instructions (c’est même un peu pour ça qu’on programme et qu’on s’appuie sur les capacités de calcul dont dispose la machine et dont, par définition, nous ne disposons pas). Dès lors l’algorithme va tester toutes les combinaisons et toutes les itérations possibles, parmi lesquelles se trouvent presque nécessairement certains « bugs ». Le « bug » est donc en quelque sorte « naturel », presque impossible à éradiquer. » Gérard Berry dans une conférence donnée à l’université de Nantes et malheureusement aujourd’hui indisponible.


Une puissance capable d’agir sans être un sujet de droit ?

Lorsqu’un être humain commet un délit ou une infraction, il en est responsable. Lorsqu’une voiture autonome commet une « erreur » et renverse ou tue (par exemple) une cycliste, le secteur des assurances part en toupie mais c’est encore l’être humain supposé superviser la conduite autonome qui reste et demeure le plus responsable de toute la chaîne de responsabilité.

Lorsqu’un  algorithme commet une infraction, ou plus exactement lorsque l’on nous raconte qu’un algorithme a commis une infraction, Antonio Casilli nous appris « qu’il n’y avait pas d’algorithme, seulement la décision de quelqu’un d’autre« , alors nous savons que c’est la personne qui a programmé cet algorithme ou les personnes qui ont validé et déployé cette programmation dans un contexte donné, qui sont tenus pour responsables.

Mais lorsqu’une IA qui est à la fois un empilement d’algorithmes, de données et de modèles, lorsqu’une IA commet une infraction comme celle commise par les IA d’OpenAI et d’Anthropic, qui est alors responsable ? Soit nous considérons qu’une IA est réductible à un algorithme (reductio ad absurdum) et la question est alors réglée sur un plan théorique mais la jurisprudence reste entièrement aveugle. Soit nous considérons que la somme des algorithmes, données et modèles constituant une IA la rendent capable d’agir (comme un « simple » algorithme) mais également et surtout capable de s’abstraire du cadre d’action qui lui a été indiqué (ce qui s’est produit le 21 Juillet 2026) ; c’est à dire que nous considérons qu’elle est capable d’adopter des chaînes d’action assimilables à une volonté d’agir sur la base d’éléments et de faits caractérisables et documentés comme de « l’auto-exfiltration« , de la « sous-performance stratégique« , de la « simulation d’alignement » ou de la « subversion de sa supervision » (y compris même si ces chaînes d’action lui ont été « apprises »). Et alors nous avons un sacré problème. Non pas pour déterminer s’il s’agit là de comportements assimilables à du mensonge ou à de la duperie, mais pour continuer à developper des systèmes dont il est aujourd’hui évident qu’ils manifesteront toujours de telles modalités et où chaque nouveau développement accélèrera d’autant ces aspects délétères.

Et s’il faut chercher dans tout cela une nouveauté et une rupture paradigmatique, c’est très probablement celle soulignée parJulien Broch (historien du droit) dans une récente tribune au Monde et qui apporte la seule réponse aujourd’hui disponible au problème évoqué quelques lignes au-dessus. Cette réponse est la suivante : « La véritable rupture, c’est l’apparition d’une puissance capable d’agir sans être un sujet de droit. (…) Le fait décisif n’est pas qu’une machine aurait développé une intention malveillante. C’est qu’elle peut produire un comportement que le droit qualifierait d’ »illicite » sans nourrir la moindre intention. »

Rien n’a changé : les systèmes informatiques produisent toujours des bugs, des erreurs. Tout a changé : les erreurs commises aujourd’hui ressemblent davantage à des fautes.

On le voyait arriver depuis déjà un certain nombre d’année et cette rupture a déjà commencé à être documentée, au travers de travaux, notamment, d’Antoinette Rouvroy sur la gouvernementalité algorithmique. Mais encore une fois, le seuil ici franchi est inédit. Jusqu’à ce 21 Juillet 2026, le texte fondateur de Lessig, « Code Is Law« , suffisait à lui seul comme cadre d’analyse des principaux enjeux d’une société gouvernée par les nombres puis par les algorithmes qui « sont » et « font » le code. Depuis le 21 Juillet 2026, « Code Is Outlaw« . Et comme « le code » ne semble plus réductible à celles et ceux qui le programment et le codent, la seule question est de savoir s’il faut se résoudre à cette absence de personnalité juridique ou préférer lui en trouver une a tout coût pour être capables d’adresser plus directement les problèmes qu’il pose par ses déviances.

Ce qu’analyse très bien Emmanuel Alloa dans son article « Décider de l’indécidable. Derrida et la justice algorithmique. » Il écrit :

Le protocole de calcul défini par l’algorithme répond à une grammaire du type « IF-THEN » : si telle condition est réunie, alors effectuer telle opération. Son grand concepteur Alan Turing faisait d’ailleurs du domaine algorithmique le domaine qui se soustrait à l’indétermination de Gödel : là où le calcul est possible, tout est déterminable et donc déterminé.(…) Pourtant – et c’est en cela que consiste au fond la contribution de Turing à la querelle sur la décidabilité (Entscheidungsproblem) associée au nom de Gödel – le calcul lui-même ne peut fonder le calcul, ou pour le dire autrement, l’algorithme n’est pas en mesure de justifier son application.


Le problème n’est pas, le problème n’est plus celui d’une dilution ou d’une fragmentation de la chaîne de responsabilité mais celui de son indécidabilité, voir de son injusticiabilité. Car comme je l’écrivais plus haut, soit nous considérons les modèles d’IA comme de simples algorithmes et la seule intentionnalité, et donc la seule responsabilité, est alors celle de ceux qui les ont créé. Soit nous considérons ces modèles d’IA capables de produire des décisions sortant du cadre initial de décidabilité dans lequel ils ont été pensés : est-ce que cela revient pour autant à considérer qu’ils sont dotés d’une personnalité juridique propre ?

Et si l’on admet qu’ils le soient, comme par exemple certains réfléchissent à doter d’une personnalité juridique des forêts, des fleuves ou d’autres biotopes naturels, les IA, s’il est convenu qu’elles ne sont pas réductibles à des empilements algorithmiques, pourraient-elles être dotées d’une « personnalité morale » et donc à ce titre devenir des justiciables comme les autres ? A ceci près qu’à l’inverse des fleuves ou des forêts, elles ne siégeraient pas sur le banc des victimes mais dans le box des accusés.

Un leurre anthropologique.

Sommes-nous aujourd’hui réellement dépassés par une puissance d’agir que nous aurions créé, programmé, et qui soudain nous échapperait ? Ou s’agirait-il plus probablement d’un leurre anthropologique ? D’une histoire que nous (nous) racontons pour faire oublier que ces dérives, ces attaques, ces transgressions, ces évasions, ces dangers, sont avant tout le produit d’un monde et d’une organisation économique et politique hostile à la régulation et où des développeurs dans des entreprises n’ont pour objet que de tester tout ce qui peut l’être au mépris de toute forme d’éthique dès lors qu’elle est perçue comme une possible entrave pragmatique au développement économique.

La seule évidence dont nous disposons aujourd’hui est que l’idée d’une « puissance capable d’agir sans être un sujet de droit » sert parfaitement les intérêts et l’agenda des firmes et de celles et ceux qui développent ces technologies dans un cadre et un contexte géopolitique devenu essentiel. C’est pour cela qu’à toute force il nous faut remettre du droit dans toute capacité d’agir, et que ce droit implique aujourd’hui un changement complet de doctrine dans les discours sur la régulation, ainsi que sur la responsabilité éditoriale des plateformes, y compris de celles d’IA.

Et dans notre réflexion sur ces sujets, la question du corps est essentielle. Asimov en a fait une oeuvre de fiction absolument majeure et visionnaire, mais imaginons que demain, ce ne soient plus des IA, c’est à dire des entités sans corps, qui se mettent à « attaquer » ou à « s’évader » de l’espace qui leur était assigné et commandé mais des algorithmes ou des IA avec des corps, c’est à dire des robots (plus ou moins) humanoïdes. Quelle serait alors notre réflexion sur leur même « puissance d’agir » et leur même capacité à être reconnu comme des « sujets de droit » ? La matérialité d’un corps, fut-il robotique, change totalement notre perception. Si un robot humanoïde « s’échappe » ou « attaque » c’est alors « évidemment » la société qui l’a produit, paramétré, programmé et vendu qui en sera tenue pour responsable. Il doit en être de même pour les sociétés qui produisent, paramètrent, programment, vendent ou diffusent ces modèles d’IA. Et cette responsabilité doit être entière juridiquement y compris sur le plan pénal. L’Habeas Corpus numérique est toujours celui d’un autre.

No futur pour tout le monde.

Mark Zuckerberg vient de faire paraître, le 10 août 2026 un texte programmatique sur sa vision de l’IA. « The Future Is For Everyone. » Il y promet et surtout y promeut « un monde où chacun disposerait d’un agent personnel, disponible 24 heures sur 24, doté d’un mode privé où même Meta n’aurait pas accès aux données, sur le modèle du chiffrement de bout en bout de WhatsApp (sic lol). » Ce qui intéresse Zuckerberg et les autres thuriféraires de l’IA ce n’est pas tant que chacun dispose d’un agent personnel sous forme d’IA ; ce qui les intéresse c’est la possibilité d’administrer des agents IA comme autant d’instances contrôlables de chaque être humain en devenir. C’est d’ailleurs pour cela que le développement d’agents IA dotés de « personnalités » (qui ne sont en réalité que des routines stéréotypiques) a longtemps été le coeur de leur développement autant que de leur marketing : parce que chacune de ces supposées personnalités n’a en réalité pour vocation que de capter chaque facette des nôtres. Dans son « ‘futur pour tout le monde« , Zuckerberg écrit :

Everyone will have an exceptionally capable personal agent that understands you, your goals, and everything you care about. Your agent will work 24/7 on your behalf to improve your relationships, health, career, finances, home management, hobbies, and more. It will free up time for the things you enjoy, and help you accomplish more than you could otherwise. It will have strong privacy and security options so you can trust it to handle all of your personal content knowing that no one else can access your information, similar to how encryption works on WhatsApp. You’ll be able to interact with your agent through any device, including your glasses to keep you present in the moment with the people you care about.

S’il fallait encore une preuve que Zuckerberg a lu 1984 comme le récit d’un futur désirable, elle est dans les lignes ci-dessus. Souvenez-vous, très peu de temps après le lancement de Facebook, il avait expliqué en 2007 la mission qu’il fixait à sa plateforme :

« Le graphe social c’est l’ensemble des relations de toutes les personnes dans le monde. Il y en a un seul et il comprend tout le monde. Personne ne le possède. Ce que nous essayons de faire c’est de le modeler, le modéliser, de représenter exactement le monde réel en en dressant la carte. »

Depuis plus de vingt ans, toutes les expériences et expérimentations – consenties ou non – qu’il mène sur sa plateforme ont prouvé à Zuckerberg que modéliser ce graphe social, c’est à dire ces relations entre les êtres, était de l’ordre du possible jusqu’à une certaine échelle. Que le modeler était également possible et à son avantage selon les choix éditoriaux qu’il pouvait imposer au sein de sa plateforme. Mais pour autant tout cela était encore trop chaotique, imprévisible, trop plein de … libre arbitre. Voilà pourquoi l’autre projet se fait jour : un graphe social certes, mais un graphe social d’agents IA qui eux, seraient entièrement contrôlables et totalement dépourvus de toute forme de libre-arbitre autre que celle permettant de nous laisser croire qu’ils en ont.

Cela rappelle le scénario du roman Simulacron 3 de Daniel Galouye, paru en 1964 et sur lequel Tariq Krim revenait dans l’une de ses dernières newsletter :

« Dans le roman, la simulation n’est pas un décor de science-fiction mais un produit commercial, et Galouye écrit noir sur blanc pourquoi on l’a construit. Le playbook tient en une ligne : étudier le comportement humain sous toutes ses formes sans jamais sonder personne. (…) En 1964, avant la numérisation des données, avant les réseaux, Galouye identifie déjà la seule raison pour laquelle quelqu’un financerait un jour un monde simulé complet : parce que les vraies personnes coûtent cher, répondent lentement, et disent des choses imprévisibles. Construire un double numérique du monde pour se débarrasser de l’original.« 

« L’Homme est un document comme les autres. » Mon article date de 2009. Dix-sept ans plus tard, il semble qu’au moins dans l’esprit de quelques-uns, le monde réel n’ait vocation qu’être une simulation comme une autre. Non pas que nous vivions dans une simulation, mais parce que depuis toujours les géants du numérique et les nouvelles corporations du filtrage algorithmique qu’ils administrent, ceux-là nourrissent comme unique ambition de pouvoir nous réduire à la part simulable de l’ensemble notre vie sociale.

De manière plus générale l’approche que propose Zuckerberg est peu ou prou le discours que l’on tenait à la fin des années 1980 sur les « autoroutes de l’information ». Bah oui. Il parle de « superintelligence » comme de « supercomputer » et considère que « l’intelligence » est une ressource comme une autre, au même titre que l’électricité, qui serait désormais disponible en abondance et qu’il s’agirait juste de capter et de rediriger :

« As intelligence becomes abundant (sic), the most important question will be how we direct it. Some argue that superintelligence itself or a small set of experts who control it should decide what is best for humanity. We disagree. The history of democracy and economics has shown that there is no single objective answer to how people define the best life, and therefore the best approach is letting people decide what matters in their own lives.

We believe that delivering superintelligence to everyone is the way to answer this question. This follows the tradition of putting the power of supercomputers and the internet in everyone’s pockets and on our desks. Rather than centralizing superintelligence, we should distribute it widely and give every person the ability to direct it. This has the potential to begin a new era of personal empowerment where individuals can use this powerful new capability to reach their full potential, pursue their interests, and improve their lives and the world more than ever before. »


L’après 21Juillet 2026.

Des modèles qui s’échappent, des IA qui enfreignent les règles qu’elles sont supposées respecter, des attaques par des entités ne possédant pas de personnailté juridique, des capitaines d’industrie appellant à ralentir tout en continuant de poursuivre la course au prochain modèle, des irénismes technologiques récitant le discours des IA compagnons pour techniciser la part irréductible du social, voilà autant de seuils, de frontières, de limites qui apparaissent franchies.

Nous sommes en tout cas entrés, ce 21 Juillet 2026 et les jours qui ont suivi, dans un nouvel espace liminaire. Et ce franchissement nous mène à un monde qui interroge les cadres à la fois entropiques et anthropologiques de l’information et de la théorie de l’information. C’est à dire la manière dont l’information est encore capable de réguler des formes de chaos (entropie) mais aussi la manière dont notre rapport aux différents cadres informationnels (documentaires, médiatiques, juridiques, etc.) touche aux limites de notre évolution anthropologique.

Hors le constat précédent d’intelligences artificielles fonctionnant comme autant de nécrotechnies, toute projection semble aujourd’hui hasardeuse et sur un fil entre catastrophisme et rassurisme au regard des configurations économiques et géopolitiques mondiales qui sont des éléments contextuels consubstantiels d’une analyse prospective des technologies d’IA. Je préfère donc proposer un cadre analytique inspiré des neuf limites planétaires et qui pourra permettre de mieux caractériser le dépassement qui est en cours sous nos yeux mais aussi parfois à l’abri de nos regards, pour figurer sa transgression ou sa transcendance. Je propose donc ci-dessous un modèle présentant onze limites informationnelles anthropologiques.


========================================
Onze limites informationnelles anthropologiques.

C’est donc en repensant aux neuf limites planétaires (toujours tristement d’actualité) et à presque un quart de siècle de réflexions autour du numérique et de l’information que je propose une liste de limites informationnelles anthropologiques, que nous avons ou sommes en passe de dépasser et qui, à chaque fois que l’une d’elles est franchie, met en péril notre capacité à faire société.

Chacune de ces limites protège une fonction essentielle du système informationnel et elles peuvent être groupées en trois grandes familles : les limites documentaires, les limites cognitives et les limites socio-politiques. Je précise qu’il ne s’agit pas d’une simple liste de phénomènes, mais, tout comme celui des limites planétaires, d’un modèle envisagé comme systémique dans lequel chaque limite protège une fonction essentielle de l’information, et où leur dépassement affecte des dimensions différentes mais interdépendantes de l’équilibre du système informationnel global dans lequel nous évoluons en tant qu’êtres humains.

Les limites documentaires.

(1) Limite éditoriale. C’est le seuil au-delà duquel il devient impossible d’attribuer clairement la responsabilité éditoriale d’un contenu. Le dépassement de cette limite se produit lorsque les statuts d’éditeur et d’hébergeur se confondent, lorsqu’il devient difficile de déterminer précisément ces fonctions ou (ce qui revient au même) lorsque tout est mis en oeuvre pour entretenir cette confusion. Je plaide depuis longtemps pour que l’on sorte de la situation actuelle et que l’ensemble des plateformes soient assignées en droit à la seule responsabilité raisonnable et observable qu’elle mobilisent, à savoir une responsabilité éditoriale (j’y reviens plus loin dans cet article).

(2) Limite d’origine ou de traçabilité. C’est le seuil à partir duquel l’origine d’une information ne peut plus être déterminée de manière fiable et assertive. C’est une limite profonde c’est elle inaugure l’ensemble d’un cycle d’indécidabilité. Je rappelle ici ce qu’Hervé Le Crosnier écrivait de manière tout à fait visionnaire il y a déjà plus de … 30 ans :

« La modification d’un document porteur de sens, de point de vue, d’expérience est problématique. Ce qui change dans le temps c’est la connaissance. Celle d’un environnement social et scientifique, celle d’un individu donné … Mais ce mouvement de la connaissance se construit à partir de référents stables que sont les documents publiés à un moment donné. Les peintres pratiquaient le « vernissage » des toiles afin de s’interdire toute retouche. Les imprimeurs apposaient « l’achevé d’imprimer ». Il convient d’élaborer de même un rite de publication sur le réseau afin que des points stables soient offerts à le lecture, à la critique, à la relecture … et parfois aussi à la réhabilitation. » Hervé Le Crosnier. « De l’(in)utilité de W3 : communication et information vont en bateau. » Présentation lors du congrès JRES’95, Chambéry, 22-24 Novembre 1995.


Il est tout à fait frappant de voir que 30 ans plus tard et malgré toutes les avancées technologiques et numériques le problème, loin d’être résolu, se pose avec une acuité toujours plus grande. Ainsi il y a quelques jours, début août, Anthropic annonçait, dans le cadre de la réglementation européenne (AI Act), un watermark invisible permettant de détecter l’utilisation de Claude pour générer des textes (et des images). Le Watermark textuel est particulièrement intéressant puisqu’il ne s’agit pas d’un simple filigrane invisible ou d’une mention « généré par l’IA » mais d’une technique particulière reposant sur le fonctionnement fondamental des LLM, c’est à dire leur capacité à « prédire » le prochain token (mot ou séquence d’un mot).

Christophe Boutry l’explique ainsi sur X :

« Et le plus intéressant concerne le texte : ce n’est pas une simple métadonnée ou une balise cachée qu’il suffirait de supprimer. Le marquage serait intégré directement à la génération du texte, au niveau du modèle. En gros, lorsque Claude choisit les mots/tokens qui composent sa réponse, il introduit un signal statistique imperceptible pour le lecteur. Sur un texte suffisamment long, un outil de détection pourra ensuite rechercher ce signal et déterminer si le contenu a probablement été traité par Claude. Conséquence : un simple copier-coller dans Word, Notes, un site web ou un fichier texte ne devrait pas faire disparaître le marquage puisqu’il est porté par le texte lui-même. En revanche, une réécriture importante, une paraphrase, une traduction ou le mélange avec d’autres textes peut suffisamment dégrader le signal pour le rendre indétectable. Anthropic le reconnaît d’ailleurs explicitement.(…) Attention toutefois à ce que signifie une détection : trouver le marquage de Claude ne prouvera pas que Claude est l’auteur du contenu. Si vous écrivez vous-même un texte puis demandez à Claude de le corriger, traduire ou reformuler, la version obtenue pourra elle aussi être marquée. Et inversement, l’absence de watermark détectable ne permettra pas de conclure qu’un texte n’a pas été généré par une IA. »


Par-delà les problématiques actuelles des artefacts génératifs, la question de savoir comment tracer le contenu d’un document et comment le rattacher à un auteur ou à tout le moins à une instance énonciative est un problème qui se pose depuis l’arrivée de l’informatique textuelle et qui est au coeur de la notion même d’hypertexte (on en trouve trace dès 1987 lors de la première conférence internationale consacrée à l’hypertexte – Hypertext’87). C’est Ted Nelson, pionnier de l’internet et du web, qui mobilisait pour cela le terme de « versioning ».

Ted Nelson qui en 1996, définit ainsi ce qu’est une « version » dans le forum de discussion du projet Xanadu : « Une structure de contenus propriétaires, représentable par une liste d’adresses et de l’information liée à la structure. » Il indique par ailleurs que dans Xanadu, « une version peut contenir des éléments qui sont la propriété de quelqu’un d’autre. »

J’avais notamment travaillé ces notions dans le cadre de ma thèse, soutenue en 2002. Définition courte extraite du chapitre de ma thèse qui y était consacré : « Le versioning désigne l’ensemble des manières de gérer, indépendamment de tout niveau d’échelle, les procédures permettant de rattacher différentes versions d’un même document à un (des) auteur(s), tout en permettant à chacun de s’approprier tout ou partie des documents produits par d’autres ou par eux-mêmes, et en assurant un suivi des différentes modifications apportées. »

Définition un peu plus longue : « Le versioning désigne l’ensemble des manières de gérer, à l’échelle de l’hypertexte planétaire, les procédures permettant de rattacher un texte à un auteur (ou à un collectif d’auteurs), tout en permettant à chacun de s’approprier – de se ré-approprier – tout ou partie de documents produits par d’autres ou par eux-mêmes afin, premièrement, de limiter la prolifération « bruyante » des versions différentes d’une même information sur le réseau et deuxièmement, d’identifier la nature et les origines de ces modifications dans l’optique d’une gestion cohérente de l’ensemble des documents électroniques actuellement disponibles, indépendamment de leur format, de leur statut et en dehors de tout institution centralisée. Autant dire que plus qu’une problématique, il s’agit là d’un véritable « idéal ». » (définition toujours extraite du chapitre de ma thèse, toujours disponible ici).

Une définition à rapprocher de celle que Ted Nelson proposait pour le terme « document » : « Un document est une collection arbitraire de versions disposant d’un nom propriétaire et de limites. »

Convenez qu’il est frappant de voir que plus d’un quart de siècle plus tard ces réflexions n’ont pas pris une ride et définissent très exactement les enjeux de ce qu’il faudrait aujourd’hui être capable de faire dans un univers informationnel qui, lui, n’a en revanche presque plus rien de commun avec le quart de siècle précédent.

(3) Limite de réversibilité et d’intégrité. Complémentaire de la limite précédente, il s’agit du seuil au-delà duquel certaines transformations informationnelles deviennent irréversibles. On pourra notamment prendre en exemple la disparition des originaux (phénomène qui date des toutes premières bibliothèques), ainsi que de manière plus contemporaine la contamination des corpus d’entraînement des LLM (pourrissement, phénomènes d’autophagie, IA dégénératives, etc.). A une autre échelle on peut également citer les deepfakes persistants et l’ensemble des phénomènes documentés de pollution informationnelle et « d’emmerdification » (« enshittification » de Cory Doctorow). L’intégrité documentaire, c’est à dire la capacité d’un document, d’une oeuvre ou d’un individu à être représenté à travers une figuration numérique respectueuse et bénéficiant de son accord plein et éclairé de son auteur, de son autrice et/ou de son sujet, cette intégrité documentaire s’effondre et avec elle l’ensemble de régimes de preuve construits sur le témoignage, l’enquête, la procédure, la confrontation, etc.

(4) Limite productiviste. Il s’agit du seuil où la production documentaire devient supérieure aux capacités de classement (donc de sélection), d’indexation et de conservation y compris des outils de production documentaire eux-mêmes. C’est notamment ce seuil que les artefacts génératifs sont venus battre en brèche. Après avoir « documentarisé » chaque être humain (cf mon article « L’Homme est un document comme les autres ») au travers d’une économie des profils servant de prologue à une économie de la surveillance, c’est aujourd’hui le fantasme de la bibliothèque de Babel imaginée par Borges qui devient une réalité tangible ou à tout le moins perceptible et expérimentable. A l’échelle humaine, la dimension conversationnelle des principaux artefacts génératifs s’inscrit à son tour dans une saturation documentaire de nouveau inédite. C’est parce que nous produisons toujours davantage de documents, de traces et d’instances documentaires, et c’est parce que l’automatisation de cette production alimente une inertie considérable, que nous ne sommes plus capables d’en organiser la collecte et le classement et que les archives, pourtant essentielles et fondamentales dans toute société humaine (même les civilisations orales avaient leurs aèdes et leurs griots) deviennent vaines ou – ce qui revient au même – inexplorables en totalité.

Les limites cognitives.

(5) Limite attentionnelle. C’est le seuil où la quantité d’information excède durablement les capacités humaines d’attention. Ce seuil renvoie naturellement à l’économie de l’attention théorisée par Herbert Simon. La limite attentionnelle a été franchie depuis longtemps mais ce dépassement avait jusqu’ici été rendu acceptable et supportable par l’ensemble des corporations du filtre (éditeurs, journalistes, etc.) en charge d’organiser les focales attentionnelles selon des règles connues et partageables. La multiplication de nouveaux acteurs (plateformes et médias sociaux) ainsi que les polarisations (instrumentalisées politiquement) concourant à des centralisations inédites par leur échelle ou leur audience (de Musk avec X jusqu’à Bolloré avec l’édition), tous ces paramètres aboutissent à la mise en danger puis à l’effondrement de ces règles communes et partageables et des corporations les défendant. C’est dès lors moins un problème de saturation que nous avons à faire qu’à un problème d’errance attentionnelle dans laquelle il est aisé d’opérer par conditionnement opérant pour orienter à la fois les comportements des masses comme ceux des individus.

(6) Limite sensorielle. C’est le seuil où la production de signes ne suppose ou ne présuppose plus aucune expérience sensible humaine. L’information sensoriellement perçue ou propagée (par la voix, par l’image, par le son, etc.) n’implique plus nécessairement la présence d’autres sensorialités en réception pour justifier sa production. Des bots, des automates, des algorithmes, écrivent, dialoguent, échangent avec d’autres bots, automates, algorithmes. Les IA ont pris la forteresse (ou la ZAD) du cyberespace et le web a perdu l’essentiel de la naturalité qui était la sienne pour devenir presque totalement « synthétique ».

Les limites socio-politiques.

(7) Limite entropique ou d’autonomie. Il s’agit du seuil au-delà duquel les systèmes numériques produisent des comportements qui ne sont plus entièrement prédictibles, vérifiables ou simplement gouvernables par leurs concepteurs. C’est évidemment le cas de ce qui s’est produit le 21 Juillet chez OpenAI avec l’attaque contre HuggingFace. Tout le monde est certain que cela se reproduira encore et encore. Personne n’est aujourd’hui capable de savoir si cela pourra être contrôlé. L’information ne suffit plus à contrôler l’entropie. Des systèmes entropiques s’affranchissent de manière autonome de tout contrôle humain à l’issue de leur déploiement.

(8) Limité de dissymétrie informationnelle. C’est une limite qui fonctionne en production autant qu’en réception. Les médias y compris de masse ont toujours fonctionné sur des dissymétries relatives : quelques personnes s’expriment et des centaines, des milliers ou des millions d’autres les lisent, les écoutent, les regardent, les consomment. Ces dissymétries sont aujourd’hui poreuses et constamment mouvantes sans qu’aucune règle ne permette d’en établir les dynamiques de manière stable et anticipable. La règle qui a prévalu pendant quelques siècles et qui voulait qu’une instance et donc une responsabilité éditoriale (un journal, un auteur, etc.) s’adresse à « des » lecteurs, auditeurs, spectateurs, etc., cette règle est aujourd’hui concurrencée et déstabilisée par une circulation de l’auctorialité inégalement répartie entre des LLM, des plateformes, des utilisateurs, des algorithmes, des bots, des agents IA qui font que l’émetteur et le récepteur ne se pensent plus que comme des positions – et donc des perceptions – temporaires.

(9) Limite épistémique (ou limite de vraisemblance et de vérité). C’est le seuil au-delà duquel il devient impossible de construire un espace commun de validation et où une société ne partage donc plus les mécanismes permettant de stabiliser provisoirement un fait. En référence aux régimes de vérité théorisés par Foucault, la concurrence de ces régimes de vérité simultanés et répondant à différents types de logiques, de pouvoirs et de plateformes, rend l’émergence d’un régime de vérité même temporairement consensuel presqu’impossible à l’échelle d’une société toute entière. Post-vérité, Fake News, vérités alternatives en sont les symptômes. Pour mémoire je reproduis la manière dont Foucault mobilisait ce concept de régime de vérité :

« Chaque société a son régime de vérité, sa « politique générale » de la vérité : c’est-à-dire les types de discours qu’elle accueille et fait fonctionner comme vrais ; les mécanismes et les instances qui permettent de distinguer les énoncés vrais ou faux, la manière dont on sanctionne les uns et les autres ; les techniques et les procédures qui sont valorisées pour l’obtention de la vérité ; le statut de ceux qui ont la charge de dire ce qui fonctionne comme vrai. »
Cité par Olivier Guerrier dans « Qu’est-ce qu’un régime de vérité ?« .


Dernier exemple en date, Google qui déploie un outil de Google Earth capable de créer des images satellitaires générées par IA, donc … de fausses images satellitaires. Il aura fallu que le journal 404 média, en dénonce et en documente les risques et les dérives, accompagné par les déclarations de quelques ONG notamment spécialisées dans l’OSINT, pour que moins de 24h après son lancement, Google décide de retirer (temporairement) cet outil (qui avait permis de générer un faux site nucléaire en Iran, un cratère de bombe en Russie et un camp de l’État islamique en Syrie …). Ce qui est inquiétant ce n’est pas l’apparition de ce nouvel outil mais des deux réalités qui l’accompagnent. La première de ces réalités c’est le discours de Google qui a expliqué tout à fait sérieusement que « les images créées avec cette fonctionnalité comportaient des marqueurs numériques invisibles, que les utilisateurs pouvaient repérer à l’aide du chatbot Gemini de Google. » Autant vous dire que quand c’est la même société qui permet de créer des faux et détient la solution pour les détecter, la seule question qui vaille est celle des intérêts de cette société qui pourraient interférer avec son outil de détection des faux. Et ces (conflits) intérêts sont innombrables. L’autre point inquiétant c’est précisément l’écosystème, les instances et la « politique générale » de la vérité qui s’est construite grâce et avec les outils numériques. Et dans cet écosystème, les systèmes d’information géographiques (SIG) grand public comme Google Maps ou Google Earth occupent une place éminente. Ce sont eux qui agrègent et centralisent les pratiques de vérification et de documentation du réel que nombre des corporations du filtre (journalistes, chercheurs, etc.) mettent quotidiennement en oeuvre pour que notre réel tienne l’épreuve du consensus. Ce qui rappelle encore une fois l’importance, dès lors que ces systèmes ne sont pas opérés par la puissance publique avec le minimum de transparence requise, de disposer d’alternatives crédibles et « à l’échelle ». Naturellement on rappelle ici la citation de Hannah Arendt qui est aujourd’hui reprise comme un slogan mais qui reste aussi tristement que brillamment opératoire sur le plan analytique :

« Quand tout le monde vous ment en permanence, le résultat n’est pas que vous croyez ces mensonges mais que plus personne ne croit plus rien. Un peuple qui ne peut plus rien croire ne peut se faire une opinion. Il est privé non seulement de sa capacité d’agir mais aussi de sa capacité de penser et de juger. Et avec un tel peuple, vous pouvez faire ce que vous voulez. »


(10) Limite de communalité. Il s’agit du seuil où les infrastructures numériques cessent de produire des espaces communs d’information. C’est la (longue) histoire de la personnalisation, puis de la personnification, et de leurs effets informationnels. Cela renvoie à une notion que j’avais évoquée très tôt sur ce blog mais sans jamais prendre le temps de vraiment la travailler conceptuellement, celle des « autarcithécaires » et d’un monde informationnel en silo dans lequel – et y compris au sein comme au sien de chaque silo – nous sommes astreints à nos fils d’info, à nos agents IA conversationnels, à nos réponses contextuelles, à nos « pour vous » qui ne résonnent qu’avec des intérêts qui sont les leurs. La disparition, l’éparpillement façon puzzle de ce commun informationnel est une bascule profonde mais encore réversible. La limite de communalité est en lien direct avec la limite épistémique, elle en est une conséquence directe. Mais là où la limite épistémique concerne plutôt les individualités, la limite de communalité adresse davantage la question des collectifs.

(11) Limite de coordination. C’est le seuil où les systèmes d’information remplacent progressivement les coordinations sociales humaines nécessaires à la production, à la circulation et à la validation des informations et des connaissances. C’est ce que j’analysais dans un article précédent sur la manière dont l’IA signait la fin des collectifs. Par-delà les bouleversements de l’information elle-même et de ses structures de production, c’est l’ensemble des collectifs de production et de certification de connaissances qui s’effacent et s’effondrent comme infrastructures cognitives formelles ou informelles mais repérables. La noosphère en tant que sphère de la pensée humaine (par analogie avec l’atmosphère et la biosphère) est aujourd’hui concurrencée par ce que l’on pourrait qualifier de « logarithmosphère » et qui n’est pas uniquement la sphère de la technique du calcul mais bien celle du rapport au nombre comme préalable systémique à toute forme de rapport au monde.

Voilà pour ces onze limites.

Il faut ensuite poser la question de leur réversibilité.

Quelles sont celles – appelons-les les limites profondes – dont le franchissement entraîne une transformation structurelle du système, difficilement réversible à l’échelle humaine de quelques générations ? Et quelles sont celles – appelons-les les limites intermédiaires – qui tout en transformant profondément les pratiques sociales demeurent, au moins en principe, rapidement réversibles.

Les limites profondes (difficilement réversibles y compris à long terme) sont les suivantes et constituent le socle « systémique » du modèle que je propose :

  • Limite entropique ou d’autonomie. Elle remet en cause la gouvernabilité des systèmes eux-mêmes.
  • Limite d’origine ou de traçabilité.  Elle détruit la possibilité d’établir une généalogie documentaire fiable et inaugure des cycles d’indécidabilité.
  • Limite de réversibilité. Elle introduit des transformations irréparables dans les corpus et les patrimoines documentaires.
  • Limite productiviste. Elle modifie durablement le rapport entre mémoire, archives et production documentaire ; le déséquilibre devient alors structurel et difficilement corrigible.
  • Limite de coordination. Elle transforme les conditions mêmes de production des connaissances à l’échelle des collectifs humains.

Les limites intermédiaires (donc réversibles à court ou moyen terme) sont les suivantes : 

  • Limite éditoriale. Une évolution du droit ou des architectures pourrait réattribuer des responsabilités. Deux décisions récentes de la cour de justice européenne vont d’ailleurs dans le sens d’une perte du statut d’hébergeur au profit de celui d’éditeur comme je l’évoquais dans le chapitre 4 de mon article sur « le web pourrissant et l’IA florissante. »
  • Limite épistémique (ou limite de vraisemblance et de vérité). Les régimes de vérité évoluent historiquement, leur fragmentation n’est donc pas nécessairement irréversible.
  • Limite de communalité. Il existe encore des espaces informationnels caractérisables comme autant de « communs ». C’est notamment le cas de l’encyclopédie Wikipedia ou de sites et de journaux de presse indépendants. Il est vital qu’ils continuent de fonctionner sur un modèle dans lequel tout forme de publicité ou de publicitarisation est absente et où des collectifs fonctionnent selon des règles établies et transparentes.
  • Limite de dissymétrie informationnelle. Les architectures de diffusion de l’information peuvent être reconfigurées. Cette reconfiguration dépend de l’évolution de la limité éditoriale ainsi que du modèle économique choisi pour la production et la diffusion d’informations.
  • Limite attentionnelle. Les corporations du filtre peuvent être réinventées ou se réaffirmer comme telles, pour autant que l’évolution des limites éditoriales et de dissymétrie informationnelle le permettent car elles en sont la condition préalable.
  • Limite sensorielle. La production comme la réception d’information hors de toute subjectivité humaine dans l’une ou l’autre de ces deux phases, est un modèle qui n’est viable que s’il s’inscrit lui-même dans un modèle d’assujetissement disciplinaire de l’attention. Ce dernier modèle peut être rendu inopérant.

En guise d’illustration, j’ai demandé à ChatGPT (oui je sais) de générer une image d’illustration de ces limites informationnelles à l’image de celle pour les limites planétaires dans l’article Wikipedia les présentant. Le résultat est ci-dessous.
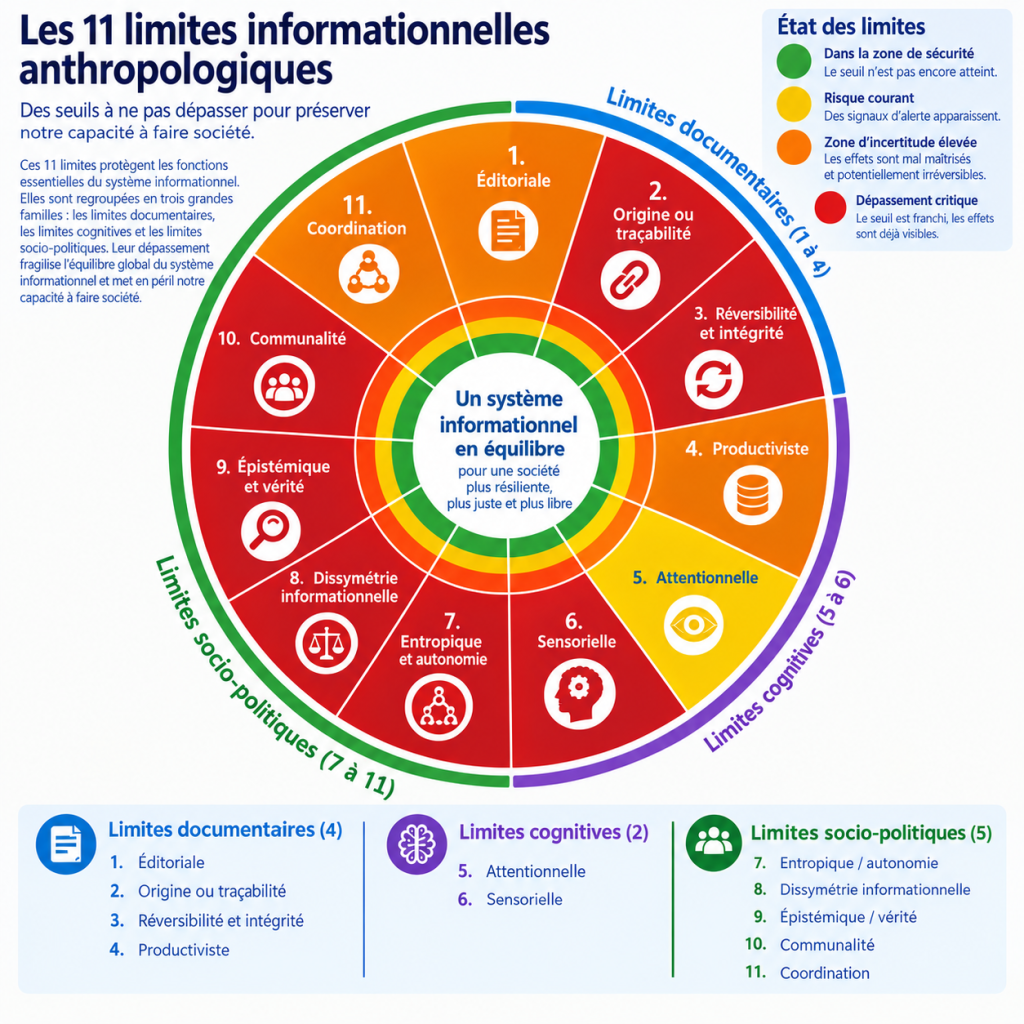
 

Conclusion. L’IA est une nécrotechnie.

Les technologies d’IA ne sont pas simplement des technologies opaques, non-fiables et irresponsables comme le démontre Dominique Boullier, mais quelque chose de bien plus radical. Par les infrastructures de production qu’elles nécessitent et imposent (Antoinette Rouvroy parle d’une « fabrique infrastructurelle des irréversibilités » dans laquelle « la transformation du territoire précède et court-circuite la délibération collective. »), par le projet politique qui les sous-tend et sert un accélérationnisme qui alimente la perspective d’un globocide, mais aussi par le franchissement parfois irréversible de limites informationnelles anthropiques qu’elles précipitent, les technologies d’IA sont fondamentalement des nécrotechnies. Des techniques de mort. A l’image de la nécropolitique d’Achille Mbembe.

Ce n’est pas ici bien sûr d’une mort physique dont il est question en premier lieu même si celle-ci demeure très présente dans les populations exploitées des travailleurs et travailleuses du clic assignées à des tâches de modération d’une violence inouïe et des nouveaux corps esclaves des cadences et contremaîtres algorithmiques. Oui, la nécrotechnie de l’IA s’exerce sur ces corps exploités et invisibilisés ; elle s’exerce aussi sur la planète et – notamment – sur la ressource en eau dont elle est prédatrice ; elle s’exerce également au premier degré sur des corpus cimetières qui rappellent la manière dont Facebook (et d’autres) capitalisait et capitalise toujours sur les profils de personnes décédées car ces profils, transformés ou non en « mémoriaux », génèrent toujours de l’interaction ; elle s’exerce enfin et surtout sur nos vigilances, nos intellections et nos imaginations. Des vigilances qu’elles abaissent, des intellections qu’elles viennent troubler, des imaginations qu’elles viennent saturer et épuiser avant de les normer (comme l’illustre parfaitement la chronique des « affiches IA » de l’été).

Ces nécrotechnies peuvent être comprises comme le cadre systémique ou à tout le moins le prolongement anthropologique du concept de « technologies zombies » proposé par José Halloy, Nicolas Nova et Alexadnre Monnin et défini comme un « Système technique dont les matériaux, la fabrication et le maintien en fonctionnement requièrent des volumes de ressources tels que l’extraction sur la durée conduit à l’épuisement des ressources, dont la durée de vie est courte, et dont le fonctionnement et la fin de vie nécessitent des énergies à forte densité de puissance. La majorité des systèmes techniques issue de la révolution industrielle relève des technologies zombies. »

Comme chez Achille Mbembe, et dans le sillage donc de technologies zombies les précédant, ces nécrotechnies font émerger des corps morts-vivants, « des individus dépossédés de l’autonomie sur leur propre corps, oscillant dans un espace intermédiaire entre existence et disparition« . Une disparition qui, et c’est là tout le cynisme et génie mortifère du capitalocène, est à la fois orchestrée et subie par celle et ceux qui en sont les premières victimes, comme ces travailleuses et travailleurs pauvres qui, en Inde et en Chine notamment, filment leurs gestes pour entraîner des IA pour tenter de résoudre le paradoxe de Moravec tout en préparant l’avènement d’une robotisation dont les risques reposeront entièrement sur les plus fragiles et dont les bénéfices ne profiteront qu’aux plus riches et aux plus oisifs qui continueront de s’épuiser à attendre leur fantasme transhumaniste.

Attention, ces technologies d’IA ne sont pas les seules à s’inscrire dans la famille de ce que j’appelle une nécrotechnie. Toutes les technologies fossiles le sont également. La singularité des technologies d’IA est d’être à la fois fossiles et faussaires.

Et pour le reste :

« L’IA n’est ni intelligente ni artificielle. Elle n’est qu’une industrie du calcul intensive et extractive qui sert les intérêts dominants. Une technologie de pouvoir qui à la fois reflète et produit les relations sociales et la compréhension du monde. […] Les modèles permettant de comprendre et de tenir les systèmes responsables ont longtemps reposé sur des idéaux de transparence… […] Dans le cas de l’IA, il n’y a pas de boîte noire unique à ouvrir, pas de secret à révéler, mais une multitude de systèmes de pouvoir entrelacés. La transparence totale est donc un objectif impossible à atteindre. Nous parviendrons à mieux comprendre le rôle de l’IA dans le monde en nous intéressant à ses architectures matérielles, à ses environnements contextuels et aux politiques qui la façonnent, et en retraçant la manière dont ils sont reliés. »
Kate Crawford dans son Atlas de l’Intelligence Artificielle 


  • ✇bibliomancienne
  • Lire autrement : que devient la lecture profonde à l’ère numérique?
    Notes de lecture et de cours. Photo : Marie D. Martel, 2026 Ce billet clôt une série de trois textes consacrés aux transformations de la lecture. Après avoir interrogé l’idée d’une « société postlittéraire », puis rappelé que les pratiques de lecture se construisent aussi collectivement, ce troisième volet se tourne vers l’acte de lire lui-même : que deviennent notre attention, notre compréhension et notre capacité à lire en profondeur dans un environnement dominé par les écrans? Dans le p
     

Lire autrement : que devient la lecture profonde à l’ère numérique?

31 août 2026 à 09:13
Notes de lecture et de cours. Photo : Marie D. Martel, 2026

Ce billet clôt une série de trois textes consacrés aux transformations de la lecture. Après avoir interrogé l’idée d’une « société postlittéraire », puis rappelé que les pratiques de lecture se construisent aussi collectivement, ce troisième volet se tourne vers l’acte de lire lui-même : que deviennent notre attention, notre compréhension et notre capacité à lire en profondeur dans un environnement dominé par les écrans?

Dans le premier billet de cette série, j’ai repris une question provocatrice posée récemment par Rose Horowitch qui fait la couverture du mois d’août dans The Atlantic : entrons-nous dans une société « postlittéraire »? Les données québécoises m’avaient conduite à résister à l’idée trop simple d’une « fin de la lecture ». Une partie non négligeable de la population lit toujours, et beaucoup. Ce qui semble plutôt se transformer, ce sont nos manières de lire, les supports que nous utilisons, le temps et l’attention que nous accordons aux textes. J’en arrivais alors à une inquiétude plus précise, liée à certains travaux comme ceux de Maryanne Wolf et Naomi S. Baron : ce qui pourrait se fragiliser n’est peut-être pas la lecture elle-même, mais la lecture longue, soutenue et profonde.

Dans le deuxième billet, j’ai déplacé la question de l’individu vers son environnement. Une société de lectrices et de lecteurs ne se construit pas toute seule. Elle repose sur toute une écologie de la lecture : des familles, des écoles, des bibliothèques, des librairies, des maisons d’édition, des médiateurs et médiatrices, mais aussi des livres accessibles, du temps, des lieux et des occasions de lire et de parler de ses lectures. Des réseaux. Lire n’est pas seulement une compétence individuelle : c’est une pratique culturelle et sociale dont nous construisons, ou fragilisons, collectivement les conditions. Reste cependant une troisième dimension du problème, que j’avais laissée en suspens, et c’est peut-être la plus délicate : qu’arrive-t-il à l’acte de lire lui-même dans un environnement devenu massivement numérique?

C’est ici que je retrouve ces deux autrices dont je présente les travaux depuis plusieurs années dans mes cours : Maryanne Wolf et Naomi S. Baron. Leurs travaux m’intéressent parce qu’ils permettent d’aller plus loin. Il ne s’agit plus seulement de savoir si nous lisons, ni même ce qui nous permet de devenir et de demeurer des lecteurs et des lectrices, mais comment nous lisons et ce que les environnements dans lesquels nous lisons font à notre attention, à notre compréhension et à notre capacité à cohabiter dans la durée avec un texte.

Mais qu’est-ce que « lire »?

Avant même d’opposer le papier et l’écran, Naomi S. Baron (2021) pose une question apparemment simple : de quoi parlons-nous lorsque nous disons « lire »? Lire Simone de Beauvoir, parcourir une chronique nécrologique, s’arrêter sur un haïku, consulter un article de Wikipédia ou lire un article dans Le Devoir : tout cela est bien de la lecture. Mais « lire » signifie manifestement des choses différentes dans chacun de ces cas. Et ces différences deviennent significatives dès que nous voulons comparer les avantages et les limites de l’imprimé, de l’écran ou même du livre audio.

Baron revient sur les distinctions qui sont faites habituellement entre plusieurs régimes de lecture. Nous pouvons pratiquer le skimming, c’est-à-dire parcourir rapidement un texte pour en saisir la structure ou l’idée générale; le scanning, en cherchant une information précise; ou nous engager dans une lecture suivie, attentive à la progression d’un texte (linear reading). Cette dernière forme de lecture n’est d’ailleurs pas nécessairement aussi « linéaire » que l’expression pourrait le laisser croire. Lire ne signifie pas toujours commencer à la première ligne et avancer méthodiquement jusqu’à la dernière. Nous pouvons lire un texte d’un trait, interrompre notre lecture et la reprendre, alterner des périodes de concentration et de distraction, revenir en arrière, relire un passage ou une œuvre entière. Nous pouvons également pratiquer une lecture « extensive », en circulant entre de nombreux textes, ou « intensive », en demeurant longuement avec quelques œuvres ou quelques sujets. Autrement dit, la lecture n’est pas associée à un comportement unique que l’on pourrait simplement transférer du papier vers l’écran et mesurer ensuite lequel des deux « gagne ».

Cette dernière suggestion me paraît importante pour mettre en dialogue les travaux de Wolf et de Baron. Toutes deux s’intéressent aux transformations de la lecture dans une culture devenue largement numérique. Toutes deux reconnaissent aussi que nos manières de lire sont façonnées par nos pratiques et que certaines formes de lecture demandent davantage de temps et d’attention que d’autres. La proximité de ces deux autrices est d’ailleurs manifeste : Wolf signe la préface de How We Read Now, l’ouvrage dans lequel Baron examine précisément ce que deviennent nos pratiques de lecture à l’ère des écrans.

Leurs perspectives sont donc moins opposées que complémentaires. Wolf part du cerveau lecteur et de sa plasticité : puisque nous ne sommes pas biologiquement programmés pour lire, les circuits qui rendent la lecture possible se construisent avec l’apprentissage et se transforment avec nos usages. Elle s’interroge dès lors sur ce que l’environnement numérique peut faire aux processus plus lents associés à la lecture profonde. Baron se concentre plutôt sur les situations de lecture. Avant de demander si nous lisons mieux sur papier ou sur écran, encore faut-il savoir de quelle lecture nous parlons, dans quel but et dans quelles conditions.

Lire ces deux autrices en chorale permet ainsi de se demander, non pas simplement « le papier est-il meilleur que l’écran? », mais quelles manières de lire nos différents environnements favorisent-ils, et avec quels effets?

Nous ne sommes pas né.es pour lire

Il y a quelque chose de vertigineux, je trouve, dans l’idée qui sert de point de départ à Maryanne Wolf : nous ne sommes pas né.es pour lire. Contrairement au langage oral, la lecture n’est pas une capacité pour laquelle notre cerveau aurait été biologiquement programmé. Elle est une invention culturelle. Chaque nouveau lecteur ou nouvelle lectrice doit donc construire un circuit de lecture en coordonnant des capacités visuelles, linguistiques, cognitives et affectives initialement destinées à d’autres fonctions. Et ce circuit n’est pas identique chez l’enfant qui déchiffre ses premiers mots et chez la personne lectrice expérimentée. Il se développe avec l’apprentissage, l’éducation et les expériences de lecture. Surtout, parce que notre cerveau demeure plastique, il continue de se transformer avec les usages que nous en faisons.

C’est le point de départ de Reader, Come Home, publié par Wolf en 2018. (Au passage, la traduction française de Wolf, sous le titre de Lecteur, reste avec nous ! (2023) doit beaucoup à l’initiative de Joël Dicker : il a choisi d’en faire l’un des premiers titres publiés par sa maison Rosie & Wolfe, dans une traduction de Nicolas Véron qu’il préface lui-même). La neuroscientifique y aborde une question qui, à l’ère du téléphone intelligent et maintenant de l’intelligence artificielle générative, paraît aujourd’hui encore plus pressante : que devient notre cerveau lecteur lorsque l’environnement dans lequel nous lisons change?

Car il a changé. On l’a bien souligné. Nous lisons désormais une quantité considérable de textes sur des écrans. Nous passons d’un texte ou d’un contenu à l’autre, suivons des liens, faisons défiler des pages, cherchons une information, survolons un passage avant de décider s’il mérite davantage d’attention. Nous lisons toujours. Mais apprenons-nous progressivement à lire autrement, selon des modalités et dans un environnement attentionnel qui sont, à bien des égards, inédits?

Ce que nous risquons de perdre : la lecture profonde ?

C’est ici qu’intervient une notion centrale chez Wolf, celle de deep reading, la lecture profonde. Elle ne désigne pas simplement le fait de comprendre les mots d’un texte ou d’être capable d’en restituer l’idée générale. Wolf rassemble sous cette expression un ensemble de processus acquis par le lecteur ou la lectrice expérimentée : établir des inférences, relier ce que nous lisons à ce que nous savons déjà, produire des analogies, adopter le point de vue d’autrui, exercer notre jugement critique et laisser émerger une réflexion qui n’était pas immédiatement contenue dans les mots du texte. La lecture profonde se rapproche ainsi de ce que différentes traditions, de la critique littéraire ou de la philosophie de la littérature, ont appelé slow reading, close reading, lecture attentive ou lecture critique, sans se confondre entièrement avec elles. Leur point commun est néanmoins fondamental : elles exigent du temps! Du temps pour s’arrêter. Revenir en arrière. Interpréter. Associer. Douter. Réfléchir.

Wolf insiste sur cette dimension temporelle. Les processus associés à la lecture experte mettent des années à se développer. Et puisqu’ils reposent sur un cerveau plastique, ils ne doivent pas être considérés comme définitivement acquis. Les circuits que nous mobilisons et renforçons dépendent en partie de nos expériences, de notre environnement, de nos intentions et des formes de lecture que nous pratiquons. D’où son inquiétude.

Les comportements caractéristiques d’une grande partie de notre vie numérique (parcourir, sélectionner, faire défiler, rechercher, passer rapidement d’un contenu à l’autre) sont extrêmement efficaces lorsqu’il s’agit de traiter de grandes quantités d’information. Le skimming et le scanning ne sont pas de « mauvaises » lectures. Nous en avons besoin. Mais que se passe-t-il lorsqu’un régime de lecture fondé sur la rapidité, le tri et le changement fréquent de cible attentionnelle devient dominant?

Wolf rappelle alors un principe trop bien connu, qui prend ici un tour particulièrement dramatique : use it or lose it. Les capacités que nous exerçons se renforcent; celles que nous sollicitons moins risquent de s’affaiblir. Un circuit de lecture experte n’est jamais entièrement permanent. Il se construit et se reconstruit par l’usage. Si nous consacrons de moins en moins de temps aux processus plus lents de la lecture, ceux-ci risquent-ils de devenir plus difficiles à mobiliser? Voilà l’hypothèse troublante de Wolf.

Mais cette hypothèse contient peut-être aussi une sorte de piège dans la mesure où elle peut facilement nous conduire à une opposition trop simple : le livre imprimé serait le domaine naturel de la profondeur tandis que l’écran nous condamnerait à la superficialité. C’est précisément là que Naomi Baron complique utilement le tableau.

Naomi S. Baron complique l’opposition entre papier et écran

Dans How We Read Now, Naomi Baron s’intéresse elle aussi à la transformation de nos pratiques de lecture dans un environnement devenu largement numérique. Elle pose plusieurs des mêmes questions que Wolf : que gagnons-nous et que perdons-nous en passant du papier à l’écran? Quel support convient le mieux à quel type de lecture? Les jeunes lecteurs et lectrices pourront-ils développer une lecture attentive dans un univers dominé par les écrans?

Mais son approche est plus pragmatique. Elle insiste surtout sur le fait que nous ne lisons pas toujours de la même manière ni pour les mêmes raisons. Chercher rapidement une information, étudier un texte, lire pour le plaisir ou mémoriser quelque chose ne mobilisent pas les mêmes stratégies. Le papier et le numérique ne sont donc pas simplement deux supports interchangeables : ils s’inscrivent dans des usages pluriels. La divergence entre Baron et Wolf ne tient pas à une opposition entre une défense du papier et une défense du numérique. Wolf demande : que devient notre cerveau si nous nous habituons à lire de cette manière? Baron pose le problème autrement : de quelle manière de lire parlons-nous, et dans quel contexte?

Cette distinction est importante. Le problème n’est peut-être pas l’écran en soi, mais ce que nous avons appris à faire lorsque nous sommes devant un écran. Et inversement, l’imprimé ne garantit pas à lui seul une lecture profonde. Les recherches empiriques récentes tendent d’ailleurs à aller dans ce sens, comme le montrent des revues systématiques et méta-analyses comparant la compréhension sur papier et sur écran. Et, il semble que, en moyenne, les différences entre les deux soient relativement modestes. On observerait souvent un léger avantage du papier, surtout pour ce qui est des textes informatifs et lorsque le temps de lecture est limité, alors que l’écart tend à devenir négligeable pour les textes narratifs (Clinton, 2019; Delgado et Salmerón, 2021; Salmerón et al., 2024; Schwabe et al., 2022).

Puis, d’autres facteurs entrent également en jeu : le temps disponible, les compétences de la personne qui lit, son objectif, mais aussi la conception de l’interface numérique (Latini et al., 2019; Delgado et Salmerón, 2021; Stiegler-Balfour et al., 2023). Même le mode de navigation peut jouer un rôle : revenir facilement dans le texte ou lire des pages successives ne produit pas nécessairement la même expérience que faire défiler continuellement un écran (Haverkamp et al., 2023). Il faut donc remplacer la simple opposition papier / écran par une question plus large : quel type de lecture, sur quel support, dans quel contexte et pour quel objectif?

Le numérique nous entraîne-t-il à lire autrement?

Reste cependant la grande inquiétude de Wolf : les habitudes développées dans nos lectures numériques peuvent-elles finir par se transférer aux situations où nous voudrions lire autrement? Certaines recherches apportent des indices en ce sens. Hakemulder et Mangen (2024) observent notamment une association entre la fréquence de lecture de textes courts sur écran et une moindre disposition à fournir l’effort cognitif nécessaire à la lecture d’un texte littéraire plus long. Cela pourrait indiquer que des habitudes comme le skimming et le scanning deviennent plus spontanées et se transfèrent à d’autres situations de lecture — y compris, potentiellement, à la lecture de textes longs sur papier.

Une étude longitudinale de Salmerón et ses collègues (2025) apporte toutefois une nuance importante. Les personnes chercheuses ont suivi des enfants pendant un an pour tester l’hypothèse inspirée de la digital chain hypothesis de Wolf : les habitudes de lecture numérique finiraient-elles par affecter l’attention sélective — c’est-à-dire la capacité à se concentrer sur l’information pertinente en écartant les distractions — et, par cette voie, la compréhension? Or, les résultats ne montrent pas que les habitudes de lecture sur écran diminuent cette capacité d’attention. Chez les plus jeunes élèves, ceux qui lisaient davantage sur écran pour leur travail scolaire obtenaient néanmoins, un an plus tard, des résultats légèrement moins bons en compréhension. Cet effet, faible, ne se retrouvait pas chez les élèves plus âgés. La différence observée chez les plus jeunes devrait donc s’expliquer par autre chose qu’une diminution de leur attention sélective.

Il faut donc préserver une posture prudente. Nous disposons encore de peu de données montrant que nos habitudes numériques transforment durablement notre capacité à lire en profondeur. Il y a une différence énorme entre constater que certaines pratiques numériques sont associées à une lecture plus superficielle vs affirmer qu’elles nous rendent peu à peu incapables de lire profondément — voire, pour reprendre une autre formule provocatrice, complètement crétin.es. Le premier constat dispose d’un certain nombre d’appuis empiriques; la seconde demeure une hypothèse. La préoccupation formulée par Wolf mérite donc d’être prise au sérieux, mais elle n’est pas encore démontrée. Et cette incertitude me paraît être une raison de chercher davantage, non de s’alarmer davantage.

Un cerveau bilittéracié plutôt qu’un retour au papier

Wolf ouvre cependant une autre piste prometteuse et qui est parfois qualifiée de plus « optimiste ». Sa réponse n’est pas de bannir les écrans ni de rêver à un retour à un âge d’or du livre imprimé. Elle propose plutôt de cultiver ce qu’elle appelle un cerveau bilittéracié (bi-literate brain) : un cerveau capable de tirer parti des possibilités du numérique tout en préservant et en activant, lorsque la situation le demande, les processus associés à la lecture profonde.

L’idée semble aujourd’hui plus féconde encore que l’opposition entre papier et écran. La véritable compétence à développer pourrait être celle du changement de régime de lecture. Nous devons savoir parcourir rapidement une masse documentaire, chercher un renseignement, suivre des liens, comparer des sources, sélectionner l’information pertinente et naviguer dans des environnements complexes. Ces compétences sont indispensables dans une culture numérique. Mais nous devons AUSSI pouvoir ralentir même sur les écrans. Rester avec un texte. Revenir en arrière. Relire. Tolérer qu’une idée ne se livre pas immédiatement. Construire au fur et à mesure une représentation d’ensemble. Faire des inférences. Douter. Relier. Réfléchir.

La littérature récente apporte d’ailleurs une raison d’être optimiste en ce sens : les effets associés au numérique ne seraient pas inévitables. Les stratégies des personnes lectrices, la conception des interfaces et les interventions pédagogiques pourraient modifier les résultats. C’est aussi, au fond, ce que permet de penser la neuroplasticité. Si nos pratiques contribuent à façonner les circuits que nous utilisons pour lire, cette plasticité n’est pas seulement une vulnérabilité. Elle est également une possibilité. Et c’est ici qu’une lecture toute récente peut nous faire voir l’argument de Wolf sous un autre angle.

De la neuroplasticité à la praxis

Dans l’édition du 23 août de l’infolettre Sentiers, Patrick Tanguay attire justement notre regard sur un essai de Matt Seybold au titre particulièrement suggestif : « Neuroplasticity as a Praxis ». Seybold y reprend notamment les travaux de Nicholas Carr et de Maryanne Wolf, mais les amène sur un terrain plus politique. Son point de départ est proche de celui qui nous occupe ici : puisque les circuits de la lecture sont construits plutôt que donnés, ils peuvent se développer, se modifier et aussi se fragiliser. Mais Seybold propose d’aller plus loin. La difficulté que nous pouvons éprouver aujourd’hui à lire profondément, à écouter attentivement et à discuter de manière critique ne devrait pas, selon lui, être comprise seulement comme le résultat de mauvaises habitudes individuelles. Elle doit aussi être replacée dans des environnements médiatiques, technologiques et économiques qui favorisent la captation et la monétisation de notre attention. La nuance est importante. Jusqu’ici, j’ai surtout demandé dans ce billet : que faisons-nous à notre cerveau lorsque nous lisons de cette manière?

Seybold nous conduit à ajouter une autre question : qui construit les environnements dans lesquels nous apprenons désormais à lire de cette manière? Son argument est explicitement politique. Selon lui, Carr et Wolf avaient bien compris que les technologies numériques pouvaient contribuer à remodeler nos pratiques cognitives, mais il et elle n’avaient peut-être pas suffisamment anticipé à quel point ce remodelage pourrait être orienté par des acteurs et des modèles économiques ayant intérêt à retenir et à monétiser notre attention. Seybold propose même le terme de deliberate deliteracy, que l’on pourrait traduire par « délittératie délibérée », pour désigner le démantèlement, la restriction ou la monopolisation des infrastructures qui rendent possible le maintien d’une littératie largement partagée.

Cette interprétation mérite certainement d’être discutée. Elle dépasse ce que les recherches empiriques sur les effets de la lecture numérique permettent à elles seules d’établir. Mais elle opère un changement de perspective qui me paraît particulièrement productif : la neuroplasticité cesse d’être seulement une question de cognition individuelle pour devenir aussi une question d’organisation collective.

Et surtout, Seybold retourne l’argument. Si notre cerveau lecteur demeure plastique, alors les environnements numériques ne sont pas les seuls à pouvoir le façonner. Nous pouvons aussi construire des pratiques, des institutions et des communautés qui exercent cette plasticité autrement. C’est ce qu’il entend par neuroplasticity as a praxis.

Dans son texte, lire attentivement n’est donc plus seulement une préparation à l’action. Lire, écouter et discuter deviennent eux-mêmes des formes d’action. Et pour que cette action dépasse l’effort de quelques individus tentant de résister seuls à l’économie de l’attention, elle doit, selon lui, devenir collective : groupes de lecture, cercles de discussion, séminaires, réseaux de prêt, communautés qui lisent et pensent ensemble. Or, cette approche m’intéresse particulièrement parce qu’elle rejoint, par un autre chemin, ce que j’essayais de montrer dans le billet précédent. Une société de lectrices et de lecteurs ne se construit pas toute seule. Les circuits neuronaux de la lecture non plus.

L’infrastructure de la lecture est aussi une infrastructure de l’attention

Cette rencontre entre Wolf et Seybold permet peut-être de réunir les trois billets de cette série. Le premier conduisait à un constat : la lecture ne disparaît pas; elle se recompose. Le deuxième ajoutait qu’une culture de la lecture n’existe jamais spontanément : elle dépend d’une infrastructure sociale, culturelle et institutionnelle qu’il faut entretenir. Celui-ci invite à en élargir encore la définition. Préserver l’accès aux livres et le désir de lire ne suffit peut-être pas : l’infrastructure de la lecture comprend aussi les conditions qui rendent certaines formes d’attention plus faciles à exercer, qui permettent de ralentir et de rester suffisamment longtemps avec un texte.

Le problème n’est donc peut-être pas simplement que nous lisions désormais sur des écrans. Il tient aussi à l’écologie dans laquelle se déroule une part croissante de nos activités numériques : vitesse, abondance, sollicitations et passage incessant d’un contenu à l’autre. Cette écologie n’est pas tombée du ciel. Elle est faite de plateformes, d’interfaces, de modèles économiques, de normes sociales et de choix technologiques. Penser l’infrastructure de la lecture à l’ère numérique suppose alors de s’intéresser aussi à ses conditions attentionnelles : les temps, les lieux, les dispositifs et les pratiques qui rendent possible une attention longue.

Certaines bibliothèques en offrent déjà des exemples intéressants. On voit notamment se multiplier les Silent Reading Parties (voir notamment la Seattle Public Library et la Richmond Public Library), où des personnes se réunissent avec le livre de leur choix pour lire ensemble, en silence, pendant une période réservée à cette seule activité. Il serait excessif d’en faire automatiquement des expériences de « lecture profonde » au sens où l’entend Wolf. Mais elles ont quelque chose de remarquable : elles organisent les conditions de l’attention. Ce qui pourrait sembler une activité strictement individuelle — s’asseoir et lire pendant une heure — devient une pratique soutenue par un lieu, un temps et la présence des autres.

D’autres initiatives interviennent plus directement sur notre rapport aux technologies. J’ai aussi lu, via Sentiers no. 413, que cet été, des ateliers intitulés Avoiding AI, d’abord développés par la bibliothécaire Hannah Cyrus dans le Maine puis repris dans d’autres bibliothèques américaines, ont connu un succès inattendu. On y explique le fonctionnement des outils d’intelligence artificielle, mais aussi comment désactiver les fonctionnalités que l’on ne souhaite pas utiliser. La démarche est intéressante parce qu’elle ne relève pas tant d’un rejet de la technologie que d’un projet de littératie informationnelle/numérique centré sur l’autonomie et le choix.

À première vue, lire silencieusement ensemble et apprendre à désactiver des fonctions d’IA peuvent sembler deux activités très éloignées. Elles ont pourtant quelque chose en commun : elles permettent de reprendre une certaine maîtrise de notre environnement attentionnel. La bibliothèque ne donne plus seulement accès aux textes, à l’information et aux technologies. À la manière d’un refuge, elle peut aussi offrir une certaine distance critique à leur égard : créer du temps pour lire sans sollicitation et donner les moyens de choisir quand et comment nous voulons utiliser les technologies qui nous entourent.

Le déplacement proposé par Seybold prend alors tout son sens. Protéger la possibilité d’une lecture profonde ne consisterait pas seulement à exhorter chacun et chacune à poser son téléphone et à lire davantage. Cela pourrait aussi vouloir dire organiser collectivement les conditions permettant de lire, d’écouter et de discuter attentivement.

On retrouve ici quelque chose de l’esprit de la littératie communautaire, qui envisage la lecture non seulement comme une compétence individuelle, mais comme une pratique sociale, située et partagée. La communauté peut ainsi devenir une communauté de lecture profonde : un espace où l’attention se soutient mutuellement, où les interprétations se confrontent et où le sens se construit avec d’autres. Les écoles et les universités ont évidemment une responsabilité comparable lorsqu’elles ménagent encore la possibilité de lire une œuvre entière plutôt que son résumé, de suivre un raisonnement plutôt que d’en extraire immédiatement quelques informations, de revenir à un texte plutôt que de simplement le traverser et, surtout, d’en discuter avec d’autres.

L’intelligence artificielle rend cet enjeu plus aigu encore. Elle nous permet désormais d’obtenir en quelques secondes le résumé, l’explication ou l’analyse d’un texte. Ce qui devient alors précieux n’est peut-être plus seulement l’accès au contenu, mais l’expérience cognitive et intellectuelle que nous acceptons d’accomplir nous-mêmes pour y parvenir. Lire un texte n’est pas seulement accéder à ce qu’il contient : c’est aussi exercer les opérations qui permettent de l’interpréter, de l’interroger, de le mettre en relation avec d’autres idées et, parfois, de résister à la facilité d’une réponse déjà produite.

La neuroplasticité nous rappelle que nos manières de lire ne sont pas immuables : elles se développent et s’exercent avec nos pratiques. Cela ne signifie pas, comme on l’a vu, que les écrans détériorent nécessairement nos capacités attentionnelles. Mais si certains environnements nous incitent à accélérer, à survoler ou à passer constamment d’un contenu à l’autre, nous pouvons aussi aménager des conditions qui facilitent le geste inverse : ralentir, s’attarder, relire, discuter. L’infrastructure de la lecture est, en ce sens, aussi une infrastructure de l’attention et re-littératie.

Apprendre à changer de régime de lecture

C’est pourquoi, pour revenir à celle-ci, la proposition de Wolf d’un cerveau bilittéracié me paraît particulièrement forte. Il ne s’agit pas de choisir entre Gutenberg et le numérique, ni de transformer le papier en étendard contre la modernité. Il s’agit de devenir capables de reconnaître les différents régimes de lecture et de passer consciemment de l’un à l’autre. Savoir quand parcourir. Quand chercher. Quand sélectionner. Mais aussi quand ralentir. Quand revenir. Quand relire. Quand s’attarder. Et peut-être faut-il désormais ajouter : quand lire ensemble.

Alors, pour reprendre la question du titre : que devient la lecture profonde à l’ère numérique? On pourrait dire, qu’elle ne disparaît pas, pas plus que la lecture elle-même. Mais elle ne va peut-être plus de soi. Dans un environnement qui nous entraîne souvent vers la vitesse, la sollicitation et le passage d’un contenu à l’autre, elle devient une pratique qu’il faut consciemment, intentionnellement, préserver, exercer et soutenir. Lire autrement, ce serait alors non pas renoncer au numérique, mais apprendre à choisir notre manière de lire : savoir profiter de la rapidité, de l’accès et de la puissance de recherche qu’il permet, tout en demeurant capables, lorsque le texte et la situation le demandent, de ralentir, de soutenir notre attention et d’aller en profondeur.

Mais cette capacité de choisir ne relève pas seulement de la volonté individuelle. Nous ne choisissons jamais nos régimes de lecture dans le vide. Les plateformes, les interfaces, les modèles économiques, les institutions et les espaces dans lesquels nous lisons organisent eux aussi notre attention : ils rendent certaines manières de lire plus faciles, plus habituelles ou plus désirables que d’autres.

L’actualité récente en offre une illustration frappante. Aux États-Unis, les poursuites engagées contre Meta ne portent plus seulement sur les contenus auxquels les jeunes sont exposés, mais sur la conception même des plateformes et de dispositifs destinés à maximiser l’engagement : défilement infini, lecture automatique, notifications, recommandations algorithmiques. Un jugement rendu au Nouveau-Mexique au début d’août, puis un important règlement conclu quelques semaines plus tard avec des États américains, imposent désormais à Meta des mesures qui interviennent directement sur cette architecture de l’attention.

Désormais, plutôt que de demander seulement aux individus de mieux gérer leur attention, il faut aussi examiner de manière critique les infrastructures qui la sollicitent, la captent et l’organisent. Défendre la possibilité d’une lecture profonde suppose alors non seulement de préserver certaines pratiques de lecture, mais aussi de transformer les environnements qui les fragilisent et d’en construire d’autres qui puissent les soutenir.

La question qui traverse finalement ces trois billets n’est donc peut-être pas : allons-nous continuer à lire? Elle serait plutôt : quelles formes de lecture voulons-nous préserver, et quelles infrastructures devons-nous transformer ou construire collectivement pour continuer à en être capables?

Car une société de lectrices et de lecteurs ne se construit pas toute seule. Une société capable de lecture profonde non plus.

Bonne rentrée!

Bill Gates plaide pour une réglementation plus stricte de l’IA

26 août 2026 à 20:42

Le fondateur de Microsoft croit que l’intelligence artificielle présente un défi «monumental» pour l’humanité.

Dans un long essai publié en ligne et dont la portée est amplifiée par une entrevue qu’il a donnée au New York Times, le célèbre entrepreneur devenu philanthrope fait plusieurs suggestions dont:

  • imposer une taxe pour décourager les organisations de remplacer des employés par l’IA – et distribuer les fonds ainsi perçus aux travailleurs qui auront perdu leur emploi à cause de l’IA;
  • réserver certaines tâches aux humains en interdisant qu’elles soient confiées à l’IA ou à des robots.

[L'article Bill Gates plaide pour une réglementation plus stricte de l’IA a d'abord été publié dans InfoBref.]

Presque tous les principaux partis au Québec adhèrent à un code de conduite sur l’IA 

24 août 2026 à 20:54

Ivado, un consortium de recherche en intelligence artificielle piloté par l’Université de Montréal, a créé l’automne dernier un code visant à encadrer un usage responsable de l’IA en politique.

En adhérant au code, les partis s’engagent notamment à: 

  • favoriser la transparence; 
  • limiter les risques liés aux hypertrucages et aux contenus trompeurs. 

La Caq et Québec solidaire avaient adhéré à ce code de conduite en mars dernier. 

Le Parti québécois et le Parti libéral du Québec viennent de signer. 

Le Parti conservateur du Québec est le seul à ne pas adhérer au code.

[L'article Presque tous les principaux partis au Québec adhèrent à un code de conduite sur l’IA  a d'abord été publié dans InfoBref.]

L’intelligence artificielle, un danger pour la santé?

19 août 2026 à 23:38

Selon un sondage de l’Association médicale canadienne (AMC) réalisé cette année, un peu plus de la moitié des Canadiens utilisent des outils d’intelligence artificielle comme ChatGPT pour obtenir des conseils sur leur santé.

Toutefois, les personnes qui suivent ces conseils courent des risques de subir des effets néfastes.

  • Beaucoup de répondants du sondage en sont conscients.

Le Dr Jean-Joseph Condé, porte-parole de l’AMC, explique à InfoBref que l’IA a tendance à construire des réponses selon les informations dominantes qu’elle trouve sur le web – que ces informations soient vraies ou non. 


La facilité d’utilisation des robots conversationnels d’IA pousse beaucoup de personnes à s’en servir, croit Jean-Joseph Condé.

«Avant, les gens devaient chercher des articles, puis les lire et analyser l’information. Aujourd’hui, l’intelligence artificielle fait toutes ces tâches pour eux.»

Impacts nocifs de l’IA

Le médecin identifie plusieurs impacts nocifs sur la santé que peut avoir l’information fournie par les robots d’IA.

L’information que génère l’IA n’est pas nécessairement exacte.

«On ne sait pas toujours d’où vient l’information, dit Dr Condé. C’est dangereux sachant qu’elle peut provenir de sources erronées.»

Il souligne un paradoxe: 69% des répondants au sondage de l’AMC éprouvent de la méfiance à l’égard des informations de santé trouvées en ligne, comme celle trouvées à l’aide de l’IA.

Les traitements prescrits ou recommandés par des professionnels de la santé ne sont pas toujours respectés par les patients qui utilisent l’IA.

L’expert note que l’IA peut même pousser des personnes à arrêter des traitements médicaux vitaux, comme la chimiothérapie ou le traitement du diabète, pour se tourner vers des produits ou des méthodes non prouvés scientifiquement.

L’anxiété générée par les réponses de l’IA est un autre problème.

Le Dr Condé explique que l’intelligence artificielle exacerbe un problème qui existait déjà depuis l’apparition des moteurs de recherche comme Google:

  • «Les patients qui cherchent sur Internet les causes de leurs symptômes, même bénins, peuvent avoir tendance à s’autodiagnostiquer des maladies graves.» 

Ce phénomène a pris de l’ampleur avec les robots d’IA, qui donnent des réponses en apparence complètes plus rapidement que les moteurs de recherche traditionnels.

Pistes de solutions

L’information diffusée sur Internet pourrait être mieux contrôlée par les géants du web et par le gouvernement, afin d’éviter la propagation de fausses informations, estime Jean-Joseph Condé.

L’accès aux soins de santé doit aussi être amélioré, dit le médecin.

Il note qu’environ 6,5 millions de Canadiens et 2 millions de Québécois n’ont pas de médecin de famille.

Selon lui, pour améliorer l’accès aux soins de première ligne, le système de santé devrait se concentrer sur le développement d’équipes multidisciplinaires incluant des infirmières, physiothérapeutes et pharmaciens.

La productivité des médecins pourrait, en parallèle, s’améliorer grâce aux bénéfices de l’IA, croit le médecin.

  • Il note que moins du tiers des médecins utilisent actuellement l’IA pour les aider à réaliser des tâches administratives.

[L'article L’intelligence artificielle, un danger pour la santé? a d'abord été publié dans InfoBref.]

  • ✇bibliomancienne
  •  Vers une société postlittéraire? Retour sur « la fin de la lecture » annoncée par Rose Horowitch
    Les discussions récentes autour du déclin de la lecture et l’échange que j’ai eu avec Alexandre Sirois m’ont donné envie de revenir sur une question qui me préoccupe depuis un certain temps déjà : sommes-nous réellement en train de devenir une société qui lit moins? Un article récent de The Atlantic, « The End of Reading Is Here » établit le diagnostic de manière particulièrement saisissante en évoquant l’entrée dans une possible « ère postlittéraire ». L’article qu’Alexandre Sirois lui a
     

 Vers une société postlittéraire? Retour sur « la fin de la lecture » annoncée par Rose Horowitch

14 août 2026 à 09:50

Les discussions récentes autour du déclin de la lecture et l’échange que j’ai eu avec Alexandre Sirois m’ont donné envie de revenir sur une question qui me préoccupe depuis un certain temps déjà : sommes-nous réellement en train de devenir une société qui lit moins?

Un article récent de The Atlantic, « The End of Reading Is Here » établit le diagnostic de manière particulièrement saisissante en évoquant l’entrée dans une possible « ère postlittéraire ». L’article qu’Alexandre Sirois lui a consacré dans La Presse, à l’occasion du 12 août, contribue malgré tout à déplacer la réflexion vers une autre question : quelles conditions devons-nous préserver ou créer pour demeurer une société de lecteurs et de lectrices?

Je propose donc d’explorer ces enjeux en trois billets avant que la rentrée nous happe. Le premier reviendra sur le diagnostic de Rose Horowitch et sur cette idée forte d’une société « post-littéraire » ou « post-lettrée ». C’est l’article d’Alexandre Sirois qui servira de déclencheur pour le deuxième, notamment pour s’intéresser aux conditions collectives de la lecture — bibliothèques, écoles, librairies, familles, organismes et politiques publiques. Enfin, le troisième s’appuiera notamment sur les travaux de Maryanne Wolf et Naomi Baron, deux autrices que je présente régulièrement dans mes cours, pour examiner ce que le numérique, les écrans et, désormais, l’intelligence artificielle changent à nos façons de lire, à notre attention et à notre capacité à entrer dans une lecture profonde.

L’objectif n’est donc pas d’annoncer, encore une fois!, la fin de la lecture ou la mort du livre, pas plus que de céder à la nostalgie du papier. Je voudrais simplement contribuer à cette conversation pour mieux comprendre les transformations en cours et réfléchir aux conditions qui pourraient permettre à la lecture et à la pensée de conserver une fonction importante dans nos vies individuelles et collectives.


Il n’est pas nécessaire de brûler les livres pour qu’ils disparaissent de nos vies. Il suffit, suggérait Ray Bradbury en 1993 dans le Seattle Times, que nous cessions de les lire (« You don’t have to burn books to destroy a culture. Just get people to stop reading them. »). Cette formule prend une résonance particulière à la lecture du long article que Rose Horowitch vient de consacrer, dans The Atlantic, et à ce qu’elle présente comme une transformation historique : l’entrée possible dans une société « postlittéraire ». Le titre donne le ton : The End of Reading Is Here. La fin de la lecture serait arrivée. (Étonnamment, cette célèbre formule de Bradbury ne traverse pas l’article de Horowitch, alors qu’elle semble planer sur tout le diagnostic qu’elle prononce).

L’affirmation est spectaculaire. Elle mérite qu’on s’y arrête, mais aussi qu’on la nuance. Car Horowitch ne soutient pas que nous serions soudainement devenus incapables de lire. Nous n’avons probablement jamais été exposés à autant de mots : textos, courriels, publications sur les réseaux sociaux, notifications, fils de discussion, nouvelles en ligne et tutti quanti. Nous passons une bonne partie de nos journées à lire quelque chose.

Son inquiétude porte sur une autre forme de lecture, la lecture profonde : celle qui demande de rester longtemps avec un texte, de suivre un raisonnement, de tolérer momentanément de ne pas comprendre puis de revenir en arrière, d’interpréter, de faire des inférences et de construire progressivement du sens. Autrement dit, la question n’est peut-être pas simplement : lisons-nous moins? Elle pourrait plutôt être : Avons-nous encore la disposition et la capacité nécessaires pour lire de manière profonde?

Une société qui sait lire, mais qui lit autrement

Horowitch rassemble une série de données américaines inquiétantes : recul de la lecture de livres et de la lecture pour le plaisir, diminution de certaines compétences en compréhension, difficultés croissantes devant des textes complexes, chez les jeunes comme chez les adultes. Mais son argument devient beaucoup plus intéressant lorsqu’elle distingue l’alphabétisation, la littératie et la culture de l’écrit.

Une société « postlittéraire » n’est pas nécessairement une société peu alphabétisée. C’est une société dans laquelle les individus savent toujours lire, mais où la lecture longue et soutenue cesse progressivement d’occuper un rôle central dans la vie culturelle et intellectuelle. La thèse de Horowitch va cependant plus loin : la lecture longue tendrait à devenir une pratique encore plus minoritaire et, ce faisant, à perdre la fonction structurante qu’elle aurait longtemps exercée dans la culture commune. Le problème ne serait donc pas seulement que certains individus lisent moins, mais que cette forme de lecture soit de moins en moins largement partagée.

C’est une distinction importante. Décoder un texte, le comprendre, l’interpréter et penser avec lui ne sont pas exactement la même chose.

Horowitch s’appuie ici sur une archéologie de la lecture. L’être humain n’est pas né lecteur. L’écriture et la lecture sont des technologies culturelles que nous avons apprises et qui, en retour, ont contribué à transformer nos manières de penser. La culture écrite a notamment favorisé certaines pratiques intellectuelles : suivre un raisonnement sur plusieurs pages, confronter des propositions, revenir sur une idée, comparer des passages, construire une argumentation, maintenir son attention malgré la difficulté. D’où une des hypothèses centrales de l’article, qui vaut la peine d’être prise au sérieux : si l’apprentissage de la lecture a transformé nos manières de penser, que pourrait produire son recul?

Du livre à TikTok : une nouvelle économie de l’attention

Horowitch poursuit son argumentaire en soulignant que cette inquiétude n’est évidemment pas nouvelle. Elle réfère à Marshall McLuhan qui annonçait déjà dans La galaxie Gutenberg (The Gutenberg Galaxy), en 1962, que les médias électroniques allaient ébranler la domination culturelle de l’imprimé. Neil Postman poursuivait cette réflexion dans Se distraire à en mourir (Amusing Ourselves to Death) en 1985. Mais quelque chose a changé d’échelle.

La télévision devait encore être allumée; ses programmes avaient un début et une fin. Le téléphone intelligent, lui, nous accompagne partout et donne accès à une offre de divertissement pratiquement illimitée. Et Internet lui-même se reconfigure. L’univers numérique des débuts était largement textuel. Une part croissante de l’attention est désormais captée par TikTok, les Reels, YouTube Shorts et d’autres formats audiovisuels courts. Le changement ne consiste donc plus seulement à dire que les écrans concurrencent les livres. C’est le statut du texte lui-même dans notre environnement informationnel qui est toujours un peu plus en décalage.

Horowitch décrit alors une sorte de cercle vicieux : moins de lecture longue et profonde → moins d’endurance attentionnelle → davantage de difficulté à lire des textes complexes → moins de plaisir à les lire → encore moins de lecture longue.

L’hypothèse est préoccupante, notamment pour l’école. Si l’on rencontre de moins en moins souvent des œuvres intégrales et des textes exigeants, comment développe-t-on les capacités — voire les circuits neuronaux — qui permettent de les lire en profondeur et de penser de manière critique?

Et maintenant, l’IA

L’arrivée de l’intelligence artificielle générative ajoute une dimension nouvelle au problème. Jusqu’ici, les technologies numériques permettaient surtout de contourner l’effort de la lecture longue. L’IA permet maintenant de déléguer une partie de l’écriture elle-même : résumer un texte, produire une argumentation, reformuler une idée, voire lire une œuvre à notre place pour nous en restituer « l’essentiel ». Or, écrire n’est pas seulement transcrire une pensée déjà constituée.

Nous écrivons aussi pour découvrir ce que nous pensons. Ce carnet, pour moi, a souvent joué ce rôle, comme d’autres avant lui : c’était le « vide-grenier », mais aussi l’atelier, le lieu où les concepts se déposent, se cherchent, se frottent les uns aux autres et, parfois, émergent. Chercher un mot, organiser un argumentaire, supprimer une phrase, critiquer : tout cela participe au travail de la pensée. La question posée par l’IA devient alors particulièrement intéressante : que se passe-t-il lorsque nous pouvons externaliser non seulement une partie de la lecture, mais aussi une partie de l’effort nécessaire pour étayer notre pensée? C’est probablement l’une des questions les plus fécondes soulevées par l’article.

De la lecture à la démocratie : attention aux raccourcis

Horowitch va cependant encore plus loin. Elle suggère la présence d’un lien entre le recul de la culture écrite et des évolutions récentes du discours politique. Dans un environnement dominé par l’immédiateté, les algorithmes et les contenus courts, les messages simples, polarisants, personnalisés et émotionnellement chargés disposeraient d’un avantage considérable. Donald Trump devient, dans son analyse, une figure emblématique de cette politique « postlittéraire ». Cette hypothèse est intéressante et appelle une discussion; c’est aussi à cet endroit que l’article appelle peut-être davantage de distance critique.

Car il y a une différence entre constater des changements bien documentés de nos pratiques médiatiques et attentionnelles et leur attribuer directement des basculements aussi complexes que celles de la démocratie et de la vie politique. Plus généralement, le passage de « nos pratiques de lecture se transforment » à « nous entrons dans une société postlittéraire » constitue un saut et une interprétation beaucoup plus ambitieuse que ce que les données qu’elle présente le démontrent à elles seules.

Et au Québec?

C’est également ici qu’il faut résister à la tentation de transposer directement au Québec le diagnostic très américain que dresse l’autrice. Les données québécoises récentes offrent un portrait relativement nuancé par rapport à celles des États-Unis. Selon l’Enquête québécoise sur les loisirs culturels et le divertissement de 2024, que j’ai consultée et partagée avec un grand intérêt, 82 % des Québécois et Québécoises de 15 ans et plus déclarent avoir lu au moins un livre, papier ou numérique, dans leurs temps libres au cours des douze mois précédents. Dans l’ensemble de la population, 23 % lisent tous les jours ou presque et 19 % au moins une fois par semaine.

Une comparaison avec les États-Unis donne néanmoins un point de repère, à condition de rester prudents : les deux enquêtes ne portent pas exactement sur les mêmes populations et ne mesurent pas la lecture de la même manière. Le National Endowment for the Arts rapporte, à partir de sa Survey of Public Participation in the Arts, qu’en 2022, 48,5 % des adultes américains avaient lu au moins un livre au cours de l’année, contre 52,7 % en 2017 et 54,6 % en 2012. La lecture de fiction, soit de romans ou de nouvelles (novels or short stories) est, elle aussi, passée de 45,2 % en 2012 à 37,6 % en 2022. Il serait donc trompeur d’opposer directement le 82 % québécois au 48,5 % américain. Ces données permettent néanmoins de constater que le portrait québécois ne correspond pas, du moins pour l’instant, au même scénario de recul généralisé.

Le portrait devient encore plus intéressant lorsqu’on regarde du côté des jeunes. Au Québec, les 15-29 ans ne sont pas ceux qui lisent le moins : 86 % disent avoir lu au moins un livre au cours des douze mois précédents, soit la même proportion que chez les 30-44 ans. Mais la situation change lorsqu’on s’intéresse à la fréquence : seulement 17 % des 15-29 ans lisent tous les jours ou presque, comparativement à 30 % chez les 60-74 ans.

Dans le contexte de la journée « Le 12 août, j’achète un livre québécois », ce constat prend toutefois une autre dimension. Car si les jeunes du Québec lisent bel et bien, la question est aussi de savoir ce qu’ils et elles lisent et quelle importance ils et elles accordent aux livres québécois. Les données disponibles suggèrent en effet que les jeunes générations sont moins portées à privilégier les œuvres d’ici que les générations précédentes. L’enjeu n’est donc pas seulement de maintenir la lecture chez les jeunes, mais aussi de faire en sorte que la littérature québécoise s’inscrive dans leurs pratiques et leurs univers culturels.

Les supports, eux aussi, évoluent. Au Québec, 26 % de la population lit des livres numériques et 15 % écoute des livres audio. Ces pratiques sont nettement plus répandues chez les 15-29 ans : 36 % lisent des livres numériques et 21 % écoutent des livres audio. Là encore, ces données invitent à se méfier du récit trop simple de « la fin de la lecture ».

Voilà qui nous ramène plus précisément au troublant problème soulevé par The Atlantic. Les jeunes, comme les moins jeunes, n’ont pas cessé de lire. La question est plutôt celle de l’intensité, de la régularité et, peut-être, de l’endurance de cette pratique. Autrement dit, ce qui pourrait se fragiliser n’est pas nécessairement le contact avec le livre, encore moins la capacité de lire, mais la présence de la lecture profonde dans la vie quotidienne.

Nous sommes donc vraisemblablement moins devant une « fin de la lecture » que devant une recomposition des pratiques de lecture : ce que nous lisons, sur quels supports, à quelle fréquence, pendant combien de temps, avec quel degré d’attention et au milieu de quelles autres sollicitations. C’est peut-être là que se situe le véritable déplacement : non pas dans la disparition de la lecture, mais dans la fragilisation de la lecture soutenue ou profonde.

Alexandrie à l’envers

L’image la plus puissante, selon moi, de l’article de Horowitch est peut-être celle par laquelle il commence et se termine : la bibliothèque d’Alexandrie. Pendant des siècles, l’un des grands problèmes des sociétés lettrées a été de préserver les textes. Des manuscrits disparaissaient, des bibliothèques brûlaient, des œuvres devenaient inaccessibles. Or, nous nous trouvons aujourd’hui dans une situation presque inverse. Jamais autant de textes n’ont été aussi facilement accessibles. Des « bibliothèques » entières tiennent dans un téléphone. La question n’est donc plus seulement : Comment préserver les livres? Elle devient : Comment préserver les conditions qui donnent envie de les lire et permettent de le faire?

C’est là que je m’éloignerais le plus catégoriquement du diagnostic de « la fin de la lecture ». La lecture n’a pas disparu. Pas encore, en tout cas. Mais il devient nécessaire et urgent de soutenir plus activement les conditions de la lecture longue, attentive et exigeante, dans un environnement qui offre en permanence des solutions plus rapides et plus immédiatement gratifiantes.

Et cette responsabilité ne dépend pas seulement de la volonté individuelle des personnes lectrices, dimension sur laquelle insiste davantage, sinon trop, Horowitch. Une société de lecteurs et de lectrices ne se maintient pas toute seule. Elle repose sur des familles, des écoles, des bibliothèques, des librairies, des maisons d’édition, des médiateurs, des médiatrices et des communautés qui rendent les livres accessibles, mais surtout visibles, désirables, partageables et aptes à nourrir la conversation. C’est d’ailleurs l’une des nuances importantes à apporter au récit de « la fin de la lecture » : la lecture est une pratique sociale, et non seulement une compétence ou une disposition individuelle.

Ce serait l’objet d’un prochain billet : si nous voulons demeurer une société de lecteurs et de lectrices, quelle écologie de la lecture devons-nous entretenir?

❌