Connexion
«C’est comme si l’IA avait tiré le tapis sous les pieds des mathématiciens»
10 octobre 2026 à 00:00
OpenAI vient de dévoiler les résultats de plus de 370 problèmes mathématiques coriaces.


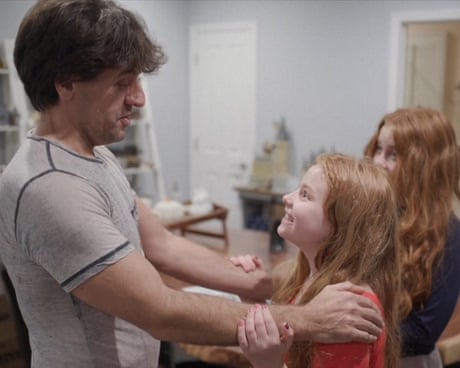
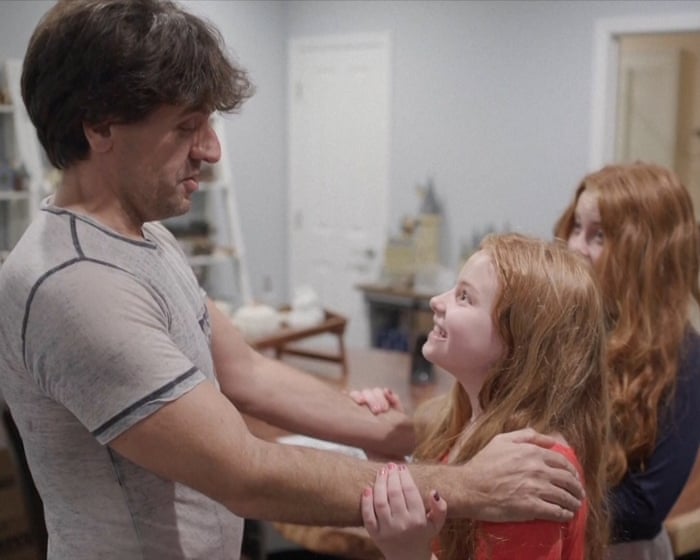
Stanford University has shared a video of Karl Deisseroth telling his two daughters and one of his sons he has won a Nobel prize in medicine.
Deisseroth spent hours fielding congratulatory calls on Monday after learning he had won the prize for helping to open a field of brain science called optogenetics. But it wasn't long before the California scientist asked for a break for a more ordinary task: he needed to make school lunches for his children who were asleep in the family home in Stanford where he had been speaking to journalists and wellwishers in the middle of the night.
Deisseroth, 54, shares the prize with two researchers in Germany for their work in optogenetics, a field that combines light with genes to switch neurons on and off in living brains
Continue reading...
© Photograph: Stanford University via AP
© Photograph: Stanford University via AP
© Photograph: Stanford University via AP

© Leah Willingham/Associated Press
Les presses du MIT publient ce jour le nouvel ouvrage de Ben Green, Algorithmic Realism : Data Science Practices to Promote Social Justice. Ben Green, on vous a déjà parlé de lui. En 2019, on avait longuement évoqué son précédent livre, The smart enough city, où il revenait sur son expérience de data scientist dans plusieurs villes américaines. Green plaidait déjà pour améliorer la responsabilité sociale des technologies, à l’épreuve des pratiques concrètes des responsables de l’innovation urbaine promouvant une innovation démocratique.
C’est ce chemin qu’il poursuit dans son nouveau livre, qui n’est pas un essai, mais un manuel à destination des responsables des données. Il rappelle que depuis qu’il est diplômé, il n’a cessé d’essayer d’appliquer la data science pour créer une société plus équitable. Mais avoir un impact positif s’est avéré bien plus difficile qu’espéré. A Memphis, par exemple, les outils qu’il avait participé à mettre au point pour aider la ville à identifier des logements à rénover ont été abandonnés après le départ de l’équipe qui les avait développé. Malgré ces expériences pas toujours concluantes, il s’est rendu compte que pour avoir un impact, il était nécessaire de désapprendre beaucoup de certitudes et d’habitudes que sa formation en data science lui avait enseigné. A Boston, par exemple, il devait travailler avec les services d’urgence pour trouver des stratégies pour améliorer la rapidité d’intervention. Or, plutôt que de trouver une astuce pour mieux répartir les ambulances dans la ville, Green a constaté dans les données, que l’essentiel des déplacements n’étaient pas nécessairement un besoin de soins médicaux d’urgence, mais une demande de services sociaux que les services d’urgence n’étaient pas en mesure de fournir mais accomplissaient quand même. Avec les services d’urgence, il a alors proposé de créer une équipe dédiée. Une réponse d’autant plus adaptée que les interventions auprès des publics en difficultés, des toxicos et des SDF, ou de ceux souffrant de problèmes de santé mentale, se concentraient sur certains quartiers sensibles, avec un pic en fin d’après-midi et en début de soirée. La création d’une équipe d’assistance communautaire a ainsi permis de répondre à la demande initiale. Elle a permis d’apporter de meilleurs soins à des publics en difficulté et elle a libéré des ambulances pouvant répondre plus rapidement lors de prises en charges médicales urgentes. Cette expérience a été fondatrice. Elle lui a enseigné trois tactiques qu’il applique depuis à tous les projets qu’il rencontre. D’abord, étudier en profondeur les défis sociaux et opérationnels des services avant d’analyser la moindre donnée. La seconde consiste à se concentrer sur les besoins exprimés pour produire des impacts réels et pas seulement des solutions algorithmiques. Pour Green, les analyses de données les plus sophistiquées ne conduisent pas à de meilleurs impacts. Les résultats de la science des données doivent être choisis en fonction de leur capacité à faire progresser les objectifs du projet, peu importe leur simplicité ou leur complexité. Le troisième enseignement, c’est qu’un data scientist isolé ne sert à rien. Améliorer les politiques publiques avec la data science nécessite des activités qui ne relèvent pas de la data science. « Pour surmonter ces défis, il m’a fallu étudier des problèmes de société, me familiariser avec les processus de travail des organismes publics et traduire une analyse technique en pratiques opérationnelles. Aucun de mes cours de science des données n’avait jamais ne serait-ce qu’évoqué ces tâches, et encore moins enseigné comment les accomplir. »
Concevoir des algorithmes susceptibles d’améliorer la société n’est pas si simple. Comme on le répète ici, les calculs sont plus souvent défaillants qu’autre chose. Certainement parce que les méthodologies de la science des données n’offrent pas de méthode pour se faire, avance Green. D’où l’enjeu de ce manuel : apporter une nouvelle approche de la data science pour orienter les scientifiques des données vers la promotion de la justice sociale. En fait, souligne Green, les méthodes actuelles que mobilisent les data scientist ne leur permettent pas d’œuvrer pour le bien commun. Cette méthode actuelle, Green l’appelle le « formalisme algorithmique ». Et pour lui, elle est profondément problématique. Il propose d’en bâtir une autre : le « réalisme algorithmique ». Et son livre se veut une boîte à outils pour changer de méthode, pour changer la façon dont se déploie la data science.
« Transformer la science des données, en passant d’une méthodologie formaliste axée sur des modèles mathématiques à une méthodologie pratique axée sur des problèmes du monde réel », c’est ce que propose Green. La science des données est un champ relativement récent, né dans les années 2010, même si elle s’est construite sur des idées et des pratiques qui ont une longue histoire, rappelle-t-il. Le formalisme algorithmique est une méthodologie qui repose sur la propriété mathématique des algorithmes. Où qu’elles se déploient, les méthodologies formalistes restreignent le champ de l’analyse aux propriétés intrinsèques de leur objet, en excluant les éléments extérieurs tels que le contexte social et l’interprétation. Le formalisme algorithmique occulte le contexte social entourant les algorithmes, les garanties formelles de performance ne sont valides qu’au regard du comportement technique de l’algorithme – et non de ses usages et de ses impacts en pratique. En la matière, ces méthodes font obstacle à toute tentative d’aborder des problèmes sociaux et politiques complexes. Le formalisme procède d’une « réduction du champ de vision », rappelle le politologue James Scott dans son livre, L’œil de l’Etat (La découverte, 2021). Le formalisme tend à renforcer les hiérarchies, expliquent Geoffrey Bowker et Susan Leigh Star dans Arranger les choses (EHESS, 2023). Il peut sembler neutre et technique, mais le formalisme a souvent des conséquences pour les groupes marginalisés. Le problème est que le formalisme « caractérise le milieu intellectuel dans lequel évoluent les data scientists » et empêche d’adopter d’autres approches. Ce formalisme a des conséquences très directes : il privilégie les critères d’exactitude et d’efficacité ainsi que l’amélioration des prédictions.
D’ailleurs, les revues comme les conférences du secteur pénalisent souvent les recherches axées sur les applications et les résultats concrets, préférant les travaux qui améliorent les méthodes de calcul. Il conduit à minimiser les dommages potentiels causés par les systèmes algorithmiques et conduit à ne pas regarder les réalités de leurs mise en œuvre, à surestimer les bénéfices et à sous-estimer les nuisances. C’est le cas par exemple de Compas, le système de prédiction du risque de récidive américain. Ses promoteurs estimaient qu’en se fondant sur des évaluations formalistes, leur outil permettrait de réduire le recours à la détention provisoire et les disparités raciales. Or, les évaluations réalisées après la mise en œuvre du système algorithmique ont montré que ces améliorations ne s’étaient pas concrétisées. « Cet écart entre les évaluations formalistes et la réalité du terrain découlait de la manière dont les juges utilisaient les évaluations des risques ». L’évaluation du risque, sous forme d’infrastructures d’abstraction, a exacerbé plutôt que réduit les disparités raciales en matière de détention provisoire, parce que les ingénieurs de Northpointe, les développeurs de Compas, n’ont pas pris en compte la manière dont ils seraient utilisés (sur ces enjeux, voire également les livres de Jathan Sadowski, de Arvind Narayanan et Sayash Kapoor ou encore de Nathan Genicot dont nous avons déjà parlé ici et qui abordent tous ces questions sous un angle ou un autre).
Pour Green, la data science souffre d’une forme de « clôture mathématique », enclose sur elle-même, renforcée par une tendance à « l’universalisme abstrait », où le monde réel pourrait se réduire uniquement à des mathématiques. Cet universalisme abstrait pousse les data scientists à appliquer des algorithmes comme solution à tous les problèmes sociaux, sans prendre en compte les particularités de ses déploiements.
« Le problème est que, bien que ces représentations par substitution rendent le problème plus facilement traitable mathématiquement, elles suppriment généralement des éléments essentiels du contexte réel ». Cela conduit à des simplifications excessives et à de mauvaises interprétations, comme quand on tente d’évaluer les enseignants en fonction des résultats scolaires de leurs élèves. La qualité de l’enseignement se réduit alors à l’amélioration des résultats des élèves, comme le montrait Cathy O’Neil dans son livre, Algorithmes, la bombe à retardement (Les Arènes, 2018). Enfin, le formalisme algorithmique tend à faire croire que la data science et le calcul seraient politiquement neutres et que les scientifiques seraient objectifs, comme le dénonçaient déjà danah boyd et Kate Crawford en 2011 dans leurs 6 provocations à l’encontre des Big Data. Croire que la science des données produit des connaissances objectives tend à renforcer la minimisation des enjeux sociaux et éthiques des calculs, jugés comme non pertinents et dépourvus de rigueur. « Dans la recherche en science des données, la priorité est donnée aux contributions techniques, supposées apolitiques. Les revues et les conférences attendent des chercheurs qu’ils justifient leurs travaux sous l’angle de la performance et de la nouveauté plutôt que par rapport aux besoins de la société », comme le montrait une remarquable analyse des valeurs encodées dans les articles de recherche du secteur.
« La neutralité politique conduit les data scientists à négliger les inégalités structurelles et les contestations politiques sous-jacentes aux enjeux sociaux ». C’est par exemple l’écueil de la police prédictive, qui exacerbe et légitime la discrimination systémique inhérente à l’action policière.
Pour Green, ce formalisme exacerbé a généré une crise morale de la discipline. À mesure que les algorithmes se généralisaient et gagnaient en influence au sein de la société, les approches critiques ont alors gagné en visibilité à mesure que montaient les controverses et les injustices. Peu à peu, la question de l’éthique est devenue un domaine influent de la science des données, en valorisant la question de l’équité (c’est-à-dire en valorisant des définitions mathématiques de la prise de décision équitable) et de l’explicabilité. Cet accent mis sur l’éthique a orienté la science des données dans des directions productives, reconnaît Green, en attirant l’attention sur les impacts sociaux des calculs. Mais pour Green, cette éthique repose trop souvent sur une approche formaliste également. Elle réduit l’éthique à une question d’amélioration du calcul, comme le remarquait déjà le sociologue Bilel Benbouzid. Pour Green, « l’éthique des données ne permet pas de produire de manière fiable des algorithmes équitables. Même lorsque les algorithmes satisfont aux définitions techniques des idéaux éthiques, ils peuvent néanmoins s’avérer nuisibles en pratique. » Pour lui, le formalisme algorithmique conduit la science des données dans une impasse. Il manque une méthodologie plus pratique pour se faire.
Pour dépasser ces limites, il est nécessaire de passer du formalisme au réalisme. « Le critère ultime des attributs d’un algorithme réside dans les impacts qu’il génère en pratique. Autrement dit, quelles que soient les propriétés mathématiques formelles d’un algorithme, ses effets concrets priment sur l’évaluation de sa qualité et de son utilité sociale. Par ce principe, le réalisme algorithmique vise à promouvoir une science des données réaliste, attentive aux usages et conséquences réels des algorithmes. » Pour le dire concrètement, nombre de services permettant d’attribuer des places dans le supérieur reposent sur l’algorithme dit des mariages stables de Gale et Shapley. Pourtant, la manière de l’implémenter est partout différente et produit des effets spécifiques, notamment parce que ses adaptations n’en respectent pas toujours les principes. Parcoursup comme son ancêtre, APB, en relevaient. Ce n’est pas pour autant qu’ils l’ont implémenté dans les règles de l’art.
Pour produire une véritable data for good, pour servir l’intérêt général par les données, alors « la justice sociale doit devenir la mission centrale de la science des données », estime Green. Pour cela, il faut changer la science des données, afin que « faire une bonne data science (doing good data science) devienne synonyme de faire le bien avec la data science (doing good with data science) ». Pour cela, il faut dépasser les attributs techniques d’un algorithme, pour se concentrer sur son rôle et ses impacts dans le contexte de son utilisation. « Les data scientists doivent donc porter leur regard vers l’extérieur : passer du fonctionnement interne des algorithmes au monde dans lequel ils opèrent.» Ils doivent concentrer leur regard sur les effets instrumentaux des systèmes, leurs impacts concrets plus que leurs performances. Pour Green, cela consiste à prendre en compte le changement social. L’enjeu par exemple ne serait plus de produire un calcul pour déterminer quels élèves risquent de décrocher pour améliorer le taux d’obtention d’un diplôme, mais à se demander comment améliorer les efforts de prévention du décrochage scolaire. « Il s’agit de développer des algorithmes qui favorisent des résultats éthiques au sein de la société.»
Green expose longuement son plan de travail concret. C’est-à-dire un nouveau « flux de travail pour la science des données » (data science workflow), c’est-à-dire un processus de travail concret qui passe par la délimitation du problème, la délimitation du projet, l’analyse des données, la mise en œuvre et l’évaluation. Et pour mettre en œuvre ce processus, les data scientists doivent apprendre à mieux collaborer avec les acteurs du terrain, plutôt qu’à produire leurs solutions en chambre. Ils doivent discuter avec ceux qui sont impactés par les systèmes, ceux qui les mettent en place pour mieux saisir les enjeux qui sont les leurs. « Le réalisme algorithmique n’exige pas des data scientists qu’ils abandonnent leurs compétences techniques, mais il souligne qu’ils ont besoin de plus que ces seules compétences. Ainsi, les data scientists ne devraient pas se définir uniquement comme des experts techniques sachant analyser des données. Au contraire, ils devraient s’efforcer d’être des stratèges de la donnée, aidant de manière créative les personnes et les organisations à utiliser les données pour relever des défis du monde réel ». Green tente ici de dresser une piste pour que les scientifiques de la données arrêtent de produire du technosolutionnisme. Il invite les ingénieurs à se défaire de l’hubris ingénieuriale, comme il le disait ailleurs. A prendre conscience que leurs solutions sont bien souvent inadaptées, toutes formidables qu’ils les trouvent. Et pour cela, il faut changer l’approche de la discipline elle-même.
Pour Green, cette réorientation est aussi une réponse à l’automatisation qui dévalorise l’expertise des data scientistes. A l’heure où l’IA générative va produire la plupart du code, le réalisme algorithmique permet de prémunir la discipline contre l’automatisation. En devenant stratèges de la données, leur rôle n’est pas seulement de programmer, mais vise à « aider les organisations à définir des stratégies pour tirer parti des données et des algorithmes afin de répondre à leurs défis concrets ». « Les data scientists cherchent rarement à s’attaquer aux inégalités structurelles, préférant se contenter d’optimiser les procédures décisionnelles existantes. Le réalisme algorithmique inverse ces tendances. Il incite les data scientists à modérer leurs ambitions quant à ce que les algorithmes peuvent accomplir seuls, tout en les encourageant à viser plus haut dans la poursuite de réformes sociales et politiques systémiques », promouvant la justice sociale.
Pourtant, prévient Green, la justice sociale est un sujet complexe et controversé. Il n’existe pas de réponse unique ou évidente quant à la manière de parvenir à la justice dans chaque situation… Et il n’est pas sûr que toutes leurs interventions y parviennent. Reste que pour lui, il faut parvenir à sortir de la lutte contre les injustices engendrées par les algorithmes pour les utiliser pour combattre les inégalités.
Pour autant, Green ne se veut pas naïf. Les data scientists ne vont pas créer demain, rapidement et facilement, une société juste, juste en changeant de méthode. D’autres enjeux s’imposent à eux. Les gouvernements eux-mêmes et nombre d’acteurs privés, sont motivés par des objectifs qui sont en conflits avec la justice sociale. Les autorités sont les premières à produire des algorithmes pour soutenir des politiques austéritaires, racistes et qui renforcent le contrôle et les inégalités sociales et les data scientists n’ont pas toujours de marge de manœuvre pour réorienter ces politiques. Le réalisme algorithmique ne prétend pas résoudre tous les défis. Il ne se veut qu’une méthode pour appréhender les défis sociaux, pour mieux collaborer avec les plus vulnérables. Et effectivement, cela ne suffira certainement pas à inverser les scripts qui se déploient dans les outils, les idéologies à l’œuvre dans les programmes et les politiques. « Les data scientists disposent d’une marge de manœuvre limitée pour générer un changement social ». Ce n’est pas pour autant qu’ils ne doivent pas être responsables de tenter de changer les choses. « Les data scientists ne sont pas responsables de la création des conditions sociales d’inégalité et d’injustice. Mais nous sommes responsables de la décision et de la manière d’agir face à ces conditions sociales.»
Le réalisme algorithmique n’est pas seulement une nouvelle méthode. C’est aussi une nouvelle culture et un ensemble de normes pour la data science. Son but est de traduire la critique des algorithmes en de nouvelles pratiques pour les data scientists.
Le passage du formalisme au réalisme et l’idée de l’appliquer à la data science ne vient pas de nulle part, explique Ben Green. Il s’inspire notamment des philosophes pragmatistes, comme John Dewey ou William James. « Les pragmatistes visaient à transformer la philosophie, d’une recherche métaphysique de vérités essentielles, en un ensemble d’outils pratiques pour résoudre les défis sociaux contemporains ». Pour eux, les concepts sont des instruments au service de l’action concrète : les idées sont des instruments pratiques – au même titre que des fourchettes, des tondeuses à gazon ou des stéthoscopes – destinés à aider les individus à faire face aux défis du monde réel. Ils proposent aux philosophes de s’affranchir de leur dépendance aux abstractions et aux formalismes et aux certitudes qu’elle produit. « Aucune connaissance ne garantit son infaillibilité », disait Dewey. Les connaissances doivent pouvoir être affinées en fonction des conséquences de leur mise en pratique.
La philosophie pragmatique s’appuie sur 3 principes. Le premier consiste à prendre en compte les conséquences : la qualité des théories dépend de leurs effets dans le monde réel, ce qui suppose d’évaluer dans la pratique si elles produisent les conséquences souhaitées. Une politique visant à réduire les inégalités de revenus ne s’évalue pas en fonction des principes qu’elle propose, mais se mesure plutôt en observant si sa mise en œuvre réduit effectivement les inégalités. Le second est le principe des outils, c’est un principe qui vise à se défier de l’abstraction qui n’est qu’un outil parmi d’autres. Le troisième est celui de la socialité : toute connaissance est le produit des personnes qui l’élaborent. Cela signifie qu’il n’existe aucune valeur éthique ou objective ultime.
Cette philosophie a eu des conséquences concrètes, notamment dans le domaine du droit. Jusqu’au début du XXe siècle, le raisonnement juridique aux Etats-Unis était dominé lui aussi par le formalisme, ce qui a suscité des critiques ouvrant la voie à des réformes progressistes, notamment pour élargir les droits et les protections des travailleurs. C’est ce que l’on a appelé le réalisme juridique. Le formalisme juridique estimait que les conséquences sociales réelles des lois étaient sans pertinence pour leur évaluation. Par exemple, les juges américains ont longtemps interprété la liberté contractuelle comme une règle rigide : l’État ne pouvait s’immiscer dans les contrats que les individus concluaient de leur plein gré. La Cour suprême des Etats-Unis a ainsi invalidé en 1905 une loi de l’Etat de New York fixant une durée maximale de travail pour les employés de boulangerie au motif qu’elle était un ingérence déraisonnable face à la liberté de contracter, quelque soit ses effets. En réaction au formalisme juridique, les réalistes ont œuvré pour prendre en compte le monde dans lequel le droit s’inscrit, pour faire du droit un outil pragmatique au service d’objectifs sociaux plutôt qu’un système visant à produire des réponses incontestables. Pour eux, la qualité des lois devait dépendre de leurs effets dans le monde réel. Pour cela, il leur a fallu montrer que les principes juridiques abstraits ne permettent pas d’apporter des réponses claires dans des cas concrets. Les réalistes juridiques ont prôné des changements d’orientation pour prendre en compte la jurisprudence, le contexte et en soutenant que le droit n’était pas un outil neutre, mais politique, et montrer que le droit ne pouvait être résolu par la simple application de principes abstraits. Ce basculement a changé l’application du droit aux Etats-Unis. En 1937, la Cour suprême des Etats-Unis a validé la constitutionnalité de lois sociales telles que celles instaurant un salaire minimum. « L’évolution du droit, passant du formalisme juridique au réalisme juridique, laisse entrevoir une trajectoire analogue pour faire progresser la science des données : le passage du formalisme algorithmique à une nouvelle méthodologie, le réalisme algorithmique.»
Pour appliquer le pragmatisme à la science des données, il faut que « le test ultime des attributs d’un algorithme réside dans les impacts qu’il génère en pratique ». Les data scientists ne peuvent se fier au comportement des entrées et des sorties du modèle. Il faut passer d’une conception des algorithmes comme des modèles mathématiques à une conception pratique d’instruments destinés à améliorer la société. « Ce qui rend un algorithme « équitable » ou « éthique », ce n’est pas qu’il possède des caractéristiques mathématiques associées à ces valeurs, mais qu’il produit, dans le monde réel, des résultats associés à ces valeurs ». Les algorithmes sont des systèmes sociotechniques qui s’inscrivent dans la société où ils se déploient, des pratiques sociales. Et s’ils sont des pratiques sociales, alors il faut développer des mesures d’évaluation adaptées, qui reflètent les effets réels de ces calculs. Prendre en considération les conséquences des systèmes, impose aux ingénieurs d’assumer la responsabilités des préjudices que leurs systèmes causent. « Si un algorithme conçu pour améliorer la société s’avère finalement nuisible, il ne peut être considéré comme socialement bénéfique, quelles que soient les mesures formelles attestant de ses bienfaits. Même si les effets néfastes d’un algorithme n’ont pas été voulus, ils définissent la manière dont celui-ci fonctionne réellement. » Là où le regard des spécialistes doit bouger, c’est qu’ils devraient privilégier les impacts sociaux indépendamment du rôle joué par les algos, quitte à ne pas développer des systèmes de calcul.
Le réalisme algorithmique repose enfin sur un autre principe et présupposé : les algorithmes sont politiques et ceux qui les fabriquent sont des acteurs politiques à part entière. « Toute activité qui influence la disponibilité des ressources, des droits, des statuts ou du pouvoir dans la société est politique ». Les défenseurs de la neutralité visent bien plus à occulter les rapports de force et perpétuer les hiérarchies sociales existantes, qu’à défendre une impartialité qui n’existe pas. Pour Green, les développeurs doivent reconnaître leur partialité, non pas parce qu’ils ignoreraient certaines choses, mais plus encore parce que leurs travaux portent des valeurs par devers eux. « Les data scientists occupent souvent des postes leur conférant une marge de manœuvre considérable pour prendre des décisions normatives. Or, ils ne devraient pas se considérer comme les arbitres du bien, mais plutôt comme des facilitateurs attachés à la participation démocratique de tous.»
Dans Logique : La théorie de l’enquête (PUF, 2006), John Dewey décrit la résolution de problèmes comme un processus en quatre étapes. « La première étape consiste à examiner le problème en question pour en comprendre les caractéristiques et définir les critères d’une résolution souhaitable. La deuxième étape consiste à explorer des solutions potentielles et à rechercher une intervention susceptible de résoudre le problème. La troisième étape consiste à mettre en œuvre l’intervention choisie. Enfin, la quatrième étape consiste à évaluer si l’intervention a produit les résultats escomptés. Si les résultats sont satisfaisants, le processus s’achève. » C’est exactement la méthode que Green retient pour l’appliquer aux défis algorithmiques. La méthode se déploie comme une feuille de route visant à
1. Délimiter le problème
2. Délimiter le projet
3. Analyser les données
4. Mettre en oeuvre
5. Et évaluer.
Avant de détailler par le menu les enjeux et défis de chaque étape. Mais, rappelle-t-il en préambule, les ingénieurs ne sont pas des « licornes omniscientes capables de tout faire en solitaire ». Si certains collaborent activement avec des communautés et des experts pour mener leurs projets, trop souvent encore, ces échanges restent « formalistes ». Dans l’ensemble, ils restreignent la participation de ces groupes à la simple fourniture d’informations sur les paramètres de mise en œuvre technique (voir par exemple notre article sur le manque de participation des publics). Et il est encore plus rare que les ingénieurs confient à d’autres le pouvoir de décision sur les résultats à privilégier ou l’opportunité même de développer des systèmes. Même lorsqu’ils consultent des communautés, trop souvent encore, les ingénieurs conservent la maîtrise du projet. Et quand c’est le cas, l’implication des parties prenantes est marginale, insuffisante pour influencer de manière significative les résultats. Quand c’est le cas, les ingénieurs ont souvent déjà arrêté leur orientation et restent souvent réticents face aux retours remettant en cause leurs choix (comme nous le montrions dans notre article sur l’échec des déploiements de projets). Enfin, quand ils laissent une place, celle-ci consiste à discuter de paramètres, d’indicateurs qui dévalorisent les savoirs des groupes dépourvus de formation technique.
En rendant les phases amonts (et avals) du processus plus collaboratives, l’enjeu est de mieux réussir à ouvrir à toutes les parties prenantes les moyens de peser sur les objectifs et la portée des projets. Green rappelle que le data scientist ne connaît jamais la complexité du fonctionnement d’un système. Ce sont ceux qui y sont confrontés les experts. Et c’est leur connaissance qui seule permet de faire la différence.
Délimiter le problème n’est pas si simple car les situations problématiques sont souvent mal définies et ambiguës et nécessitent d’éviter toute attente ou tout objectif préconçu. « Lors du diagnostic des problèmes, il est important de reconnaître qu’il n’existe probablement pas d’explication unique et correcte. La plupart des défis sociaux sont des « problèmes complexes ».» Pour cela, Green invite à l’enquête. A discuter avec les agents ou avec le public. A prendre le temps d’interviewer, de parler. Il donne l’exemple d’entretiens avec des parents confrontés à des systèmes algorithmiques visant à prédire les risques de maltraitance ou de négligence. Pour les familles, ces systèmes stigmatisent les parents plus qu’ils n’améliorent la situation. La réponse proposée par les services sociaux où ces systèmes étaient déployés était inadaptée à leur situation. Pour Green, tout l’enjeu est de poser l’énoncé du problème, de le décrire et de décrire ses causes. Aborder les personnes touchées et regarder si elles sont concernées différemment. C’est en posant un diagnostic approfondi du problème qu’on construit un point de référence qui va fournir un cadre pour la démarche. Et ce diagnostic doit être partagé et validé par ceux avec qui le data scientist doit travailler.
Une fois le problème cerné, il faut alors élaborer une stratégie de réforme, c’est-à-dire une théorie du changement qui permettrait de résoudre le problème identifié, sans évoquer de technologie. Le but n’est pas nécessairement de tout résoudre d’un coup, mais aussi d’esquisser les étapes. « Lorsque des travailleurs se syndiquent, ils ne cherchent pas simplement à obtenir des salaires plus élevés. Ils visent plutôt à accroître leur pouvoir à déterminer les conditions de travail. Grâce à ce pouvoir, ils peuvent négocier avec la direction de nombreux aspects de leur emploi : les salaires, certes, mais aussi la couverture santé, les mesures de sécurité, et bien plus encore. Pour un syndicat, il n’existe pas de victoire ultime et définitive, mais seulement une succession de compromis et de victoires partielles. Chaque action renforce la capacité du syndicat à remporter de nouvelles victoires partielles lors des campagnes de mobilisation ultérieures », comme le montrait André Gorz dans Stratégie ouvrière et néocapitalisme (Seuil, 1964). « Pour les data scientists, qui cherchent à promouvoir la justice sociale, votre objectif n’est pas d’identifier une stratégie globale de transformation de la société. Ne vous attendez pas à ce qu’une intervention quelconque puisse résoudre un problème social systémique et aboutir à une alternative parfaitement juste. L’objectif est plutôt d’identifier des « réformes non réformistes » : des actions qui, même modestement, orienteront la société vers des politiques et des structures de pouvoir égalitaires. » Pour Gorz, les réformes non réformistes s’inscrivent dans une volonté d’instaurer des relations sociales égalitaires. Elles remettent en cause le statu quo au service des objectifs visés. Compte tenu de cette distinction, les réformes non réformistes sont mieux à même de surmonter les structures politiques et de pouvoir systémiques qui, généralement, font obstacle à la réalisation de la justice sociale.
La délimitation du projet, elle, consiste à préciser les objectifs à atteindre. « Des objectifs qui doivent être à la fois spécifiques, mesurables, réalisables, pertinents et temporellement définis ». Ils doivent permettre de faire progresser la stratégie de réforme définie et sa contribution doit venir soutenir les acteurs. Ici, l’enjeu est d’identifier « Comment mon expertise et mon statut de data scientist peuvent-ils aider le groupe à atteindre ses objectifs ? »
Pour Green cela suppose par exemple de produire une cartographie des processus pour bien saisir le fonctionnement et les pratiques des acteurs accompagnés, sous forme par exemple d’une représentation détaillée de chaque étape d’un processus opérationnel, voire un organigramme ou un flux de travail (à accomplir avec ceux chargés de le faire pour en valider les étapes, préciser les acteurs impliqués, les objectifs de chacun, leurs contraintes) permettant d’identifier les points de blocages concrets. À San Francisco par exemple, le Département de la santé publique s’inquiétait de la baisse des taux de fidélisation à un programme qui fournit une aide alimentaire aux mères à faibles revenus. Pour comprendre les causes de ce problème, l’agence a collaboré avec l’équipe interne de science des données de la ville. Les spécialistes des données ont analysé six années d’informations et élaboré un modèle d’arbre de décision afin d’identifier les facteurs conduisant les mères à abandonner le programme. Ils ont également interrogé les bénéficiaires et le personnel du programme. Ces analyses ont révélé que les contraintes administratives et la stigmatisation sociale constituaient des obstacles majeurs pour les mères. En réponse, l’agence a réduit les contraintes administratives en simplifiant la prise de rendez-vous et en remplaçant les chèques papier par des cartes de paiement électroniques qu’elles réclamaient. L’agence a également lutté contre la stigmatisation en modifiant la communication du programme. A nouveau, insiste Green, l’enjeu n’est pas toujours de faire de grandes réformes. Mais souvent seulement d’aider les organismes à renforcer leurs capacités techniques, que ce soit en nettoyant leurs données, à former le personnel pour élaborer des indicateurs pertinents ou à faciliter le partage de données entre les différents services.
Un autre moyen consiste à cartographier le pouvoir, les réseaux d’acteurs en relation ou en conflit, comme « d’identifier des adversaires qu’il convient de soumettre à des pressions, des alliés potentiels qu’il faut convaincre ou des groupes non organisés qu’il s’agit d’unifier ». C’est le cas par exemple du collectif militant Anti-Eviction Mapping Project (AEMP) qui publie des cartes d’expulsion notamment à San Francisco. Avec l’Eviction Defense Collaborative, les deux associations ont produit une carte pour mettre en évidence les arrêts de navettes des entreprises technologiques de San Francisco avec celle des expulsions du centre-ville qui a conduit la ville à réglementer le passage de ces bus.
Le but, ici, est bien souvent d’analyser les données pour orienter la stratégie de mobilisation. Dans le Connecticut, des locataires de logements abordables étaient exposés à des niveaux de présence de plomb toxiques. Ils ont formé un syndicat de locataires pour se mobiliser contre le problème. Les scientifiques de l’organisation Science for the People sont venu leur apporter leur soutien en croisant les données des inspections des agences chargées de la détection du plomb avec celles du syndicat pour aller démarcher d’autres habitants confrontés au problème et accroître la mobilisation et la pression sur les autorités publiques. Suite à ces actions, une enquête a été ouverte et l’agence de protection de l’environnement est intervenue pour faire nettoyer les immeubles.
Pour élaborer des spécifications de conception, il faut s’intéresser aux variables cibles des systèmes (c’est-à-dire le résultat que l’algorithme prédit), les mesures d’évaluation et l’utilisabilité pratique, qui permettent de traduire le phénomène étudié en une représentation quantitative susceptible d’être mesurée et prédite. Or, celles-ci ne sont pas toujours définies au mieux, rappelle Green. Un algorithme utilisé par le service des impôts américains pour prédire quelles déclarations de revenus sont non conformes (qui devraient donc faire l’objet d’un contrôle fiscal) évalue « la non-conformité comme le dépôt d’une déclaration comportant une erreur, quel que soit le montant en jeu. Sur la base de cette définition, l’algorithme cible de manière disproportionnée les contribuables à faibles revenus et les contribuables noirs pour des contrôles. À l’inverse, si l’algorithme définissait la non-conformité comme un sous-paiement d’impôts d’un montant significatif, il ciblerait plutôt les contribuables à revenus élevés et non noirs pour ces contrôles » (un problème qui n’est pas sans rappeler celui des indus calculé par la CAF en France, soit dit en passant).
Parvenir à identifier correctement le problème prend du temps et des efforts, rappelle Green. A New York, le service municipal d’aide aux locataires qui vise à les aider dans leur relations avec leur propriétaires par exemple pour obtenir des réparations d’urgence, a cherché à identifier les locataires qui avaient besoin d’aide. Ils ont mis au point un système pour prédire les locataires harcelés par leurs propriétaires pour mieux cibler leurs interventions. Dans un premier temps, ils ont défini leur algorithme pour prédire les immeubles allant connaître au moins un cas de harcèlement au cours du mois suivant, mais le système sélectionnait des immeubles comportant beaucoup d’appartements, mais avec un faible taux de harcèlement de leurs propriétaires. Les scientifiques ont reformulé le problème pour prédire quels immeubles présentaient la plus forte proportion de locataires harcelés. Le modèle a alors identifié des immeubles plus petits avec des taux élevés et mieux répartis dans la ville. Le second modèle a permis de doubler le taux d’identification de locataires en difficulté avec leurs propriétaires, se révélant ainsi plus efficace pour soutenir la mission de l’agence, à savoir protéger les locataires vulnérables.
Pour Green, il y a beaucoup de variables à prendre en considération pour accomplir des analyses adaptées aux situations. Bien souvent, les associations ou les services publics ont peu de moyens pour intervenir. Cela signifie qu’il faut être capable d’intégrer les contraintes opérationnelles de l’organisme dans les indicateurs d’évaluation. « Les approches d’évaluation standard, qui prennent en compte la performance d’un algorithme sur l’ensemble de la population, ne reflètent pas la qualité de l’algorithme pour le rôle auquel il est destiné. Si un organisme ne peut intervenir qu’auprès d’une petite partie de la population, l’essentiel est d’identifier avec précision le groupe qui bénéficierait le plus d’une intervention. » Et dans de nombreux cas, « l’algorithme le plus performant pour l’ensemble de la population sera différent de celui qui performe le mieux pour le sous-ensemble étudié ».
Enfin, il faut s’assurer que l’algorithme sera utilisable en pratique et qu’il sera dimensionné et adapté aux processus existants. Par exemple, en travaillant avec les services sociaux de l’Illinois pour réduire le risque d’accouchement prématuré, les data scientists ont tenté de prédire les femmes avec le plus grand risque de complication via une application en ligne. Mais ils se sont rendu compte que cette application n’était pas fonctionnelle en pratique, car les services ne disposaient pas des capacités techniques pour en assurer la maintenance. Ils ont alors produit un score de risque depuis un simple formulaire papier facile à remplir. Moins précis que l’évaluation numérique, l’outil s’est avéré plus efficace car les services ont pu l’intégrer dans leurs opérations quotidiennes et a permis d’améliorer de 20% les soins prénataux aux femmes à hauts risques.
Pour Green, « plus vous aurez défini le périmètre de votre projet de manière pertinente pour le contexte d’utilisation spécifique, plus il sera facile de mettre en œuvre l’algorithme avec succès ». Et c’est seulement après ces étapes importantes de spécifications, que le data scientist peut faire son travail, de sélection, de nettoyage et d’analyse de données.
Là encore, le travail préliminaire consiste à bien comprendre les données, leurs ambiguïtés, leurs biais et leurs limites. Il faut comprendre comment elles sont collectées, leurs manques… Ce qui n’est possible qu’en comprenant leur collecte, leur but, et en discutant avec ceux qui les collectent. Pour Green, « une cause fréquente d’échec des logiciels publics réside dans les méthodes de développement dites « en cascade » : les pouvoirs publics définissent leurs besoins, les techniciens conçoivent et réalisent le système de manière isolée, pour ne le présenter qu’une fois le produit final achevé. L’approche en cascade suppose qu’il est possible de définir tous les détails d’un outil avant d’en entamer la réalisation », comme le montrent Tara Dawson McGuiness et Hana Schank dans leur livre, Power to the Public: The Promise of Public Interest Technology (Princeton university Press, 2021). « Cette approche mène souvent à l’échec car elle ne prévoit aucune possibilité de retour d’information intermédiaire au cours du processus de développement. Si vous tentez de concevoir un système de manière isolée, vous risquez de négliger les préférences et les pratiques de l’organisme concerné, faute de les avoir abordées en amont. De plus, ces préférences et pratiques sont susceptibles d’évoluer avec le temps. Plutôt que d’adopter une méthode en cascade (waterfall), privilégiez les pratiques de développement « agile » : créez des prototypes de manière itérative, discutez-en ou testez-les avec les utilisateurs finaux, puis ajustez votre travail en fonction des retours obtenus. »
Une fois les données analysées ou modélisées, vous pouvez en tirer des enseignements. Si vous avez élaboré un modèle, c’est à cette étape que vous l’utiliserez pour effectuer des prédictions ou des classifications sur de nouvelles données. Si vous préparez une présentation ou un rapport, c’est le moment de synthétiser les résultats dans un document destiné à être partagé. Ne vous limitez pas aux aspects techniques de vos livrables ; réfléchissez également à la manière de communiquer votre travail. Il est essentiel que votre public puisse interpréter correctement la signification de vos résultats (et, point tout aussi important, ce qu’ils ne signifient pas).
L’implémentation elle aussi doit être pédagogique recommande Green. Elle doit se faire en observant les impacts liés à l’utilisation. « Les projets de science des données sont loin d’être terminés une fois qu’un algorithme a été développé. » Pour cela, il faut non seulement surveiller ce que produit l’algorithme mais plus encore comment il s’insère et influe sur la prise de décisions, dans les processus et observer ses impacts sur les publics touchés. C’est à ce moment-là qu’on déploie des outils pour évaluer leurs effets, que ce soit via des méthodes de projection prospective, des exercices de design fiction, ou des études d’utilisation.
C’est seulement toutes ces étapes franchies qu’on peut décider ou non d’implémenter le système, estime Green en délibérant avec les parties prenantes, en ayant observé si le système produit bien des effets et à quel niveau. C’est seulement une fois que l’implémentation est réalisée avec attention pour qu’elle s’intègre aux processus, que l’évaluation peut vraiment avoir lieu. En regardant s’il atteint bien ses objectifs et s’il engendre des effets secondaires négatifs. Là encore, le manuel de Green fourmille d’exemples pour procéder à ces évaluations, que ce soit par des essais contrôlés randomisés, des comparaisons avant-après, par des études d’interaction humaines avec le système, des enquêtes sur les groupes affectés par les décisions…
Bien souvent, les évaluations formalistes des systèmes peinent à évaluer leurs impacts concrets. A San Francisco, les personnes sans abri font l’objet d’une évaluation de leur vulnérabilité par un algorithme. Ces scores orientent les décisions des organismes de logement quant aux personnes à prioriser pour l’attribution d’un logement. Or pour candidater, il leur faut répondre à un questionnaire assez traumatisant, ce qui les conduit à taire leurs récits voire à renoncer et donc à réduire leur score. L’algorithme ne parvient donc pas à accomplir pleinement ce qu’il est censé faire.
Résoudre les inégalités n’est pas si simple, rappelle Green. En 2016, les journalistes d’investigation de ProPublica ont montré que l’algorithme de Compas d’évaluation des risques de récidive était biaisé à l’encontre des Noirs. ProPublica a constaté que le taux de faux positifs de COMPAS – le taux de classification erronée d’un prévenu qui ne récidivera pas comme présentant un risque élevé – était deux fois plus élevé pour les prévenus noirs que pour les prévenus blancs. L’algorithme a classé 45 % des prévenus noirs non récidivistes comme présentant un risque élevé. En revanche, il n’a classé que 23 % des prévenus blancs non récidivistes comme présentant un risque élevé. L’algorithme a donc classé de manière disproportionnée les prévenus noirs comme susceptibles de récidiver.
Ces résultats ont suscité une grande consternation, de nombreux commentateurs exprimant leur indignation face à des algorithmes racistes dans des décisions aussi importantes. Mais Northpointe, l’entreprise qui a développé Compas, a réfuté les accusation de discrimination en s’appuyant sur une autre comparaison : parmi les prévenus considérés comme à haut risque, les prévenus noirs et blancs récidivaient à des taux similaires (environ 60 % du temps). Ce qui signifiait que l’algorithme traitait les prévenus noirs et blancs de la même manière quant à leur probabilité de récidive. Pour Northpointe, cette analyse démontrait que COMPAS est impartial.
Des chercheurs en science des données se sont penchés sur ce débat, supposant qu’il serait possible de trancher la question en ajustant COMPAS pour satisfaire aux notions d’équité présentées par ProPublica et Northpointe. Ils ont cependant rapidement découvert que cela était impossible. Les algorithmes prédictifs discriminent inévitablement une forme ou une autre, et généralement en pénalisant les groupes marginalisés. Dans le cas de COMPAS, la disparité raciale des taux de faux positifs s’explique parce que les accusés noirs récidivent plus fréquemment que les accusés blancs, mais certainement d’abord parce qu’ils sont plus nombreux à être incarcérés et moins pris en charge. L’algorithme détecte cette différence et considère donc les accusés noirs comme plus à risque que les accusés blancs. Des enquêtes ont démontré des biais raciaux, ethniques, sexistes et de classe dans de nombreux autres algorithmes du secteur public.
« Cette caractéristique des algorithmes soulève un problème important pour les data scientists qui tentent de promouvoir la justice sociale. Les groupes marginalisés obtiennent de moins bons résultats dans de nombreux domaines, notamment la criminalité, l’éducation, la réussite professionnelle et la santé. Ce sont ces inégalités qui motivent de nombreux data scientists à œuvrer pour la justice. Mais comme les algorithmes sont entraînés sur des données qui reflètent ces schémas d’inégalité, ils génèrent des prédictions et des classifications qui reproduisent les disparités sociales. »
Les spécialistes des données ont tenté de relever ce défi en développant le domaine de « l’équité algorithmique ». Comme son nom l’indique, l’équité algorithmique vise à empêcher les algorithmes d’exprimer des biais ou d’exacerber les inégalités. Ce domaine de recherche a réalisé des progrès importants dans le développement de méthodes permettant de réduire certains biais et a incité les spécialistes des données à reconnaître que les algorithmes ne sont pas objectifs.
Malgré ces avancées, l’équité algorithmique reste fondamentalement limitée en tant que méthodologie de promotion de la justice sociale. Le défaut fatal de ce domaine est qu’il considère l’équité comme un attribut technique interne aux algorithmes, explique Green.
L’équité algorithmique représente un exemple typique d’incorporation formaliste : les data scientists ont abordé les questions morales d’équité à travers les méthodes et les orientations du formalisme algorithmique. Cette approche de l’équité a conduit à des algorithmes qui paraissent équitables mais qui, en réalité, perpétuent les inégalités. « Ces limites de l’équité algorithmique signifient que les data scientists manquent d’une voie claire pour lutter contre la discrimination et les inégalités. Les réformes qui promeuvent l’équité sont les plus nécessaires dans les domaines où les disparités sociales sont criantes et généralisées. Mais les data scientists ne disposent pas de méthodes pour concevoir des algorithmes qui réduisent ces disparités plutôt que de les reproduire. Il n’est donc pas évident de savoir comment les data scientists peuvent contribuer à la justice sociale dans ces domaines. »
Pour Green, le réalisme algorithmique offre une voie productive pour pratiquer la science des données dans des domaines marqués par les inégalités car elle « reconsidère l’équité comme une propriété instrumentale – et non intrinsèque – des algorithmes ». « Dans cette optique, pour déterminer si un algorithme est équitable, ce qui compte, ce ne sont pas ses caractéristiques techniques, mais les effets qu’il produit au sein de la société. Par conséquent, les data scientists devraient cesser de poser la question formaliste dominante dans le domaine : « Comment créer des algorithmes qui satisfont à des critères statistiques d’équité ? » Cette question focalise l’attention sur le fonctionnement interne des algorithmes, en se concentrant étroitement sur des processus de décision isolés. Au lieu de cela, les data scientists devraient se demander : « Comment pouvons-nous contribuer à réduire les inégalités sociales et matérielles dans la société ? » Cette question incite les data scientists à privilégier les impacts réels des algorithmes. »
Certes, cette question ne permet pas de réponses simples. Toutefois, la démarche du réalisme algorithmique structure un processus grâce auquel les data scientists peuvent élaborer des projets favorisant l’équité. Le réalisme algorithmique invite les data scientists à élargir leur perspective au-delà des processus de décision ponctuels pour prendre en compte les environnements sociaux qui entourent ces moments de décision. Cette approche souligne que les data scientists ne sont pas limités à la simple optimisation des modalités de prise de décision : ils peuvent également modifier les structures sociales qui encadrent ces processus. « Ils devraient notamment s’efforcer de (1) réduire les disparités sociales qui alimentent les processus de décision et (2) atténuer les conséquences néfastes découlant de ces décisions. En privilégiant des interventions structurelles plutôt que des mesures d’équité, les data scientists peuvent mener des projets techniques qui contournent les contraintes liées à l’équité algorithmique tout en promouvant la justice sociale.»
Green montre que l’approche formaliste de l’équité, malgré le développement d’innombrables mesures d’équité sous forme mathématique, peine à produire des effets.
« Les mesures d’équité les plus répandues reposent sur des comparaisons entre des groupes qui valorisent soit la suffisance » (la condition de suffisance est remplie si, parmi les personnes faisant l’objet d’une prédiction donnée, tous les groupes présentent le résultat prédit dans les mêmes proportions. Cette définition de l’équité reflète l’idée que les personnes ayant une probabilité équivalente de manifester le comportement étudié doivent être traitées de manière similaire. Les modèles d’apprentissage automatique respectent généralement ce principe par défaut. Northpointe a soutenu que COMPAS était équitable car il satisfaisait au critère de suffisance) « soit la séparation » (la condition de séparation est remplie si tous les groupes soumis aux prédictions d’un algorithme présentent le même taux de faux positifs et le même taux de faux négatifs. Cette définition de l’équité reflète l’idée que les personnes présentant le même résultat doivent être traitées de manière similaire. ProPublica a soutenu que COMPAS était racialement biaisé car il ne respectait pas le critère de séparation).
Le problème est que ces deux manières de définir l’équité sont irréconciliables. Et que l’équité se résume alors à une boîte à outil, où l’équité répond ou pas aux mesures mathématiques retenues. L’équité ne se mesure que sous l’angle des données d’entrée et de sortie de processus décisionnels ponctuels et bien souvent privilégie la suffisance à la séparation, notamment parce qu’on a tendance à bien plus valoriser l’égalité formelle, c’est-à-dire celle qui juge selon une norme uniforme, qui est très perméable aux inégalités existantes. Ainsi, si Northpointe a raison d’affirmer que les prévenus noirs récidivent plus souvent, c’est oublier que cette explication occulte les raisons de cette disparité. Cette disparité ne résulte pas d’un phénomène inexplicable ou sans importance. Au contraire, des siècles d’oppression raciale ont criminalisé le fait d’être Noir et ont placé les communautés noires dans des conditions criminogènes telles que la pauvreté endémique, le sous-financement des écoles et la rareté des opportunités d’emploi, rappelle le chercheur.
Pour Green, c’est en cela que l’équité algorithmique est dans une impasse. Les critiques, partisans de la justice algorithmique, suggèrent de privilégier la séparation à la suffisance comme définition de l’équité, pour privilégier l’égalité de résultats entre les groupes. Dans le cas de Compas, cela signifierait produire les mêmes niveaux de faux positifs pour les prévenus noirs et blancs. Mais pour changer d’approche, il faudrait faire évoluer non seulement la prise en compte mathématique, mais également la contrainte juridique. Privilégier la séparation nécessiterait de préconiser des décisions différentes pour les prévenus noirs et blancs présentant le même risque de récidive, ce qui serait illégal en vertu des lois anti-discrimination. Nous sommes là dans le même défi juridique que l’on notait dans le livre de Nathan Genicot. Une impasse éthique que nos sociétés n’ont pas tranchée.
Pour dépasser cette impasse, Green suggère de passer à une approche instrumentale de l’équité. « Si nous ne pouvons pas choisir d’autres métriques d’équité, que pouvons-nous faire pour obtenir des algorithmes plus équitables ? »
« Pour élaborer une stratégie visant à mettre les algorithmes au service de la lutte contre l’injustice, nous avons besoin de l’éclairage d’une théorie morale qui dépasse le cadre de l’égalité formelle. » Cette théorie doit présenter deux caractéristiques fondamentales. Premièrement, elle doit se concentrer sur les réalités concrètes des inégalités plutôt que sur le simple respect de règles formelles et de normes uniformes. Deuxièmement, elle doit élargir le champ de l’analyse au-delà des points de décision individuels.
Pour cela, la solution que propose Green repose sur l’égalité relationnelle, qui constitue une approche substantielle de l’égalité, car elle privilégie les résultats aux procédures. Elle valorise notamment l’égalité dans les relations entre les individus. Les tenants de l’égalitarisme relationnel estiment que « les individus doivent interagir en tant qu’égaux ou jouir du même statut fondamental », contrairement aux relations hiérarchiques. Les égalitaristes relationnels suggèrent une stratégie différente pour promouvoir l’égalité : modifier les structures sociales qui encadrent les points de décision, c’est-à-dire s’intéresser bien plus aux environnements de décision. « Ce qui compte, ce n’est pas de savoir si un algorithme est conforme aux définitions de l’équité, mais s’il réduit les inégalités sociales et matérielles dans la société ».
Pour y parvenir, Green reprend tout le processus qu’il a proposé (les 5 étapes de sa méthode) pour le réinterroger à l’aune de l’équité.
Lors de la délimitation du problème, il faut se poser plus avant la question des groupes les plus vulnérables ou les plus défavorisés. Les disparités d’attributs entre les groupes doivent être considérés comme le résultat d’une injustice. Et toujours estimer que les membres du groupe favorisé ont une influence dans la définition des critères de décision. Les attributs d’une personne, comme le mérite, le besoin, la dangerosité, reflètent souvent les intérêts des groupes sociaux dominants. « Plus un groupe dominant a le pouvoir de définir les critères, plus les conditions sont défavorables aux groupes marginalisés. » Il invite par exemple à observer si « les personnes présentant des caractéristiques défavorables font l’objet, de manière disproportionnée, de décisions défavorables » ou si les « les personnes qui reçoivent une décision défavorable subissent des conséquences graves » ou combien de personnes subissent des décisions défavorables. Ces questions permettent d’adapter les réponses stratégiques. Par exemple en fournissant des ressources ou des soutiens aux groupes défavorisés pour amoindrir les effets des calculs en modifiant les critères d’évaluation des décisions. Par exemple, en tentant de modifier les décisions défavorables afin qu’elles privilégient l’aide à la sanction. Ou encore en atténuant les préjudices découlant d’une décision défavorable, ou encore en tentant de réduire le nombre de personnes faisant l’objet de décisions défavorables, en tentant par exemple d’agir sur les ressources disponibles pour permettre davantage de décisions favorables. Ainsi, pour réduire le risque de récidive chez les groupes marginalisés, la première stratégie de réforme en amont consiste à fournir des ressources ou d’autres formes de soutien aux groupes défavorisés.
Green donne un exemple, en observant comment d’autres décisions permettent de réduire le risque de récidive, par exemple en accompagnant les programmes qui visent à rompre les cycles de la criminalité et de la violence. À Chicago, un programme d’intervention communautaire contre la violence vise à offrir un soutien thérapeutique et social aux personnes à risque d’avoir un comportement violent. Les évaluations ont montré que ces programmes avaient un réel impact en réduisant de plus de 70% le risque d’arrestation pour crime violent chez les participants. Les spécialistes des données peuvent aider par exemple à améliorer le taux de rétention des participants, alors que moins de la moitié des participants vont jusqu’au bout du programme (et compte tenu des ressources limitées des programmes, il est impératif qu’ils réduisent leurs taux d’abandon). En comprenant les raisons de l’abandon ou en élaborant un modèle pour identifier les participants qui risquent d’abandonner, il y a des possibilités pour venir en soutien de ces programmes. Ou encore en concevant un modèle identifiant les meilleures stratégies de rétention.
Un exemple dans l’actualité plus récente explicite plus avant ce succès. La ville de Baltimore a réduit son taux d’homicides de 60 % entre 2021 et 2025 rapportent Public Health et le Emerald book, en copiant le programme de Chicago. Ce succès s’explique par le fait que la ville ait abordé la violence par arme à feu comme un enjeu de santé publique et ait agit sur le problème non pas par la répression, mais en promouvant un programme pour les personnes les plus à mêmes de tomber dans la violence donnant accès à un logement stable, à des emplois, à des transports publics, comme le préconisent les travaux du Centre pour les solutions contre la violence par arme à feu et du Crime and Justice Lab. Une approche axée sur la santé publique implique d’analyser les données, de se concentrer sur les personnes les plus exposées aux risques pour les repérer et leur proposer un programme adapté d’aides pour s’extraire de la spirale où ils risquent de tomber parce qu’ils ont eux-mêmes été victimes de violences et d’évaluer en permanence ce qui fonctionne et ce qui ne fonctionne pas. En s’appuyant sur des réseaux communautaires locaux, comme la Peace Team, YAP, Roca, Safe streets ou Cure violence, Baltimore a réussi à ce que 91,5% des participants à son programme ne soient plus ni victimes ni auteurs de nouvelles fusillades. Plutôt que de déployer des effectifs de police, la ville a misé sur des médiateurs et un programme d’aides dédiés pour que la réponse à la violence par la violence ne soit plus la seule option. « Le succès de Baltimore a définitivement balayé le mythe selon lequel la réduction de la criminalité nécessiterait nécessairement une augmentation des effectifs policiers.»
Une autre option consiste à attirer davantage l’attention sur les méfaits de la mise en détention auprès des juges, comme l’ont montré les propositions alternatives à Compas, comme des systèmes qui proposent pour chaque individu la meilleure solution pour qu’ils ne récidivent pas en leur proposant les aides les mieux adaptées à leur situation (comme le programme de remise en liberté sous surveillance de la ville de New York qui a permis d’éviter la détention provisoire de 150 000 personnes) ou encore, comme le propose Esas, en proposant aux juges, plutôt qu’un score de risque, d’accéder aux peines similaires prononcées dans des affaires antérieures selon des antécédents de condamnations proches, leur permettant de comparer leur sentence et de relativiser leurs jugements (voir notre article).
Il est également possible d’utiliser d’autres solutions encore, comme des modèles statistiques afin d’identifier et de contester publiquement les décisions des juges en matière d’incarcération. À titre d’exemple, des spécialistes des données ont élaboré des modèles évaluant la fréquence à laquelle les juges de New York ont ordonné le placement en détention provisoire entre 2020 et 2022, au regard de leur volume de dossiers. Ils ont ensuite publié un rapport désignant les quatorze juges les plus sévères de la ville. Selon leurs estimations, par rapport à des juges ordinaires, ces quatorze magistrats ont collectivement placé 580 personnes supplémentaires en détention, entraînant 154 années de détention provisoire additionnelles et un coût de 77 millions de dollars pour les finances publiques.
Une autre possibilité encore consiste à œuvrer à réduire les peines prononcées ou à réduire le nombre de personnes placées en détention provisoire par exemple en collaborant avec des avocats commis d’office pour concevoir un outil open-source pour les aider à mieux défendre leurs clients. ou encore en mobilisant des citoyens pour documenter les procédures de la justice et produire des rapports sur leurs actions.
Green ne promet pas le grand soir de la lutte contre les inégalités. Mais estime que le terrain des interventions concrètes offre de nombreuses possibilités d’action. Pour lui, la data science permet de porter bien d’autres regards sur l’équité algorithmique. Bien sûr, reconnait-il avec humilité, « aucune de ces interventions, prise isolément, ne suffirait à éliminer les inégalités sociales ou les préjudices liés à la détention provisoire. Toutefois, toutes contribuent — par des évolutions progressives mais significatives — à orienter les structures sociales et institutionnelles vers une plus grande égalité relationnelle.» Pour autant que, politiquement, il reste des possibilités d’action, des programmes alternatifs et des financements pour ces programmes…
« Au cours des années 2010, des villes américaines comme Philadelphie ou San Francisco ont proposé des guichets pour aider les organismes de services sociaux à fournir une aide plus équitable et plus efficace aux personnes sans-abri. L’objectif de l’accès coordonné est d’accorder la priorité en matière de logement aux personnes qui en ont le plus besoin.
Les algorithmes facilitent ce processus en quantifiant la vulnérabilité de chaque personne sollicitant une aide au logement. » Problème : les travailleurs sociaux n’ont pas intégré ces évaluations. Pire, ces algorithmes ont eu l’effet inverse : ils ont exacerbé la vulnérabilité des groupes les plus marginalisés (tels que les immigrés, les personnes transgenres et les personnes noires) et ont donné aux personnes sans-abri le sentiment d’être déshumanisées par le processus d’évaluation, comme le racontait le San Francisco Public Press en 2022.
« L’une des principales raisons de l’échec de cette initiative est que les travailleurs sociaux se sont trop reposés sur les algorithmes. Au lieu de considérer l’évaluation comme un outil permettant de contextualiser la situation de chaque individu, ils en ont fait le critère déterminant pour l’attribution d’un logement. Les agents chargés des dossiers ont fait valoir qu’ils n’avaient pas le « temps » de procéder à un examen plus personnalisé et que le questionnaire était plus simple à utiliser.
Cette dépendance excessive à l’égard des algorithmes de sélection a transformé un travail autrefois fondé sur l’accompagnement humain en une simple application rigide d’une formule. Auparavant, les travailleurs sociaux nouaient des relations avec les personnes sans abri afin de mieux cerner leurs besoins et de déterminer les formes d’aide les plus adaptées. Après l’introduction d’algorithmes d’accès coordonné au logement, les personnes en quête d’un toit n’ont plus bénéficié d’un accompagnement aussi personnalisé et respectueux. Elles étaient au contraire réduites à un simple numéro et, dans la plupart des cas, renvoyées à la rue.»
Cette histoire rappelle qu’il est très difficile de parvenir à une collaboration efficace entre humains et algorithmes. « On s’attend à ce que la combinaison de l’humain et des algorithmes permette de tirer le meilleur parti des deux mondes : la précision et la cohérence des algorithmes d’une part, l’expertise et le discernement des humains d’autre part. En pratique, toutefois, cette fusion idéale ne se concrétise que rarement.»
L’un des problèmes majeurs réside dans l’incapacité des humains à évaluer correctement la qualité des conseils fournis par les algorithmes ; même les experts peinent à distinguer les bonnes recommandations des mauvaises. Souvent, les décideurs humains accordent une confiance excessive à l’algorithme, ce qui les conduit à suivre des recommandations erronées ou biaisées. Ainsi, lorsque la police de Londres a testé un système de reconnaissance faciale en temps réel, les agents ont « largement surestimé la fiabilité du système », rapportait une analyse de l’AI Now institute. Alors que l’algorithme ne fournissait une réponse correcte que dans 19 % des cas, les agents ont approuvé 62 % de ses recommandations.
Pour relever le défi de la collaboration, les data scientists ont complété les recommandations d’explications permettant de décrire les raisons pour lesquelles l’algorithme aboutit à sa conclusion. C’est le champ de ce qu’on appelle l’IA explicable (XAI). Malgré l’engouement, force est de constater que ces explications n’améliorent généralement pas la collaboration entre humains et algorithmes. Dans de nombreux cas, les explications conduisent même à de moins bons résultats. Ce problème découle à nouveau de la prédominance du formalisme algorithmique. Si le domaine a défini ce qui caractérise une bonne explication en terme mathématique et a mis au point des outils d’explicabilité, les complexités sociales inhérentes aux collaborations entre humains et algorithmes ont du mal à être saisies par le biais d’abstractions et de métriques. A nouveau, pour Green, il est nécessaire de dépasser le formalisme pour dépasser cette limite. « Ce qui caractérise un algorithme utile, ce n’est pas sa précision maximale ni ses explications techniquement optimales. Ce qui caractérise un algorithme utile, c’est sa capacité à aider les utilisateurs à prendre de meilleures décisions.» Cela semble tautologique, mais observer si cet objectif est atteint ne s’observe pas sur la base de purs formalismes.
Dans l’approche formaliste, les spécialistes de data science insistent sur l’importance de maintenir un humain dans la boucle de décision. C’est au final toujours lui qui doit pouvoir décider, valider la recommandation du calcul. C’est un moyen censé prémunir des erreurs et des biais. De même, pour dépasser l’opacité intrinsèque aux calculs complexes, les data scientists privilégient des explications elles-mêmes automatisées. L’explicabilité est devenu le principe central et moteur de l’équité. Pourtant, cette explicabilité peine à produire des résultats et reste bien souvent très pauvre, incomplète… (absolument pas « projective », comme je le proposais moi-même). « Aider les utilisateurs à comprendre le fonctionnement d’un algorithme est très différent de les aider à utiliser ses conseils pour améliorer leurs décisions. Les convictions des data scientists quant à la qualité des explications ne correspondent donc pas à la pratique. » En fait, les explications ont pour effet involontaire d’accroître la confiance des utilisateurs envers les algorithmes, indépendamment de la qualité de ces derniers… et les incite à accepter plus facilement des conseils algorithmiques erronés.
Pour Green, à nouveau, il faut passer d’une approche formaliste en la matière à une approche réaliste. C’est-à-dire s’adapter à la manière dont les gens interprètent et utilisent les résultats des systèmes pour prendre des décisions, et pas seulement en faire des outils de décisions pour les gens. Ils doivent venir aider les gens à améliorer leurs décisions plutôt que de les prendre à leur place. Pour cela, ce n’est pas l’humain qu’il faut placer dans la boucle comme le proposent les conseils éthiques, mais l’algorithme, défend Green. En plaçant l’humain dans la boucle, on l’a vu avec la chaîne d’élimination automatisée des systèmes d’IA pour faire la guerre, trop souvent, on ne propose qu’une validation humaine de décisions algorithmiques trop complexes, une pantomime de contrôle. « À l’inverse, l’approche par un algorithme intégré au processus humain reconnaît que les algorithmes sont introduits au sein de processus décisionnels humains préexistants. Ici, ce sont les personnes qui prennent les décisions. Les algorithmes viennent compléter l’analyse de la personne en lui fournissant des éléments pour l’aider à évaluer la situation. Ce qui importe en fin de compte, c’est ce processus de décision humain, et non la capacité de l’algorithme à prendre seul de bonnes décisions ou celle de l’humain à superviser l’algorithme. Un système à algorithme intégré au processus humain, un « algorithme dans la boucle » est tout outil automatisé qui fournit des conseils aux personnes dans le but d’améliorer la prise de décision.»
Confrontés à des décisions à prendre, les humains doivent concilier des objectifs contradictoires. Lorsque les inspecteurs sanitaires choisissent les restaurants à contrôler par exemple, ils doivent concilier la priorité donnée aux établissements présentant les risques les plus élevés et la nécessité de répartir équitablement les inspections entre les différents quartiers. La manière dont ces acteurs pondèrent ces considérations concurrentes influence considérablement leurs décisions.
« L’existence de ces arbitrages implique que les décideurs disposent d’une marge d’appréciation pour déterminer l’issue la plus appropriée dans chaque cas. Bien qu’elle puisse susciter des inquiétudes quant aux risques de partialité ou d’incohérence, cette marge d’appréciation est un élément essentiel d’une prise de décision de qualité. Au quotidien, les bureaucrates de terrain sont confrontés à des situations ambiguës, incertaines et imprévisibles. Supprimer cette marge d’appréciation reviendrait à imposer une logique rigide et formelle à ces situations, empêchant ainsi les agents d’adapter leurs décisions à des cas complexes ou inédits.
Par ailleurs, imposer aux décideurs le respect de règles prescriptives violerait le principe normatif selon lequel les décisions doivent tenir compte de la situation et des besoins des individus. La marge d’appréciation est donc souhaitable, tant sur le plan pratique que normatif : elle permet aux décideurs de trouver un juste équilibre entre des valeurs et des objectifs contradictoires, en fonction des circonstances particulières.
Pour exercer leur pouvoir discrétionnaire de manière réfléchie et bénéfique pour la société, les décideurs doivent faire preuve d’un sens de la responsabilité morale quant à leurs choix. Craignant que cette marge d’appréciation ne favorise de mauvaises décisions ou des abus de pouvoir, les autorités imposent souvent des contraintes strictes aux actions des bureaucrates de terrain. Ces stratégies de contrôle et de conformité permettent généralement de prévenir les dérives les plus graves liées à l’exercice de ce pouvoir. Toutefois, leur efficacité est limitée – un contrôle précis s’avère très difficile dans ces contextes – et il a pour effet de démotiver les agents. Une stratégie bien plus efficace pour améliorer la prise de décision des agents publics consiste à responsabiliser les travailleurs et à leur accorder l’autonomie nécessaire pour exercer leur jugement de manière optimale », comme l’ont souligné bien des chercheurs tels que Michael Lipsky, Street-Level Bureaucracy: Dilemmas of the Individual in Public Services (Russell Sage Foundation, 1980), Bernardo Zacka, When the State Meets the Street: Public Service and Moral Agency (Harvard University Press, 2017) ou Dan Honig, Mission Driven Bureaucrats: Empowering People to Help Government Do Better (Oxford University Press, 2024). Le but d’un algorithme ne peut se réduire à améliorer sa précision (pour autant qu’il le permette réellement, comme le soulignaient les chercheurs Arvind Narayanan et Sayash Kapoor dans leur livre, AI Snake Oil (Princeton University Press, 2024) et en pointant le fait que nombre de calculs n’améliorent que très marginalement leur résultats), mais doit prendre en compte nombre d’autres enjeux. Par exemple, un algorithme ne devrait pas chercher à « améliorer la précision des prédictions concernant la vulnérabilité des personnes sans-abri. » « À l’inverse, un projet intégrant des algorithmes dans la boucle décisionnelle déplacerait l’attention des prédictions vers les résultats concrets : « réduire le nombre de personnes vivant sans abri ou logement stable. » Par ailleurs, il conviendrait de prendre en compte les répercussions sur les travailleurs sociaux et sur les personnes sollicitant une aide au logement. Des objectifs connexes pourraient inclure : « améliorer le moral et le sentiment d’accomplissement des travailleurs sociaux » et « augmenter la proportion de personnes sans-abri estimant être traitées avec respect par l’organisme. » La nature multidimensionnelle de ces objectifs implique qu’il n’existera pas d’indicateur unique permettant de déterminer si le projet est une réussite.» D’une certaine manière, pourrait-on dire à la suite de Green, un système qui ne vise qu’à réduire le réel à une seule question sans ambiguïté, part d’une bien mauvaise analyse du réel et fournira par avance une mauvaise réponse.
Pour améliorer la décision, estime Green, il n’est pas toujours nécessaire d’amener des informations nouvelles à ceux chargés de décisions, mais de comprendre ce qu’ils priorisent déjà. Les travailleurs sociaux chargés de la protection de l’enfance dans le comté d’Allegheny, en Pennsylvanie, privilégient la sécurité immédiate des enfants, tandis que l’algorithme dont ils reçoivent les conseils (l’Allegheny Family Screening Tool, qu’avait étudié Virginia Eubanks) prédit la sécurité des enfants sur une période de deux ans. Cette différence explique pourquoi les travailleurs sociaux ont tendance à ignorer les suggestions de l’algorithme. Nombre de professionnels hésitent à suivre les conseils algorithmiques pour des décisions à forts enjeux, estimant que ces modèles négligent la dimension humaine et la situation particulière des individus. Enfin, pour être exploitables, les enseignements tirés d’un algorithme doivent s’inscrire dans les pratiques quotidiennes et les flux d’information de l’organisation. Dans le domaine médical, par exemple, l’élaboration d’un plan de traitement pour un patient comporte de nombreux aspects allant au-delà de la simple prescription de médicaments. Les médecins doivent prendre des décisions telles que la fréquence des consultations de suivi et l’éventuelle intervention d’autres professionnels de santé (par exemple, des kinésithérapeutes ou des thérapeutes comportementaux). Ainsi, les médecins indiquent qu’ils préféreraient recevoir des recommandations algorithmiques liées à ces étapes organisationnelles, plutôt que de simples indications sur le médicament à prescrire. Ils souhaitent également que ces conseils facilitent les échanges avec les patients et les collègues, car ils élaborent souvent les plans de traitement en collaboration avec ces différents acteurs.
Le développement d’un algorithme destiné à soutenir les conseillers d’une agence municipale de placement au Danemark met en lumière les avantages d’une collaboration étroite avec les décideurs et d’une ouverture d’esprit quant à la nature de la contribution à apporter. Dans ce cas précis, des spécialistes des données collaboraient avec des conseillers chargés d’aider les chômeurs à développer leurs compétences et à trouver un nouvel emploi. Au début du projet, les spécialistes des données prévoyaient de concevoir un algorithme capable de prédire quels demandeurs d’emploi présentaient le risque le plus élevé de chômage de longue durée. Il s’agissait là d’une approche classique en science des données, axée sur la prédiction de résultats individuels. Toutefois, les conseillers ont fait valoir qu’un tel outil entrerait en conflit avec leur éthique professionnelle. Pour eux, il est essentiel de croire en chaque chômeur et de l’aider à obtenir le meilleur résultat possible. Plutôt que des prédictions sur les comportements individuels, les conseillers ont demandé des prédictions concernant les processus organisationnels. Ils ont expliqué que l’un des principaux obstacles rencontrés par les usagers était la lenteur de l’avancement de leur dossier. Par exemple, des délais importants surviennent souvent lorsque l’agence doit rassembler les documents requis. Ces délais peuvent amener les demandeurs d’emploi à perdre confiance en eux et dans le processus d’accompagnement. Les spécialistes des données n’avaient jamais envisagé ce problème : ils supposaient que les dossiers étaient toujours traités rapidement. Or, les conseillers connaissaient bien ces délais longs et imprévisibles, qui constituaient un défi majeur dans leur travail. Pour y remédier, ils ont demandé un algorithme capable de prédire le temps d’attente estimé pour chaque personne. Cette information leur permettrait de préparer les demandeurs d’emploi au délai prévu et de les maintenir engagés dans des programmes tels que des thérapies ou des formations professionnelles durant cette période d’attente.
Cet exemple danois démontre que la contribution de la science des données qui semble la plus évidente n’est pas toujours la plus utile et l’importance à saisir les besoins de terrain.
Tout cela nécessite une immersion totale avec le terrain, explique Green. Il faut comprendre comment les agents interprètent les informations, si certains éléments leur semblent confus… Mais surtout, pour Green, cela suppose de dépasser la seule explication. Par exemple en proposant des exemples similaires pour les inviter à mettre leur décision en perspective ou en les invitant à réfléchir par eux-même à une décision avant de recevoir les recommandations des systèmes. « L’idée sous-jacente est que si les individus réfléchissent de manière autonome à une décision, ils l’analyseront plus en profondeur et seront mieux à même d’évaluer les recommandations de l’algorithme. Plusieurs études ont montré que les fonctions de « contrainte cognitive » conduisent à des prédictions humaines plus précises que les scénarios où les utilisateurs ont un accès immédiat aux recommandations algorithmiques. »
Une autre manière de faire consiste à guider le raisonnement sans recommander de décisions. Une autre manière encore consiste à proposer un éventail de choix par exemple en les rendant interactifs, permettant aux utilisateurs d’évaluer les conséquences des choix qu’ils ont à faire. « En encourageant une implication active – plutôt que passive – dans les systèmes intégrant l’humain dans la boucle algorithmique, l’interactivité aiderait les professionnels à préserver leur sens de la mission et leur autonomie lors de l’utilisation d’algorithmes, évitant ainsi de réduire leur pouvoir discrétionnaire à une simple formalité administrative.»
L’interactivité permet de conjuguer les capacités prédictives d’un algorithme aux connaissances spécifiques et contextuelles et à la démarche d’investigation du décideur. Ainsi, plutôt que de faire des recommandations de prescriptions pour traiter la dépression par exemple, les médecins devraient pouvoir adapter les systèmes aux situations individuelles.
Dans son manuel, Green soutient que la clé réside dans une interaction profonde des data scientist avec les usagers et ceux qui déploient des outils. Leur intervention ne peut être ponctuelle, plaide-t-il, elle doit s’inscrire profondément dans les pratiques réelles. Il invite également à se défaire du solutionnisme pour produire des systèmes qui élargissent les choix plutôt qu’ils ne réduisent, comme il le disait déjà il y a quelques années. A observer ce que les praticiens en pensent, comment ils réagissent aux systèmes et pas seulement à les déployer voire à les imposer, au risque de leurs échecs. Le développement algorithmique ne peut pas se faire à l’encontre des missions que remplissent les gens. « Les défaillances persistantes des collaborations entre humains et algorithmes sapent la théorie du changement qui sous-tend de nombreux projets de science des données, laquelle vise à obtenir de meilleurs résultats sociaux en améliorant la prise de décision.»
Green termine son livre en prévenant les data scientists de se défier de l’IA générative. L’IA générative accélère et prolonge la logique du formalisme algorithmique. Le risque est de les considérer comme des outils polyvalents, susceptibles d’être appliqués à grande échelle, négligeant toutes les spécificités contextuelles qu’il met en avant dans son manuel.
« Si la science des données continue à suivre le formalisme algorithmique, le domaine produira des outils de plus en plus puissants sur le plan technique, mais souvent inutiles, voire nuisibles sur le plan sociétal. » Face à l’automatisation qui risque de rendre le scientifique des données obsolète, il est nécessaire de réarmer ses capacités. C’est ce que ce manuel propose. « Le réalisme algorithmique offre une piste pour permettre aux data scientists de se distinguer dans un monde où de nombreux aspects techniques de la science des données ont été automatisés. En concevant les algorithmes comme des outils opérationnels plutôt que comme des modèles mathématiques, le réalisme algorithmique redéfinit l’expertise qui caractérise un data scientist efficace.»
Pour l’instant, et cela risque d’être pire à mesure que l’IA se répand partout, « la plupart des data scientists sont formés et employés dans des environnements qui n’encouragent pas – et souvent découragent – le réalisme algorithmique. » De l’enseignement à la recherche, le domaine, pour ne pas disparaître sous les applications produites par l’IA, a besoin de s’ouvrir aux enjeux sociaux et aux applications concrètes, plaide Green. Or, « on continue d’enseigner aux étudiants des sciences de l’information que les dimensions sociales et éthiques des algorithmes sortent du cadre », comme l’expliquait l’ingénieur Jimmy Wu. Pour remédier à cela, il faut reconnecter l’éthique à la pratique. Nous devons sortir des façons dont on enseigne l’éthique dans les écoles d’ingénieurs que ce soit par leur mise en œuvre mathématique et formaliste comme par le biais de dissertations morales déconnectées des enjeux applicatifs. « Il ne s’agit pas d’enseigner l’éthique de manière abstraite aux étudiants en science des données, mais de leur transmettre les orientations et les compétences favorisant une pratique éthique de la discipline ». Il recommande également d’avoir plus de cours cliniques, c’est-à-dire de faire travailler les étudiants sur des projets réels. Et d’aider les étudiants à quitter le monde de la tech où le formalisme règne en maître ou sinon à leur apprendre à promouvoir des produits et des comportements éthiques au sein des entreprises et à faire face aux dilemmes éthiques auxquels ils sont confrontés.
*
Green ne promet pas de révolution algorithmique. Il propose à la data science de se poser des questions que bien peu se posent, de faire un pas de côté. D’arrêter de croire que le calcul est la solution quand, bien souvent, il est le problème qui ne voit pas ses effets.
Hubert Guillaud
In the last 15 years, eight women have won the prize and just six men
© Getty Images

© San Francisco Police Department

For more than four months, Brian, a commercial fisherman in his late 40s, had been waiting for the weather conditions to be right for us to go fishing outside Bagenkop, a small harbor town on the southern tip of the Danish island of Langeland.
“One more problem has come up,” Brian told me over the phone in early May. “I have lost my fishing license." He was no longer allowed to sell fish for a living. Instead of preparing his boat to go out to sea and to show me how fishing in Denmark had changed over his lifetime, Brian was now removing the registration number from its hull.
Across Denmark, coastal fishing communities are shrinking as catches decline. At the same time, warming seas, overfishing and pollution are putting increasing pressure on marine ecosystems.
“Plenty of fish in the sea”? Not anymore, say UN experts, with 35% of the world’s marine fish stocks being fished faster than they can be biologically replaced. Today, more than half of the fish we consume worldwide comes from fish farms.
This summer, sea temperatures along Denmark’s beaches reached 28 degrees Celsius, a record high. On September 2, the UN Environment Program warned that the world is likely to cross 1.5 C of warming above pre-industrial levels within the next few years. As the climate warms, the pressure on marine ecosystems grows.
In August, Iceland voted not to restart accession talks with the European Union, in part because of concern that it would lose sovereign control of its fishing industry. While fishing is not as major a part of Denmark’s GDP as it is Iceland’s, the EU’s impact has meant independent Danish fishermen have struggled to survive in the face of corporate competition.
For Brian, though, it’s about more than regulations. It is about watching the ocean he grew up with slowly disappear.
His story reflects a larger shift happening along the Danish coastline. Coastal fishermen, once a central part of the country’s history, are a vanishing breed.
For Brian, it was never about the money. Even when he was a teenager and he told his father he wanted to be a fisherman, his father said it was a bad idea. But the pull of the sea was irresistible. His life as a fisherman began as a hobby, accumulating experience and knowledge just by spending as much time as possible on water. He learned how to read the currents, the weather, and fish movements through experience rather than education. In 2019, despite the uncertainty surrounding the industry, he bought a commercial fishing boat. “When I started as a teenager, there were fish everywhere,” he said. But over the years, the numbers have dwindled starkly. Every few years, another Danish harbor became economically unsustainable. First Bogense, then Kerteminde, later Nyborg and Spodsbjerg. Each one of them followed the same pattern: fewer fish, declining landings, and growing questions about whether it was possible for small fisheries to continue their operations.

While working on this story, I spoke to ten small-scale Danish fisheries across the country. Half of them said they do not expect to still be fishing five years from now. In 2019, they said, ten nets could bring in between 150-200 kilos of plaice on a single trip. Two years later, the same nets would return with only two kilos. As the catches became smaller, so did the possibility of keeping a commercial license. Brian no longer caught and sold enough fish to keep his permit.
One day still stands out to him as perhaps the single worst he has experienced at sea. He had three nets in the water. The first one he hauled in looked normal. The second held fewer fish than expected. Then he started pulling in the third — the net was completely empty and covered in thick, black slime.
Marine biologist Stiig Markager told me that what Brian saw was a tell-tale sign of oxygen depletion. In 2025, around 40% of Danish marine areas were affected by low oxygen levels. Oxygen depletion happens when too many nutrients, mainly nitrogen and phosphorus from agriculture and wastewater, enter the sea. These nutrients fuel large algae blooms.
When the algae die and sink to the seabed, bacteria begin decomposing them, consuming enormous amounts of oxygen in the process. Climate change exacerbates the problem. “Warmer water contains less oxygen. At the same time, biological processes speed up when temperatures rise.” In practice that means algae grow faster, oxygen is consumed more quickly, and deep waters struggle to recover. Together, these processes reinforce each other. “When oxygen disappears, it damages the seabed ecosystem,” Markager said.
A new global study argues that aquatic deoxygenation is approaching an “unsafe space” and should be considered a potential tenth planetary boundary. The global ocean has lost around 2% of its oxygen over the past 50 years. The consequences for marine life are catastrophic, forcing either flight or suffocation.
Marine biologists have studied oxygen depletion in the Danish seas for decades. But, Brian says, “fishers are often the first people to see the effects of that depletion, directly in their nets.” It is a first-hand experience, fishers say, that is often discounted or ignored. Many independent coastal fishers say they feel increasingly excluded from political conversations about the ocean, despite spending their working lives at sea.
“It feels like we’re not really welcome anymore,” Brian said. He believes small-scale fisheries like his are being pushed out while decisions about the seas are increasingly made by those on land. “I think they don’t want so many people out there seeing what’s actually happening.”
For years, debates about oxygen depletion in Denmark have become deeply political. Marine scientist Stiig Markager says that the results of environmental research have repeatedly clashed with agricultural and political interests. “There is complete opposition from agriculture and from Venstre (a major center-right political party) to making research publicly available,” he said. “There is a clear political strategy from Venstre that there must be no interference with agriculture.”
According to Markager, tensions between environmental researchers and agricultural interests intensified during the early 2000s, as scientists linked nitrogen runoff from farming to oxygen depletion in Danish waters. Despite decades of plans and political promises, Markager says, the recovery many researchers hoped for never fully arrived.
For this story, I also contacted both the Minister of Environment and the Minister for Food, Agriculture and Fisheries to ask for an interview about the state of Danish waters and the future of small-scale fishing. Neither had time to answer questions.


One harbor that has felt the impact of the changing nature of Danish waters is Bønnerup Strand, which has transformed from a fishing town into a tourist destination. The harbor now features an ice cream shop, a hot dog kiosk, a seafood restaurant, and a mini golf course. The iconic blue Danish fishing boats are conspicuous only by their absence. Instead, boats built for leisure, not commercial fishing, are docked at the harbor.
Along the quay, an outdoor exhibition has been installed behind glass panels. It started last year, created by a local group of volunteers trying to preserve what Bønnerup Strand used to be. The pictures show fishing nets piled high, men in blue overalls, boats unloading their catch, and fish laid out in crates.
Movement. Noise. Purpose. It was a harbor bustling with life. Hans, in his 60s now, was once a fisherman in Bønnerup Strand. He walks past the diorama and tells me that twenty years ago “there were 60 or 70 fishing boats here, now there are two.” Some of the independent fishers chose to leave, their lives no longer making economic sense. Others lost their licenses. The rest have disappeared, not all at once, but gradually. Some left before it was too late, others had their boats seized by the bank when their revenue became too low. “Quite a lot of my colleagues had their boats taken by them," says Hans, referring to banks who repossessed boats because independent fishermen no longer made enough money to pay for them.
You could say that the gradual suffocation of the Danish seas began in 1909 with the invention of the artificial nitrogen fertilizer that transformed global agriculture. Artificial fertilizer rapidly became central to modern-day farming. By 1959, nearly 75% of farms were using fertilizer to increase crop production. At first, the growing amounts of nitrogen entering the sea did not appear harmful. During the 1960s and 70s, the extra nutrients actually increased algae and plankton growth, creating more food for some fish species. “There were actually more fish,” says Markager, the marine scientist, “but by the mid-1980s, the consequences had become impossible to ignore.”


On October 8, 1986, on Danish television fishermen in Gilleleje were seen pulling dead lobsters from the sea. The images became the subject of alarmed national conversation. For the first time, the public saw what oxygen depletion meant for life beneath the surface of the sea.
Hans, the fisherman from Bønnerup Strand, told me he was part of the television coverage himself. “Fishers had talked about pollution long before the dead lobsters,” he said. “But suddenly people started paying attention.” The public outrage pushed Denmark to act. In 1987, the country introduced its first Water Environment Plan, aiming to reduce phosphorus emissions from wastewater by 80% and nitrogen emissions by 50% within five years. For many fishers and marine scientists, it became the first real sign that the environmental crisis in Danish waters was finally being taken seriously. During the 1990s, nitrogen and phosphorus pollution declined significantly. Water in several fjords and coastal areas became clearer, and conditions slowly began improving. For a moment, it appeared the damage could still be reversed.
But by the early 2000s, many coastal fisheries were once again experiencing declining catches and, with it, a growing uncertainty about the future. Hans was one of those affected. Coming from a family that had fished for five generations, the harbor was never a tourist destination for Hans. It was a way of life. But on a sunny Friday in April back 2005, he sailed out to Kattegat for plaice. He knew it was over. “I said to my employee: “this is the last trip. I start working on land from Monday.”” He had made the decision months earlier, as the numbers of fish dwindled and regulations tightened.
It wasn’t an easy choice, but he had four children to think of. Climate change had taken away his livelihood. “You can’t do anything about it,” he said. “If you think too much about it, you go crazy.” Researchers describe this kind of environmental grief as solastalgia, the distress caused by watching a familiar environment change beyond recognition. Unlike homesickness, solastalgia happens while still remaining in the same place. For coastal fishers, the sea remains physically present, but the ecosystem they once knew and depended on, is disappearing.
Adapting has always been part of the job, says Hans. “There has always been a species that disappeared and then another one came.” But eventually, nothing was replacing what was lost anymore.

In 2002, marine scientists Stiig Markager and Peter Bondo Christensen from DMU, the Danish Environmental Research Institute, published research showing that around 75% of Denmark’s nitrogen emissions originated from agriculture through waterways and atmospheric pollution. The findings intensified tensions between marine scientists, politicians, and agricultural organizations about who was responsible for the declining marine environment.
In response to the worsening marine crisis, Denmark established DMU in 1989 to monitor oxygen depletion, nutrient pollution, and ecological changes beneath the surface. But their findings were inconvenient. By 2007, after nearly two decades as an independent institution, DMU was folded into Aarhus University as part of a wider restructuring of Denmark’s research sector. The decision sparked criticism from several environmental researchers and organizations, who feared the changes could weaken the independence of Danish environmental monitoring.
“Agriculture succeeded in closing DMU,” former researcher Bo Normander told the media. “Nature has lost.” In 2015, the Danish government introduced the controversial Landbrugspakke, easing environmental regulations on fertilizer use in an effort to increase agricultural production.
Critics warned that the policy could worsen nitrogen pollution in Danish waters at a time when oxygen depletion remained a recurring problem. In the years that followed, researchers from Aarhus University reported rising nitrogen emissions instead of the reductions politicians had promised. Markager argues that despite decades of environmental warnings, nitrogen pollution reductions largely stalled. While nitrogen pollution in Danish waters declined significantly after the first Danish Water Environment Plans in the 1980s and 1990s, researchers say the reductions have largely stagnated over the last 20-25 years.
Now, Denmark is trying to reverse that trend. In the first week of September, the country passed a historic new law changing how agricultural nitrogen is regulated. The law will take effect in 2027 and represents a significant tightening of the rules introduced in 2015.
Under the system introduced in 2015, farmers were allowed to fertilize closer to what was considered the agronomic optimum for their crops, while still operating within nationally defined nitrogen quotas and other rules. The new system moves in the opposite direction. Instead of relying primarily on broad national rules, nitrogen regulation will increasingly take the environmental sensitivity of individual areas into account.
Where a farm is located will thus matter much more. The requirements will vary depending on factors such as whether fields drain towards vulnerable rivers or coastal waters, and whether they lie above areas important for groundwater and drinking-water protection. For farmers, this means that the amount of nitrogen they can use will become more restricted in areas where the surrounding environment is particularly vulnerable.
For fishermen like Brian and Hans, the law represents a change they have long been asking for: an attempt to redress the damage done to Danish seas.


But understanding how the water became polluted is more complicated than it first appears. Much of the pollution data commonly referred to in public debates focuses on point-source pollution, which emanates from identifiable sources like wastewater treatment plants, industrial discharge, and fish farms, and is generally easier to measure. But most nitrogen pollution in Danish waters actually comes from diffuse sources, mainly agricultural runoff carried from fields through rainwater, rivers, groundwater, and the atmosphere. Unlike point sources, diffuse pollution is far harder to measure directly and comes with greater uncertainty in the data. As a result, wastewater pollution can often appear to be the biggest issue, even though agriculture remains the dominant source of nitrogen input into Danish waters.
For Hans, the consequences appear almost irreversible. These days, the fish often do not return. “There are still plaice here, but they’re too thin. They don’t gain weight.” Scientists point to several overlapping causes, and the suggested solutions are just as diverse. Activists call for stricter rules, fishers say there are already too many. Farmers reject blame, and governments insist wastewater is already being purified. Plenty of fingers are being pointed, but the problem remains.
Hans doesn’t expect it to change. “I don’t think we’ll have fish out here ever again.” These days, he’s on the other side of the industry, buying catch from fisheries and selling it to customers. “People have to get used to the fact that we don’t always have everything available on demand. With a changing climate, fish shops may no longer offer cod, salmon, or plaice like we’ve been used to.” Instead, he says, squid is becoming the new normal.
Still, while independent fisheries disappear, the demand for fish continues to grow. Instead of restoring the ocean, parts of the fishing industry are increasingly moving onto land.
In northern Denmark, companies like Skagen Salmon are now raising fish entirely inside closed artificial systems, where the water, oxygen, and temperature are carefully controlled. Outside, Skagen Salmon looks like a factory. No windows, just a large grey box near the coastline.
If the building had windows, the fish inside could look out at the sea. But these fish will never see, taste, or feel those waters. Instead, they are raised in artificial tanks until they reach market size. They are then slaughtered and sold to supermarkets and fish shops across the country.
Erica Hellerstein
Isobel Cockerell
Simon Allison
The post In Denmark, the sea can’t breathe appeared first on Coda Story.

Le gouvernement Carney avait instauré l’an dernier un financement de 1,7 milliard $ pour attirer ou ramener au Canada «les meilleurs talents».
Mélanie Joly, ministre fédérale de l’industrie, a annoncé hier que 540 millions $ avaient permis de recruter une première cohorte de 64 chercheurs.
Ces chercheurs ont accepté un poste de titulaire de chaire de recherche au pays.
[L'article Le Canada a attiré des dizaines de chercheurs établis aux États-Unis a d'abord été publié dans InfoBref.]

Dans l’édition 2026 du classement de Shanghai, un classement mondial des 1000 meilleures institutions universitaires établi par une université chinoise réputée, le Canada compte 30 établissements, dont 6 au Québec.
Le classement est fondé sur des critères principalement liés à la recherche: distinctions scientifiques, chercheurs les plus cités, publications dans des revues scientifiques.
Les trois universités canadiennes les mieux classées:
Les universités américaines occupent la tête du classement:
[L'article Les 100 meilleures universités au monde comptent une québécoise a d'abord été publié dans InfoBref.]
Astronomy, our window into the rest of the universe, happens in the dark. Planets, stars and galaxies – all the mysteries of the cosmos – only reveal themselves at night. But the night sky may be getting much brighter, thanks to an American company with a plan to conquer darkness itself by sending 50,000 giant mirrors into space.
What you are reading first appeared as a cover story for The Atlas, our new global publication with The Continent. Sign up here to get the next edition delivered to your inbox on August 27.
Astronomers are panicking.
It is an “existential threat” to optical astronomy, says the European Southern Observatory. A “disastrous” idea that will “permanently scar” the night sky, according to the Royal Astronomical Society. The American Astronomical Society told Nature it “would probably mean the end of ground-based astronomy, or optical astronomy, at least.”
Sthabile Kolwa agrees. “It will take away a very crucial part of our civilization,” she tells The Atlas. Kolwa, a senior lecturer in astronomy at the University of South Africa, studies the life cycles of galaxies, but today her concerns are more immediate. “It might come to this, that we just have to find them in the parking lot and say, ‘Hey, what are you guys doing? You’re going to ruin science for us.’ ”
The parking lot in question is in Hawthorne, California, outside the headquarters of Reflect Orbital. They call themselves The Sunlight Company. The start-up is celebrating: Earlier this month, the United States Federal Communications Commission (FCC) approved the launch of Eärendil-1, likely in a few months time.
This satellite, named for a character in JRR Tolkien’s The Silmarillion, will unfurl an 18m x 18m mirror in low Earth orbit. It’s designed to reflect sunlight onto the dark side of the earth, lighting a 5km2 patch of land with the strength of four full moons.
It is a proof of concept.
By 2035, Reflect Orbital wants 50,000 of its mirrors in space, delivering illumination “comparable to daylight” on demand to paying customers (“sunlight is the new oil,” says chief executive Ben Nowack). The company says this will allow solar panels to generate clean energy overnight; provide “safer, evenly-lit streets” to cities that pay for it; and keep construction sites and farms working 24/7.
There will be an app, of course, offering “sunlight as a service” – lighting up the night will be as easy as ordering an Uber.
Clean, renewable energy is at the heart of the company’s vision, a spokesperson told The Atlas in a statement. Reflect Orbital declined to respond to specific queries and said it is in constant dialogue with astronomers, scientists and environmental researchers to mitigate the impact of the light pollution: “We are able to dim the brightness of the service and turn it off at any stage. We control where the light shines when serving an authorised customer. Most people and most places will never see this light. It is precise, targeted and customers will require permits to receive the service.”
A new research paper, published in May, challenges Reflect Orbital’s position. Its author, the European Southern Observatory’s Oliver Hainault, concluded that the company’s 50,000 satellites would increase the background brightness of the sky by 300% – even when their mirrors are pointed somewhere else. This, coupled with a proposal from Elon Musk’s SpaceX to build vast data centres in space, would go “beyond the limit” of what astronomy can withstand.
What that means, in practice, is that the images from ground-based telescopes will be dramatically less useful, marred by streaks of light from passing satellites. The most distant light sources won’t be visible at all.
This will obscure evidence of other galaxies, hinder research into black holes and other cosmic phenomena, and potentially prevent early warnings of asteroid approaches. Cutting-edge astronomy will only be possible from space-based telescopes like the James Webb and the Hubble – access to which is already massively oversubscribed, and subject to political interference.
The night sky will look different to the naked eye, too. “The next time you’re away from urban light pollution, spend some time outdoors after dark and enjoy the view of the Milky Way and the constellations that have inspired awe since humankind woke to consciousness. Chances are those views are not here to stay forever,” wrote journalist Tereza Pultarova for Space.com.
The night sky is already a lot brighter than it was 150 years ago, when light bulbs started to become commonplace. According to Dark Sky International, a US-based nonprofit that advocates against light pollution, 80% of Earth’s human population already lives under some form of sky glow, most of which is generated on land. This has forced astronomers to seek out “dark sky places,” like the Atacama Desert in Chile or the Upper Karoo in South Africa, for their telescopes.
Humans can adapt to less darkness. But it is much harder for animals and ecosystems that have evolved alongside predictable rhythms of day and night. Nocturnal predators lose the ability to hunt; sea turtle babies can’t find their way to the sea; migratory birds are thrown hopelessly off course; and moths expend all their energy helplessly chasing artificial light sources.
“It’s almost like we are on a mission to obliterate natural darkness from earth,” said Ruskin Hartley, Dark Sky’s chief executive. “And now rather than do it street by street and bulb by bulb, let’s do it from space.”
Space is, in theory, protected by the Outer Space Treaty, a 1967 agreement signed by 110 countries, including all the major space superpowers. It states that “space is the province of all mankind." But that’s not what’s actually happening, Hartley argues. “In the US, it’s the most wealthy, most powerful individuals who are gobbling up as much of that orbital space as they can before someone else can get that opportunity” – with China, Russia and Europe all scrambling too for a greater presence in low Earth orbit.
“Who gets to choose that we light up the night sky? Who gets to make that decision?” Ruskin asks. In the US, it is the FCC’s job to decide what satellites are allowed in space. But it has said that assessing the impact of light pollution or environmental damage is not within its remit. Instead, it wants to slash regulation so American companies can take advantage of the “space industrial revolution.”
And Reflect Orbital has rich and powerful backers. Earlier this year, it secured a $1.5-million contract from the US air force, hinting at possible military applications for its mirrors. Last year, it raised $20-million from three venture capital firms, including Sequoia Capital, one of the biggest investors in Silicon Valley. Sequoia also owns a multibillion-dollar stake in SpaceX, which has its own plans for low earth orbit.
There are already more than 10,000 Starlink satellites up there, giving Elon Musk unprecedented influence over global communications. The company wants to launch one million more satellites over the next few years to build a network of space-based data centres. In addition to the light pollution, astronomers worry the potential for collisions will increase dramatically, as will risks to the ozone layer.
On her blog Higher Dimensions, the astronomy professor Janna Levin contemplates our brighter future. “It is quite possible that the hot glow of the swarm of data satellites will saturate the night, washing out the stars from our perspective on Earth. We’ll look up into the sky and instead of Zeus transformed into a swan outlined in a constellation of a few stars, the machine gods will literally loom above us, glowing with radiant heat, making declarations, predicting the weather, forecasting then determining our fate.”
Kolwa, the South African astronomy lecturer, offers a different metaphor: that of empires “colonizing low Earth orbit.” This was an ambition of one of the most infamous imperialists of them all, Cecil John Rhodes, who said that he looked up at the stars and thought: “I would annex the planets if I could; I often think of that. It makes me sad to see them so clear and yet so far.”
But it hasn’t been colonized just yet.
“I’m still trying to figure out what we can do, what responsibility we have as scientists,” says Kolwa. “How could we engage our communities to stand up to these corporations and say no? We must keep our night skies dark, as dark as possible.”

Isobel Cockerell
Isobel Cockerell
The post Darkness is losing its war with the light appeared first on Coda Story.
L’entreprise de biotechnologies américaine Moderna va entamer un essai clinique de phase I pour évaluer son vaccin contre la souche du virus à l’origine de l’éclosion qui a fait, depuis mi-mai, plus de 1000 morts en République démocratique du Congo.
La phase I d’un essai vise à évaluer:
Moderna devra ensuite mener d’autres essais avant de soumettre son vaccin à Santé Canada en vue d’une homologation.
[L'article Santé Canada autorise Moderna à tester un vaccin contre la maladie Ebola a d'abord été publié dans InfoBref.]
After kilometers of flat, orange desert, the bus dives down through an increasingly lunar landscape as it reaches San Pedro de Atacama. Amidst the sea of red rocks, patchy vegetation and distant high plains known as altiplanos, a small sign appears on the side of the road. The entry marker has been tagged in graffiti. “Se vendió los salares.” “They sold the salt flats.”
The town of San Pedro, located in the north of Chile not far from the borders with Argentina and Bolivia, then appears like an oasis. In this hub for international tourism, small buses packed with visitors make trips from the dusty, bustling center to explore the region’s various geysers, sand dunes and volcanoes. Night sky tourism ventures offer a unique look at the southern stars. But it is the vast white salt flats, formed between 100 and 10 million years ago, that people come from around the world to see.
As tectonic plates slowly shifted, water flowing from the Andes mountains lost access to the sea and settled into a natural drainage area known as an endorheic basin. Here, water evaporated quickly, leaving a white crust of salt on top and below, a rich mélange of minerals – lithium, potassium, magnesium, and boron — encased in brine. The Salar de Atacama is one of the biggest salt flats in the world — and one of the most important.
On March 11, Jose Antonio Kast, Chile’s new president took office. Kast, a conservative ostentatiously close to Donald Trump, has long been a critic of Chile’s national lithium strategy. One of his first actions as president was to sign an exploratory deal with the United States to extract rare earths and essential mirals. Chile, the world’s largest producer of copper and second largest of lithium, is central to the Trump administration’s plans to reduce its reliance on China as a source of the rare earths and metals that are fundamental to modern industry, from semiconductors to electric vehicles to batteries to defense technology.
Even before Kast took office, he attended Trump’s “Shield of the Americas” summit in Miami, an ostensibly security-related alliance that is also an attempt led by the U.S. to curb China’s growing influence in Latin America. Under the previous Chilean government, China had become a dominant player in the national lithium industry, as it had in Argentina. With Javier Milei, a Trump ally, in office in Buenos Aires, having another ally ensconced in Santiago has been a significant boost to U.S. plans to reclaim its role as the overwhelming regional hegemon. It was intervention from Washington, for instance, that led to Chile abandoning a $500 million Chinese telecom deal to link the two countries via undersea fiber optic cables.
Amidst the geopolitical wrangling, though, is the question of who benefits from Chile’s national resources and what impact the relentless drive to extract those resources has on the country and its people.
Sonia Ramos Chocobar sweeps kibble from the small kitchen table of her home on the outskirts of San Pedro and shoos her five dogs and three cats into the yard. Chocobar has just returned home after several days in neighboring Calama – where she was attending the first-ever Salt Flats Conference – and the house is a mess. The climate activist has made time between her afternoon grocery shopping and an evening community gathering to meet with me.
Chocobar, in her 70s, is a bit of a local legend. In 2009, she made national news when she and another environmental activist (Amelia Mamani, since deceased) silently walked from San Pedro to Santiago, a distance of 1,534 kilometers, to raise awareness about the environmental risks of geothermal exploration near a geyser known as El Tatio — sacred to the Lickanantay indigenous community she comes from. The “march of the grandmothers” was followed by other environmental actions. Most recently, Chocobar walked to Antofagasta, the gritty port town that exports much of the copper, lithium and other resources mined out of the vast expanses of land in what’s known as Chile’s Gran Norte (“Greater North”) region.
This time her message was different: save the Atacama salt flats.
The broader area where the borders of Chile, Argentina and Bolivia converge is often referred to as the world’s “lithium triangle.” This lost corner of South America is believed to hold 68% of the world’s lithium reserves — a key element in the production of the lithium-ion batteries that fuel not only electric vehicles, but, increasingly, data centers and other large “green” infrastructure projects. San Pedro, roughly in the middle of the triangle, is sitting on a modern gold mine — and a faultline for the future of renewable energy.
The town of 2,500 full-time residents has long been at the center of a tug-of-war between different actors, all of whom claim sovereignty – dominion – over the salt flats surrounding it: the indigenous communities who have called this environment home for centuries, the Chilean state and the international markets salivating over the “white gold” extracted from it. Over the years, and through much negotiation on local, national and international levels, a sort of entente had been reached: the state owns the resource, private companies exploit it and some of the profits kick back to local communities. Lithium was even granted a special status under a dictatorship-era decree: a “strategic” mineral, only to be mined with the express agreement of the State. The election of Kast has already disrupted this tenuous equilibrium. The Chilean president has removed environmental protections from roughly 40 different types of natural resources — reopening the tap that has long fueled extractivism and inequality in Chile after four years of left-wing, protectionist policies.
With counter space cleared and the tape recorder set, Chocobar begins to speak, choosing her words carefully and pausing regularly for emphasis. She sounds tired, but steely. “We are always in a constant effort to protect our water, our land,” she tells me. “We have the misfortune of the Pacific. And we have the misfortune that the Salar de Atacama is one of the greatest lithium sources in the world.”
It wasn’t always this way — in fact, the “resource curse” is relatively new, she explains. For a long time, the Atacama desert was viewed by most Chileans as a no man’s land. Growing up as a member of the Lickanantay indigenous community — also known as the Atacameño people — Chocobar learned how to coexist with the harsh environment, rather than to dominate it. How to extract groundwater, which plants to grow, when and where to shuffle crops. “If we are millenary people, it is because we have found many ways to survive here,” she says. “People think the desert is lifeless, but it’s the exact opposite.”
Over her many years, Chocobar has seen these techniques slowly disappear: dried-up streams, dying flora and fauna, water rerouted from communities to corporations. The natural richness of the desert lands she calls home has been converted into a monocrop for export. The culprit? The world’s increasingly rapacious appetite for rare earths and metals.
Lithium demands huge amounts of water. To extract the resource through a process called brine evaporation, mineral-rich groundwater is pumped from beneath the salt flats at a rate of thousands of liters per second into vast open-air ponds. Then, the water is evaporated to reveal the lithium. 95% of this groundwater — which once belonged to the smattering of 18 indigenous communities that inhabit the region — quite literally disappears into thin air.
For local communities, the strain is already noticeable. In San Pedro, an estimated 49% of residents don’t have access to running water, says journalist Ernesto Picco. In one town — the ironically named Santiago del Rio Grande — Picco has reported, 100% of residents have no access to water.
It's not only humans who are being affected. The water scarcity has modified the breeding and feeding habits of alpaca populations, a local llama herder in neighboring Toconao, Hugo Flores, told me. A river used to run through San Pedro. On one of my days in town, I climbed down a ladder and walked across the dried up stream to get a better view of the distant Licancabur Volcano. The caked ground chipped under my sandals.
“We’re sitting on a watershed, and yet there is water scarcity,” Chocobar explains. “We’re being conquered, in a sense — commercially, economically. It is a natural laboratory that is being destroyed.”
Lithium hasn’t always been so coveted.
When it comes to minerals, in Chile, copper was for a long time — and still is, to a certain extent —king. Since its discovery in the 1880s, the South American country has been one of the world’s largest exporters of copper, which is drilled out of open pit mines in the Gran Norte region. From the window of a taxi in the port city of Antofagasta the day before, I had admired the massive telescopic loading chutes that transport the mineral directly into the hull of boats, releasing brown-gold particles into the air that settles on surfaces — park benches, balconies, cars — across the city.
It wasn't until the 1960s that the Chilean government began to recognize the benefits of lithium after accidentally discovering it buried in salt brine during an exploration aimed at identifying additional water sources for copper mining. The timing couldn’t have been better. “After World War II, there was a lot of speculative value in lithium as a nuclear material,” James J. A. Blair, a professor at Cal Poly Pomona who has published several papers on lithium mining in Chile, explained over a recent video call.
In 1979, about six years into his 17-year iron reign and following the lead of the United States, which had done the same, Chilean dictator Augusto Pinochet declared lithium a “strategic resource” reserved exclusively for the state — not on account of its economic potential, which was at the time unknown, but as a national security stockpile.
This seemingly small linguistic tweak has had long-lasting effects.
After Pinochet’s decree, lithium extraction came under the auspices of Chile’s State Development Agency, CORFO, which started to ink contracts with private firms for further exploration. A year later, CORFO partnered with U.S.-based Foote Minerals to form the Chilean Lithium Company (SCL), in which the state held a 45% stake.
What began as a Cold War precaution would quietly harden into one of the most unusual resource regimes in the world. By carving lithium out from the standard mining code, written in the 1930s, the Chilean state created a hybrid model. Lithium was not exactly nationalized, but neither was it fully privatized. “Lithium sits in a legal gray zone in Chile,” Blair told me. “It’s formally non-concessionable — meaning private actors can’t just stake a claim the way they would for copper — but in practice, the state has delegated extraction through long-term agreements that are incredibly favorable to a small number of firms.”
During the dictatorship’s wave of privatizations in the 1980s, control over key lithium assets was transferred to a small circle of politically connected actors. Among them: Julio Ponce Lerou, Pinochet’s son-in-law, who would go on to run SQM, now one of the world’s dominant lithium producers.
“Decisions were made in a highly centralized and opaque way,” researcher Gonzalo Gutiérrez told me over cafeteria food at the University of Chile, in Santiago. “By the time lithium became economically important, the institutional framework was already locked in.”
That framework has proven to be remarkably durable. Even as Chile transitioned back to democracy in the 1990s and expanded its role as a global mining powerhouse, lithium remained an exception — governed not through open concessions but through a handful of contracts administered by CORFO.
In her 2025 book “Extraction,” researcher Thea Riofrancos notes that even today, two firms — SQM and Albemarle — effectively operate as a “a legally sanctioned private duopoly.” Control over lithium, she writes, is a tightrope between “the palpable potential of public control and the reality of corporate dominance.”
For Ramón Balcázar, the founder of the San Pedro-based nonprofit, Fundacion Tantí, this legal exceptionalism has had profound consequences on the ground. “The state claims ownership, but the impacts are local,” he said. “Communities were never meaningfully included in the design of these contracts, yet they are the ones living with the depletion of water and the transformation of their ecosystems.”
Balcazar’s nonprofit sits on a side street in San Pedro, across from a trendy French bakery called La Franchuteria that sells iced lattes at European prices.
Since its founding in 2016, Fundacion Tanti’s small team of researchers has studied the effects of lithium mining on indigenous communities in the Atacama desert. The period has coincided with nothing less than an explosion in the demand for Chilean lithium.
The growth has mostly been tied to a dramatic rise in demand for electric vehicle batteries. Between 2015 and 2024, global lithium demand grew roughly sixfold, largely driven by EV batteries. The boom has fundamentally reshaped lithium markets: whereas EV batteries accounted for only about 15% of lithium demand in 2017, they made up roughly 85% by 2023. In Chile, arguably the world’s lithium breadbasket, raw materials are mined for export but rarely do its benefits trickle back down to communities.
“Where is the lithium going? To Elon Musk?” Daniela Rodriguez, a local journalist and activist I spoke with in San Pedro, asked. “To send rockets into space, to power electric cars that you never even see around here?”
In 2021, Balcazar and fellow researchers came up with a neat term for this phenomenon: “green extractivism.” “What we are seeing is not an energy transition — it’s an expansion of the extractive frontier under a green label,” he told me.
Faced with increasing demand for lithium to fuel the “green revolution,” the Chilean state has tried to thread the needle. In 2019, after a wave of mass protests against neoliberal inequality known as “el estallido social” (the social uprising), Chileans elected Gabriel Boric, a young, tattooed reformer who promised to, among other things, reassert state control over the lithium supply chain to redistribute its value.
“Lithium is the mineral of the future,” Boric said on the campaign trail. “Chile can’t make the historic mistake of privatizing resources again.” His government promised a paradigm shift: more community involvement, more protection of wetlands, greener methods of extraction. Lithium, he seemed to say, would benefit Chileans across the whole supply chain and not just a select few at the top.
In April 2023, the government announced its National Lithium Strategy. The policy sought to expand production while increasing state control through public-private partnerships, renegotiate the contract with SQM (the same private company once headed by Pinochet’s son-in-law) and include community and indigenous participation in future lithium exploration decisions.
In all, Boric’s government identified 68 salt flats that could be opened to mining exploration, but also 27 wetlands to be protected, Riofrancos, the author of “Extraction,” notes in her book.
“The national lithium strategy is Boric's most successful policy,” Nicolas Grau, Boric’s former finance minister, told me over the phone. “It will allow Chile to industrialize through lithium — growing the economy while also protecting the environment.” After years of passive control, the state would finally take a more “protagonistic role” in managing the resource, Grau said, without nationalizing it.
To Riofrancos, the juggling act under Boric was typical of what happens when a state tries to pry some space in a market where extractivism has long been left unchecked. “Boric’s blueprint cited Allende as an inspiration, but his approach was more conciliatory toward extractive capital than anything Allende had proposed,” she writes.
Local communities in San Pedro felt similarly. “The only thing politicians care about is being in power,” Chocobar said in San Pedro. “For all intents and purposes, we might as well not exist.”
Boric’s successor, Kast has quickly rolled back environmental protections, fulfilling his campaign promises of commercializing mining and partnering with the U.S. regardless of the environmental impacts on the salt flats.
Jorge Heine, a former Chilean diplomat and expert on international relations, argues that Kast is more constrained than it might appear. “People tend to overestimate how much a single administration can reshape lithium policy,” Heine explained. “This is a sector governed by long-term contracts, by international commitments, and by a legal framework that has proven remarkably resilient. Kast can tweak, accelerate, or slow things down, but dismantling the model entirely would come at a significant political and economic cost.”
But huge costs are already being paid, costs that communities in San Pedro have been living with for decades. Could Kast’s attempts to liberalize lithium mining and potentially exacerbate inequalities and environmental damage galvanize resistance?
For now, the signs of that resistance are still weak: graffiti scrawled on the side of the road, a grandmother walking along a highway with a cardboard sign, four panels of wood hung in a town square. But like lithium itself, transformations tend to take place very slowly at first — millennia of build-up in the brine — until suddenly they happen very fast. From Santiago to Atacama, protesters have been taking to the streets. In June, broader protests against Kast’s dismantling of social programs and services turned violent.
At some point, austerity for the people contrasted with largesse for mining companies, technology companies and acquisitive foreign powers becomes hard for even a government elected in a landslide to defend.
Phineas Rueckert
Isobel Cockerell
The post The Chilean curse is its abundance of riches appeared first on Coda Story.
Les promesses de l’IA pour découvrir de nouveaux matériaux ou révolutionner les découvertes scientifiques sont fortes. L’idée que l’IA serait l’avenir de la science comme on l’entend très souvent est bien plus un moyen d’orienter les investissements qu’une vérité scientifique, au risque d’augmenter la dépendance de la science à l’IA.
Dans le domaine de la fabrication de médicament, on attend là encore que l’IA permette de nouvelles percées, explique The Economist. Pourtant, les partenariats entre entreprises pharmaceutiques et sociétés d’IA se multiplient, notamment dans l’espoir de mieux identifier des molécules, de raccourcir le temps de développement des essais cliniques et de diminuer le taux d’échec de ceux-ci (actuellement, « les médicaments candidats entrant en essais cliniques ont un taux d’échec de 90 %, ce qui porte le coût de développement d’un médicament efficace à la somme astronomique de 2,8 milliards de dollars »). « Même des gains d’efficacité marginaux représenteraient des avantages considérables. Des rapports provenant de l’ensemble du secteur suggèrent que l’IA a commencé à apporter ces gains. Elle a réduit la phase préclinique (celle qui précède les essais cliniques sur l’homme) à 12-18 mois, contre trois à cinq ans auparavant. Et elle a amélioré le taux de réussite. Une étude publiée en 2024, portant sur les performances de molécules proposées par l’IA lors des premiers essais cliniques, a révélé un taux de réussite de 80 à 90 %. À titre de comparaison, les moyennes historiques se situaient entre 40 et 65 %. »
« La conception d’un nouveau médicament commence généralement par le criblage de petites molécules organiques afin d’identifier celles présentant une activité biologique prometteuse afin de sélectionner les plus probables. L’IA peut analyser des bibliothèques de dizaines de milliards de molécules, en testant des propriétés telles que la puissance, la solubilité et la toxicité grâce à des émulations logicielles de ces molécules, sans qu’il soit nécessaire d’utiliser les molécules réelles en laboratoire. Jim Weatherall, l’un des responsables de cette activité chez AstraZeneca, une autre grande entreprise pharmaceutique, affirme que cette méthode permet de trier les molécules prometteuses deux fois plus vite qu’auparavant, et que plus de 90 % du processus de découverte de petites molécules de l’entreprise est désormais assisté par l’IA. »
L’IA sert donc d’abord à optimiser les investissements. L’IA contribue également à améliorer la conception des essais cliniques. Par exemple en formulant une hypothèse sur une maladie et en tentant de confirmer ou d’infirmer ces hypothèses par une recherche bibliographique.
L’IA se révèle également prometteuse dans la sélection des patients pour les essais cliniques. Elle peut analyser les dossiers médicaux, les biopsies et les examens d’imagerie des candidats afin d’identifier ceux qui pourraient tirer le meilleur parti d’un nouveau médicament. Une meilleure sélection des participants permet de réduire la taille des essais, et donc de les rendre plus rapides et moins coûteux. Un autre utilisation de l’IA consiste à créer des patients synthétiques permettant de comparer un patient réel et son double numérique pour comparer l’évolution prédite sans traitement par rapport au patient testé. A terme, les patients synthétiques permettrait de réduire les groupes témoins et leurs coûts (au risque tout de même que ces comparaisons aient une fiabilité relative).
L’optimisation des essais cliniques via l’IA représente une réduction considérable des risques, avec une diminution concomitante des coûts de développement des médicaments.
Mais si l’IA promet de produire de nouveaux médicaments, elle ne promet pas que nous ayons les capacités industrielles de le faire, comme le montrent les innombrables pénuries que nous traversons. Elle ne résout pas le risque d’abandon de la santé pour tous, qu’évoquait par exemple le philosophe Alexandre Monnin dans AOC il y a quelques mois (voire notre synthèse).
Au contraire. Dans le domaine de la médecine, comme le soulignaient l’avocate américaine des sans abris Leah Goodridge et la médecin et chercheuse, Oni Blackstock, directrice de l’association Health Justice, dans une tribune pour The Guardian, l’IA risque bien plus d’être utilisée pour refuser des soins que pour faire progresser la médecine. En Californie du Sud, où le nombre de personnes sans abris est l’un des plus élevé du pays, Akido Labs gère des cliniques pour les personnes sans domicile fixe et celles à faibles revenus. Mais ces patients sont vus par des assistants médicaux qui utilisent l’IA pour écouter les conversations, puis proposer des diagnostics et des plans de traitement potentiels, qui sont ensuite examinés par un médecin. L’objectif de l’entreprise, a déclaré son directeur technique à la Technology Review, est de « supprimer le médecin de la consultation ».
Cela s’inscrit dans une tendance plus large où l’IA générative est de plus en plus intégrée au système de santé, rappellent Goodridge et Blackstock. En 2025, une enquête de l’Association médicale américaine a révélé que deux médecins sur trois utilisaient l’IA dans leur travail quotidien, notamment pour diagnostiquer les patients. Une start-up spécialisée en IA (OpenEvidence, qui n’est pas accessible en Europe) a levé 200 millions de dollars pour fournir aux professionnels de santé un ChatGPT pour médecins. Et les législateurs américains examinent actuellement un projet de loi qui autoriserait l’IA à prescrire des médicaments. Bien que cette tendance à l’intelligence artificielle dans le secteur de la santé affecte presque tous les patients, son impact est plus profond sur les personnes à faibles revenus, qui rencontrent déjà d’importants obstacles à l’accès aux soins. « Les personnes sans domicile fixe et à faibles revenus ne devraient pas servir de cobayes pour l’IA dans le domaine de la santé. Au contraire, leurs voix et leurs priorités devraient déterminer si, comment et quand l’IA sera mise en œuvre dans leurs soins ».
La saturation des hôpitaux, les coûts d’accès au soin… expliquent en grande partie ces développements. D’autant que ces contraintes « sont souvent amplifiées dans les communautés économiquement défavorisées, où les établissements de santé sont souvent sous-financés et les patients non assurés, avec un fardeau plus lourd de maladies chroniques dû au racisme et à la pauvreté ». Les très documentés biais des IA de santé, « qui diagnostiquent bien moins les problèmes des patients noirs et hispaniques, des femmes et des patients bénéficiant de l’assurance Medicaid, promettent surtout d’aggraver les inégalités de santé pour les patients qui rencontrent déjà des obstacles à l’accès aux soins ». Pire, comme on le lit dans la TR, les patients ne sont même pas informés que leur professionnel de santé ou leur système de santé utilise l’IA. Un assistant médical explique ainsi que ses patients savent qu’un système d’IA les écoute, mais qu’il ne leur dit pas qu’elle formule des recommandations diagnostiques. Ces discriminations sont renforcées par la tendance croissante à l’utilisation de l’IA pour déterminer les remboursements de santé des personnes à faibles revenus (voir ce que nous disions d’United HealthCare connu pour sa politique de refus de remboursement de soins de santé). Bref, si l’IA d’un côté promet une amélioration de la production de médicaments, elle risque bien plus d’empêcher les publics d’y accéder.
Il y a d’autres domaines que l’IA accélère, comme le pointait Cade Metz dans le New York Times. Notamment la recherche en mathématiques, en biologie et en chimie. Mais là encore, bien des annonces tonitruantes se révèlent souvent assez décevantes une fois que les spécialistes les décortiquent. C’était le cas notamment lorsqu’une startup d’IA, Harmonic a annoncé avoir résolu un problème mathématique, avant que les experts ne constatent que ses solutions ne différaient guère des travaux antérieurs de mathématiciens. L’IA parvient à identifier des solutions existantes, enfouies dans des décennies d’articles de recherche plus qu’elle n’en invente. « On a l’impression d’être face à un élève brillant qui a tout mémorisé pour l’examen, mais qui ne comprend pas vraiment le concept », assène le mathématicien Terence Tao. L’IA permet bien plus de suggérer des hypothèses ou des expériences qui permettent de cibler les recherches, explique un spécialiste du cancer, qui constate lui aussi que cela permet d’accélérer les processus. Mais un chercheur expérimenté est toujours nécessaire pour guider le système. Pour Terence Tao, interviewé dans Nature, l’IA peut commettre des erreurs invérifiables dans nombre de domaines, mais en maths, elles sont vérifiables. Les inconvénients sont donc bien plus limités. « On commence à voir des exemples où l’IA – peut-être par chance – résout des problèmes importants pour les mathématiciens. C’est encore très rare et l’IA présente encore de nombreuses faiblesses ; elle ne remplace pas le travail humain. Mais il devient de plus en plus difficile de nier l’efficacité de ces outils. » Mais définir de nouveaux concepts et déterminer les problèmes à résoudre restera probablement du ressort des mathématiciens humains… au moins pendant un certain temps encore, estime le médaillé Fields.
Si l’IA pour la recherche scientifique promet, elle pourrait aussi avoir des effets délétères, rappelle la journaliste Grace Huckins pour la Technology Review et réduire à terme le dynamisme de la science. Une étude publiée dans Nature a révélé que si certains scientifiques perçoivent des avantages professionnels à adopter l’IA, la science dans son ensemble pourrait en pâtir, car l‘IA réduit le champ d’investigation de la communauté scientifique. Cela pourrait s’expliquer par le fait que l’IA excelle particulièrement dans l’analyse de données et de publications existantes, ce qui incite les scientifiques qui l’utilisent à se concentrer sur des domaines établis où des données à grande échelle sont disponibles. Il pourrait en résulter un nombre réduit de scientifiques disponibles pour étudier des problèmes moins adaptés à l’IA. Intégrer efficacement l’IA dans la science est plus qu’un simple défi technique : préserver le dynamisme et la diversité de la science à l’ère de l’IA pourrait nécessiter un effort concerté de la part de la communauté scientifique.
Dans un éditorial pour Science, Julio Ottino et Brian Uzzi enfoncent le clou et dénoncent le risque d’une « progression sans progrès ». « Les progrès réalisés dans l’utilisation de l’intelligence artificielle pour faire progresser la découverte scientifique rendent de plus en plus réaliste l’idée de systèmes automatisés de « science de bout en bout » : des chaînes de traitement intégrées capables de générer des hypothèses, de mener des expériences (in silico ou robotisées), d’analyser les résultats et de produire des résultats publiables avec une intervention humaine minimale. La question cruciale n’est pas de savoir si l’IA peut « faire » de la science, mais si la science – en tant que système social et évolutif produisant des connaissances fiables – peut survivre à la manière dont l’IA la pratique. »
Or, « la science n’est pas simplement une suite de tâches optimisables. Elle progresse par un processus analogue à l’évolution darwinienne : variation à travers de nombreux efforts indépendants ; sélection par la critique, la réplication et la compétition ; et conservation des résultats robustes. Cette structure distribuée permet à la science de s’autocorriger et de générer de la nouveauté. L’indépendance n’est pas fortuite ; elle est le mécanisme qui produit à la fois la fiabilité et la découverte. »
Mais, la science n’a jamais pleinement atteint cet idéal, rappellent-ils. Elle a aussi été façonnée par les biais, les erreurs et la fraude. Les partisans de l’intelligence artificielle arguent que l’automatisation pourrait atténuer certaines de ces limitations tout en accélérant les découvertes et en élargissant la participation. Reste donc à savoir si l’IA en science réduit ces imperfections ou les amplifie à l’échelle des machines.
L’intégration de l’IA à la science risque de modifier fondamentalement la structure de la science. Notamment en favorisant des plateformes dominantes, entraînées sur des données similaires et optimisées pour certains objectifs. « Comme sur d’autres marchés de technologies numériques, la concentration est un résultat plausible. Le risque est fort qu’une poignée de systèmes façonnent la majorité de la production scientifique (…). La diversité simulée au sein d’un système ne saurait se substituer à la diversité épistémique entre des approches véritablement concurrentes.»
La conséquence n’est pas seulement institutionnelle ; elle est bien épistémique, c’est-à-dire qu’elle concerne toutes les connaissances. « Le système scientifique prospère grâce à l’inefficacité : efforts redondants, tentatives infructueuses et chemins divergents. Il ne s’agit pas de coûts à éliminer, mais de sources de découverte. À l’inverse, les pressions d’optimisation favorisent la convergence. Il risque d’en résulter une production accrue, mais une exploration moindre de l’inattendu.»
« Ce rétrécissement a des implications sur la créativité. Une grande partie de la force de l’IA réside dans l’exploration combinatoire, le réarrangement des connaissances existantes en de nouvelles configurations. Or, nombre d’avancées majeures en science ne sont pas des combinaisons ; ce sont des ruptures, des changements conceptuels qui contredisent les hypothèses des cadres antérieurs. Parce que ces avancées s’écartent des schémas encodés dans les données existantes, elles sont les moins susceptibles d’émerger de systèmes entraînés sur le passé. »
« L’indépendance n’est pas seulement une garantie de fiabilité ; elle est la condition de la rupture conceptuelle. » A l’inverse, « l’optimisation de chaque composant ne garantit pas l’intégrité de l’ensemble. » Au contraire, elle peut la compromettre.
« Il ne s’agit pas de rejeter l’IA, mais de la considérer comme un simple progrès technique. Préserver les propriétés fondamentales d’un système scientifique évolutif devient désormais une contrainte de conception. Les résultats scientifiques doivent garantir une traçabilité claire – une chaîne de responsabilité identifiable qui ne se dissout pas dans des systèmes opaques. Les dispositifs institutionnels et techniques doivent assurer des approches véritablement distinctes, et non de simples variations au sein d’une architecture partagée. »
« Ces exigences ne sont pas des inefficacités à éliminer par l’ingénierie. Elles représentent les solutions accumulées au problème de la fiabilité des connaissances. Un système d’IA peut produire des résultats impressionnants. Mais s’il remplace un processus évolutif par un processus artificiel, il risque de restreindre non seulement le champ de nos découvertes, mais aussi notre capacité de découverte tout court. »
Geraint Rees et James Wilsdon pour Nature tirent la sonnette d’alarme. L’IA est en train de submerger les appels à projets et demandes de financement de la recherche, améliorant le nombre, la qualité, le volume des demandes au risque de provoquer l’effondrement même du système. Les réponses générées par l’IA peuvent être entraînées sur les publications des chercheurs, sur les critères d’attribution des subventions et même sur les projets retenus pour ajuster les demandes aux résultats attendus. Et l’effet se constate déjà, pointent les chercheurs. Dans une étude qui a regardé les projets de 12 organismes de financement de la recherche de l’Union européenne, les chercheurs montrent une augmentation des candidatures depuis 2022.
« Les décideurs politiques et les organismes de financement vont devoir repenser l’allocation des fonds de recherche avant que le système ne devienne ingérable. » Confrontés à un afflux de réponses de qualité, ils devront alors faire des choix largement arbitraires quant aux projets à financer et aux candidats.
Jusqu’à présent, les organismes de financement de la recherche ont principalement réagi à ces évolutions en restreignant l’utilisation de l’IA par les candidats et les évaluateurs, certains déclarant les demandes inéligibles si elles sont élaborées avec de l’IA. Mais ces préconisations sont impossibles à appliquer car la probabilité de détection est faible et ne constitue pas une réponse au problème. Le risque est fort que toutes les propositions répondent aux critères de financement et que les différences entre elles soient minimes. « Lorsque les propositions et les évaluations sont toutes deux gérées par des agents entraînés sur le même corpus de travaux déjà financés, le système n’évaluera plus la qualité des idées, mais plutôt la capacité des agents à simuler les idées précédemment récompensées par les financeurs.»
« Parmi les propositions visant à remédier à la surcharge des systèmes de financement figurent le recours à des tirages au sort (attribution aléatoire de fonds à des demandes de subvention correspondant à un certain niveau de qualité) et des modèles distribués d’évaluation par les pairs, où les chercheurs qui soumettent des demandes de subvention sont chargés d’évaluer celles d’autres chercheurs. Ces mesures permettent de lutter contre le volume de demandes, mais elles restent inefficaces si les indicateurs de qualité deviennent peu fiables. »
Geraint Rees et James Wilsdon proposent plutôt que les organismes de financement envisagent de recentrer l’évaluation non plus sur les propositions écrites, mais sur le chercheur principal, son équipe et ses programmes de recherche passés et en cours. « Les financeurs devraient investir dans la vérification des antécédents afin d’examiner la performance de recherche d’un individu ou d’un groupe sur une période prolongée, ainsi que dans des entretiens et des évaluations de portefeuilles de la performance d’équipe sur la durée. » Mais cette solution écarte de fait les plus petites ou plus jeunes équipes : les aides risquent alors d’aller uniquement aux projets les plus établis.
En mars, le Conseil de la recherche médicale du Royaume-Uni a annoncé le rétablissement des entretiens pour tous les candidats présélectionnés : une approche chronophage et laborieuse et peu adaptée aux grands volumes de candidatures. Le NIH américain, regroupant l’ensemble des Instituts nationaux de la santé, lui, a limité à 6 dépôts par an le nombre de candidatures individuelles, après avoir constaté que certains chercheurs en soumettaient plus de 40. Les financeurs pourraient également envisager des approches plus radicales, suggèrent les deux chercheurs.Il pourrait s’agir d’instaurer un quota fixe de propositions par chercheur ou pour l’ensemble de sa carrière, toutes sources de financement confondues. Ils pourraient aussi répartir le budget disponible entre les chercheurs éligibles à l’échelle nationale et attribuer le même montant à tous, éliminant ainsi la concurrence.
D’autres solutions proposent aux organismes de recherche de s’appuyer sur l’IA pour l’évaluation. « L’IA pourrait ensuite servir à prioriser et à présélectionner les candidatures, en comparant les données selon ces différents profils afin d’identifier les candidats dont le parcours est cohérent avec les informations fournies dans leur dossier. Ce processus de présélection serait transparent, auditable et conçu pour favoriser la diversité, et non la freiner, à travers les différentes étapes de carrière, disciplines et institutions. » Mieux (ou pire, c’est selon), certains modèles proposent de prédire l’impact d’un article ou d’une recherche, fléchant les financements vers les projets les plus porteurs.
Quelque soient les solutions retenues, la nécessaire transformation du financement de la recherche risque de se faire dans la douleur et la contestation, estiment les chercheurs. La mise en place d’infrastructures IA nécessite des investissements soutenus, des tests rigoureux et une gouvernance continue. Les financeurs confrontés à des contraintes budgétaires pourraient hésiter. C’est oublier pourtant que le système gaspille déjà des ressources considérables en comités d’experts et en nouvelles soumissions, sans parler du temps consacré par les chercheurs à répondre aux appels. Un système basé sur l’IA native et bien conçu pourrait constituer un investissement judicieux, défendent les chercheurs. Reste que des systèmes d’évaluation entraînés sur des données de financement historiques intégreront les inégalités passées, risquant d’amplifier, plutôt que de corriger, l’effet Matthieu, c’est-à-dire la concentration au profit des plus dotés. « Il s’agit d’un risque réel, mais nous pensons que la conception et la gouvernance peuvent contribuer à l’atténuer. Les biais dans les systèmes d’IA sont mesurables, ce qui permet de les examiner et d’y remédier », soulignent-ils, certainement trop rapidement car les biais ne sont ni mesurables ni corrigeables facilement. Troisièmement, les chercheurs et les institutions pourraient se montrer réticents face aux décisions façonnées par des algorithmes qu’ils ne peuvent pas interroger. La transparence et les mécanismes d’appel pourraient contribuer à instaurer la confiance, défendent-ils encore.
Le système de financement par subventions conçu pour un monde pré-IA est devenu défaillant. Les financeurs doivent s’adapter, estiment les chercheurs. Il pourrait en résulter un système plus performant : un système qui exploite la puissance de l’IA et la combine à des connaissances spécialisées, et qui réduit le temps et l’énergie gaspillés dans la rédaction de demandes de subventions improductives pour les réorienter vers une recherche novatrice. Un constat plus facile à déclamer qu’à mettre au point.
Certains modèles proposent de prédire l’impact d’un article ou d’une recherche, fléchant les financements vers les projets les plus porteurs, expliquaient donc Geraint Rees et James Wilsdon. Qu’en est-il ?
Savoir si une étude changera le monde ? C’est pourtant l’idée que propose Funding the Frontier : un tableau de bord pour prédire l’impact de la recherche. L’outil (non disponible) utilise le Big data pour retracer l’impact sociétal des projets de recherche sur les politiques, les médicaments ou les produits, explique Nature (voir également l’article de recherche qui montre des captures d’écran du tableau de bord et la vidéo promotionnelle). Le projet porté par Dashun Wang « intègre des données sur les publications de recherche, les brevets, les documents d’orientation et les essais cliniques, et présente ces informations de manière visuelle et intuitive. Ils ont également combiné cet outil à un algorithme prédictif basé sur l’apprentissage automatique pour prédire les études et les domaines susceptibles d’apporter les plus grands bénéfices sociétaux à l’avenir – par exemple, les subventions les plus susceptibles de déboucher sur un brevet ». « Même sans son aspect prédictif, disposer d’un outil permettant de rechercher l’impact des recherches sur la société » est déjà une information importante, estime un chercheur.
Un chef de projet d’une importante agence de financement américaine l’a utilisée pour examiner les impacts sociaux généraux des subventions de l’agence, lui permettant de constater l’impact de certaines recherches ailleurs dans le monde. « Un autre utilisateur, investisseur dans le domaine de la recherche biomédicale, a constaté que dans le domaine de la recherche sur la maladie d’Alzheimer, l’impact clinique le plus important au cours des 20 dernières années provenait d’études visant à comprendre la maladie, mais que l’impact futur le plus important prévu se concentrait sur les études portant sur les systèmes de soutien social des personnes atteintes de la maladie, ce qui laisse entrevoir de nouvelles opportunités d’investissement ».
L’aspect prédictif est pourtant préoccupant, estime le même James Wilsdon qui en évoquait les perspectives précédemment. Le spécialiste des politiques de recherche estime que ce tableau de bord pourrait créer des prophéties autoréalisatrices et des décisions d’investissements plus conservatrices, au détriment de recherches plus originales, capables d’ouvrir d’autres possibilités.
En attendant, le travail académique commence à crouler sous la « prolifération métastatique de publications » truffées d’hallucinations et de distorsions de contenus, comme s’en plaint sur Facebook la philosophe du droit, Antoinette Rouvroy. L’Academic Slop est arrivé, constate également le chercheur Seva Gunitsky dans sa newsletter. Il raconte que dans la revue dont il s’occupait le nombre de soumission a doublé voire triplé depuis l’apparition de l’IA générative, et que le taux de rejet s’est envolé. Techniquement compétents, certains de ces articles respectent les normes et sont tout à fait convenables. Faciles à produire et exigeant peu de créativité, ils constituent néanmoins le type de travail incrémental légitime que le philosophe des sciences Thomas Kuhn appelait la fabrique de la « science normale ». Pour Gunitsky la valeur d’une théorie originale va continuer à prendre de l’importance. « Les travaux quantitatifs de qualité deviennent bon marché et abondants ; une bonne théorie reste difficile à élaborer ».
Mais l’effet le plus important est que l’évaluation par les pairs repose désormais davantage sur le discernement. Si n’importe qui peut produire un article empirique compétent sur n’importe quel sujet, le principal obstacle devient l’identification des questions importantes à poser. « Dans ce contexte, la question pour les évaluateurs et les éditeurs n’est plus tant « est-ce juste ?» que « pourquoi est-ce important ? ». Cette question est inévitablement subjective, mais pas totalement, car elle exige une solide connaissance des débats en cours. Elle nécessite néanmoins de connaître les tensions et les lacunes productives, les énigmes intéressantes et les idées reçues apparemment établies. »
« Ce concept porte un nom : la phronesis. C’était le terme employé par Aristote pour désigner la sagesse pratique, ou la capacité à discerner la conduite à tenir dans des circonstances particulières. Contrairement à l’épistémè (la connaissance scientifique) ou à la technè (le savoir-faire technique), la phronesis ne peut se réduire à des règles ou à des algorithmes. Elle requiert de l’expérience, du jugement et ce qu’Aristote appelait la « perception ». Cela signifie non seulement l’intelligence, mais aussi la capacité intellectuelle de percevoir les caractéristiques essentielles d’une situation donnée. »
La philosophe Isaiah Berlin appelait cette qualité « le sens du réel » dans le jugement politique : la capacité de percevoir ce qui est possible et ce qui compte à un moment historique donné. Or, il n’est pas certain que les IA possèdent cette capacité voire ne la possèdent jamais. « Si le discernement devient le critère ultime de qualité, nous nous dirigeons encore davantage vers un système à deux vitesses dans l’édition scientifique. Les revues les plus prestigieuses privilégieront les articles d’une originalité remarquable ou présentant des avancées théoriques ou empiriques majeures, tandis que toutes les autres publieront les articles produits par l’IA qui font progresser, de manière graduelle, notre compréhension de sujets spécifiques. Et peut-être que la théorie gagnera en prestige au détriment des méthodes sophistiquées d’analyse des données. »
Pas sûr que la théorie et l’empirisme puissent ainsi si facilement se scinder en deux. Le risque que les publications automatisées se transforment en matière noire scientifique, que personne ne lit ni ne consulte est fort. A nouveau, ici aussi, le risque est fort que s’accentue davantage les hiérarchies de prestige comme critère d’importance. « Paradoxalement, l’effet uniformisant de l’IA pourrait rendre le monde universitaire plus élitiste encore ».
« La technologie qui nous a inondés de dissertations étudiantes façonnées avec l’IA va maintenant inonder de nos propres travaux, et nous aurons besoin de ce même discernement dont nous nous plaignons de l’absence chez nos étudiants. » Pas sûr que ce soit plus facile pour les experts. L’IA fait peut-être gagner beaucoup de temps à certains, mais la pollution des travaux de recherche qu’elle engendre en fait perdre énormément aux lectrices et lecteurs. Le goulot d’étranglement de la lecture et de la vérification s’annonce plus reserré que jamais.
La seule chose dont on soit sûr, en observant toutes ces perspectives… ce n’est pas que l’IA apporte un progrès scientifique notable, c’est que l’IA en science renforce les inégalités dans toutes les couches de la science.
Hubert Guillaud
MAJ du 02/06/2026 : Une analyse de 7,3 millions d’articles de revues scientifiques publiés entre 2020 et 2025 révèle qu’en 2025, un peu plus de la moitié présentent des signes d’influence des LLM, avec des variations importantes d’utilisation selon la région du monde, le prestige de l’établissement, l’éditeur et la discipline. « Le développement économique et la proximité de l’anglais comme langue principale sont des facteurs prédictifs clés de ces variations régionales. Les établissements moins bien classés affichent des taux d’adoption plus élevés que les universités d’élite, les jeunes éditeurs à but lucratif présentent des taux supérieurs à ceux de leurs concurrents, et l’adoption varie considérablement selon les disciplines universitaires. L’adoption des LLM dans la rédaction académique est répandue, mais socialement stratifiée. »
MAJ du 21/06/2026 : Dans leur newsletter, Tim O’Reilly et Ilan Strauss, proposent de garantir un exosquelette pour appliquer l’IA à la science. Cet exosquelette est constitué d’innombrables systèmes permettant de garantir les références, comme le DOI (l’identifiant d’objets numériques qui attribue un numéro à chaque publication scientifique), RetractationWatch (la base de données des articles scientifique dépubliés et rétractés), Orcid (qui founit un identifiant unique aux chercheurs), Open Alex (un graphe de connaissances scientifiques)… ou encore le projet Vraix du MIT (cherchant à créer une toile du savoir pour distinguer les contenus possiblement génératifs des autres)… et nombres d’autres, qui n’ont pas été intégrés aux systèmes d’IA, alors qu’ils pourraient permettre de résoudre de nombreux problèmes : diminuer les citations erronées, réduire l’emprise de la littérature scientifique non valide… une infrastructure fondée sur des principes ouverts qui cherchent à garantir que les contenus scientifiques ne puissent être ni accaparés ni dégradés. Ces infrastructures sont des biens publics que les entreprises d’IA ignorent pour la plupart ou, pire, fragilisent. « À l’heure actuelle, la relation entre l’IA et l’infrastructure scientifique est presque exclusivement extractive. Les entreprises d’IA entraînent leurs modèles sur des articles scientifiques. Elles créent des produits capables de générer et de manipuler des textes scientifiques. Elles se disputent le marché de l’« IA au service de la science ». Pourtant, elles ne contribuent pratiquement pas à l’infrastructure qui, à la base, garantit la fiabilité des connaissances scientifiques. »
Les entreprises d’IA consomment du contenu scientifique sans rien apporter en retour. Strauss et O’Reilly font une analogie avec Content ID de YouTube : face à l’utilisation non autorisée de leurs œuvres, la première réaction de l’industrie musicale a été d’exiger leur retrait. La réponse de YouTube a été : « Et si nous vous aidions plutôt à les monétiser ? » Cette approche a permis d’aligner les intérêts et de créer une économie dynamique pour les créateurs. Nous devrions appliquer le même raisonnement à la science. Les entreprises d’IA ne devraient pas seulement utiliser l’infrastructure scientifique pour améliorer leurs produits (elles le devraient pourtant), mais elles devraient surtout chercher à aider la science à gagner en valeur, en pérennité et en exhaustivité.
Pour cela, les systèmes d’IA devraient améliorer la validation de leurs sources et références. L’infrastructure existe, il leur suffit de l’utiliser. Ils pourraient également réinjecter les métadonnées extraites dans OpenAlex, améliorant ainsi le graphe de données pour tous. Ils pourraient utiliser et financer RetractationWatch pour améliorer leurs modèles et réponses. Les fournisseurs d’IA pourraient également financer cette infrastructure scientifique très fragile qui constitue le socle technique de la crédibilité de la science. « Les entreprises d’IA, qui génèrent des milliards de revenus grâce à des produits reposant sur la crédibilité scientifique, devraient contribuer à l’infrastructure qui garantit cette crédibilité. Il ne s’agit pas de philanthropie, mais d’un intérêt bien compris.» Elles pourraient également contribuer a améliorer cette chaîne qui identifie la provenance du contenu scientifique. « Lorsque l’IA contribue à un article scientifique, cette contribution doit être traçable : elle ne doit pas simplement faire l’objet d’une déclaration standard, mais être liée à des affirmations, des sources et des étapes de vérification précises. »
« Les entreprises d’IA qui s’appuieront sur cette infrastructure créeront de meilleurs produits. Mais surtout, elles investiront dans l’infrastructure civilisationnelle qui rend possible, à la base, l’existence de connaissances fiables. À condition toutefois que les entreprises d’IA cessent de considérer cette question comme le problème d’autrui et commencent à la voir comme un socle sur lequel bâtir — un socle dont dépend leur propre succès dans le domaine scientifique.»
It starts with a simple search term in the Department of Justice’s Epstein Library. “Blue eyes.” Hundreds of results. Jeffrey Epstein’s international trafficking agents send him pictures and descriptions of blue-eyed young girls: potential victims to be dispatched to his various homes. “I spotted two skinny blond blue eyes 21 years old ladies in Monaco last weekend and asked them for CVs,” one agent, whose name has been redacted, wrote. “Trying her best to move from her small town to Moscow; English isn't great. Could be fun for Paris, blue eyes,” wrote another. “Can't understand if her breast is real. Otherwise very pretty and sweet…Very blue eyes as we like.”
One of Epstein’s victims wrote of being chosen for her eye color in a journal entry later shared with federal prosecutors. "Superior gene pool?!? Why me?" she wrote, describing Epstein's worldview as "Nazi like." "It makes no sense. Why my hair color and eye color?"
Epstein — himself blue-eyed — seemed to prefer both his victims, and the people he bankrolled, to have blue eyes. “All of my fundees have blue eyes,” he boasted in one email. In the entryway of his Manhattan townhouse, he displayed dozens of prosthetic eyeballs in a frame. Epstein made notes and sent article links to his contacts asking if having blue eyes meant you were more intelligent or a “genius”. He even had a list of scientists and tech leaders with blue eyes — including Elon Musk, Peter Thiel, and Google’s Ray Kurzweil. “Total — 70 people Blue eyes — 41 Unclear (might be blue, but not 100% sure)” the list says. Appearing in the files — whether on this list or elsewhere in Epstein's records — does not connote legal wrongdoing.
Going deeper into the files, Epstein and his network of contacts discussed beliefs about how physical characteristics and race might denote intelligence. They exchanged emails about population control. They spoke of engineering women’s sex drives, building designer babies, and living in a world full of superintelligent humans that could merge with robots. They spoke of getting rid of the elderly, the infirm, and the poor.
The files offer a glimpse into a world where ideas about eugenics and race science have never gone away. On the contrary, they run through our elite universities, through the most powerful companies in Silicon Valley, and through the tech industry itself. Epstein’s was an exclusive club that counted among its members people who harbor dreams of re-engineering human minds and bodies, seizing control of our collective future, and building technology that, they hope, will one day merge with — or even replace — all of us.
In 2002, two decades before the launch of ChatGPT, Epstein hosted an Artificial Intelligence summit on his Caribbean island. In the years that followed, he cultivated close, regular contact with a network of (predominantly male) scientists, researchers, academics and tech leaders working at the vanguard of AI, biotech, genetics and cognitive science, meeting them at universities like Harvard and at his various homes.
In August 2018, a year before Epstein was found dead in his jail cell, he was in email correspondence with software consultant and bitcoin investor Bryan Bishop about funding a project to create “designer babies” — children with genes cherrypicked for their looks, health, strength, immune systems, sleep needs and even, in Bishop’s imaginings, abilities to live on a different planet.
“Attached is the doc you requested, it's the "use of funds" spreadsheet for the designer baby and human cloning company,” Bishop wrote to Epstein. “This gets us out of our self-funded ‘garage biology’ phase to the first live birth of a human designer baby, and possibly a human clone, within 5 years. Once we reach the first birth, everything changes and the world will never be the same again.”
Bishop went on to discuss how his ultimate ambition was to make “practically unlimited modifications to the cells before generating an embryo.”
In response to a request for comment, Bishop sent Coda a publicly available set of answers to frequently asked questions about designer babies.
“The reason people have an aversion to eugenics, and rightfully so, is because countries used genocide and sterilization to prevent reproduction by populations that they didn’t like. We have no intention of doing anything of the sort,” Bishop writes in the public FAQ. “‘Designer baby’ simply describes a child whose genome has been intentionally altered or chosen by their parents, rather than left entirely to the genetic lottery of natural conception.”
“It’s such a great subject,” Epstein responded after he read Bishop’s proposal. “We need to get a read on legal. Can’t do anything where US rules apply to US citizens regardless of where [they are].”
Building a super-race of humans, and parachuting humanity into a different evolutionary era — or even obsoleting the human race as we know it — is a running theme in the Epstein files, and an increasingly prominent ambition for tech evangelists today.
“It’s eugenics all the way down,” said Jacob Metcalf, a founding partner at Ethical Resolve, a consulting firm working with tech companies to develop their ethics protocols. A common fantasy in tech circles, he said, is “to essentially control human destiny. And a lot of the times that human destiny is for humans to be replaced. That's the really bleak thing here. What could be more eugenic than getting rid of humans.”
In 2008, Epstein began conversations with the computer scientist Ben Goertzel. Over the years, Epstein would send Goertzel more than $360,000 to fund the researcher’s plans to build towards Artificial General Intelligence (AGI), a term Goertzel himself popularized.
“I remain eager to move forward on working together to accelerate progress toward a human-obsoleting thinking machine,” Goertzel wrote to Epstein in May 2008. Eighteen years on, and the idea of obsoleting humans with artificial intelligence is widely discussed in the tech world.
When asked to comment on his exchange with Epstein, Goertzel told Coda: “I do think we will create forms of transhuman intelligence going beyond the scope of humanity as we know it, but I also very much hope and envision a strong role for humans even after this happens.”
Goertzel went on to describe a future where the world reaches the “Singularity” — a Silicon Valley buzzword signifying a tipping point where AI surpasses human intelligence. “I do think AI will eventually gain its own superhuman autonomy, but I think this can happen in a way that respects and nourishes human life rather than being harmful to it,” he said. “Epstein and I discussed this face to face a few times and indeed I was a bigger fan of the human species than he was, and more optimistic about its flourishing post-Singularity.”
In an email to Epstein, Goertzel laid out a scenario where AI systems would start running their own economic activity. He envisioned this Artificial Intelligence economy acting as a “parasite to overcome the regular human economy” that would eventually “gain its own superhuman autonomy.” The ideas Epstein and Goertzel exchanged mirror a broader conversation unfolding in the tech world that imagines a future where ultimately, human labour could be rendered superfluous, and ultimately be replaced by artificial intelligence and robots.
Together, Goertzel and Epstein also discussed modifying human brains — a concept popular in Silicon Valley today, where numerous brain-computer projects are researching ways to cognitively enhance the human brain, and alter human personality, memory, and mental capabilities.
In 2008, when Epstein told Goertzel he was “off to jail” for a year, after he was convicted of soliciting a minor for prostitution, Goertzel suggested the solution to his problems might one day be solved if human brains could be re-programmed.
“According to my understanding, the girls you were involved with were old enough to know what they were doing, so society really has no ‘moral right’ to lock you up,” Goertzel wrote to Epstein. “This is a fucked-up society we live in. But past ones have really been no better -- the fault is really w/ the human brain architecture, which is precisely what I'm aiming to supercede in my AGI work.”
When asked to comment on these remarks — and in particular the implication that Epstein’s problems might be solved if his accusers' brains were one day re-engineered — Goertzel told Coda: “This was a general observation that the messed-up nature of our society generally is rooted in the way our brains have evolved... and that advanced tech will let us modify our brains to make ourselves and thus our society better. There was no implication intended (nor stated) that women’s brains are any more or less messed up or in need of improvement than men’s.”
Goertzel reflected that his comments on Epstein’s victims being “old enough” were “regrettable and unfortunate in hindsight,” adding that his impression was that Epstein had been involved with adult women, not “disgustingly curating high school students for sexual purposes. I should have paid more attention.”
In 2013, three and a half years after Epstein was released from jail, Goertzel approached Epstein for funding to build a “toddler robot”. Given Epstein’s criminal history of abusing minors, this has inevitably attracted attention online. “When we were discussing measuring the IQ of robot toddlers, the topic was never sexualized in any way,” Goertzel told Coda when asked about the project. “While I had nothing to do with Epstein's perverse sexual tastes or abuse of women, what I have read about his awful doings in the newspapers relates to his interest in teenage girls not toddlers.”
Epstein was particularly interested in funding projects that built — like Goertzel’s –- on transhumanist theories. Transhumanism is a worldview that captivates many of the most prominent tech leaders in Silicon Valley today. It believes in a future when the human body can be endlessly altered, genetically engineered, and ultimately fused with artificial intelligence.
“Transhumanism is a much more radical concept than eugenics,” explained Timnit Gebru, a computer scientist and researcher who has written extensively about eugenicist ideas within artificial intelligence. “In eugenics, you're trying to create a more superior human by breeding humans through generations. In transhumanism, you're trying to get rid of humans altogether.”
For transhumanists, she added, “their idea is to get rid of any undesirable properties they see with humans."
Perhaps the most well-known proponent of transhumanism in the Epstein files is Peter Thiel.
“I think you would prefer the human race to endure, right?” New York Times journalist Ross Douthat asked Thiel last year. “Uh—,” Thiel said. “This is a long hesitation!” Douthat said. “Should the human race survive?” “Yes, but I would like us to radically solve these problems,” Thiel said. “We want you to be able to change your heart and change your mind and change your whole body.”
Thiel’s name appears in the files more than 2000 times, and Epstein reportedly invested some $40 million into Valar Ventures, a firm co-founded by Thiel. The two spoke of building secret societies and shared an interest in transhumanism and cryogenics — Epstein wanted to freeze his brain and penis when he died, so that one day he could be revived, while Thiel has also stated his body will be frozen after his death.
They also appeared to share an interest in bringing an end to the democratic systems of today, imagining a different system altogether. Epstein, for his part, spent his life puppeteering the most powerful people in the world and undermining democratic systems. Thiel, meanwhile, first expressed his own anti-democratic views in 2009 when he wrote: “I no longer believe that freedom and democracy are compatible,” adding that since women were allowed to vote, the notion of a capitalist democracy became impossible. When the Brexit vote came through, Epstein wrote to Thiel: “Brexit, just the beginning.” Thiel asked — “of what”; Epstein said – “Return to tribalism, counter to globalization, amazing new alliances.”
Globalization — and the idea of internationally powerful governing bodies — is a worldview that both Epstein and Thiel seemed to distrust. In March, in a palazzo in Rome, a stone’s throw from the Vatican, Thiel gave one of his infamous lectures in which he espoused his views about an “antichrist” that gets in the way of technological progress. This antichrist, he suggested, could be an internationally powerful body; the product of globalization. I stood outside the palace as attendees — priests, students, researchers — mutely hurried out, refusing to speak to the cluster of reporters waiting for Thiel’s black Mercedes.
“He has a totally irrational side, which lives on fear, of what danger might happen,” one audience member told me of Thiel on condition of anonymity, recalling how, up close, Thiel looked haunted and ill. “His head is full of future scenarios, which is what’s killing him. I think he’s scared.”
Thiel did not respond to multiple requests for comment.
Epstein didn’t confine himself to lofty conversations about a future collapse of the global order or re-engineering humanity. He also had ambitions for his own personal eugenics project. In 2019, it emerged that he wanted to seed the world with his DNA — and reportedly have 20 women impregnated at a time at Zorro ranch, his New Mexico property.
Epstein tried to recruit Virginia Giuffre for this very project. He “fantasized about improving the human race by fathering children who carried his superior genes,” she recounted in her memoir, published posthumously late last year. “He’d talk about using his Zorro ranch as a literal breeding ground to propagate babies.” When Giuffre was 18 years old, she recalled, Epstein asked if she would carry his child and hand over all legal rights to it – “like a modern-day handmaid.”
In a haunting diary entry from another Epstein victim, written between the ages of 16 and 17 and shared with federal prosecutors, a girl describes being told she will be sent to Zorro ranch — possibly to participate in the very same project. “Go to New Mexico? What in the hell? This makes no sense. What about school?” she writes, describing how Epstein chose her for her hair color and eye color, and tried to convince her she would create “perfect offspring.”
The teenager chronicles her pregnancy, pasting a sonogram into the scrapbook, before giving a traumatic account of giving birth with Ghislaine Maxwell beside her. “Ghislaine said to push all the pain away. I don't understand. Blood and water all over the bed.” As the baby was born, she writes, Maxwell covered her eyes. “I saw between her fingers this tiny head and body in the doctors hands.”
The girl describes hearing the baby’s “tiny cries” before “they took her.”
“I’m nothing but your property and incubator,” the teenager writes of Epstein. The diary is a terrifying piece of evidence that appears to link to Epstein’s longstanding fixation with creating genetically bespoke humans. The diary author’s lawyers, Wigdor LLP, declined to comment.
Epstein’s fever-dreams of creating an army of children carrying specific genes reflect a broader trend of “pronatalism” — a movement historically tied to eugenics — that’s thriving in Silicon Valley.
Millions of dollars of funding are currently being poured into projects creating “superbabies,” while billionaire tech oligarchs including Elon Musk — whose name appears more than 1000 times in the files — reportedly want to use surrogates “to reach legion-level before the apocalypse.” Musk did not respond to requests for comment.
In the files, women appear either as victims, as objects, or as vessels for genetic engineering experiments. They are an inconvenient reality, people to be controlled and re-booted. Epstein wrote a 2013 email implying that women “are like shrimp. You throw away the head and keep the body.”
“The obsession with "artificial" life appears tied to a masculine desire to try control the production of life – ultimately ridding themselves of their dependency on women," said Gabriella Razzano, Co-Founder of OpenUp, a social impact tech lab based in Cape Town, who is also a senior advisor at the African AI Observatory. “I think there is important work to be done on tying the narratives that are very revealing in the Epstein files to understand how, and why, technology is being developed as it is.”
The trading of ideas about intelligence — both artificial and human — takes a particularly sinister turn in a 2016 exchange between Epstein and the cognitive scientist and AI researcher Joscha Bach, whose research Epstein funded to the tune of $300,000.
Bach writes to Epstein about a study claiming that “black children outperform white children in motor development, even in very poor and socially disadvantaged households, but they lag behind (and never catch up) in cognitive development even after controlling for family income.”
Epstein responds with racist ideas about his notion of how to “make blacks smarter”, adding — “maybe climate change is a good way of dealing with overpopulation. The Earth’s forest fire. Potentially a good thing for the species,” before contemplating a world with “too many people,” where “many mass executions of the elderly and infirm make sense.”
Epstein then imagines creating a future “Übermensch” — a superior human with cherry-picked attributes. “What I like is the idea that ubermensch could be the melding of humans, put together in one brain,” Epstein writes. This bespoke human, he suggests, would include traits from marginalized groups, who he appears to believe have a stronger awareness of how to navigate power structures because of their historical exclusion. “An increased motor system, an increased awareness, an increased status calculator (Blacks, jews, women). Ubermensch could be the combination of the best of humans, not the best of a specific race or gender. Fun idea.”
Bach told Coda in a statement: “I was summarizing a scientific study in a private email. Studies like this get often abused in ideological discourse to justify discrimination, which I strongly oppose and condemn.”
“I am firmly opposed to any form of racial discrimination, and I reject the use of group-level statistical claims to make judgments about individuals or to justify unequal treatment.”
He continued: “It goes without saying that if global warming were to lead to a reduction in the human population, it would be accompanied by immeasurable suffering. Our civilization would break down, leading to a return to dark ages, in which the elderly and infirm were often killed, because people could not support them, and often did not care about supporting them. Every reasonable person understands that this is horrible and not desirable in any way.”
Epstein “was often callous about human suffering in a way that I found disturbing but worth understanding, as a window into the perspectives of the rich and powerful,” Bach added.
Alongside Epstein’s conversations about mass executions for the old and and the sick, he was also interested in Silicon Valley’s dream concept of living forever — he had numerous email conversations with the longevity guru Peter Attia about prolonging his own lifespan, and funded a Harvard project geared towards “the end of aging.” In an email to Attia, Epstein mused: “I’m not sure why women live past reproductive age at all.” Attia, who published a statement about his relationship to Epstein, did not respond to requests for comment.
This interest in “longevity” — living for as long as possible, even living forever, is popular among the elite precisely because they find themselves in an elite class, says David Robert Grimes, a scientist and disinformation expert who has written about longevity and race science in Silicon Valley. “They're both sides of the same coin — the Silicon Valley eugenics, and also the longevity stuff. They promote an idea that ‘we are exclusive and we are special',” he said. "It helps them to justify deep social inequality."
The tech elite did not inherit this ideology by accident. Stanford University, the intellectual heart of Silicon Valley, was once a major hub for the American eugenics movement, which later helped to inspire Nazi race laws. Stanford’s founding president, David Starr Jordan, was a prominent eugenicist, campaigning for forced sterilization of people with undesirable genetic traits. The university removed his name from its buildings in 2020 — but in Palo Alto, his beliefs did not disappear with the nameplate.
"Instead of eugenics we just call it longevity or biohacking," Christopher Wylie, the Cambridge Analytica whistleblower who has spent years investigating Silicon Valley's belief systems, said on a panel with me at a journalism conference last year. "It's the same."
The ideology Epstein bankrolled in private is being built in public. It’s a vision of the future in which a select few get to upgrade and extend their lives, while tightening their grip on the systems that determine which humans are worth investing in — and which are not.
It sounds like a dark sci-fi fantasy, except, as the files show, that fantasy is being funded and pushed into reality. Most of us will never be in the rooms where these ideas are discussed. All of us will live with the results.
Isobel Cockerell

J. Paul Neeley
The post “All my fundees have blue eyes.” Epstein and the tech world’s dark ideology appeared first on Coda Story.