❌

Vue lecture

Google AI Overviews : Cronos dévorant ses enfants ?

Déjà en place aux USA et dans plus de 120 pays depuis 2 ans, Google AI Overviews débarque en France cet été (c’est effectif depuis ce mercredi 22 juillet). Le principe est simple : pour chaque requête sur le moteur, c’est l’IA de Google (Gemini) qui propose des résumés ou plus exactement, et la précision me semble d’importance, des synthèses et – souvent – des préconisations.

Cette arrivée durant l’été est annoncée comme un tremblement de terre, notamment par les éditeurs de presse qui, comme c’est le cas depuis plus de 20 ans avec le lancement de Google News en 2002, ne trouvent aucune issue au pacte attentionnel Faustien qui leur a été imposé : laissez-moi indexer et réutiliser vos contenus et en échange vous serez visibles, ou empêchez-moi de le faire et l’audience de vos sites sera quasi nulle.

L’article de Nicolas Lellouche sur Numérama résume très bien les principaux enjeux de cette arrivée et le changement de statut de celui qui était, jusqu’ici, un moteur de recherche.

Il y a, bien sûr, de quoi s’inquiéter circonstantiellement toujours davantage, mais structurellement, sur le fond, rien n’a vraiment changé depuis presqu’un quart de siècle. Google est un moteur de recherche devenu un moteur de réponses (« il n’y aura plus que des réponses » prophétisait Marguerite Duras) ; Google est un béhémot calculatoire qui a bâti son succès sur un régime de captation d’externalités (le web) qu’il a progressivement transformé en autant d’internalités. D’abord sur des sources ouvertes (le web donc, et notamment Wikipédia) puis sur des sources propriétaires ou mettant en jeu des principes de propriété intellectuelle (la presse notamment). Et toujours en pratiquant « l’Opt-Out » c’est à dire la captation / prédation par défaut, libre ensuite à chacun de faire part de sa volonté d’en sortir (il est d’ailleurs possible de sortir votre site de l’AI Overview). Et lorsque la masse de ces internalités fut suffisamment « à l’échelle », Google se trouva alors en situation de jouer à son avantage la rivalité qu’il avait lui-même créé (et arbitré) entre la qualité, l’importance et la nécessité de la production de contenus externes d’une part, et d’autre part celle de la production de réponses internes suffisamment courtes pour ne pas heurter de front la propriété intellectuelle (jouant entre l’usage « de minimis », le Fair-Use et l’exception pour courte citation) et suffisamment complètes pour satisfaire des requêtes informatives sans nécessité d’aller chercher des compléments d’information à l’extérieur du moteur ou alors en le faisant uniquement dans l’écosystème de sites tiers déjà dans le giron de la firme.

Avec AI Overviews, Google pousse donc un cran plus loin cette logique phagocyte. Et ce faisant il cesse peut-être irrévocablement d’être un « portail » (il n’en était déjà plus que l’ombre depuis longtemps mais maintenait nonobstant une fonction d’accès et d’orientation) pour devenir une simple « porte », que chaque requête sur le moteur referme derrière notre passage.

Permettez-moi alors de formuler une question volontairement provocante. Et si finalement Google était juste en train de devenir … un média ? Google dont longtemps le métier correspondant à son chiffre d’affaire fut celui d’être une régie publicitaire, et de n’être que cela (malgré ce que ses fondateurs affirmaient dans leur article séminal). Google deviendrait donc un média. Mais un média aux fonds baptismaux particuliers : entièrement construit sur la prédation d’externalités, sorte de Cronos dévorant ses enfants, il se mue aujourd’hui avec AI Overviews en média autophage qui tend à ne plus se nourrir que de lui-même. Ce « lui-même » étant permis par la volumétrie totalement inédite ainsi que par les effets de dissémination en même temps que d’opacification immanents des LLM (larges modèles de langage). La question est de savoir jusqu’où et jusqu’à quand ce principe autophage pourra être poursuivi, et la seule certitude est qu’il ne pourra pas l’être éternellement car si grande que soit l’étendue des éléments constituant aujourd’hui la ressource indexable et pouvant être générée du moteur, elle n’est pas infinie et nécessitera donc toujours et tout le temps l’appui de ressources externes (au Royaume-Uni après deux ans de déploiement le trafic vers les sites d’éditeurs à drastiquement chuté – entre 20 et 40% de baisse). Sauf … sauf à considérer pouvoir se satisfaire d’un pourrissement (ou d’une emmerdification) et à disposer des moyens pour faire croire qu’il n’est que périphérique et marginal.

Deux éléments pour conclure.

D’abord le mythe de Cronos dévorant ses enfants laisse place au scénario dans lequel ceux-ci se voient finalement régurgités et renversent leur père pour s’installer comme nouveaux dieux sur le mont Olympe.  C’est précisément pour s’en prémunir que très tôt Google a eu l’intelligence de développer son propre LLM et pouvant s’appuyer sur l’immensité des données et des textes qu’il avait déjà collectés, traités, indexés, et dont il avait, bien avant même l’invention du terme « LLM », déjà fait corpus (à ce titre le programme Google Books exploité à l’époque avec les technologies disponibles du TALN – traitement automatique du langage naturel – fut une pierre angulaire déterminante.

Ensuite j’évoquais plus haut l’article séminal de S. Brin et L. Page dans lequel après avoir décrit la formule et l’algorithme du Pagerank ils reviennent en annexe sur la toxicité du modèle publicitaire qui fait aujourd’hui leur fortune et constitue leur seul paradigme de déploiement. Notez que ce passage (ces « annexes ») a étrangement disparu de la version accessible depuis le site de la firme, mais qu’elle est heureusement toujours présente sur la page originale du laboratoire de l’université de Stanford. La seule leçon à retenir de cela est assez simple : ne faites jamais confiance à un prédateur.

Tableau de Rubens. Cronos dévorant ses enfants
(Source Wikipedia)
  •  

Caméra(i) Café. Sucré à l’IA.

Longtemps le numérique fut envisagé et traité comme ce qu’il était en première intention : un moyen de stockage. Et à ce titre la possible et pratique externalisation de nos mémoires, mémoires documentaires d’abord, mémoires intimes ensuite.

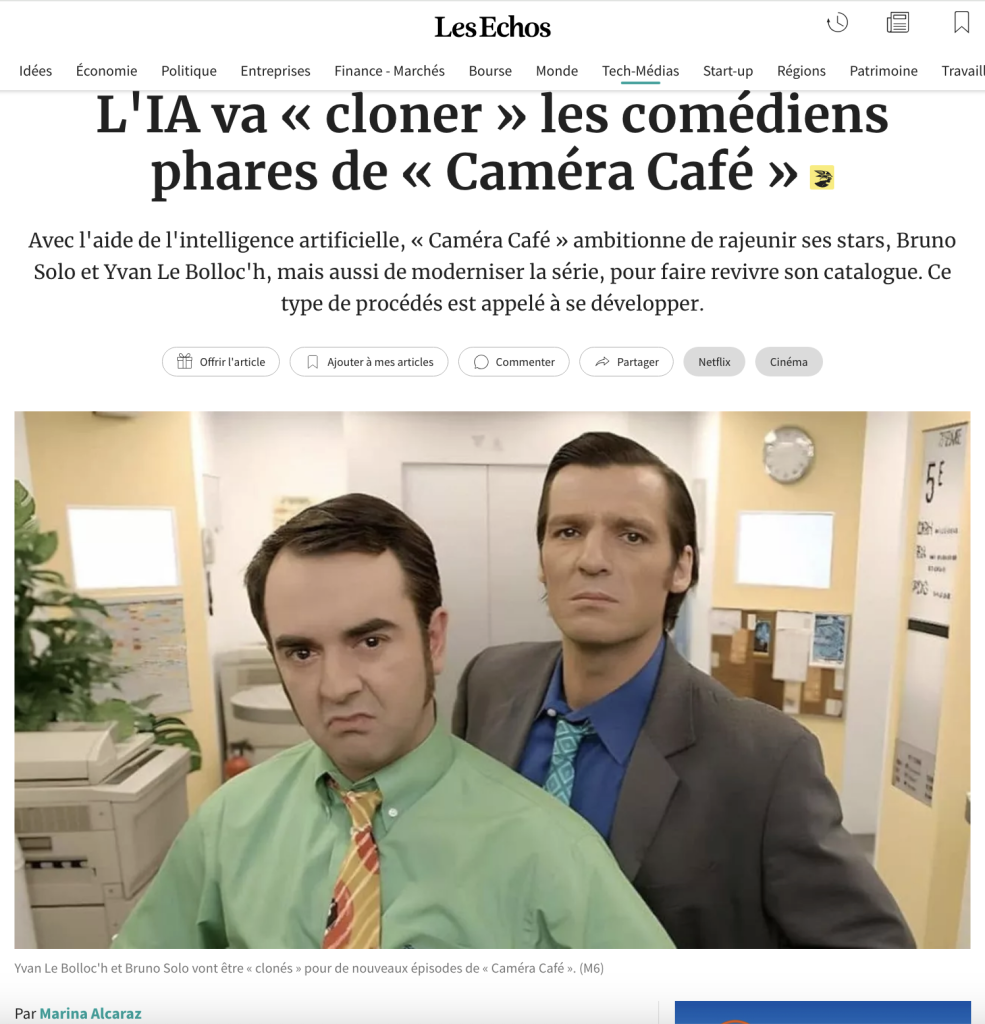
Je suis récemment tombé sur un article expliquant comment le recours à l’IA allait permettre de redonner vie à la série Caméra Café, notamment en clonant – avec leur accord – les deux acteurs principaux et en les rajeunissant, mais aussi je cite : dans l’optique de « moderniser la série » et de « faire revivre [le] catalogue [de la maison de production]. »

On s’était habitué aux suites menant à Rocky 5 ou à Rambo 4 ou plus récemment à Fast And Furious 10, on vit également l’émergence des séries, reboots, préquels et autres déclinaisons « d’univers » ou de tonneaux des Danaïdes scénaristiques baptisés « multivers », mais aujourd’hui avec l’IA ce à quoi nous assistons c’est à l’industrialisation de ces multivers comme autant de répliques d’univers à moindre coût. Et ce pour permettre de doper de vacuité d’anciennes têtes de gondole d’audience en leur donnant une nouvelle et artificielle jeunesse, mais aussi et surtout une nouvelle surface et amplitude de diffusion.

Têtes de clones.


L’article de Marina Alcaraz dans Les Échos explique ainsi que l’IA sera utilisée dans 4 objectifs distincts :

« D’abord, pour reprendre tout le catalogue français du programme tourné au début des années 2000 (environ 700 épisodes) et le passer au format actuel en 16/9 et 4K. L’IA sert à reconstituer les images manquantes et à moderniser le rendu.

Ensuite, les nouvelles technologies sont utilisées pour indexer les épisodes et analyser les textes. Exit les termes de l’époque, comme Walkman, les références à l’actualité ou à la politique du début du millénaire. « Quand les dialogues parlent de choses que les jeunes ne connaissent pas, l’IA va les remplacer par des mots ou des expressions plus d’actualité », explique Jean-Yves Robin, président de Robin & Co.

Enfin, l’IA va créer des deepfakes des comédiens, dont ceux Bruno Solo et Yvan Le Bolloc’h, pour les insérer dans les versions issues de l’international. On estime qu’il y a 5.000 à 6.000 épisodes produits dans le monde, dont environ la moitié d’originaux, reprend le producteur. On pense pouvoir au moins doubler le catalogue français. C’est une façon de faire revivre les catalogues sur des fictions comme celle-ci, où des comédiens sont trop âgés. »


Cet exemple est particulièrement intéressant car il mobilise en effet les quatre ressorts actuels des enjeux de l’IA dans le contexte des industries culturelles. Un enjeu d’abord technique d’optimisation et de « modernisation » (pour autant que l’idée de modernisme ait un sens lorsque l’on parle d’IA). Un enjeu ensuite « éthique » qui mobilise la question de l’intégrité documentaire des oeuvres (et d’une forme de « cancel culture », j’y reviendrai). Un enjeu juridique qui touche à la fois au droit d’auteur, au droit à l’image et à la propriété intellectuelle ; ici les comédiens ont accepté d’être clonés contre rémunération et il serait d’ailleurs intéressant de voir quel type de contrôle ils ont accepté de céder sur leur image, et jusqu’à quand. Et enfin un enjeu économique de saturation et de maximisation des logiques d’exploitation par procédé de duplication dans un univers médiatique déjà passablement saturé et qui vient encore alourdir le poids de ce que l’on appelait « les étagères infinies », c’est à dire l’immensité de catalogues de contenus dans lesquels on passe davantage de temps à choisir quoi regarder plutôt qu’à simplement … regarder.

Désormais, il semble qu’aucun contenu culturel ayant eu ne serait-ce qu’une once de succès d’audience ou critique ne puisse et ne doive mourir ou être oublié. Tout doit être fait pour le maintenir artificiellement en circulation médiatique. C’est une sorte de palimpseste à l’envers, dans lequel on partirait de la version la plus aboutie de l’oeuvre originale pour ensuite la recouvrir de couches affadies de ses propres extensions, dérivations, réécritures et copies.

[Mise à jour du 23 Juillet]

Autour de ce sujet on pourra également se référer au concept de « Foreverism » de Grafton Tanner, ainsi qu’aux pages de Deleuze sur la question de la répétition.

[/Mise à jour]

Dans un tout autre registre, je m’étais il y a quelques années intéressé au fait que les profils Facebook de personnes décédées continuaient d’être une manne d’interaction (et donc de revenus) pour la plateforme ; plateforme qui avait ainsi tout intérêt à nous inciter à transformer ces comptes en autant de « mémorial » et à nous rappeler de souhaiter les anniversaires de nos amis morts. Il s’agissait et il s’agit toujours de se payer, encore et encore, jusqu’au bout du cynisme.

C’est un peu le même type de processus auquel nous assistons aujourd’hui avec ces maisons de production qui veulent encore se payer sur des contenus culturels (ici des séries) pourtant déjà au bout de toutes les logiques de rentabilité existantes : en l’occurence, pour la série Caméra Café, elle a déjà été vendue et exploitée dans plus de 60 pays, et tous les produits dérives possibles et imaginables ont également été exploités et surexploités.

Intégrité documentaire.

C’est pour moi le grand sujet des années qui s’ouvrent devant nous. Car avec l’IA, et comme cela est relaté dans l’article de Marina Alcaraz pour Les Échos, vient aussi la tentation d’effacer toute forme de référence à l’actualité de l’époque de production du contenu concerné. On parle ainsi de gommer le « walkman » pour le remplacer par autre chose qui parle à la nouvelle « cible » envisagée. Toujours d’après le prodicteur de la série, grâce à l’IA, exit aussi les références à l’actualité politique de l’époque. Ce qui vient nourrir encore le débat sur une forme de Cancel Culture. Ou comment réécrire des contenus culturels qui ne peuvent être autre chose que le reflet d’une époque avec tout ce que cette époque comportait de tolérance qui nous semble aujourd’hui relever légitimement de formes d’abus condamnables.

De mon côté, plutôt que de m’enferrer dans le débat souvent glissant de la « cancel culture » je préfère parler et questionner le thème de l’intégrité documentaire.

Je vous en ai souvent parlé sur ce blog, mais la première fois que j’ai commencé à réfléchir à la notion « d’intégrité documentaire » c’était lorsque j’écrivais beaucoup sur « l’affaire » Google Books et la manière dont le moteur s’était soudainement mis à numériser à très large échelle des livres du domaine public mais aussi des ouvrages sous droits, et où avaient émergé, pour l’ensemble des contenus culturels, les offres de streaming allant avec une forme manifeste de dépossession des anciens supports physiques (CD, DVD, etc.) qui nous privaient ce faisant de certains de nos droits de propriété (j’avais même appelé cela « l’acopie« ). Bref c’était il y a plus de 20 ans. Pour expliquer cette notion d’intégrité documentaire auprès de mes étudiants j’utilisais et j’utilise encore souvent l’exemple des éditions des grands classiques en version « digest » disponibles aux USA du type « la bible en 20 pages » ou « les misérables en 50 pages. » Je leur explique que si l’on n’est confronté qu’à la version « courte » des misérables, version dont on a expurgé non seulement différents niveaux de l’intrigue mais dont on a aussi modifié, pour les atténuer, les aspects paraissant les plus « choquants », le référent culturel que l’on construit et les comportements et les repères sociaux communs qu’il permet d’inscrire dans un horizon culturel partagé changent alors de manière radicale. En modifiant et en édulcorant « Les misérables » comme oeuvre littéraire (ou fait culturel) on influe nécessairement sur la perception que nous aurons de « la misère » comme réalité sociale. De la même manière et en prolongement, le fait de choisir, sur telle ou telle édition ou réédition, numérique ou non, d’enlever, de gommer ou de réécrire certains aspects de l’oeuvre sont une atteinte claire à son intégrité documentaire et constitue donc aussi un trouble à la diachronie et à la synchronie dans lesquelles toute oeuvre s’inscrit.

C’est d’ailleurs ce que l’historienne Laure Murat rappelle encore dans son dernier essai (que je n’ai pas encore lu) « Toutes les époques sont dégueulasses » mais dont j’ai pu entendre une interview sur France Inter dans laquelle elle expliquait ceci :

Faut-il corriger les textes pour qu’ils soient lisibles à nos yeux contemporains ? Laure Murat : « Je crois que la question pose un gros problème. Parce que si vous nettoyez les textes des sujets qui fâchent, des mots qui fâchent, vous aboutissez à une falsification et un mensonge historique, qui a pour conséquence très grave de priver les opprimés de l’histoire de leur oppression. Donc, supprimez les remarques misogynes de James Bond et ses actions – parce qu’il faut aussi toucher à l’intrigue – ça devient quand même nettement plus compliqué. Faites-en un proto-féministe, il y a beaucoup de travail, et vous ne comprendrez plus rien à la misogynie des années 1950-60. Et je crois que ce n’est pas une bonne idée. »


Alors on pourra certes arguer que la suppression d’un Walkman dans Caméra café n’a pas la portée symbolique de la réécriture d’une oppression, mais quid des blagues machistes ou sexistes de la série qui, à l’époque déjà, jouaient d’une ambiguïté sur la « beaufitude » de celui qui les énonçait ?  Faut-il également les réécrire au risque, en effet, de ne plus rien comprendre au sexisme et à la misogynie du début des années 2000 ?

« Celui qui oublie ou qui méprise l’histoire est condamné à la revivre » écrivait le philosophe George Santayana. La seule promesse d’une Cancel Culture qui au prétexte de l’IA, finirait par faire système à l’échelle de nombre de biens et produits culturels, c’est le retour en plus violent de ce passé effacé.

  •  
❌