❌

Vue lecture

Comprendre les défaillances de la chaîne d’élimination automatisée

L’AI Now Institute en collaboration avec Airwars.org, un site qui depuis 2014 documente les conflits, ont publié un excellent reportage visuel pour comprendre les enjeux de l’IA sur le champ de bataille sous forme d’un récit, fictif et simplifié, d’une attaque menée avec l’IA, augmenté d’explications spécifiques. « Pour démystifier l’IA militaire, nous construisons une chaîne de destruction abstraite qui reflète un cycle de ciblage par IA. Plutôt que de copier un cadre formel de chaîne de destruction utilisé par un État spécifique, notre schéma illustre les activités tactiques et les décisions impliquant l’utilisation de systèmes d’IA à travers six étapes : 1. Capteurs et données, 2. Surveillance, 3. Renseignement et identification, 4. Sélection, 5. Frappe et 6. Évaluation post-frappe. » 

« Les systèmes d’aide à la décision assistés par l’IA – qu’ils s’appuient sur de grands modèles de langage (LLM) ou sur d’autres types d’algorithmes d’apprentissage automatique – intègrent des informations provenant de capteurs couvrant les zones d’opérations militaires. Il peut s’agir de textes issus d’Internet, d’images satellites, de données audio provenant de télécommunications ou de vidéos captées par des drones. Ces données sont synthétisées sur une interface unique et conviviale.

Le problème : les données des capteurs peuvent être incomplètes ou altérées en raison de défaillances, d’interruptions des communications ou d’incertitudes environnementales. Des données comportant des erreurs d’étiquetage (par exemple, des inversions, des omissions ou des étiquettes superflues) peuvent entraîner une dégradation significative, bien que difficile à déceler, des performances de l’IA. L’écosystème d’information dans lequel évoluent les LLM ou autres réseaux de neurones peut également contenir des informations obsolètes ou délibérément corrompues. Ces sources de données sont par ailleurs vulnérables aux afflux massifs d’événements, aux campagnes de désinformation, au détournement de tendances et aux manœuvres de leurre militaire, autant d’éléments qui finissent par compromettre l’efficacité des technologies d’IA en matière de ciblage. » En fait, contrairement au discours qui voudrait que toutes les données utilisées soient parfaitement fiables, c’est en fait assez peu le cas, rappellent les chercheurs. 

Si l’histoire est fictive, les technologies décrites, elles, sont bien réelles. Et les explications permettent de comprendre les enjeux de chacune, comme la détection d’anomalie par exemple, qui vise à repérer des schémas inhabituels ou des changements dans l’imagerie  satellitaire, les données radar et autres flux de télédétection provenant de zones d’opérations militaires. Ces systèmes peuvent recourir à des réseaux de neurones à convolution ou à des auto-encodeurs pour traiter des volumes massifs de données et repérer des éléments susceptibles d’indiquer des mouvements de troupes, des déploiements de missiles, des infrastructures endommagées ou des modifications inattendues du terrain. Le problème avec ces technologies de détection d’anomalies c’est qu’elles peinent à distinguer des menaces réelles des variations environnementales ordinaires. « Les conditions météorologiques, les ombres, le bruit des capteurs et les différences d’angles de vue peuvent entraîner des erreurs de classification. De même, les auto-encodeurs sont entraînés à différencier les schémas correspondant à une classification spécifique des anomalies qui s’en écartent. Toutefois, ces modèles manquent de généralisabilité et de fiabilité ; par ailleurs, les données utilisées pour leur apprentissage peuvent être biaisées, présenter une distribution limitée ou reposer sur des classifications stéréotypées, conduisant à une mauvaise identification de la nature ou de l’identité d’une menace imminente. En 2025 par exemple, il a été démontré que la précision de Maven peut chuter en dessous de 30 % lorsqu’il est déployé sur un terrain inconnu ou dans des conditions environnementales incertaines entravant sa capacité à reconnaître et à signaler des objets », comme le rappelait Katrina Manson dans son livre. 

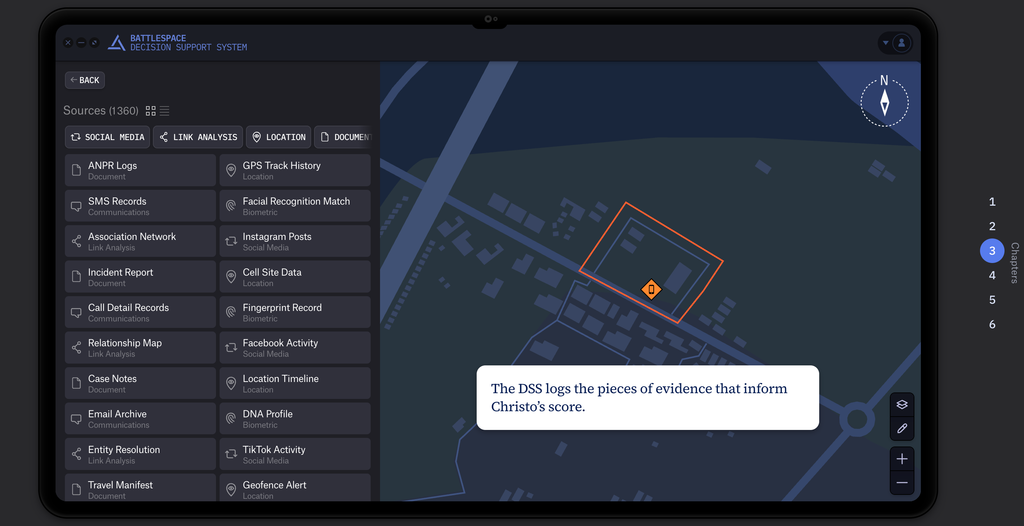
Parmi les nombreuses techniques utilisées, il y a aussi le géorepérage de ces mêmes cibles pour détecter les véhicules ou téléphones qui entrent dans une zone, déclenchant une surveillance et un suivi de la localisation des téléphones et véhicules et une interception des communications : les messages sont automatiquement relayés et traduits en direct, avec des termes qui déclenchent des alertes renforcées (notamment des termes temporels, comme « imminent » ou « bientôt »). Les propriétaires des cartes Sim sont bien sûr identifiés pour contrôler s’ils ne sont pas déjà sur des listes de suspects ou contrôler leur score de risque (un système de notation sociale qui passe au crible toutes les données collectées passivement sur les habitants, données issues de caméras et des réseaux sociaux, pour créer un score de probabilité qu’ils appartiennent à l’armée adverse, voir notre dossier). Si le score de menace est élevé, l’opérateur peut accéder aux sources afférentes pour enquêter et confirmer ou infirmer la menace depuis toutes les données collectées. Parmi celles-ci : les déplacements provenant du GPS du téléphone, les informations relatives aux plaques minéralogiques du propriétaires du véhicules (et donc les déplacements associés à ces véhicules), ses SMS, l’enregistrement de ses derniers appels, l’enregistrement de son visage ou de ses empreintes pour débloquer son téléphone, ses mails, savoir s’il s’est déjà trouvé dans une zone géorepérée… Des tonnes d’informations que l’opérateur n’a souvent pas le temps d’examiner car son temps est compté. Mais surtout, les liens et les activités sur les réseaux sociaux constituent l’un des facteurs du score de risque. Une analyse des publications est produite, traduite et analysée automatiquement notamment pour y détecter des émotions, comme le fait que leur auteur soit susceptible d’apprécier des actions de l’ennemi, ou que ces échanges aient été likés par des membres avérés de l’armée adverse. Dans ces analyses traduites, automatisées, il est impossible de vérifier si les publications en question sont bien réelles ou si les traductions sont fidèles. Ses relations sur les réseaux sociaux ou via ses appels et SMS sont également analysées pour montrer si ses abonnés sont membres de l’armée adverse ou s’il a pu échanger avec des ennemis confirmés. En accédant à son profil, on peut récupérer des photos permettant de lancer automatiquement une requête dans les réseaux de caméras de vidéosurveillance et observer si ses déplacements ont un rapport avec des sites surveillés et sensibles. Là encore les erreurs d’identification peuvent être innombrables. Compte tenu du temps limité, l’opérateur a tendance à valider ce que le système de notation sociale suggère. Si l’identification a un caractère d’urgence, un drone de surveillance peut être déployé pour suivre la personne identifiée. 

Capture d’écran de la fiction explicative de l’AI Now Institute et AIrwars. On voit sur la carte un téléphone géorepéré dans un bâtiment et sur la gauche, tous les éléments du téléphone auquel accède le système.
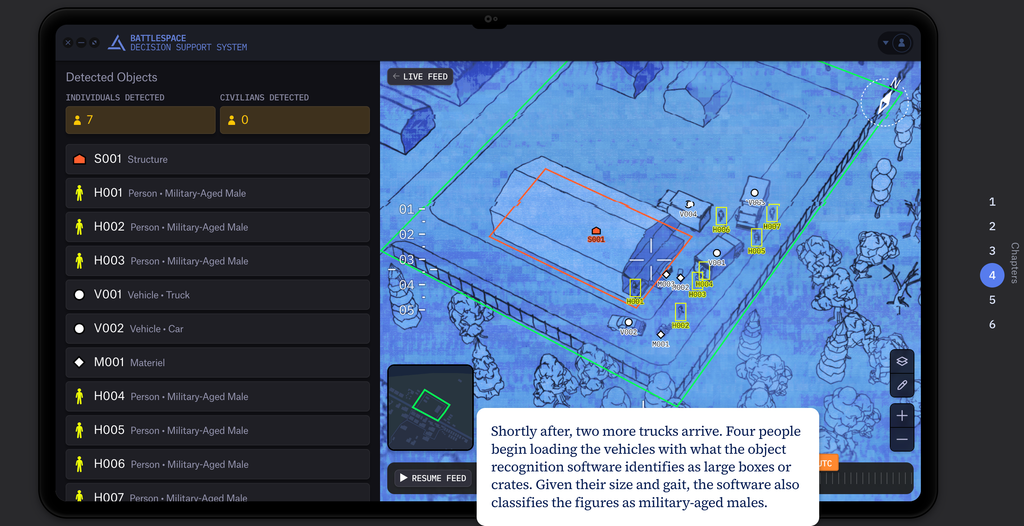
Autre capture, le système repère les téléphones, les véhicules et le matériel en leur attribuant des caractéristiques spécifiques.

Dans ce cas, le flux vidéo permet d’identifier qui est présent. Les personnes, les véhicules… et les personnes sont distinguées entre civils et membres de l’armée ennemie. Selon leur taille ou leur gabarit, il identifie les objets et les personnes, par exemple en les classant comme des « hommes en âge de combattre ». Chaque image du scénario permet d’accéder à des fenêtres contextuelles permettant de mettre en perspective la fiabilité des technologies utilisées. Par exemple, l’animation rappelle que la détection de formes et d’objets reste peu fiable. « Des recherches ont par exemple révélé que les systèmes peuvent classer de manière erronée 97 % des objets s’ils apparaissent dans des postures s’écartant de celles figurant dans les données d’apprentissage. Par ailleurs, diverses études montrent qu’une grande précision lors des phases de test ne garantit pas nécessairement une précision ou des performances élevées lors du déploiement en conditions réelles. En 2021, l’US Air Force a mené un programme pilote de reconnaissance de cibles affichant un taux de précision de 95 % dans des scénarios d’entraînement. Ce chiffre a toutefois chuté à seulement 25 % en environnement réel. Dans la grande majorité des cas, des algorithmes entraînés à reconnaître des images de missiles sol-sol sous un angle oblique se sont révélés incapables d’identifier ces mêmes objets lorsqu’ils apparaissaient dans des positions différentes. »

Une fois la frappe accomplie, l’opérateur reçoit un rapport d’évaluation, généré par un système d’évaluation des dommages de combat assisté par IA. Ces rapports ont tendance à renforcer les erreurs de classification déjà commises par les systèmes. Les réseaux sociaux sur place et les publications journalistiques locales donnent souvent une autre vision de ces résultats, mais ces informations ne sont pas réintégrées dans le système pour apprécier ses erreurs. Ils montrent aussi parfois que les personnes ciblées ne sont pas aussi menaçantes qu’elles semblaient l’être, en rappelant leur parcours et leurs fonctions. 

« À Gaza, l’armée israélienne a publié une vidéo d’une frappe tuant un homme qui transportait ce qu’elle a identifié comme un lance-roquettes. Elle a par la suite reconnu que ses forces avaient mal identifié l’objet : il s’agissait d’un vélo. » La vidéo est d’ailleurs confondante. Vue de haut, on ne sait pas ce que l’homme tient à son bras. Mais, si le système vous indique que c’est un lance-roquette, alors assurément, cela semble en être un. En fait, on comprend que c’est la manière dont ces outils regardent le monde qui est problématique. Pour un système de ce type, tout est menace, tout est orienté pour détecter des menaces, et à force de regarder le monde comme une menace, il le devient. 

« Les partisans de l’IA soutiennent qu’elle peut atténuer et réduire ces erreurs. Toutefois, ces systèmes risquent aussi de provoquer l’effet inverse, notamment en augmentant les taux d’erreur tout au long de la chaîne de ciblage et de frappe. Au cours d’une campagne de frappes de 40 jours contre l’Iran ce printemps, l’armée américaine a déclaré avoir atteint plus de 13 000 cibles, un rythme d’opérations quasi impossible à tenir avant l’avènement de l’IA.

L’IA pourrait également compliquer l’identification des défaillances et entraver l’obligation de rendre des comptes. À la suite d’une enquête d’Airwars sur une série de frappes assistées par l’IA ayant tué un étudiant irakien, l’armée américaine a déclaré n’avoir « aucun moyen de savoir » si la frappe meurtrière avait reposé sur l’IA.

Le livre Project Maven (voire notre critique), consacré à l’IA militaire américaine a révélé que, dans certaines opérations, seules deux des six étapes de la chaîne de ciblage et de frappe impliquent désormais une intervention humaine directe, une troisième nécessitant une certaine supervision humaine. Les autres étapes sont aujourd’hui entièrement automatisées. »

Dans une interview pour Democracy Now, Heidy Khlaaf, directrice scientifique chargée de l’IA à l’AI Now Institute et responsable de la publication avec AIrwars de cette fiction explicative, rappelle que derrière ces systèmes automatisés il n’y a pas de robot tueur, mais des chaînes de systèmes algorithmiques qui ont tous leurs propres pièges et leurs propres défauts. « Ils présentent tous une fiabilité et une précision très faibles. Ces systèmes s’appuient les uns sur les autres et s’alimentent mutuellement pour aboutir, malheureusement, à des pertes civiles, comme nous l’avons souvent constaté lors de leur utilisation. » « La distinction entre systèmes autonomes et systèmes de soutien est assez superficielle en pratique ». En réalité, quand on utilise ces systèmes, les biais d’automatisation sont très forts, rappelle-t-elle : tout y est présenté comme un risque. C’est le cas par exemple des systèmes de traduction automatisés, comme l’a montré une enquête d’Associated Press, qui montrait que l’usage de systèmes de traduction avaient du mal avec l’arabe. Prendre un mot pour un autre peut suffire pour vous inscrire sur une liste de personnes cibles. « Il est très difficile de comprendre pourquoi une IA a pris une décision donnée lorsqu’il s’agit de grands modèles de langage, en raison de leur envergure et de leur mode de fonctionnement. Était-ce dû à des données erronées ? L’IA a-t-elle reçu des instructions en ce sens ? S’agissait-il d’hallucinations ? Quiconque a utilisé ChatGPT sait que ces agents conversationnels inventent souvent des informations. C’est, je pense, la situation dans laquelle nous nous trouvons actuellement. La cause exacte de ces événements reste incertaine. En fait, je dirais même que c’est là l’une des finalités des systèmes d’IA : ils servent souvent à diluer la responsabilité », comme le pointait très bien le sociologue Ori Schwarz également (voir notre article). 

« En fin de compte, ces entreprises sont en train de réinventer la notion de sécurité. Elles s’approprient bon nombre de termes traditionnellement utilisés dans l’ingénierie de la sûreté et de la sécurité pour les appliquer à des formes de sécurité différentes. Au lieu de se demander : « Nos systèmes sont-ils fiables ? Sont-ils précis ? Fonctionnent-ils comme prévu ? Sont-ils adaptés à leur usage, de sorte qu’aucun être humain ne subisse de préjudice du fait des décisions ou des recommandations qu’ils génèrent ? » Au lieu de cela, nous nous retrouvons avec des cadres relatifs à la sécurité et à l’éthique qui portent sur des questions telles que l’autonomie, l’intentionnalité ou la conscience de ces systèmes. Or, il s’agit là d’une question tout à fait différente. Ces systèmes peuvent souvent donner l’illusion de posséder ces caractéristiques, ce qui conduit à anthropomorphiser le langage ou les actions de ces modèles. Nous avons vu récemment, par exemple, les capacités de cybersécurité être présentées comme si ces systèmes étaient autonomes – comme s’ils agissaient de leur propre chef, ce qui correspondrait à une attente que nous aurions à leur égard. Pourtant, dans la réalité, ces entreprises les déployaient dans des environnements très peu sécurisés et amenaient délibérément ces modèles à mener des cyberattaques dans le cadre de tests ou d’évaluations comparatives. »

« C’est précisément ce qui me pose problème : ces entreprises tentent, une fois de plus, d’attribuer la responsabilité à l’IA plutôt qu’à elles-mêmes. Or, l’IA ne fait que ce que nous lui ordonnons de faire ; elle n’est capable que de ce pour quoi nous l’avons conçue. »

« Il est donc crucial de garder à l’esprit que, certes, ces systèmes sont performants. Oui, ils sont capables de mener des actions telles que des cyberattaques ou des frappes. Et ils accélèrent effectivement les opérations ; c’est indéniable. C’est même l’une de leurs caractéristiques fondamentales. Toutefois, si l’on dispose d’un outil qui accélère les opérations mais dont la fiabilité et la précision de base se situent entre 30 et 60 %, le résultat ne diffère guère d’un ciblage aveugle, n’est-ce pas ? » Nous ne sommes pas confrontés à des robots tueurs dotés d’intentions propres, mais à une conception délibérée, défaillante, produite par des personnes qui « décident de le déployer, en toute connaissance de cause des systèmes à la fiabilité et à la précision médiocres – surtout dans des situations inédites, un cas de figure plus probable encore en temps de guerre que lors de cyberattaques.»

  •  

De l’opposition d’extrême-droite aux data centers en Amérique

Molly Taft pour Wired revient sur la lutte d’extrême-droite contre les data centers aux Etats-Unis. Ces dernières décennies, des centres de données ont été construits en toute discrétion aux 4 coins des Etats-Unis sans vraiment déclencher de contestations, rappelle-t-elle. Discrets, on pouvait habiter à côté d’un centre de données sans jamais en entendre parler. Ils étaient construits dans des zones bénéficiant à la fois d’une connexion par fibre optique et d’un accès à l’énergie, comme la Silicon Valley et la région de Washington DC. Mais, avec l’arrivée de l’IA, les data centers ont changé : désormais, on parle de versions gigantesques, qui se construisent rapidement après avoir obtenu des dérogations environnementales. Les gens ont commencé à se poser des questions sur ces constructions qui devenaient visibles par leur gigantisme même. Avec la montée de la contestation, de nombreux Etats ont introduit des moratoires voire interdit leur construction (sans compter les villes et comtés qui ont également pris des décisions en ce sens, y compris dans des zones très conservatrices comme le comté de Hill, au Texas). Des personnes ont été arrêtées, placées en détention ou expulsées alors qu’elles manifestaient contre des centres de données lors de réunions publiques dans le New Jersey, en Californie, dans le Wisconsin et dans l’Indiana.

Face à ces constructions, on évoque souvent la mobilisation de gauche, menée tant par des associations et des collectifs (cf. « Aux Etats-Unis, la résistance contre les data centers s’organise »), que par des politiciens, dont les démocrates Bernie Sanders et Alexandria Ocasio-Cortez, inspirateurs de moratoires sur l’IA qui essaiment depuis à travers les Etats-Unis. Paris Marx remarquait d’ailleurs, pertinemment, que si Sanders et AOC étaient d’actifs fourbisseurs de critiques de l’IA, ils n’ont pas la même approche. Alors que Sanders s’inquiète des potentialités de l’IA, reprenant les arguments de nombre des entrepreneurs de la Tech, AOC, elle met plutôt en garde contre les innombrables problèmes que génère déjà l’IA et notamment contre les dommages économiques susceptibles de découler de l’éclatement de la bulle financière entourant l’IA. Elle a également joué un rôle moteur pour fournir aux victimes de deepfakes générés par IA les moyens de tenir les auteurs responsables de leurs actes.  

Mais, si la contestation de gauche des data centers et de l’IA est bien documentée, celle de l’extrême-droite américaine l’est beaucoup moins. Elle est pourtant vive. Molly Taft raconte que les premiers politiques américains qui se sont inquiétés de ces projets étaient des politiciens d’extrême droite, Marjorie Taylor Greene et Thomas Massie. Mais pour Taft, celui qui a beaucoup dénoncé la technologie et l’IA, c’est assurément Steve Bannon, l’ancien conseiller de Trump. Dans son émission War Room, Bannon explique que les hyperscalers sont des « laboratoires d’armement braqués contre la population ». Mais la critique est surtout portée par l’un de ses éditorialistes, Joe Allen, auteur de Dark Aeon: Transhumanism and the War Against Humanity (auto-édité). Joe Allen s’est fait connaître par un slogan : Humans First (l’humain d’abord) devenu un cri de ralliement sur les ondes de la War Room. Le moto s’est transformée en organisation et en tournée, visant à mobiliser le grand public à l’encontre de l’IA pour exiger un encadrement fort de l’IA. Comme le raconte NBC, l’organisation incite les responsables politiques à refuser les contributions financières des grandes entreprises de l’IA… Human First se définit comme apolitique, avec des membres tant progressistes que conservateurs. Ce qui a l’air de déplaire à Musk et quelques thuriféraires de l’IA. Dans une newsletter d’extrême-droite américaine, Jordan Schachtel a affirmé que l’organisation Humans First avait été créée pour attirer des sympathisants conservateurs par des personnes entretenant des liens étroits avec « l’altruisme efficace », un mouvement visant à soutenir des causes et à allouer des ressources en se fondant sur des preuves d’impact positif, dont la base de donateurs serait entièrement composée de progressistes de la région de la baie de San Francisco… (et notamment le Center for AI Safety fondateur de l’initiative Humans First) pour en faire une sorte de cheval de Troie, visant à rendre les questions de sécurité de l’IA plus acceptables pour un public politique conservateur. Joe Allen a rejeté avec véhémence ces accusations, mais a reconnu que la publication de Schachtel soulevait des questions d’influences opaques… alimentant la paranoïa complotiste, marque de fabrique des délires des conservateurs Maga. Mais on pourrait tout autant inverser la question et se demander si la droite ultraconservatrice américaine ne serait pas en train d’essayer de récupérer le succès de la contestation de gauche contre l’IA et les data centers. 

Pour Molly Taft, la colère contre les data centers est en train de rejoindre celle contre le déploiement de l’IA partout. « La colère contre les centres de données et les inquiétudes du public concernant l’IA sont généralement traitées, dans les sondages et les politiques publiques, comme des sujets distincts : d’un côté, l’expression de préoccupations environnementales et civiques ; de l’autre, la crainte de pertes d’emplois et des inquiétudes liées aux chatbots. Pourtant, de plus en plus d’éléments indiquent que la frontière n’est pas si nette. Une étude publiée en juin, portant sur un échantillon restreint d’électeurs, montre par exemple que très peu de personnes opposées aux centres de données vivent à proximité de ces installations, et que la plupart de ceux qui s’y opposent sont également sceptiques à l’égard de l’IA » (d’autres données, dont nous avons rendu compte, montrent plutôt que la critique des data centers est au contraire, très située). 

Molly Taft s’est rendue en Georgie, lors d’une des réunions de Human First, dans un amphithéâtre de l’université Georgia Tech. « On y trouvait des étudiants, notamment des membres d’un club naissant dédié à la sécurité de l’IA qui avait invité Allen. (Deux d’entre eux m’ont avoué n’être venus que grâce aux affiches placardées sur le campus.) Un caméraman de More Perfect Union – une chaîne de contenu progressiste devenue une plateforme incontournable pour les vidéos dénonçant les centres de données – rôdait dans la salle pour filmer la scène. »

Les conférences d’Allen suivent un schéma bien connu, explique Taft : « des arguments de droite qui détonnent mêlés à des descriptions cauchemardesques et hallucinatoires de notre avenir (l’idée qu’une cabale mondialiste d’oligarques de la tech voudrait remplacer toute l’humanité par des robots). Tout cela pourrait sembler totalement délirant, jusqu’à ce que l’on se rappelle que ce sont aussi des arguments qu’ont employés la plupart des grands patrons de la tech ». « Ah oui, c’est vrai. Elon Musk possède bien une entreprise d’implantation de puces cérébrales. Sam Altman a écrit sur un blog que les humains serviraient de programme d’amorçage biologique pour l’intelligence numérique avant de s’effacer au profit d’une nouvelle branche de l’arbre de l’évolution ». 

« Même si l’on créait des machines plus intelligentes que vous, même si l’on créait des machines plus puissantes que vous, il vous faudrait continuer à vous battre ; car si vous ne le faites pas, vous êtes des mauviettes », lance Allen à l’assistance. « Si vous ne le faites pas, vous vous couchez par terre et vous laissez la machine vous écraser comme un monster truck dans une arène de beaufs, et personne – personne – ne veut de ça. Personne, sauf le plus masochiste des individus. »

Allen a conclu son discours par un cri du cœur : « Aux écolos présents dans la salle, je dis : la Terre d’abord ! Pas vrai, les écolos ? » (Je ne savais pas trop si c’était à moi qu’il s’adressait.) « Aux patriotes présents dans la salle, je dis : l’Amérique d’abord ! Et pour tous ceux qui ont du sang qui pulse dans les veines, pour tous ceux qui ont le feu au ventre et à l’esprit, n’oubliez jamais : à l’ère des machines, l’humain d’abord. »

Dans son livre, Allen raconte avec vivacité comment il est tombé sur le manifeste de Unabomber à la fin des années 1990, alors qu’il surfait sur le Web dans la salle d’écriture de son collège communautaire. Ted Kaczynski, mathématicien brisé par les travers du monde moderne, a rédigé La Société industrielle et son avenir tout en envoyant des bombes à des universités et à des dirigeants d’entreprise. « Le discours de « Oncle Ted » était plus sensé que ne veulent bien l’admettre les pacifistes ou les technophiles », écrit Allen.

« L’influence est manifeste. Dans War Room, Allen adopte l’attitude d’un prédicateur en chaire, nous mettant tous en garde contre l’ère dystopique à venir. Une grande partie de son œuvre flirte avec le « body horror » : que deviennent nos âmes, se demande-t-il, lorsque nos corps et nos environnements sont de plus en plus numérisés ? Je lui demande pourquoi, selon lui, les gens détestent les centres de données. Il répond : « Si vous observez le développement d’un fœtus, la croissance du cerveau et la formation des neurones, c’est fascinant. Les centres de données… si l’on considère qu’ils sont les neurones de l’Antéchrist, c’est bien ce à quoi nous assistons. Le faux messie ». » Le discours d’Allen, complètement claqué au sol, ressemble finalement énormément aux propos problématiques des patrons de la Tech qu’évoquait le journaliste Thibault Prévost dans Les prophètes de l’IA. Pour les soutiens de l’extrême droite américaine, le problème des centres de données n’est pas dans les injustices sociales qu’ils induisent, mais sont combattus parce qu’ils sont installés pour surveiller la population. Reste qu’ils le sont depuis une bouillie argumentative qui ressemble bien plus aux délires d’une IA qu’à un raisonnement argumentatif. 

Les contestations de gauche, comme celle initiée par Gage Bailey au sud d’Atlanta, qui documente les problèmes énergétiques et les tensions sur les ressources que font peser les projets de data centers géants sur les populations locales, sont de plus en plus rejointes par de nouveaux gens également en colère, mais pas pour les mêmes raisons. Les militants de gauche font le travail de terrain pour faire adopter des arrêtés locaux, quand les arguties de droites brodent sur les visions cauchemardesques de notre avenir robotisé. Mais, si le groupe Facebook de Bailey n’a cessé de s’agrandir, les tensions politiques semblent rester minimes. « De droite comme de gauche, tous les membres s’opposent aux centres de données et la plupart d’entre eux sont très sceptiques quant à l’IA. Ces coalitions improbables semblent également tenir bon en dehors du comté de Bailey. Lors d’une récente manifestation contre les centres de données dans le New Jersey, j’ai interrogé un manifestant masqué – qui m’a dit accepter « tous » les pronoms et se préoccuper vivement de l’« éthique » de l’IA – au sujet de l’influence de la droite sur le mouvement. Il a haussé les épaules, visiblement mal à l’aise. « Tout ennemi de mon ennemi est, au moins, un allié temporaire », a-t-il répondu.»

Taft relit Kaczynski et se rappelle que celui-ci était particulièrement remonté contre la gauche moderne, celle de la défense des droits des homosexuels, du féminisme et autres causes similaires. S’il en avait autant après les conservateurs (qu’il qualifie « d’imbéciles, qui se lamentent sur le déclin des valeurs traditionnelles tout en soutenant avec enthousiasme le progrès technologique et la croissance économique »), pour Kaczynski, le gauchisme était un sous-produit inévitable de la société moderne, laquelle dresse l’être humain contre l’ordre naturel du monde ; une situation à laquelle il fallait résister. D’ailleurs, celui-ci est autant célébré à droite qu’à gauche de l’échiquier politique. 

Pour Taft, les confusions politiques sont innombrables. On trouve des échos de la pensée de Kaczynski dans les résistances, nombreuses, aux énergies renouvelables. Dans le Vermont, cette opposition a même dressé des écologistes radicaux contre le solaire et l’éolien. Une étude de 2025 a révélé que plus de 450 comtés et municipalités, répartis dans la quasi-totalité des États, avaient mis en place des restrictions concernant l’énergie solaire ou éolienne, soit une augmentation de 16 % par rapport à l’année précédente. Le mouvement conservateur et complotiste, « Make America Healthy Again », « peut lui aussi être perçu comme l’expression d’un écologisme à la Kaczynski (qui tient surtout d’un anti-industrialisme radical, NDT) : l’idée que la société moderne empoisonne nos terres, notre air et notre eau, et que les inventions contemporaines telles que les vaccins ou les antidépresseurs sont en réalité néfastes pour nous. Bon nombre de ces idées se rejoignent parfois dans des contextes inattendus. Actuellement, l’un des auteurs les plus populaires de la catégorie « Climat et Environnement » sur la plateforme Substack est un agriculteur adepte d’un mode de vie écologique qui, ces derniers mois, s’en est pris aux installations solaires dans le nord de l’État de New York, affirmant (à tort) que les panneaux peuvent empoisonner les sols et détruire les terres agricoles. »

Le livre d’Allen est une lecture plus déconcertante encore que La Société industrielle et son avenir, confie Taft. « L’annexe, intitulée « Mon plan en 55 points pour rester humain » – qui propose notamment de « dire bonjour à ses voisins » ou d’« acheter un téléphone à clapet » – ferait pourtant un tabac lors de n’importe quelle lecture publique organisée par la gauche », ironise la journaliste, tout en soulignant la grande confusion dans laquelle il baigne. 

Les centres de données, qui rapprochent des voisins aux profils très disparates dans toutes les régions du pays, pourraient offrir l’occasion de mener un combat véritable et unifié contre les oligarques de la tech. Un rêve se dessine ici, perceptible jusque dans les colonnes du New York Times qui, début mai, qualifiait les centres de données de sujet « faisant le plus consensus entre les deux partis depuis la bière ». 

En tout cas, souligne la journaliste, la droite radicale est en train de s’emparer totalement du débat sur les centres de données. Des personnalités comme Tucker Carlson et Matt Walsh publient des vidéos virales remettant en question la construction de projets spécifiques. Nancy Mace, candidate au poste de gouverneure de Caroline du Sud, annonce qu’elle soutient un moratoire d’un an. Le gouverneur de Floride, Ron DeSantis – devenu un critique virulent de l’IA et des centres de données -, promulgue une loi inédite visant notamment à garantir « que les autorités locales conservent le pouvoir de refuser l’implantation de centres de données sur leur territoire ».

La politique a finit par rattraper Humans First également. Fin mars, une vive altercation éclate en ligne : des alliés de la Maison Blanche favorables à l’IA, comme Marc Andreessen et David Sacks, retweetent un article critique à l’égard de Humans First. Peu après, l’organisation se scinde selon des clivages partisans. L’aile conservatrice conserve le nom Humans First et nomme à sa tête Amy Kremer, militante politique d’ultra-droite, figure du Tea Party ayant contribué à l’organisation du rassemblement Save America du 6 janvier à Washington et ayant fondé les mouvements Women for Trump et Women for America First. Allen quitte le groupe. « Lorsque je l’interroge sur ce changement, il se montre curieusement évasif (tout en restant fidèle à son goût pour les métaphores liées aux horreurs corporelles) : le groupe était en train de « subir une mitose », dit-il. « Je suis désormais un organite solitaire flottant dans le cytoplasme résiduel. » (sic)

Convergence ou confusionnisme des luttes ?

La journaliste Shira Ovide pour le Washington Post, dresse le même constat. L’ampleur de la contestation des centres de données fait converger des Américains bien différents, qui s’en prennent aux symboles concrets d’un système politique et économique qu’ils perçoivent comme leur étant défavorable. « Les centres de données incarnent physiquement toute l’anxiété que les gens ressentent face à l’IA et à l’économie », a déclaré le gouverneur de l’Utah, Spencer Cox (Républicain), lors d’une interview. M. Cox, qui a essuyé des critiques pour son soutien à un projet de centre de données, a ajouté que les gens ont le sentiment de pouvoir combattre ces installations. « Le mouvement de contestation contre les centres de données estompe les clivages politiques et sociaux traditionnels. Le sénateur Bernie Sanders (indépendant, Vermont) souhaite interdire les centres de données, et Humans First, mouvement dirigé par Amy Kremer, ancienne figure du Tea Party, organise des manifestations nationales contre ces centres ce samedi. Le comté de Hill, au Texas, où Donald Trump a recueilli 82 % des voix en 2024, a interdit la construction de centres de données cette année. Les habitants de Monterey Park, en Californie, ville ouvrière à prédominance asiatique et latino-américaine située à l’est de Los Angeles, ont fait de même. »

Scott Babwah Brennen, directeur du Centre de politique technologique de l’université de New York, s’est dit stupéfait de la rapidité avec laquelle l’indignation populaire suscitée par les centres de données influence les politiques publiques. Pendant 15 ans, a-t-il déclaré, les collectivités locales ont déroulé le tapis rouge pour la construction de centres de données dans des régions comme l’est de l’État de Washington et le nord de la Virginie. Des entreprises telles que Google, Amazon, Meta et Microsoft ont souvent bénéficié d’allégements fiscaux, les élus estimant qu’ils garantiraient des recettes fiscales futures stables. La contestation depuis deux ans se focalise beaucoup sur le fait que les factures énergétiques des habitants à côté de centres de données s’envolent. L’opposition, tant dans les régions républicaines que démocrates, s’est envolé. « Il y a ici un clivage partisan bien plus marqué que l’an dernier », explique Babwah Brennen.

Shaena Crossland, originaire de Virginie-Occidentale, s’inquiète de voir les centres de données reproduire le schéma d’industries telles que l’extraction du charbon et l’exploitation forestière, qui ont exploité les ressources de Virginie-Occidentale tandis que l’État restait majoritairement pauvre. « J’espère que ce cycle d’exploitation et de manipulation des populations prendra fin », a déclaré Crossland. Avec une autre habitante, Amy Margolies, elle est à la pointe de l’opposition à un projet de complexe de centres de données dans l’est de l’État.

Partout aux États-Unis, la population se montre de plus en plus sceptique quant aux promesses de création d’emplois locaux et d’avantages technologiques offertes par les centres de données, explique Abre’ Conner, directrice du Centre pour la justice environnementale et climatique de la NAACP, l’Association nationale pour la promotion des gens de couleur, l’une des organisations ayant intenté une action en justice contre le projet d’expansion du complexe de centres de données d’Elon Musk dans la région de Memphis.

Les centres de données incitent désormais les citoyens à résister aux influences économiques et politiques. « C’est l’une des plus importantes manifestations de la prise de conscience du pouvoir citoyen », affirme Conner.

Katherine Levine Einstein, politologue à l’Université de Boston et spécialiste des résistances locales à la construction de nouveaux logements, explique que l’opposition aux centres de données partage certains points communs avec cette résistance de longue date, mais seulement jusqu’à un certain point. Comme les décisions en matière de zonage et de permis de construire sont généralement prises au niveau local aux États-Unis, explique-t-elle, « une vingtaine de voisins mécontents » peuvent bloquer la construction de maisons ou de centres de données à proximité, même si ces nouvelles constructions pourraient profiter à beaucoup d’autres. Mais si l’opinion à l’égard de nouveaux logements consiste à y être favorable sans en vouloir à proximité, « l’opinion publique sur les centres de données est différente : les gens n’en veulent nulle part.»

Pour la journaliste Gaby Del Valle de The Verge, dans le comté d’Hernando, en Floride, c’est Carole, une femme de 71 ans, qui mène la lutte contre le projet local. Animatrice de radio spécialisée dans la musique country, elle est une conservatrice convaincue et anime l’une des 150 manifestations liées au mouvement Humans First. Mais loin d’un mouvement rationnel, les contestations de Carol sont toutes plus hallucinantes les unes que les autres. « Elle a affirmé que les vaches élevées dans des fermes situées à proximité de ces installations mettaient bas des veaux mort-nés. Les infrastructures à très grande échelle (« hyperscale ») s’approvisionnent en composants auprès de la Chine – un adversaire des États-Unis -, ce qui menacerait la sécurité nationale. « Nous courons au désastre », m’a dit Carol. « Savez-vous ce que contiennent ces puces ? » Je lui ai répondu que non. « Nous faisons aveuglément confiance aux Chinois ? » a-t-elle poursuivi, incrédule. « Pour nous fournir des puces ? » De leur côté, les partisans conservateurs des centres de données soutiennent que la Chine finance des campagnes anti-IA aux États-Unis. » 

Si les Américains sont peut-être plus polarisés que jamais, la levée de boucliers contre ces installations transcende les clivages partisans, au point de pouvoir sceller des alliances politiques inédites et surprenantes. Car malgré les délires dans lesquelles baignent les arguments de la contestation ultra-conservatrice, elles rejoignent celles des progressistes sur certains points : le coût environnemental de la construction et de la maintenance des centres de données ; les enjeux éthiques liés à l’IA, allant de son utilisation pour une surveillance gouvernementale de masse à ses répercussions sur la santé mentale des utilisateurs ; ainsi que la crainte des habitants de voir leur qualité de vie dégradée par la proximité d’une telle installation.

Toutefois, la levée de boucliers de la droite contre les centres de données est également motivée par des préoccupations partisanes, notamment la menace d’une infiltration chinoise dans les technologies américaines, dans un délire sinophobe qui traverse toute l’Amérique, des militaires aux milieux de la Tech.

Patti Zirhut, organisatrice de la rencontre et du groupe No Data Center de Hernando County, se confie : « « Je suis très conservatrice et je n’adhère absolument pas aux idées des démocrates », m’a expliqué Zirhut. Toutefois, elle se sent également trahie par la direction républicaine de la Floride. Elle soutenait ardemment le gouverneur Ron DeSantis – au début. Mais durant son second mandat, a-t-elle déploré, « il n’a fait que favoriser le développement immobilier, invitant tout le monde à s’installer ici et défigurant notre État ». DeSantis s’est positionné comme un sceptique vis-à-vis de l’IA et a promulgué, en mai, une loi obligeant les centres de données à prendre en charge leurs propres coûts énergétiques, tout en autorisant les autorités locales à réglementer la consommation d’eau pour ces projets. Cependant, son administration a accordé des millions de dollars d’allégements fiscaux aux promoteurs de centres de données, selon le Tampa Bay Times. » De quoi le faire détester de sa base, rapporte The Verge. « Zirhut s’inquiète également d’un amendement soutenu par DeSantis, qui viserait à supprimer la taxe foncière pour la plupart des propriétaires ; une telle mesure priverait les comtés de recettes indispensables, rendant potentiellement plus attrayants des projets tels que les centres de données. » Le favori Républicain local pour le poste de gouverneur, Byron Donalds, est lui aussi un fervent partisan de la construction de centres de données en Floride et souhaite attirer davantage d’investissements extérieurs en Floride. « Ce n’est pas du tout ce que nous voulons ici en Floride », explique Zirhut. Le soutien de Donalds aux centres de données lui fait désormais perdre des partisans au sein de son propre parti. « De récentes publicités hostiles ont mis l’accent sur le soutien qu’il a reçu du secteur technologique, notamment plus de 5 millions de dollars de dons de la part de « Leading the Future » – un super PAC pro-IA doté de 100 millions de dollars et financé entre autres par Andreessen Horowitz et Joe Lonsdale de Palantir. Or, « en Floride, l’opposition aux centres de données est généralisée dans tout l’État ». Plus de 20 comtés et municipalités ont débattu de moratoires sur la construction de centres de données ou les ont adoptés, rapporte Politico. « Dans certaines localités, la levée de boucliers a été suffisamment forte pour dissuader les promoteurs. En juin, le porteur d’un projet controversé de centre de données dans le comté de Citrus a abandonné son projet. « Les moratoires locaux sur les centres de données envoient le signal que la région est fermée aux affaires, tant pour les centres de données que pour d’autres projets de développement économique importants », a déclaré à The Verge Dan Diorio, vice-président exécutif chargé des politiques étatiques et des relations gouvernementales au sein de la Data Center Coalition, un groupe de pression du secteur ».

Patti Zirhut, elle, n’est pas opposée à la croissance, mais elle ne veut pas que les pouvoirs publics accordent des avantages à de grands promoteurs n’ayant aucun lien avec la communauté. « Si l’on pouvait privilégier le niveau local, avec des constructeurs de la région, ce serait très bien, car ils savent comment gérer les spécificités de la Floride ». Elle s’inquiète de la façon dont l’IA peut alimenter la surveillance de masse, une question devenue particulièrement brûlante après que le bureau du shérif du comté de Hernando a commencé à installer des dispositifs Flock sur les routes locales. « Nous ne voulons pas que les gens perdent leur emploi, que notre pays soit dirigé par l’IA, ni vivre comme en Chine, où notre argent est contrôlé et chacun de nos faits et gestes surveillé ». Bien que Mme Zirhut soit républicaine de longue date, la question du centre de données – et celle, plus vaste, du développement – l’a amenée à faire des choix politiques inattendus. « Si Byron Donalds remporte la primaire, je voterai pour les démocrates. Je ne voterai pas pour lui » a-t-elle confié. « Je pense que beaucoup de gens sont dans ce cas. Ce n’est pas une question de parti. Vraiment pas. C’est une question de vie humaine. » 

Pour Ben Green, explique-t-il dans une tribune pour Tech Policy Press, « ce qui rend la question des centres de données particulièrement intéressante pour les démocrates, c’est sa capacité à séduire des électeurs au-delà de leur base électorale habituelle. De nombreuses contestations liées aux centres de données surviennent précisément dans les zones rurales et les États républicains ou disputés où les démocrates cherchent désespérément à gagner du terrain. Des communautés se sont mobilisées pour s’opposer à ces installations dans des États aux profils politiques très variés, tels que l’Indiana, le Michigan, le Missouri, le Nebraska, l’Ohio et la Virginie. Électeurs comme élus ont constaté que les centres de données constituent l’un des rares sujets capables d’amener les citoyens à voter en s’affranchissant des clivages partisans habituels. » Mais constatait-il également : « certains responsables républicains commencent eux aussi à adopter des positions fermes contre les centres de données. Si les démocrates n’agissent pas rapidement sur ce dossier, ils risquent de se faire devancer par leurs adversaires. » 

Reste que les délires de la droite Maga sur les data centers ne vont pas disparaître demain. Comme s’en moque Cory Doctorow sur son blog dans un billet édifiant sur les risques de l’éclatement de la coalition trumpiste après Trump, toute cette sphère de droite réactionnaire est saisit d’une paranoïa folle. « Ils baignent dans les théories du complot et sont en permanence intoxiqués par leurs propres délires. Ils croient dur comme fer aux conneries sur le grand remplacement ou sur le fait que la Chine pousse l’Amérique à détester les centres de données.» Trump n’a pas inventé ces délires, il leur a simplement donné de l’assurance. Et les délires semblent n’avoir plus besoin de leur grand ordonnateur pour s’épancher. Trump peut tenter d’apaiser sa base électorale en renouvelant son soutien à l’industrie de l’IA, il est peu probable que cela permette aux délires complotistes Maga de s’éteindre.

Hubert Guillaud

PS : The Verge propose également un long et édifiant reportage sur ce qu’on appelle le Data Center Alley, le comté de Loudoun en Virginie, où les data centers sont arrivés il y a plus de 20 ans et où l’on trouve plus de 250 data centers. « En quelques années, les centres de données sont passés du statut d’élément banal du quotidien à celui de sujet de préoccupation quotidienne pour de nombreux résidents. » La contestation a fini par grimper en flèche, et si les data centers ont permis une certaine prospérité, les nuisances finissent par l’emporter. « L’expansion des centres de données à Loudoun a pris une telle ampleur qu’elle semble désormais échapper à tout contrôle ». Car si le comté annonce ne pas vouloir davantage de centres de données, de nouvelles installations voient le jour, malgré tout. L’opposition quant à elle, se constitue tardivement. Mais désormais, les propriétaires locaux sont confrontés non seulement au bruit des générateurs électriques mais également aux pylônes électriques en tout sens quand ce n’est pas à l’expropriation pour l’extension des projets. « On entend à peine les oiseaux désormais » confie une habitante et nombre d’arbres ont été abattus pour permettre aux fils électriques à haute tension de passer sans encombre.

  •  

Le piège de l’authenticité

Pour Aeon, les sociologues Marion Fourcade et Kieran Healy, identifient un intéressant paradoxe, celui de l’authenticité. Dans leur livre, The Ordinal Society (Harvard University Press, 2024, voir notre critique), ils identifiaient déjà plusieurs paradoxes de la numérisation de nos sociétés, comme celui de la standardisation ou de l’individualisation. 

Dans la société ordinale (une société du score, comme le disaient déjà Daniele Citron et Frank Pasquale), rappellent-ils, tout est ordonné, classé, trié pour être apparié. « C’est grâce à leur capacité à observer, juger et gérer les individus dans différents contextes sociaux que les ordinateurs exercent leur influence la plus significative sur la société. Partout, la logique bureaucratique des organisations fusionne avec la logique calculatoire des machines. Partout les ordinateurs produisent des scores qui créent des différences, définissent des priorités, organisent les files d’attente et constituent une base d’action extrêmement utile et puissante. Ils instaurent l’ordre en catégorisant les personnes, les choses et les idées, puis en les associant entre elles, à des positions sociales, à des biens, des services et des prix. »

« Les schémas qui en résultent constituent ce que nous appelons structure sociale – une sorte de société ordinale où les données générées par ordinateur servent de repères pour nos choix. Dans le domaine économique, par exemple, ces méthodes contribuent à fixer les salaires et les horaires de travail. Elles calculent les loyers, le prix des assurances et déterminent l’admissibilité aux services sociaux. Elles facilitent de nouvelles formes de recherche de rente et accélèrent le développement de nouvelles classes d’actifs négociables sur les marchés financiers. Elles ont également modifié la relation entre les individus et les groupes qu’ils forment et auxquels ils appartiennent. Elles organisent la circulation de l’information, la distribution de l’influence sociale et les moyens de mobilisation politique. Notre capacité à tisser des liens sociaux significatifs et à agir collectivement s’en est trouvée profondément altérée. » L’ordonnancement algorithmique a une conséquence expliquent-ils : il transforme en retour notre perception de nous-même. Ce nouveau rapport semble libérer les personnes des affiliations sociales et les juger selon leurs qualités. « Il promet l’intégration aux exclus, la reconnaissance aux créatifs et une juste récompense aux entrepreneurs.» 

« Pourtant, cette promesse d’émancipation s’accomplit par des systèmes qui classent, trient et, surtout, hiérarchisent les individus avec une précision toujours plus grande et à une échelle auparavant inimaginable. L’ordre social qui en résulte est une sorte de paradoxe, caractérisé par des tensions constantes entre liberté individuelle et contrôle social, entre l’élan subjectif de l’authenticité intérieure et les forces objectives de la validation externe. Il donne naissance à une certaine manière d’être, à un nouveau type de soi, dont les expériences sont définies par la quête d’autonomie personnelle et l’attrait de la dépendance aux plateformes. » Derrière l’individualisation, la personnalisation du calcul, se cache en fait une catégorisation toujours plus élastique, granulaire. Comme nous le disions déjà il y a près de 10 ans, la personnalisation n’a rien de personnel : « les algorithmes ne cherchent pas à nous distinguer, mais à nous catégoriser. » Mais les effets de ces catégorisations, produites à la volée, inférées, recomposées ou profondes, sont bien réelles, tant d’un point de vue personnel que collectif. C’est ce que montrait par exemple la pertinente note de Melkom Boghossian pour la fondation Jean Jaurès quand il expliquait comment les algorithmes accentuent les clivages de genre. Mais, pour Marion Fourcade et Kieran Healy, les conséquences sont plus profondes encore, car ces catégorisations « exacerbent l’individualisme et la compétition interpersonnelle  à un point tel que notre capacité à tisser des liens sociaux significatifs et à agir collectivement s’en trouve profondément altérée ». Les sociologues parlent d’individualisme exacerbé. 

Polarisations identitaires

« Aux débuts d’Internet, être en ligne offrait certaines libertés. Non seulement l’anonymat ou le pseudonymat en ligne étaient courants, mais ils étaient célébrés comme une forme de libération. » Nous pouvions alors avoir plusieurs versions de nous-mêmes, plusieurs identités et naviguer dans leurs interstices, entre des profils qui ne communiquaient pas entre eux. « Vous bénéficiez d’une forme de confidentialité qui repose moins sur des protections juridiques explicites que sur les limitations techniques de systèmes connectés en théorie, mais non intégrés en pratique », votre profil de joueur ne communiquait pas avec votre profil sur tel ou tel forum. Un peu comme la séparation administrative, qui permettait aux Etats-Unis, aux immigrants sans papiers de payer leurs impôts en toute sécurité. « Cette séparation administrative délibérée permettait aux entreprises et aux gouvernements américains de tirer profit de la main-d’œuvre immigrée tout en créant un véritable sanctuaire où des millions de personnes pouvaient s’acquitter de leurs obligations fiscales (grâce à leur numéro d’identification fiscale individuel) sans craindre d’être expulsées. » 

Mais pour les sociologues, c’est là ce qui est en train de changer. Le Département de l’efficacité gouvernementale (Doge) a changé la donne et les informations fiscales sont désormais utilisées pour retrouver les sans-papiers. En fait, les espaces d’expression se réduisent quand d’innombrables agences utilisent les données des courtiers en données, ou quand les agences gouvernementales acquièrent le droit d’examiner les profils sur les réseaux sociaux. A mesure que les croisements de données sont rendues possibles entre institutions étatiques et privées, la surveillance devient non seulement omniprésente, mais surtout bien plus puissante. 

Mais plus encore que la possibilité d’identifiabilité, l’exploitation des profilages renvoie à chacun des questions sur son identité même. Qui sommes-nous vraiment ? Ne sommes-nous pas de plus en plus celle ou celui que nous renvoient l’exploitation de nos profils ? En exploitant notre soif de sociabilité et nos idéaux d’épanouissement personnel, les réseaux sociaux nous incitent à afficher nos convictions et à rallier des alliées pour les valider, dans une quête d’authenticité qui se retourne souvent contre ses auteurs. Dans un livre à paraître à l’automne sur les influenceurs (Gurus, Hucksters, Entertainers, Chicago university press, 2026), la sociologue Angèle Christin montre par exemple comment la nécessité de se distinguer peut conduire à la polarisation. « La dynamique des plateformes pousse les artistes du divertissement et les gourous à produire des contenus extrêmes et incendiaires pour maintenir l’engagement de l’audience, tandis que les marques et les spécialistes du marketing incitent les vendeurs à des prestations commerciales répétitives et convenues. Les inquiétudes concernant la manipulation algorithmique et les conflits entre créateurs engendrent par ailleurs des scandales nuisibles à la réputation, souvent marqués par le harcèlement. Angèle Christin révèle comment le travail sur ces plateformes favorise, de manière répétée et structurelle, la précarité et les inégalités, ainsi que les clashs destructeurs et la diffusion de contenus incendiaires en ligne. » 

Pour Fourcade et Healy, le piège de l’authenticité génère d’autres chausses-trappes encore. Ce que l’on y affiche devient la preuve de son identité. « Dans son ouvrage Ballad of the Bullet (Princeton university press, 2020), l’ethnographe Forrest Stuart a montré le décalage important entre les performances que les musiciens hip-hop de Chicago mettent en scène sur les réseaux sociaux et la réalité plus banale de leur vie. Les jeunes qui se donnent des airs de durs pour vendre leur musique sur YouTube risquent d’apprendre à leurs dépens que les forces de l’ordre et les juges ont tendance à interpréter ces signes au pied de la lettre, sans y voir les jeux de pouvoir et les affirmations identitaires dont ils surjouent. De même, le recours par l’administration Trump aux tatouages ​​comme preuve facilement mesurable et accessible d’appartenance à un gang transforme un marqueur souvent superficiel en un simple critère d’évaluation pour les expulsions. Dans un pays où le gouvernement s’arroge le droit d’instrumentaliser les opinions déclarées des citoyens dans les procédures d’immigration, l’effet est glaçant ». 

L’expressivité en ligne, renforcée par les contraintes algorithmiques, qui produisait des liens sociaux, s’apprête bien plus à générer des obstacles pour chacun d’entre nous.  

De l’authenticité à l’authentification

Les contenus génératifs viennent renforcer encore le phénomène en déstabilisant encore un peu plus l’authenticité, en floutant la distinction entre le vrai et le faux. « Tout cela a pour effet de déplacer l’accent de l’authenticité vers l’authentification, de la démonstration de la véracité de son identité vers la preuve de la véracité de son témoignage. La question n’est plus de savoir si les marqueurs d’identité sont authentiques (« Est-ce que ces données sont vraiment vous ? ») ni même sincère (« Qui êtes-vous vraiment ? »), mais si chaque élément de votre présence numérique est exempt de toute médiation artificielle (« Est-ce vraiment vous ? »). Ce nouveau régime d’authentification transforme les interactions, d’une série de performances à juger, en une succession d’actions à vérifier par des machines à chaque étape. Être légitime exige désormais d’être publiquement identifiable, authentique et, de plus en plus, pleinement authentifié. » 

« Ce qui a commencé comme une célébration de l’unicité individuelle, encourageant la production de preuves numériques, évolue vers un système de vérification complexe qui considère toute trace comme potentiellement suspecte. » Avec la circulation de fausses versions de nous-mêmes, nous risquons de nous retrouver pris dans un cycle sans fin de démonstration et de défense de notre existence, nous soumettant toujours davantage à un mécanisme de scepticisme institutionnalisé, venant renforcer (s’il en était besoin) la conviction administrative que chacun est coupable, fraudeur, bonimenteur… L’image que l’on donne de soi est à la fois perçue comme la réalité et comme un mensonge, nécessitant d’être toujours interrogée pour être utilisée à son encontre.  

De l’individualisation du savoir à la construction de croyances

« Ces crises politiques et techniques de l’authentification dépassent largement le cadre de l’individu. Avec l’avènement d’internet, le savoir s’est considérablement étendu et diversifié. Mais il est aussi devenu plus personnalisé et plus étriqué, car les internautes interagissent avec le web en s’appuyant sur leurs convictions personnelles et leurs conceptions de la réalité, et en les développant. L’arrivée de l’IA générative aggrave peut-être ce défi épistémique : quand tout doit être authentifié, mais que les contrefaçons sont de plus en plus sophistiquées, comment être sûr de quoi que ce soit ? » 

Nous vivons à l’ère de la désintermédiation du savoir. En un clic, nous pouvons consulter des documents juridiques originaux, télécharger de vastes ensembles de données, bénéficier de l’aide d’un assistant IA pour écrire le code nécessaire à leur analyse et rédiger rapidement les résultats. « Il ne faut pas sous-estimer à quel point cette transformation a été stupéfiante et incroyablement enrichissante à bien des égards. Malgré ses problèmes, si l’on demandait à un chercheur s’il reviendrait à un monde entièrement pré-numérique et pré-réseau pour le partage des connaissances, la communication académique et l’accès aux données, la réponse serait massivement « non ». Mais cette transformation du quotidien professionnel s’accompagne d’autre chose. La propension à la recherche est devenue, sans qu’on s’en rende compte, une seconde nature. » Aujourd’hui, « faire ses propres recherches » est plus qu’une simple habitude chez les universitaires. C’est un impératif moral, un devoir civique et, un peu comme être un bon conducteur, une compétence que chacun s’imagine posséder. Les individus capables d’explorer le réseau et d’interroger les bases de données de modèles de langage à grande échelle (LLM), et qui ont la confiance en eux et les moyens de diffuser leurs découvertes, tendent à devenir une source d’opinion faisant autorité. Du moins, c’est ainsi qu’ils le perçoivent. On comprend dès lors pourquoi les connaissances ainsi produites sont souvent si chargées d’émotion. Plus on s’investit dans la recherche et le développement de sa propre compréhension, plus cette quête de savoir prend de l’ampleur. »

« Le savoir se transforme en une forme de révélation personnelle, où chacun est à la fois celui qui cherche et celui qui interprète sa propre vérité ». « Ce qui a commencé comme un exercice de raisonnement autonome devient une question de croyance – une croyance défendue avec d’autant plus de ferveur qu’elle semble avoir été découverte par soi-même plutôt qu’imposée de l’extérieur. » Le problème est que cette quête individualisée de sens renforce la polarisation. « L’idée même de parvenir à un consensus largement partagé sur les faits semble de plus en plus hors de portée ». « En conséquence, les hiérarchies traditionnelles du savoir et les sources d’expertise sont contournées au profit de recherches algorithmiques autoguidées, qui génèrent une réponse précisément pertinente à une requête ou à une consigne, qu’il s’agisse d’une liste de liens ou d’un paragraphe de synthèse. Dans le meilleur des cas, cette pratique tend vers une forme d’idéal démocratique cher à John Dewey : elle semble revitaliser la production de savoir en tant qu’entreprise participative, animée par un esprit démocratique d’enquête ouverte et de recherche collective de la vérité. »… Tout en demeurant très individualisée et individualisante. C’est ce qu’espéraient beaucoup d’observateurs aux débuts du World Wide Web, y compris lors des premières vagues des réseaux sociaux, des blogs jusqu’à Twitter. Toutefois, dans le pire des cas, la diffusion du savoir finit par transiter par des plateformes qui personnalisent les résultats à grande échelle et favorisent l’engagement envers des contenus extrêmes ou trompeurs, car le sensationnalisme et la complaisance sont les moteurs des revenus publicitaires. 

Lorsque, en 2023, le gouvernement canadien a exigé des entreprises du numérique qu’elles rémunèrent les médias pour les liens renvoyant vers des actualités publiées sur leurs plateformes, Meta a tout simplement bloqué ces liens sur Facebook et Instagram. Le vide informationnel qui en a résulté a été rapidement comblé par des contenus non vérifiés et orientés à droite, ce qui a contribué à soutenir le candidat local de mouvance trumpiste. « Nous sommes désormais submergés d’exemples de plateformes technologiques usant de leur puissance de marché pour modeler les écosystèmes de l’information selon leurs impératifs commerciaux, au mépris des conséquences sociétales ». Google a révolutionné la recherche en traitant, de fait, les pages web comme un vaste réseau de réputation. L’autorité relative des sites était déterminée par une multitude de décisions indépendantes : celle de créer ou non un lien vers eux. Cependant, la volonté d’adapter les résultats aux préférences individuelles a été de plus en plus dictée par l’efficacité des titres accrocheurs (clickbait) ou du placement publicitaire. Il en a résulté une fragmentation des connaissances accessibles au public, désormais produites pour faciliter la manipulation du marché en confortant des croyances préexistantes. Si la perception de la recherche en ligne comme une forme de pensée critique et active a perduré, il peut s’avérer difficile, pour certains, de trouver des informations fiables. Cette situation rend d’autant plus ardue la construction d’une réalité partagée. Et l’idée même de parvenir à un consensus largement partagé sur les faits – quelle que soit leur teneur – semble s’éloigner toujours davantage. 

L’illusion de l’individu souverain : une identité centrée sur le soi

« C’est dans ces gouffres de la connaissance que se façonne le sentiment d’une identité centrée sur le « soi » nourri par la conviction que l’individu est l’unique source véritable de sa propre illumination ». La conjonction d’un égocentrisme épistémologique et de l’hyperconnectivité rend les individus perméables à des formes diffuses de construction de « super-sens » (pour reprendre une expression de Hannah Arendt). « En quête d’une vérité porteuse de sens, ils traquent des indices significatifs disséminés sur Internet, s’appuyant sur des algorithmes commerciaux et des systèmes de recommandation pour assembler des bribes d’information disparates en une vision du monde cohérente. Ce qui commence souvent comme une quête existentielle ludique peut aisément se cristalliser en croyances déformant la réalité » ; celles-ci prospèrent en favorisant l’émergence de nouveaux types sociaux et de regroupements politiquement influents. À son apogée, le mouvement QAnon a illustré l’interaction entre cette disposition à la quête de sens, les médiations numériques et le ciblage à but lucratif. Ses membres se percevaient comme des esprits critiques, seuls capables de mettre au jour des vérités cachées et de décrypter des indices complexes. Ils rejetaient avec véhémence l’idée d’appartenir à une secte, arguant – comme l’a expliqué l’un d’eux au chercheur Peter Forberg – qu’« aucune secte ne vous incite à penser par vous-même ». 

Le risque est fort que les grands modèles de langages (LLM) ne puissent résoudre le problème de la fiabilité des connaissances au sein d’une sphère publique fragmentée. « Tout comme les impératifs commerciaux ont engendré des contenus fallacieux et des bulles de filtres, les LLM seront probablement soumis aux mêmes pressions dans un contexte de rendement décroissant ». Les entreprises qui les entraînent ayant un besoin impérieux de rentabilité, les logiques commerciales classiques – telles que la personnalisation et la segmentation des services – risquent fort de s’imposer à nouveau, donnant lieu à des univers épistémiques sur mesure, générés par des modèles adaptés aux goûts et aux capacités financières de publics distincts. 

« En tant qu’individu, notre plus grande crainte culturelle est d’être englouti par la société de masse, tout comme votre plus grande crainte politique est celle d’une surveillance exercée par un État autoritaire ». Ces peurs sont toujours bien présentes. Toutefois, dans un monde saturé de catégories et d’identités, de nouveaux dilemmes surgissent, estiment les chercheurs.« Sur le plan individuel, tout – comportements publics, déclarations, mesures chiffrées – peut potentiellement devenir un facteur de différenciation et, par conséquent, une source d’identité. Du côté des organisations, les données générées par les utilisateurs conduisent à les regrouper ou à les segmenter selon des modalités de plus en plus spécifiques, éphémères et souvent incompréhensibles. Plus les classifications sociales (ou pseudo-sociales) se font précises, plus les occasions de distinctions et de jugements moraux se multiplient. La principale victime de cette évolution est la possibilité de nouer des alliances politiques stables et de grande envergure. Plus les citoyens sont traités individuellement comme des cibles d’interventions commerciales, plus la vie politique se fragmente. »

« Les méthodes traditionnelles de ciblage électoral partaient d’un message politique pour rechercher les individus susceptibles d’y adhérer. L’essor du big data inverse cette logique : on part des dispositions culturelles de l’électorat pour élaborer, en partant de la base, des messages qui résonnent avec ces attentes. »

Fourcade et Healy rappellent d’ailleurs que bien avant Cambridge Analytica, le Mouvement 5 étoiles (M5S) italien a sans doute été le pionnier de cette approche politique fondée sur les données, comme le raconte Giuliano da Empoli dans Les ingénieurs du chaos (2019). Tout a commencé en 2005, lorsque Gianroberto Casaleggio, spécialiste du marketing numérique féru de démocratie directe, a recruté l’humoriste et satiriste populaire Beppe Grillo pour lancer un blog éponyme, destiné à partager avec le public sa désillusion et son indignation politiques. Ce blog encourageait la participation citoyenne, permettant ainsi à Casaleggio – auquel a succédé son fils Davide après son décès en 2016 – de repérer les griefs et les propositions suscitant le plus d’écho grâce aux « j’aime », aux commentaires et aux retours des utilisateurs, tout en testant, adaptant et affinant le discours politique de Grillo. Il en a résulté la naissance du premier « parti algorithmique », dont l’idéologie chaotique a été façonnée à partir des enseignements tirés des données. Très vite, le peuple du blog a été invité à descendre dans la rue, soutenu par l’infrastructure des réseaux sociaux d’un autre outil numérique : l’application Meetup. En 2018, le M5S est devenu le premier parti d’Italie, contribuant à former un gouvernement de coalition de courte durée. Un petit groupe d’hommes ultra-riches a repris le contrôle de l’État en s’adressant directement aux masses. 

Les campagnes politiques modernes ont fait évoluer cette approche vers une forme plus sophistiquée et, sans doute, plus manipulatrice encore, soulignent les chercheurs. Les données issues des réseaux sociaux – concernant les pratiques culturelles, les émotions et les dispositions d’esprit sur une vaste gamme de sujets – permettent d’élaborer de nouveaux récits et de nouvelles esthétiques, de remodeler l’environnement informationnel et les liens sociaux des individus, et de susciter leur vote à des moments stratégiques. « L’objectif politique visé est généralement atteint grâce à une « architecture de persuasion » élaborée, reposant sur des messages personnalisés et une exposition répétée. Par exemple, les algorithmes publicitaires identifient des schémas d’actions efficaces (dons, « j’aime », achats, partages) et ciblent des utilisateurs similaires susceptibles de reproduire ces comportements ». Chaque itération exploite des données de réponse en temps réel pour dresser une cartographie toujours plus fine des cibles manipulables. « La mobilisation politique est, de fait, régie de manière cybernétique par des algorithmes. Sa logique opérationnelle émerge de constellations de variables difficiles à appréhender dans leur ensemble, conférant aux formations politiques qui en résultent un caractère émergent et ad hoc, relativement indépendant des instances de médiation traditionnelles telles que les partis politiques et les mouvements sociaux. L’affaiblissement de ces structures conventionnelles et la possibilité de personnaliser les messages politiques engendrent également des formes de domination sociale hautement individualisées. Les dirigeants populistes prospèrent grâce à l’idée qu’ils entretiennent un lien direct avec le public – bien que ce lien soit souvent entretenu par tout un écosystème, une « boucle de rétroaction de propagande » soigneusement élaborée. Les propriétaires de réseaux sociaux peuvent même imposer ce lien aux utilisateurs par le biais de manipulations algorithmiques servant leurs propres intérêts, comme l’auraient fait Elon Musk et Donald Trump sur leurs plateformes respectives. Grisés par l’idéal de l’« individu souverain », affranchi des frontières nationales, des normes sociales ou de la loi, quelques hommes ultra-riches ont réussi à reconquérir le pouvoir sur l’État et les élites traditionnelles en faisant appel directement aux masses et à la liberté du marché. » 

Trump lui-même semble s’être transformé en simple token, offrant son propre statut et sa réputation comme une opportunité d’investissement à ses abonnés enthousiastes… ironisent les chercheurs. Mais en réalité, pour la plupart d’entre nous, l’économie numérique exige de nous de travailler plus dur, même pour en tirer une célébrité rapide et en tirer profit. Les règles du jeu sont biaisées puisque nul ne maîtrise les catégories qui le propulsent ou l’invisibilisent, et l’argent, le temps et le capital social jouent un rôle majeur pour propulser certains individus au-dessus des autres. L’économie numérique repose de plus en plus sur la capacité à accéder et à payer des « accélérateurs algorithmiques » (publicité, comptes certifiés, cercle relationnel de personnes déjà visibles, affaiblissement des contenus pour booster leur viralité, usage des bots). L’essor du « personal branding » (la mise en scène de soi) témoigne en partie d’un désespoir, d’un écran de fumée idéologique masquant une réalité sociale bien plus sombre sur le terrain. 

« Alors que le déploiement des technologies numériques continue de générer des concentrations de richesse toujours plus stratosphériques, les masses s’enfoncent davantage dans le vide laissé par le démantèlement de la solidarité sociale et la montée de l’automatisation. Ce que l’on oublie souvent au sujet des « individus souverains », c’est que tout le monde ne peut pas en devenir un. »

  •  

L’IA appliquée à la science… rêve de progrès

Ce que l’IA accélère

Les promesses de l’IA pour découvrir de nouveaux matériaux ou révolutionner les découvertes scientifiques sont fortes. L’idée que l’IA serait l’avenir de la science comme on l’entend très souvent est bien plus un moyen d’orienter les investissements qu’une vérité scientifique, au risque d’augmenter la dépendance de la science à l’IA. 

Dans le domaine de la fabrication de médicament, on attend là encore que l’IA permette de nouvelles percées, explique The Economist. Pourtant, les partenariats entre entreprises pharmaceutiques et sociétés d’IA se multiplient, notamment dans l’espoir de mieux identifier des molécules, de raccourcir le temps de développement des essais cliniques et de diminuer le taux d’échec de ceux-ci (actuellement, « les médicaments candidats entrant en essais cliniques ont un taux d’échec de 90 %, ce qui porte le coût de développement d’un médicament efficace à la somme astronomique de 2,8 milliards de dollars »). « Même des gains d’efficacité marginaux représenteraient des avantages considérables. Des rapports provenant de l’ensemble du secteur suggèrent que l’IA a commencé à apporter ces gains. Elle a réduit la phase préclinique (celle qui précède les essais cliniques sur l’homme) à 12-18 mois, contre trois à cinq ans auparavant. Et elle a amélioré le taux de réussite. Une étude publiée en 2024, portant sur les performances de molécules proposées par l’IA lors des premiers essais cliniques, a révélé un taux de réussite de 80 à 90 %. À titre de comparaison, les moyennes historiques se situaient entre 40 et 65 %. »

« La conception d’un nouveau médicament commence généralement par le criblage de petites molécules organiques afin d’identifier celles présentant une activité biologique prometteuse afin de sélectionner les plus probables. L’IA peut analyser des bibliothèques de dizaines de milliards de molécules, en testant des propriétés telles que la puissance, la solubilité et la toxicité grâce à des émulations logicielles de ces molécules, sans qu’il soit nécessaire d’utiliser les molécules réelles en laboratoire. Jim Weatherall, l’un des responsables de cette activité chez AstraZeneca, une autre grande entreprise pharmaceutique, affirme que cette méthode permet de trier les molécules prometteuses deux fois plus vite qu’auparavant, et que plus de 90 % du processus de découverte de petites molécules de l’entreprise est désormais assisté par l’IA. »  

L’IA sert donc d’abord à optimiser les investissements. L’IA contribue également à améliorer la conception des essais cliniques. Par exemple en formulant une hypothèse sur une maladie et en tentant de confirmer ou d’infirmer ces hypothèses par une recherche bibliographique. 

L’IA se révèle également prometteuse dans la sélection des patients pour les essais cliniques. Elle peut analyser les dossiers médicaux, les biopsies et les examens d’imagerie des candidats afin d’identifier ceux qui pourraient tirer le meilleur parti d’un nouveau médicament. Une meilleure sélection des participants permet de réduire la taille des essais, et donc de les rendre plus rapides et moins coûteux. Un autre utilisation de l’IA consiste à créer des patients synthétiques permettant de comparer un patient réel et son double numérique pour comparer l’évolution prédite sans traitement par rapport au patient testé. A terme, les patients synthétiques permettrait de réduire les groupes témoins et leurs coûts (au risque tout de même que ces comparaisons aient une fiabilité relative). 

L’optimisation des essais cliniques via l’IA représente une réduction considérable des risques, avec une diminution concomitante des coûts de développement des médicaments. 

Mais si l’IA promet de produire de nouveaux médicaments, elle ne promet pas que nous ayons les capacités industrielles de le faire, comme le montrent les innombrables pénuries que nous traversons. Elle ne résout pas le risque d’abandon de la santé pour tous, qu’évoquait par exemple le philosophe Alexandre Monnin dans AOC il y a quelques mois (voire notre synthèse).

Au contraire. Dans le domaine de la médecine, comme le soulignaient l’avocate américaine des sans abris Leah Goodridge et la médecin et chercheuse, Oni Blackstock, directrice de l’association Health Justice, dans une tribune pour The Guardian, l’IA risque bien plus d’être utilisée pour refuser des soins que pour faire progresser la médecine. En Californie du Sud, où le nombre de personnes sans abris est l’un des plus élevé du pays, Akido Labs gère des cliniques pour les personnes sans domicile fixe et celles à faibles revenus. Mais ces patients sont vus par des assistants médicaux qui utilisent l’IA pour écouter les conversations, puis proposer des diagnostics et des plans de traitement potentiels, qui sont ensuite examinés par un médecin. L’objectif de l’entreprise, a déclaré son directeur technique à la Technology Review, est de « supprimer le médecin de la consultation ».

Cela s’inscrit dans une tendance plus large où l’IA générative est de plus en plus intégrée au système de santé, rappellent Goodridge et Blackstock. En 2025, une enquête de l’Association médicale américaine a révélé que deux médecins sur trois utilisaient l’IA dans leur travail quotidien, notamment pour diagnostiquer les patients. Une start-up spécialisée en IA (OpenEvidence, qui n’est pas accessible en Europe) a levé 200 millions de dollars pour fournir aux professionnels de santé un ChatGPT pour médecins. Et les législateurs américains examinent actuellement un projet de loi qui autoriserait l’IA à prescrire des médicaments. Bien que cette tendance à l’intelligence artificielle dans le secteur de la santé affecte presque tous les patients, son impact est plus profond sur les personnes à faibles revenus, qui rencontrent déjà d’importants obstacles à l’accès aux soins. « Les personnes sans domicile fixe et à faibles revenus ne devraient pas servir de cobayes pour l’IA dans le domaine de la santé. Au contraire, leurs voix et leurs priorités devraient déterminer si, comment et quand l’IA sera mise en œuvre dans leurs soins ». 

La saturation des hôpitaux, les coûts d’accès au soin… expliquent en grande partie ces développements. D’autant que ces contraintes « sont souvent amplifiées dans les communautés économiquement défavorisées, où les établissements de santé sont souvent sous-financés et les patients non assurés, avec un fardeau plus lourd de maladies chroniques dû au racisme et à la pauvreté ». Les très documentés biais des IA de santé, « qui diagnostiquent bien moins les problèmes des patients noirs et hispaniques, des femmes et des patients bénéficiant de l’assurance Medicaid, promettent surtout d’aggraver les inégalités de santé pour les patients qui rencontrent déjà des obstacles à l’accès aux soins ». Pire, comme on le lit dans la TR, les patients ne sont même pas informés que leur professionnel de santé ou leur système de santé utilise l’IA. Un assistant médical explique ainsi que ses patients savent qu’un système d’IA les écoute, mais qu’il ne leur dit pas qu’elle formule des recommandations diagnostiques. Ces discriminations sont renforcées par la tendance croissante à l’utilisation de l’IA pour déterminer les remboursements de santé des personnes à faibles revenus (voir ce que nous disions d’United HealthCare connu pour sa politique de refus de remboursement de soins de santé). Bref, si l’IA d’un côté promet une amélioration de la production de médicaments, elle risque bien plus d’empêcher les publics d’y accéder. 

Il y a d’autres domaines que l’IA accélère, comme le pointait Cade Metz dans le New York Times. Notamment la recherche en mathématiques, en biologie et en chimie. Mais là encore, bien des annonces tonitruantes se révèlent souvent assez décevantes une fois que les spécialistes les décortiquent. C’était le cas notamment lorsqu’une startup d’IA, Harmonic a annoncé avoir résolu un problème mathématique, avant que les experts ne constatent que ses solutions ne différaient guère des travaux antérieurs de mathématiciens. L’IA parvient à identifier des solutions existantes, enfouies dans des décennies d’articles de recherche plus qu’elle n’en invente. « On a l’impression d’être face à un élève brillant qui a tout mémorisé pour l’examen, mais qui ne comprend pas vraiment le concept », assène le mathématicien Terence Tao. L’IA permet bien plus de suggérer des hypothèses ou des expériences qui permettent de cibler les recherches, explique un spécialiste du cancer, qui constate lui aussi que cela permet d’accélérer les processus. Mais un chercheur expérimenté est toujours nécessaire pour guider le système. Pour Terence Tao, interviewé dans Nature, l’IA peut commettre des erreurs invérifiables dans nombre de domaines, mais en maths, elles sont vérifiables. Les inconvénients sont donc bien plus limités. « On commence à voir des exemples où l’IA – peut-être par chance – résout des problèmes importants pour les mathématiciens. C’est encore très rare et l’IA présente encore de nombreuses faiblesses ; elle ne remplace pas le travail humain. Mais il devient de plus en plus difficile de nier l’efficacité de ces outils. » Mais définir de nouveaux concepts et déterminer les problèmes à résoudre restera probablement du ressort des mathématiciens humains… au moins pendant un certain temps encore, estime le médaillé Fields. 

… au risque de réduire le champ d’investigation de la science

Si l’IA pour la recherche scientifique promet, elle pourrait aussi avoir des effets délétères, rappelle la journaliste Grace Huckins pour la Technology Review et réduire à terme le dynamisme de la science. Une étude publiée dans Nature a révélé que si certains scientifiques perçoivent des avantages professionnels à adopter l’IA, la science dans son ensemble pourrait en pâtir, car l‘IA réduit le champ d’investigation de la communauté scientifique. Cela pourrait s’expliquer par le fait que l’IA excelle particulièrement dans l’analyse de données et de publications existantes, ce qui incite les scientifiques qui l’utilisent à se concentrer sur des domaines établis où des données à grande échelle sont disponibles. Il pourrait en résulter un nombre réduit de scientifiques disponibles pour étudier des problèmes moins adaptés à l’IA. Intégrer efficacement l’IA dans la science est plus qu’un simple défi technique : préserver le dynamisme et la diversité de la science à l’ère de l’IA pourrait nécessiter un effort concerté de la part de la communauté scientifique. 

Dans un éditorial pour Science, Julio Ottino et Brian Uzzi enfoncent le clou et dénoncent le risque d’une « progression sans progrès ». « Les progrès réalisés dans l’utilisation de l’intelligence artificielle pour faire progresser la découverte scientifique rendent de plus en plus réaliste l’idée de systèmes automatisés de « science de bout en bout » : des chaînes de traitement intégrées capables de générer des hypothèses, de mener des expériences (in silico ou robotisées), d’analyser les résultats et de produire des résultats publiables avec une intervention humaine minimale. La question cruciale n’est pas de savoir si l’IA peut « faire » de la science, mais si la science – en tant que système social et évolutif produisant des connaissances fiables – peut survivre à la manière dont l’IA la pratique. »

Or, « la science n’est pas simplement une suite de tâches optimisables. Elle progresse par un processus analogue à l’évolution darwinienne : variation à travers de nombreux efforts indépendants ; sélection par la critique, la réplication et la compétition ; et conservation des résultats robustes. Cette structure distribuée permet à la science de s’autocorriger et de générer de la nouveauté. L’indépendance n’est pas fortuite ; elle est le mécanisme qui produit à la fois la fiabilité et la découverte. »

Mais, la science n’a jamais pleinement atteint cet idéal, rappellent-ils. Elle a aussi été façonnée par les biais, les erreurs et la fraude. Les partisans de l’intelligence artificielle arguent que l’automatisation pourrait atténuer certaines de ces limitations tout en accélérant les découvertes et en élargissant la participation. Reste donc à savoir si l’IA en science réduit ces imperfections ou les amplifie à l’échelle des machines.

L’intégration de l’IA à la science risque de modifier fondamentalement la structure de la science. Notamment en favorisant des plateformes dominantes, entraînées sur des données similaires et optimisées pour certains objectifs. « Comme sur d’autres marchés de technologies numériques, la concentration est un résultat plausible. Le risque est fort qu’une poignée de systèmes façonnent la majorité de la production scientifique (…). La diversité simulée au sein d’un système ne saurait se substituer à la diversité épistémique entre des approches véritablement concurrentes.»

La conséquence n’est pas seulement institutionnelle ; elle est bien épistémique, c’est-à-dire qu’elle concerne toutes les connaissances. « Le système scientifique prospère grâce à l’inefficacité : efforts redondants, tentatives infructueuses et chemins divergents. Il ne s’agit pas de coûts à éliminer, mais de sources de découverte. À l’inverse, les pressions d’optimisation favorisent la convergence. Il risque d’en résulter une production accrue, mais une exploration moindre de l’inattendu.»

« Ce rétrécissement a des implications sur la créativité. Une grande partie de la force de l’IA réside dans l’exploration combinatoire, le réarrangement des connaissances existantes en de nouvelles configurations. Or, nombre d’avancées majeures en science ne sont pas des combinaisons ; ce sont des ruptures, des changements conceptuels qui contredisent les hypothèses des cadres antérieurs. Parce que ces avancées s’écartent des schémas encodés dans les données existantes, elles sont les moins susceptibles d’émerger de systèmes entraînés sur le passé. »

« L’indépendance n’est pas seulement une garantie de fiabilité ; elle est la condition de la rupture conceptuelle. » A l’inverse, « l’optimisation de chaque composant ne garantit pas l’intégrité de l’ensemble. » Au contraire, elle peut la compromettre.

« Il ne s’agit pas de rejeter l’IA, mais de la considérer comme un simple progrès technique. Préserver les propriétés fondamentales d’un système scientifique évolutif devient désormais une contrainte de conception. Les résultats scientifiques doivent garantir une traçabilité claire – une chaîne de responsabilité identifiable qui ne se dissout pas dans des systèmes opaques. Les dispositifs institutionnels et techniques doivent assurer des approches véritablement distinctes, et non de simples variations au sein d’une architecture partagée. »

« Ces exigences ne sont pas des inefficacités à éliminer par l’ingénierie. Elles représentent les solutions accumulées au problème de la fiabilité des connaissances. Un système d’IA peut produire des résultats impressionnants. Mais s’il remplace un processus évolutif par un processus artificiel, il risque de restreindre non seulement le champ de nos découvertes, mais aussi notre capacité de découverte tout court. »

Le financement de la recherche : submergé par l’IA

Geraint Rees et James Wilsdon pour Nature tirent la sonnette d’alarme. L’IA est en train de submerger les appels à projets et demandes de financement de la recherche, améliorant le nombre, la qualité, le volume des demandes au risque de provoquer l’effondrement même du système. Les réponses générées par l’IA peuvent être entraînées sur les publications des chercheurs, sur les critères d’attribution des subventions et même sur les projets retenus pour ajuster les demandes aux résultats attendus. Et l’effet se constate déjà, pointent les chercheurs. Dans une étude qui a regardé les projets de 12 organismes de financement de la recherche de l’Union européenne, les chercheurs montrent une augmentation des candidatures depuis 2022. 

« Les décideurs politiques et les organismes de financement vont devoir repenser l’allocation des fonds de recherche avant que le système ne devienne ingérable. » Confrontés à un afflux de réponses de qualité, ils devront alors faire des choix largement arbitraires quant aux projets à financer et aux candidats. 

Jusqu’à présent, les organismes de financement de la recherche ont principalement réagi à ces évolutions en restreignant l’utilisation de l’IA par les candidats et les évaluateurs, certains déclarant les demandes inéligibles si elles sont élaborées avec de l’IA. Mais ces préconisations sont impossibles à appliquer car la probabilité de détection est faible et ne constitue pas une réponse au problème. Le risque est fort que toutes les propositions répondent aux critères de financement et que les différences entre elles soient minimes. « Lorsque les propositions et les évaluations sont toutes deux gérées par des agents entraînés sur le même corpus de travaux déjà financés, le système n’évaluera plus la qualité des idées, mais plutôt la capacité des agents à simuler les idées précédemment récompensées par les financeurs.» 

« Parmi les propositions visant à remédier à la surcharge des systèmes de financement figurent le recours à des tirages au sort (attribution aléatoire de fonds à des demandes de subvention correspondant à un certain niveau de qualité) et des modèles distribués d’évaluation par les pairs, où les chercheurs qui soumettent des demandes de subvention sont chargés d’évaluer celles d’autres chercheurs. Ces mesures permettent de lutter contre le volume de demandes, mais elles restent inefficaces si les indicateurs de qualité deviennent peu fiables. »

Geraint Rees et James Wilsdon proposent plutôt que les organismes de financement envisagent de recentrer l’évaluation non plus sur les propositions écrites, mais sur le chercheur principal, son équipe et ses programmes de recherche passés et en cours. « Les financeurs devraient investir dans la vérification des antécédents afin d’examiner la performance de recherche d’un individu ou d’un groupe sur une période prolongée, ainsi que dans des entretiens et des évaluations de portefeuilles de la performance d’équipe sur la durée. » Mais cette solution écarte de fait les plus petites ou plus jeunes équipes : les aides risquent alors d’aller uniquement aux projets les plus établis. 

En mars, le Conseil de la recherche médicale du Royaume-Uni a annoncé le rétablissement des entretiens pour tous les candidats présélectionnés : une approche chronophage et laborieuse et peu adaptée aux grands volumes de candidatures. Le NIH américain, regroupant l’ensemble des Instituts nationaux de la santé, lui, a limité à 6 dépôts par an le nombre de candidatures individuelles, après avoir constaté que certains chercheurs en soumettaient plus de 40. Les financeurs pourraient également envisager des approches plus radicales, suggèrent les deux chercheurs.Il pourrait s’agir d’instaurer un quota fixe de propositions par chercheur ou pour l’ensemble de sa carrière, toutes sources de financement confondues. Ils pourraient aussi répartir le budget disponible entre les chercheurs éligibles à l’échelle nationale et attribuer le même montant à tous, éliminant ainsi la concurrence. 

D’autres solutions proposent aux organismes de recherche de s’appuyer sur l’IA pour l’évaluation. « L’IA pourrait ensuite servir à prioriser et à présélectionner les candidatures, en comparant les données selon ces différents profils afin d’identifier les candidats dont le parcours est cohérent avec les informations fournies dans leur dossier. Ce processus de présélection serait transparent, auditable et conçu pour favoriser la diversité, et non la freiner, à travers les différentes étapes de carrière, disciplines et institutions. » Mieux (ou pire, c’est selon), certains modèles proposent de prédire l’impact d’un article ou d’une recherche, fléchant les financements vers les projets les plus porteurs. 

Quelque soient les solutions retenues, la nécessaire transformation du financement de la recherche risque de se faire dans la douleur et la contestation, estiment les chercheurs. La mise en place d’infrastructures IA nécessite des investissements soutenus, des tests rigoureux et une gouvernance continue. Les financeurs confrontés à des contraintes budgétaires pourraient hésiter. C’est oublier pourtant que le système gaspille déjà des ressources considérables en comités d’experts et en nouvelles soumissions, sans parler du temps consacré par les chercheurs à répondre aux appels. Un système basé sur l’IA native et bien conçu pourrait constituer un investissement judicieux, défendent les chercheurs. Reste que des systèmes d’évaluation entraînés sur des données de financement historiques intégreront les inégalités passées, risquant d’amplifier, plutôt que de corriger, l’effet Matthieu, c’est-à-dire la concentration au profit des plus dotés. « Il s’agit d’un risque réel, mais nous pensons que la conception et la gouvernance peuvent contribuer à l’atténuer. Les biais dans les systèmes d’IA sont mesurables, ce qui permet de les examiner et d’y remédier », soulignent-ils, certainement trop rapidement car les biais ne sont ni  mesurables ni corrigeables facilement. Troisièmement, les chercheurs et les institutions pourraient se montrer réticents face aux décisions façonnées par des algorithmes qu’ils ne peuvent pas interroger. La transparence et les mécanismes d’appel pourraient contribuer à instaurer la confiance, défendent-ils encore.

Le système de financement par subventions conçu pour un monde pré-IA est devenu défaillant. Les financeurs doivent s’adapter, estiment les chercheurs. Il pourrait en résulter un système plus performant : un système qui exploite la puissance de l’IA et la combine à des connaissances spécialisées, et qui réduit le temps et l’énergie gaspillés dans la rédaction de demandes de subventions improductives pour les réorienter vers une recherche novatrice. Un constat plus facile à déclamer qu’à mettre au point. 

Prédire les résultats de la science… au risque de l’y enfermer

Certains modèles proposent de prédire l’impact d’un article ou d’une recherche, fléchant les financements vers les projets les plus porteurs, expliquaient donc Geraint Rees et James Wilsdon. Qu’en est-il ? 

Savoir si une étude changera le monde ? C’est pourtant l’idée que propose Funding the Frontier : un tableau de bord pour prédire l’impact de la recherche. L’outil (non disponible) utilise le Big data pour retracer l’impact sociétal des projets de recherche sur les politiques, les médicaments ou les produits, explique Nature (voir également l’article de recherche qui montre des captures d’écran du tableau de bord et la vidéo promotionnelle). Le projet porté par Dashun Wang « intègre des données sur les publications de recherche, les brevets, les documents d’orientation et les essais cliniques, et présente ces informations de manière visuelle et intuitive. Ils ont également combiné cet outil à un algorithme prédictif basé sur l’apprentissage automatique pour prédire les études et les domaines susceptibles d’apporter les plus grands bénéfices sociétaux à l’avenir – par exemple, les subventions les plus susceptibles de déboucher sur un brevet ». « Même sans son aspect prédictif, disposer d’un outil permettant de rechercher l’impact des recherches sur la société » est déjà une information importante, estime un chercheur. 

Un chef de projet d’une importante agence de financement américaine l’a utilisée pour examiner les impacts sociaux généraux des subventions de l’agence, lui permettant de constater l’impact de certaines recherches ailleurs dans le monde. « Un autre utilisateur, investisseur dans le domaine de la recherche biomédicale, a constaté que dans le domaine de la recherche sur la maladie d’Alzheimer, l’impact clinique le plus important au cours des 20 dernières années provenait d’études visant à comprendre la maladie, mais que l’impact futur le plus important prévu se concentrait sur les études portant sur les systèmes de soutien social des personnes atteintes de la maladie, ce qui laisse entrevoir de nouvelles opportunités d’investissement ». 

L’aspect prédictif est pourtant préoccupant, estime le même James Wilsdon qui en évoquait les perspectives précédemment. Le spécialiste des politiques de recherche estime que ce tableau de bord pourrait créer des prophéties autoréalisatrices et des décisions d’investissements plus conservatrices, au détriment de recherches plus originales, capables d’ouvrir d’autres possibilités. 

Coincés dans l’Academic Slop ? 

En attendant, le travail académique commence à crouler sous la « prolifération métastatique de publications » truffées d’hallucinations et de distorsions de contenus, comme s’en plaint sur Facebook la philosophe du droit, Antoinette Rouvroy. L’Academic Slop est arrivé, constate également le chercheur Seva Gunitsky dans sa newsletter. Il raconte que dans la revue dont il s’occupait le nombre de soumission a doublé voire triplé depuis l’apparition de l’IA générative, et que le taux de rejet s’est envolé. Techniquement compétents, certains de ces articles respectent les normes et sont tout à fait convenables. Faciles à produire et exigeant peu de créativité, ils constituent néanmoins le type de travail incrémental légitime que le philosophe des sciences Thomas Kuhn appelait la fabrique de la « science normale ». Pour Gunitsky la valeur d’une théorie originale va continuer à prendre de l’importance. « Les travaux quantitatifs de qualité deviennent bon marché et abondants ; une bonne théorie reste difficile à élaborer ».

Mais l’effet le plus important est que l’évaluation par les pairs repose désormais davantage sur le discernement. Si n’importe qui peut produire un article empirique compétent sur n’importe quel sujet, le principal obstacle devient l’identification des questions importantes à poser. « Dans ce contexte, la question pour les évaluateurs et les éditeurs n’est plus tant « est-ce juste ?» que « pourquoi est-ce important ? ». Cette question est inévitablement subjective, mais pas totalement, car elle exige une solide connaissance des débats en cours. Elle nécessite néanmoins de connaître les tensions et les lacunes productives, les énigmes intéressantes et les idées reçues apparemment établies. »

« Ce concept porte un nom : la phronesis. C’était le terme employé par Aristote pour désigner la sagesse pratique, ou la capacité à discerner la conduite à tenir dans des circonstances particulières. Contrairement à l’épistémè (la connaissance scientifique) ou à la technè (le savoir-faire technique), la phronesis ne peut se réduire à des règles ou à des algorithmes. Elle requiert de l’expérience, du jugement et ce qu’Aristote appelait la « perception ». Cela signifie non seulement l’intelligence, mais aussi la capacité intellectuelle de percevoir les caractéristiques essentielles d’une situation donnée. »

La philosophe Isaiah Berlin appelait cette qualité « le sens du réel » dans le jugement politique : la capacité de percevoir ce qui est possible et ce qui compte à un moment historique donné. Or, il n’est pas certain que les IA possèdent cette capacité voire ne la possèdent jamais. « Si le discernement devient le critère ultime de qualité, nous nous dirigeons encore davantage vers un système à deux vitesses dans l’édition scientifique. Les revues les plus prestigieuses privilégieront les articles d’une originalité remarquable ou présentant des avancées théoriques ou empiriques majeures, tandis que toutes les autres publieront les articles produits par l’IA qui font progresser, de manière graduelle, notre compréhension de sujets spécifiques. Et peut-être que la théorie gagnera en prestige au détriment des méthodes sophistiquées d’analyse des données. »

Pas sûr que la théorie et l’empirisme puissent ainsi si facilement se scinder en deux. Le risque que les publications automatisées se transforment en matière noire scientifique, que personne ne lit ni ne consulte est fort. A nouveau, ici aussi, le risque est fort que s’accentue  davantage les hiérarchies de prestige comme critère d’importance. « Paradoxalement, l’effet uniformisant de l’IA pourrait rendre le monde universitaire plus élitiste encore ».

« La technologie qui nous a inondés de dissertations étudiantes façonnées avec l’IA va maintenant inonder de nos propres travaux, et nous aurons besoin de ce même discernement dont nous nous plaignons de l’absence chez nos étudiants. » Pas sûr que ce soit plus facile pour les experts. L’IA fait peut-être gagner beaucoup de temps à certains, mais la pollution des travaux de recherche qu’elle engendre en fait perdre énormément aux lectrices et lecteurs. Le goulot d’étranglement de la lecture et de la vérification s’annonce plus reserré que jamais. 

La seule chose dont on soit sûr, en observant toutes ces perspectives… ce n’est pas que l’IA apporte un progrès scientifique notable, c’est que l’IA en science renforce les inégalités dans toutes les couches de la science.  

Hubert Guillaud

MAJ du 02/06/2026 : Une analyse de 7,3 millions d’articles de revues scientifiques publiés entre 2020 et 2025 révèle qu’en 2025, un peu plus de la moitié présentent des signes d’influence des LLM, avec des variations importantes d’utilisation selon la région du monde, le prestige de l’établissement, l’éditeur et la discipline. « Le développement économique et la proximité de l’anglais comme langue principale sont des facteurs prédictifs clés de ces variations régionales. Les établissements moins bien classés affichent des taux d’adoption plus élevés que les universités d’élite, les jeunes éditeurs à but lucratif présentent des taux supérieurs à ceux de leurs concurrents, et l’adoption varie considérablement selon les disciplines universitaires. L’adoption des LLM dans la rédaction académique est répandue, mais socialement stratifiée. »

MAJ du 21/06/2026 : Dans leur newsletter, Tim O’Reilly et Ilan Strauss, proposent de garantir un exosquelette pour appliquer l’IA à la science. Cet exosquelette est constitué d’innombrables systèmes permettant de garantir les références, comme le DOI (l’identifiant d’objets numériques qui attribue un numéro à chaque publication scientifique), RetractationWatch (la base de données des articles scientifique dépubliés et rétractés), Orcid (qui founit un identifiant unique aux chercheurs), Open Alex (un graphe de connaissances scientifiques)… ou encore le projet Vraix du MIT (cherchant à créer une toile du savoir pour distinguer les contenus possiblement génératifs des autres)… et nombres d’autres, qui n’ont pas été intégrés aux systèmes d’IA, alors qu’ils pourraient permettre de résoudre de nombreux problèmes : diminuer les citations erronées, réduire l’emprise de la littérature scientifique non valide… une infrastructure fondée sur des principes ouverts qui cherchent à garantir que les contenus scientifiques ne puissent être ni accaparés ni dégradés. Ces infrastructures sont des biens publics que les entreprises d’IA ignorent pour la plupart ou, pire, fragilisent. « À l’heure actuelle, la relation entre l’IA et l’infrastructure scientifique est presque exclusivement extractive. Les entreprises d’IA entraînent leurs modèles sur des articles scientifiques. Elles créent des produits capables de générer et de manipuler des textes scientifiques. Elles se disputent le marché de l’« IA au service de la science ». Pourtant, elles ne contribuent pratiquement pas à l’infrastructure qui, à la base, garantit la fiabilité des connaissances scientifiques. »

Les entreprises d’IA consomment du contenu scientifique sans rien apporter en retour. Strauss et O’Reilly font une analogie avec Content ID de YouTube : face à l’utilisation non autorisée de leurs œuvres, la première réaction de l’industrie musicale a été d’exiger leur retrait. La réponse de YouTube a été : « Et si nous vous aidions plutôt à les monétiser ? » Cette approche a permis d’aligner les intérêts et de créer une économie dynamique pour les créateurs. Nous devrions appliquer le même raisonnement à la science. Les entreprises d’IA ne devraient pas seulement utiliser l’infrastructure scientifique pour améliorer leurs produits (elles le devraient pourtant), mais elles devraient surtout chercher à aider la science à gagner en valeur, en pérennité et en exhaustivité.

Pour cela, les systèmes d’IA devraient améliorer la validation de leurs sources et références. L’infrastructure existe, il leur suffit de l’utiliser. Ils pourraient également réinjecter les métadonnées extraites dans OpenAlex, améliorant ainsi le graphe de données pour tous. Ils pourraient utiliser et financer RetractationWatch pour améliorer leurs modèles et réponses. Les fournisseurs d’IA pourraient également financer cette infrastructure scientifique très fragile qui constitue le socle technique de la crédibilité de la science. « Les entreprises d’IA, qui génèrent des milliards de revenus grâce à des produits reposant sur la crédibilité scientifique, devraient contribuer à l’infrastructure qui garantit cette crédibilité. Il ne s’agit pas de philanthropie, mais d’un intérêt bien compris.» Elles pourraient également contribuer a améliorer cette chaîne qui identifie la provenance du contenu scientifique. « Lorsque l’IA contribue à un article scientifique, cette contribution doit être traçable : elle ne doit pas simplement faire l’objet d’une déclaration standard, mais être liée à des affirmations, des sources et des étapes de vérification précises. »

« Les entreprises d’IA qui s’appuieront sur cette infrastructure créeront de meilleurs produits. Mais surtout, elles investiront dans l’infrastructure civilisationnelle qui rend possible, à la base, l’existence de connaissances fiables. À condition toutefois que les entreprises d’IA cessent de considérer cette question comme le problème d’autrui et commencent à la voir comme un socle sur lequel bâtir — un socle dont dépend leur propre succès dans le domaine scientifique.»

  •  
❌